هل سبق أن أمضيت ساعات في التخطيط لقصة ولقطاتها، لتتفاجأ بتغيّر ملامح الشخصية بين المشاهد أو اختفاء حدث رئيسي؟ يمكن للفيديو بالذكاء الاصطناعي أن يجسد أفكارك، لكن الإصلاحات المتكررة قد تلتهم الوقت الذي كنت تأمل توفيره. سنستعرض ستة قيود في تقنية توليد الفيديو بالذكاء الاصطناعي الحالية، والحلول العملية، وأين يمكن لـ Kling VIDEO 3.0 السلسلة أن تساعد.
ما هي قيود تقنية توليد الفيديو بالذكاء الاصطناعي الحالية؟
أصبح بإمكان الفيديو بالذكاء الاصطناعي الآن التعامل مع مشاهد أكثر تعقيدًا، لكن الاتساق، والحركة، والنص، والتحكم الدقيق لا تزال تتعطل أثناء التوليد. بدءًا من الحفاظ على الاتساق البصري عبر الإطارات وصولًا إلى التحكم في الحركة والتفاصيل، تواصل هذه القيود تشكيل كيفية استخدام المبدعين للذكاء الاصطناعي في إنتاج الفيديو.
يعرض الجدول أدناه المجالات التي لا تزال تقنية توليد الفيديو بالذكاء الاصطناعي الحالية تقصّر فيها، وكيف تظهر تلك المشكلات في المشاريع الواقعية، وما الذي يمكنك فعله لتجاوزها.
القيد | التحدي التقني | ما الذي يحدث | حل سريع |
ثبات زمني محدود وتماسك الإطارات | يتعين على النموذج الحفاظ على الإضاءة والتخطيط والقوام والمعلومات البصرية الأخرى عبر الإطارات المتتالية بينما تتحرك الموضوعات والكاميرات. | قد تتغير الإضاءة، ويمكن أن تنجرف عناصر الخلفية، وقد تختفي الأدوات الصغيرة، ويمكن أن تومض القوام أو مخططات الأجسام أثناء اللقطة. | حافظ على تركيز كل لقطة على حركة رئيسية واحدة. للمشاهد الأكثر تعقيدًا، استخدم مقاطع أقصر وصورة مرجعية للحفاظ على الإعداد والتكوين في مكانهما. |
ثبات الشخصيات والأشياء عبر اللقطات | يجب أن تعيد اللقطات المُنشأة بشكل منفصل إنشاء هوية الموضوع والمظهر وتفاصيل التصميم نفسها في كل مرة. | قد تتغير الوجوه، وتسريحات الشعر، والملابس، والإكسسوارات، وأشكال المنتجات، والألوان، أو التفاصيل السطحية من لقطة إلى أخرى. | أعد استخدام صور المرجع نفسها واحتفظ بتفاصيل التعريف متسقة. تجنب تغيير الإضاءة، وزاوية الكاميرا، والأسلوب، والبيئة كلها دفعة واحدة. |
فيزياء وحركة غير واقعية | يجب على النموذج الحفاظ على واقعية ميكانيكا الجسم، وتلامس الأجسام، والعلاقات المكانية، وسلوك المواد مع مرور الوقت. | قد تمر الأيدي عبر الأشياء، وقد تبدو الحركة عديمة الوزن، وقد تبدو الاصطدامات غير صحيحة، ويمكن أن تتصرف الأقمشة أو الماء أو الشعر أو حركات الكاميرا السريعة بطريقة غير طبيعية. | قسّم الأفعال المعقدة إلى إيقاعات منفصلة. صف حركة الموضوع وحركة الكاميرا بشكل منفصل بدلاً من دمجهما في تعليمات واحدة. |
توليد فيديو طويل الشكل محدود | يجب على التسلسل الأطول الحفاظ على الشخصيات والمواقع والدعائم والأسلوب البصري والتوقيت ومنطق القصة عبر لقطات عديدة. | قد تنحرف الشخصيات أو المواقع، ويمكن أن تختفي الدعائم، وتصبح فجوات الاستمرارية أكثر وضوحًا، وقد تبدو المشاهد منفصلة كلما طال الفيديو. | اعمل انطلاقًا من لوحة القصة أو قائمة اللقطات، وأعد استخدام المرجعيات البصرية، وأنشئ المشروع مشهدًا تلو الآخر. تعامل مع الإيقاع والانتقالات والتسلسل النهائي أثناء المونتاج. |
صعوبة في التفاصيل الدقيقة وإنشاء النصوص | الأشكال الصغيرة، الطباعة، الشعارات، وتفاصيل المنتج تتطلب اتساقًا مكانيًا دقيقًا من إطار إلى آخر. | يمكن أن تنحرف الأصابع، وقد يُكتب النص بطريقة خاطئة أو يتعرض للتشويه، ويمكن أن تتحرك الشعارات، وقد تتغير الميزات الصغيرة للمنتج أثناء الحركة. | أضف النصوص والشعارات والعناوين والعناصر الثابتة الأخرى للعلامة التجارية في مرحلة المعالجة اللاحقة. بالنسبة للقطات المنتج، استخدم مرجعًا واضحًا واحرص على أن يكون التأطير بسيطًا نسبيًا. |
تحكم وتخصيص محدودان عبر المطالبات | التحكم القائم على المطالبات غير مباشر، لذلك فإن تغيير تعليمات واحدة قد يؤثر أيضًا في أجزاء أخرى من اللقطة المولدة. | قد يتبع النموذج بعض التعليمات عن كثب بينما يغير الإطار أو الخلفية أو التوقيت أو مظهر الموضوع بطرق لم تطلبها. | حدد الموضوع والمظهر العام أولاً، ثم حسّن الحركة والإطار والتوقيت في خطوات أصغر. ولّد بضعة تنويعات قصيرة بدلاً من وضع كل متطلباتك في موجه واحد طويل. |
كيف يساعد Kling مولّد الفيديو بالذكاء الاصطناعي في معالجة هذه القيود
يوفر Kling AI Video Generator مزيداً من التحكم الإبداعي والإنتاجي في إنشاء الفيديو بالذكاء الاصطناعي، مما يجعل تطوير اللقطات المتصلة والموضوعات المتكررة والحوار والسرد البصري الأكثر تعقيداً أسهل. عبر VIDEO 3.0 و VIDEO 3.0 Omni، يمكن للمبدعين العمل على الحفاظ على الاتساق في الموضوعات المستندة إلى المراجع، وميزات Multi-Shot و Custom Multi-Shot، والتحكم في الحركة، وتوليداً مرناً يتراوح بين 3 و15 ثانية، وإخراج نص بمستوى أصلي، وصوت أصلي لدعم إنشاء فيديو سينمائي احترافي.
حافظ على اتساق الشخصيات والمنتجات عبر اللقطات
عندما يظهر الشخص نفسه أو المنتج ذاته أو الدعامة المهمة نفسها عبر عدة لقطات، يصبح الحفاظ على ملامحه المميزة قابلة للتعرّف صعبًا إذا جرى توليد كل لقطة من وصف جديد. توفر سلسلة Kling VIDEO 3.0 تدفقات عمل قائمة على المراجع تمنح النموذج المزيد من المعلومات المرئية حول العناصر المتكررة وتساعد على تقليل التغييرات غير المرغوب فيها بين اللقطات.
باستخدام Kling VIDEO 3.0, يمكنك استخدام صور مرجعية متعددة لتقديم زوايا مختلفة للشخصية نفسها أو المنتج نفسه أو العنصر نفسه. بالنسبة إلى شخصية ما، يمكن أن تمنح الزوايا الأمامية والجانبية وغيرها من الزوايا المفيدة النموذج معلومات إضافية حول بنية الوجه، وتسريحة الشعر، والملابس، والسمات المميزة. وبالنسبة إلى المنتجات أو الدعامات المهمة، يمكن للزوايا الإضافية التقاط تفاصيل قد تفوتها صورة أمامية واحدة، مثل الشكل، والنسب، والمواد، وتفاصيل الجوانب، أو خصائص السطح.
بالنسبة للمشاريع التي تحتاج إلى موضوع قابل لإعادة الاستخدام عبر لقطات ومشاهد مختلفة، توفر Kling VIDEO 3.0 Omni سير عمل مرجع العنصر. يمكنك إنشاء عنصر من صور متعددة الزوايا أو فيديو قصير للشخصية، ثم الرجوع إلى ذلك العنصر مرة أخرى مع تغير المشهد أو زاوية الكاميرا أو المحتوى المحيط. يمكن لعناصر الشخصية أيضًا أن تتضمن معلومات صوتية، مما يساعد شخصية متكررة على الحفاظ على السمات البصرية المميزة نفسها وصوت متسق عبر المشاهد ذات الصلة.
في كلا سيرَي العمل، يمكن للمعلومات المرجعية الأقوى أن تقلل من الإعادات الناتجة عن تغير الوجه، أو اختفاء ملحق، أو ابتعاد المنتج عن تصميمه المقصود.
أمثلة على استخدام Kling VIDEO 3.0
إطار البداية | ||
مرجع الصورة | ||
| الموجه: تتحرك الكاميرا تدريجيًا حول الفتاة إلى الأمام، ثم ترفع رأسها وتبتسم بحرارة للكاميرا، كأنها ترى صديقة قديمة بعد سنوات طويلة. | ||
فيديو | ||
أمثلة على استخدام Kling VIDEO 3.0 Omni
عنصر/صورة مرجعية | |
@Shirt Boy | @Image1 |
لقطة متوسطة، منظر أمامي التوجيه: @Shirt Boy ينزل منحدرًا ويجلس بجوار العمود في @image. لقطة مقرّبة، الوجه: @Shirt Boy يتكئ على العمود ويقول: «نسيم اليوم يبدو ألين من الأمس... حتى العشب يبدو لطيفًا.» مظهر سينمائي @image1. لقطة مقرّبة جانبية، الوجه: @Shirt Boy يغمض عينيه بينما يتساقط ضوء الشمس برفق على وجهه. لقطة من الأعلى: @Shirt Boy يستلقي على ظهره، العشب يغطي قميصه، وذراعاه خلف رأسه، يحدق في السماء الزرقاء قائلاً: «آمل ألا ينتهي هذا النوع من الصيف أبدًا.»
| |
فيديو | |
توجيه حركة الشخصية المعقدة بدقة أكبر
بالنسبة للإجراءات اليومية، يمكنك وصف ما ينبغي على الشخصية القيام به داخل التوجيه، بما في ذلك الإيقاع، وحركة الجسم، وتغيرات التعبير. يمكن أن يحوّل مولّد فيديو بالذكاء الاصطناعي الخاص بـ Kling هذه التوجيهات إلى حركة، لكن النص يصبح أقل دقة عندما تتطلب اللقطة التفافًا معينًا أو إيماءة أو حركة رقص أو تسلسلًا من التعابير.
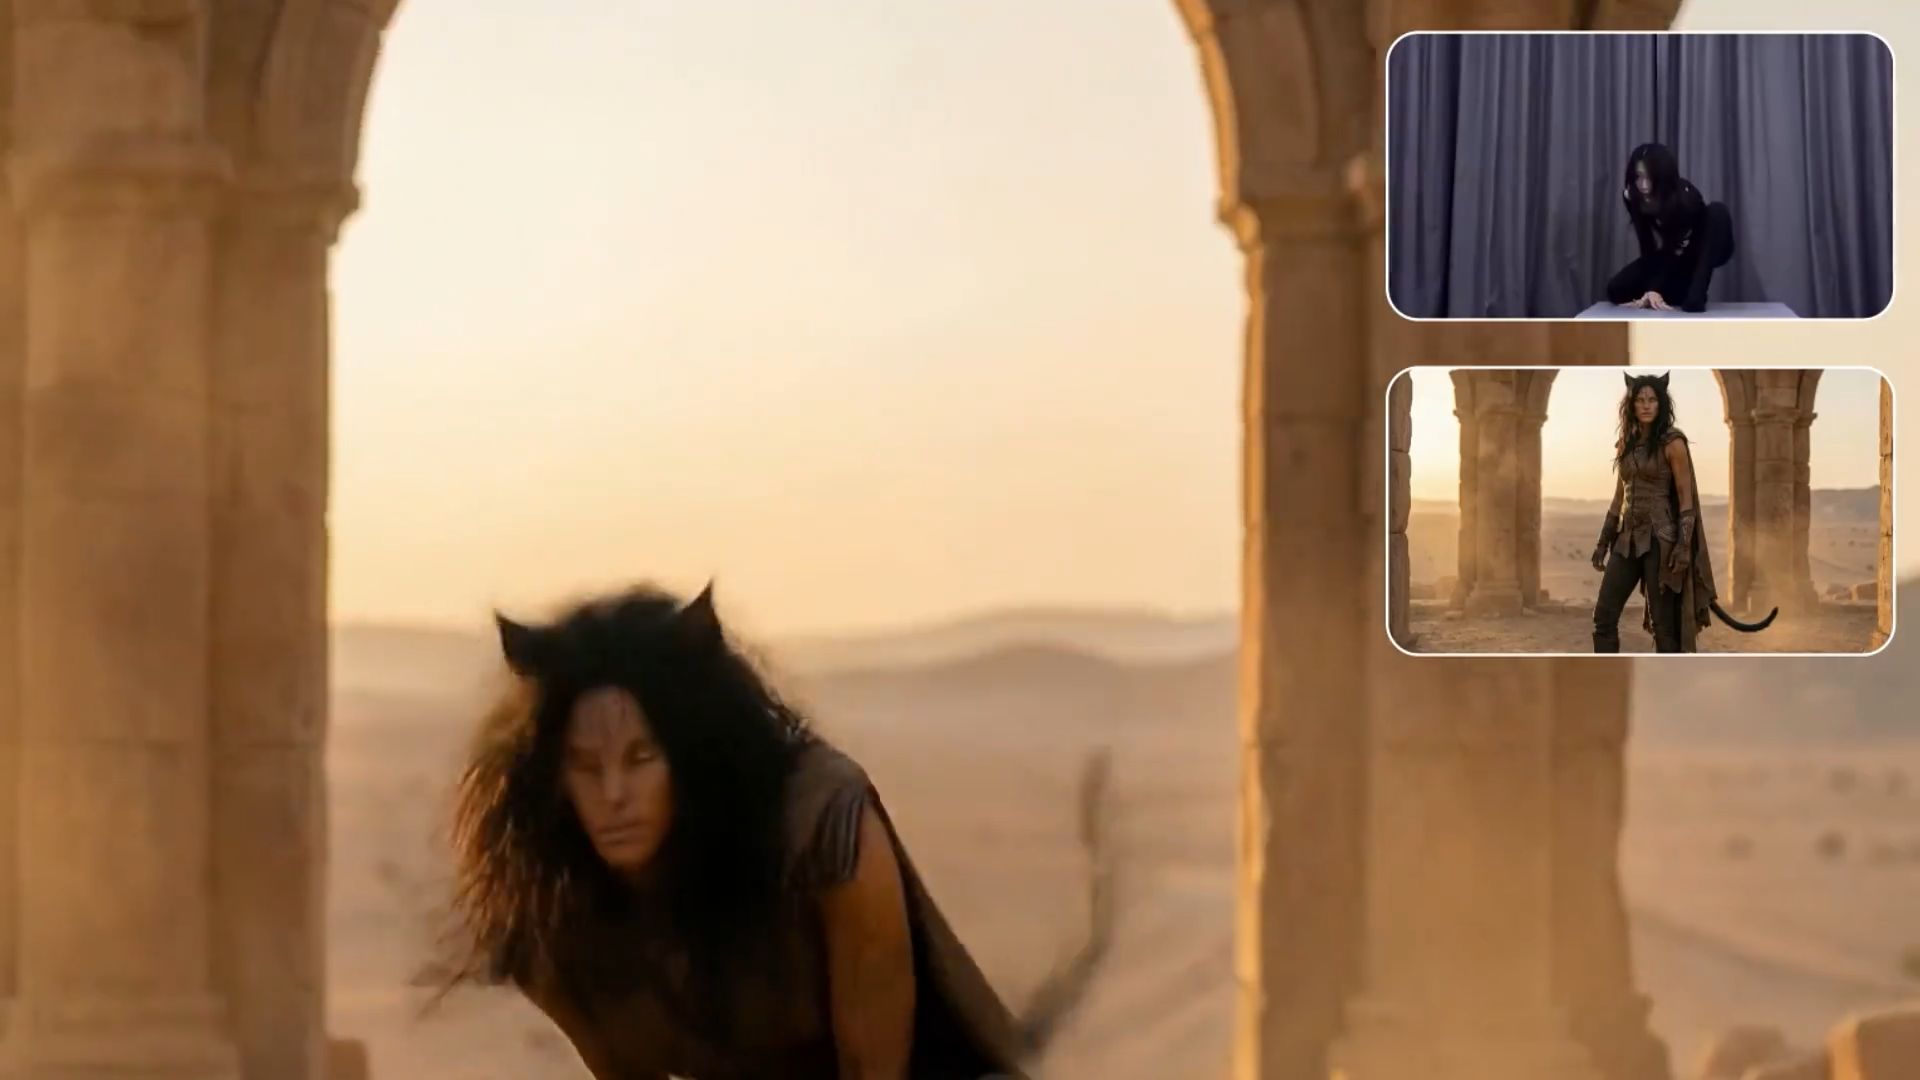
لهذا المستوى من التفاصيل، يعتمد Motion Control على مرجع للحركة بدلاً من ذلك. حمّل فيديو حركة أو اختر حركة من مكتبة الحركة، ثم طبّق حركته وتعبيراته على شخصيتك. كما يعمل Kling VIDEO 3.0 Motion Control على تحسين اتساق ملامح الوجه عبر الحركات المعقدة متعددة الزوايا وطويلة المدة. الانطلاق من الحركة التي تريدها يكون في الغالب أسهل من إعادة صياغة مطالبة عدة مرات للحصول على أداء محدد بشكل صحيح.

أنشئ ووجّه اللقطات المترابطة
نادراً ما تنجح المشاهد من زاوية كاميرا واحدة. قد تبدأ بلقطة واسعة، ثم تنتقل إلى لقطة أقرب، ثم تبدّل إلى لقطة ردّة فعل. وباستخدام Multi-Shot، يمكن لسلسلة Kling VIDEO 3.0 تخطيط التكوينات وتغييرات الكاميرا ضمن التسلسل نفسه.
إذا كنت تعرف مسبقًا كيفية تقسيم المشهد، فإن Custom Multi-Shot يتيح لك تحديد محتوى وطول كل لقطة بنفسك. هذا يجعل من الأسهل تشكيل الإيقاع من دون حشر كل التعليمات في مطالبة طويلة واحدة أو تجميع دفعة من المقاطع غير المرتبطة لاحقًا.
صورة مرجعية | |||
مرجع الشخصية | |||
التوجيه | |||
| اللقطة 1 (3 ثوانٍ): لقطة قريبة لمنصة الكوميديا المفتوحة للميكروفون (انظر صورة المرجع)، مع لافتة نيون عتيقة كبيرة مكتوب عليها "KLING" في الخلفية. تحدد الإضاءة الخلفية الذهبية الدافئة معالم المشهد. تتبع الكاميرا المؤدي بينما يسير نحو الميكروفون ويجري تعديلاً طفيفاً على ارتفاعه. | |||
| اللقطة 2 (4 ثوانٍ): لقطة قريبة متوسطة لـ @Little Scholar، يقول فيها: "لقد خسرت أمام Kid—كم يملك من خبرة عملية أصلاً؟—وكان يعلّم الجميع كيف يكونون سعداء في العمل." | |||
| اللقطة 3 (4 ثوانٍ): @Little Scholar، مرتدياً ابتسامة متحفظة وخفيفة، يتوقف بطبيعية ويقول: "اسمعوا هذا فقط: لقد أمضى خمس دقائق يجادل دفاعاً عن فرضية زائفة كهذه." | |||
| اللقطة 4 (ثانيتان): الانتقال إلى الجمهور الذي يضحك بصوت عالٍ. | |||
فيديو | |||
امنح القصص القصيرة مساحة أكبر للتطور
سلسلة Kling VIDEO 3.0 يمكنها إنشاء مقاطع تتراوح مدتها بين 3 و15 ثانية، مما يمنح المشهد القصير وقتًا أطول ليدخل أحد الشخصيات، ويتحدث، ويتفاعل، أو يتحرك عبر عدة وحدات سردية دون أن يُقسَّم إلى سلسلة من المقاطع الصغيرة. وعند إقرانه بـ Multi-Shot، يثبت ذلك الوقت الإضافي فعاليته في الإعلانات القصيرة، ومشاهد الحوار، واللحظات المحركة بالشخصيات حيث يكتسب إيقاع المشهد الأهمية نفسها التي تحظى بها العناصر البصرية.
حافظ على نص الشاشة ونسخة العلامة التجارية أكثر قابلية للاستخدام
يمكن أن ينهار النص بسرعة بمجرد أن يبدأ المشهد في التحرك. قد تتشوه الملصقات، وقد تسقط الحروف، ويمكن أن تنتقل اللافتات أو الشعارات من إطار إلى آخر.
بفضل مخرجات نصية بمستوى أصلي، تؤدي سلسلة VIDEO 3.0 عملاً أفضل في الحفاظ على اللافتات والتعليقات التوضيحية والتسميات وغيرها من النصوص مقروءة مع تغيّر اللقطة. بالنسبة للإعلانات ومقاطع الفيديو الخاصة بالمنتجات، يعني ذلك فقدان عدد أقل من اللقطات القابلة للاستخدام بسبب نص مشوّه أو هوية علامة تجارية غير مقروءة. تظل الشعارات الدقيقة وأصول العلامة التجارية المقفلة أكثر أمانًا عند إضافتها في مرحلة ما بعد الإنتاج عندما تكون الدقة ضرورية.
صورة |
فيديو |
اجمع الحوار والصوت ضمن سير العمل نفسه
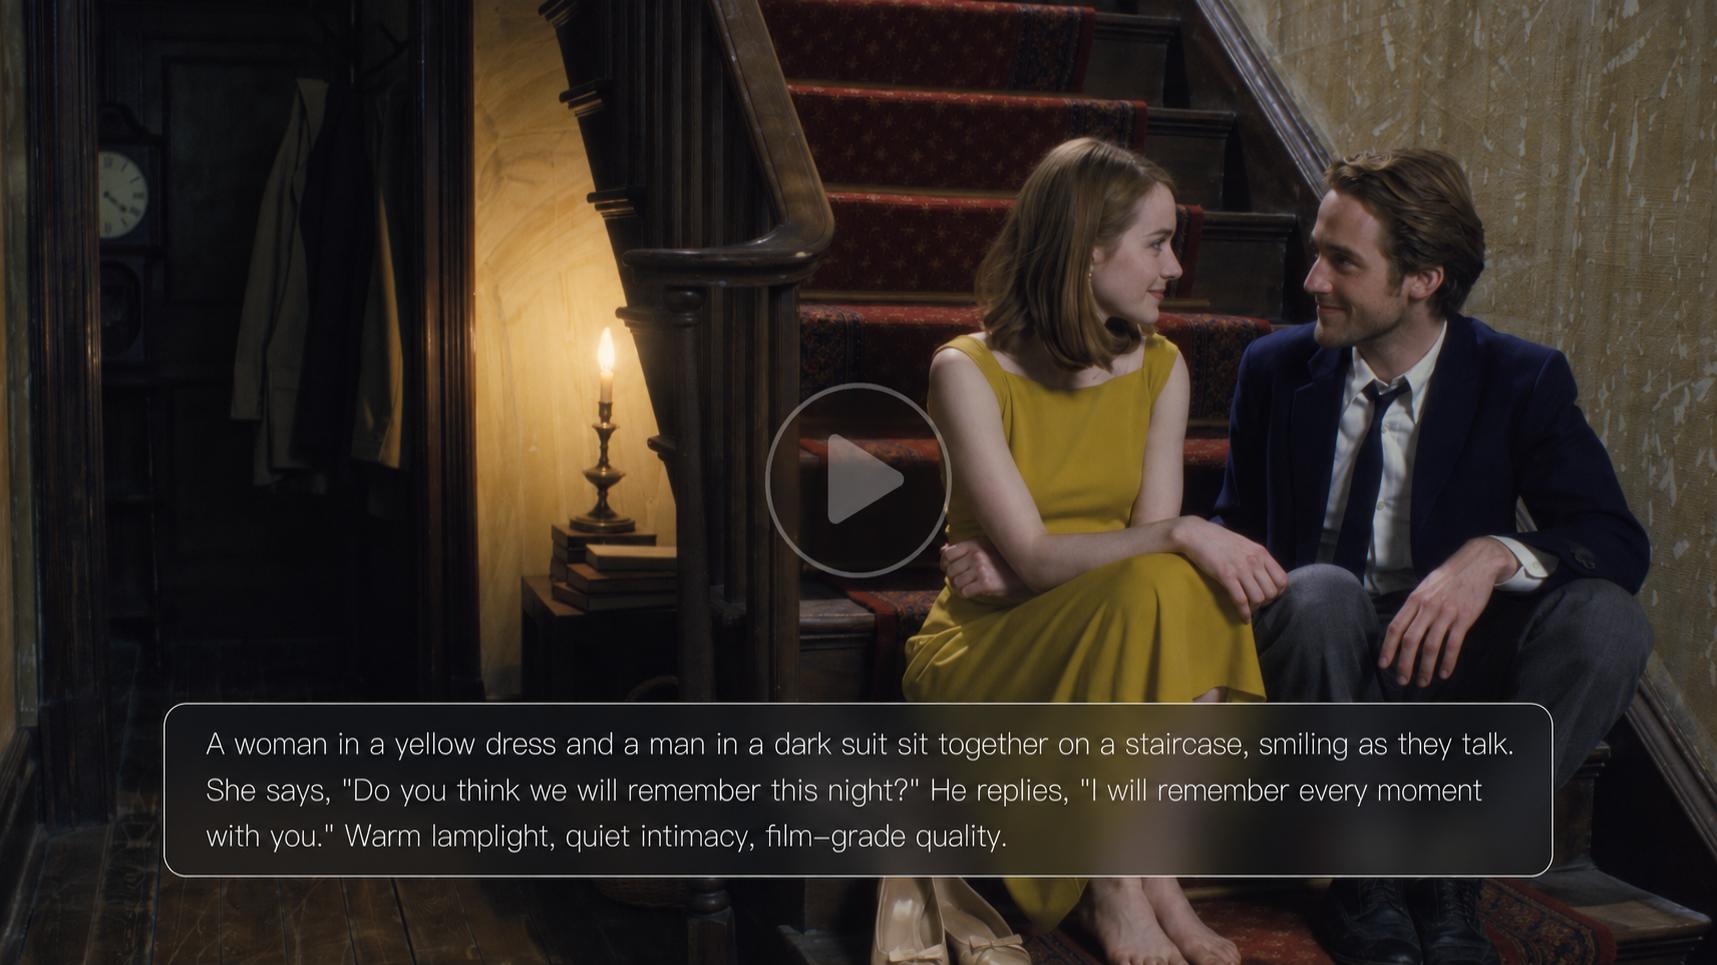
باستخدام Native Audio، تستطيع سلسلة VIDEO 3.0 إنشاء المشهد والحوار معًا، بما في ذلك المحادثات متعددة الشخصيات باللغات الصينية والإنجليزية واليابانية والكورية والإسبانية. بدلاً من إنشاء مقطع صامت أولاً والتعامل مع الأصوات والتوقيت ومزامنة الشفاه لاحقًا، يمكنك التخطيط لمن يتحدث، وما يقوله، وكيف يُنفَّذ المشهد منذ البداية. ويُعد ذلك مفيدًا بشكل خاص للأفلام القصيرة المعتمدة على الحوار والمشاهد متعددة الشخصيات، حيث يجب أن يظل الكلام وأداء الشخصيات متزامنين.
صورة |
التوجيه: في محطة صغيرة يلفها ضباب الصباح، ابتسم الصبي وقدم علبة البنتو قائلاً: 「أعددته على عجل، هل سيكون جيدًا؟ إنها وصفة أمي.」 تناولت الفتاة العلبة بابتسامة: 「نعم، سيكون لذيذًا بالتأكيد! سأتواصل معك عبر LINE عندما أصل.」 |
فيديو |
النهاية
سواء كنت تصنع إعلانًا لمنتج، أو فيلمًا قصيرًا يعتمد على الحوار، أو قصة متعددة اللقطات، فإن قيود تقنيات إنشاء الفيديو بالذكاء الاصطناعي الحالية غالبًا ما تظهر بطرق مألوفة: تتغير الشخصية بين اللقطات، تبدو الحركة غير متقنة، يتفكك النص، أو يحتاج المشهد إلى عدة محاولات للوصول إلى النتيجة الصحيحة. يمكن أن تقلل المراجع الواضحة، وتخطيط اللقطات الأقصر، وأدوات التحكم المخصصة لكل لقطة، من إعادة العمل غير الضرورية. تقدم سلسلة Kling VIDEO 3.0 اتساقًا قائمًا على المراجع للعنصر، وميزات Multi-Shot وCustom Multi-Shot، والتحكم في الحركة، وتوليدًا مرنًا بين 3 و15 ثانية، وإخراج نص بمستوى أصلي، وصوتًا أصليًا في سير عمل التوليد، ما يمنح المبدعين قدرة أكبر على التحكم في الشخصيات والحركة والإيقاع والحوار وسرد القصة بصريًا.
الأسئلة الشائعة
ما القيود الرئيسية لتقنية إنشاء الفيديو بالذكاء الاصطناعي في عام 2026؟
نماذج الفيديو بالذكاء الاصطناعي الحالية يمكن أن تفقد الاتساق كلما أصبح المشهد أكثر تعقيداً. قد يتغير موضع الوجه بين اللقطات، وقد تبدو الحركة غير دقيقة قليلاً، وقد يتشوه النص، وتصبح التسلسلات الأطول أصعب في الحفاظ على ترابطها. كما أن الأوامر التفصيلية لا تتحول دائماً إلى نتائج مطابقة تماماً، لذلك يعتمد المنشئون غالباً على صور مرجعية، ولقطات أقصر، وعدة جولات من التحسين للوصول بالمادة المصورة إلى المستوى المطلوب.
هل يمكن لمولدات الفيديو بالذكاء الاصطناعي إنشاء مقاطع طويلة؟
يمكن لمولدات الفيديو بالذكاء الاصطناعي إنتاج مقاطع أطول وتسلسلات متعددة اللقطات، لكن يصبح الحفاظ على الاتساق أكثر صعوبة كلما طال الفيديو. كما تركز معايير القياس مثل DirectorBench وMSVBench على مشكلات مثل الانتقالات بين اللقطات، والاتساق عبر اللقطات، واستمرارية السرد. في المشاريع الأطول، يكون من الأسهل عادة العمل لقطة تلو الأخرى، وإعادة استخدام المراجع نفسها، والتأكد من كيفية ارتباط كل مشهد قبل الانتقال إلى التالي.
لماذا تبدو مقاطع الفيديو المولدة بالذكاء الاصطناعي غير متسقة؟
يمكن أن تبدو مقاطع الفيديو المُنشأة بالذكاء الاصطناعي متباينة لأن النموذج يجب أن يحافظ على ثبات الوجوه والأشياء والقوام وغيرها من تفاصيل المشهد من إطار إلى الإطار التالي. عندما تتحرك الكاميرا أو يختفي شيء ما خلف جسم آخر ثم يعود إلى الظهور، قد تتغير تلك التفاصيل. استخدام نفس صورة المرجع، والبدء بفعل أبسط، وتغيير جزء واحد من المطالبة في كل مرة يمكن أن يجعل النتيجة أسهل للتحكم. إذا كان من الضروري تطابق وجه أو منتج أو أداة بشكل دقيق، فتحقق من المقطع إطارًا بإطار.
هل تستطيع مولدات الفيديو بالذكاء الاصطناعي إنشاء فيزياء واقعية؟
يمكن أن تجعل الفيديوهات المعتمدة على الذكاء الاصطناعي الحركة تبدو مقنعة، لكن ذلك لا يعني دائمًا أن الفيزياء صحيحة. T2VPhysBench اختبر نماذج الفيديو مقابل 12 قانونًا فيزيائيًا أساسيًا واكتشف مشكلات متكررة تتعلق بالجاذبية، والحفظ، وغيرها من التفاعلات الفيزيائية. إذا كان لا بد للفيديو أن يعرض كيفية عمل منتج، أو عملية علمية، أو تسلسلاً واضحًا للسبب والنتيجة، فقارن النتيجة بلقطات حقيقية وراجع الحركة بعناية.
ما أبرز اتجاهات تكنولوجيا الفيديو المُنشأ بالذكاء الاصطناعي في عام 2026؟
تشمل اتجاهات تقنية الفيديو المولَّد بالذكاء الاصطناعي في عام 2026 المزيد من الطرق لبدء فيديو، وتوجيه أداء، والتعامل مع الكلام داخل المشروع نفسه. قد يبدأ منشئ المحتوى بمولد فيديو بالذكاء الاصطناعي أو الذكاء الاصطناعي لتحويل الصور إلى فيديو، يستخدم التحكم في الحركة لحركة محددة، ثم يضيف حواراً منطوقاً مع مزامنة الشفاه أو أدوات الدبلجة. كما أصبحت الصور الرمزية بالذكاء الاصطناعي، والصوت الأصلي، وأدوات تحرير الفيديو جزءاً أكبر من كيفية صنع مقاطع الفيديو القصيرة والإعلانات والمحتوى المحلَّي.