Haben Sie schon einmal Stunden damit verbracht, eine Geschichte und ihre Einstellungen zu planen, nur damit sich das Gesicht einer Figur zwischen den Szenen verändert oder eine Schlüsselaktion verschwindet? KI-Video kann Ihre Ideen zum Leben erwecken, doch wiederholte Korrekturen verschlingen schnell die Zeit, die Sie eigentlich sparen wollten. Wir beleuchten sechs Einschränkungen der aktuellen KI-Videogenerationstechnologie, praktische Workarounds und wo die Kling VIDEO 3.0 Serie helfen kann.
Was sind die Einschränkungen der aktuellen KI-Videogenerationstechnologie?
KI-Video kann mittlerweile komplexere Szenen handhaben, doch Konsistenz, Bewegung, Text und präzise Steuerung können während der Generierung weiterhin zusammenbrechen. Von der Aufrechterhaltung visueller Konsistenz über mehrere Frames bis hin zur Kontrolle von Bewegung und Details prägen diese Einschränkungen weiterhin, wie Kreative KI in der Videoproduktion einsetzen.
Die folgende Tabelle zeigt, wo die aktuelle KI-Videogeneration noch zurückbleibt, wie sich diese Probleme in realen Projekten äußern und was Sie tun können, um sie zu umgehen.
Einschränkung | Technische Herausforderung | Was passiert | Schnelle Problemumgehung |
Begrenzte zeitliche Konsistenz und Bildkohärenz | Das Modell muss Beleuchtung, Layout, Texturen und andere visuelle Informationen über aufeinanderfolgende Frames hinweg bewahren, während sich Motive und Kameras bewegen. | Die Beleuchtung kann sich verändern, Objekte im Hintergrund können driften, kleine Requisiten können verschwinden, und Texturen oder Körperumrisse können während einer Aufnahme flackern. | Richte jede Aufnahme auf eine zentrale Aktion aus. Für komplexere Szenen verwende kürzere Clips und ein Referenzbild, um Setting und Komposition stabil zu halten. |
Konsistenz von Charakteren und Objekten über Aufnahmen hinweg | Separat generierte Aufnahmen müssen jedes Mal dieselbe Subjektidentität, Erscheinung und Designdetails reproduzieren. | Gesichter, Frisuren, Kleidung, Accessoires, Produktformen, Farben oder Oberflächendetails können sich von einer Aufnahme zur nächsten verändern. | Verwenden Sie dieselben Referenzbilder erneut und halten Sie prägende Details konsistent. Vermeiden Sie es, Beleuchtung, Kamerawinkel, Styling und Umgebung gleichzeitig zu ändern. |
Unrealistische Physik und Bewegung | Das Modell muss Körpermechanik, Objektkontakt, räumliche Beziehungen und Materialverhalten über die Zeit hinweg glaubwürdig halten. | Hände können durch Objekte hindurchgehen, Bewegungen können sich schwerelos anfühlen, Kollisionen können falsch aussehen, und Stoff, Wasser, Haare oder schnelle Kamerabewegungen können sich unnatürlich verhalten. | Zerlege komplizierte Aktionen in einzelne Beats. Beschreibe die Bewegung des Motivs und die Kamerabewegung getrennt, anstatt beides in eine einzige Anweisung zu packen. |
Begrenzte Longform-Videoerstellung | Eine längere Sequenz muss Figuren, Schauplätze, Requisiten, visuellen Stil, Timing und erzählerische Logik über viele Einstellungen hinweg bewahren. | Figuren oder Schauplätze können abdriften, Requisiten können verschwinden, Kontinuitätsbrüche werden auffälliger, und Szenen können sich losgelöst anfühlen, je länger das Video wird. | Arbeite anhand eines Storyboards oder einer Shot-Liste, verwende visuelle Referenzen erneut und generiere das Projekt Szene für Szene. Kümmere dich um Rhythmus, Übergänge und die endgültige Sequenzierung im Schnitt. |
Schwierigkeiten mit feinen Details und Texterzeugung | Kleine Formen, Typografie, Logos und Produktdetails erfordern eine exakte räumliche Konsistenz von Frame zu Frame. | Finger können sich verformen, Text kann falsch geschrieben oder verzerrt sein, Logos können verrutschen, und kleine Produktmerkmale können sich während der Bewegung verändern. | Fügen Sie Text, Logos, Untertitel und andere feste Markenelemente in der Postproduktion hinzu. Verwenden Sie für Produktaufnahmen eine klare Referenz und halten Sie die Bildgestaltung relativ schlicht. |
Eingeschränkte Prompt-Steuerung und Anpassung | Die promptbasierte Steuerung ist indirekt, daher kann das Ändern einer Anweisung auch andere Teile der generierten Aufnahme beeinflussen. | Das Modell kann manchen Anweisungen genau folgen, verändert dabei jedoch Bildausschnitt, Hintergrund, Timing oder das Erscheinungsbild des Motivs auf eine Weise, um die Sie nicht gebeten haben. | Legen Sie zunächst Motiv und Gesamtlook fest und verfeinern Sie anschließend Bewegung, Bildausschnitt und Timing in kleineren Schritten. Erzeugen Sie einige kurze Variationen, statt alle Anforderungen in ein einziges langes Prompt zu packen. |
Wie der Kling AI Video Generator dabei hilft, diese Einschränkungen zu beheben
Der Kling AI Video Generator bringt mehr kreative und produktionstechnische Kontrolle in die KI-Videoerstellung und erleichtert es, zusammenhängende Einstellungen, wiederkehrende Motive, Dialoge und komplexere visuelle Erzählweisen zu entwickeln. In VIDEO 3.0 und VIDEO 3.0 Omni können Kreative mit referenzbasierter Motivkonsistenz, Multi-Shot und Custom Multi-Shot, Motion Control, flexibler 3–15-Sekunden-Generierung, Native-Level Text Output und Native Audio arbeiten, um professionelle filmische Videoproduktionen zu unterstützen.
Halten Sie Charaktere und Produkte über Einstellungen hinweg konsistent
Wenn dieselbe Person, dasselbe Produkt oder ein wichtiges Requisit in mehreren Aufnahmen erscheint, kann es schwierig sein, seine bestimmenden Merkmale wiedererkennbar zu halten, wenn jede Aufnahme aus einer neuen Beschreibung generiert wird. Die Kling VIDEO 3.0-Serie bietet referenzbasierte Workflows, die dem Modell mehr visuelle Informationen über wiederkehrende Motive liefern und helfen, unerwünschte Änderungen zwischen den Aufnahmen zu reduzieren.
Mit Kling VIDEO 3.0, können Sie mehrere Referenzbilder verwenden, um verschiedene Ansichten desselben Charakters, Produkts oder Objekts bereitzustellen. Bei einer Figur können Ansichten von vorne, von der Seite und aus anderen nützlichen Winkeln dem Modell mehr Informationen über Gesichtsstruktur, Frisur, Kleidung und erkennbare Merkmale liefern. Bei Produkten oder wichtigen Requisiten können zusätzliche Ansichten Details erfassen, die eine einzelne Vorderansicht möglicherweise übersieht, etwa Form, Proportionen, Materialien, Seitendetails oder Oberflächenmerkmale.
Für Projekte, die ein wiederverwendbares Motiv über verschiedene Einstellungen und Szenen hinweg benötigen, bietet Kling VIDEO 3.0 Omni einen Element-Reference-Workflow. Sie können ein Element aus Mehrwinkelbildern oder einem kurzen Charaktervideo erstellen und dieses Element dann erneut referenzieren, wenn sich die Szene, der Kamerawinkel oder der umgebende Inhalt ändern. Charakterelemente können auch Sprachinformationen enthalten, wodurch eine wiederkehrende Figur sowohl erkennbare visuelle Merkmale als auch eine konsistente Stimme über verwandte Szenen hinweg beibehält.
In beiden Workflows können stärkere Referenzinformationen Wiederholungen reduzieren, die durch ein sich veränderndes Gesicht, ein verschwindendes Accessoire oder ein Produkt entstehen, das von seinem beabsichtigten Design abweicht.
Anwendungsbeispiele für Kling VIDEO 3.0
Startbild | ||
Bildreferenz | ||
| Prompt: Die Kamera bewegt sich allmählich nach vorne um das Mädchen herum, bis sie vor ihr ist; sie hebt dann den Kopf und lächelt der Kamera warm zu, als würde sie nach vielen Jahren einen alten Freund wiedersehen. | ||
Video | ||
Kling VIDEO 3.0 Omni Anwendungsbeispiele
Element-/Referenzbild | |
@Shirt Boy | @Image1 |
Halbnahe, Vorderansicht Prompt: @Shirt Boy läuft den Hang hinunter und setzt sich am Pfosten in @image. Nahaufnahme, Gesicht: @Shirt Boy lehnt sich an den Pfosten und sagt: „Der Wind fühlt sich heute weicher an als gestern … sogar das Gras wirkt sanft.“ Filmischer Look @image1. Seitliche Nahaufnahme, Gesicht: @Shirt Boy schließt die Augen, während Sonnenlicht sanft auf sein Gesicht fällt. Vogelperspektive: @Shirt Boy legt sich zurück, Gras bedeckt sein Hemd, die Arme hinter dem Kopf, blickt in den blauen Himmel und sagt: „Ich hoffe, so ein Sommer endet nie.“
| |
Video | |
Komplexe Charakterbewegungen noch präziser steuern
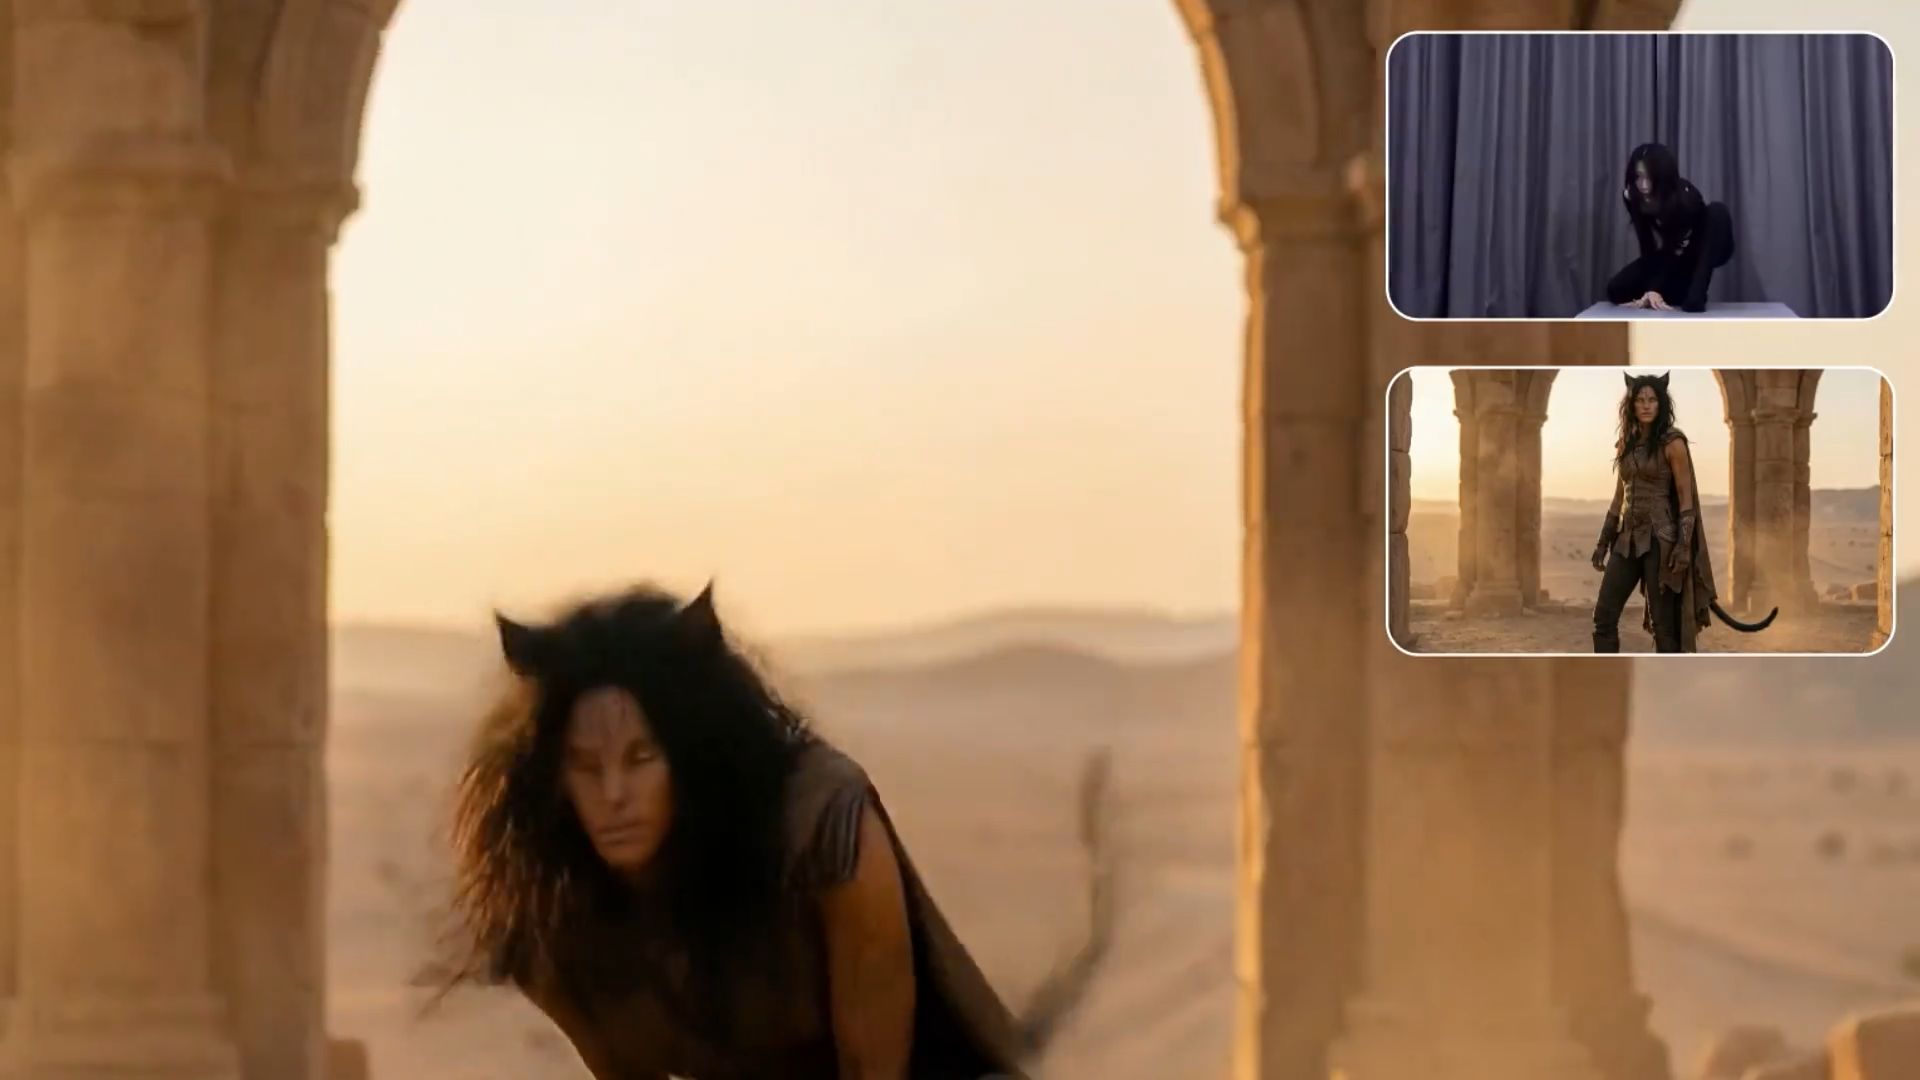
Für alltägliche Aktionen kannst du im Prompt beschreiben, was die Figur tun soll, einschließlich Tempo, Körperbewegungen und Veränderungen im Ausdruck. Klings KI-Videogenerator kann diese Anweisungen in Bewegung umsetzen, doch Text wird weniger präzise, wenn eine Einstellung eine bestimmte Drehung, Geste, Tanzbewegung oder Abfolge von Mimiken erfordert.
Für dieses Detailniveau arbeitet Motion Control stattdessen mit einer Bewegungsreferenz. Lade ein Bewegungsvideo hoch oder wähle eine Aktion aus der Bewegungsbibliothek und übertrage dann deren Bewegung und Mimik auf deine Figur. Kling VIDEO 3.0 Motion Control verbessert außerdem die Gesichtskonsistenz bei komplexen, mehrwinkligen und länger andauernden Bewegungen. Mit der gewünschten Bewegung zu beginnen, ist oft einfacher, als einen Prompt mehrfach umzuschreiben, um eine bestimmte Performance zu treffen.

Verbundene Einstellungen aufbauen und inszenieren
Eine Szene funktioniert nur selten aus einer einzigen Kameraperspektive. Vielleicht beginnst du mit einer Totale, schneidest näher heran und wechselst dann zu einer Reaktion. Mit Multi-Shot kann die Kling VIDEO 3.0 Series das Framing und die Kamerawechsel über dieselbe Sequenz hinweg planen.
Wenn Sie bereits wissen, wie die Szene aufgeteilt werden soll, ermöglicht Ihnen Custom Multi-Shot, den Inhalt und die Länge jeder Aufnahme selbst festzulegen. Dadurch wird es einfacher, das Tempo zu gestalten, ohne jede Anweisung in eine lange Eingabeaufforderung zu quetschen oder später eine Reihe nicht zusammenhängender Clips zusammenzuschneiden.
Referenzbild | |||
Charakterreferenz | |||
Prompt | |||
| Einstellung 1 (3 s): Nahaufnahme der Comedy-Open-Mic-Bühne (siehe Referenzbild), mit einem großen Retro-Neon-"KLING"-Schild im Hintergrund. Warm goldenes Gegenlicht konturiert die Szene. Die Kamera folgt der auftretenden Person, während sie zum Mikrofon geht und eine leichte Höhenanpassung vornimmt. | |||
| Einstellung 2 (4 s): Halbnahe Aufnahme von @Little Scholar, der sagt: „Ich habe tatsächlich gegen Kid verloren – wie viel Berufserfahrung hat er überhaupt? –, der allen beibrachte, wie man bei der Arbeit glücklich wird.“ | |||
| Einstellung 3 (4 s): @Little Scholar, mit einem zurückhaltenden, feinen Lächeln, legt eine natürliche Pause ein und sagt: „Hört euch das an: Er hat fünf Minuten damit verbracht, für eine so fadenscheinige Prämisse zu argumentieren.“ | |||
| Einstellung 4 (2 s): Schnitt zum laut lachenden Publikum. | |||
Video | |||
Geben Sie Kurzgeschichten mehr Raum, sich zu entfalten
Kling VIDEO 3.0 Series kann Clips von 3 bis 15 Sekunden generieren und gibt einer kurzen Szene so mehr Zeit, damit eine Figur auftreten, sprechen, reagieren oder mehrere Storybeats durchlaufen kann, ohne in eine Reihe winziger Clips aufgeteilt zu werden. In Verbindung mit Multi-Shot eignet sich diese zusätzliche Zeit hervorragend für kurze Werbespots, Dialogszenen und charakterngetriebene Momente, in denen der Rhythmus der Szene genauso wichtig ist wie die Visuals.
Sorgen Sie dafür, dass Bildschirmtext und Markentexte besser nutzbar bleiben
Text kann schnell auseinanderfallen, sobald sich eine Szene zu bewegen beginnt. Beschriftungen können sich verformen, Buchstaben können ausfallen, und Schilder oder Logos können von einem Frame zum nächsten verrutschen.
Mit Native-Level Text Output leistet die VIDEO 3.0 Series bessere Arbeit, Schilder, Untertitel, Beschriftungen und anderen Text bei wechselnden Einstellungen lesbar zu halten. Für Werbe- und Produktvideos bedeutet das, dass weniger brauchbare Aufnahmen durch verzerrte Texte oder unleserliches Branding verloren gehen. Exakte Logos und fest verankerte Marken-Assets lassen sich weiterhin am sichersten in der Postproduktion hinzufügen, wenn Präzision entscheidend ist.
Bild |
Video |
Führen Sie Dialog und Ton in denselben Workflow zusammen
Mit Native Audio kann die VIDEO 3.0 Series Szene und Dialog gleichzeitig erzeugen, einschließlich Gesprächen mit mehreren Figuren auf Chinesisch, Englisch, Japanisch, Koreanisch und Spanisch. Anstatt zuerst einen stummen Clip zu erstellen und sich anschließend um Stimmen, Timing und Lippensynchronisation zu kümmern, können Sie von Anfang an planen, wer spricht, was gesagt wird und wie die Einstellung abläuft. Das ist besonders nützlich für dialoggetriebene Kurzfilme und Szenen mit mehreren Figuren, in denen Sprache und Darstellung der Charaktere synchron bleiben müssen.
Bild |
Prompt: An einem kleinen Bahnhof, der in Morgennebel gehüllt ist, lächelte der Junge und reichte das Bento hinüber: „Ich habe es in Eile gemacht, ist das okay? Es ist das Rezept meiner Mutter.“ Das Mädchen nahm es lächelnd entgegen: „Ja, es wird bestimmt lecker! Ich melde mich über LINE, sobald ich angekommen bin.“ |
Video |
Das Ende
Egal, ob Sie eine Produktanzeige, einen dialoggetriebenen Kurzfilm oder eine Multi-Shot-Geschichte erstellen, die Einschränkungen der aktuellen KI-Videogenerierungstechnologie zeigen sich oft auf vertraute Weise: Eine Figur verändert sich zwischen den Einstellungen, Bewegungen wirken unpassend, Text zerfällt oder eine Szene benötigt mehrere Anläufe, bis sie stimmt. Klare Referenzen, eine kürzere Shot-Planung und auf die Anforderungen jeder Einstellung abgestimmte Steuerungen können unnötige Nacharbeit reduzieren. Die Kling VIDEO 3.0 Series bringt referenzbasierte Motivkonsistenz, Multi-Shot und Custom Multi-Shot, Motion Control, flexible 3–15-Sekunden-Generierung, Textausgabe auf Muttersprachenniveau und Native Audio in den Generierungs-Workflow und gibt Kreativen damit mehr Kontrolle über Figuren, Bewegung, Tempo, Dialog und visuelles Storytelling.
FAQs
Was sind die wichtigsten Einschränkungen der KI-Videogenerierungstechnologie im Jahr 2026?
Aktuelle KI-Videomodelle können an Konsistenz verlieren, wenn eine Szene komplexer wird. Ein Gesicht kann zwischen den Einstellungen verrutschen, Bewegungen können leicht falsch wirken, Text kann verzerrt werden, und längere Sequenzen sind schwerer kohärent zu halten. Ausführliche Prompts führen ebenfalls nicht immer zu exakten Ergebnissen, daher verlassen sich Erstellerinnen und Ersteller häufig auf Referenzbilder, kürzere Einstellungen und ein paar Runden Feinschliff, um das Material dorthin zu bringen, wo es sein muss.
Können KI-Videogeneratoren lange Videos erstellen?
KI-Videogeneratoren können längere Clips und Sequenzen mit mehreren Einstellungen erzeugen, doch je länger das Video wird, desto schwieriger lässt sich die Konsistenz aufrechterhalten. Benchmarks wie DirectorBench und MSVBench konzentrieren sich ebenfalls auf Probleme wie Übergänge zwischen Einstellungen, Konsistenz über Einstellungen hinweg und die Kontinuität der Handlung. Bei längeren Projekten ist es in der Regel einfacher, Einstellung für Einstellung zu arbeiten, dieselben Referenzen erneut zu verwenden und zu prüfen, wie jede Szene zusammenhängt, bevor man fortfährt.
Warum sehen KI-generierte Videos inkonsistent aus?
KI-generierte Videos können uneinheitlich wirken, weil das Modell Gesichter, Objekte, Texturen und andere Szenendetails von Bild zu Bild stabil halten muss. Wenn sich die Kamera bewegt oder etwas hinter einem anderen Objekt verschwindet und wieder ins Sichtfeld zurückkehrt, können sich diese Details verändern. Das Verwenden desselben Referenzbilds, das Beginnen mit einer einfacheren Aktion und das Ändern jeweils nur eines Teils des Prompts kann das Ergebnis leichter kontrollierbar machen. Wenn ein Gesicht, ein Produkt oder ein Requisit genau übereinstimmen muss, sollten Sie den Clip Bild für Bild prüfen.
Können KI-Videogeneratoren realistische Physik erzeugen?
KI-Videos können Bewegungen überzeugend erscheinen lassen, aber das bedeutet nicht immer, dass die Physik stimmt. T2VPhysBench hat Videomodelle anhand von 12 grundlegenden physikalischen Gesetzen getestet und wiederkehrende Probleme mit Gravitation, Erhaltung und anderen physikalischen Wechselwirkungen festgestellt. Wenn ein Video zeigen muss, wie ein Produkt funktioniert, einen wissenschaftlichen Prozess abbildet oder eine klare Ursache-Wirkungs-Aktion vermittelt, sollte das Ergebnis mit realem Filmmaterial verglichen und die Bewegung genau geprüft werden.
Was sind die wichtigsten Technologietrends für KI-generierte Videos im Jahr 2026?
Die Trends bei KI-generierter Videotechnologie im Jahr 2026 umfassen mehr Möglichkeiten, ein Video zu starten, eine Performance zu dirigieren und Sprache innerhalb desselben Projekts zu verarbeiten. Ein Creator könnte mit einem KI-Videogenerator oder Image-to-Video-KI, Bewegungssteuerung für eine bestimmte Bewegung verwenden und anschließend gesprochene Dialoge mit Lippensynchronität oder Dubbing-Tools. KI-Avatare, nativer Ton und Videobearbeitungstools werden ebenfalls zu einem größeren Bestandteil der Produktion von Kurzvideos, Anzeigen und lokalisierten Inhalten.