物語とショットを何時間も計画したのに、シーンごとにキャラクターの顔が変わったり重要なアクションが消えたりした経験はありませんか?AI動画はアイデアを形にできますが、繰り返しの修正で節約するはずの時間が奪われることもあります。ここでは、現行のAI動画生成技術が抱える6つの制約と実用的な回避策、そしてKling VIDEO 3.0 シリーズ が役立つ場面を整理して紹介します。
現在のAI動画生成技術の制約とは?
AI動画はより複雑なシーンを扱えるようになりましたが、一貫性、モーション、テキスト、精密な制御は生成の過程で破綻することがあります。フレーム間の視覚的一貫性の維持から動きとディテールの制御まで、これらの制約がクリエイターのAI動画制作の活用方法を左右し続けています。
以下の表は、現行のAI動画生成がどこで未だ力不足なのか、それらの問題が実際のプロジェクトでどのように現れるのか、そしてそれを回避するために何ができるのかを示しています。
制約 | 技術的課題 | 何が起こるのか | 簡単な回避策 |
時間的一貫性とフレーム整合性の制限 | 被写体やカメラが動いている間も、モデルは連続するフレーム間で照明、レイアウト、テクスチャなどの視覚情報を維持しなければならない。 | 撮影中に照明が変化したり、背景物がずれたり、小道具が消えたり、テクスチャや身体の輪郭がちらつくことがある。 | 各ショットは主要なアクション1つに集中させる。より複雑なシーンでは、設定と構図を維持するために短いクリップと参照画像を使用する。 |
ショット間におけるキャラクターとオブジェクトの一貫性 | 個別に生成されたショットは、毎回同じ被写体のアイデンティティ、外観、デザインの詳細を再現する必要があります。 | ショットごとに、顔、ヘアスタイル、衣装、アクセサリー、製品の形状、色、または表面のディテールが変わってしまう場合があります。 | 同じ参照画像を再利用し、特徴となるディテールを一貫させましょう。照明、カメラアングル、スタイリング、環境を一度に変えないようにしてください。 |
非現実的な物理と動き | モデルは、時間を通じて身体の動き、物体との接触、空間的な関係、素材の挙動をもっともらしく保つ必要があります。 | 手が物体をすり抜けてしまったり、動きに重さが感じられなかったり、衝突が不自然に見えたり、布や水、髪、あるいは高速なカメラワークが不自然な挙動を示すことがあります。 | 複雑な動きは個々のビートに分解しましょう。被写体の動きとカメラの動きは1つの指示にまとめず、それぞれ別々に記述してください。 |
限定された長尺動画生成 | 長尺のシーケンスでは、多くのショットにわたってキャラクター、ロケーション、小道具、ビジュアルスタイル、タイミング、そしてストーリーの整合性を維持する必要があります。 | 映像が長くなるにつれて、キャラクターやロケーションがずれたり、小道具が消えたり、コンティニュイティの破綻が目立ったり、シーン同士のつながりが希薄に感じられることがあります。 | ストーリーボードやショットリストを基に作業し、ビジュアルリファレンスを再利用しながら、プロジェクトをシーンごとに生成しましょう。テンポ、トランジション、最終的なシーケンスは編集で整えてください。 |
微細なディテールとテキスト生成の難しさ | 小さな形状、タイポグラフィ、ロゴ、製品の細部は、フレームごとに正確な空間的一貫性が求められます。 | 指が歪んだり、テキストが誤字や変形を起こしたり、ロゴがずれたり、動きの中で細かな製品の特徴が変化することがあります。 | テキスト、ロゴ、キャプションなどの固定されたブランド要素は、ポストプロダクションで追加しましょう。製品ショットでは、明確な参照資料を用い、フレーミングを比較的シンプルに保ってください。 |
プロンプトによる制御とカスタマイズの制限 | プロンプトに基づく制御は間接的であるため、1つの指示を変更すると生成されたショットの他の部分にも影響が及ぶ可能性があります。 | モデルは、一部の指示には忠実に従いつつも、あなたが求めていない形でフレーミングや背景、タイミング、被写体の見た目を変更してしまうことがあります。 | まず被写体と全体的なルックを設定し、その後に動き、フレーミング、タイミングを小さなステップで細かく調整しましょう。すべての要件を1つの長いプロンプトに詰め込むのではなく、短いバリエーションを複数生成してください。 |
Kling がどのようにAI Video Generatorがこれらの制約に対処するか
Kling AI Video Generator は、AI ビデオ生成におけるクリエイティブ面と制作面の制御を強化し、連続したショットや繰り返し登場する被写体、会話、より複雑なビジュアルストーリーテリングを作りやすくします。VIDEO 3.0 と VIDEO 3.0 Omni 全体で、クリエイターは参照に基づく被写体の一貫性、Multi-Shot と Custom Multi-Shot、Motion Control、柔軟な3~15秒生成、ネイティブレベルのテキスト出力、ネイティブオーディオを用いて、プロフェッショナルなシネマティック動画制作を支援できます。
ショット間でキャラクターと製品の一貫性を保つ
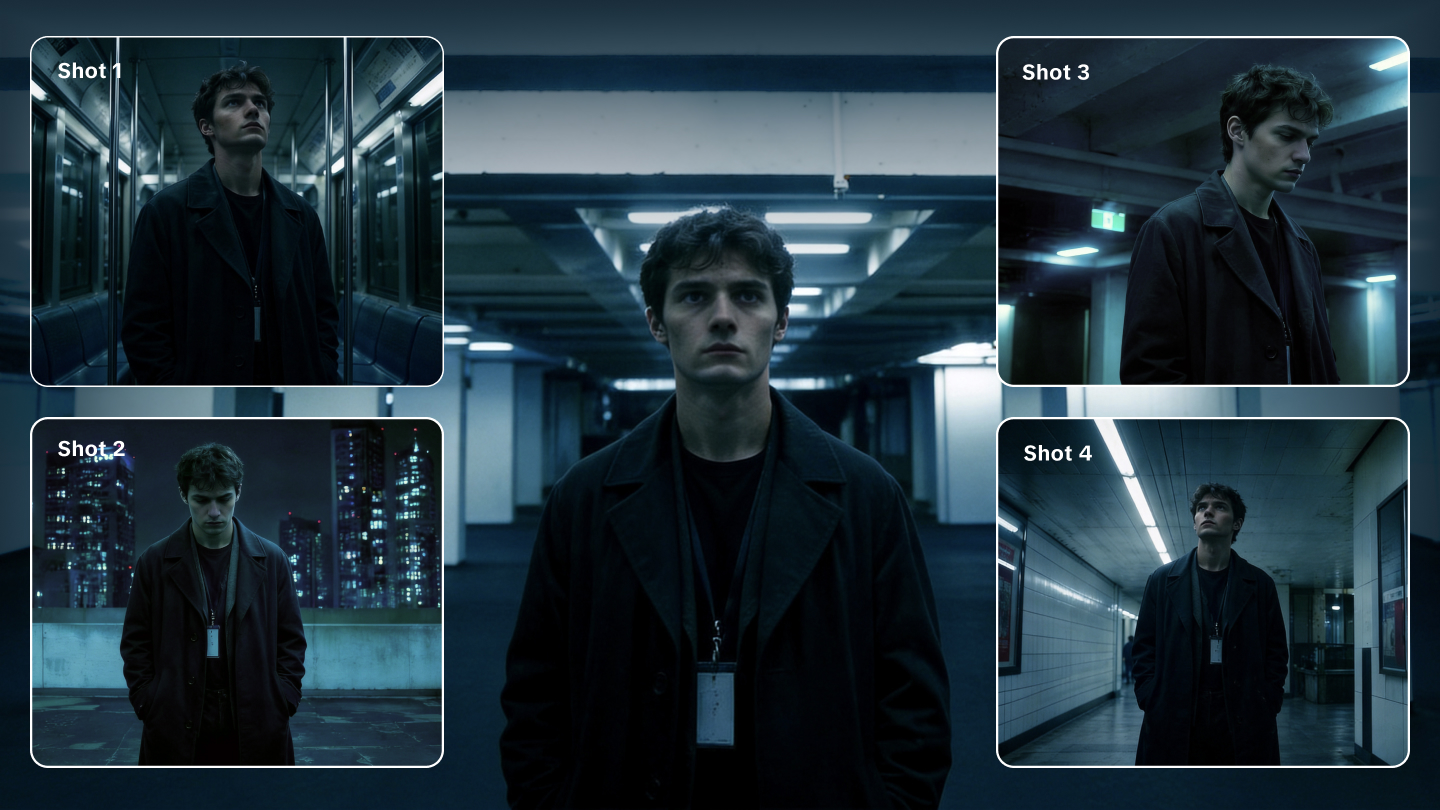
同じ人物や製品、重要な小道具が複数のショットに登場する場合、各ショットが新しい説明文から生成されると、その決定的な特徴を認識できるように保つことは難しくなります。Kling VIDEO 3.0 シリーズはリファレンスベースのワークフローを提供し、モデルに繰り返し登場する被写体に関する視覚情報をさらに与え、ショット間の望ましくない変化を減らすのに役立ちます。
Kling VIDEO 3.0, 同じキャラクターや製品、オブジェクトの異なる視点を提示するために複数のリファレンス画像を使用できます。キャラクターの場合、正面や側面などの有用なアングルが顔の構造、ヘアスタイル、衣服、識別できる特徴についてモデルにより多くの情報を与えます。製品や重要な小道具では、追加の視点によって、形状やプロポーション、素材、側面のディテール、表面の特徴など、1枚の正面画像では見逃す可能性のあるディテールを捉えられます。
異なるショットやシーンをまたいで再利用可能な被写体が必要なプロジェクト向けに、Kling VIDEO 3.0 Omni は Element Reference ワークフローを提供します。複数角度の画像や短いキャラクタービデオから Element を構築し、シーンやカメラアングル、周囲のコンテンツが変化してもその Element を再び参照できます。Character Element には音声情報も含めることができ、繰り返し登場するキャラクターが関連シーン全体で識別可能な視覚的特徴と一貫した声を維持するのに役立ちます。
どちらのワークフローでも、より強力な参照情報によって、顔の変化、アクセサリーの消失、製品が意図したデザインから逸脱することで引き起こされる再生成を減らすことができます。
Kling VIDEO 3.0 使用例
開始フレーム | ||
画像リファレンス | ||
| プロンプト: カメラは徐々に少女の前へ回り込み、彼女は顔を上げてカメラに向かって温かく微笑み、まるで何年も会っていなかった旧友に再会したかのように。 | ||
動画 | ||
Kling VIDEO 3.0 Omni 使用例
要素/参照画像 | |
@Shirt Boy | @Image1 |
ミディアムショット、正面 プロンプト: @Shirt Boyが@imageで坂を下り、柱のそばに腰を下ろす。クローズアップ、顔: @Shirt Boyが柱にもたれかかり、「今日の風は昨日より柔らかい…草まで優しく感じる」と言う。シネマティックなルック @image1。横からの顔のクローズアップ: @Shirt Boyが目を閉じ、柔らかな日差しが顔に降り注ぐ。トップダウンショット: @Shirt Boyが仰向けになり、草がシャツを覆い、腕を頭の後ろに組んで青空を見上げながら、「こんな夏がいつまでも終わらなければいいのに」と言う。
| |
動画 | |
複雑なキャラクターの動きをより正確に指示
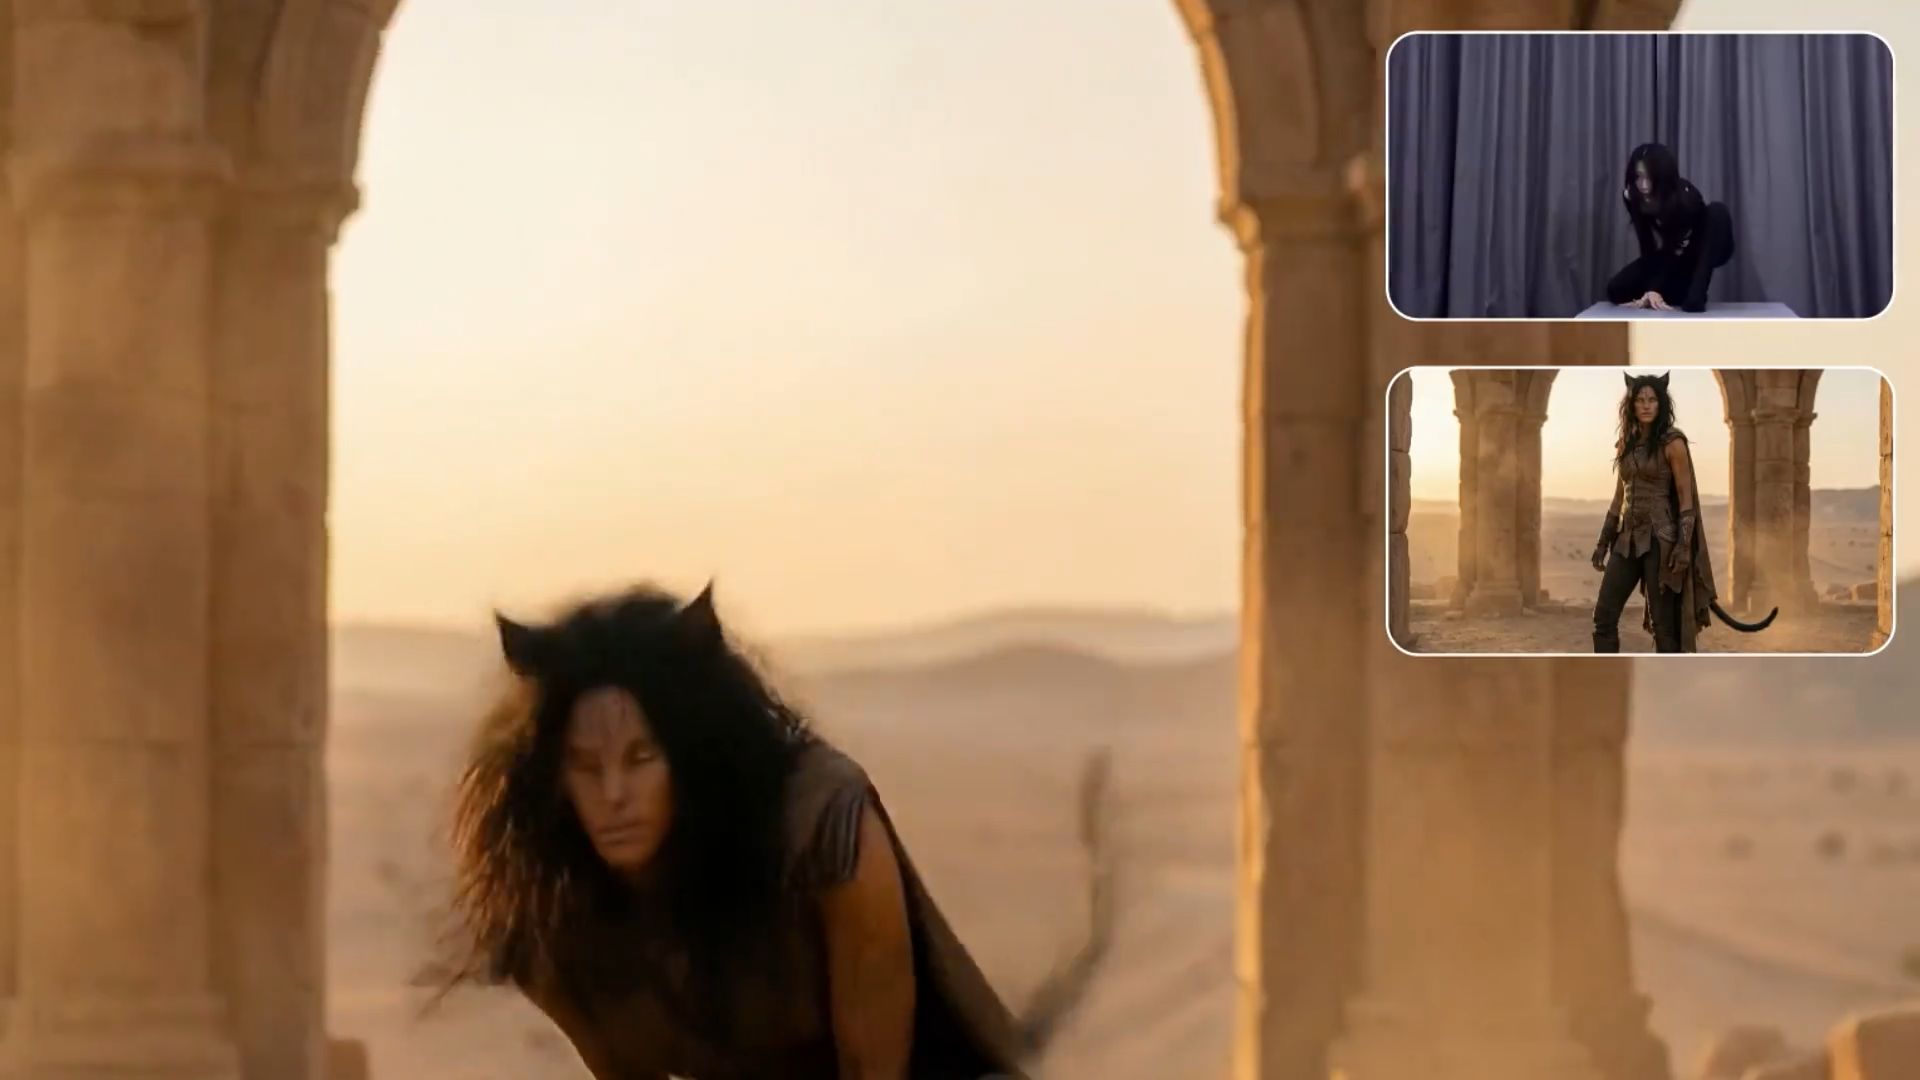
日常的な動きであれば、プロンプトの中でキャラクターにさせたいことを、歩調や体の動き、表情の変化まで含めて記述できます。KlingのAIビデオジェネレーター はその指示を動きに変換できますが、特定の方向転換やジェスチャー、ダンスの動き、表情の連続などが必要なショットになると、テキストだけでは精度が下がってしまいます。
そのレベルのディテールには、Motion Control が動きのリファレンスから動作します。モーション動画をアップロードするか、モーションライブラリからアクションを選択し、その動きや表情をキャラクターに適用します。Kling VIDEO 3.0 Motion Control は、複雑で多角度、さらに長時間の動きにわたっても表情の一貫性を高めます。求めるモーションから始める方が、特定の演技を得るためにプロンプトを何度も書き直すよりもしばしば簡単です。

ショットをつなげて構築・演出する
シーンが単一のカメラアングルだけで成立することはほとんどありません。ワイドショットで始め、寄りのショットに切り替え、さらにリアクションへ移ることもあるでしょう。Multi-Shot を使えば、Kling VIDEO 3.0 Series は同じシーケンス内でフレーミングやカメラの切り替えを計画できます。
シーンをどのように分割するかすでに把握している場合は、Custom Multi-Shotを使って各ショットの内容と長さを自分で設定できます。これにより、あらゆる指示をひとつの長いプロンプトに詰め込んだり、後で関連性のないクリップをつぎはぎすることなく、ペースを整えやすくなります。
参考画像 | |||
キャラクター参照 | |||
プロンプト | |||
| ショット1(3秒): コメディのオープンマイクステージ(参考画像を参照)をクローズアップで捉え、背景には大型のレトロなネオンの"KLING"看板がある。暖かな黄金色のバックライトがシーンを縁取り、カメラは出演者がマイクへ歩み寄り、わずかに高さを調整する様子を追う。 | |||
| ショット2(4秒): @Little Scholarのミディアムクローズアップで、「実はKidに負けたんです――彼、仕事の経験ってどれくらいあるんですか?――職場でどうやって幸せになるかをみんなに教えていたんですよ」と言う。 | |||
| ショット3(4秒): 控えめな穏やかな笑みを浮かべた@Little Scholarが自然に間を取り、「これ、聞いてください。彼はそんな馬鹿げた前提について5分も議論したんです」と語る。 | |||
| ショット4(2秒): 観客が大きく笑う様子に切り替える。 | |||
ビデオ | |||
短編ストーリーが展開する余地を広げる
Kling VIDEO 3.0シリーズは3~15秒のクリップを生成でき、短いシーンに登場人物が登場して話し、反応し、複数のストーリービートを通して動くための時間をより多く与えます。Multi-Shotと組み合わせると、その余裕は短い広告、対話シーン、視覚と同じくらいシーンのリズムが重要なキャラクター主導の瞬間に最適です。
画面上のテキストとブランドコピーをより使いやすく保つ
シーンが動き始めると、テキストはすぐに崩れることがあります。ラベルは歪み、文字が抜け落ち、看板やロゴがフレームごとにずれてしまうことがあります。
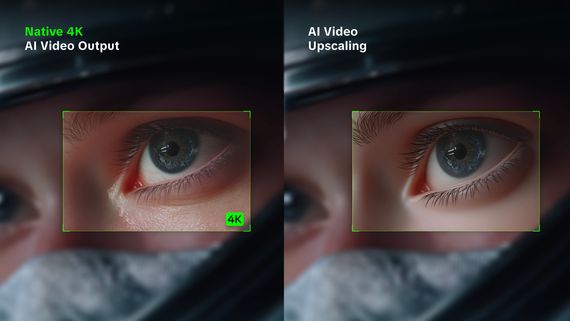
ネイティブレベルのテキスト出力により、VIDEO 3.0シリーズはショットが変化しても看板、キャプション、ラベルなどのテキストの可読性をより良く保ちます。広告や製品動画では、歪んだコピーや読めないブランディングによって使えなくなるショットが少なくなることを意味します。厳密なロゴや固定されたブランドアセットは、正確さが求められる場合には依然としてポストプロダクションで追加する方が安全です。
画像 |
動画 |
会話とサウンドを同じワークフローに統合する
Native Audio を使えば、VIDEO 3.0 シリーズは中国語、英語、日本語、韓国語、スペイン語での複数キャラクターの会話を含むシーンと台詞を同時に生成できます。まず無音のクリップを作ってから音声やタイミング、リップシンク を処理するのではなく、最初から誰が話し、何を話し、ショットがどのように進行するかを計画できます。これは、会話主体の短編や複数キャラクターのシーンで、セリフとキャラクターの演技を同期させる必要がある場合に特に有効です。
画像 |
プロンプト: On a small station shrouded in morning mist, the boy smiled and handed over the bento: 「急いで作ったけど、大丈夫? お母さんのレシピだよ。」 The girl took it with a smile: 「うん、きっと美味しい! 到着したら LINE するね。」 |
動画 |
終わり
製品広告、対話主体の短編、マルチショットのストーリーのいずれを制作するとしても、現在のAI動画生成技術の制約はおなじみの形で現れることが多い。ショット間でキャラクターが変わってしまう、動きに違和感がある、テキストが崩れる、あるいはシーンを正しく仕上げるまでに何度も試行する必要があるといった具合だ。明確なリファレンス、より短いショット設計、各ショットのニーズに合わせたコントロールを用いれば、不要な手戻りを減らせる。Kling VIDEO 3.0シリーズは、リファレンスを基盤とした被写体の一貫性、Multi-ShotとCustom Multi-Shot、Motion Control、柔軟な3~15秒の生成、ネイティブレベルのテキスト出力、ネイティブ音声をワークフローに組み込み、クリエイターがキャラクター、動き、テンポ、対話、ビジュアルストーリーテリングをより自在に操れるようにする。
よくある質問
2026年におけるAI動画生成技術の主な制約は何ですか?
現在のAI動画モデルは、シーンが複雑になるにつれて一貫性を失うことがあります。ショット間で顔がずれたり、動きがわずかに不自然に見えたり、テキストが歪んだり、長尺のシーケンスは整合性を保つのがさらに難しくなります。詳細なプロンプトも必ずしも正確な結果に結び付くわけではないため、クリエイターは参照画像や短いショット、数回のリファインを頼りに、必要な映像に仕上げることがよくあります。
AI動画ジェネレーターで長尺動画は作れる?
AI動画ジェネレーターは長めのクリップや複数ショットのシーケンスを生成できますが、動画が長くなるほど一貫性を保つのは難しくなります。DirectorBench やMSVBench といったベンチマークも、ショット遷移やショット間の整合性、ストーリーの連続性といった課題に焦点を当てています。長尺のプロジェクトでは、通常はショットごとに作業し、同じ参照画像を再利用し、次に進む前に各シーンのつながりを確認する方が容易です。
AI生成動画はなぜ一貫性が欠けて見えるのか?
AI生成の動画は、モデルが顔や物体、質感などのシーンの詳細をフレームごとに安定させ続けなければならないため、一貫性に欠けて見えることがあります。カメラが動いたり、何かが別の物体の背後に隠れて再び現れたりすると、そのようなディテールがずれる場合があります。同じ参照画像を使い、より単純なアクションから始め、プロンプトの一部を一度に一つずつ変えることで、結果を制御しやすくなります。顔や商品、小道具などを正確に合わせる必要がある場合は、クリップをフレームごとに確認してください。
AI動画生成ツールはリアルな物理挙動を作り出せるか?
AI動画は動きをもっともらしく見せられるが、それが常に物理的に正しいとは限らない。T2VPhysBench はビデオモデルを12の基本的な物理法則で検証し、重力、保存則、その他の物理的相互作用に繰り返し発生する問題を発見した。製品の動作、科学的プロセス、明確な因果関係を示す必要がある動画の場合は、実際の映像と結果を比較し、動きを綿密に確認しよう。
2026年のAI生成動画技術の主要トレンドとは?
2026年のAI生成動画技術のトレンドには、動画の開始方法、パフォーマンスの演出、同じプロジェクト内でのスピーチの処理に関するより多くの手段が含まれる。クリエイターはAIビデオジェネレーターまたは image to video AI、特定の動きのためにモーションコントロールを使用し、その後、リップシンクを伴う話し言葉のセリフや吹き替えツールを追加できる。AIアバター、ネイティブ音声、動画編集ツールも、ショートフォーム動画、広告、ローカライズされたコンテンツの制作方法においてより大きな役割を果たしつつある。