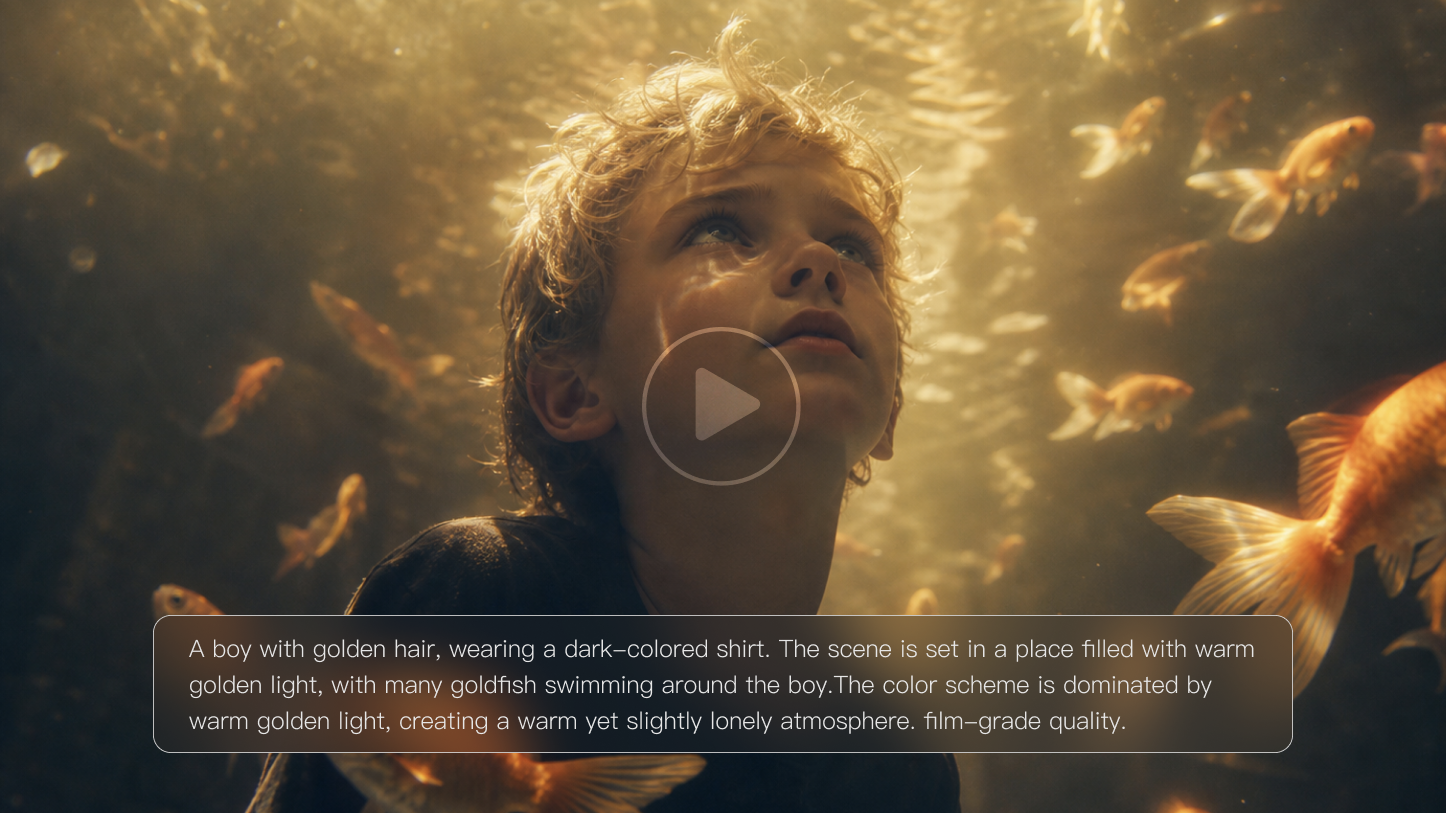
Czy zdarzyło Ci się spędzić godziny na planowaniu historii i ujęć, tylko po to, by zobaczyć, jak twarz bohatera zmienia się między scenami albo znika kluczowe działanie? Wideo generowane przez AI może ożywić Twoje pomysły, lecz powtarzające się poprawki potrafią pochłonąć czas, który chciałeś zaoszczędzić. Przedstawimy sześć ograniczeń obecnej technologii generowania wideo przez AI, praktyczne obejścia oraz miejsca, w których Kling VIDEO 3.0 series może pomóc.
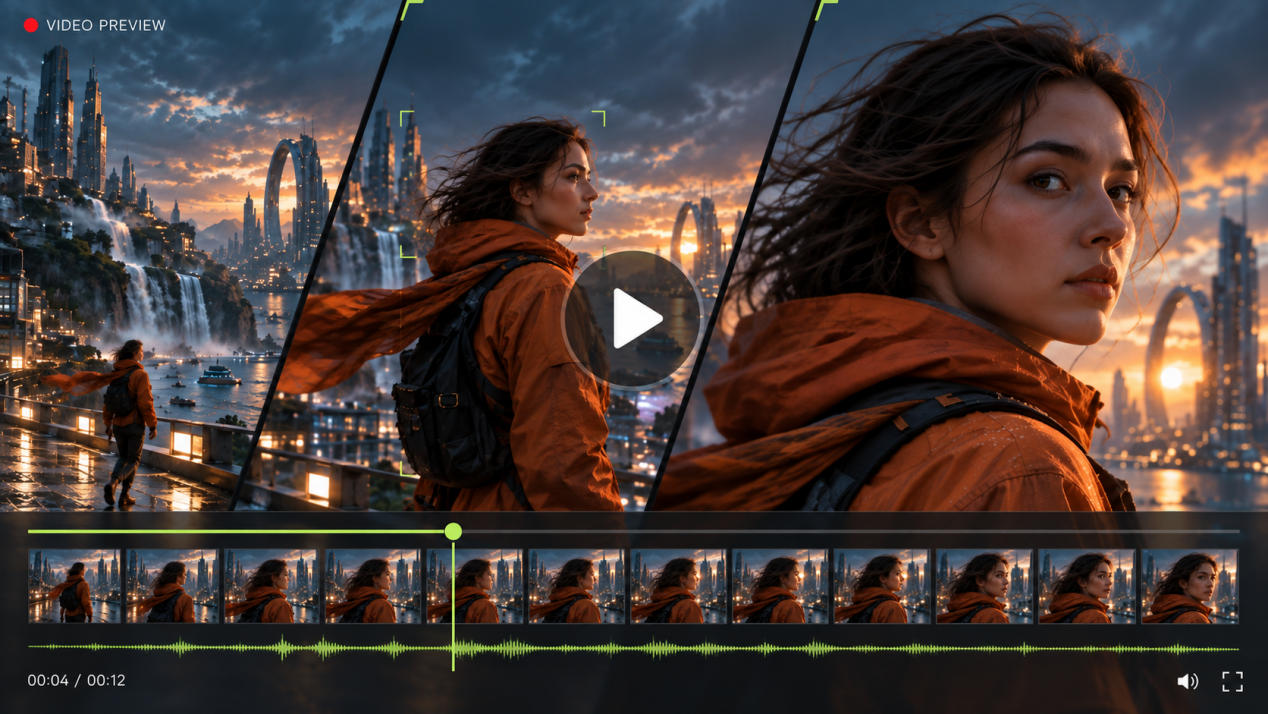
Jakie są ograniczenia obecnej technologii generowania wideo przez AI?
Wideo AI potrafi już obsługiwać bardziej złożone sceny, ale spójność, ruch, tekst i precyzyjna kontrola wciąż mogą się załamywać podczas generowania. Od utrzymywania spójności wizualnej między klatkami po kontrolowanie ruchu i detali te ograniczenia nadal kształtują sposób, w jaki twórcy korzystają z AI w produkcji wideo.
Poniższa tabela pokazuje, gdzie obecne generowanie wideo przez AI nadal zawodzi, jak te problemy objawiają się w realnych projektach oraz co możesz zrobić, aby je obejść.
Ograniczenie | Wyzwanie techniczne | Co się dzieje | Szybkie obejście |
Ograniczona spójność czasowa i koherencja klatek | Model musi zachować oświetlenie, układ, tekstury i inne informacje wizualne w kolejnych klatkach, gdy obiekty i kamery są w ruchu. | Oświetlenie może się zmieniać, obiekty w tle mogą dryfować, drobne rekwizyty mogą znikać, a tekstury lub kontury ciała mogą migotać podczas ujęcia. | Zachowuj w każdym ujęciu jedną główną akcję w centrum. W przypadku bardziej złożonych scen używaj krótszych klipów i obrazu referencyjnego, aby utrzymać scenerię i kompozycję. |
Spójność postaci i obiektów między ujęciami | Oddzielnie generowane ujęcia muszą za każdym razem odtworzyć tę samą tożsamość obiektu, wygląd i szczegóły projektu. | Twarze, fryzury, ubrania, akcesoria, kształty produktów, kolory lub detale powierzchni mogą zmieniać się z jednego ujęcia na kolejne. | Używaj ponownie tych samych obrazów referencyjnych i utrzymuj kluczowe szczegóły w spójności. Unikaj jednoczesnej zmiany oświetlenia, kąta kamery, stylizacji i otoczenia. |
Nierealistyczna fizyka i ruch | Model musi zachować wiarygodną mechanikę ciała, kontakt z obiektami, relacje przestrzenne i zachowanie materiałów w czasie. | Dłonie mogą przenikać przez obiekty, ruch może wydawać się pozbawiony ciężaru, kolizje mogą wyglądać nieprawidłowo, a tkanina, woda, włosy lub szybkie ruchy kamery mogą zachowywać się nienaturalnie. | Podziel skomplikowane działania na osobne etapy. Opisuj ruch obiektu i ruch kamery oddzielnie, zamiast łączyć je w jednej instrukcji. |
Ograniczona generacja długich form wideo | Dłuższa sekwencja musi zachować postacie, lokacje, rekwizyty, styl wizualny, czasowanie i logikę fabuły w wielu ujęciach. | Postacie lub lokacje mogą dryfować, rekwizyty mogą znikać, przerwy w ciągłości stają się bardziej zauważalne, a sceny mogą wydawać się oderwane, gdy wideo się wydłuża. | Pracuj na storyboardzie lub liście ujęć, ponownie wykorzystuj odniesienia wizualne i generuj projekt scena po scenie. Zadbaj o tempo, przejścia i ostateczną sekwencję na etapie montażu. |
Trudności z drobnymi detalami i generowaniem tekstu | Małe kształty, typografia, logotypy i detale produktów wymagają dokładnej spójności przestrzennej z klatki na klatkę. | Palce mogą się deformować, tekst może być zapisany z błędami lub zniekształcony, logotypy mogą się przesuwać, a drobne cechy produktu mogą się zmieniać podczas ruchu. | Dodaj tekst, logotypy, napisy i inne stałe elementy marki na etapie postprodukcji. W przypadku ujęć produktowych korzystaj z wyraźnego materiału referencyjnego i zachowaj stosunkowo prostą kompozycję kadru. |
Ograniczona kontrola nad promptami i personalizacją | Kontrola oparta na promptach jest pośrednia, więc zmiana jednej instrukcji może również wpłynąć na inne elementy wygenerowanego ujęcia. | Model może ściśle przestrzegać części wskazówek, jednocześnie zmieniając kadr, tło, timing lub wygląd obiektu w sposób, którego nie oczekiwałeś. | Najpierw ustal temat i ogólny wygląd, a następnie dopracuj ruch, kadr i timing mniejszymi krokami. Generuj kilka krótkich wariantów zamiast umieszczać wszystkie wymagania w jednym długim poleceniu. |
Jak Kling AI Video Generator pomaga przezwyciężać te ograniczenia
Kling AI Video Generator udostępnia więcej kontroli kreatywnej i produkcyjnej w generowaniu wideo przez AI, ułatwiając tworzenie powiązanych ujęć, powracających bohaterów, dialogu oraz bardziej złożonej narracji wizualnej. W ramach VIDEO 3.0 i VIDEO 3.0 Omni twórcy mogą korzystać ze spójności bohaterów opartej na referencjach, Multi-Shot i Custom Multi-Shot, Motion Control, elastycznego generowania w zakresie 3–15 sekund, Native-Level Text Output oraz Native Audio, aby wspierać profesjonalną filmową produkcję wideo.
Zachowuj spójność postaci i produktów w kolejnych ujęciach
Gdy ta sama osoba, produkt lub ważny rekwizyt pojawia się w kilku ujęciach, zachowanie rozpoznawalnych cech charakterystycznych może być trudne, jeśli każde ujęcie jest generowane na podstawie nowego opisu. Seria Kling VIDEO 3.0 zapewnia przepływy pracy oparte na materiałach referencyjnych, które dostarczają modelowi więcej informacji wizualnych o powracających obiektach i pomagają ograniczyć niepożądane zmiany między ujęciami.
Za pomocą Kling VIDEO 3.0, możesz użyć wielu obrazów referencyjnych, aby dostarczyć różne ujęcia tej samej postaci, produktu lub obiektu. W przypadku postaci ujęcia z przodu, z boku i pod innymi przydatnymi kątami mogą przekazać modelowi więcej informacji o strukturze twarzy, fryzurze, ubraniu i rozpoznawalnych cechach. W przypadku produktów lub ważnych rekwizytów dodatkowe ujęcia mogą uchwycić szczegóły, których pojedynczy obraz z przodu może nie pokazać, takie jak kształt, proporcje, materiały, detale boczne czy cechy powierzchni.
W projektach, które potrzebują wielokrotnego wykorzystania bohatera w różnych ujęciach i scenach, Kling VIDEO 3.0 Omni udostępnia przepływ pracy Element Reference. Możesz zbudować Element z obrazów pod wieloma kątami lub krótkiego wideo postaci, a następnie ponownie odwoływać się do tego Elementu, gdy zmienia się scena, kąt kamery lub otaczająca treść. Elementy postaci mogą również zawierać informacje głosowe, pomagając powracającej postaci zachować zarówno rozpoznawalne cechy wizualne, jak i spójny głos w powiązanych scenach.
W obu przepływach pracy bardziej szczegółowe informacje referencyjne mogą zmniejszyć liczbę powtórek spowodowanych zmianą twarzy, zniknięciem akcesorium lub oddaleniem się produktu od zamierzonego projektu.
Przykłady użycia Kling VIDEO 3.0
Klatka początkowa | ||
Odniesienie do obrazu | ||
| Polecenie: Kamera stopniowo obchodzi dziewczynę i ustawia się przed nią, po czym dziewczyna unosi głowę i ciepło uśmiecha się do kamery, jakby po wielu latach zobaczyła starego przyjaciela. | ||
Wideo | ||
Przykłady użycia Kling VIDEO 3.0 Omni
Element/obraz referencyjny | |
@Shirt Boy | @Image1 |
Ujęcie średnie, widok z przodu Polecenie: @Shirt Boy schodzi po zboczu i siada przy słupie na @image. Zbliżenie, twarz: @Shirt Boy opiera się o słup i mówi: „Dzisiejszy wiatr wydaje się łagodniejszy niż wczoraj… nawet trawa jest delikatna.” Filmowe ujęcie @image1. Boczne zbliżenie, twarz: @Shirt Boy zamyka oczy, gdy miękkie światło słoneczne pada na jego twarz. Ujęcie z góry: @Shirt Boy odchyla się do tyłu, trawa okrywa jego koszulę, ręce założone za głowę, spogląda na błękitne niebo, mówiąc: „Mam nadzieję, że takie lato nigdy się nie skończy.”
| |
Wideo | |
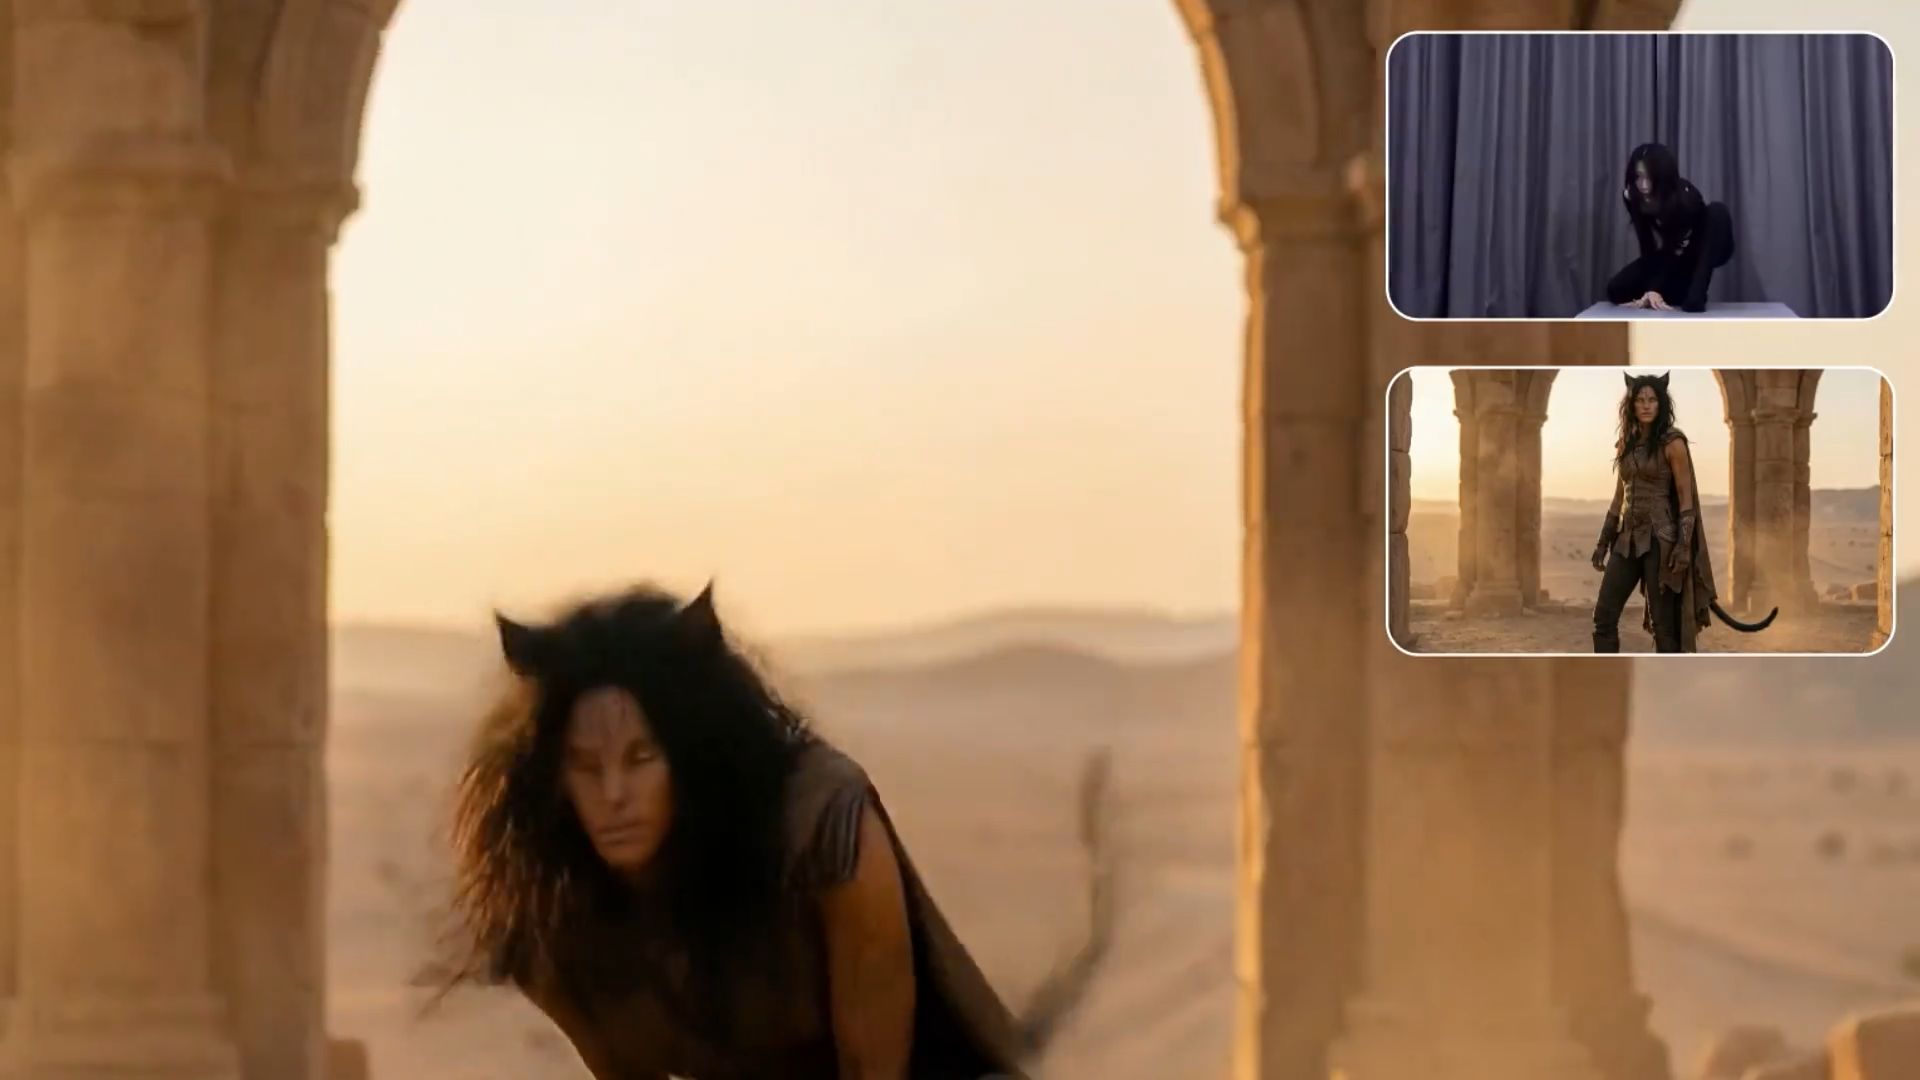
Steruj złożonym ruchem postaci z większą precyzją
Dla codziennych czynności możesz w poleceniu opisać, co postać powinna zrobić, uwzględniając tempo, ruchy ciała i zmiany w mimice. Generator wideo AI firmy Kling może zamienić te wskazówki w ruch, ale tekst staje się mniej precyzyjny, gdy ujęcie wymaga konkretnego obrotu, gestu, ruchu tanecznego lub sekwencji wyrazów twarzy.
Dla takiego poziomu szczegółowości Sterowanie ruchem działa na podstawie referencji ruchu. Prześlij wideo z ruchem lub wybierz akcję z biblioteki ruchów, a następnie zastosuj jej ruchy i ekspresję do swojej postaci. Kling VIDEO 3.0 Motion Control dodatkowo poprawia spójność mimiki przy złożonych, wielokątnych i dłuższych ruchach. Rozpoczęcie od pożądanego ruchu jest często łatwiejsze niż wielokrotne przeredagowywanie promptu, aby uzyskać konkretny występ.

Buduj i reżyseruj powiązane ujęcia
Scena rzadko działa z jednego kąta kamery. Możesz zacząć od szerokiego ujęcia, przejść bliżej, a następnie zmienić na reakcję. Dzięki Multi-Shot seria Kling VIDEO 3.0 może planować kadrowanie i zmiany ujęcia w ramach tej samej sekwencji.
Jeśli już wiesz, jak scena powinna zostać podzielona, Custom Multi-Shot pozwala ci samodzielnie określić zawartość i długość każdego ujęcia. To ułatwia kształtowanie tempa bez upychania wszystkich instrukcji w jednym długim prompcie lub późniejszego zszywania serii niepowiązanych klipów.
Obraz referencyjny | |||
Referencja postaci | |||
Polecenie | |||
| Ujęcie 1 (3 s): Zbliżenie na scenę komediowego open micu (zobacz obraz referencyjny), z dużym retro neonowym napisem "KLING" w tle. Ciepłe, złote światło tylne obrysowuje scenę. Kamera podąża za wykonawcą, gdy podchodzi do mikrofonu i dokonuje drobnej regulacji wysokości. | |||
| Ujęcie 2 (4 s): Średnie zbliżenie na @Little Scholar, który mówi: "Właściwie przegrałem z Kidem—ile on w ogóle ma doświadczenia zawodowego?—który uczył wszystkich, jak być szczęśliwym w pracy." | |||
| Ujęcie 3 (4 s): @Little Scholar, z powściągliwym, subtelnym uśmiechem, robi naturalną pauzę i mówi: "Po prostu posłuchajcie: spędził pięć minut, broniąc tak naciąganej tezy." | |||
| Ujęcie 4 (2s): Przejście do publiczności głośno się śmiejącej. | |||
Wideo | |||
Daj krótkim historiom więcej przestrzeni na rozwój
Seria Kling VIDEO 3.0 może generować klipy trwające od 3 do 15 sekund, dając krótkiej scenie więcej czasu na to, by postać weszła, mówiła, reagowała lub przeszła przez kilka etapów fabuły bez dzielenia jej na serię drobnych ujęć. W połączeniu z Multi-Shot ten dodatkowy czas dobrze sprawdza się w krótkich reklamach, scenach dialogowych oraz momentach skupionych na postaciach, w których rytm sceny jest równie ważny jak oprawa wizualna.
Zadbaj, aby tekst na ekranie i treści marki były bardziej użyteczne
Tekst może szybko się rozsypać, gdy scena zaczyna się poruszać. Etykiety mogą się zniekształcać, litery wypadać, a znaki lub logotypy przesuwać się z jednej klatki do następnej.
Dzięki funkcji Native-Level Text Output, VIDEO 3.0 Series skuteczniej utrzymuje znaki, napisy, etykiety i inny tekst czytelny w miarę zmiany ujęcia. W przypadku reklam i filmów produktowych oznacza to mniej użytecznych ujęć utraconych z powodu zdeformowanej treści lub nieczytelnego brandingu. Dokładne logotypy i zablokowane zasoby marki wciąż bezpieczniej dodawać na etapie postprodukcji, gdy liczy się precyzja.
Obraz |
Wideo |
Połącz dialog i dźwięk w tym samym przepływie pracy
Z pomocą Native Audio seria VIDEO 3.0 potrafi jednocześnie generować scenę i dialog, w tym wieloosobowe rozmowy po chińsku, angielsku, japońsku, koreańsku i hiszpańsku. Zamiast najpierw tworzyć niemy klip, a potem zajmować się głosami, synchronizacją czasową i synchronizacją ruchu warg, możesz od początku zaplanować, kto mówi, co mówi i jak rozegra się ujęcie. To szczególnie przydatne w krótkich formach opartych na dialogach oraz scenach z wieloma bohaterami, w których mowa i gra aktorska muszą pozostawać zsynchronizowane.
Obraz |
Prompt: Na małej stacji spowitej poranną mgłą chłopiec uśmiechnął się i wręczył bento: 「急いで作ったけど、大丈夫? お母さんのレシピだよ。」 Dziewczyna przyjęła je z uśmiechem: 「うん、きっと美味しい! 到着したら LINE するね。」 |
Wideo |
Koniec
Niezależnie od tego, czy tworzysz reklamę produktu, krótkometrażowy film oparty na dialogu, czy wieloujęciową opowieść, ograniczenia obecnej technologii generowania wideo przez AI często objawiają się w dobrze znanych problemach: postać zmienia się między ujęciami, ruch wydaje się nienaturalny, tekst się rozpada lub scena wymaga wielu prób, by ją dopracować. Jasne materiały referencyjne, krótsze planowanie ujęć i dobór narzędzi sterujących do potrzeb każdego ujęcia mogą ograniczyć zbędne poprawki. Seria Kling VIDEO 3.0 wprowadza do procesu generowania spójność postaci opartą na referencjach, Multi-Shot i Custom Multi-Shot, kontrolę ruchu, elastyczne generowanie trwające od 3 do 15 sekund, wyjście tekstowe na poziomie native oraz natywny dźwięk, dając twórcom większą kontrolę nad bohaterami, ruchem, tempem, dialogiem i wizualnym opowiadaniem historii.
Najczęściej zadawane pytania
Jakie są główne ograniczenia technologii generowania wideo przez AI w 2026 roku?
Aktualne modele wideo AI mogą tracić spójność, gdy scena staje się bardziej złożona. Twarz może zmieniać się między ujęciami, ruch może wyglądać nieco niepoprawnie, tekst może się zniekształcać, a dłuższe sekwencje trudniej utrzymać w spójności. Szczegółowe prompty również nie zawsze przekładają się na dokładne rezultaty, dlatego twórcy często polegają na obrazach referencyjnych, krótszych ujęciach i kilku rundach dopracowywania, by uzyskać materiał w pożądanej formie.
Czy generatory wideo AI potrafią tworzyć długie filmy?
Generatory wideo AI mogą tworzyć dłuższe klipy i sekwencje wielokadrowe, ale wraz z rozrostem wideo coraz trudniej utrzymać spójność. Takie benchmarki jak DirectorBench i MSVBench również koncentrują się na problemach, takich jak przejścia między ujęciami, spójność między kadrami i ciągłość narracji. W przypadku dłuższych projektów zazwyczaj łatwiej jest pracować ujęcie po ujęciu, ponownie wykorzystywać te same materiały referencyjne i sprawdzać, jak każda scena łączy się z następną, zanim przejdzie się dalej.
Dlaczego filmy generowane przez AI wyglądają niespójnie?
Nagrania generowane przez AI mogą wyglądać niespójnie, ponieważ model musi utrzymywać twarze, obiekty, tekstury i inne szczegóły sceny stabilne z klatki na klatkę. Gdy kamera się porusza lub coś znika za innym obiektem i wraca do kadru, te detale mogą się zmieniać. Użycie tego samego obrazu referencyjnego, rozpoczęcie od prostszej akcji i zmienianie jednej części promptu naraz może ułatwić kontrolę nad rezultatem. Jeśli twarz, produkt lub rekwizyt muszą dokładnie pasować, przejrzyj klip klatka po klatce.
Czy generatory wideo AI mogą odwzorować realistyczną fizykę?
Wideo AI może sprawiać, że ruch wygląda przekonująco, ale to nie zawsze oznacza, że fizyka jest poprawna. T2VPhysBench przeprowadziło testy modeli wideo pod kątem 12 fundamentalnych praw fizyki i wykryło powtarzające się problemy z grawitacją, zasadą zachowania i innymi interakcjami fizycznymi. Jeśli wideo ma pokazać, jak działa produkt, proces naukowy lub wyraźne działanie przyczynowo-skutkowe, porównaj wynik z rzeczywistymi nagraniami i dokładnie przeanalizuj ruch.
Jakie są kluczowe trendy technologii wideo generowanego przez AI w 2026 roku?
Trendy w technologii wideo generowanego przez AI w 2026 roku obejmują więcej sposobów rozpoczynania wideo, reżyserowania występu i obsługi mowy w ramach tego samego projektu. Twórca może zacząć od generatora wideo AI lub AI do konwersji obrazu na wideo, wykorzystać kontrolę ruchu w celu uzyskania określonego ruchu, a następnie dodać dialog mówiony z synchronizacją ust lub narzędzia do dubbingu. Awatary AI, natywny dźwięk i narzędzia do edycji wideo również stają się ważniejszym elementem tworzenia krótkich form wideo, reklam i zlokalizowanych treści.