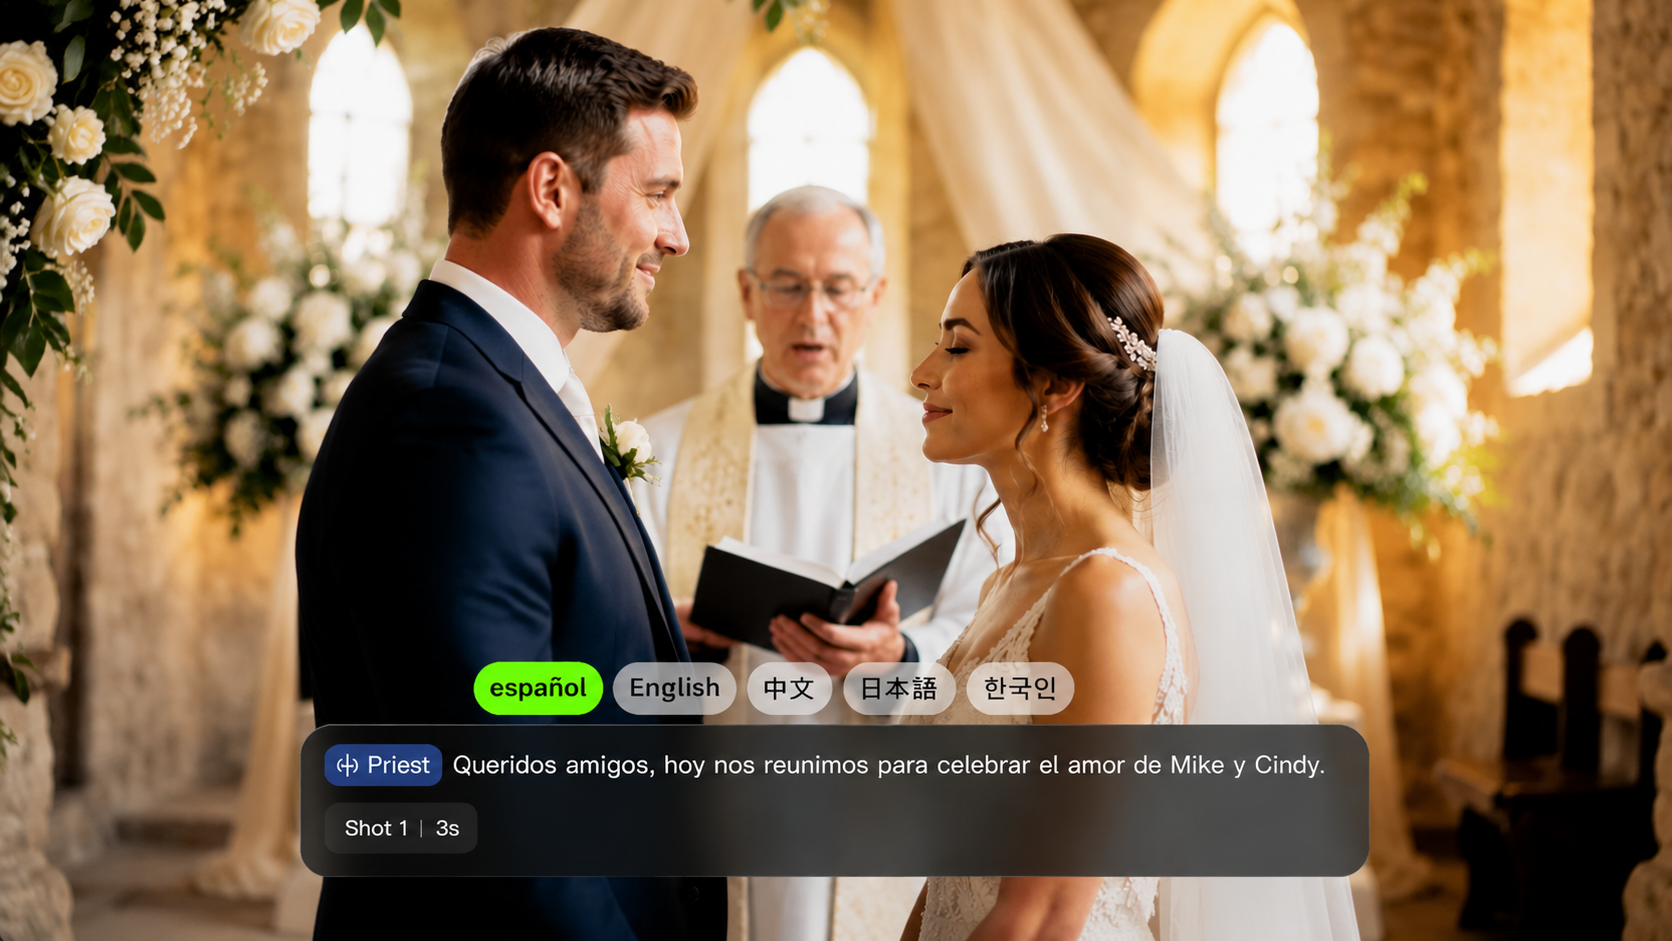
يحتاج مسار تدريبي إلى سرد واضح. قد يحتاج بودكاست إلى تصحيحات صوتية سريعة. تحتاج شخصية خيالية إلى جملة تناسب ما يحدث على الشاشة. يبدأ اختيار أفضل مولد صوت بالذكاء الاصطناعي من المشروع النهائي، لا من أكبر مكتبة أصوات. على سبيل المثال، يستحق Kling AI أيضًا النظر إليه عندما يجب أن يكون الحوار جزءًا من مشهد بصري.
ما المهم عند اختيار مولد صوت بالذكاء الاصطناعي؟
ابدأ بالمخرجات التي تحتاج إليها. يمكن أن يُستخدم مولد صوت بالذكاء الاصطناعي لإلقاء مستقل أو لحوار شخصية داخل فيديو، وذلك وفقًا للأداة. بمجرد أن تعرف أي صيغة تناسب مشروعك، قارن بعض التفاصيل العملية:
- جودة الإلقاء: استمع إلى نطق واضح، وتوقفات طبيعية، وتركيز يناسب النص.
- خيارات اللغة والصوت: تحقق من اللغة المطلوبة، واللهجة، وأسلوب الصوت بدلاً من الاكتفاء بعدد الأصوات المذكور في العناوين.
- أدوات المراجعة: تعرف ما إذا كان بإمكانك إصلاح سطر واحد من دون إعادة بناء المشروع بأكمله.
- الحقوق والأذونات: تحقق من شروط الترخيص المطبقة واحصل على الموافقة قبل استنساخ صوت شخص ما.
- ملاءمة المشروع: حدّد ما إذا كنت بحاجة إلى تنزيل صوتي، أو تحرير قائم على التفريغ النصي، أو حوار يتم توليده مع الفيديو.
يُعد اختبار قصير باستخدام النص الفعلي الخاص بك أكثر فائدة من الاختيار بناءً على عدد الميزات فقط.
أفضل مولدات الصوت بالذكاء الاصطناعي: مقارنة بين 6 خيارات
تتناول هذه الأدوات إنشاء الصوت بطرق مختلفة. يسلّط الجدول الضوء على حالات الاستخدام الرئيسية لكل منها ومسارات العمل، يلي ذلك نظرة أقرب على كل خيار.
أداة | الأفضل لـ | قدرات الصوت والحوار | سير العمل النموذجي |
Kling AI (Kling 4.0) | مقاطع فيديو بالذكاء الاصطناعي مع حوارات ومرئيات متكاملة، بما يشمل مقاطع فيديو توضيحية، ومحتوى تعليمي، وتسويقًا تقوده الشخصيات، وقصصًا متحركة، ومقاطع فيديو اجتماعية متعددة اللغات.
| توليد صوتي بصري أصيل، وحوارات بتسع لغات، ومحادثات متعددة الشخصيات موجهة بالمحفز، وتحسين محاذاة مزامنة الشفاه، وعناصر شخصيات قابلة لإعادة الاستخدام مع ربط بين المظهر والصوت. | استخدم المطالبات لتوجيه الحوار والتعابير والحركات وحركة الكاميرا. ومع Omni Reference، اجمع بين الصور المدعومة ومقاطع الفيديو وElements ومرجعيات الصوت لتوجيه الأسلوب البصري والإيقاع والنقاط الأساسية للقصة.
|
ElevenLabs | السرد، والمسارات الصوتية المعبرة، وتصميم الصوت | تحويل النص إلى كلام، وتصميم واستنساخ الصوت، والكلام المعبر، وحوار متعدد المتحدثين. | اختر أو صمّم صوتاً، أدخل نص السيناريو، اضبط طريقة الإلقاء، وولّد الصوت. |
Murf AI | تعليق صوتي للأعمال والتدريب والعروض التقديمية | سرد مدعوم بالذكاء الاصطناعي مع عناصر تحكم في السرعة ودرجة الحدة والتأكيد والنبرة، بالإضافة إلى إنتاج التعليق الصوتي للمحتوى متعدد الوسائط. | حضّر نصًا، واختر صوتًا، وحسّن الإلقاء، وقرِن السرد بالمرئيات. |
Speechify Studio | تعليقات صوتية للمبدعين ودبلجة الفيديو | تعليقات صوتية ودبلجة مدعومة بالذكاء الاصطناعي، مع خيارات لمطابقة صوت المتحدث وتنغيمه وسرعته. | أضف نصًا أو فيديو، اختر صوتًا ولغة، أنشئ تعليقًا صوتيًا أو دبلجة، وراجع النتيجة. |
Descript | البودكاست، والمقابلات، ومراجعات المحتوى الصوتي. | أصوات الذكاء الاصطناعي واستنساخ الصوت، والتحرير المعتمد على النص، والكلام المعاد توليده. يمكن أن تضبط إعادة توليد الفيديو المدعومة أيضًا حركات الفم. | حرر النص المكتوب، اكتب التصحيحات، أعد توليد السطور المحددة، وراجع الصوت أو الفيديو. |
LOVO (Genny) | التعليق الصوتي التسويقي والمشاريع متعددة الوسائط | تحويل النص إلى كلام للتعليقات الصوتية وبيئة عمل للفيديو تدعم المشاريع التي تضم متحدثًا واحدًا أو أكثر. | أدخل النص، اختر الأصوات، أنشئ التعليقات الصوتية، واجمع العناصر المرئية والصوتية في Genny. |
1. Kling AI: الأفضل لحوارات الشخصيات في الفيديو المعتمد على الذكاء الاصطناعي
بالنسبة للمشاهد التي تقودها الشخصيات، يولد Kling 4.0 الصوت والصورة معًا، مما يتيح للمبدعين توجيه الحوار والتعبيرات والإيماءات وتأطير الكاميرا ضمن الفيديو نفسه. يدعم الحوار بتسع لغات—الصينية، الإنجليزية، اليابانية، الكورية، الإسبانية، البرتغالية، الألمانية، الفرنسية، والهندية—ويقدم تحسينًا في مواءمة تزامن الشفاه للمساعدة على ربط الجمل المنطوقة بأداء الشخصية.
باستخدام Omni Reference، يمكنك دمج الصور المدعومة ومقاطع الفيديو والعناصر والمراجع الصوتية لتوجيه مظهر الشخصية وصوتها. بالنسبة للشخصيات المتكررة، يمكنك إنشاء أو اختيار عنصر شخصية بسمات بصرية محددة وصوت مرتبط، مما يساعد على الحفاظ على مظهر مألوف وهوية صوتية يمكن التعرف عليها عبر المشاهد.
إلى جانب المشاهد التي تعتمد على الحوار، يدعم نموذجنا Kling 4.0 مقاطع فيديو تصل إلى 30 ثانية في توليد واحد، مع حركة واسعة النطاق أكثر استقرارًا وحركات كاميرا معقدة. ومن خلال إدراج صور الإطارات المفتاحية ضمن مواد المرجع لتوجيه اللحظات البصرية المهمة، يمكن للمبدعين صياغة سرديات أكثر تماسكًا وإنتاج مقاطع فيديو ذكاء اصطناعي عالية الجودة مع قدر أكبر من التحكم والثبات.

2.ElevenLabs: الأفضل للسرد ومسارات صوت الشخصيات
تركز ElevenLabs على إنتاج الصوت المنطوق لمشروعات مثل السرد والخيال وحوارات الشخصيات. يمكن للمنشئين العمل باستخدام أصوات محددة أو ميزات استنساخ الأصوات المصرح بها حيثما كانت مدعومة. يناسب هذا المشاريع التي يكون فيها المسار الصوتي هو المخرج الرئيسي؛ تأكد من اللغة المقصودة وشروط الترخيص قبل الالتزام بسير عمل الإنتاج.
3.Murf AI: الأفضل للتعليقات الصوتية للأعمال والتدريب
يوفر Murf AI سير عمل للتعليقات الصوتية يتمحور حول النص ومناسب للعروض التقديمية ومواد التدريب والمقاطع التوضيحية. يمكن للفرق إعداد السرد، وضبط الإلقاء، ومراجعة التسجيل إلى جانب الرسالة المنظمة. تحقق من خيارات النطق وحقوق التصدير للصوت المحدد والخطة التي تنوي استخدامها.
4.Speechify Studio: الأفضل للتعليقات الصوتية البسيطة للمبدعين
Speechify Studio يوفر بيئة قائمة على المتصفح لإنتاج التعليقات الصوتية والمحتوى المروي. يمكن أن يلائم مقاطع الفيديو البسيطة لصانعي المحتوى أو المواد التعليمية حيث يكون إدخال النص وإجراء المراجعات السريعة أمرًا مهمًا. تحقق من الأصوات واللغات وعناصر التحكم في التحرير المتضمنة في المنتج والخطة اللذين اخترتهما.
5. Descript: الأفضل لتوليد الصوت إلى جانب التحرير
تجمع Descript بين مشاريع الصوت والفيديو مع التحرير القائم على التفريغ النصي. وهي مفيدة عندما يخضع بودكاست أو مقابلة أو تعليق صوتي لتغييرات متكررة في النص وتصحيحات. ميزات الصوت المُولَّد والاستبدال لديها متطلبات وصول وترخيص خاصة بها، لذا راجع الانتقالات بعناية بعد تعديل التسجيل.
6. LOVO: الأفضل للتعليقات الصوتية التسويقية والمشروعات متعددة الوسائط
تجمع مساحة عمل Genny من LOVO بين السرد المولَّد والأدوات الخاصة بتجميع المشاريع متعددة الوسائط. يمكن أن يساعد ذلك في إعداد فيديوهات الشرح التسويقي أو العروض التقديمية التي تحتاج إلى مسار صوتي إلى جانب العناصر المرئية. تأكد من تنسيقات الإخراج، وحدود المشاريع، وشروط استخدام الأصوات التي تنطبق على باقتك.
لماذا تختار Kling 4.0 لمقاطع الفيديو المدعومة بالذكاء الاصطناعي مع حوارات الشخصيات؟
يمكن لأداة تركز على الصوت أولاً أن تنشئ مساراً صوتياً، لكن مقاطع الفيديو التي تقودها الشخصيات تحتاج أيضاً إلى أن يتطابق الحوار مع المتحدث والعاطفة والحركة والتوقيت على الشاشة. يجلب Kling 4.0 هذه العناصر إلى سير عمل أصلي لتوليد الصوت والصورة، ما يتيح لك توجيه الكلام والأداء البصري معاً. وعند دمجه بإنشاء موجَّه بالمرجع وتحكم أكثر دقة في السرد، يصبح هذا النهج مفيداً للمحادثات متعددة اللغات، والقصص المتحركة، والشخصيات المتكررة، ومقاطع الفيديو التسويقية التي تقودها الشخصيات.
أنشئ حوارات متعددة اللغات مع أداء متوافق للشخصيات
في Kling 4.0، يمكنك وصف من يتحدث، وما يقوله كل شخصية، وكيف يتفاعلون، وكيف تؤطر الكاميرا المحادثة. حدِّد لغة كل متحدث، ونبرته، والتوقفات، والإيماءات، والاستجابة العاطفية للمساعدة في جعل المشهد مترابطًا. يدعم النموذج تسع لغات ويقدم محاذاة محسّنة لمزامنة الشفاه، مما يساعد الحوار المنطوق على التوافق مع أداء الشخصية على الشاشة.
في المشاهد متعددة الشخصيات، حافظ على تمييز حوارات كل متحدث واصفًا ردود أفعالهم بالتسلسل. على سبيل المثال، قد يطرح السائح سؤالًا بالإسبانية، وقد يترجمه مترجم إلى الصينية، وقد يجيب أحد أفراد الطاقم بالصينية. يمكنك توجيه المحادثة وأفعال الشخصيات في المطالبة نفسها، ثم مراجعة الكلام الناتج وحركات الفم والتوقيت.
صورة مرجعية | فيديو مُولَّد |
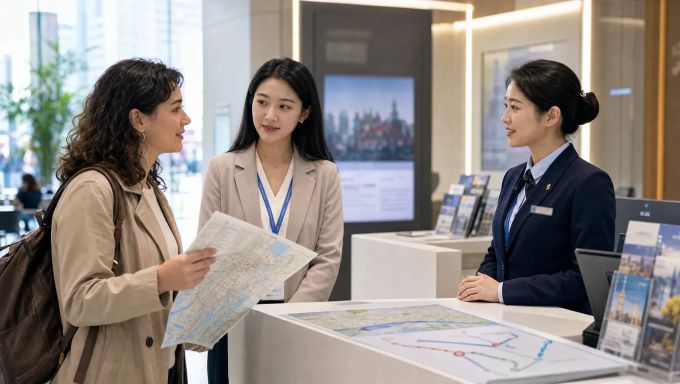 | 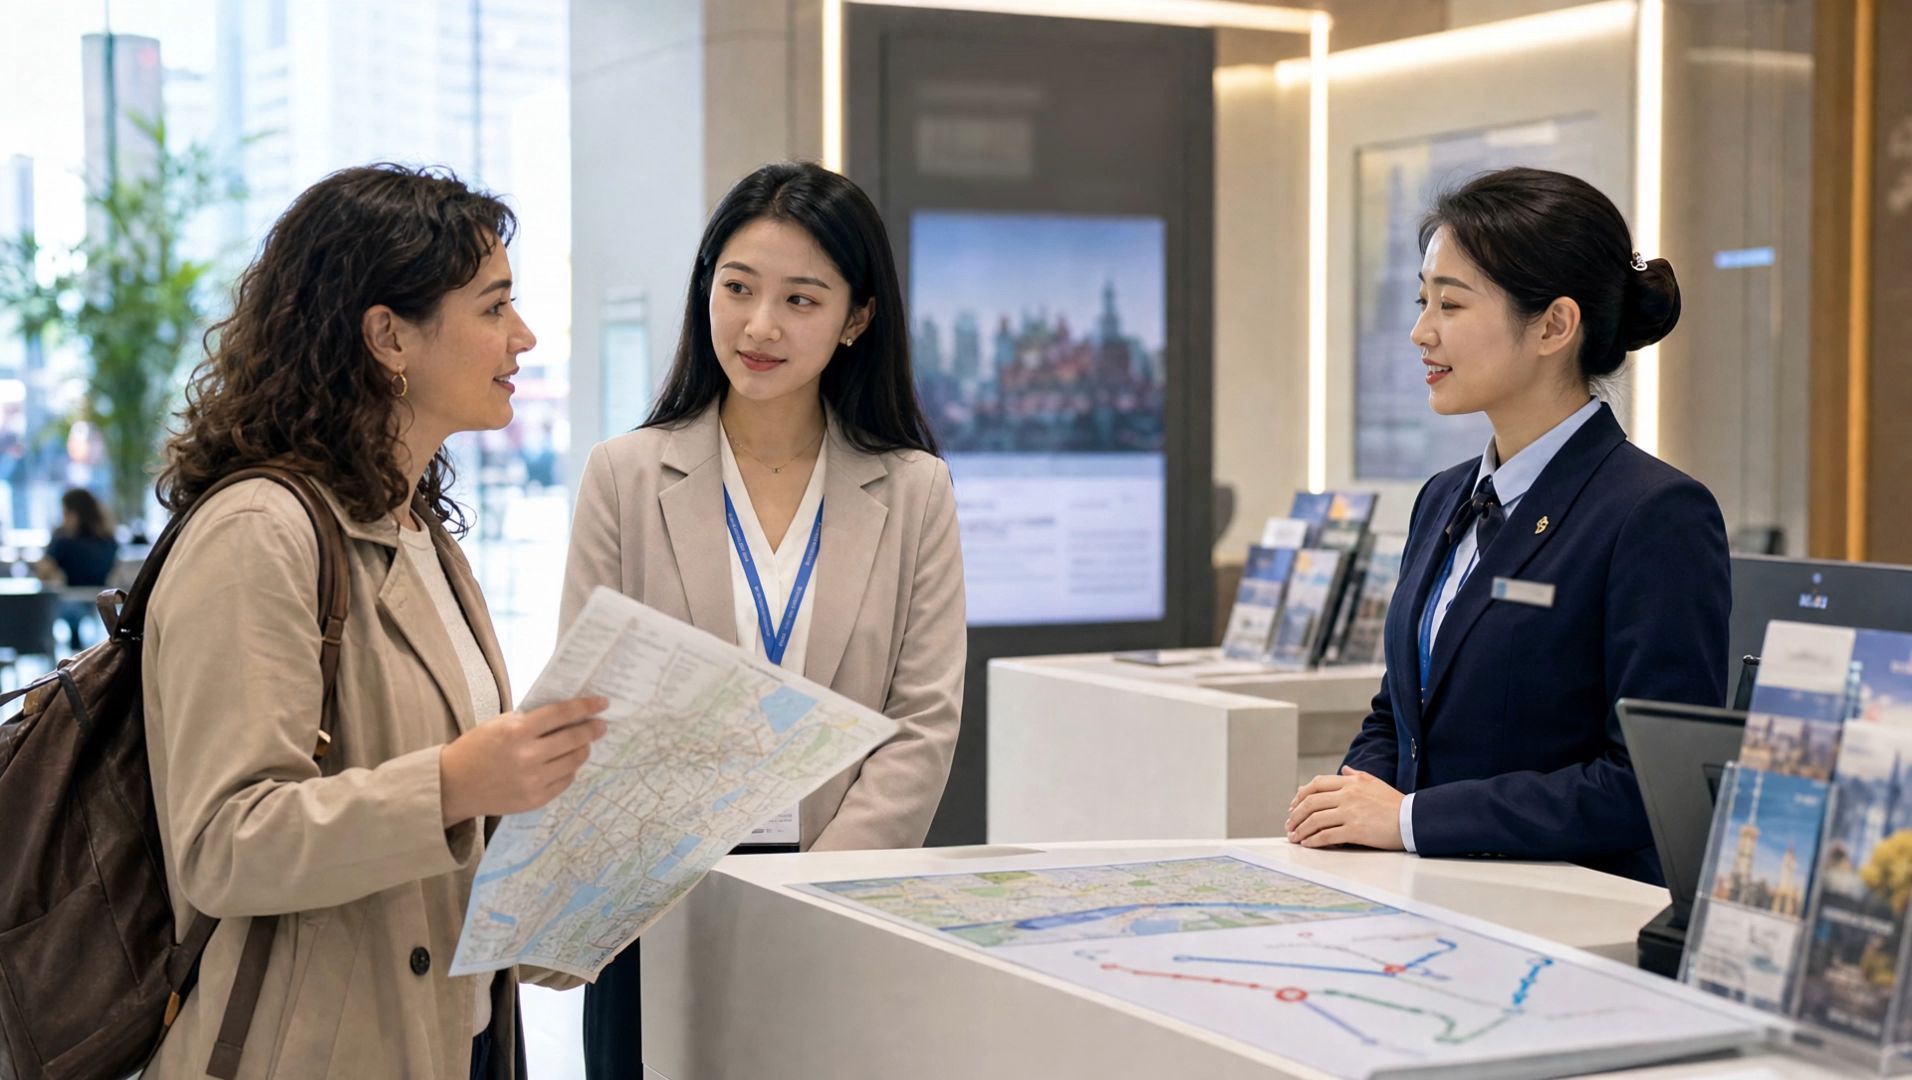 |
الموجه: سياق المشهد: ثلاث شخصيات بشرية متمايزة طوال الفيديو. يوجد ثلاثة أشخاص في مركز معلومات سياحية لمدينة خيالية مشرق ونظيف. حافظ على درجات ألوان متسقة طوال الوقت. تقف السائحة الإسبانية على اليسار، يقف المترجم في المنتصف، ويقف موظف السياحة على اليمين. توضع خريطة مدينة ومخطط مسار على مكتب المعلومات. يجب طمس النصوص الخلفية وتسميات الخرائط بحيث تكون غير مقروءة. يمنع ظهور أي علامات تجارية حقيقية أو أسماء منظمات أو شعارات أو علامات مائية. توقيت الحدث: 0–3 ثوانٍ: لقطة متوسطة للأشخاص الثلاثة جميعاً. تنظر السائحة الإسبانية إلى المترجم في المنتصف، ترفع الخريطة في يدها، وتتحدث بالإسبانية الطبيعية الواضحة والبطيئة قليلاً: "¿Dónde está la estación de metro más cercana?" بعد أن تنتهي من الكلام، يتم التوقف لمدة تقارب 0.5 ثانية. يلتفت المترجم إلى موظف السياحة ويترجم إلى الصينية: "她想知道最近的地铁站在哪里。" 3–7 ثوانٍ: الانتقال إلى لقطة المترجم وموظف السياحة. ينظر موظف السياحة إلى الخريطة (من دون استخدام لقطة مقربة للخريطة) ويجيب بالصينية الطبيعية والواضحة: "沿这条路直走,步行大约五分钟就能到." بعد أن ينتهي الموظف من الكلام، يتم التوقف لمدة تقارب 0.5 ثانية. يؤكد المترجم الفهم ويلتفت نحو السائحة. ٧–١١ ثانية: يترجم المترجم إجابة عضو الطاقم إلى إسبانية طبيعية وواضحة وبطيئة قليلًا: “La estación de metro está a unos cinco minutos a pie. Siga recto por esta calle.” أثناء الحديث، يشير المترجم إلى المسار على الخريطة، ويدرسه السائح بانتباه. ١١–١٥ ثانية: العودة إلى لقطة متوسطة تظهر الأشخاص الثلاثة جميعًا. بعد فهم الاتجاهات، يبتسم السائح الإسباني ويهز رأسه ويقول بالإسبانية: “Muchas gracias.” يحافظ الثلاثة على تفاعل خدمة طبيعي بينما ينتهي المشهد. الصوت: - يتحدث السائح الإسباني اللغة الإسبانية فقط. - يتحدث موظف السياحة الصيني اللغة الصينية فقط. - يتحدث المترجم الصيني باللغة الصينية أولًا، ثم بالإسبانية. - لكل شخص صوت مميز. - عندما يتحدث أحدهم، يظل الآخرون صامتين. لا توجد مقاطعات أو حوارات متداخلة. - يجب أن تكون جميع الحوارات ذات مخارج واضحة، مع تزامن حركة الشفاه مع اللغة المقابلة. - يجب أن يكون النطق بالإسبانية طبيعيًا وقياسيًا، من دون لكنة إنجليزية. - يجب أن يكون الكلام بطيئًا قليلًا مع توقفات طبيعية بين الجمل. - احتفظ بالأصوات المحيطة الخفيفة من مركز المعلومات السياحية. لا تضف موسيقى خلفية. يجب ألا تطغى الأصوات المحيطة على الحوار. الكاميرا: ابدأ بلقطة متوسطة للأشخاص الثلاثة لإظهار علاقاتهم. عندما يتحدث السائح، انتقل إلى لقطة ثنائية للسائح والمترجم. عندما ينقل المترجم السؤال، انتقل إلى لقطة للمترجم وموظف المركز. خلال إجابة الموظف، ضمّن لقطة قريبة لمسار الخريطة. عندما يترجم المترجم إلى الإسبانية، عد إلى لقطة ثنائية للمترجم والسائح. اختم بلقطة متوسطة للأشخاص الثلاثة. حافظ على ثبات مواقع الشخصيات وخطوط النظر والملابس طوال الوقت. لا تستبدل الشخصيات فجأة أو تغيّر علاقاتها المكانية. الأسلوب: أسلوب وثائقي واقعي وطبيعي ومهني لخدمة السفر. إضاءة ساطعة ونظيفة، وتعابير وجه طبيعية، وحركات متزنة. يجب أن يشبه المشهد تفاعلًا حقيقيًا في مطار أو مركز معلومات سياحية في المدينة. | |
أبقِ مظهر الشخصية وصوتها مرتبطين باستخدام Omni Reference
Omni Reference يدعم ما يصل إلى 15 أصلًا مرجعيًا مجمعًا في عملية توليد واحدة، بما في ذلك ما يصل إلى 10 صور، وما يصل إلى 5 مقاطع فيديو بمدة إجمالية لا تتجاوز 30 ثانية، وما يصل إلى 7 Elements، بما في ذلك ما يصل إلى 3 Elements للفيديو. كما يتم دعم المراجع الصوتية ضمن حدود الأصول المجمعة.
بالنسبة للشخصيات المتكررة، يمكنك إنشاء أو اختيار Element للشخصية بسمات بصرية محددة وربط صوت عند إعداد Element. يساعد إعادة استخدام ذلك Element ضمن سير عمل توليد مدعوم على توجيه كل من مظهر الشخصية وهويتها الصوتية. يمكنك أيضًا إسناد أدوار أخرى للمراجع المخصّصة، مثل تحديد الإعداد، أو توجيه الحركة، أو توفير توجيه للكاميرا. تساعد أدوار المراجع الواضحة النموذج على اتباع نيتك بشكل أكثر اتساقًا، على الرغم من أنه ينبغي مراجعة النتيجة النهائية.
وجّه الإجراءات الأطول، وحركات الكاميرا، وإيقاعات السرد مباشرة
يدعم نموذجنا Kling 4.0 مقاطع فيديو من جيل واحد تصل مدتها إلى 30 ثانية، مما يمنح حوار الشخصيات وردود أفعالها وحركاتها مجالًا أكبر للتطور. تساعد حركة أكثر استقرارًا على نطاق واسع وحركات كاميرا معقدة في إنشاء مشاهد أكثر سلاسة واتساقًا.
بالنسبة للقصص الأطول، يتيح لك سير العمل Timeline دمج المقاطع المولَّدة، وقص اللقطات أو استبدالها، ومعاينة التسلسل. يمكنك أيضًا إجراء تعديلات مستهدفة على اللقطات الحالية، لتنقيح الفيديو دون إعادة بناء كل مشهد من الصفر.
كيفية إنشاء فيديو بالذكاء الاصطناعي مع حوار للشخصيات
إذا كنت تريد إنشاء شخصيات تتبادل الحوار داخل فيديو بدلاً من تنزيل ملف صوتي مستقل، فإن Kling AI يقدم سير عمل يركز على الفيديو أولاً. ومع Kling 4.0، يمكنك إعداد مراجع للشخصيات، وتوجيه الحوار والأداء البصري عبر المطالبات، ومراجعة المشهد الكامل قبل التصدير.
الخطوة 1. افتح إنشاء الفيديو وجهّز مراجع الشخصيات
افتح مساحة عمل إنشاء الفيديو في Kling AI واختر Kling 4.0. إذا كنت تخطط لإعادة استخدام شخصية، فأنشئ أو اختر عنصر شخصية Element، وحدد مظهرها، واربط الصوت المقصود حيثما كان ذلك مدعومًا. أضف عنصر Element وأي مراجع للإعداد أو الحركة أو الصوت عبر Omni Reference، مع الالتزام بالحد الإجمالي البالغ 15 مادة مرجعية. يمكنك أيضًا البدء بموجه فقط إذا لم تكن المراجع ضرورية.
الخطوة 2. اكتب موجهًا لكل متحدث وإجراء
حدد من يتحدث، والحوار الدقيق، واللغة المقصودة، ونبرة الشخصية وعاطفتها. صِف التوقفات، والإيماءات، وردود الفعل، وحركات الكاميرا أيضًا. امنح كل مرجع دورًا واضحًا حتى يعرف النموذج أي التفاصيل يجب اتباعها.
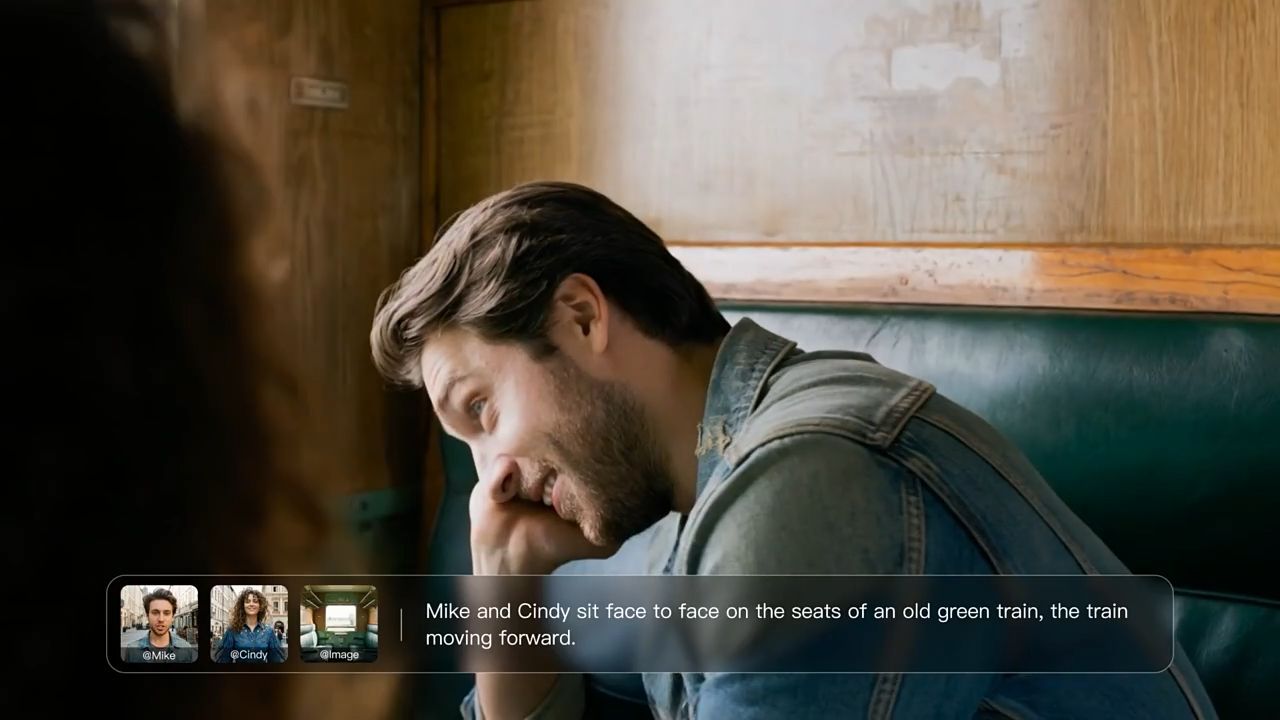
| الموجِّه: @Element1 يحدد مظهر الشخصية والصوت المرتبط بها. @Image1 يحدد بيئة متجر الكتب. تنظر الشخصية إلى رف عرض فارغ، وتتوقف لحظة، وتقول بالإنجليزية الطبيعية: "The last copy is already gone," بتعبير خائب الأمل. تقترب الكاميرا ببطء. حافظ على اتساق السمات البصرية المميزة للشخصية. |
الخطوة 3. التوليد، المراجعة، والتنقيح
أنشئ مسودة وراجع الصوتيات والمرئيات معًا. افحص حوارات كل شخصية، والنطق، واللغة، وحركات الفم، والتوقيت، وتعبيرات الوجه، واتساق المظهر والصوت. راجع أيضًا الحركات الكبيرة وانتقالات الكاميرا. إذا بدا سطر ما متسارعًا أو كان رد الفعل غير واضح، فبسّط الموجِّه أو عدّل الأدوار المرجعية قبل إنشاء لقطة أخرى. صدّر بعد مراجعة المقطع الكامل وخيارات الإخراج المتاحة.
كيفية التحقق من جودة الصوت بالذكاء الاصطناعي قبل النشر
بالنسبة للمشروعات الاحترافية، تحقَّق من الحقوق المرتبطة بالأصوات، والتسجيلات المصدرية، والسمات القابلة للتعرّف. لا يعني الإذن باستخدام تسجيلٍ ما تلقائيًا الحصول على إذن لاستنساخ المتحدث فيه. إذا كان من الممكن أن يُساء تفسير الحوار المُولَّد على أنه كلمات شخص حقيقي، فراجع متطلبات الموافقة والإفصاح المعمول بها. عندما تحتاج إلى تعديل الحوار أو أداء شخصية في مقطع موجود، يمكن لـمحرر الفيديو بالذكاء الاصطناعي الخاص بنا مساعدتك على إجراء تغييرات مستهدفة. راجع النتيجة دائمًا قبل النشر.
ما الذي يجب التحقق منه | ما الذي يجب الاستماع إليه أو البحث عنه | الحل العملي |
النطق | الأسماء والكلمات غير المألوفة | أعد صياغة العبارة أو استخدم عناصر التحكم في النطق إن كانت متاحة |
الإيقاع | كلام متعجل أو فترات صمت محرجة | قصِّر الجملة أو اضبط التوقفات |
التعبير | تأكيد يغيّر المعنى | وضّح العاطفة المقصودة للشخصية |
الاتساق | الحفاظ على صوت الشخصية عبر مقطع أطول | قارن بين بداية ونهاية المخرجات |
حوار الفيديو | ما إذا كانت الكلمات تتناسب مع الإيماءات والتعبيرات | راجع المشهد الكامل وحسّن توجهه |
النهاية
أفضل مولد صوتي بالذكاء الاصطناعي يعتمد على ما إذا كنت تنشئ مقطعًا صوتيًا، أو تعدّل صوتًا موجودًا، أو تبتكر شخصية تتحدث على الشاشة. الأدوات الست المذكورة أعلاه تدعم أجزاء مختلفة من ذلك العمل. إذا كان مشروعك يحتاج إلى حوار، وحركة شخصية، ومرئيات تُطوَّر معًا، فإن Kling 4.0 يوفّر طريقة موجَّهة بالمراجع لبناء المشهد واختبار أداءات بديلة.
الأسئلة الشائعة
هل يُعد استنساخ الصوت أمرًا غير قانوني؟
استنساخ الصوت ليس غير قانوني افتراضياً. ومع ذلك، قد يوقعك في مشاكل قانونية إذا استخدمت صوت شخص دون موافقته. تختلف القواعد بين الدول والمناطق، وغالباً ما تتعلق بالخصوصية وحقوق الشخصية وانتحال الهوية أو الاستخدام التجاري المخادع. هناك خط واضح بين استنساخ صوت لمشروع مُنحت تصريحاً بالعمل عليه، وبين اختلاق مقطع صوتي يجعل شخصاً حقيقياً يقول أشياء لم يتفوه بها قط. ابحث دائماً عن اللوائح المحلية واحصل على الموافقة المناسبة قبل استخدام أي صوت بشري يمكن التعرف عليه.
هل تستطيع أصوات الذكاء الاصطناعي أن تضحك أو تهمس أو تُظهر العاطفة؟
يمكن للعديد من نماذج الصوت المعتمدة على الذكاء الاصطناعي تقديم تعبيرات مثل الضحك، والهمسات الناعمة، والنبرات المتحمسة أو حتى الحزن. مقدار التحكم الذي تملكه يعتمد على الأداة التي تستخدمها؛ فبعضها يتيح لك إضافة مطالبات وصفية، أو علامات أداء، أو ضبط معلمات الصوت. ضع في اعتبارك أن كل نموذج يستجيب للتعليمات بطريقة مختلفة. من الحكمة اختبار مقطع قصير أولاً، حتى تتأكد من أن العاطفة تأتي بشكل طبيعي بدلاً من صرف الانتباه عما تحاول إيصاله.
هل يمكن لبرنامج إنشاء الأصوات بالذكاء الاصطناعي إنشاء أصوات مختلفة لعدة شخصيات؟
يدعم بعض صانعي الأصوات بالذكاء الاصطناعي عدة متحدثين، لكن الإمكانات تختلف من أداة لأخرى. في Kling AI، يمكنك وصف حوار كل شخصية، ولغتها، ونبرتها، وردود أفعالها داخل المطالبة. بالنسبة للشخصيات المتكررة، يمكنك إنشاء أو اختيار Element وربط صوت بها للمساهمة في ترسيخ هوية صوتية يسهل التعرف عليها. راجع الحوار الناتج، والتوقيت، وإجراءات الشخصيات للتأكد من أن كل متحدث يظل مميزاً.
ما الفرق بين مولد الصوت بالذكاء الاصطناعي ومغير الصوت بالذكاء الاصطناعي؟
يُنشئ مولد الصوت بالذكاء الاصطناعي صوتًا جديدًا، بينما يعدِّل مغير الصوت بالذكاء الاصطناعي تسجيلًا صوتيًا موجودًا. في Kling AI، يمكنك وصف تأثيرات الصوت الخلفية في مطالبتك. بالنسبة لأصوات الشخصيات، يمكنك إنشاء Element أو اختيارها وربط صوت بها للمساعدة في ترسيخ الهوية الصوتية للشخصية. مع Kling 4.0، يمكنك أيضًا توليد حوار جنبًا إلى جنب مع العناصر المرئية، مما يجمع بين كلام الشخصية وحركاتها وتعبيراتها في الفيديو نفسه. إذا كنت تريد تعديل تسجيل صوتي موجود، فقد يكون مغير الصوت بالذكاء الاصطناعي أكثر ملاءمة.
هل يمكن لمولدات الصوت بالذكاء الاصطناعي إنشاء حوارات تبدو طبيعية في مقاطع الفيديو؟
نعم. تركز بعض مولدات الصوت بالذكاء الاصطناعي على الصوت المستقل، بينما يمكن لأدوات توليد الفيديو بالذكاء الاصطناعي إنشاء حوارات إلى جانب أداء الشخصيات والعناصر المرئية. في Kling AI، يدعم نموذجنا Kling 4.0 إنشاء الصوت والصورة بشكل أصلي بتسع لغات، مع تحسين مواءمة مزامنة حركة الشفاه للمساعدة في ربط الكلام بالإجراءات على الشاشة. للحصول على نتائج أكثر طبيعية، صف نبرة كل شخصية وعواطفها وتوقفاتها وردود أفعالها في مطالبتك، ثم راجع الحوار والتوقيت الناتجين.