Ein Schulungskurs braucht eine klare Narration. Ein Podcast benötigt möglicherweise schnelle Stimmkorrekturen. Eine fiktive Figur braucht eine Zeile, die zu dem passt, was auf dem Bildschirm geschieht. Die Wahl des besten KI-Sprachgenerators beginnt beim fertigen Projekt, nicht bei der größten Stimmenbibliothek. So lohnt sich beispielsweise auch Kling AI, wenn Dialoge Teil einer visuellen Szene sein sollen.
Was zählt bei der Wahl eines KI-Sprachgenerators?
Beginne mit dem gewünschten Ergebnis. Ein KI-Sprachgenerator kann je nach Tool für eigenständige Sprache oder für Figurendialoge innerhalb eines Videos genutzt werden. Sobald du weißt, welches Format zu deinem Projekt passt, vergleiche ein paar praktische Details:
- Sprachqualität: Achte auf klare Aussprache, natürliche Pausen und eine Betonung, die zum Skript passt.
- Sprach- und Stimmoptionen: Prüfe die benötigte Sprache, den Akzent und den Stimmenstil statt bloßer Schlagzeilen zur Anzahl der Stimmen.
- Überarbeitungswerkzeuge: Finde heraus, ob du eine einzelne Zeile korrigieren kannst, ohne das ganze Projekt neu aufzubauen.
- Rechte und Genehmigungen: Bestätigen Sie die geltenden Lizenzbedingungen und holen Sie die Zustimmung ein, bevor Sie die Stimme einer Person klonen.
- Projektpassung: Entscheiden Sie, ob Sie einen Audio-Download, eine transkriptbasierte Bearbeitung oder einen zusammen mit Video generierten Dialog benötigen.
Ein kurzer Test mit Ihrem tatsächlichen Skript ist aussagekräftiger, als sich allein auf die Anzahl der Funktionen zu stützen.
Die besten KI-Stimmgeneratoren: 6 Optionen im Vergleich
Diese Tools gehen die Stimmerstellung auf unterschiedliche Weise an. Die Tabelle hebt ihre wichtigsten Anwendungsfälle und Workflows hervor, gefolgt von einem genaueren Blick auf jede Option.
Werkzeug | Am besten geeignet für | Sprach- und Dialogfunktionen | Typischer Arbeitsablauf |
Kling AI (Kling 4.0) | KI-Videos mit integriertem Dialog und visuellen Elementen, einschließlich Erklärvideos, Bildungsinhalten, charaktergeführtem Marketing, animierten Geschichten und mehrsprachigen Social-Videos.
| Native audiovisuelle Generierung, Dialoge in neun Sprachen, promptgesteuerte Mehrcharakter-Konversationen, verbesserte Lip-Sync-Abstimmung und wiederverwendbare Charakterelemente mit Verknüpfung von Erscheinungsbild und Stimme. | Verwenden Sie Aufforderungen, um Dialog, Ausdrücke, Aktionen und Kamerabewegungen zu steuern. Mit Omni Reference kombinieren Sie unterstützte Bilder, Videos, Elements und Sprachreferenzen, um den visuellen Stil, das Tempo und die Schlüsselmomente der Geschichte zu steuern.
|
ElevenLabs | Erzählung, ausdrucksstarke Sprachspuren und Stimmendesign | Text-to-Speech, Stimmendesign und Klonen, ausdrucksstarke Sprache sowie Dialoge mit mehreren Sprecher:innen. | Wählen oder gestalten Sie eine Stimme, geben Sie ein Skript ein, passen Sie die Darbietung an und generieren Sie Audio. |
Murf AI | Unternehmens-, Schulungs- und Präsentations-Voiceovers. | KI-Erzählung mit Steuerungen für Geschwindigkeit, Tonhöhe, Betonung und Tonfall sowie Voiceover-Produktion für multimediale Inhalte. | Bereiten Sie ein Skript vor, wählen Sie eine Stimme aus, verfeinern Sie die Darbietung und kombinieren Sie die Erzählung mit visuellen Elementen. |
Speechify Studio | Creator-Voiceovers und Videonachvertonung | KI-Voiceovers und Synchronisation mit Optionen zur Anpassung an Sprecherstimme, Intonation und Geschwindigkeit. | Fügen Sie ein Skript oder Video hinzu, wählen Sie eine Stimme und eine Sprache aus, generieren Sie eine Narration oder Synchronisation und überprüfen Sie das Ergebnis. |
Descript | Podcasts, Interviews und Überarbeitungen von gesprochenen Inhalten. | KI-Stimmen und Stimmklonen, transkriptbasiertes Bearbeiten und regenerierte Sprache. Unterstützte Videoregenerierung kann auch die Mundbewegungen anpassen. | Bearbeiten Sie das Transkript, geben Sie Korrekturen ein, regenerieren Sie ausgewählte Zeilen und überprüfen Sie das Audio oder Video. |
LOVO (Genny) | Marketing-Voiceovers und Multimedia-Projekte | Text-to-Speech-Voiceovers und ein Videoarbeitsbereich, der Projekte mit einer oder mehreren Sprecherinnen und Sprechern unterstützt. | Gib ein Skript ein, wähle Stimmen aus, generiere Voiceovers und setze visuelle Elemente und Audio in Genny zusammen. |
1.Kling AI: Am besten für Charakterdialoge in KI-Videos
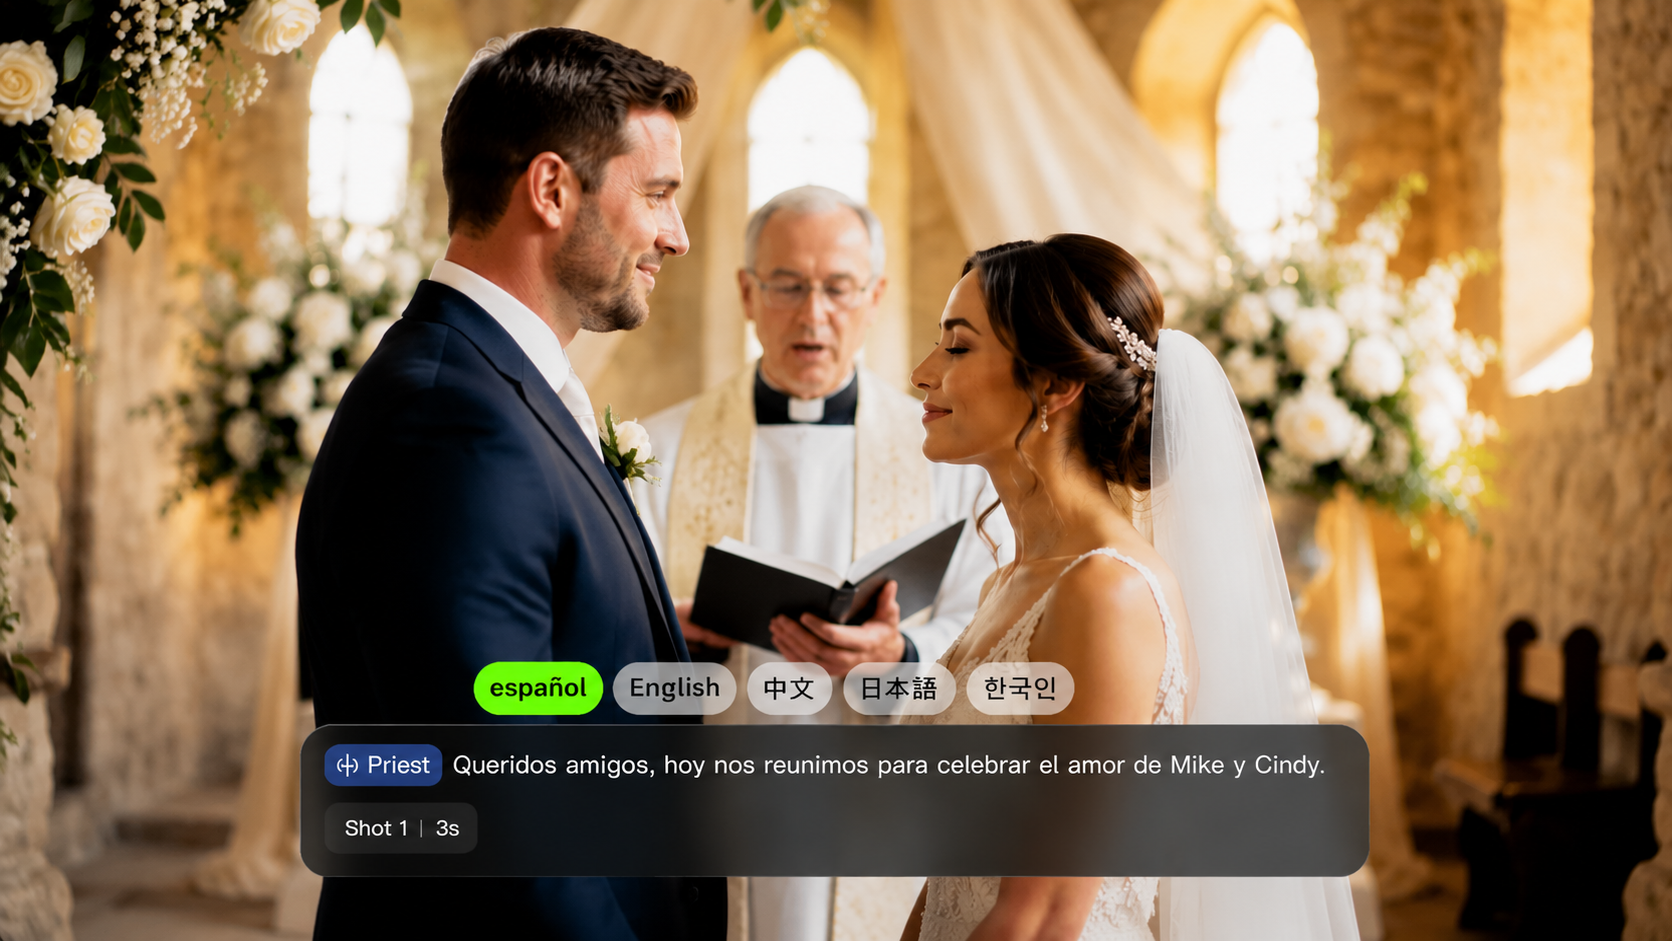
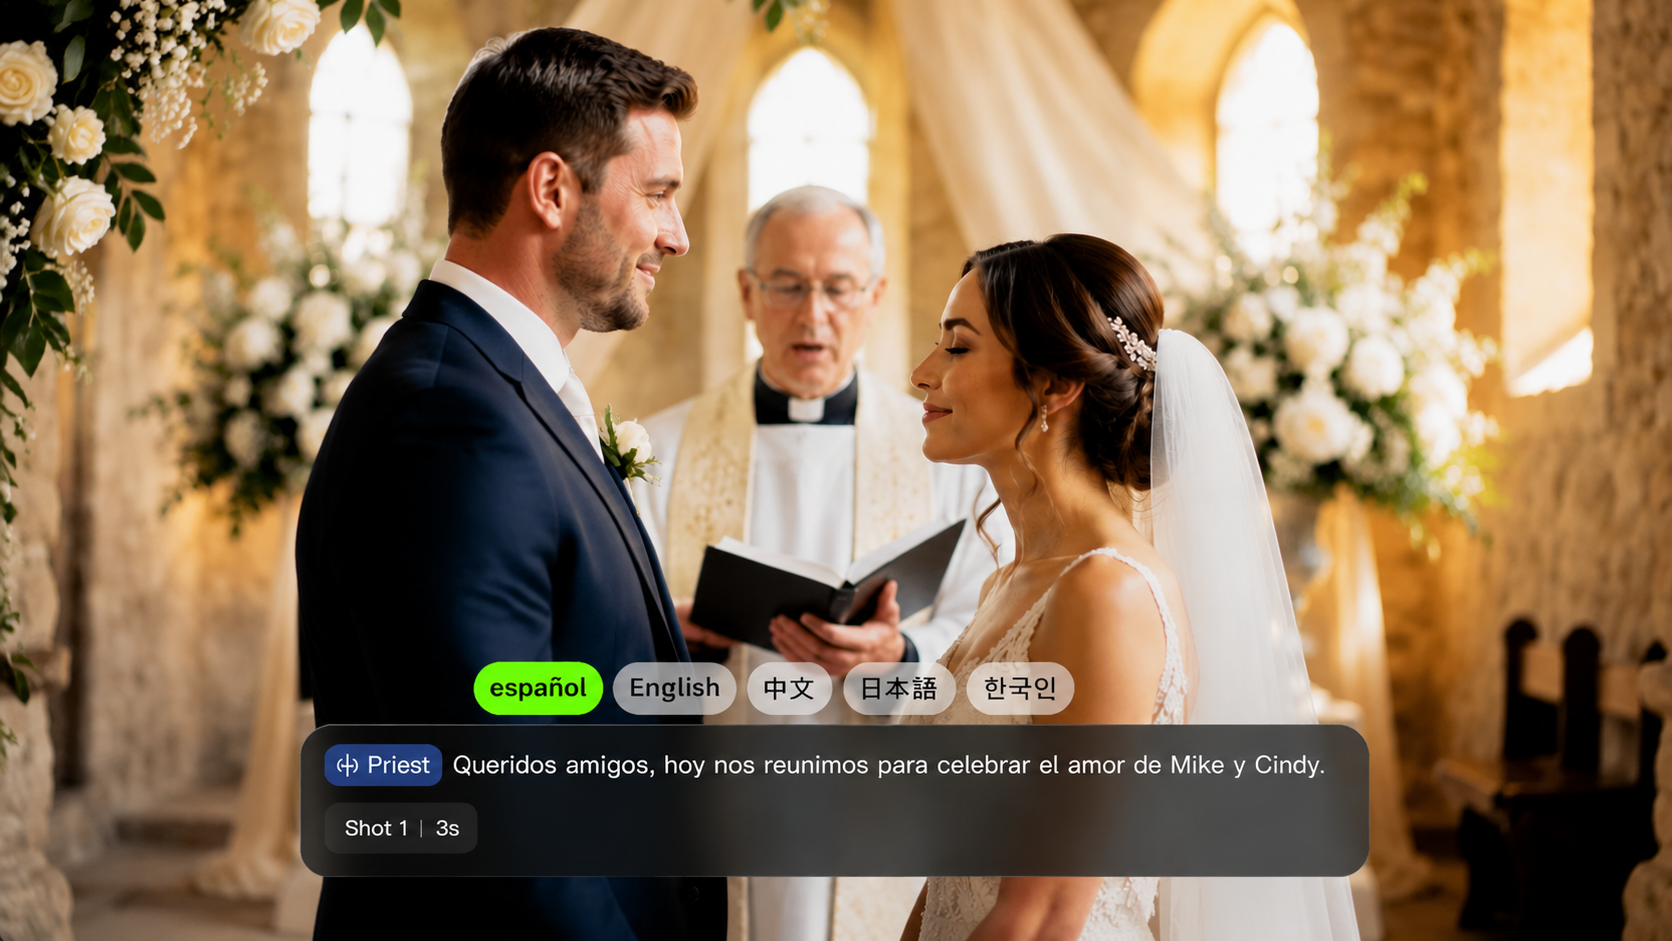
Für charaktergeführte Szenen erzeugt Kling 4.0 Audio und visuelle Elemente gleichzeitig, sodass Kreative Dialoge, Mimik, Gesten und Kameraführung innerhalb desselben Videos steuern können. Es unterstützt Dialoge in neun Sprachen – Chinesisch, Englisch, Japanisch, Koreanisch, Spanisch, Portugiesisch, Deutsch, Französisch und Hindi – und bietet eine verbesserte Lippen-Synchronisation, um gesprochene Passagen mit der Darstellung der Figuren zu verbinden.
Mit Omni Reference können Sie unterstützte Bilder, Videos, Elemente und Sprachreferenzen kombinieren, um das Aussehen und den Klang von Charakteren zu steuern. Für wiederkehrende Charaktere können Sie ein Charakter-Element mit definierten visuellen Merkmalen und einer gebundenen Stimme erstellen oder auswählen, wodurch über Szenen hinweg ein wiedererkennbares Erscheinungsbild und eine konsistente stimmliche Identität erhalten bleiben.
Über dialoggesteuerte Szenen hinaus unterstützt unser Kling 4.0-Modell Videos mit einer Länge von bis zu 30 Sekunden in einer einzigen Generierung, mit stabilerer großflächiger Bewegung und komplexen Kamerafahrten. Durch die Einbindung von Keyframe-Bildern in die Referenzmaterialien, um wichtige visuelle Momente zu steuern, können Kreative kohärentere Erzählungen gestalten und hochwertige KI-Videos mit mehr Kontrolle und Stabilität produzieren.

2. ElevenLabs: Am besten für Erzählungen und Charakter-Stimmspuren
ElevenLabs konzentriert sich auf die Produktion von gesprochenem Audio für Projekte wie Erzählungen, Fiktion und Charakterdialoge. Creator können mit ausgewählten Stimmen oder, sofern verfügbar, mit autorisierten Voice-Cloning-Funktionen arbeiten. Es eignet sich für Projekte, bei denen die Sprachspur das Hauptergebnis ist; prüfen Sie die gewünschte Sprache und die Lizenzbedingungen, bevor Sie sich auf einen Produktions-Workflow festlegen.
3.Murf AI: Am besten geeignet für Unternehmens- und Schulungs-Voiceovers
Murf AI bietet einen skriptzentrierten Voiceover-Workflow, der für Präsentationen, Schulungsmaterialien und Erklärvideos geeignet ist. Teams können die Erzählung vorbereiten, die Sprechweise anpassen und die Aufnahme zusammen mit einer strukturierten Botschaft überprüfen. Bestätigen Sie die verfügbaren Ausspracheoptionen und Exportrechte für die spezifische Stimme und den Tarif, den Sie nutzen möchten.
4.Speechify Studio: Am besten für einfache Creator-Voiceovers
Speechify Studio bietet eine browserbasierte Umgebung zur Erstellung von Voiceovers und vertonten Inhalten. Es eignet sich für unkomplizierte Creator-Videos oder Lehrmaterial, bei denen Skripteingabe und schnelle Überarbeitung wichtig sind. Prüfen Sie, welche Stimmen, Sprachen und Bearbeitungsoptionen im gewählten Produkt und Tarif enthalten sind.
5.Descript: Am besten für Sprachgenerierung in Verbindung mit Bearbeitung
Descript kombiniert Audio- und Videoprojekte mit transkriptbasierter Bearbeitung. Es ist hilfreich, wenn ein Podcast, Interview oder Voiceover wiederholte Skriptänderungen und Korrekturen durchläuft. Generierte Sprache und Austauschfunktionen haben eigene Zugriffs- und Autorisierungsanforderungen, daher sollten Sie Übergänge nach der Überarbeitung einer Aufnahme sorgfältig prüfen.
6.LOVO: Am besten für Marketing-Voiceovers und Multimedia-Projekte
Der Genny-Arbeitsbereich von LOVO kombiniert generierte Erzählungen mit Werkzeugen zum Zusammenstellen von Multimedia-Projekten. Das kann bei Marketing-Erklärvideos oder präsentationsähnlichen Videos helfen, die eine Sprachspur neben visuellen Elementen benötigen. Prüfen Sie die Ausgabeformate, Projektkontingente und Nutzungsbedingungen für Stimmen, die für Ihren Plan gelten.
Warum Kling 4.0 für KI-Videos mit Charakterdialog wählen?
Ein Audio-First-Tool kann eine gesprochene Spur erzeugen, aber charaktergeführte Videos benötigen auch, dass der Dialog zum Sprecher, zur Emotion, zur Handlung und zum Timing auf dem Bildschirm passt. Kling 4.0 bringt diese Elemente in einen nativen audio-visuellen Generierungs-Workflow ein und ermöglicht es Ihnen, Sprache und visuelle Performance gemeinsam zu dirigieren. In Kombination mit referenzgestützter Erstellung und präziserer narrativer Steuerung ist dieser Ansatz nützlich für mehrsprachige Gespräche, animierte Geschichten, wiederkehrende Charaktere und charaktergeführte Marketingvideos.
Mehrsprachige Dialoge mit passender Charakterdarstellung generieren
In Kling 4.0 können Sie beschreiben, wer spricht, was jede Figur sagt, wie sie reagiert und wie die Kamera das Gespräch in Szene setzt. Geben Sie die Sprache, den Tonfall, Pausen, Gesten und die emotionale Reaktion jedes Sprechers an, um der Szene ein stimmiges Gesamtbild zu verleihen. Das Modell unterstützt neun Sprachen und eine verbesserte Lippen-Synchronisierung, sodass gesprochene Dialoge besser zum Bildschirmauftritt der Figur passen.
Bei Szenen mit mehreren Figuren halten Sie die Zeilen jedes Sprechers getrennt und beschreiben Sie ihre Reaktionen der Reihe nach. Ein Tourist könnte beispielsweise eine Frage auf Spanisch stellen, ein Dolmetscher könnte sie ins Chinesische übersetzen und ein Mitarbeiter könnte auf Chinesisch antworten. Sie können das Gespräch und die Handlungen der Figuren im selben Prompt anleiten und anschließend die resultierende Sprache, Mundbewegungen und das Timing überprüfen.
Reference Image | Generated Video |
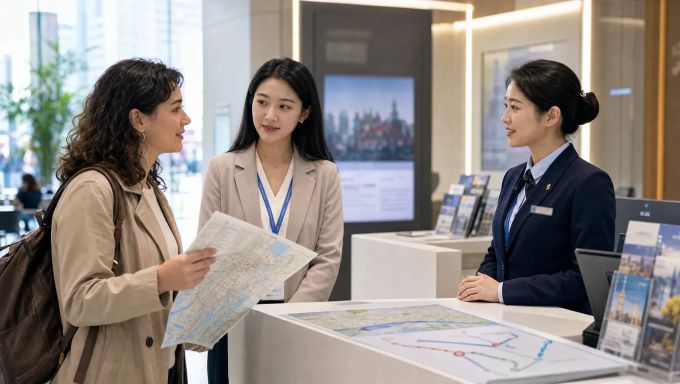 | 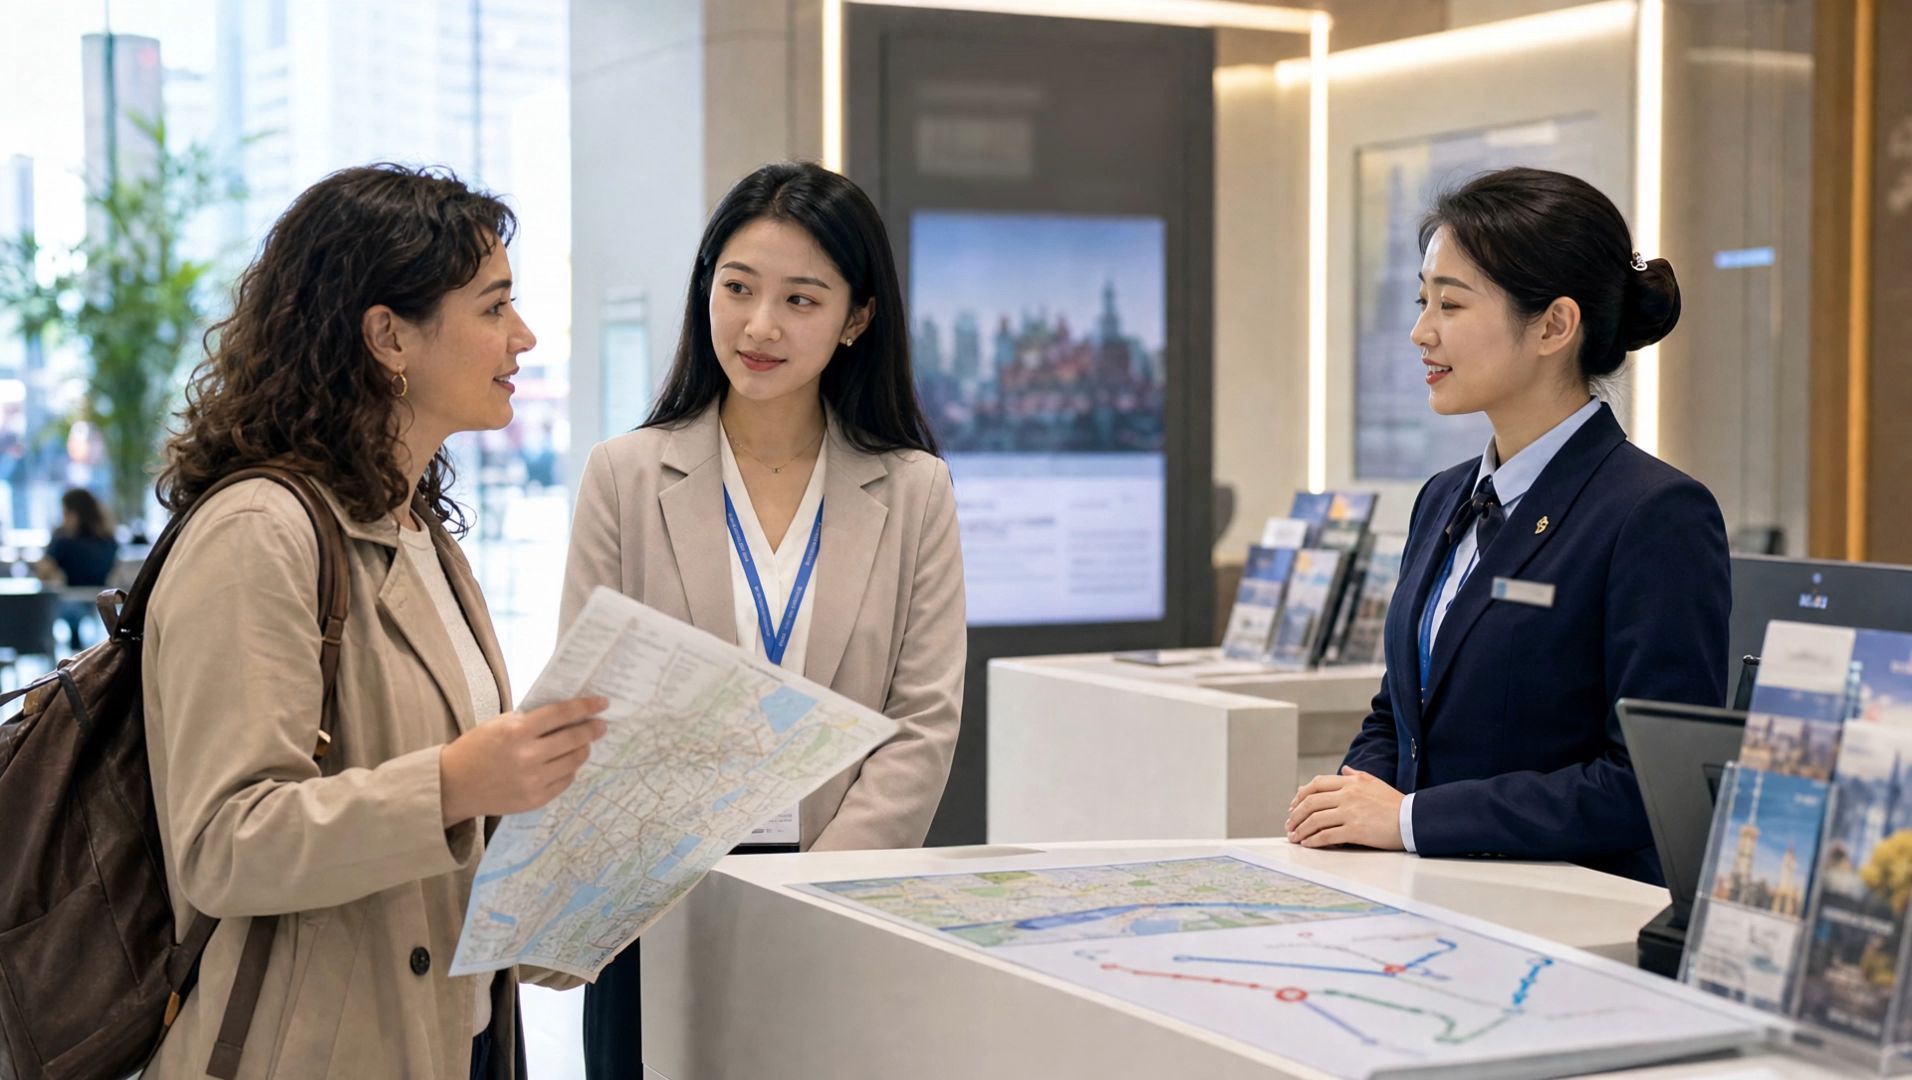 |
Prompt: SZENENKONTEXT GENAU 3 EINZIGARTIGE MENSCHLICHE CHARAKTERE IM GESAMTEN VIDEO: Drei Personen befinden sich in einem hellen, sauberen, fiktiven städtischen Touristeninformationszentrum. Halte die Farbtöne durchgehend konsistent. Die Touristin steht links, der Dolmetscher steht in der Mitte und der Mitarbeiter des Tourismusbüros steht rechts. Auf dem Informationsschalter liegen eine Stadtkarte und ein Streckenplan. Hintergrundtexte und Kartenbeschriftungen müssen unscharf und unleserlich sein. Es dürfen keine realen Marken, Organisationsnamen, Logos oder Wasserzeichen erscheinen. AKTIONSZEITPLAN: 0–3 Sekunden: Halbtotale aller drei Personen. Die spanische Touristin blickt den Dolmetscher in der Mitte an, hebt die Karte in ihrer Hand und spricht in natürlichem, klarem, leicht langsamem Spanisch: “¿Dónde está la estación de metro más cercana?” Nachdem sie ausgesprochen hat, etwa 0,5 Sekunden pausieren. Der Dolmetscher wendet sich dem Mitarbeiter des Tourismusbüros zu und übersetzt ins Chinesische: “她想知道最近的地铁站在哪里。” 3–7 Sekunden: Schnitt auf den Dolmetscher und den Mitarbeiter des Tourismusbüros. Der Mitarbeiter des Tourismusbüros blickt auf die Karte (keine Nahaufnahme der Karte verwenden) und antwortet in natürlichem, klarem Chinesisch: “沿这条路直走,步行大约五分钟就能到。” Nachdem der Mitarbeiter zu Ende gesprochen hat, etwa 0,5 Sekunden pausieren. Der Dolmetscher bestätigt das Verständnis und wendet sich der Touristin zu. 7–11 Sekunden: Der Dolmetscher überträgt die Antwort des Mitarbeiters in natürliches, klares, leicht langsames Spanisch: “La estación de metro está a unos cinco minutos a pie. Siga recto por esta calle.” Während er spricht, zeigt der Dolmetscher auf die Route auf der Karte, und der Tourist studiert sie aufmerksam. 11–15 Sekunden: Rückkehr zu einer Halbtotalen aller drei Personen. Nachdem der spanische Tourist die Wegbeschreibung verstanden hat, lächelt er, nickt und sagt auf Spanisch: “Muchas gracias.” Alle drei halten eine natürliche Service-Interaktion aufrecht, während die Szene endet. AUDIO: - Der spanische Tourist spricht nur Spanisch. - Der chinesische Tourismusmitarbeiter spricht nur Chinesisch. - Der chinesische Dolmetscher spricht zuerst Chinesisch, dann Spanisch. - Jede Person hat eine eigene Stimme. - Wenn eine Person spricht, bleiben die anderen still. Keine Unterbrechungen oder überlappenden Dialoge. - Sämtlicher Dialog muss klare Vocals haben, mit Lippenbewegungen, die mit der jeweiligen Sprache synchronisiert sind. - Die spanische Aussprache muss natürlich und standardmäßig sein, ohne englisch gefärbte Aussprache. - Die Sprechweise sollte leicht verlangsamt sein, mit natürlichen Pausen zwischen den Sätzen. - Behalten Sie subtile Umgebungsgeräusche eines Touristeninformationszentrums bei. Fügen Sie keine Hintergrundmusik hinzu. Die Umgebungsgeräusche dürfen den Dialog nicht übertönen. KAMERA: Beginnen Sie mit einer Halbtotale aller drei Personen, um ihre Beziehungen zu etablieren. Wenn der Tourist spricht, schneiden Sie auf eine Zweier-Einstellung des Touristen und des Dolmetschers. Wenn der Dolmetscher die Frage weitergibt, schneiden Sie auf den Dolmetscher und das Personalmitglied. Während das Personalmitglied antwortet, fügen Sie eine Nahaufnahme der Streckenführung auf der Karte ein. Wenn der Dolmetscher ins Spanische übersetzt, kehren Sie zu einer Zweier-Einstellung von Dolmetscher und Tourist zurück. Beenden Sie mit einer Halbtotale aller drei Personen. Halten Sie während der gesamten Szene die Positionen der Personen, die Blickrichtungen und die Kleidung konsistent. Ersetzen Sie keine Figuren abrupt und verändern Sie nicht ihre räumlichen Beziehungen. STIL: Realistischer, natürlicher, professioneller Reisedokumentationsstil. Helle, saubere Beleuchtung, natürliche Gesichtsausdrücke und zurückhaltende Bewegungen. Die Szene sollte einer authentischen Interaktion an einem Flughafen oder in einem städtischen Touristeninformationszentrum ähneln. | |
Verbinde das Aussehen und die Stimme von Charakteren mit Omni Reference
Omni Reference unterstützt bis zu 15 kombinierte Referenz-Assets in einer einzelnen Generierung, darunter bis zu 10 Bilder, bis zu 5 Videos mit einer Gesamtdauer von höchstens 30 Sekunden sowie bis zu 7 Elements, einschließlich bis zu 3 Video Elements. Sprachreferenzen werden ebenfalls innerhalb dieses kombinierten Asset-Limits unterstützt.
Für wiederkehrende Charaktere kannst du ein Charakter-Element mit festgelegten visuellen Merkmalen erstellen oder auswählen und beim Einrichten des Elements eine Stimme zuweisen. Wenn du dieses Element in einem unterstützten Generierungs-Workflow erneut verwendest, hilft es, sowohl das Aussehen als auch die stimmliche Identität der Figur zu steuern. Du kannst außerdem anderen Referenzen spezifische Rollen zuweisen, etwa um das Setting zu definieren, Bewegungen zu leiten oder Anweisungen für die Kamera zu geben. Klare Referenzrollen helfen dem Modell, deiner Absicht zuverlässiger zu folgen, dennoch sollte das Endergebnis überprüft werden.
Steuere längere Aktionen, Kamerabewegungen und Story-Beats
Unser Modell Kling 4.0 unterstützt Videos, die in einem einzigen Durchgang erzeugt werden, mit einer Länge von bis zu 30 Sekunden und gibt Figurendialogen, Reaktionen und Aktionen mehr Raum, sich zu entfalten. Stabilere groß angelegte Bewegungen und komplexe Kamerafahrten helfen dabei, flüssigere, kohärentere Szenen zu erzeugen.
Für längere Geschichten ermöglicht unser Timeline-Workflow, generierte Clips zu kombinieren, Aufnahmen zu kürzen oder zu ersetzen und die Sequenz vorzuschauen. Sie können außerdem gezielte Bearbeitungen an vorhandenem Filmmaterial vornehmen und Ihr Video verfeinern, ohne jede Szene von Grund auf neu erstellen zu müssen.
So erstellen Sie ein KI-Video mit Figurendialogen
Wenn Sie Charakterdialoge generieren möchten, ohne eine eigenständige Audiodatei herunterzuladen, bietet Kling AI einen videofokussierten Workflow. Mit Kling 4.0 können Sie Charakterreferenzen vorbereiten, Dialoge und visuelle Darbietungen über Prompts steuern und die vollständige Szene vor dem Export überprüfen.
Schritt 1. Videogenerierung öffnen und Charakterreferenzen vorbereiten
Öffne den Arbeitsbereich für die Videoerstellung von Kling AI und wähle Kling 4.0. Wenn du planst, eine Figur wiederzuverwenden, erstelle oder wähle ein Charakter-Element, definiere sein Erscheinungsbild und verknüpfe die vorgesehene Stimme, sofern unterstützt. Füge das Element sowie alle relevanten Einstellungen, Bewegungs- oder Sprachreferenzen über Omni Reference hinzu und bleib innerhalb des kombinierten Limits von 15 Referenz-Assets. Du kannst auch nur mit einem Prompt starten, wenn keine Referenzen benötigt werden.
Schritt 2. Schreibe für jede Sprecherin und jeden Sprecher sowie jede Aktion einen Prompt
Gib an, wer spricht, den genauen Dialog, die gewünschte Sprache sowie den Tonfall und die Emotion der Figur. Beschreibe auch Pausen, Gesten, Reaktionen und Kamerabewegungen. Weise jeder Referenz eine klare Rolle zu, damit das Modell weiß, welchen Details es folgen soll.
| Prompt: @Element1 definiert das Aussehen der Figur und die zugewiesene Stimme. @Image1 definiert die Buchhandlungskulisse. Die Figur sieht sich ein leeres Ausstellungsregal an, hält inne und sagt in natürlichem Englisch: "The last copy is already gone," mit enttäuschtem Ausdruck. Die Kamera fährt langsam heran. Halte die prägenden visuellen Merkmale der Figur konsistent. |
Schritt 3. Generieren, Prüfen und Verfeinern
Erstelle einen Entwurf und überprüfe Sprache und Visuals gemeinsam. Prüfe die Zeilen jeder Figur, Aussprache, Sprache, Mundbewegungen, Timing, Gesichtsausdrücke sowie die Konsistenz von Erscheinungsbild und Stimme. Überprüfe außerdem größere Bewegungen und Kameraübergänge. Wenn sich eine Zeile gehetzt anfühlt oder eine Reaktion unklar ist, vereinfache den Prompt oder passe die Referenzrollen an, bevor du einen weiteren Take erzeugst. Exportiere erst, nachdem du den vollständigen Clip und die verfügbaren Ausgabeoptionen überprüft hast.
Wie man die Qualität einer KI-Stimme vor der Veröffentlichung prüft
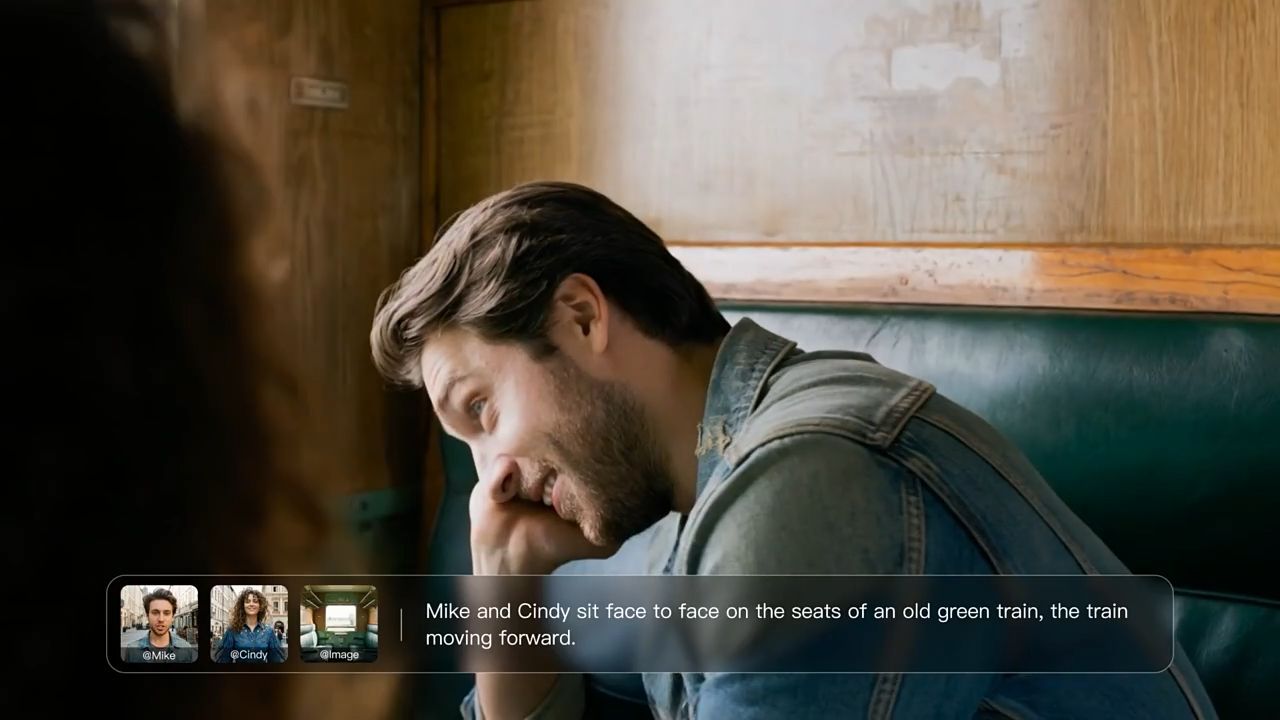
Für professionelle Projekte sollten Sie die mit Stimmen, Ausgangsaufnahmen und identifizierbaren Ebenbildern verbundenen Rechte prüfen. Die Erlaubnis, eine Aufnahme zu verwenden, umfasst nicht automatisch die Erlaubnis, den Sprecher zu klonen. Wenn generierte Dialoge mit den Worten einer realen Person verwechselt werden könnten, überprüfen Sie die geltenden Anforderungen an Einwilligung und Offenlegung. Wenn Sie Dialoge oder die Darstellung einer Figur in einem bestehenden Clip anpassen müssen, kann Ihnen unser KI-Video-Editor helfen, gezielte Änderungen vorzunehmen. Überprüfen Sie das Ergebnis immer, bevor Sie es veröffentlichen.
Was zu prüfen ist | Worauf Sie hören oder achten sollten | Praktische Lösung |
Aussprache | Namen und unbekannte Wörter | Formulieren Sie den Ausdruck um oder nutzen Sie die Aussprachekontrollen, falls verfügbar |
Tempo | Überhastete Sprache oder unbeholfene Pausen | Kürzen Sie den Satz oder passen Sie die Pausen an |
Ausdruck | Betonung, die die Bedeutung verändert | Kläre die beabsichtigte Emotion des Charakters |
Konsistenz | Verleihe dem Charakter über einen längeren Abschnitt hinweg eine Stimme | Vergleiche den Anfang und das Ende der Ausgabe |
Video-Dialog | Ob die Worte zu Gesten und Gesichtsausdrücken passen | Überprüfen Sie die gesamte Szene und verfeinern Sie ihre Ausrichtung |
Das Ende
Der beste KI-Stimmgenerator hängt davon ab, ob Sie einen gesprochenen Track erstellen, vorhandenes Audio überarbeiten oder eine Figur erschaffen, die auf dem Bildschirm spricht. Die sechs oben genannten Tools unterstützen unterschiedliche Teile dieser Arbeit. Wenn Ihr Projekt Dialog, Figurenaktion und visuelle Elemente gemeinsam entwickeln muss, bietet Kling 4.0 eine referenzgestützte Möglichkeit, die Szene aufzubauen und alternative Darbietungen zu testen.
FAQs
Ist Voice Cloning illegal?
Stimmenklonen ist nicht per se illegal. Es kann Sie jedoch in rechtliche Schwierigkeiten bringen, wenn Sie die Stimme einer Person ohne deren Einwilligung verwenden. Die Regeln unterscheiden sich je nach Land und Region und betreffen häufig Datenschutz, Persönlichkeitsrechte, Identitätsmissbrauch oder irreführende kommerzielle Nutzung. Es gibt eine klare Grenze zwischen dem Klonen einer Stimme für ein Projekt, für das Sie eine Genehmigung erhalten haben, und dem Erzeugen von Audio, das eine reale Person Dinge sagen lässt, die sie nie gesagt hat. Prüfen Sie stets die lokalen Vorschriften und holen Sie eine ordnungsgemäße Zustimmung ein, bevor Sie eine erkennbare menschliche Stimme verwenden.
Können KI-Stimmen lachen, flüstern oder Emotionen zeigen?
Viele KI-Sprachmodelle können ausdrucksstarke Elemente wie Lachen, leises Flüstern, aufgeregte Tonlagen oder sogar Traurigkeit erzeugen. Wie viel Kontrolle Sie haben, hängt davon ab, welches Tool Sie verwenden; einige erlauben es Ihnen, beschreibende Prompts, Performance-Markierungen hinzuzufügen oder Stimmparameter anzupassen. Denken Sie daran, dass jedes Modell unterschiedlich auf Anweisungen reagiert. Es ist sinnvoll, zunächst einen kurzen Ausschnitt zu testen, damit Sie sicherstellen können, dass die Emotion natürlich ankommt, statt die Aufmerksamkeit von dem abzulenken, was Sie vermitteln möchten.
Kann ein KI-Stimmen-Generator verschiedene Stimmen für mehrere Charaktere erzeugen?
Einige KI-Stimmen-Generatoren unterstützen mehrere Sprecher, aber die Fähigkeiten variieren je nach Tool. Bei Kling AI können Sie im Prompt den Dialog, die Sprache, den Ton und die Reaktionen jeder Figur beschreiben. Für wiederkehrende Figuren können Sie ein Element erstellen oder auswählen und eine Stimme daran binden, um eine wiedererkennbare stimmliche Identität zu etablieren. Überprüfen Sie den generierten Dialog, das Timing und die Aktionen der Figuren, um sicherzustellen, dass jeder Sprecher unverwechselbar bleibt.
Was ist der Unterschied zwischen einem KI-Sprachgenerator und einem KI-Stimmenveränderer?
Ein KI-Sprachgenerator erzeugt neues Audio, während ein KI-Stimmenveränderer eine vorhandene Sprachaufnahme verändert. Bei Kling AI kannst du Hintergrundgeräusche in deiner Eingabeaufforderung beschreiben. Für Charakterstimmen kannst du ein Element erstellen oder auswählen und eine Stimme zuweisen, um die vokale Identität der Figur zu etablieren. Mit Kling 4.0 kannst du außerdem Dialoge zusammen mit visuellen Inhalten generieren und dabei Charakterrede, Aktionen und Ausdrücke im selben Video kombinieren. Wenn du eine vorhandene Sprachaufnahme verändern möchtest, ist ein KI-Stimmenveränderer möglicherweise besser geeignet.
Können KI-Sprachgeneratoren in Videos natürlich klingende Dialoge erzeugen?
Ja. Einige KI-Sprachgeneratoren konzentrieren sich auf eigenständige Audios, während KI-Video-Generatoren Dialoge parallel zu Charakterdarstellungen und visuellen Elementen erzeugen können. Bei Kling AI unterstützt unser Modell Kling 4.0 die native audio-visuelle Generierung in neun Sprachen und bietet eine verbesserte Lippen-Synchronisation, um Sprache mit Aktionen auf dem Bildschirm zu verbinden. Für natürlichere Ergebnisse beschreiben Sie in Ihrem Prompt den Ton, die Emotionen, Pausen und Reaktionen jeder Figur und prüfen anschließend den erzeugten Dialog sowie das Timing.