Apakah Anda pernah menghabiskan berjam-jam merencanakan sebuah cerita dan pengambilan gambarnya, hanya untuk melihat wajah karakter berubah antar adegan atau aksi penting menghilang? Video AI dapat mewujudkan ide Anda, tetapi perbaikan berulang bisa menyita waktu yang ingin Anda hemat. Kami akan menguraikan enam keterbatasan teknologi pembuatan video AI saat ini, solusi praktis, dan di mana Kling VIDEO 3.0 series dapat membantu.
Apa Saja Keterbatasan Teknologi Pembuatan Video AI Saat Ini?
Video AI kini dapat menangani adegan yang lebih kompleks, tetapi konsistensi, gerakan, teks, dan kontrol presisi masih bisa rusak saat generasi berlangsung. Dari mempertahankan konsistensi visual antar frame hingga mengendalikan gerakan dan detail, keterbatasan ini terus memengaruhi bagaimana kreator menggunakan AI dalam produksi video.
Tabel di bawah ini menunjukkan di mana pembuatan video AI saat ini masih kurang, bagaimana masalah tersebut muncul dalam proyek nyata, dan apa yang dapat Anda lakukan untuk menyiasatinya.
Keterbatasan | Tantangan Teknis | Apa yang Terjadi | Solusi Cepat |
Konsistensi Temporal Terbatas dan Koherensi Frame | Model harus mempertahankan pencahayaan, tata letak, tekstur, dan informasi visual lainnya di seluruh frame berturut-turut saat subjek dan kamera bergerak. | Pencahayaan dapat bergeser, objek latar belakang dapat melayang, properti kecil dapat menghilang, dan tekstur atau garis tubuh dapat berkelap-kelip selama pengambilan gambar. | Pertahankan setiap bidikan terfokus pada satu aksi utama. Untuk adegan yang lebih kompleks, gunakan klip yang lebih pendek dan gambar referensi untuk menjaga latar dan komposisi tetap stabil. |
Konsistensi Karakter dan Objek di Seluruh Shot | Shot yang dihasilkan secara terpisah harus menciptakan kembali identitas subjek, penampilan, dan detail desain yang sama setiap saat. | Wajah, gaya rambut, pakaian, aksesori, bentuk produk, warna, atau detail permukaan dapat berubah dari satu shot ke shot berikutnya. | Gunakan kembali gambar referensi yang sama dan pertahankan detail penentu agar konsisten. Hindari mengubah pencahayaan, sudut kamera, penataan, dan lingkungan secara bersamaan. |
Fisika dan Gerakan yang Tidak Realistis | Model harus menjaga mekanika tubuh, kontak objek, hubungan spasial, dan perilaku material tetap meyakinkan seiring waktu. | Tangan dapat menembus objek, pergerakan bisa terasa tanpa bobot, tabrakan bisa terlihat tidak tepat, dan kain, air, rambut, atau gerakan kamera cepat dapat berperilaku tidak alami. | Pisahkan tindakan yang rumit menjadi beat terpisah. Jelaskan gerakan subjek dan gerakan kamera secara terpisah alih-alih menggabungkan keduanya dalam satu instruksi. |
Pembuatan Video Format Panjang Terbatas | Sebuah urutan yang lebih panjang harus mempertahankan karakter, lokasi, properti, gaya visual, timing, dan logika cerita di banyak bidikan. | Karakter atau lokasi dapat bergeser, properti bisa menghilang, jeda kontinuitas menjadi lebih terlihat, dan adegan bisa terasa terputus ketika video semakin panjang. | Bekerjalah dari storyboard atau daftar bidikan, gunakan kembali referensi visual, dan hasilkan proyek per adegan. Tangani ritme, transisi, dan penyusunan akhir saat penyuntingan. |
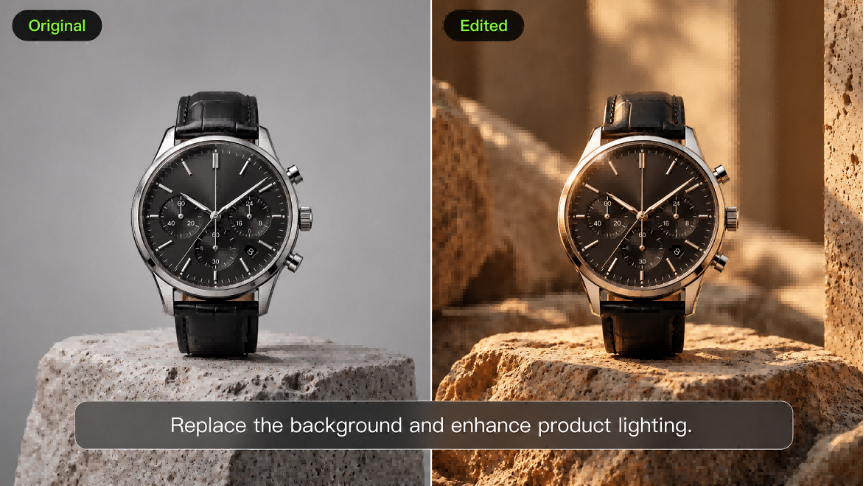
Kesulitan dalam Detail Halus dan Pembuatan Teks | Bentuk kecil, tipografi, logo, dan detail produk memerlukan konsistensi spasial yang tepat dari frame ke frame. | Jari bisa melengkung, teks dapat salah eja atau terdistorsi, logo bisa bergeser, dan fitur produk kecil dapat berubah selama pergerakan. | Tambahkan teks, logo, caption, dan elemen merek tetap lainnya pada tahap pascaproduksi. Untuk pengambilan gambar produk, gunakan referensi yang jelas dan jaga pembingkaian tetap relatif sederhana. |
Kontrol Prompt dan Kustomisasi Terbatas | Kontrol berbasis prompt bersifat tidak langsung, sehingga mengubah satu instruksi juga dapat memengaruhi bagian lain dari bidikan yang dihasilkan. | Model ini mungkin mengikuti beberapa arahan secara ketat sambil mengubah pembingkaian, latar belakang, waktu, atau penampilan subjek dengan cara yang tidak Anda minta. | Tentukan subjek dan tampilan keseluruhan terlebih dahulu, lalu perhalus gerakan, pembingkaian, dan waktu dalam langkah-langkah kecil. Buat beberapa variasi pendek alih-alih memasukkan setiap kebutuhan ke dalam satu prompt panjang. |
Bagaimana Kling AI Video Generator Membantu Mengatasi Keterbatasan Ini
Kling AI Video Generator menghadirkan kontrol kreatif dan produksi yang lebih besar ke dalam pembuatan video AI, sehingga memudahkan pengembangan pengambilan gambar yang saling terhubung, subjek berulang, dialog, dan cerita visual yang lebih kompleks. Di seluruh VIDEO 3.0 dan VIDEO 3.0 Omni, para kreator dapat bekerja dengan konsistensi subjek berbasis referensi, Multi-Shot dan Custom Multi-Shot, Motion Control, generasi fleksibel 3–15 detik, Native-Level Text Output, dan Native Audio untuk mendukung pembuatan video sinematik profesional.
Pertahankan Karakter dan Produk Tetap Konsisten di Setiap Pengambilan Gambar
Ketika orang, produk, atau properti penting yang sama muncul di beberapa bidikan, menjaga agar fitur penentunya tetap mudah dikenali bisa sulit jika setiap bidikan dihasilkan dari deskripsi baru. Kling VIDEO 3.0 Series menyediakan alur kerja berbasis referensi yang memberikan model lebih banyak informasi visual tentang subjek berulang dan membantu mengurangi perubahan yang tidak diinginkan antar bidikan.
Dengan Kling VIDEO 3.0, Anda dapat menggunakan beberapa gambar referensi untuk memberikan pandangan berbeda dari karakter, produk, atau objek yang sama. Untuk karakter, sudut depan, samping, dan sudut berguna lainnya dapat memberi model lebih banyak informasi tentang struktur wajah, gaya rambut, pakaian, dan fitur yang mudah dikenali. Untuk produk atau properti penting, tampilan tambahan dapat menangkap detail yang mungkin terlewat oleh satu gambar depan, seperti bentuk, proporsi, material, detail samping, atau fitur permukaan.
Untuk proyek yang membutuhkan subjek yang dapat digunakan kembali di berbagai cuplikan dan adegan, Kling VIDEO 3.0 Omni menyediakan alur kerja Referensi Elemen. Anda dapat membangun sebuah Elemen dari gambar multi-sudut atau video karakter pendek, kemudian merujuk Elemen itu lagi saat adegan, sudut kamera, atau konten sekitarnya berubah. Elemen karakter juga dapat menyertakan informasi suara, membantu karakter berulang mempertahankan ciri visual yang mudah dikenali dan suara yang konsisten di seluruh adegan terkait.
Dalam kedua alur kerja, informasi referensi yang lebih kuat dapat mengurangi pengulangan yang disebabkan oleh wajah yang berubah, aksesori yang menghilang, atau produk yang melenceng dari desain yang dimaksudkan.
Contoh Penggunaan Kling VIDEO 3.0
Frame Awal | ||
Referensi Gambar | ||
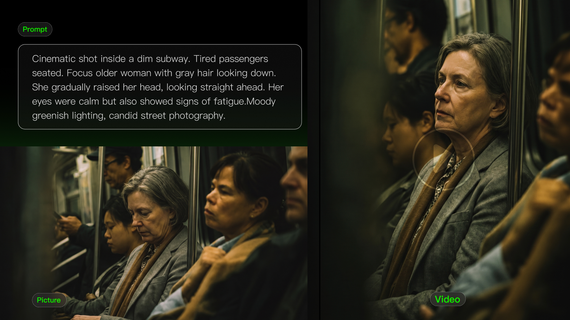
| Prompt: Kamera perlahan bergerak mengitari ke bagian depan gadis itu, yang kemudian mengangkat kepalanya dan tersenyum hangat ke arah kamera, seolah-olah melihat sahabat lama setelah bertahun-tahun. | ||
Video | ||
Contoh Penggunaan Kling VIDEO 3.0 Omni
Gambar Elemen/Referensi | |
@Shirt Boy | @Image1 |
Bidikan medium, tampak depan Prompt: @Shirt Boy berjalan menuruni lereng dan duduk di dekat tiang di @image. Close-up, wajah: @Shirt Boy bersandar pada tiang dan berkata, "Angin hari ini terasa lebih lembut daripada kemarin… bahkan rumput pun terasa lembut." Tampilan sinematik @image1. Close-up samping, wajah: @Shirt Boy memejamkan mata ketika sinar matahari jatuh lembut di wajahnya. Bidikan dari atas: @Shirt Boy berbaring telentang, rumput menutupi kausnya, kedua tangan di belakang kepala, menatap langit biru sambil berkata, "Aku berharap musim panas seperti ini tidak pernah berakhir."
| |
Video | |
Arahkan Gerakan Karakter Kompleks dengan Lebih Presisi
Untuk tindakan sehari-hari, Anda dapat menjelaskan apa yang harus dilakukan karakter dalam prompt, termasuk tempo, gerakan tubuh, dan perubahan ekspresi. Kling memiliki generator video AI yang dapat mengubah arahan tersebut menjadi gerakan, tetapi teks menjadi kurang presisi ketika sebuah bidikan memerlukan putaran tertentu, gestur, gerakan dansa, atau rangkaian ekspresi.
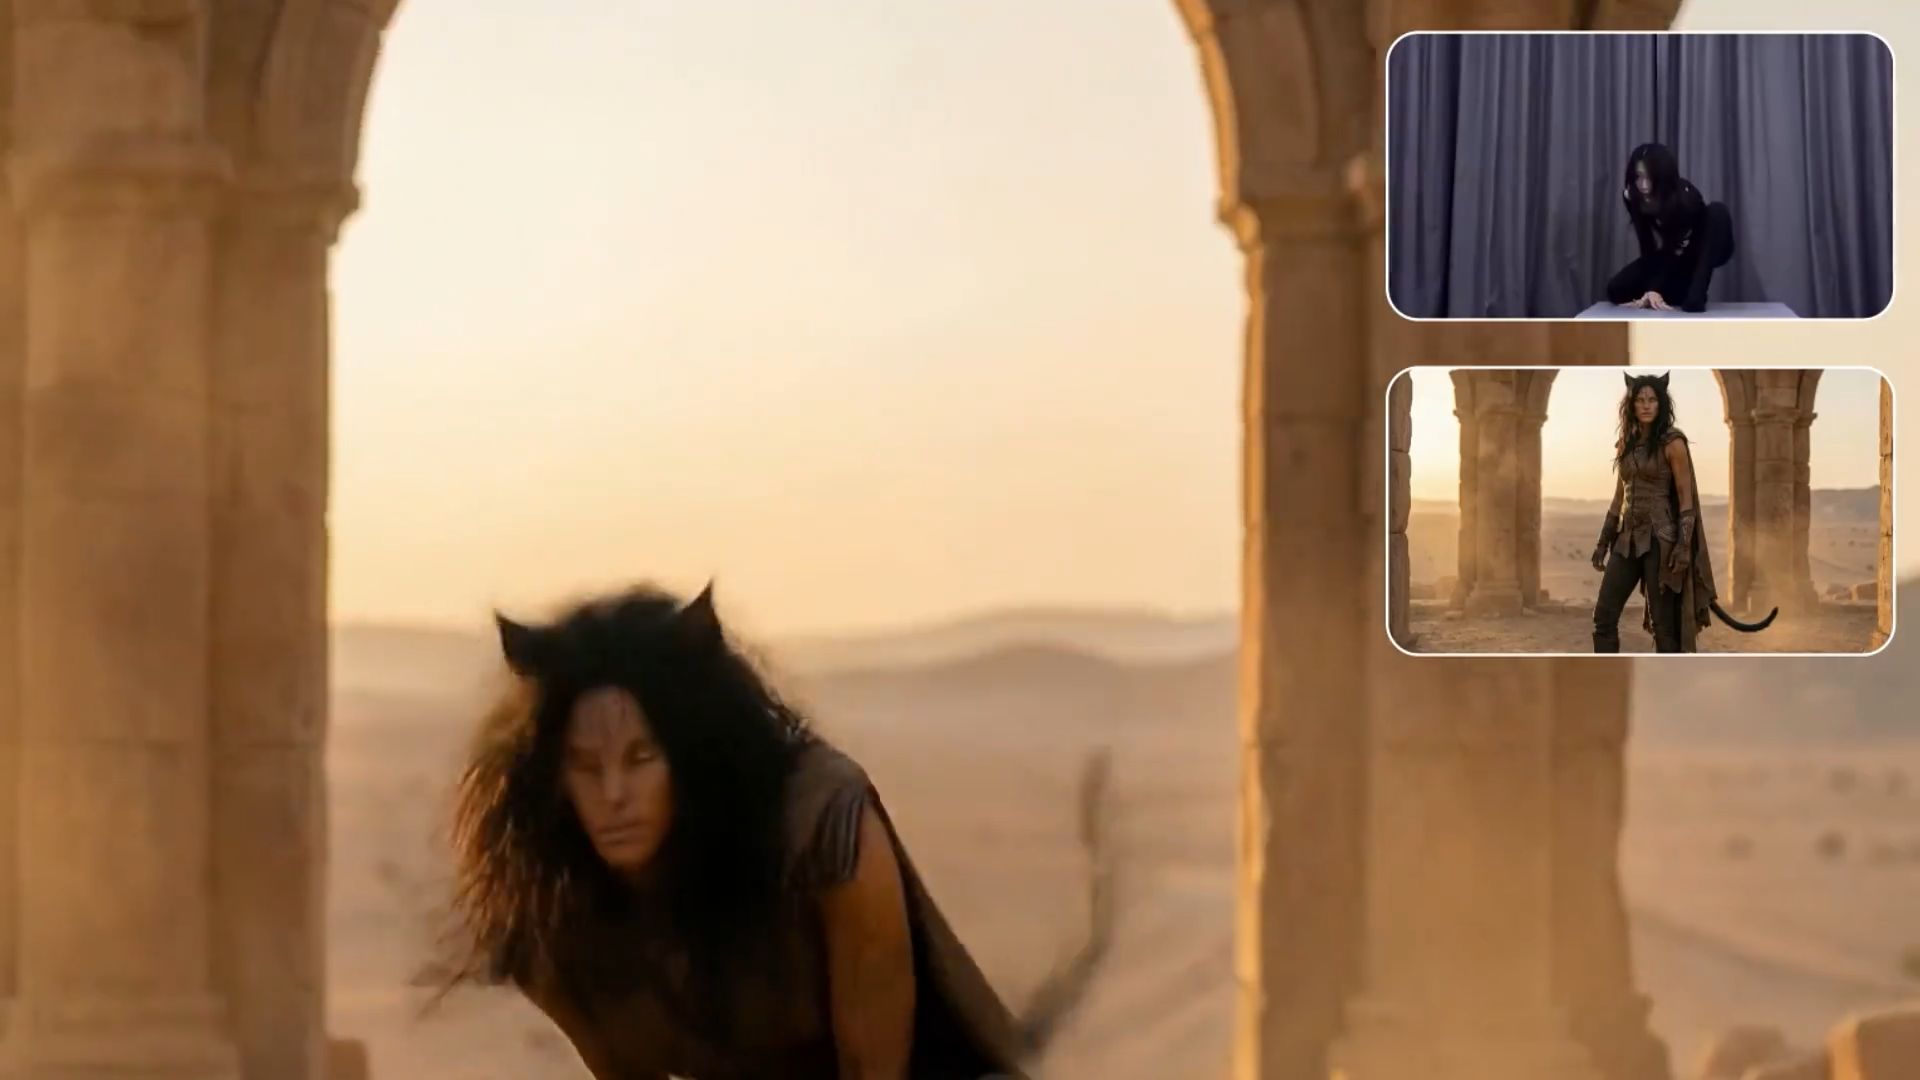
Untuk tingkat detail seperti itu, Motion Control berfungsi berdasarkan referensi gerakan sebagai gantinya. Unggah video gerak atau pilih sebuah aksi dari perpustakaan gerak, lalu terapkan gerakan dan ekspresinya pada karakter Anda. Kling VIDEO 3.0 Motion Control juga meningkatkan konsistensi wajah dalam gerakan yang kompleks, multi-sudut, dan berdurasi lebih lama. Memulai dari gerakan yang Anda inginkan sering kali lebih mudah daripada menulis ulang prompt berkali-kali untuk mendapatkan performa spesifik yang tepat.

Bangun dan Arahkan Pengambilan Gambar yang Saling Terhubung
Sebuah adegan jarang berhasil dari satu sudut kamera saja. Anda mungkin memulai dengan bidikan lebar, memotong lebih dekat, lalu beralih ke reaksi. Dengan Multi-Shot, Kling VIDEO 3.0 Series dapat merencanakan pembingkaian dan perpindahan kamera dalam urutan yang sama.
Jika Anda sudah tahu bagaimana adegan harus dipecah, Custom Multi-Shot memungkinkan Anda mengatur konten dan durasi setiap shot sendiri. Hal itu memudahkan Anda membentuk tempo tanpa menjejalkan setiap instruksi ke dalam satu prompt panjang atau menjahit sekelompok klip yang tidak saling terkait di kemudian hari.
Gambar Referensi | |||
Referensi Karakter | |||
Prompt | |||
| Pengambilan gambar 1 (3 dtk): Close-up di panggung komedi open-mic (lihat gambar referensi), dengan tanda neon retro besar "KLING" di latar belakang. Cahaya belakang keemasan yang hangat membingkai adegan. Kamera mengikuti penampil saat mereka berjalan ke mikrofon dan melakukan penyesuaian tinggi kecil. | |||
| Pengambilan gambar 2 (4 dtk): Close-up medium dari @Little Scholar, yang berkata, "Aku benar-benar kalah dari Kid—seberapa banyak pengalaman kerja yang dia punya?—yang sedang mengajari semua orang cara bahagia di tempat kerja." | |||
| Pengambilan gambar 3 (4 dtk): @Little Scholar, mengenakan senyum tertahan dan halus, berhenti sejenak secara alami dan berkata, "Dengar saja ini: dia menghabiskan lima menit berdebat untuk premis yang begitu palsu." | |||
| Bidikan 4 (2 detik): Potong ke penonton yang tertawa terbahak-bahak. | |||
Video | |||
Berikan Cerita Pendek Lebih Banyak Ruang untuk Berkembang
Kling VIDEO 3.0 Series dapat menghasilkan klip dari 3 hingga 15 detik, memberikan lebih banyak waktu bagi sebuah adegan pendek untuk karakter masuk, berbicara, bereaksi, atau bergerak melalui beberapa beat cerita tanpa harus dipecah menjadi serangkaian klip kecil. Dipadukan dengan Multi-Shot, waktu tambahan itu sangat cocok untuk iklan pendek, adegan dialog, dan momen berfokus karakter di mana ritme adegan sama pentingnya dengan visualnya.
Buat Teks di Layar dan Salinan Merek Tetap Lebih Mudah Digunakan
Teks dapat cepat berantakan begitu sebuah adegan mulai bergerak. Label dapat terdistorsi, huruf bisa hilang, dan tanda atau logo dapat bergeser dari satu frame ke frame berikutnya.
Dengan Native-Level Text Output, VIDEO 3.0 Series melakukan pekerjaan yang lebih baik dalam menjaga papan tanda, teks keterangan, label, dan teks lainnya tetap terbaca saat pengambilan gambar berubah. Untuk iklan dan video produk, itu berarti lebih sedikit pengambilan gambar yang dapat digunakan hilang karena salinan yang terdistorsi atau branding yang tidak terbaca. Logo yang presisi dan aset merek terkunci tetap lebih aman ditambahkan pada tahap pascaproduksi saat presisi penting.
Gambar |
Video |
Satukan Dialog dan Suara dalam Alur Kerja yang Sama
Dengan Native Audio, Seri VIDEO 3.0 dapat menghasilkan adegan dan dialog secara bersamaan, termasuk percakapan multi-karakter dalam bahasa Mandarin, Inggris, Jepang, Korea, dan Spanyol. Alih-alih membuat klip tanpa suara terlebih dahulu lalu menangani suara, penentuan waktu, dan sinkronisasi bibir setelahnya, Anda dapat merencanakan siapa yang berbicara, apa yang mereka katakan, dan bagaimana pengambilan gambar berlangsung sejak awal. Ini sangat berguna untuk film pendek yang digerakkan oleh dialog dan adegan multi-karakter, di mana ucapan dan penampilan karakter perlu tetap sinkron.
Gambar |
Prompt: Di sebuah stasiun kecil yang diselimuti kabut pagi, anak laki-laki itu tersenyum dan menyerahkan bento: "Aku membuatnya buru-buru, tidak apa-apa? Ini resep Ibu." Gadis itu menerimanya sambil tersenyum: "Ya, pasti enak! Aku akan LINE begitu tiba." |
Video |
Tamat
Baik Anda membuat iklan produk, film pendek berbasis dialog, atau cerita multi-shot, keterbatasan teknologi pembuatan video AI saat ini sering muncul dengan cara yang familiar: karakter berubah antar pengambilan gambar, gerakan terasa janggal, teks terpecah, atau sebuah adegan membutuhkan beberapa percobaan untuk menjadi tepat. Referensi yang jelas, perencanaan pengambilan yang lebih singkat, dan kontrol yang dipilih sesuai kebutuhan tiap pengambilan dapat mengurangi pengerjaan ulang yang tidak perlu. Kling VIDEO 3.0 Series menghadirkan konsistensi subjek berbasis referensi, Multi-Shot dan Custom Multi-Shot, Kontrol Gerakan, generasi fleksibel 3–15 detik, Native-Level Text Output, dan Native Audio ke dalam alur kerja generasi, sehingga memberikan kreator lebih banyak kontrol atas karakter, pergerakan, tempo, dialog, dan penceritaan visual.
FAQ
Apa Saja Keterbatasan Utama Teknologi Pembuatan Video AI pada 2026?
Model video AI saat ini dapat kehilangan konsistensi ketika suatu adegan menjadi lebih kompleks. Wajah bisa bergeser antar bidikan, gerakan bisa terlihat sedikit salah, teks dapat terdistorsi, dan menjaga koherensi pada rangkaian yang lebih panjang menjadi lebih sulit. Prompt yang terperinci juga tidak selalu menghasilkan hasil yang tepat, sehingga kreator sering mengandalkan gambar referensi, bidikan yang lebih pendek, dan beberapa putaran penyempurnaan untuk mendapatkan cuplikan sesuai kebutuhan.
Bisakah Generator Video AI Membuat Video Panjang?
Generator video AI dapat menghasilkan klip yang lebih panjang dan rangkaian multi-shot, tetapi konsistensi semakin sulit dipertahankan seiring video bertambah panjang. Tolok ukur seperti DirectorBench dan MSVBench juga berfokus pada masalah seperti transisi bidikan, konsistensi lintas bidikan, dan kesinambungan cerita. Untuk proyek yang lebih panjang, biasanya lebih mudah bekerja per bidikan, menggunakan kembali referensi yang sama, dan memeriksa bagaimana setiap adegan terhubung sebelum melanjutkan.
Mengapa Video yang Dihasilkan AI Terlihat Tidak Konsisten?
Video yang dihasilkan AI dapat terlihat tidak konsisten karena model harus menjaga wajah, objek, tekstur, dan detail adegan lainnya tetap stabil dari satu frame ke frame berikutnya. Ketika kamera bergerak atau sesuatu menghilang di balik objek lain lalu kembali terlihat, detail tersebut dapat bergeser. Menggunakan gambar referensi yang sama, memulai dengan aksi yang lebih sederhana, dan mengubah satu bagian prompt pada satu waktu dapat membuat hasilnya lebih mudah dikendalikan. Jika wajah, produk, atau properti perlu sangat cocok, periksa klipnya frame demi frame.
Dapatkah Generator Video AI Menciptakan Fisika yang Realistis?
Video AI dapat membuat gerakan terlihat meyakinkan, tetapi itu tidak selalu berarti fisikanya benar. T2VPhysBench menguji model-model video terhadap 12 hukum fisika fundamental dan menemukan masalah yang berulang dengan gravitasi, konservasi, dan interaksi fisik lainnya. Jika sebuah video perlu menunjukkan cara kerja produk, suatu proses ilmiah, atau tindakan sebab-akibat yang jelas, bandingkan hasilnya dengan rekaman nyata dan periksa gerakannya dengan saksama.
Apa Tren Teknologi Video Buatan AI Utama pada 2026?
Tren teknologi video yang dihasilkan AI pada tahun 2026 mencakup lebih banyak cara untuk memulai sebuah video, mengarahkan sebuah penampilan, dan menangani ucapan dalam proyek yang sama. Seorang kreator mungkin memulai dengan generator video AI atau AI gambar-ke-video, menggunakan kontrol gerak untuk sebuah gerakan spesifik, lalu menambahkan dialog lisan dengan sinkronisasi bibir atau alat dubbing. Avatar AI, audio asli, dan alat pengeditan video juga semakin menjadi bagian penting dari cara video berdurasi pendek, iklan, dan konten yang dilokalkan dibuat.