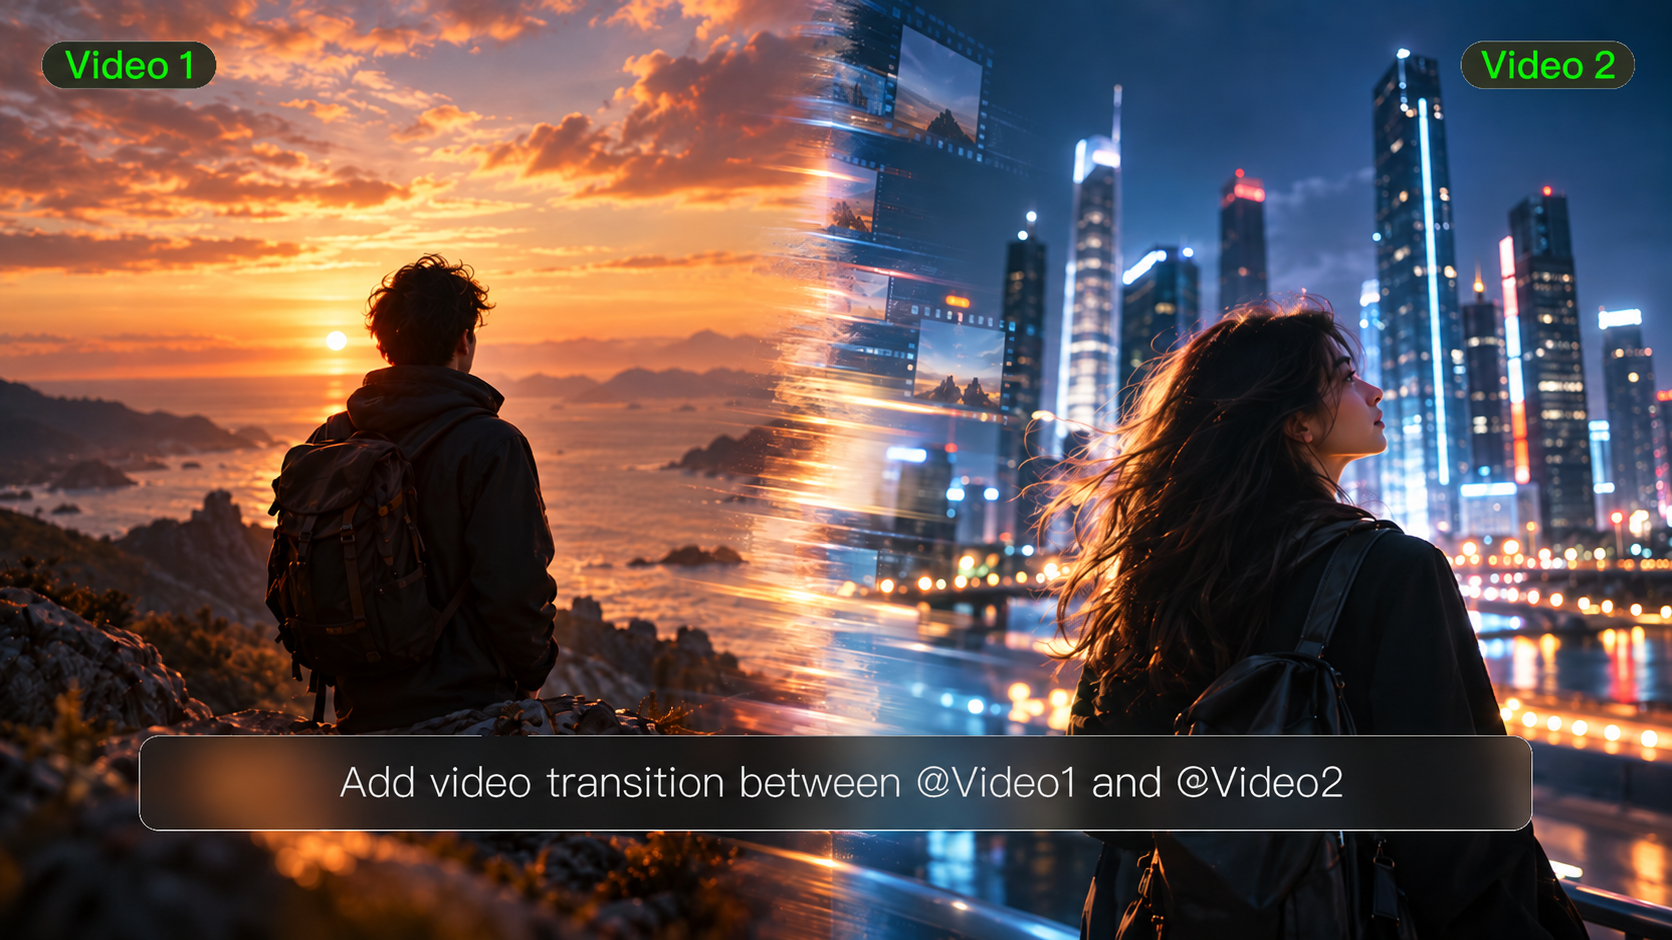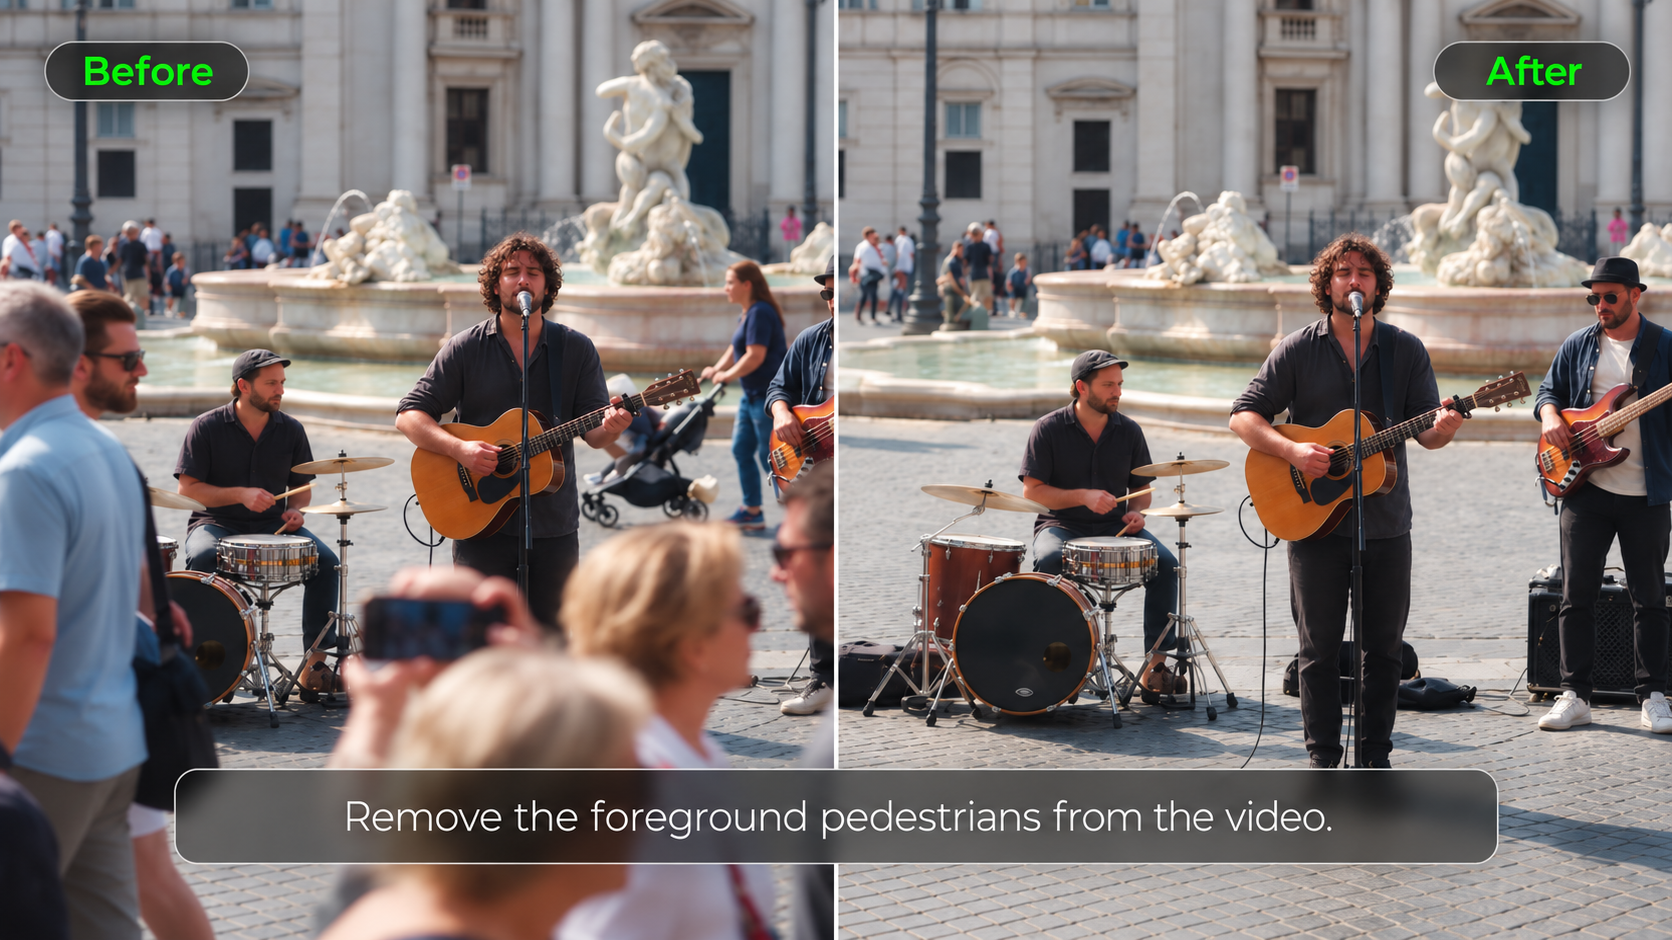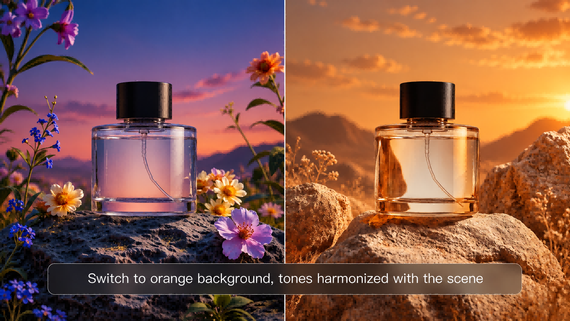
Já passou horas planejando uma história e seus planos de filmagem, apenas para ver o rosto de um personagem mudar entre cenas ou uma ação-chave desaparecer? O vídeo com IA pode dar vida às suas ideias, mas correções repetidas podem consumir o tempo que você esperava economizar. Vamos detalhar seis limitações da tecnologia atual de geração de vídeo por IA, soluções práticas e onde a Kling VIDEO 3.0 série pode ajudar.
Quais são as limitações da tecnologia atual de geração de vídeo por IA?
Os vídeos gerados por IA agora conseguem lidar com cenas mais complexas, mas consistência, movimento, texto e controle preciso ainda podem falhar durante a geração. Desde manter a consistência visual entre quadros até controlar o movimento e os detalhes, essas limitações continuam a moldar como os criadores usam IA na produção de vídeo.
A tabela abaixo mostra onde a geração de vídeo por IA atual ainda fica aquém, como esses problemas aparecem em projetos reais e o que você pode fazer para contorná-los.
Limitação | Desafio técnico | O que acontece | Solução rápida |
Consistência temporal limitada e coerência de quadros | O modelo precisa preservar a iluminação, o layout, as texturas e outras informações visuais em quadros consecutivos enquanto os sujeitos e as câmeras estão em movimento. | A iluminação pode mudar, objetos de fundo podem deslocar-se, pequenos adereços podem desaparecer e texturas ou contornos corporais podem oscilar durante uma tomada. | Mantenha cada tomada centrada em uma ação principal. Para cenas mais complexas, use clipes mais curtos e uma imagem de referência para manter o cenário e a composição no lugar. |
Consistência de Personagens e Objetos Entre Planos | Planos gerados separadamente precisam recriar a mesma identidade do sujeito, aparência e detalhes de design a cada vez. | Rostos, penteados, roupas, acessórios, formas de produtos, cores ou detalhes de superfície podem mudar de um plano para o outro. | Reutilize as mesmas imagens de referência e mantenha os detalhes definidores consistentes. Evite mudar iluminação, ângulo de câmera, estilo e ambiente ao mesmo tempo. |
Física e Movimento Irrealistas | O modelo precisa manter mecânica corporal, contato entre objetos, relações espaciais e comportamento do material críveis ao longo do tempo. | As mãos podem atravessar objetos, o movimento pode parecer sem peso, as colisões podem parecer erradas, e tecido, água, cabelo ou movimentos rápidos de câmera podem se comportar de forma antinatural. | Divida ações complicadas em etapas distintas. Descreva o movimento do sujeito e o movimento da câmera separadamente, em vez de colocar ambos em uma única instrução. |
Geração de vídeo de longa duração limitada | Uma sequência mais longa precisa preservar personagens, locais, adereços, estilo visual, ritmo e lógica da história ao longo de muitos planos. | Personagens ou locais podem desviar, adereços podem desaparecer, quebras de continuidade tornam-se mais perceptíveis e as cenas podem parecer desconectadas à medida que o vídeo fica mais longo. | Trabalhe a partir de um storyboard ou lista de planos, reutilize referências visuais e gere o projeto cena a cena. Trate do ritmo, das transições e da montagem final na edição. |
Dificuldade com detalhes finos e geração de texto | Pequenas formas, tipografia, logotipos e detalhes de produtos exigem consistência espacial exata de quadro para quadro. | Os dedos podem deformar, o texto pode ser escrito incorretamente ou distorcido, os logotipos podem deslocar-se e pequenas características do produto podem mudar durante o movimento. | Adicione texto, logotipos, legendas e outros elementos fixos da marca na pós-produção. Para tomadas de produto, use uma referência clara e mantenha o enquadramento relativamente simples. |
Controle e personalização limitados por prompt | O controle baseado em prompt é indireto, portanto, alterar uma instrução pode também afetar outras partes da tomada gerada. | O modelo pode seguir algumas instruções de perto enquanto altera o enquadramento, o fundo, o tempo ou a aparência do sujeito de maneiras que você não solicitou. | Defina primeiro o assunto e o visual geral, depois refine o movimento, o enquadramento e o tempo em etapas menores. Gere algumas variações curtas em vez de incluir todos os requisitos em um único prompt longo. |
Como o Kling AI Video Generator Ajuda a Superar Essas Limitações
Kling AI Video Generator traz mais controle criativo e de produção para a geração de vídeo com IA, facilitando o desenvolvimento de tomadas conectadas, sujeitos recorrentes, diálogos e narrativas visuais mais complexas. Ao longo de VIDEO 3.0 e VIDEO 3.0 Omni, os criadores podem trabalhar com consistência de sujeito baseada em referências, Multi-Shot e Custom Multi-Shot, Motion Control, geração flexível de 3–15 segundos, Native-Level Text Output e Native Audio para apoiar a criação de vídeos cinematográficos profissionais.
Mantenha Personagens e Produtos Consistentes Entre as Tomadas
Quando a mesma pessoa, produto ou objeto de cena importante aparece em várias tomadas, manter seus traços definidores reconhecíveis pode ser difícil se cada tomada for gerada a partir de uma nova descrição. A Kling VIDEO 3.0 Series fornece fluxos de trabalho baseados em referências que dão ao modelo mais informações visuais sobre assuntos recorrentes e ajudam a reduzir alterações indesejadas entre as tomadas.
Com Kling VIDEO 3.0, você pode usar várias imagens de referência para fornecer diferentes visões do mesmo personagem, produto ou objeto. Para um personagem, ângulos frontal, lateral e outros úteis podem fornecer ao modelo mais informações sobre estrutura facial, penteado, roupa e traços reconhecíveis. Para produtos ou objetos de cena importantes, vistas adicionais podem capturar detalhes que uma única imagem frontal pode deixar passar, como formato, proporções, materiais, detalhes laterais ou características de superfície.
Para projetos que precisam de um assunto reutilizável em diferentes tomadas e cenas, Kling VIDEO 3.0 Omni fornece um fluxo de trabalho Element Reference. Você pode construir um Element a partir de imagens em múltiplos ângulos ou de um vídeo curto do personagem e, em seguida, referenciar esse Element novamente conforme a cena, o ângulo da câmera ou o conteúdo ao redor muda. Character Elements também podem incluir informações de voz, ajudando um personagem recorrente a manter tanto traços visuais reconhecíveis quanto uma voz consistente em cenas relacionadas.
Em ambos os fluxos de trabalho, informações de referência mais sólidas podem reduzir refações causadas por uma face que muda, um acessório que desaparece ou um produto que se afasta do design pretendido.
Exemplos de uso do Kling VIDEO 3.0
Frame inicial | ||
Referência de imagem | ||
| Prompt: A câmera gradualmente se move ao redor até ficar diante da garota, que então levanta a cabeça e sorri calorosamente para a câmera, como se estivesse vendo um velho amigo após muitos anos. | ||
Vídeo | ||
Exemplos de uso do Kling VIDEO 3.0 Omni
Elemento/Imagem de referência | |
@Shirt Boy | @Image1 |
Plano médio, vista frontal Prompt: @Shirt Boy desce a encosta e senta-se junto ao poste em @image. Close-up, rosto: @Shirt Boy encosta-se ao poste e diz: “O vento de hoje parece mais suave do que o de ontem… até a relva parece gentil.” Visual cinematográfico @image1. Close-up lateral, rosto: @Shirt Boy fecha os olhos enquanto a luz do sol pousa suavemente no seu rosto. Plano de cima: @Shirt Boy reclina-se, com a relva a cobrir a camisa, braços atrás da cabeça, olhando para o céu azul e dizendo: “Espero que este tipo de verão nunca acabe.”
| |
Vídeo | |
Direcione movimentos complexos de personagem com mais precisão
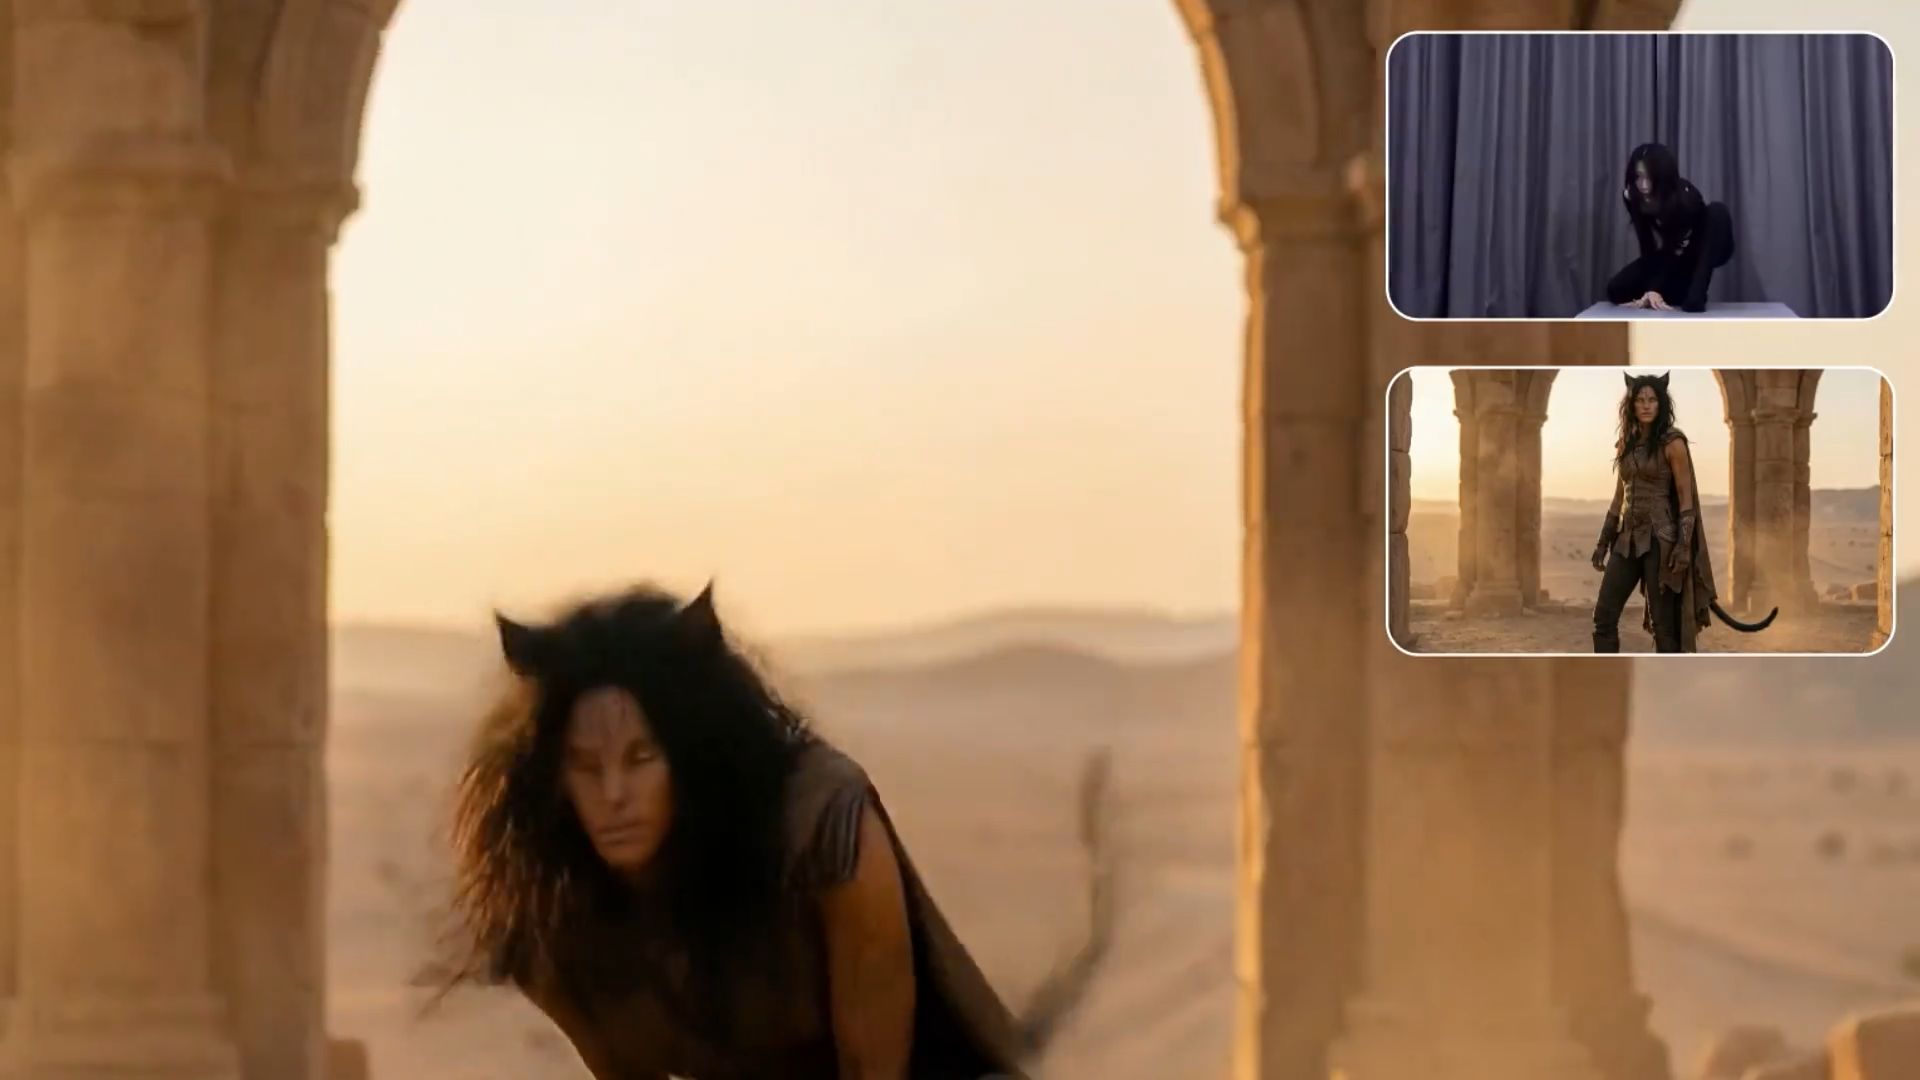
Para ações quotidianas, pode descrever no prompt o que a personagem deve fazer, incluindo ritmo, movimento corporal e mudanças de expressão. O AI video generator da Kling pode transformar essas orientações em movimento, mas o texto torna-se menos preciso quando um plano exige uma volta, gesto, movimento de dança ou sequência de expressões específica.
Para esse nível de detalhe, Motion Control funciona a partir de uma referência de movimento. Carregue um vídeo de movimento ou escolha uma ação da biblioteca de movimentos, e aplique seus movimentos e expressões ao seu personagem. Kling VIDEO 3.0 Motion Control também melhora a consistência facial em movimentos complexos, com múltiplos ângulos e de longa duração. Começar a partir do movimento desejado geralmente é mais fácil do que reescrever um prompt várias vezes para acertar uma performance específica.

Crie e direcione tomadas conectadas
Uma cena raramente funciona com um único ângulo de câmera. Você pode começar com uma tomada ampla, cortar para mais perto e depois mudar para uma reação. Com o Multi-Shot, a série Kling VIDEO 3.0 pode planejar o enquadramento e as mudanças de câmera ao longo da mesma sequência.
Se você já sabe como a cena deve ser dividida, o Custom Multi-Shot permite que você defina o conteúdo e a duração de cada tomada. Isso torna mais fácil moldar o ritmo sem enfiar todas as instruções em um único prompt longo ou juntar depois um lote de clipes sem relação.
Imagem de referência | |||
Referência de personagem | |||
Instrução | |||
| Tomada 1 (3s): Plano fechado do palco de comédia de microfone aberto (veja a imagem de referência), com uma grande placa de néon retrô "KLING" ao fundo. Uma luz de fundo dourada e quente contorna a cena. A câmera segue o artista enquanto ele caminha até o microfone e faz um pequeno ajuste de altura. | |||
| Tomada 2 (4s): Plano médio fechado de @Little Scholar, que diz: "Na verdade, perdi para o Kid — quanta experiência de trabalho ele tem, afinal? — que estava ensinando todo mundo a ser feliz no trabalho." | |||
| Tomada 3 (4s): @Little Scholar, com um sorriso contido e discreto, faz uma pausa natural e diz: "Só escutem isto: ele passou cinco minutos argumentando a favor de uma premissa tão absurda." | |||
| Plano 4 (2s): Corte para o público rindo alto. | |||
Vídeo | |||
Dê mais espaço para as histórias curtas se desenvolverem
A Kling VIDEO 3.0 Series pode gerar clipes de 3 a 15 segundos, dando a uma cena curta mais tempo para um personagem entrar, falar, reagir ou percorrer vários momentos narrativos sem ser dividida em uma série de clipes minúsculos. Combinado com Multi-Shot, esse tempo extra funciona bem para anúncios curtos, cenas de diálogo e momentos centrados em personagens em que o ritmo da cena importa tanto quanto os visuais.
Mantenha o texto em tela e o copy da marca mais utilizáveis
O texto pode desmoronar rapidamente assim que uma cena começa a mover-se. Os rótulos podem distorcer-se, as letras podem desaparecer e os sinais ou logótipos podem mudar de um fotograma para o seguinte.
Com o Native-Level Text Output, a série VIDEO 3.0 faz um trabalho melhor em manter sinais, legendas, rótulos e outros textos legíveis à medida que o plano muda. Para anúncios e vídeos de produtos, isso significa menos planos úteis perdidos devido a texto deformado ou branding ilegível. Logótipos exatos e ativos de marca bloqueados continuam a ser mais seguros de adicionar na pós-produção quando a precisão é essencial.
Imagem |
Vídeo |
Reúna diálogo e som no mesmo fluxo de trabalho
Com Native Audio, a VIDEO 3.0 Series pode gerar a cena e o diálogo juntos, incluindo conversas com vários personagens em chinês, inglês, japonês, coreano e espanhol. Em vez de criar primeiro um clipe mudo e cuidar das vozes, do ritmo e da sincronização labial depois, você pode planejar quem fala, o que dizem e como a tomada se desenrola desde o início. Isso é especialmente útil para curtas guiados por diálogos e cenas com vários personagens, nas quais a fala e a atuação dos personagens precisam permanecer sincronizadas.
Imagem |
Prompt: Em uma pequena estação envolta pela névoa matinal, o garoto sorriu e entregou o bento: 「急いで作ったけど、大丈夫? お母さんのレシピだよ。」 A garota o recebeu com um sorriso: 「うん、きっと美味しい! 到着したら LINE するね。」 |
Vídeo |
O Fim
Esteja você criando um anúncio de produto, um curta impulsionado por diálogos ou uma história com várias tomadas, as limitações da tecnologia atual de geração de vídeo por IA costumam aparecer de maneiras conhecidas: um personagem muda entre os planos, o movimento parece estranho, o texto se desfaz ou uma cena exige várias tentativas até ficar certa. Referências claras, planejamento de tomadas mais curto e controles escolhidos para as necessidades de cada tomada podem reduzir retrabalho desnecessário. A Kling VIDEO 3.0 Series traz consistência de sujeito baseada em referências, Multi-Shot e Custom Multi-Shot, Motion Control, geração flexível de 3–15 segundos, Native-Level Text Output e Native Audio para o fluxo de trabalho de geração, dando aos criadores mais controle sobre personagens, movimento, ritmo, diálogo e narrativa visual.
Perguntas frequentes
Quais são as principais limitações da tecnologia de geração de vídeo por IA em 2026?
Os modelos atuais de vídeo com IA podem perder consistência à medida que uma cena se torna mais complexa. Um rosto pode mudar entre tomadas, o movimento pode parecer ligeiramente errado, o texto pode distorcer e sequências mais longas são mais difíceis de manter coerentes. Prompts detalhados também nem sempre se traduzem em resultados exatos, então os criadores frequentemente dependem de imagens de referência, tomadas mais curtas e algumas rodadas de refinamento para levar o material ao ponto desejado.
Os geradores de vídeo com IA conseguem criar vídeos longos?
Os geradores de vídeo com IA podem produzir clipes mais longos e sequências com múltiplas tomadas, mas a consistência fica mais difícil de manter à medida que o vídeo cresce. Benchmarks como DirectorBench e MSVBench também se concentram em problemas como transições entre tomadas, consistência entre tomadas e continuidade da história. Para projetos mais longos, geralmente é mais fácil trabalhar tomada por tomada, reutilizar as mesmas referências e verificar como cada cena se conecta antes de avançar.
Por que os vídeos gerados por IA parecem inconsistentes?
Vídeos gerados por IA podem parecer inconsistentes porque o modelo precisa manter rostos, objetos, texturas e outros detalhes da cena estáveis de um quadro para o outro. Quando a câmera se move ou algo desaparece atrás de outro objeto e volta a ficar visível, esses detalhes podem se alterar. Usar a mesma imagem de referência, começar com uma ação mais simples e alterar uma parte do prompt por vez pode tornar o resultado mais fácil de controlar. Se um rosto, produto ou adereço precisar corresponder com precisão, revise o clipe quadro a quadro.
Os geradores de vídeo de IA conseguem criar física realista?
O vídeo com IA pode fazer o movimento parecer convincente, mas isso nem sempre significa que a física está correta. T2VPhysBench testou modelos de vídeo em relação a 12 leis físicas fundamentais e encontrou problemas recorrentes com gravidade, conservação e outras interações físicas. Se um vídeo precisar mostrar como um produto funciona, um processo científico ou uma ação clara de causa e efeito, compare o resultado com filmagens reais e verifique o movimento de perto.
Quais são as principais tendências de tecnologia de vídeo gerado por IA em 2026?
As tendências da tecnologia de vídeo gerada por IA em 2026 incluem mais maneiras de iniciar um vídeo, dirigir uma performance e lidar com a fala dentro do mesmo projeto. Um criador pode começar com um gerador de vídeo com IA ou IA de imagem para vídeo, usar controle de movimento para um movimento específico, depois adicionar diálogo falado com sincronização labial ou ferramentas de dublagem. Avatares de IA, áudio nativo e ferramentas de edição de vídeo também estão se tornando uma parte maior de como vídeos de formato curto, anúncios e conteúdo localizado são produzidos.