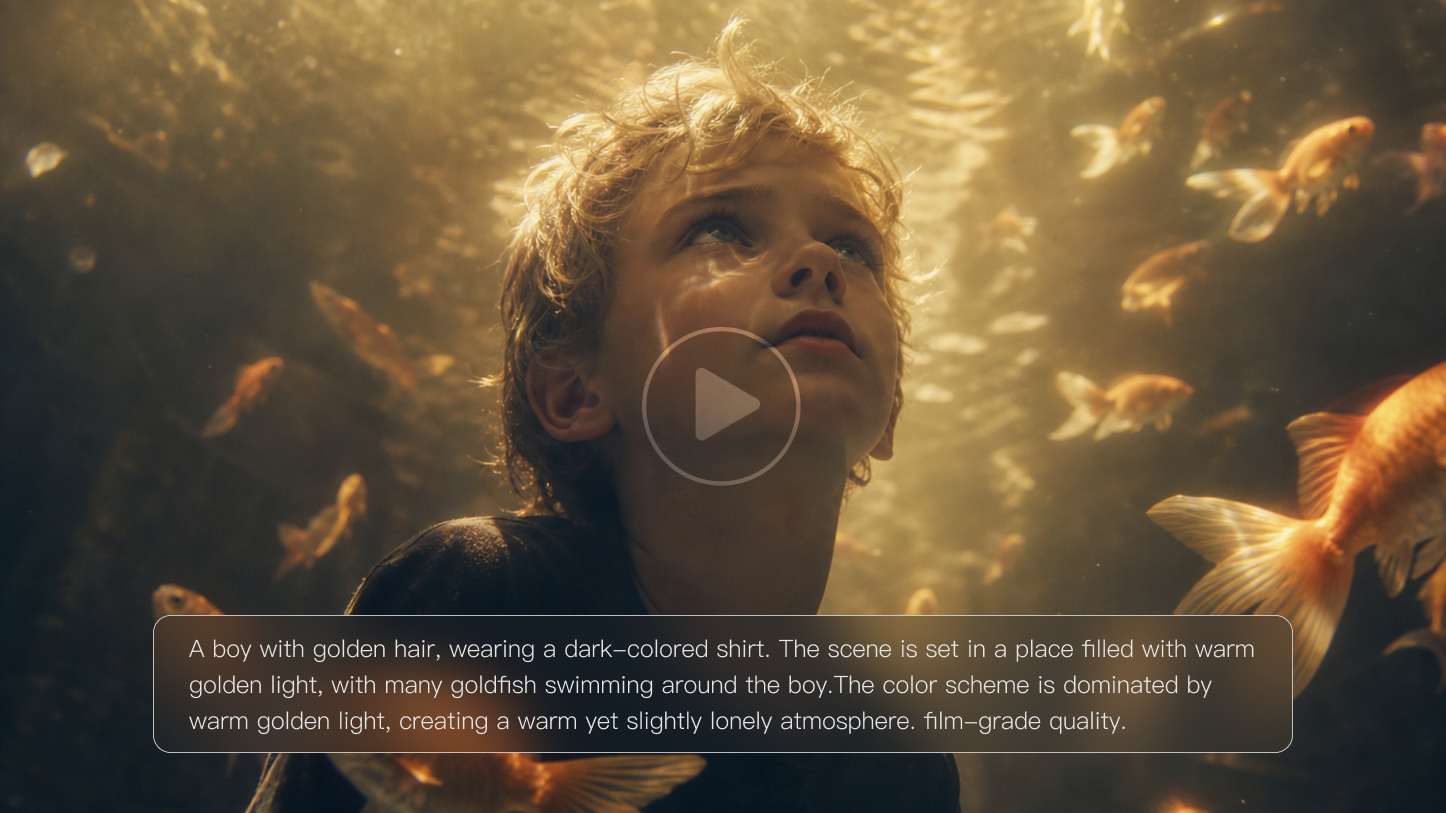
يمكن لنماذج النص إلى فيديو تحويل مشهد مكتوب إلى فيديو مع حركة كاميرا، وصوت، ولقطات متعددة. لكن المشكلة أن المقطع النهائي قد لا يطابق التوجيه، أو يتحرك بشكل غير طبيعي، أو يسمح بتغيّر شخصية أو منتج من لقطة إلى أخرى. يستعرض هذا المقال لماذا تهم تلك الفروق، وما الذي يجب التحقق منه قبل اختيار نموذج، وكيف يتعامل Kling VIDEO 3.0 مع التحكم في اللقطات، والحركة، والصوت، والاتساق البصري.
ما هي نماذج النص إلى فيديو؟
نماذج النص إلى فيديو تستخدم الذكاء الاصطناعي التوليدي لتحويل الأوصاف باللغة الطبيعية إلى فيديو. يمكن للتوجيه أن يحدد الموضوع، والبيئة، والفعل، وحركة الكاميرا، والأسلوب البصري. وإذا كان النموذج يدعم الصوت، فيمكنه أيضًا تضمين الحوار، والأصوات المحيطة، وإشارات صوتية أخرى.
غالبًا ما تُعامل نماذج النص إلى فيديو ومولّدات الذكاء الاصطناعي للنص إلى فيديو على أنها الشيء نفسه، لكنها تؤدي أدوارًا مختلفة:
نموذج النص إلى فيديو | مولّد الذكاء الاصطناعي للنص إلى فيديو | |
ما هو | نظام الذكاء الاصطناعي الذي يفسر التوجيه ويولّد الفيديو | المنتج أو الواجهة التي يستخدمها الأشخاص للوصول إلى تحويل النص إلى فيديو |
ما الذي يتولاه | تفسير التوجيه، وإنشاء المشهد، والحركة، والاستمرارية عبر الزمن | الخصائص المبنية حول النموذج، مثل عناصر التحكم في اللقطات، والمدخلات المرجعية، والصوت، والمدة، ونسبة العرض إلى الارتفاع، والتحرير، والتصدير |
لماذا يهم الأمر | يؤثر النموذج مباشرةً في جودة الفيديو والحركة والاتساق البصري | يؤثر المُولِّد في مقدار التحكم الإبداعي الذي تملكه وفي ما يمكنك فعله بالفيديو لاحقًا |
يحدد النموذج ما يتم توليده، بينما يحدد مولد فيديو بالذكاء الاصطناعي كيفية الوصول إلى تلك الإمكانات، والتحكم في العملية، والعمل مع الفيديو النهائي.
كيف تعمل نماذج تحويل النص إلى فيديو؟
تحول نماذج تحويل النص إلى فيديو المطالبة المكتوبة إلى تسلسل من الصور المتحركة. تختلف العملية الدقيقة حسب النموذج، لكنها عمومًا تتضمن فهم المطالبة، وبناء تمثيل مضغوط للمشهد، وتحديد كيفية تغير الأشياء بمرور الوقت، والحفاظ على الاتساق في النتيجة من لحظة إلى أخرى.
1. تفسير الموجه
يبدأ نموذج ذكاء اصطناعي لتحويل النص إلى فيديو بتحديد التعليمات الرئيسية في الموجه، بما في ذلك:
- الموضوع
- الإجراء
- الإعداد
- النمط البصري
- اتجاه الكاميرا
- الحوار أو الإشارات الصوتية الأخرى، عند توفرها
| prompt: “راكب دراجة يعبر شارع وسط المدينة الماطر بينما تتبعه الكاميرا من الخلف.” |
يتضمن ذلك الوصف القصير عدة تعليمات يجب أن تعمل معًا. يتقدم راكب الدراجة إلى الأمام، وتتبع الكاميرا من الخلف، ويجب أن يكون المطر والشارع والإضاءة والمحيط متناسقين ضمن اللقطة نفسها.
بعبارة أخرى، يصف الموجه أكثر مما يجب أن يظهر على الشاشة. كما يحدد العلاقات بين الموضوع والحركة والكاميرا والبيئة.
2. أنشئ تمثيلًا مضغوطًا للفيديو
بعد قراءة الموجه، يحتاج النظام إلى تمثيل عملي للمشهد قبل أن يتحول إلى لقطات منتهية. تعتمد الطريقة الدقيقة على بنية النموذج.
العديد من نماذج تحويل النص إلى فيديو القائمة على الانتشار تعمل في مساحة تمثيل مضغوطة بدلاً من معالجة الإطارات كاملة الدقة منذ البداية. تبدأ بالضوضاء وتشكلها تدريجياً وفقاً للموجه، مما يُظهر الموضوع والمشهد والإضاءة والتكوين وغير ذلك من التفاصيل البصرية. العمل في هذه المساحة المضغوطة يقلل مقدار البيانات المتداولة أثناء التوليد، وبمجرد أن يتشكل المشهد، يتم فك ترميز النتيجة إلى إطارات فيديو مرئية.
3. توليد الحركة والتفاعلات
يجب على الفيديو أن يُظهر ما يحدث من لحظة إلى أخرى. يحتاج النموذج إلى التعامل مع الحركة وتفاعل الكائنات وتغيرات زاوية الرؤية من دون إفساد المشهد.
- الحركة: ينبغي للشخصية التي تدور أو تمشي أو تمد يدها أن تغير الوضعية والمكان تدريجياً، خطوة بخطوة، بدلاً من الانتقال فجأة من حالة إلى أخرى.
- التفاعل مع الأشياء: تحتاج الأفعال إلى ترتيب واضح. إذا التقط شخص كوباً، يجب أن تمتد اليد إليه وتلامسه قبل أن يتحرك الكوب.
- الكاميرا والفضاء: تؤدي حركات التتبع الأفقية والعمودية، والاقتراب، واللقطات التتبعية إلى تغيير زاوية الرؤية، إلا أن الموضوع والمحيط يجب أن يظلان راسخين في الفضاء نفسه.
الصورة الثابتة لا يلزمها سوى وصف لحظة واحدة. أما الفيديو فيجب أن يأخذ في الحسبان ما يحدث بين اللحظات.
4. حافظ على التناسق الزمني والسمعي البصري
مع تطور الفيديو، يجب أن يحافظ الأشخاص والأشياء والصوت على ترابطهم عبر الزمن. ويتعلق ذلك في الأساس بنوعين من التناسق:
- الاتساق الزمني: يجب ألا تتغير الشخصيات والمنتجات والملابس والدعائم والإضاءة والخلفيات بدون سبب واضح من لحظة إلى أخرى. وحتى بعد القطع من لقطة قريبة إلى لقطة واسعة أو تغيير زاوية الكاميرا، يجب أن يظل الشخص أو المنتج نفسه سهل التعرف عليه.
- الاتساق السمعي البصري: يجب أن يحدث الحوار وحركة الشفاه وتعابير الوجه والأصوات المحيطة والإجراءات على الشاشة في الوقت المناسب. عندما يتحدث أحد الشخصيات، ينبغي أن تتطابق حركة الفم مع الحوار، بينما يجب أن تتوافق أصوات الخطوات أو الصدمات مع الحركة التي تنتمي إليها.
فيما يمكن استخدام الذكاء الاصطناعي للنص إلى فيديو؟
يعمل الذكاء الاصطناعي للنص إلى فيديو بشكل جيد في الحالات التي تحتاج فيها الفكرة إلى أن تُرى قبل أن تستحق الإنتاج على نطاق كامل. يمكن أن يساعد في الاختبار الإبداعي المبكر، والمشاهد التي يصعب تصويرها، والمشاريع التي تحتاج إلى عدة اتجاهات بصرية قبل بدء الإنتاج.
إنشاء مقاطع فيديو لوسائل التواصل الاجتماعي
يمتلك المحتوى الاجتماعي فترة صلاحية قصيرة، لذلك نادرًا ما يكون من المنطقي ترتيب جلسة تصوير جديدة لكل منشور أو مفهوم حملة. يمكن لموجّه أن ينتج مقاطع للتشويقات، الإعلانات، منشورات الحملات، أو الفيديوهات القصيرة ذات القصص دون إعادة بناء إعداد الإنتاج في كل مرة. كما يمكن لمنشئي المحتوى تجربة إعدادات مختلفة، وحركات كاميرا متعددة، وتوجيهات بصرية متنوعة قبل الاستقرار على نسخة.
حوّل أفكار المنتجات إلى فيديوهات تسويقية
لا تُظهر النصوص والنماذج الثابتة دائمًا كيف سيبدو المنتج عندما يتحرك داخل المشهد. يتيح الذكاء الاصطناعي من النص إلى الفيديو للمسوقين وضع المنتج نفسه في بيئات مختلفة، واستكشاف مفاهيم الإعلانات، واختبار المعالجات البصرية في مرحلة مبكرة من العملية. وإذا ظهر المنتج عبر عدة لقطات، فإن النتائج تكشف أيضًا مدى صمود شكله ولونه وتفاصيله المميزة من لقطة إلى أخرى.
أنشئ مشاهد سردية قصيرة
يصبح من الأصعب التخطيط لقصة قصيرة بمجرد أن تتضمن عدة لقطات، وأفعال الشخصيات، وتغييرات الكاميرا، والحوار. يمكن لذكاء اصطناعي يحول النص إلى فيديو أن يرسم تلك العناصر في تسلسل، مما يسهل اختبار ترتيب اللقطات والإيقاع وتوقيت الحوار قبل بناء كل مشهد على حدة. ويكون هذا مفيدًا بشكل خاص للمقاطع السينمائية القصيرة التي تعتمد حكايتها على أكثر من لقطة متواصلة واحدة.
تصوُّر المفاهيم ولوحات القصة المصورة
يمكن أن يوضح العرض العام أو لوحة القصة ما ينبغي أن يحدث، لكن من الأصعب تقييم التوقيت وحركة الكاميرا على صفحة ثابتة. تحويل الفكرة إلى حركة يمنح المخرجين والمصممين والفرق الإبداعية شيئًا أقرب إلى تجربة المشاهدة النهائية. يمكنهم مقارنة التأطير، واختبار الانتقالات، والتقاط اللحظات الضعيفة بينما لا تزال التغييرات سهلة التنفيذ.
إنشاء مقاطع فيديو تعليمية وتوضيحية
بعض الموضوعات يصعب تسجيلها بالكاميرا لأنها مكلفة أو مجردة أو بعيدة المنال أو يستحيل إعدادها. يمكن لذكاء اصطناعي يحول النص إلى فيديو أن يوضح عملية ما، أو يعيد بناء مشهد، أو يعرض حدثًا لا يمكن تصويره مباشرة. في الشروحات ومواد التدريب ومحتوى الصفوف الدراسية، يمكن للحركة أن تجعل المفهوم أسهل للفهم عندما لا توفر الصورة الثابتة تفاصيل كافية.
كيف تختار أفضل نموذج ذكاء اصطناعي لتحويل النص إلى فيديو لمشروعك؟
لا يوجد نموذج واحد لتحويل النص إلى فيديو يناسب جميع المشاريع. ابدأ بما تريد إنجازه، ثم حدد القدرات الأكثر أهمية لذلك العمل. أهم الأمور التي يجب مقارنتها هي مدى الالتزام بالموجه، والحركة والواقعية الفيزيائية، والاتساق، والتحكم الإبداعي، والصوت، وحدود المخرجات وسير العمل.
الالتزام بالموجه
أولاً، تحقق مما إذا كان النموذج يتبع التعليمات فعلاً. يجب أن تظهر الموضوع، الحركة، المشهد، الأسلوب البصري، واتجاه الكاميرا معاً بدلاً من الاكتفاء بأوضح التفاصيل. إذا طلبت راكب دراجة يسير تحت المطر بينما تتابعه الكاميرا من الخلف، فيجب أن تكون الشخصية، والطقس، والحركة، وزاوية النظر كلها حاضرة. ما يغفله النموذج يمكن أن يخبرك بقدر ما يخبرك مدى صقل اللقطات.
الحركة والمعقولية الفيزيائية
يجب أن تتتابع الأفعال بترتيب واضح. المشي، الالتفاف، الوصول، التصادمات، وحركة الكاميرا ينبغي أن تنتقل من حالة إلى أخرى من دون قفزات مفاجئة. التفاعل الفيزيائي مهم أيضاً: ينبغي لليد أن تلامس الشيء قبل أن يتحرك، ويجب أن يؤثر الهبوط في الجسد، وينبغي للشعر، والقماش، والماء، أو الأشياء الحرة أن تستجيب للحركة القريبة بدلاً من أن تتصرف بشكل مستقل.
اتساق الشخصية والمنتج
يجب أن يظل الموضوع نفسه قابلاً للتعرّف عليه عندما يتغير التأطير أو الزاوية أو المسافة. يجب ألا تنحرف الوجوه، والملابس، وشكل المنتج، واللون، والدعائم، والإضاءة، وغيرها من التفاصيل المحدِّدة بدون سبب. تجعل المشاهد متعددة اللقطات ذلك أصعب، لذا ينبغي أيضًا التحقق في المشاريع المبنية حول شخصيات أو منتجات متكررة من وجود صور مرجعية، أو مراجع للموضوع، أو أي طريقة أخرى للحفاظ على الهوية البصرية من لقطة إلى أخرى.
التحكم الإبداعي وتحكم الكاميرا
عندما يحتوي المشهد بالفعل على توجه بصري واضح، يصبح التحكم أمرًا مهمًا. يؤثر كل من التأطير، وحركة الكاميرا، وترتيب اللقطات، والمدخلات المرجعية، ونسبة العرض إلى الارتفاع، وبنية المشاهد متعددة اللقطات في مدى تطابق النتيجة مع الفكرة الأصلية. كما أن التحكم الدقيق يعني أنك أقل عرضة لإعادة تشغيل التسلسل بالكامل لمجرد تغيير زاوية، أو إعادة ترتيب لقطة، أو إصلاح التكوين.
دعم الصوت
تختلف قدرات الصوت كثيرًا بين النماذج. ينتج بعضها العناصر المرئية فقط، بينما يستطيع بعضها الآخر إنشاء الحوار، والصوت المحيط، والمؤثرات مع اللقطات. في المشاهد الغنية بالحوار، تحقّق من بقاء الصوت وحركة الفم وتعبير الوجه والتوقيت متزامنة. يجب أن تتزامن أصوات الخطوات والارتطامات والأصوات البيئية مع الحركة التي تنتمي إليها أيضًا.
المدة، الدقة، وسير العمل
انظر إلى الحدود التي تؤثر في الفيديو النهائي، بما في ذلك طول التوليد، ونسب العرض إلى الارتفاع المدعومة، والدقات المتاحة، وخيارات التصدير. قد يكون لمقطع اجتماعي قصير ومشهد منتج متعدد اللقطات متطلبات إخراج مختلفة للغاية.
ما يحدث بعد التوليد لا يقل أهمية. هل يمكنك إطالة المقطع، أو إعادة استخدام الموضوع نفسه، أو تعديل لقطة واحدة، أو إعادة توليد الصوت، أو متابعة التحرير من دون البدء من جديد؟ يجب ألّا تجبرك التغييرات الصغيرة على إعادة بناء التسلسل بالكامل.
تتطلب المشاريع المختلفة أولويات مختلفة. ابدأ بنوع الفيديو الذي تنشئه، ثم ركّز على القدرات الأهم:
إذا كنت تريد إنشاء | أعط الأولوية | لماذا يهم |
مقاطع اجتماعية قصيرة | الالتزام بالموجه، نسب الأبعاد، سير العمل | يتحرك المحتوى الاجتماعي بسرعة، لذا يجب أن يظل الناتج قريبًا من الفكرة، وأن يتناسب مع صيغ المنصات الشائعة، وأن يكون سهل المراجعة. |
مقاطع الفيديو الخاصة بالمنتج والتسويق | اتساق المنتج، الالتزام بالتوجيه، الدقة | يجب أن تظل هيئة المنتج ولونه وعلامته التجارية والتفاصيل الأساسية مستقرة عبر اللقطات، بينما يلبي الفيديو النهائي متطلبات الحملة أو العرض التقديمي. |
مشاهد سردية أو سينمائية قصيرة | الحركة والملاءمة الفيزيائية، والتحكم في الكاميرا، والاتساق بين اللقطات المتعددة | يجب أن تكون حركات الشخصيات، وتغييرات الكاميرا، وانتقالات المشاهد مترابطة عبر التسلسل من دون انحراف بصري واضح. |
مقاطع فيديو مدفوعة بالحوار | دعم الصوت، مزامنة الشفاه, اتساق الشخصية | يجب أن يظل الحوار، وحركة الفم، والأداء الوجهي، وهوية الشخصية متسقة، بينما ينبغي أن يصل الصوت في اللحظة المناسبة. |
معاينات المفهوم ولوحات القصة | التحكم الإبداعي والتحكم في الكاميرا، ومدخلات مرجعية، ومرونة في المراجعة | الهدف هو اختبار التكوين، واتجاه الكاميرا، والإيقاع، والأفكار البديلة مبكرًا، بينما لا تزال التغييرات سهلة التنفيذ. |
مقاطع الفيديو التعليمية والتوضيحية | الالتزام بالموجه، والحركة وإمكانية التحقق الفيزيائية، وسير العمل | يجب أن تشرح العناصر البصرية العملية أو الفكرة بدقة، وأن تحافظ على سهولة متابعة الحركة، وأن تسمح بإجراء المراجعات عندما يتغير المحتوى. |
ما الذي يمكنك فعله باستخدام Kling VIDEO 3.0؟
The hard part of text-to-video is not getting one good-looking shot. It is getting the subject, action, camera direction, sound, and small visual details from the prompt to show up the way you intended. As prompts become more detailed and scenes add more shots, the model has more to keep track of from one moment to the next.
Kling VIDEO 3.0 تم تصميمه حول تلك المتطلبات، مع تفسير أقوى للتوجيهات، وسرد متعدد اللقطات، وثبات الموضوعات، وصوت أصلي، ومدة مرنة، وتصييـر للنصوص. وبدلاً من كتابة وصف والانتظار ببساطة لمعرفة ما سيعود، يمكنك تشكيل كيفية تطور القصة، ومتى تتغير الكاميرا، وكيف تنتقل الموضوعات عبر اللقطات، وأين يدخل الصوت إلى المشهد.
فهم التوجيهات واتباعها بدقة أكبر
يمكن لـKling VIDEO 3.0 تفسير التوجيهات متعددة الطبقات التي تجمع بين الموضوعات والإجراءات والإعدادات وتوجيه الكاميرا والبنية السردية. يساعد ذلك التوجيهات المعقدة من النص إلى الفيديو على البقاء أقرب إلى المشهد المقصود، خصوصاً عندما تتضمن عدة إجراءات أو تحركات كاميرا مخططاً لها أو تسلسل أحداث محدداً.
الحفاظ على ثبات الشخصيات والمنتجات عبر اللقطات
يمكن أن تبدو الشخصية صحيحة في لقطة واحدة ومع ذلك تتغير بشكل ملحوظ من زاوية أخرى. في الفيديو متعدد اللقطات، قد تتحول الوجوه، وقد تنحرف تفاصيل الملابس، وقد يتغير لون المنتج أو شكله أو سماته المميزة من لقطة إلى التالية.
في تدفقات عمل VIDEO 3.0 المدعومة بالمراجع والمتاحة، يمكنك استخدام صور مرجعية متعددة لتوفير إرشاد بصري إضافي والمساعدة في ترسيخ شخصية متكررة أو منتج أو أي موضوع رئيسي آخر عبر تغييرات التكوين والزاوية والمشهد. تمنح هذه المراجع النموذج مزيدًا من المعلومات حول مظهر الموضوع وتفاصيله البصرية الرئيسية، ما يساعد على تقليل الانحراف البصري الواضح في مشاهد الشخصيات المتكررة ولقطات المنتج والمحتوى ذو العلامة التجارية.

أنشئ قصصًا متعددة اللقطات مع تحكم أكبر في الإيقاع
اللقطة الواحدة تكون عادة قابلة للإدارة. يبدأ التحدي عندما تحتاج القصة إلى لقطات مقرّبة ولقطات واسعة وزوايا كاميرا مختلفة وتغييرات في المشاهد. يعني توليد كل لقطة على حدة مزيداً من التجميع لاحقاً، ويصبح الحفاظ على الإيقاع والاستمرارية عبر التسلسل أكثر صعوبة.
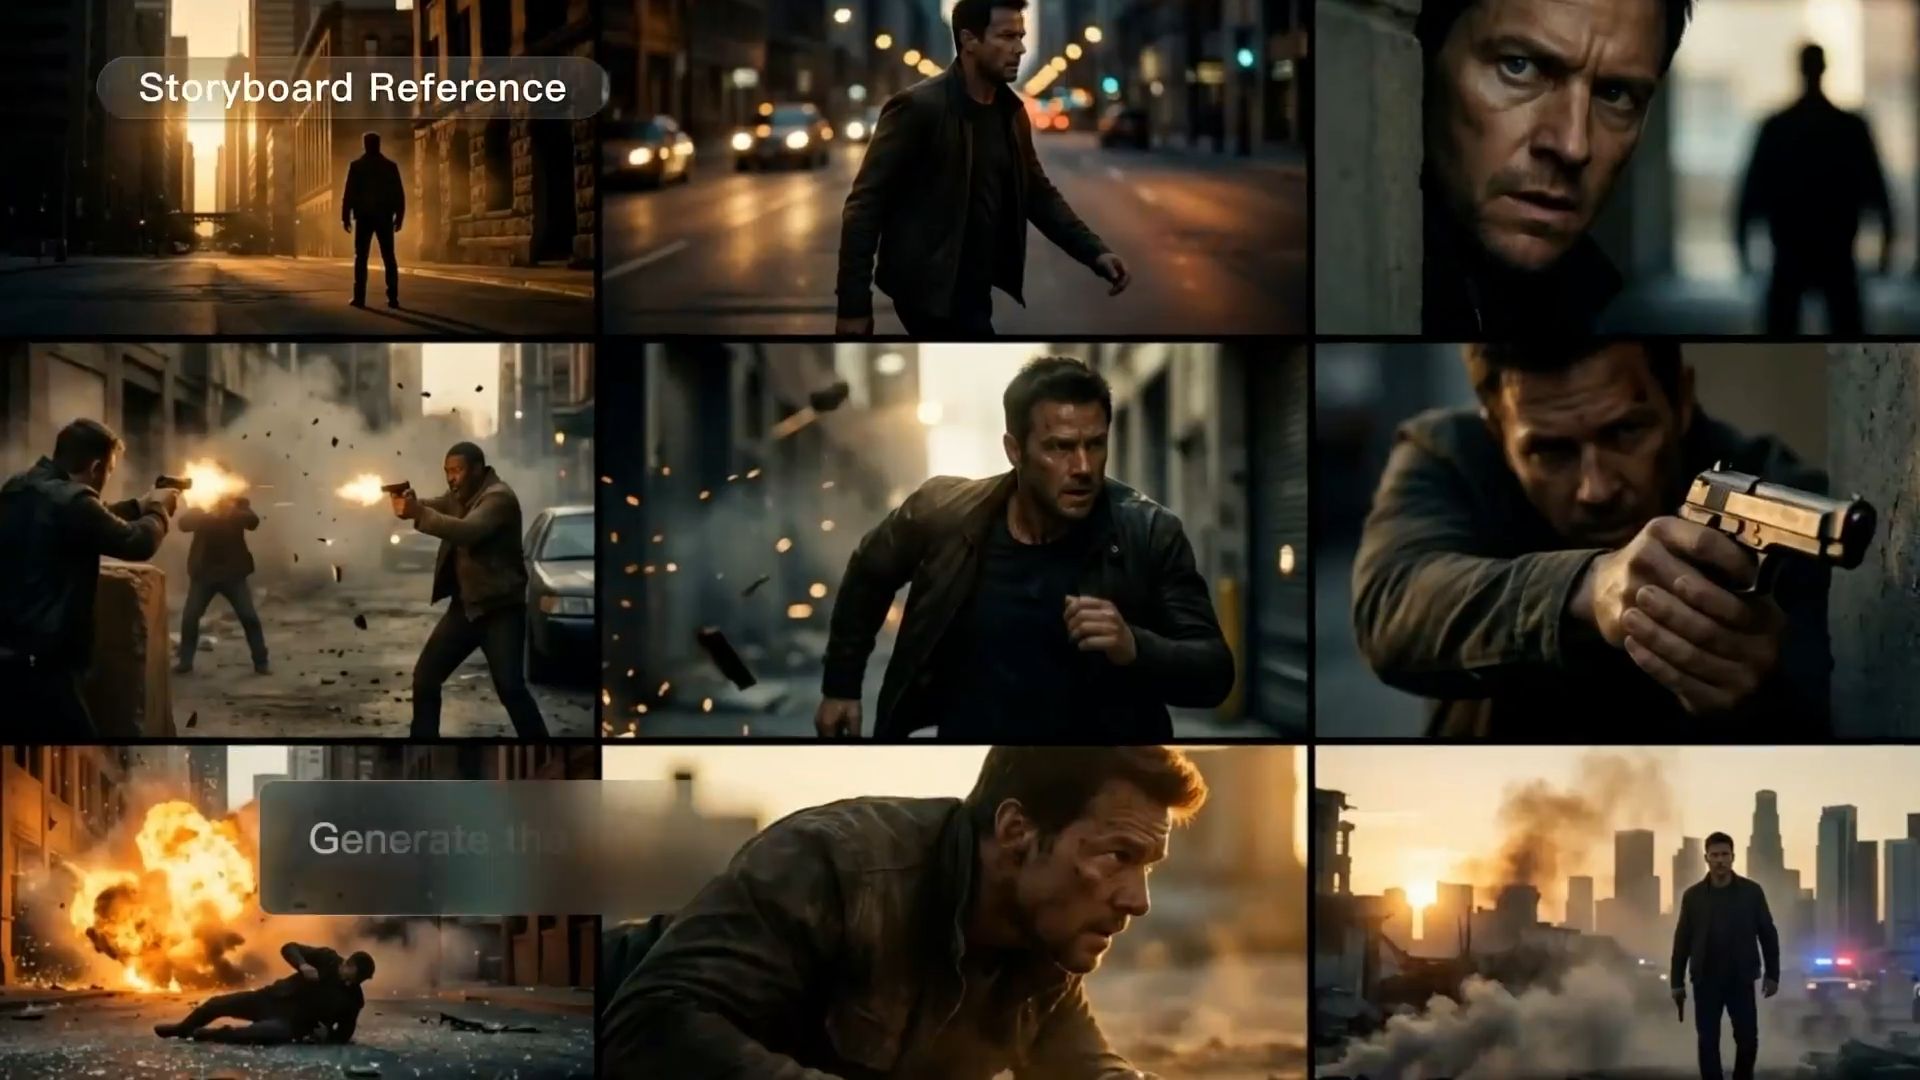
يمكن لـ Multi-Shot في Kling VIDEO 3.0 التعامل مع عدة لقطات في عملية توليد واحدة، ما يحوّل مطالبة واحدة إلى تسلسل مترابط بدلاً من مجموعة من المقاطع المعزولة. بالنسبة لتسلسل مخطط، يتيح لك Custom Multi-Shot تحديد المحتوى والترتيب والمدة لكل لقطة، بحيث يتم ضبط القطعات والإيقاع قبل أن يبدأ التوليد.
توليد الحوار وصوت المشهد معاً
عندما ينتج نموذج الفيديو الصورة فقط، تصبح مشاهد الحوار عملاً إضافياً. يجب التعامل مع الأصوات البشرية والصوت المحيط والمؤثرات والتوقيت لاحقاً. أضف عدة شخصيات، وستحتاج أيضاً إلى تتبّع من يقول كل سطر وما إذا كان الصوت يتزامن مع الحركة الصحيحة على الشاشة.
يولّد الصوت الأصلي لـKling VIDEO 3.0 الحوارات والأصوات المحيطة ومخرجات صوتية أخرى مع الفيديو. وفي المشاهد التي تضم عدة شخصيات، يمكنك إسناد السطور إلى متحدثين مختلفين، مع دعم للغات الصينية والإنجليزية واليابانية والكورية والإسبانية، إلى جانب اللهجات والنبرات المدعومة. يتم تضمين الكلام وأداء الشخصيات وصوت المشهد في عملية توليد واحدة بدلاً من إضافتها لاحقًا إلى مقطع صامت.
أنشئ قصصًا أطول تصل إلى 15 ثانية وبجودة خرج 4K
يوفر Kling VIDEO 3.0 للمبدعين مساحة أكبر لتطوير كل مشهد، مع توليد مرن يمتد من 3 إلى 15 ثانية لتفاعلات الشخصيات، والسرد متعدد اللقطات، والحوار، والانتقالات. وفي مسارات العمل المدعومة، يحافظ خرج يصل إلى 4K على أدق التفاصيل والأنسجة والوضوح البصري العام، مما يساعد المبدعين على الانتقال من المفاهيم الأولية إلى محتوى مصقول للإعلان، وعروض المنتجات، والسرد السينمائي، وغير ذلك.
النهاية
نماذج تحويل النص إلى فيديو التي تستحق وقتك تفعل أكثر من مجرد تحريك مطالبة: فهي تتبع نيتك، تتحرك بشكل طبيعي، تأتي مع صوت، وتحافظ على ثبات الهدف عبر اللقطات. عند قياسها وفق هذه المعايير، يجمع Kling VIDEO 3.0 بين التوليد المدفوع بالمطالبة، والتحكم Multi-Shot، واتساق الموضوع، والصوت الأصلي في مكان واحد. افتح Kling، واكتب مشهدك، وشاهد كيف ينبض بالحياة في عملية توليد واحدة.
الأسئلة الشائعة
كيف أختار من بين أفضل نماذج الذكاء الاصطناعي لتحويل النص إلى فيديو في عام 2026؟
ابدأ بنوع الفيديو الذي تريد إنشاؤه، ثم قارن النماذج المناسبة لتلك المهمة. يعطي السرد متعدد اللقطات وزناً أكبر للتحكم في الكاميرا واتساق الشخصيات. تتطلب المشاهد المليئة بالحوار صوتاً قوياً، ومزامنة للشفاه، وأداءً للشخصيات، بينما يعتمد العمل المتعلق بالمنتجات والإعلانات على الالتزام الدقيق بالموجهات، وثبات الموضوع، وجودة المخرجات. كما أن الطول والدقة مهمان أيضاً، لأن اختباراً سريعاً وعملاً منتهياً نادراً ما يتطلبان المواصفات نفسها. يجمع Kling VIDEO 3.0 بين Multi-Shot وNative Audio والالتزام بالموجهات وقدرة توليد تصل إلى 15 ثانية للقصص متعددة اللقطات، والمشاهد القائمة على الحوار، والمشروعات التي تحتاج إلى بقاء الشخصية نفسها أو المنتج نفسه قابلاً للتعرف عليه عبر اللقطات.
هل يمكن لتحويل النص إلى فيديو بالذكاء الاصطناعي أن يتضمن الصوت؟
نعم. يمكن لـ Kling VIDEO 3.0 توليد الحوار والصوت المحيطي والمؤثرات مع الفيديو، لذلك لن تحتاج إلى إضافة الصوت لاحقًا. يمكنك كتابة الجمل مباشرة في الأمر الإرشادي، وإسنادها إلى شخصيات محددة، واختيار اللغة أو اللهجة أو اللكنة. يمكن لقدرة text-to-speech الخاصة به تحويل تلك الجمل إلى أصوات الشخصيات باللغات الصينية والإنجليزية واليابانية والكورية والإسبانية. يعني ذلك تقليل العمل الصوتي المنفصل وتقليل تجميع الصوت بعد إنشاء الفيديو.
ما المدة التي يمكن أن يكون عليها الفيديو المُولَّد؟
تختلف مدة الفيديو حسب النموذج. يدعم Kling VIDEO 3.0 توليدًا مرنًا يتراوح من 3 إلى 15 ثانية. تعمل المقاطع الأقصر جيدًا للحركات السريعة والمحتوى الاجتماعي، بينما تتيح المقاطع الأطول مزيدًا من الوقت للبناء والحوار والسرد متعدد اللقطات. بالنسبة إلى الفيديوهات النهائية التي تحتاج إلى تفاصيل بصرية أدق، توفر الأوضاع المدعومة أيضًا إخراجًا يصل إلى 4K، مما يمنح ملمس المنتجات وتفاصيل الشخصيات وعمق المشاهد وضوحًا أكبر.
هل أحتاج إلى مهارات تحرير الفيديو؟
إذا أردت إجراء تغييرات بعد عملية التوليد، فإن سير عمل التحرير VIDEO 3.0 Omni الخاص بـ Kling يتيح لك تعديل اللقطات الحالية باستخدام تعليمات باللغة الطبيعية، بما في ذلك تغيير الخلفيات، أو الموضوعات، أو الأسلوب، أو التأطير.