이야기와 촬영을 몇 시간이나 계획했는데도 장면마다 캐릭터 얼굴이 바뀌거나 핵심 동작이 사라진 적이 있나요? AI 비디오는 아이디어를 현실로 만들어 주지만, 반복적인 수정은 아끼려던 시간을 갉아먹을 수 있습니다. 우리는 현재 AI 비디오 생성 기술의 여섯 가지 한계, 실용적인 해결책, 그리고 Kling VIDEO 3.0 시리즈 가 도움이 될 수 있는 지점을 살펴보겠습니다.
현재 AI 비디오 생성 기술의 한계는 무엇일까요?
AI 비디오는 이제 더 복잡한 장면도 처리할 수 있지만, 일관성, 모션, 텍스트, 정밀 제어가 생성 과정에서 여전히 무너지곤 합니다. 프레임 전반의 시각적 일관성을 유지하는 것부터 모션과 세부를 제어하는 것까지, 이러한 한계는 창작자가 비디오 제작에서 AI를 활용하는 방식을 계속해서 좌우합니다.
아래 표는 현재 AI 비디오 생성이 아직 부족한 지점, 실제 프로젝트에서 나타나는 문제, 그리고 이를 우회하기 위해 취할 수 있는 방법을 보여 줍니다.
한계 | 기술적 과제 | 무슨 일이 일어나나요 | 빠른 임시 해결책 |
Limited Temporal Consistency and Frame Coherence | 모델은 피사체와 카메라가 움직이는 동안 연속된 프레임 전반에 걸쳐 조명, 레이아웃, 텍스처 및 기타 시각 정보를 유지해야 합니다. | 촬영 중에 조명이 변하거나 배경 객체가 떠다니고, 작은 소품이 사라질 수 있으며, 텍스처나 신체 윤곽이 깜빡거릴 수 있습니다. | 각 샷이 하나의 주요 동작에 초점을 맞추도록 유지하세요. 더 복잡한 장면에서는 짧은 클립과 참조 이미지를 사용해 배경과 구도를 고정하세요. |
샷 전반에 걸친 캐릭터와 객체 일관성 | 별도로 생성된 샷은 매번 동일한 피사체의 정체성, 외형, 디자인 세부 사항을 재현해야 합니다. | 샷이 바뀔 때마다 얼굴, 헤어스타일, 의상, 액세서리, 제품 형태, 색상 또는 표면 디테일이 달라질 수 있습니다. | 동일한 참고 이미지를 재사용하고 핵심 디테일을 일관되게 유지하세요. 조명, 카메라 앵글, 스타일링, 환경을 한 번에 모두 바꾸는 것은 피하세요. |
비현실적인 물리와 움직임 | 모델은 시간이 지나도 신체 메커니즘, 물체 접촉, 공간 관계, 소재 거동이 믿을 만하게 유지되도록 해야 합니다. | 손이 물체를 통과할 수 있고, 움직임이 무중력처럼 느껴지며, 충돌이 이상해 보일 수 있고, 천, 물, 머리카락 또는 빠른 카메라 움직임이 부자연스럽게 동작할 수 있습니다. | 복잡한 동작을 개별 비트로 나누세요. 피사체의 움직임과 카메라 움직임을 하나의 지침에 모두 담으려 하지 말고 각각 따로 설명하세요. |
제한된 장편 비디오 생성 | 긴 시퀀스는 여러 샷에 걸쳐 캐릭터, 장소, 소품, 시각적 스타일, 타이밍, 그리고 이야기의 논리를 유지해야 합니다. | 영상이 길어질수록 캐릭터나 장소가 변질되거나, 소품이 사라지고, 연속성의 붕괴가 더 눈에 띄며, 장면이 서로 동떨어져 보일 수 있습니다. | 스토리보드나 샷 리스트를 기반으로 작업하고, 시각적 레퍼런스를 재사용하며, 프로젝트를 장면 단위로 생성하세요. 편집 단계에서 페이싱, 전환, 최종 시퀀싱을 처리하세요. |
섬세한 디테일과 텍스트 생성의 어려움 | 작은 형태, 타이포그래피, 로고 및 제품 세부 사항은 프레임마다 정확한 공간적 일관성이 필요합니다. | 손가락이 뒤틀리거나 텍스트가 철자가 틀리거나 왜곡될 수 있고, 로고가 이동하며, 작은 제품 특징이 움직임 중에 변할 수 있습니다. | 텍스트, 로고, 캡션 및 기타 고정된 브랜드 요소는 후반 작업에서 추가하세요. 제품 촬영 시에는 명확한 레퍼런스를 사용하고 프레이밍을 비교적 단순하게 유지하세요. |
제한적인 프롬프트 제어와 커스터마이징 | 프롬프트 기반 제어는 간접적이므로 한 가지 지시를 변경하면 생성된 샷의 다른 부분에도 영향을 줄 수 있습니다. | 모델이 일부 지시를 정확히 따르면서도, 요청하지 않은 방식으로 구도, 배경, 타이밍 또는 피사체의 외형을 바꿀 수 있습니다. | 먼저 피사체와 전체적인 룩을 정한 뒤, 움직임·구도·타이밍을 더 작은 단계로 다듬으세요. 모든 요구사항을 하나의 긴 프롬프트에 담기보다 짧은 변형을 몇 가지 생성하는 편이 좋습니다. |
Kling 이 이러한 제한을 어떻게 AI 비디오 생성기가 해결하도록 돕는지
Kling AI Video Generator는 AI 비디오 생성에 더 많은 창의적 및 제작 통제를 제공하여 연결된 샷, 반복 등장 인물, 대사, 더욱 복잡한 시각적 스토리텔링을 더 쉽게 개발할 수 있게 합니다. VIDEO 3.0과 VIDEO 3.0 Omni 전반에서 크리에이터는 참조 기반 피사체 일관성, Multi-Shot 및 Custom Multi-Shot, Motion Control, 유연한 3~15초 생성, Native-Level Text Output, Native Audio를 활용해 전문적인 시네마틱 비디오 제작을 지원할 수 있습니다.
샷 전반에 걸쳐 캐릭터와 제품의 일관성을 유지하세요
같은 사람, 제품 또는 중요한 소품이 여러 샷에 걸쳐 등장할 때, 각 샷이 새로운 설명에서 생성된다면 그 고유한 특징을 알아볼 수 있게 유지하기가 어려울 수 있습니다. Kling VIDEO 3.0 Series는 반복적으로 등장하는 주제에 대해 모델에 더 많은 시각적 정보를 제공하고 샷 사이의 원치 않는 변화를 줄이는 참조 기반 워크플로를 제공합니다.
Kling VIDEO 3.0, 을 사용하면 동일한 캐릭터, 제품 또는 객체에 대해 서로 다른 시각을 제공하는 여러 참조 이미지를 활용할 수 있습니다. 캐릭터의 경우 정면, 측면 및 기타 유용한 각도가 얼굴 구조, 헤어스타일, 의상, 인지 가능한 특징에 대한 더 많은 정보를 모델에 제공할 수 있습니다. 제품이나 중요한 소품의 경우 추가 시점이 형태, 비율, 소재, 측면 디테일 또는 표면 특징처럼 단일 정면 이미지에서 놓칠 수 있는 세부 사항을 포착할 수 있습니다.
다양한 샷과 장면에서 재사용 가능한 피사체가 필요한 프로젝트의 경우, Kling VIDEO 3.0 Omni 는 Element Reference 워크플로를 제공합니다. 여러 각도의 이미지나 짧은 캐릭터 영상으로 Element를 구축한 다음, 장면이나 카메라 앵글, 주변 콘텐츠가 변할 때 그 Element를 다시 참조할 수 있습니다. 캐릭터 Element에는 음성 정보도 포함할 수 있어, 반복 등장하는 캐릭터가 관련 장면 전반에서 알아볼 수 있는 시각적 특징과 일관된 목소리를 모두 유지할 수 있도록 돕습니다.
두 워크플로 모두에서, 더 탄탄한 참조 정보는 얼굴이 변하거나 액세서리가 사라지거나 제품이 의도한 디자인에서 벗어나 발생하는 재작업을 줄일 수 있습니다.
Kling VIDEO 3.0 사용 예시
시작 프레임 | ||
이미지 참조 | ||
| 프롬프트: 카메라가 천천히 소녀 앞쪽으로 이동하고, 소녀는 고개를 들어 오랜만에 옛 친구를 만난 것처럼 카메라를 향해 따뜻하게 미소 짓는다. | ||
영상 | ||
Kling VIDEO 3.0 Omni 사용 예시
요소/참고 이미지 | |
@Shirt Boy | @Image1 |
중간 샷, 정면 프롬프트: @Shirt Boy가 경사면을 내려와 @image의 기둥 옆에 앉습니다. 클로즈업, 얼굴: @Shirt Boy가 기둥에 기대어 “오늘 바람은 어제보다 더 부드럽게 느껴져… 풀도 온화하게 느껴져.”라고 말합니다. 영화 같은 분위기 @image1. 측면 클로즈업, 얼굴: @Shirt Boy가 눈을 감고 부드러운 햇빛이 얼굴에 내려앉습니다. 탑다운 샷: @Shirt Boy가 누워 셔츠를 덮은 풀 사이에서 팔을 머리 뒤에 대고 푸른 하늘을 바라보며 “이런 여름이 끝나지 않았으면 좋겠어.”라고 말합니다.
| |
비디오 | |
복잡한 캐릭터 움직임을 더욱 정확하게 지휘하세요
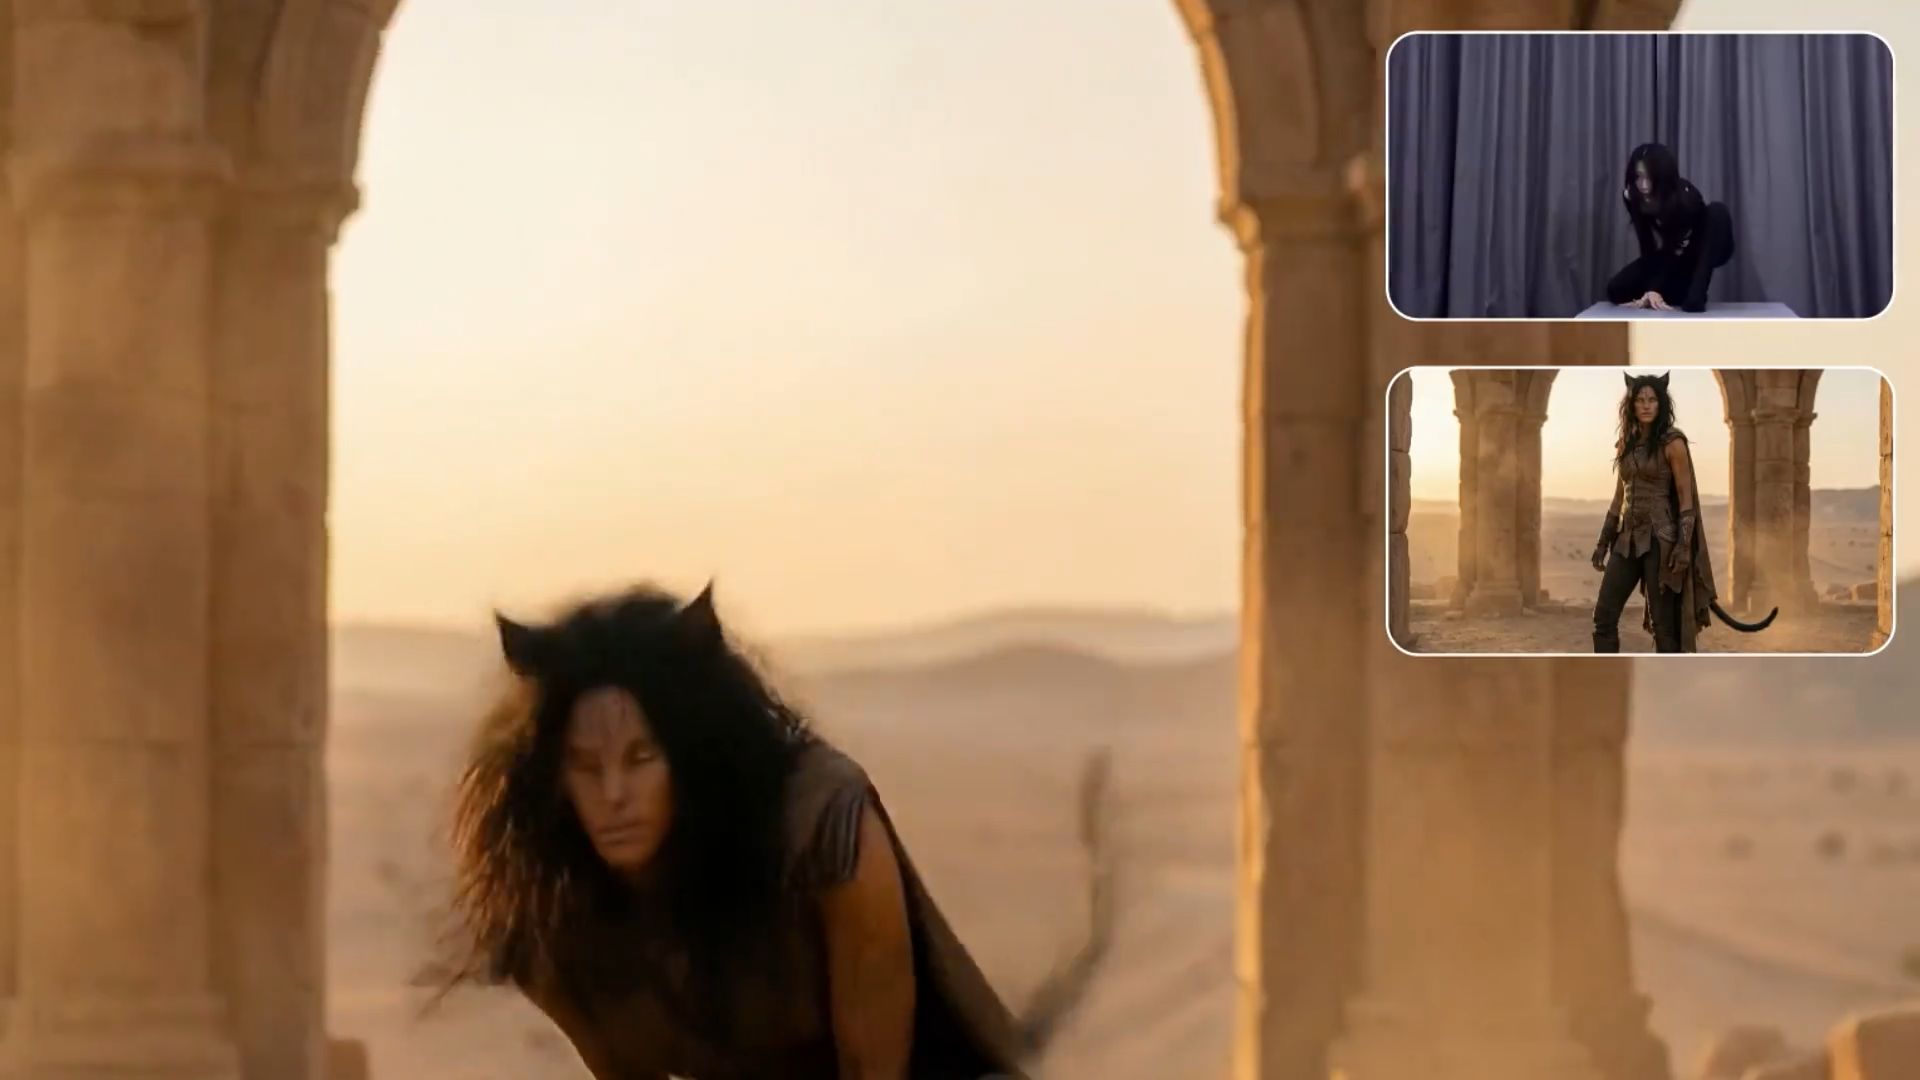
일상적인 동작의 경우, 프롬프트에서 캐릭터가 해야 할 일을 동작 속도, 몸 움직임, 표정 변화까지 포함해 상세히 설명할 수 있습니다. Kling의 AI 비디오 생성기 는 이러한 지시를 동작으로 바꿀 수 있지만, 특정한 회전, 제스처, 댄스 동작 또는 잇따르는 표정 변화를 요구하는 샷에서는 텍스트만으로는 정밀도가 떨어집니다.
그 정도 수준의 디테일을 위해 모션 컨트롤 은 대신 동작 참조를 기반으로 작동합니다. 모션 영상을 업로드하거나 모션 라이브러리에서 동작을 선택한 다음, 해당 움직임과 표정을 캐릭터에 적용하세요. Kling VIDEO 3.0 Motion Control은 복잡하고 다각도이며 장시간 이어지는 움직임에서도 얼굴 일관성을 향상시킵니다. 원하는 동작에서 시작하는 것이 특정 퍼포먼스를 정확히 얻기 위해 프롬프트를 여러 번 다시 작성하는 것보다 대체로 더 쉽습니다.

연결된 숏을 구축하고 연출하세요
하나의 카메라 앵글만으로 장면이 완성되는 경우는 거의 없습니다. 넓은 숏으로 시작해 더 가까이 들어가고, 반응 샷으로 전환할 수도 있죠. Multi-Shot을 사용하면 Kling VIDEO 3.0 Series가 동일한 시퀀스 전반에서 프레이밍과 카메라 전환을 계획할 수 있습니다.
장면을 어떻게 나눌지 이미 알고 있다면, Custom Multi-Shot을 사용해 각 샷의 내용과 길이를 직접 설정할 수 있습니다. 이렇게 하면 모든 지시를 하나의 긴 프롬프트에 억지로 욱여넣거나 나중에 관련 없는 클립들을 이어 붙이지 않고도 속도를 더 쉽게 조절할 수 있습니다.
참고 이미지 | |||
캐릭터 참고 | |||
프롬프트 | |||
| 샷 1 (3초): 코미디 오픈 마이크 무대를 클로즈업하며 (참고 이미지를 참조), 배경에는 큰 레트로 네온 "KLING" 간판이 있다. 따뜻한 황금빛 배경 조명이 장면을 감싸며 윤곽을 드러낸다. 카메라는 공연자가 마이크 쪽으로 걸어가며 높이를 약간 조정하는 모습을 따라간다. | |||
| 샷 2 (4초): @Little Scholar의 미디엄 클로즈업. 그는 "나는 실제로 Kid에게 졌는데—그에게 업무 경험이 얼마나 있다고?—그가 모두에게 직장에서 행복해지는 법을 가르치고 있었어."라고 말한다. | |||
| 샷 3 (4초): 절제된 은은한 미소를 띤 @Little Scholar가 자연스럽게 잠시 멈추고 "이것 좀 들어봐: 그는 그런 터무니없는 전제를 두고 5분이나 변론했어."라고 말한다. | |||
| 샷 4 (2초): 크게 웃고 있는 관객으로 컷한다. | |||
비디오 | |||
짧은 이야기가 더 넉넉하게 전개되도록
Kling VIDEO 3.0 Series는 3초에서 15초까지의 클립을 생성할 수 있어, 짧은 장면이 캐릭터가 등장하고, 대사를 하고, 반응하거나 여러 스토리 비트를 거치는 동안 아주 짧은 클립으로 쪼개지지 않아도 될 만큼의 시간을 확보해 준다. Multi-Shot과 결합하면, 이 추가 시간은 장면의 리듬이 비주얼만큼 중요한 짧은 광고, 대화 장면, 캐릭터 중심 순간에 잘 어울린다.
온스크린 텍스트와 브랜드 카피를 더 활용하기 쉽게 유지하세요
장면이 움직이기 시작하면 텍스트가 빠르게 무너질 수 있습니다. 라벨이 왜곡되고, 글자가 빠지며, 표지판이나 로고가 한 프레임에서 다음 프레임으로 이동할 수 있습니다.
Native-Level Text Output 기능을 통해 VIDEO 3.0 Series는 촬영 장면이 변할 때 표지판, 자막, 라벨 및 기타 텍스트를 더 잘 읽을 수 있도록 유지합니다. 광고 및 제품 영상에서는 이로 인해 왜곡된 문구나 읽기 어려운 브랜딩 때문에 사용할 수 없는 샷이 줄어듭니다. 정밀도가 중요한 경우 정확한 로고와 고정된 브랜드 자산은 여전히 후반 작업에서 추가하는 것이 더 안전합니다.
이미지 |
비디오 |
대화와 사운드를 동일한 워크플로우로 결합하기
With Native Audio, VIDEO 3.0 Series can generate the scene and dialogue together, including multi-character conversations in Chinese, English, Japanese, Korean, and Spanish. Instead of creating a silent clip first and handling voices, timing, and lip sync afterward, you can plan who speaks, what they say, and how the shot plays out from the start. This is especially useful for dialogue-driven shorts and multi-character scenes, where speech and character performance need to stay in sync.
이미지 |
프롬프트: 아침 안개가 드리운 작은 역에서 소년이 미소 지으며 도시락을 건넸다: 「急いで作ったけど、大丈夫? お母さんのレシピだよ。」 소녀도 미소 지으며 그것을 받았다: 「うん、きっと美味しい! 到着したら LINE するね。」 |
비디오 |
끝
Whether you’re making a product ad, a dialogue-driven short, or a multi-shot story, the limitations of current AI video generation technology often show up in familiar ways: a character changes between shots, motion feels off, text breaks apart, or a scene takes several tries to get right. Clear references, shorter shot planning, and controls chosen for the needs of each shot can cut down on unnecessary rework. The Kling VIDEO 3.0 Series brings reference-based subject consistency, Multi-Shot and Custom Multi-Shot, Motion Control, flexible 3–15 second generation, Native-Level Text Output, and Native Audio into the generation workflow, giving creators more control over characters, movement, pacing, dialogue, and visual storytelling.
자주 묻는 질문
2026년에 AI 비디오 생성 기술의 주요 한계는 무엇인가요?
현재 AI 비디오 모델은 장면이 복잡해질수록 일관성을 잃을 수 있다. 샷 사이에서 얼굴이 달라질 수 있고, 동작이 약간 부자연스러워 보이거나, 텍스트가 왜곡될 수 있으며, 긴 시퀀스는 일관성을 유지하기가 더 어렵다. 자세한 프롬프트가 항상 정확한 결과로 이어지지는 않기 때문에, 제작자들은 일반적으로 참조 이미지, 짧은 샷, 그리고 여러 차례의 다듬기를 활용해 원하는 영상에 도달한다.
AI 비디오 생성기는 장편 영상을 만들 수 있을까?
AI 비디오 생성기는 더 긴 클립과 다중 샷 시퀀스를 만들 수 있지만, 영상이 길어질수록 일관성을 유지하기가 어려워진다. DirectorBench 및 MSVBench 와 같은 벤치마크도 샷 전환, 샷 간 일관성, 이야기 연속성 같은 문제에 주목한다. 더 긴 프로젝트에서는 보통 샷 단위로 작업하고, 동일한 참조 자료를 재사용하며, 다음 단계로 넘어가기 전에 각 장면이 어떻게 연결되는지 확인하는 것이 더 수월하다.
왜 AI 생성 영상은 일관성이 없어 보일까?
AI로 생성된 비디오는 모델이 프레임마다 얼굴, 객체, 질감, 기타 장면 세부사항을 안정적으로 유지해야 하기 때문에 일관성이 없어 보일 수 있다. 카메라가 움직이거나 어떤 것이 다른 물체 뒤로 사라졌다가 다시 나타날 때, 이런 세부사항이 달라질 수 있다. 같은 참조 이미지를 사용하고, 더 단순한 동작부터 시작하며, 프롬프트의 한 부분씩만 변경하면 결과를 제어하기가 더 쉬워진다. 얼굴, 제품 또는 소품이 정확히 일치해야 한다면, 클립을 프레임별로 확인하라.
AI 비디오 생성기는 현실적인 물리를 구현할 수 있을까?
AI 비디오는 움직임을 그럴듯하게 만들 수 있지만, 그렇다고 해서 물리가 항상 맞는 것은 아닙니다. T2VPhysBench 는 비디오 모델을 12개의 기본 물리 법칙을 기준으로 테스트한 결과, 중력, 보존 법칙, 기타 물리적 상호작용에서 반복적인 문제를 발견했습니다. 제품이 어떻게 작동하는지, 과학적 과정, 혹은 분명한 인과관계를 보여야 하는 비디오는 실제 영상과 결과를 비교하고 움직임을 면밀히 확인하세요.
2026년 AI 생성 비디오 기술의 핵심 트렌드는 무엇인가요?
2026년 AI 생성 비디오 기술 트렌드에는 비디오를 시작하고 퍼포먼스를 연출하며 동일한 프로젝트 안에서 음성을 처리하는 더 다양한 방법이 포함된다. 크리에이터는 AI 비디오 생성기 또는 image to video AI, 특정 동작을 위해 모션 컨트롤을 사용한 다음 립싱크나 더빙 도구로 구어 대사를 추가할 수 있다. AI 아바타, 네이티브 오디오, 비디오 편집 도구는 숏폼 비디오, 광고 및 현지화된 콘텐츠가 제작되는 방식에서 점점 더 큰 비중을 차지하고 있다.