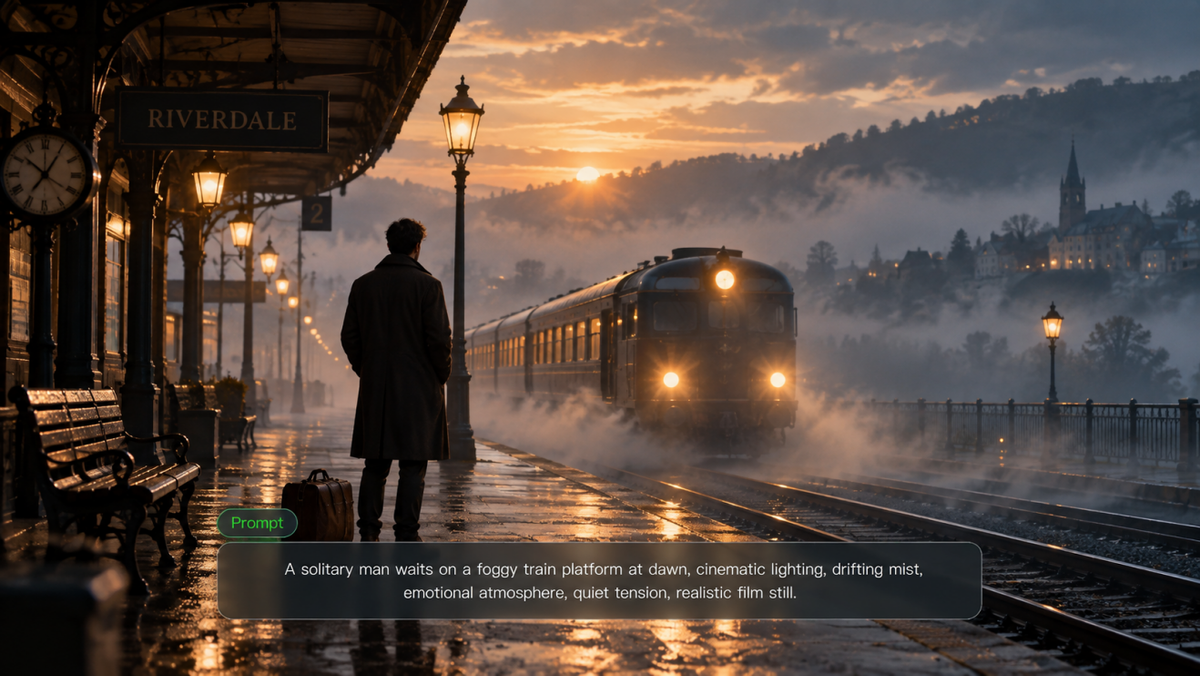
Los modelos de texto a video pueden convertir una escena escrita en un video con movimiento de cámara, sonido y múltiples tomas. El problema es que un clip terminado aún puede apartarse de la indicación, moverse de forma torpe o permitir que un personaje o producto cambie de una toma a la siguiente. Este artículo analiza por qué esas diferencias importan, qué revisar antes de elegir un modelo y cómo Kling VIDEO 3.0 gestiona el control de tomas, el movimiento, el audio y la continuidad visual.
¿Qué son los modelos de texto a video?
Los modelos de texto a video utilizan IA generativa para convertir descripciones en lenguaje natural en video. Una indicación puede especificar el sujeto, el escenario, la acción, el movimiento de cámara y el estilo visual. Si el modelo admite audio, también puede incluir diálogo, sonido ambiental y otras señales de audio.
Los modelos de texto a video y los generadores de IA de texto a video a menudo se tratan como lo mismo, pero desempeñan funciones diferentes:
Modelo de texto a video | Generador de IA de texto a video | |
Qué es | El sistema de IA que interpreta la indicación y genera el video | El producto o la interfaz que las personas utilizan para acceder a la generación de texto a video |
Qué gestiona | Interpretación de indicaciones, generación de escenas, movimiento y continuidad en el tiempo | Funciones construidas alrededor del modelo, como controles de toma, entradas de referencia, audio, duración, relación de aspecto, edición y exportación |
Por qué importa | El modelo afecta directamente la calidad del video, el movimiento y la consistencia visual | El generador influye en cuánto control creativo tienes y qué puedes hacer con el video después |
El modelo determina qué se genera, mientras que un generador de video con IA determina cómo accedes a esas capacidades, controlas el proceso y trabajas con el video terminado.
¿Cómo funcionan los modelos de texto a video?
Los modelos de texto a video convierten una indicación escrita en una secuencia de imágenes en movimiento. El proceso exacto varía según el modelo, pero generalmente implica comprender la indicación, construir una representación comprimida de la escena, determinar cómo cambian las cosas a lo largo del tiempo y mantener el resultado consistente de un momento a otro.
1. Interpretar el prompt
Un modelo de IA de texto a video comienza identificando las instrucciones principales del prompt, incluidas:
- el sujeto
- la acción
- el escenario
- el estilo visual
- la dirección de la cámara
- diálogo u otras pistas de audio, cuando se admitan
| prompt: “Un ciclista recorre una calle del centro bajo la lluvia mientras la cámara lo sigue desde atrás.” |
Esa breve descripción contiene varias instrucciones que deben funcionar juntas. El ciclista avanza, la cámara lo sigue desde atrás, y la lluvia, la calle, la iluminación y el entorno deben tener sentido dentro de la misma toma.
En otras palabras, el prompt describe más que lo que debería aparecer en pantalla. También establece relaciones entre el sujeto, el movimiento, la cámara y el entorno.
2. Crear una representación de video comprimida
Después de leer la indicación, el sistema necesita una representación funcional de la escena antes de que se convierta en metraje final. El método exacto depende de la arquitectura del modelo.
Muchos modelos de texto a video basados en difusión trabajan en un espacio de representación comprimido en lugar de procesar fotogramas a plena resolución desde el principio. Comienzan con ruido y poco a poco lo moldean según la indicación, haciendo que el sujeto, el entorno, la iluminación, la composición y otros detalles visuales entren en escena. Trabajar en este espacio comprimido reduce la cantidad de datos que se manejan durante la generación y, una vez que la escena ha tomado forma, el resultado se decodifica en fotogramas de video visibles.
3. Generar movimiento e interacciones
El video tiene que mostrar lo que sucede de un momento a otro. El modelo debe manejar el movimiento, la interacción de los objetos y los cambios de punto de vista sin romper la escena.
- Movimiento: Un personaje que gira, camina o extiende la mano debe cambiar de pose y posición paso a paso, en lugar de saltar de un estado a otro.
- Interacción con objetos: Las acciones necesitan un orden claro. Si alguien levanta una taza, la mano tiene que alcanzarla y hacer contacto antes de que la taza se mueva.
- Cámara y espacio: Los paneos, las inclinaciones, los acercamientos y los planos de seguimiento cambian el punto de vista, pero el sujeto y el entorno aún deben permanecer anclados en el mismo espacio.
Una imagen fija solo tiene que describir un momento. El vídeo tiene que tener en cuenta lo que ocurre entre los momentos.
4. Mantén la coherencia temporal y audiovisual
A medida que el vídeo avanza, las personas, los objetos y el sonido deben mantenerse coherentes con el tiempo. Esto se reduce principalmente a dos tipos de coherencia:
- Consistencia temporal: Los personajes, productos, vestuario, accesorios, iluminación y fondos no deberían cambiar sin un motivo claro de un momento a otro. Incluso después de un corte de un primer plano a una toma amplia o de un cambio en el ángulo de la cámara, la misma persona o producto debería seguir siendo fácil de reconocer.
- Consistencia audiovisual: El diálogo, el movimiento de labios, las expresiones faciales, el sonido ambiente y las acciones en pantalla deben ocurrir en el momento adecuado. Cuando un personaje habla, el movimiento de la boca debe coincidir con el diálogo, mientras que los pasos o los sonidos de impacto deben coincidir con la acción a la que pertenecen.
¿Para qué puedes usar la IA de texto a video?
La IA de texto a video funciona bien en situaciones en las que una idea necesita verse antes de que valga la pena producirla a gran escala. Puede ayudar con las primeras pruebas creativas, las escenas difíciles de filmar y los proyectos que necesitan varias direcciones visuales antes de comenzar la producción.
Crea videos para redes sociales
El contenido social tiene una vida útil corta, por lo que organizar una nueva sesión de rodaje para cada publicación o concepto de campaña rara vez tiene sentido. Un prompt puede generar clips para teasers, anuncios, publicaciones de campaña o videos cortos impulsados por historias sin reconstruir el montaje de producción cada vez. Los creadores también pueden probar diferentes configuraciones, movimientos de cámara y direcciones visuales antes de decidirse por una versión.
Transforma las ideas de producto en videos de marketing
El texto publicitario y las maquetas estáticas no siempre muestran cómo se verá un producto una vez que se mueva por una escena. La IA de texto a video permite a los especialistas en marketing colocar el mismo producto en diferentes entornos, explorar conceptos de anuncios y probar tratamientos visuales en etapas más tempranas del proceso. Si el producto aparece en varias tomas, los resultados también revelan qué tan bien se mantienen su forma, color y detalles distintivos de una toma a la siguiente.
Crea escenas narrativas cortas
Planificar un relato corto se vuelve más difícil una vez que incluye varios planos, acciones de los personajes, cambios de cámara y diálogo. La IA de texto a video puede mapear esos elementos en una secuencia, lo que facilita probar el orden de los planos, el ritmo y la sincronización del diálogo antes de que cada escena se construya por separado. Esto es especialmente útil para piezas cinematográficas breves en las que la historia depende de más de una toma continua.
Visualizar conceptos y guiones gráficos
Un tratamiento o guion gráfico puede explicar lo que debería suceder, pero el ritmo y el movimiento de cámara son más difíciles de evaluar en una página estática. Convertir la idea en movimiento les da a directores, diseñadores y equipos creativos algo más cercano a la experiencia de visionado final. Pueden comparar encuadres, probar transiciones y detectar momentos débiles mientras los cambios aún son fáciles de realizar.
Crear videos educativos y explicativos
Algunos sujetos son difíciles de capturar con una cámara porque son caros, abstractos, inaccesibles o imposibles de escenificar. La IA de texto a video puede ilustrar un proceso, reconstruir un escenario o mostrar un evento que no puede filmarse directamente. Para explicaciones, material de formación y contenido de aula, el movimiento puede facilitar la comprensión de un concepto cuando una imagen fija no muestra lo suficiente.
¿Cómo elegir el mejor modelo de IA de texto a video para tu proyecto?
Ningún modelo de IA de texto a video es adecuado para todos los proyectos. Comienza con lo que quieres crear y luego decide qué capacidades son más importantes para esa tarea. Las principales cosas que comparar son la adherencia al prompt, el movimiento y la plausibilidad física, la consistencia, el control creativo, el audio y los límites del resultado y del flujo de trabajo.
Adherencia al prompt
Primero, verifica si el modelo realmente sigue la instrucción. El sujeto, la acción, el escenario, el estilo visual y la dirección de la cámara deberían aparecer todos juntos en lugar de solo los detalles más obvios. Si pides un ciclista pedaleando bajo la lluvia mientras la cámara lo sigue desde atrás, el ciclista, el clima, el movimiento y el punto de vista deberían estar presentes. Lo que el modelo omite puede decirte tanto como lo pulido que se ve el metraje.
Movimiento y plausibilidad física
Las acciones deben desarrollarse en un orden claro. Caminar, girar, alcanzar, las colisiones y el movimiento de la cámara deben pasar de un estado al siguiente sin saltos repentinos. La interacción física también importa: una mano debe entrar en contacto antes de que un objeto se mueva, un aterrizaje debe afectar al cuerpo, y el cabello, la tela, el agua o los objetos sueltos deben responder al movimiento cercano en lugar de comportarse por su cuenta.
Consistencia de personajes y productos
El mismo sujeto debe seguir siendo reconocible cuando cambian el encuadre, el ángulo o la distancia. Los rostros, la vestimenta, la forma del producto, el color, los accesorios, la iluminación y otros detalles definitorios no deberían desviarse sin motivo. Las escenas con múltiples tomas hacen que esto sea más difícil, por lo que los proyectos construidos en torno a personajes o productos recurrentes también deben verificarse en busca de imágenes de referencia, referencias del sujeto u otra forma de trasladar la identidad visual de toma en toma.
Control creativo y de cámara
Cuando una escena ya tiene una dirección visual clara, el control importa. El encuadre, el movimiento de cámara, el orden de las tomas, las referencias de entrada, la relación de aspecto y la estructura de múltiples tomas afectan lo estrechamente que el resultado se ajusta a la idea original. Un control más fino también significa que es menos probable que vuelvas a ejecutar toda una secuencia solo para cambiar un ángulo, reordenar una toma o corregir la composición.
Soporte de audio
Las capacidades de audio difieren mucho entre modelos. Algunos generan solo contenido visual, mientras que otros pueden crear diálogo, sonido ambiental y efectos junto con las imágenes. En escenas con mucho diálogo, verifica si la voz, el movimiento de la boca, la expresión facial y la sincronización se mantienen alineados. Los pasos, los impactos y los sonidos ambientales también deberían coincidir con la acción a la que pertenecen.
Duración, resolución y flujo de trabajo
Analiza los límites que afectan al video final, incluida la duración de generación, las relaciones de aspecto compatibles, las resoluciones disponibles y las opciones de exportación. Un clip breve para redes sociales y una escena de producto con múltiples tomas pueden tener requisitos de salida muy diferentes.
Lo que ocurre después de la generación es igual de importante. ¿Puedes extender el clip, reutilizar el mismo sujeto, revisar una toma, regenerar el audio o continuar editando sin empezar desde cero? Los cambios pequeños no deberían obligarte a reconstruir toda la secuencia.
Los diferentes proyectos requieren distintas prioridades. Comienza con el tipo de video que estás creando y luego céntrate en las capacidades que más importan:
Si quieres crear | Prioriza | Por qué es importante |
Videos cortos para redes sociales | Fidelidad al prompt, relaciones de aspecto, flujo de trabajo | El contenido social se mueve con rapidez, por lo que el resultado debe mantenerse fiel a la idea, ajustarse a los formatos habituales de las plataformas y ser fácil de revisar. |
Videos de producto y marketing | Coherencia del producto, cumplimiento del prompt, resolución | La forma del producto, el color, la identidad de marca y los detalles clave deben mantenerse estables entre tomas, mientras que el metraje final sigue cumpliendo las necesidades de la campaña o la presentación. |
Escenas narrativas o cinematográficas cortas | Movimiento y plausibilidad física, control de cámara, coherencia entre múltiples tomas | Las acciones de los personajes, los cambios de cámara y las transiciones de escena deben conectarse a lo largo de la secuencia sin una deriva visual evidente. |
Videos centrados en el diálogo | Compatibilidad con audio, sincronización labial, coherencia de los personajes | El diálogo, el movimiento de la boca, la actuación facial y la identidad del personaje deben permanecer alineados, mientras que el sonido debe llegar en el momento adecuado. |
Vistas previas de conceptos y guiones gráficos | Control creativo y de cámara, entradas de referencia, flexibilidad de revisión | El objetivo es probar la composición, la dirección de cámara, el ritmo y las ideas alternativas desde el principio, mientras los cambios aún son fáciles de realizar. |
Videos educativos y explicativos | Cumplimiento del prompt, movimiento y plausibilidad física, flujo de trabajo | Los elementos visuales deben explicar un proceso o idea con precisión, mantener el movimiento fácil de seguir y permitir revisiones cuando el contenido cambie. |
¿Qué puedes hacer con Kling VIDEO 3.0?
La parte difícil de texto a video no es conseguir una sola toma que se vea bien. Es lograr que el sujeto, la acción, la dirección de cámara, el sonido y los pequeños detalles visuales del prompt aparezcan tal como los ideaste. A medida que los prompts se vuelven más detallados y las escenas agregan más tomas, el modelo tiene más elementos que seguir de un momento a otro.
Kling VIDEO 3.0 está diseñada en torno a esas exigencias, con una interpretación más sólida de las indicaciones, narración con múltiples tomas, coherencia de sujetos, audio nativo, duración flexible y renderizado de texto. En lugar de escribir una descripción y simplemente esperar a ver qué regresa, puedes moldear cómo se desarrolla la historia, cuándo cambia la cámara, cómo los sujetos se trasladan entre tomas y dónde entra el sonido en la escena.
Comprende y sigue las indicaciones con mayor precisión
Kling VIDEO 3.0 puede interpretar indicaciones en capas que combinan sujetos, acciones, escenarios, dirección de cámara y estructura narrativa. Esto ayuda a que las indicaciones complejas de texto a video se mantengan más cerca de la escena prevista, especialmente cuando implican múltiples acciones, movimientos de cámara planificados o una secuencia específica de eventos.
Mantén la coherencia de personajes y productos entre tomas
Un personaje puede lucir correctamente en una toma y aun así cambiar de forma notable desde otro ángulo. En un vídeo con múltiples tomas, los rostros pueden desplazarse, los detalles de la ropa pueden variar, y el color, la forma o los rasgos distintivos de un producto pueden cambiar de una toma a la siguiente.
En los flujos de trabajo compatibles de VIDEO 3.0 asistidos por referencias, puedes usar múltiples imágenes de referencia para proporcionar orientación visual adicional y ayudar a anclar un personaje recurrente, un producto u otro sujeto clave a través de cambios en el encuadre, el ángulo y el entorno. Estas referencias proporcionan al modelo más información sobre la apariencia del sujeto y los detalles visuales clave, lo que ayuda a reducir el evidente desplazamiento visual en escenas con personajes recurrentes, tomas de productos y contenido de marca.
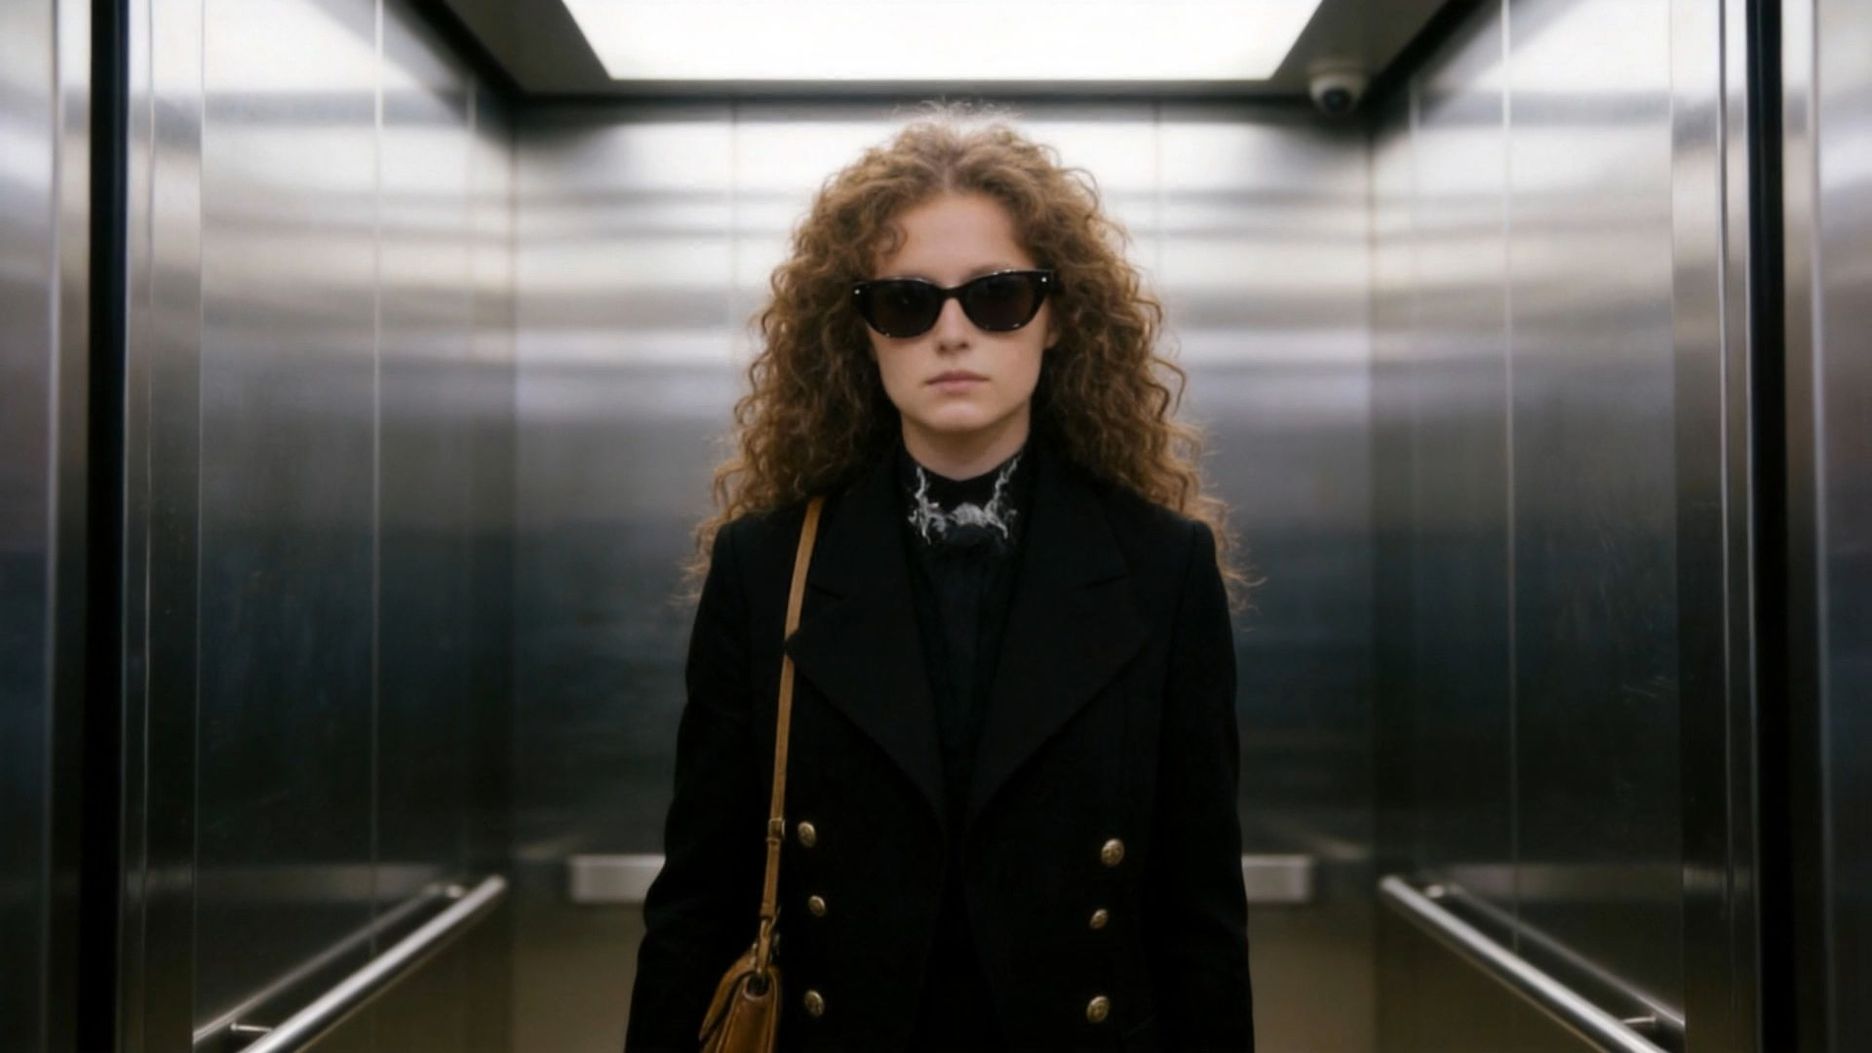

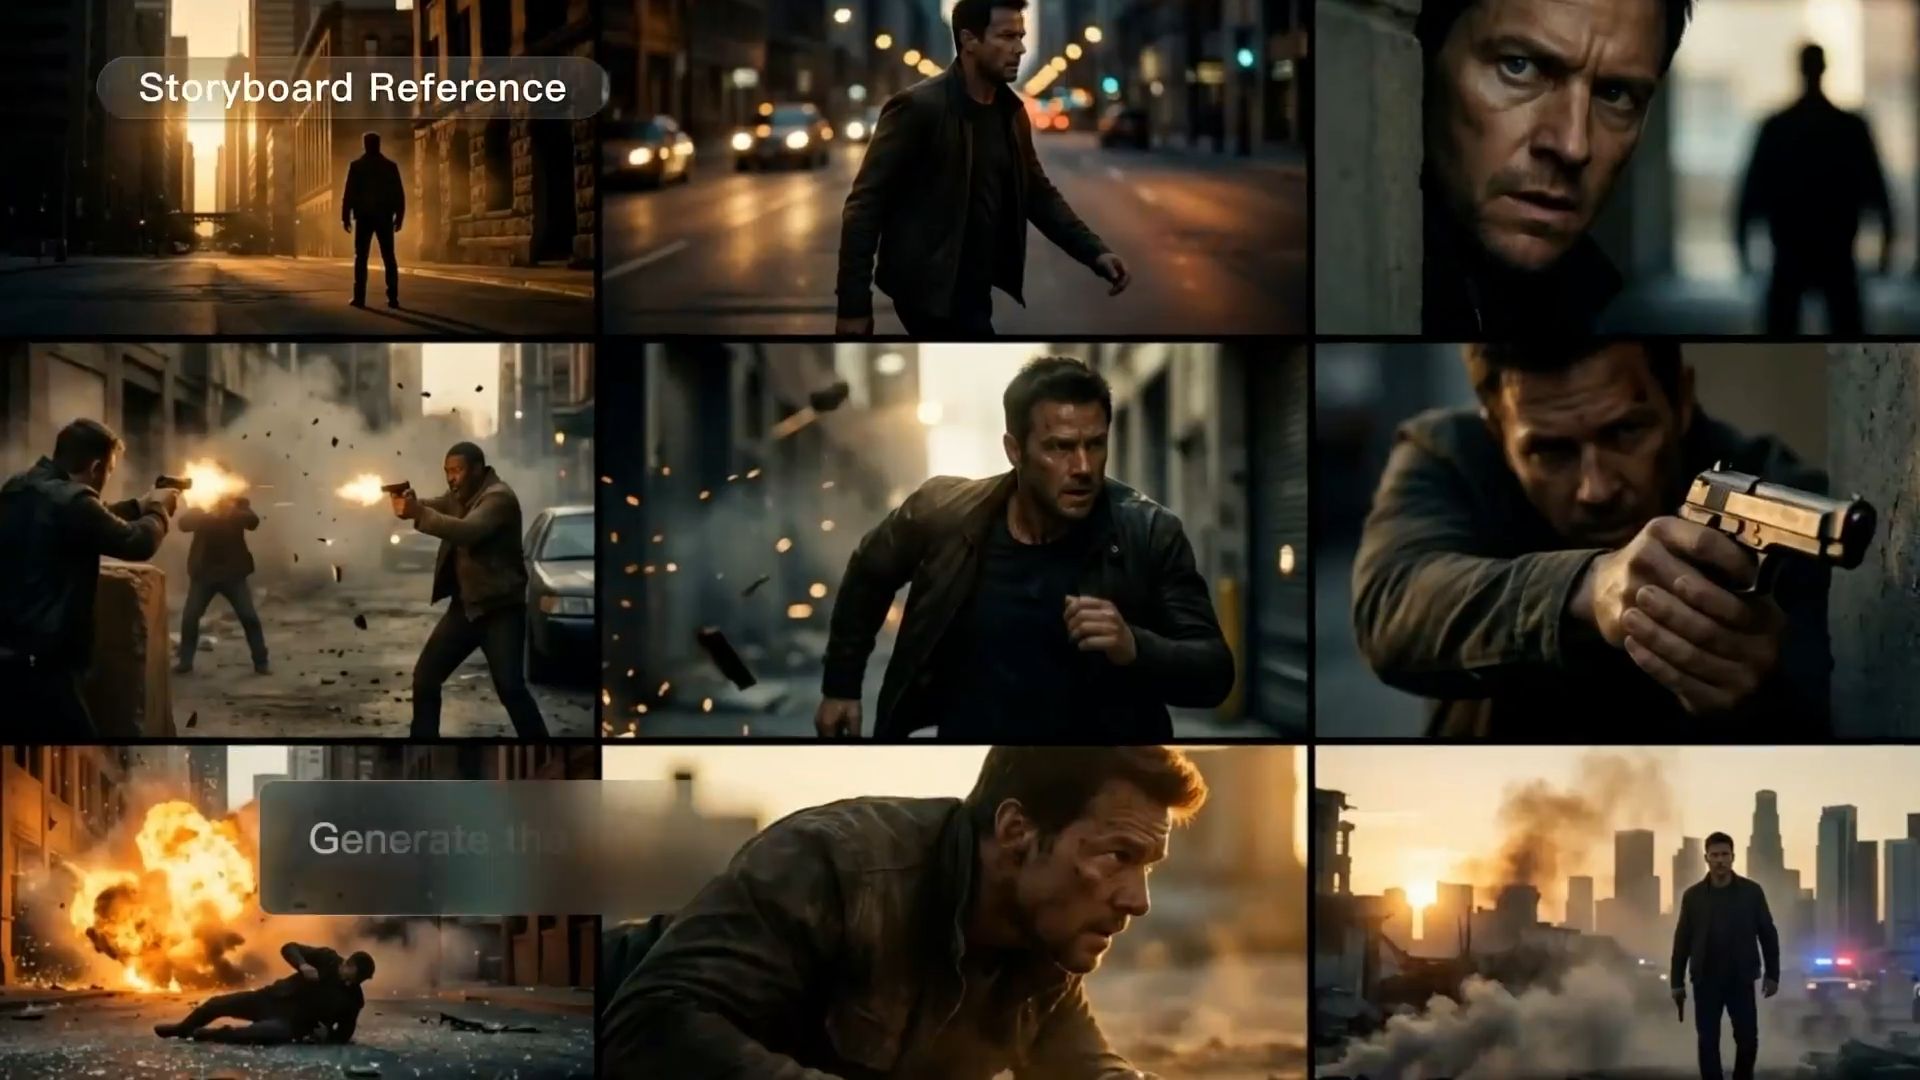
Crea historias de múltiples tomas con mayor control sobre el ritmo
Un único plano suele ser manejable. El reto empieza cuando una historia necesita primeros planos, planos generales, diferentes posiciones de cámara y cambios de escena. Generar cada plano por separado implica más montaje después y se vuelve más difícil mantener el ritmo y la continuidad intactos a lo largo de la secuencia.
Multi-Shot de Kling VIDEO 3.0 puede manejar varios planos en una sola generación, convirtiendo un único prompt en una secuencia conectada en lugar de un conjunto de clips aislados. Para una secuencia planificada, Custom Multi-Shot te permite definir el contenido, el orden y la duración de los planos individuales, de modo que los cortes y el ritmo queden fijados antes de que comience la generación.
Genera el diálogo y el sonido de la escena juntos
Cuando un modelo de video produce solo imágenes, las escenas con diálogo requieren trabajo adicional. Las voces, el sonido ambiente, los efectos y el timing deben gestionarse después. Si añades varios personajes, también tienes que llevar un control de quién dice cada línea y de si el sonido coincide con la acción correcta en pantalla.
El audio nativo de Kling VIDEO 3.0 genera diálogos, sonidos ambientales y otros elementos de audio junto con el video. En escenas con varios personajes, puedes asignar líneas a distintos hablantes, con compatibilidad para chino, inglés, japonés, coreano y español, además de los dialectos y acentos admitidos. La voz, la interpretación de los personajes y el sonido de la escena se integran en la misma generación en lugar de añadirse después a un clip silencioso.
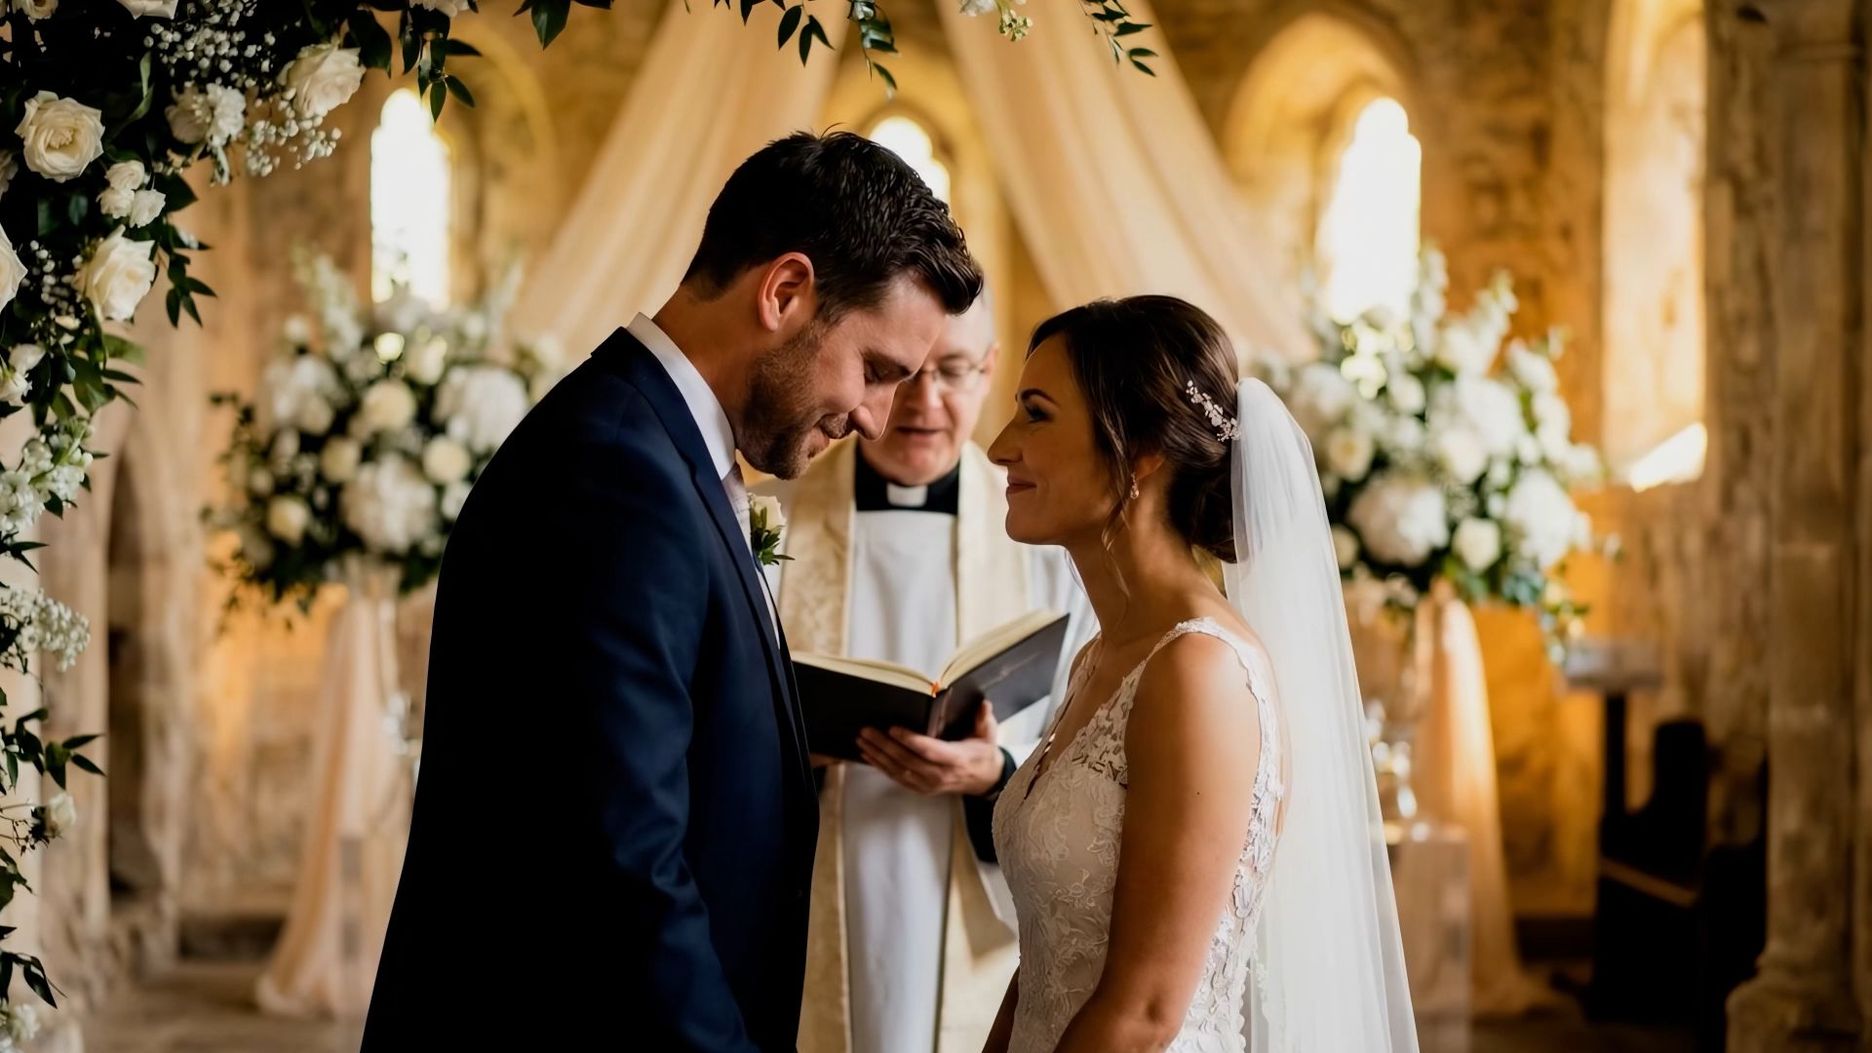
Crea historias más largas de hasta 15 segundos y salida 4K
Kling VIDEO 3.0 ofrece a los creadores más espacio para desarrollar cada escena, con una generación flexible de 3 a 15 segundos para interacciones entre personajes, narrativas de múltiples planos, diálogos y transiciones. En los flujos de trabajo compatibles, la salida de hasta 4K conserva detalles más finos, texturas y la claridad visual general, lo que ayuda a los creadores a pasar de los conceptos iniciales a contenido pulido para publicidad, presentaciones de productos, narrativas cinematográficas y más.
Fin
Los modelos de texto a video que merecen tu tiempo hacen más que animar un prompt: siguen tu intención, se mueven con naturalidad, llegan con sonido y mantienen un sujeto estable entre planos. Evaluado con esos criterios, Kling VIDEO 3.0 reúne en un solo lugar la generación impulsada por prompt, el control Multi-Shot, la consistencia de sujetos y audio nativo. Abre Kling, escribe tu escena y mírala cobrar vida en una sola generación.
Preguntas frecuentes
¿Cómo elijo entre los mejores modelos de IA de texto a video en 2026?
Comienza con el tipo de video que quieres hacer y luego compara los modelos en función de ese trabajo. La narración Multi-shot otorga mayor peso al control de la cámara y la consistencia de los personajes. Las escenas con mucho diálogo requieren un audio potente, sincronización labial y desempeño de los personajes, mientras que el trabajo de productos y anuncios depende más del cumplimiento de las instrucciones, la estabilidad del sujeto y la calidad de la salida. La longitud y la resolución también importan, ya que una prueba rápida y una pieza terminada rara vez tienen los mismos requisitos. Kling VIDEO 3.0 combina Multi-Shot, Native Audio, cumplimiento de las instrucciones y generación de hasta 15 segundos para historias multi-shot, escenas impulsadas por el diálogo y proyectos en los que el mismo personaje o producto debe seguir siendo reconocible a lo largo de los planos.
¿Puede la IA de texto a video incluir sonido?
Sí. Kling VIDEO 3.0 puede generar diálogo, sonido ambiental y efectos junto con el video, por lo que no tienes que agregar el audio después. Puedes escribir las líneas directamente en la indicación, asignarlas a personajes específicos y elegir el idioma, dialecto o acento. Su text-to-speech puede convertir esas líneas en voces de personajes en chino, inglés, japonés, coreano y español. Eso significa menos trabajo de doblaje por separado y menos montaje de audio después de que se genere el video.
¿Cuánto puede durar un video generado?
La duración del video varía según el modelo. Kling VIDEO 3.0 admite una generación flexible de 3 a 15 segundos. Los clips más cortos funcionan bien para acciones rápidas y contenido social, mientras que los clips más largos dejan más tiempo para la preparación, el diálogo y la narración con múltiples tomas. Para videos terminados que necesitan un detalle visual más fino, los modos compatibles también ofrecen salida de hasta 4K, lo que aporta mayor claridad a las texturas de productos, los detalles de los personajes y la profundidad de la escena.
¿Necesito habilidades de edición de video?
Si deseas hacer cambios después de la generación, el flujo de trabajo de edición VIDEO 3.0 Omni de Kling te permite modificar el metraje existente con instrucciones en lenguaje natural, incluyendo cambiar fondos, sujetos, estilo o encuadre.