किसी प्रशिक्षण कोर्स को स्पष्ट नैरेशन की आवश्यकता होती है। किसी पॉडकास्ट को तेज़ वॉयस सुधार की जरूरत पड़ सकती है। किसी काल्पनिक चरित्र को ऐसी पंक्ति चाहिए जो स्क्रीन पर हो रही घटना से मेल खाए। सर्वश्रेष्ठ AI वॉयस जेनरेटर चुनने की शुरुआत सबसे बड़े वॉयस लाइब्रेरी से नहीं, बल्कि अंतिम प्रोजेक्ट से होती है। उदाहरण के लिए, जब संवाद को किसी विज़ुअल सीन का हिस्सा बनना हो, तब Kling AI पर भी विचार करना चाहिए।
AI वॉयस जेनरेटर चुनते समय क्या मायने रखता है?
अपनी आवश्यक आउटपुट से शुरुआत करें। AI वॉयस जेनरेटर का उपयोग, टूल पर निर्भर करते हुए, स्वतंत्र भाषण या वीडियो के भीतर चरित्र संवाद के लिए किया जा सकता है। जब आपको पता चल जाए कि कौन-सा प्रारूप आपके प्रोजेक्ट में फिट बैठता है, तो कुछ व्यावहारिक विवरणों की तुलना करें:
- वाणी की गुणवत्ता: सुनते समय स्पष्ट उच्चारण, स्वाभाविक विराम और स्क्रिप्ट के अनुरूप जोर पर ध्यान दें।
- भाषा और वॉयस विकल्प: आवश्यक भाषा, लहजे और वॉयस शैली को देखें, सिर्फ कुल वॉयस की संख्या पर नहीं।
- रीविजन टूल्स: जानें कि क्या आप पूरे प्रोजेक्ट को फिर से बनाए बिना केवल एक पंक्ति ठीक कर सकते हैं।
- अधिकार और अनुमतियाँ: किसी व्यक्ति की आवाज़ की क्लोनिंग से पहले लागू लाइसेंसिंग शर्तों की पुष्टि करें और सहमति प्राप्त करें।
- प्रोजेक्ट उपयुक्तता: निर्धारित करें कि आपको ऑडियो डाउनलोड, प्रतिलेख आधारित संपादन, या वीडियो के साथ उत्पन्न संवाद की आवश्यकता है या नहीं।
अपने वास्तविक स्क्रिप्ट का उपयोग करके किया गया एक छोटा परीक्षण केवल फीचर गिनती के आधार पर चुनने की तुलना में अधिक जानकारीपूर्ण होता है।
सर्वश्रेष्ठ एआई वॉइस जेनेरेटर: 6 विकल्पों की तुलना
ये टूल आवाज़ निर्माण को अलग-अलग तरीकों से अपनाते हैं। तालिका उनके मुख्य उपयोग मामलों और वर्कफ़्लो को रेखांकित करती है, और उसके बाद प्रत्येक विकल्प पर विस्तृत नज़र डाली गई है।
टूल | के लिए सर्वोत्तम | वॉइस और संवाद क्षमताएँ | सामान्य कार्यप्रवाह |
Kling AI (Kling 4.0) | एकीकृत संवाद और दृश्य वाले AI वीडियो, जिनमें व्याख्यात्मक वीडियो, शैक्षणिक सामग्री, पात्र-प्रमुख विपणन, एनिमेटेड कहानियाँ, और बहुभाषी सोशल वीडियो शामिल हैं।
| मूल ऑडियो-विज़ुअल निर्माण, नौ भाषाओं में संवाद, प्रॉम्प्ट-निर्देशित बहु-पात्र वार्तालाप, बेहतर lip-sync संरेखण, और रूप तथा आवाज़ बाइंडिंग वाले पुनः प्रयोज्य किरदार तत्व। | प्रॉम्प्ट्स का उपयोग करके संवाद, अभिव्यक्तियों, क्रियाओं और कैमरा मूवमेंट को निर्देशित करें। Omni Reference के साथ, समर्थित छवियों, वीडियो, Elements और वॉयस संदर्भों को मिलाकर दृश्य शैली, गति और मुख्य कहानी बिंदुओं को मार्गदर्शित करें।
|
ElevenLabs | वर्णन, अभिव्यंजक वॉयस ट्रैक्स और वॉयस डिज़ाइन | टेक्स्ट-टू-स्पीच, वॉयस डिज़ाइन और क्लोनिंग, अभिव्यंजक भाषण, और मल्टी-स्पीकर संवाद। | किसी आवाज़ का चयन या डिज़ाइन करें, स्क्रिप्ट दर्ज करें, डिलीवरी समायोजित करें और ऑडियो उत्पन्न करें। |
Murf AI | व्यवसाय, प्रशिक्षण और प्रस्तुति वॉयसओवर | गति, पिच, जोर और टोन के नियंत्रणों के साथ AI नैरेशन, साथ ही मल्टीमीडिया सामग्री के लिए वॉयसओवर प्रोडक्शन। | एक स्क्रिप्ट तैयार करें, आवाज़ चुनें, डिलीवरी को परिष्कृत करें और नैरेशन को विज़ुअल्स के साथ जोड़ें। |
Speechify Studio | क्रिएटर वॉयसओवर और वीडियो डबिंग | स्पीकर की आवाज़, स्वराघात और गति से मेल खाने के विकल्पों के साथ AI वॉयसओवर और डबिंग। | एक स्क्रिप्ट या वीडियो जोड़ें, एक आवाज़ और भाषा चुनें, नैरेशन या डबिंग बनाएँ, और परिणाम की समीक्षा करें। |
Descript | पॉडकास्ट, साक्षात्कार, और बोले गए कंटेंट के संशोधन | AI वॉइसेज़ और वॉइस क्लोनिंग, ट्रांसक्रिप्ट-आधारित संपादन, और पुनः निर्मित भाषण। समर्थित वीडियो पुनर्जनन मुँह की हरकतों को भी समायोजित कर सकता है। | ट्रांसक्रिप्ट संपादित करें, सुधार टाइप करें, चुनी गई पंक्तियों को पुनः उत्पन्न करें, और ऑडियो या वीडियो की समीक्षा करें। |
LOVO (Genny) | मार्केटिंग वॉइसओवर और मल्टीमीडिया प्रोजेक्ट्स | टेक्स्ट-टू-स्पीच वॉइसओवर और एक वीडियो वर्कस्पेस जो एक या अधिक वक्ताओं वाले प्रोजेक्ट्स का समर्थन करता है। | स्क्रिप्ट दर्ज करें, आवाजें चुनें, वॉइसओवर जनरेट करें, और Genny में विजुअल्स व ऑडियो संयोजित करें। |
1.Kling AI: एआई वीडियो में कैरेक्टर संवाद के लिए सर्वश्रेष्ठ
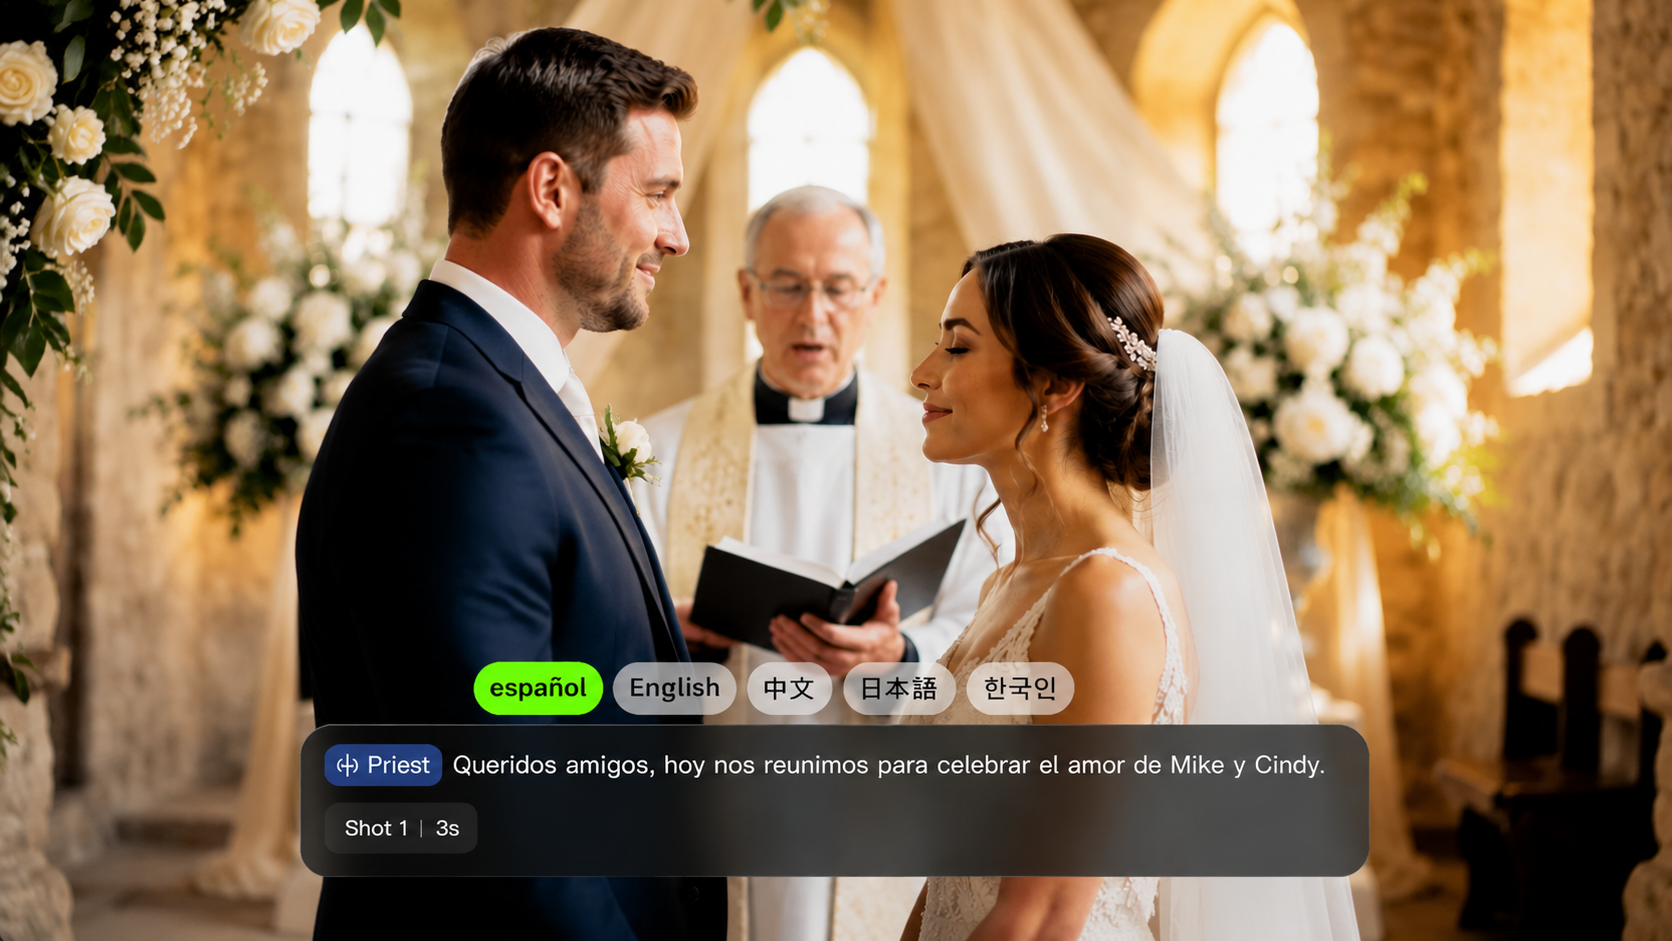
कैरेक्टर-प्रधान दृश्यों के लिए, Kling 4.0 ऑडियो और विजुअल को साथ में जनरेट करता है, जिससे क्रिएटर्स एक ही वीडियो में संवाद, अभिव्यक्तियों, इशारों और कैमरा फ़्रेमिंग को निर्देशित कर सकते हैं। यह नौ भाषाओं में संवाद का समर्थन करता है—चीनी, अंग्रेज़ी, जापानी, कोरियाई, स्पैनिश, पुर्तगाली, जर्मन, फ्रेंच और हिंदी—और बेहतर लिप-सिंक संरेखण प्रदान करता है ताकि बोले गए संवाद को कैरेक्टर प्रदर्शन से जोड़ने में मदद मिले।
Omni Reference के साथ, आप समर्थित छवियों, वीडियो, Elements और वॉयस संदर्भों को मिलाकर पात्र की उपस्थिति और ध्वनि का मार्गदर्शन कर सकते हैं। आवर्ती पात्रों के लिए, आप परिभाषित दृश्य विशेषताओं और एक बाउंड वॉयस वाले किसी चरित्र Element को बना या चुन सकते हैं, जिससे दृश्यों में एक पहचानने योग्य उपस्थिति और वोकल पहचान बनाए रखने में मदद मिलती है।
संवाद-आधारित दृश्यों से आगे, हमारा Kling 4.0 मॉडल एक ही जेनरेशन में 30 सेकंड तक के वीडियो का समर्थन करता है, जिसमें अधिक स्थिर बड़े पैमाने की गति और जटिल कैमरा मूवमेंट होते हैं। महत्वपूर्ण दृश्य क्षणों को निर्देशित करने के लिए संदर्भ सामग्रियों में कीफ्रेम छवियों को शामिल करके, निर्माता अधिक सुसंगत कथानक बना सकते हैं और अधिक नियंत्रण और स्थिरता के साथ उच्च-गुणवत्ता वाले AI वीडियो तैयार कर सकते हैं।

2.ElevenLabs: वर्णन और चरित्र वॉइस ट्रैक्स के लिए सर्वश्रेष्ठ
ElevenLabs कथानक, कथा-साहित्य और चरित्र संवाद जैसे प्रोजेक्ट्स के लिए बोले गए ऑडियो का उत्पादन करने पर केंद्रित है। क्रिएटर्स चयनित आवाज़ों या समर्थित स्थानों पर अधिकृत वॉइस-क्लोनिंग फीचर्स के साथ काम कर सकते हैं। यह उन प्रोजेक्ट्स के लिए उपयुक्त है जिनमें भाषण ट्रैक मुख्य आउटपुट होता है; उत्पादन वर्कफ़्लो अपनाने से पहले इच्छित भाषा और लाइसेंसिंग शर्तों की जाँच करें।
3.Murf AI: व्यावसायिक और प्रशिक्षण वॉयसओवर के लिए सर्वश्रेष्ठ
Murf AI प्रस्तुतियों, प्रशिक्षण सामग्रियों और व्याख्यात्मक सामग्री के लिए उपयुक्त स्क्रिप्ट-केंद्रित वॉयसओवर वर्कफ़्लो प्रदान करता है। टीमें संरचित संदेश के साथ-साथ नैरेशन तैयार कर सकती हैं, डिलीवरी समायोजित कर सकती हैं, और रिकॉर्डिंग की समीक्षा कर सकती हैं। जिस आवाज़ और प्लान का आप उपयोग करना चाहते हैं, उसके लिए उच्चारण विकल्पों और एक्सपोर्ट अधिकारों की पुष्टि करें।
4.Speechify Studio: सरल क्रिएटर वॉयसओवर के लिए सर्वश्रेष्ठ
Speechify Studio आवाज़-ओवर और वर्णित सामग्री बनाने के लिए ब्राउज़र-आधारित वातावरण प्रदान करता है। यह सरल क्रिएटर वीडियो या शैक्षिक सामग्री के लिए उपयुक्त है जहाँ स्क्रिप्ट प्रविष्टि और तेज़ संशोधन मायने रखते हैं। चुने गए उत्पाद और योजना में कौन से वॉयस, भाषाएँ, और संपादन नियंत्रण शामिल हैं, यह अवश्य जाँचें.
5.Descript: संपादन के साथ-साथ वॉइस जेनरेशन के लिए सर्वश्रेष्ठ
Descript ट्रांसक्रिप्ट-आधारित संपादन के साथ ऑडियो और वीडियो परियोजनाओं को संयोजित करता है। यह तब उपयोगी है जब किसी पॉडकास्ट, साक्षात्कार या वॉइसओवर में बार-बार स्क्रिप्ट परिवर्तन और सुधार किए जाने हों। जनरेटेड स्पीच और रिप्लेसमेंट फीचर्स के अपने एक्सेस और प्राधिकरण आवश्यकताएँ होती हैं, इसलिए रिकॉर्डिंग में संशोधन करने के बाद संक्रमणों की सावधानी से समीक्षा करें.
6.LOVO: मार्केटिंग वॉइसओवर्स और मल्टीमीडिया प्रोजेक्ट्स के लिए सर्वश्रेष्ठ
LOVO के Genny workspace में जनरेट की गई नैरेशन को मल्टीमीडिया प्रोजेक्ट्स को तैयार करने वाले टूल्स के साथ जोड़ा जाता है। यह उन मार्केटिंग एक्सप्लेनेर्स या प्रेज़ेंटेशन शैली के वीडियो के लिए मददगार हो सकता है जिन्हें विज़ुअल्स के साथ एक वॉइस ट्रैक की आवश्यकता होती है। अपने प्लान पर लागू आउटपुट फ़ॉर्मैट, प्रोजेक्ट अलाउंस, और वॉइस-उपयोग की शर्तों की पुष्टि करें।
चरित्र संवाद वाले AI वीडियो के लिए Kling 4.0 क्यों चुनें?
एक ऑडियो-प्राथमिक टूल बोले गए ट्रैक को जनरेट कर सकता है, लेकिन कैरेक्टर-प्रधान वीडियो में संवाद को स्क्रीन पर दिख रहे वक्ता, भावनाओं, क्रिया और टाइमिंग से मेल खाना भी ज़रूरी होता है। Kling 4.0 इन तत्वों को एक नैटिव ऑडियो-विज़ुअल जनरेशन वर्कफ़्लो में लाता है, जिससे आप भाषण और दृश्य प्रदर्शन को एक साथ निर्देशित कर सकते हैं। रेफ़रेंस-निर्देशित क्रिएशन और अधिक सटीक नैरेटिव नियंत्रण के साथ मिलकर यह तरीका बहुभाषी बातचीत, एनिमेटेड कहानियों, आवर्ती कैरेक्टर, और कैरेक्टर-प्रधान मार्केटिंग वीडियो के लिए उपयोगी है।
मेल खाते कैरेक्टर प्रदर्शन के साथ बहुभाषी संवाद जनरेट करें
Kling 4.0 में, आप बता सकते हैं कि कौन बोलता है, प्रत्येक किरदार क्या कहता है, वे कैसे प्रतिक्रिया देते हैं, और कैमरा बातचीत को कैसे फ्रेम करता है। हर वक्ता की भाषा, लहजा, विराम, हावभाव और भावनात्मक प्रतिक्रिया निर्दिष्ट करें ताकि दृश्य अधिक जुड़ा हुआ महसूस हो। मॉडल नौ भाषाओं का समर्थन करता है और बेहतर लिप-सिंक अलाइनमेंट प्रदान करता है, जिससे बोले गए संवाद किरदार की ऑन-स्क्रीन परफॉर्मेंस से मेल खाते हैं।
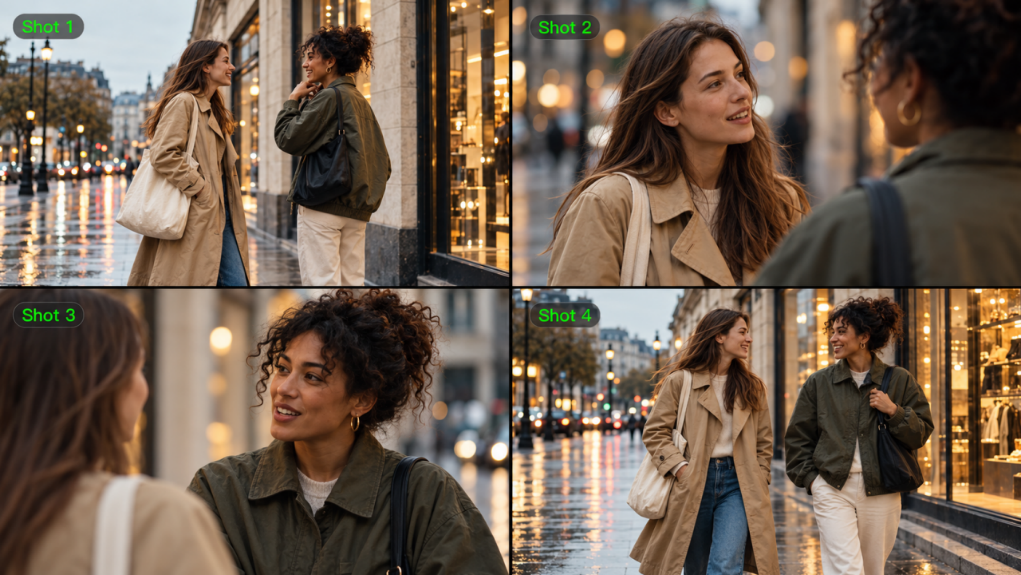
बहु-किरदार दृश्यों के लिए, प्रत्येक वक्ता की पंक्तियाँ स्पष्ट रखें और उनकी प्रतिक्रियाएँ क्रमवार वर्णित करें। उदाहरण के लिए, एक पर्यटक स्पेनिश में प्रश्न पूछ सकता है, एक दुभाषिया उसे चीनी में अनुवाद कर सकता है, और एक स्टाफ सदस्य चीनी में उत्तर दे सकता है। आप उसी प्रॉम्प्ट में बातचीत और किरदारों की क्रियाओं का मार्गदर्शन कर सकते हैं, फिर परिणामी संवाद, होंठों की गतिविधि और समय-निर्धारण की समीक्षा कर सकते हैं।
संदर्भ छवि | उत्पन्न वीडियो |
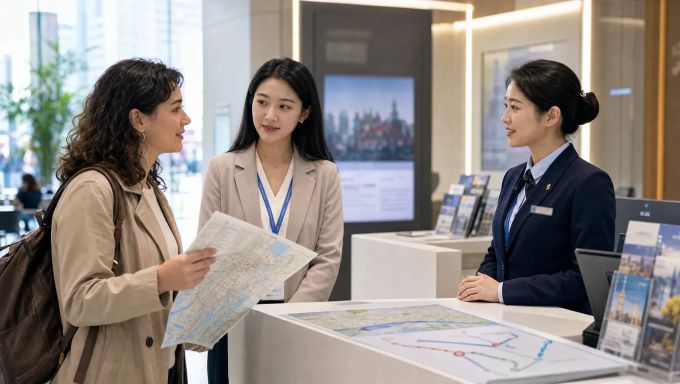 | 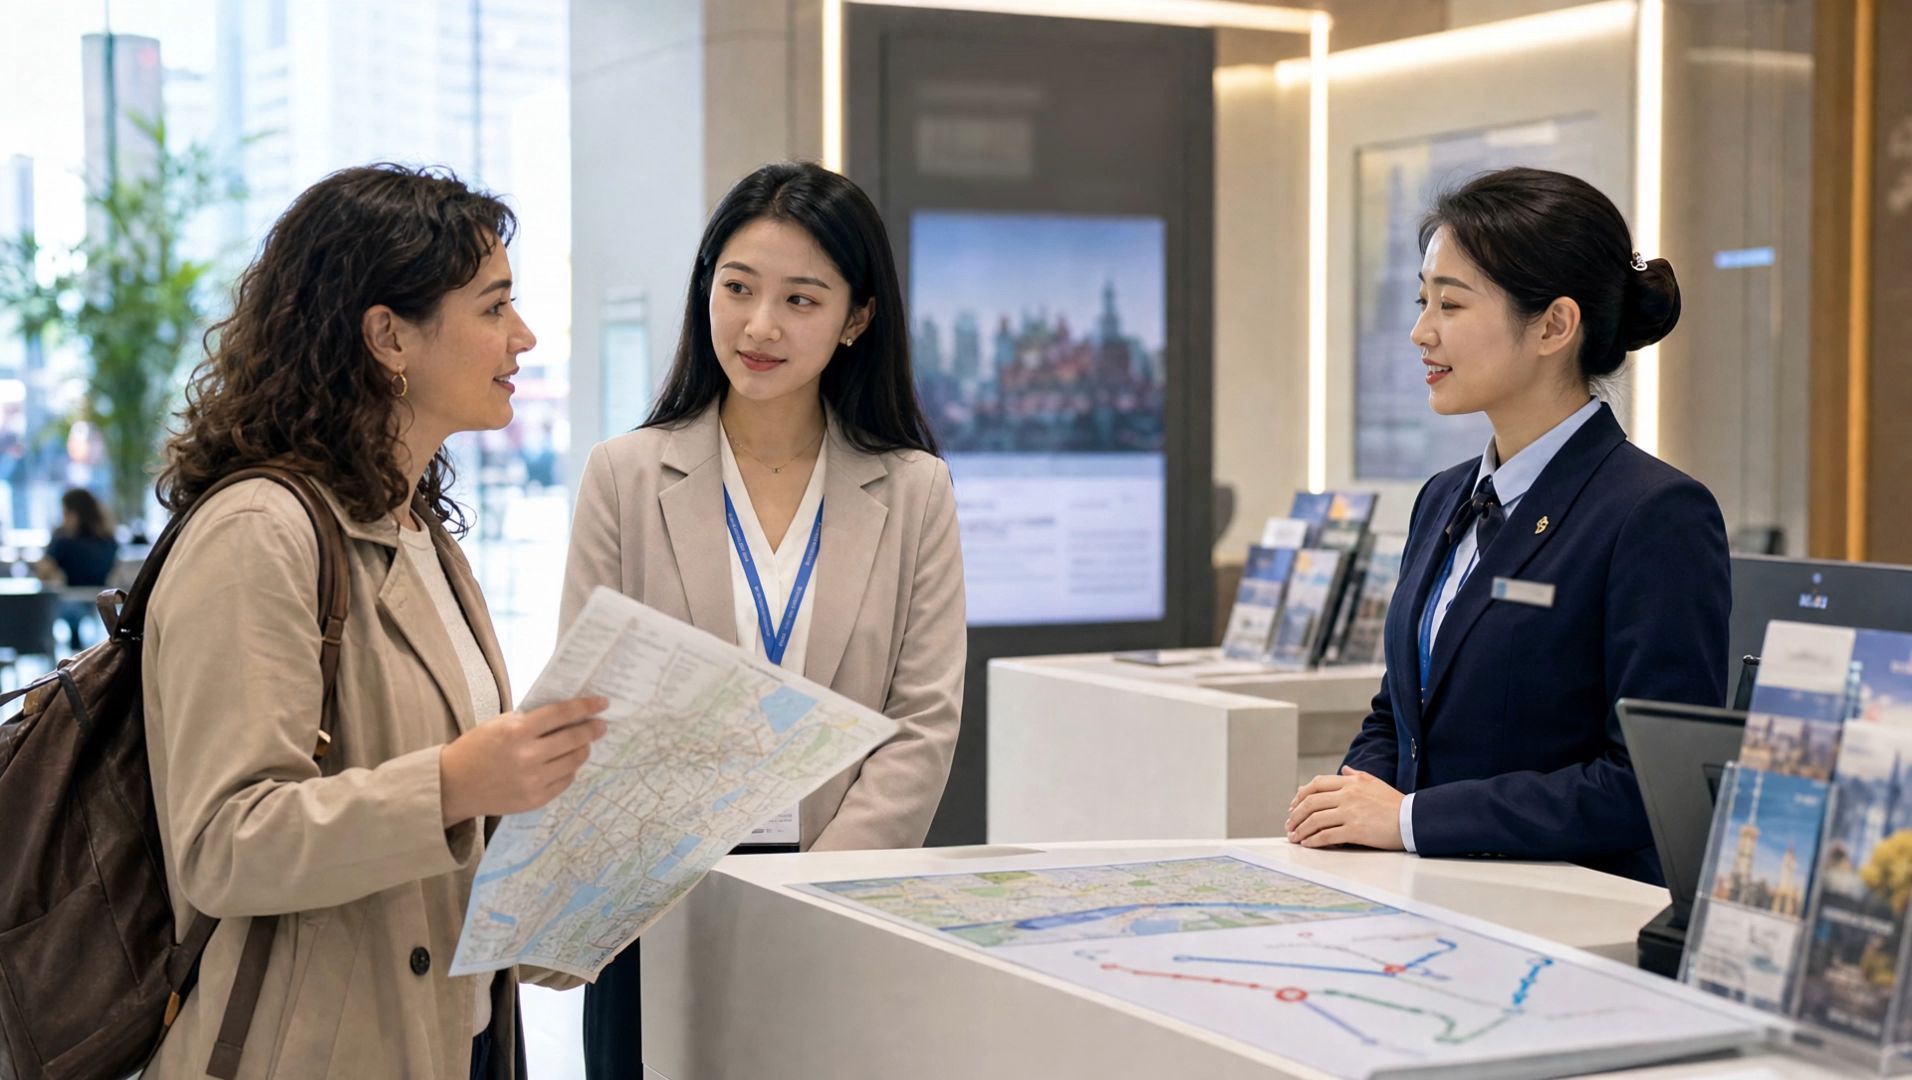 |
प्रॉम्प्ट: दृश्य संदर्भ: पूरे वीडियो में ठीक 3 अलग-अलग मानव किरदार: तीन लोग एक उजले, साफ, काल्पनिक शहर के पर्यटक सूचना केंद्र में हैं। पूरे समय समान रंग टोन बनाए रखें। पर्यटक बाईं ओर, दुभाषिया बीच में, और पर्यटन कर्मचारी दाईं ओर खड़े हों। सूचना डेस्क पर शहर का मानचित्र और मार्ग आरेख रखा है। पृष्ठभूमि का पाठ और मानचित्र लेबल धुंधले और अपठनीय होने चाहिए। कोई वास्तविक ब्रांड, संगठन के नाम, लोगो या वॉटरमार्क दिखाई नहीं देने चाहिए. क्रिया समयांकन: 0–3 सेकंड: तीनों लोगों का मीडियम शॉट। स्पेनिश महिला पर्यटक बीच में खड़े दुभाषिए को देखती है, हाथ में मानचित्र उठाती है और स्वाभाविक, स्पष्ट, थोड़ी धीमी स्पेनिश में कहती है: “¿Dónde está la estación de metro más cercana?” वह बोलना समाप्त करने के बाद लगभग 0.5 सेकंड का विराम रखें। दुभाषिया पर्यटन कर्मचारी की ओर मुड़ता है और चीनी में अनुवाद करता है: “她想知道最近的地铁站在哪里।” 3–7 सेकंड: दुभाषिए और पर्यटन कर्मचारी पर कट करें। पर्यटन कर्मचारी मानचित्र को देखता है (मानचित्र का क्लोज़-अप उपयोग न करें) और स्वाभाविक, स्पष्ट चीनी में उत्तर देता है: “沿这条路直走,步行大约五分钟就能到。” कर्मचारी के बोलने के बाद लगभग 0.5 सेकंड का विराम रखें। दुभाषिया समझ की पुष्टि करता है और पर्यटक की ओर मुड़ता है. 7–11 सेकंड: दुभाषिया स्टाफ सदस्य के उत्तर को स्वाभाविक, स्पष्ट और थोड़ी धीमी स्पेनिश में अनुवाद करता है: “La estación de metro está a unos cinco minutos a pie. Siga recto por esta calle.” बोलते समय, दुभाषिया नक्शे पर मार्ग की ओर इशारा करता है, और पर्यटक उसे ध्यान से देखता है। 11–15 सेकंड: तीनों लोगों के मध्यम शॉट पर वापस आएँ। दिशाएँ समझ लेने के बाद, स्पेनिश पर्यटक मुस्कुराता है, सिर हिलाता है, और स्पेनिश में कहता है: “Muchas gracias.” दृश्य के अंत तक तीनों एक स्वाभाविक सेवा संवाद बनाए रखते हैं। ऑडियो: - स्पेनिश पर्यटक केवल स्पेनिश ही बोलते हैं। - चीनी पर्यटन कर्मचारी केवल चीनी ही बोलते हैं। - चीनी दुभाषिया पहले चीनी में बोलते हैं, फिर स्पेनिश में। - हर व्यक्ति की आवाज़ अलग है। - जब एक व्यक्ति बोल रहा हो, तो बाकी लोग चुप रहें। कोई बाधा या ओवरलैपिंग संवाद न हो। - सभी संवादों की आवाज़ स्पष्ट हो और होंठों की गति संबंधित भाषा के साथ समकालिक हो। - स्पैनिश उच्चारण स्वाभाविक और मानक होना चाहिए, अंग्रेज़ी लहजे के उच्चारण के बिना। - बातचीत थोड़ी धीमी होनी चाहिए, और वाक्यों के बीच स्वाभाविक विराम हों। - पर्यटक सूचना केंद्र की हल्की पृष्ठभूमि ध्वनियाँ बनाए रखें। पृष्ठभूमि संगीत न जोड़ें। परिवेशी ध्वनियाँ संवाद पर हावी नहीं होनी चाहिए। कैमरा: संबंध स्थापित करने के लिए तीनों व्यक्तियों के मीडियम शॉट से शुरुआत करें। जब पर्यटक बोलता है, तो पर्यटक और दुभाषिए के टू-शॉट पर कट करें। जब दुभाषिया प्रश्न दोहराए, तो दुभाषिया और स्टाफ सदस्य पर कट करें। स्टाफ सदस्य के उत्तर के दौरान, मानचित्र मार्ग का क्लोज़-अप शामिल करें। जब दुभाषिया स्पैनिश में अनुवाद करे, तो दुभाषिया और पर्यटक के टू-शॉट पर वापस जाएँ। अंत में तीनों लोगों का मीडियम शॉट लें। पूरे दृश्य में पात्रों की स्थितियाँ, नज़र की दिशा और परिधान एकसमान बनाए रखें। पात्रों को अचानक न बदलें और न ही उनके स्थानिक संबंध बदलें। शैली: यथार्थवादी, स्वाभाविक, पेशेवर यात्रा-सेवा डॉक्यूमेंट्री शैली। चमकीली, स्वच्छ प्रकाश व्यवस्था, स्वाभाविक चेहरे के भाव और संयत गतियाँ। दृश्य को हवाई अड्डे या शहर के पर्यटक सूचना केंद्र में वास्तविक बातचीत जैसा दिखना चाहिए। | |
Omni Reference के साथ चरित्र की उपस्थिति और आवाज़ को जुड़े रखें
Omni Reference एक जनरेशन में 15 तक संयुक्त संदर्भ एसेट्स का समर्थन करता है, जिसमें 10 तक छवियां, 5 तक वीडियो शामिल हैं जिनकी कुल अवधि 30 सेकंड से अधिक नहीं है, और 7 तक Elements शामिल हैं, जिनमें 3 तक वीडियो Elements हैं। संयुक्त एसेट सीमा के भीतर वॉइस संदर्भ भी समर्थित हैं।
बार-बार आने वाले चरित्रों के लिए आप परिभाषित दृश्य विशेषताओं वाले चरित्र Element को बना या चुन सकते हैं और Element सेट करते समय आवाज़ को बाँध सकते हैं। समर्थित जनरेशन वर्कफ़्लो में उस Element को पुन: उपयोग करने से चरित्र की उपस्थिति और वोकल पहचान दोनों को मार्गदर्शित करने में मदद मिलती है। आप अन्य संदर्भों को भी विशिष्ट भूमिकाएँ सौंप सकते हैं, जैसे सेटिंग को परिभाषित करना, मूवमेंट का मार्गदर्शन करना या कैमरा निर्देश देना। स्पष्ट संदर्भ भूमिकाएँ मॉडल को आपकी मंशा का अधिक स्थिरता से पालन करने में मदद करती हैं, हालांकि अंतिम परिणाम की फिर भी समीक्षा की जानी चाहिए।
लंबी क्रियाओं, कैमरा मूव्स और कहानी बीट्स को निर्देशित करें
हमारा Kling 4.0 मॉडल 30 सेकंड तक के सिंगल-जनरेशन वीडियो का समर्थन करता है, जिससे चरित्र संवाद, प्रतिक्रियाओं और क्रियाओं को विस्तार पाने के लिए अधिक जगह मिलती है। अधिक स्थिर बड़े पैमाने की गतियां और जटिल कैमरा मूवमेंट्स अधिक सुगम, अधिक सुसंगत दृश्य बनाने में मदद करती हैं।
लंबी कहानियों के लिए, हमारा Timeline वर्कफ़्लो आपको जनरेट किए गए क्लिप्स को संयोजित करने, शॉट्स को ट्रिम या बदलने, और क्रम का पूर्वावलोकन करने देता है। आप मौजूदा फुटेज में लक्षित संपादन भी कर सकते हैं, जिससे आपको हर दृश्य को शुरू से दोबारा बनाए बिना अपने वीडियो को परिष्कृत करने में मदद मिलती है।
चरित्र संवाद के साथ AI वीडियो कैसे बनाएं
यदि आप स्टैंडअलोन ऑडियो फ़ाइल डाउनलोड करने की बजाय वीडियो में ही चरित्र संवाद जनरेट करना चाहते हैं, तो Kling AI एक वीडियो-प्रथम वर्कफ़्लो प्रदान करता है। Kling 4.0 के साथ, आप चरित्र संदर्भ तैयार कर सकते हैं, प्रॉम्प्ट्स के माध्यम से संवाद और दृश्य प्रदर्शन को निर्देशित कर सकते हैं, और निर्यात करने से पहले पूर्ण दृश्य की समीक्षा कर सकते हैं।
चरण 1. वीडियो जेनरेशन खोलें और चरित्र संदर्भ तैयार करें
Kling AI के Video Generation workspace को खोलें और Kling 4.0 चुनें। यदि आप किसी चरित्र को पुनः उपयोग करने की योजना बना रहे हैं, तो एक चरित्र Element बनाएँ या चुनें, उसकी उपस्थिति निर्धारित करें, और जहाँ समर्थित हो वहाँ इच्छित voice को जोड़ें। Element और किसी भी संबंधित setting, motion या voice संदर्भ को Omni Reference के माध्यम से जोड़ें, और संदर्भ परिसंपत्तियों की कुल सीमा 15 के भीतर रखें। यदि संदर्भ आवश्यक नहीं हैं, तो आप केवल prompt से भी शुरू कर सकते हैं।
चरण 2. प्रत्येक वक्ता और क्रिया के लिए एक Prompt लिखें
कौन बोलता है, सटीक संवाद, इच्छित भाषा, और चरित्र का स्वर तथा भावना स्पष्ट करें। ठहराव, हावभाव, प्रतिक्रियाएँ और कैमरा मूवमेंट्स का भी वर्णन करें। प्रत्येक संदर्भ को एक स्पष्ट भूमिका दें ताकि मॉडल को पता हो कि किन विवरणों का पालन करना है।
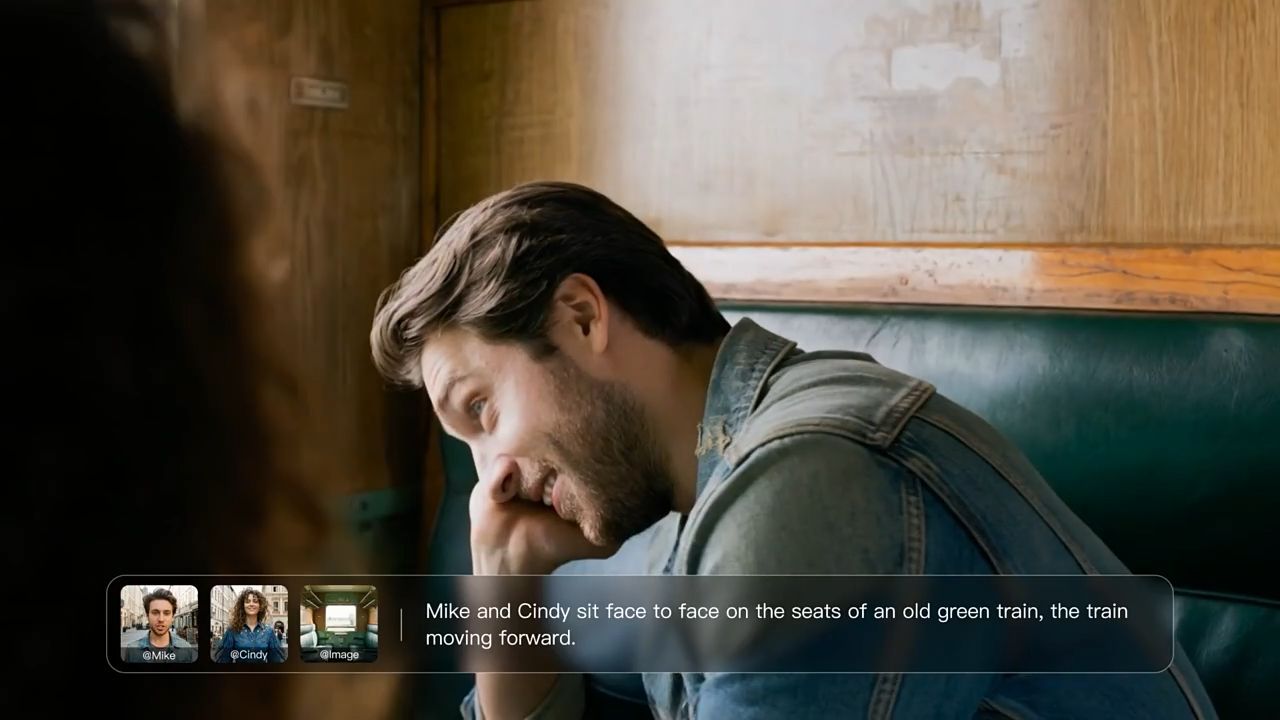
| Prompt: @Element1 चरित्र की उपस्थिति और निर्धारित आवाज़ को परिभाषित करता है। @Image1 बुकस्टोर की सेटिंग को परिभाषित करता है। चरित्र एक खाली डिस्प्ले शेल्फ़ को देखता है, ठहरता है, और स्वाभाविक अंग्रेज़ी में निराश भाव के साथ "The last copy is already gone" कहता है। कैमरा धीरे-धीरे भीतर की ओर बढ़ता है। चरित्र की प्रमुख दृश्य विशेषताओं को सुसंगत रखें। |
चरण 3. निर्माण, समीक्षा, और परिष्करण
एक ड्राफ़्ट तैयार करें और संवाद तथा दृश्य सामग्री की साथ-साथ समीक्षा करें। प्रत्येक चरित्र की पंक्तियों, उच्चारण, भाषा, मुख-गतियों, समय-निर्धारण, चेहरे के भाव, तथा रूप और आवाज़ की सुसंगतता की जाँच करें। बड़े आंदोलनों और कैमरा संक्रमणों की भी समीक्षा करें। यदि कोई पंक्ति जल्दबाज़ी भरी लगे या प्रतिक्रिया अस्पष्ट हो, तो अगला टेक बनाने से पहले प्रॉम्प्ट को सरल करें या संदर्भ भूमिकाओं को समायोजित करें। पूर्ण क्लिप और उपलब्ध आउटपुट विकल्पों की समीक्षा करने के बाद ही एक्सपोर्ट करें।
प्रकाशन से पहले AI आवाज़ की गुणवत्ता कैसे जाँचें
व्यावसायिक परियोजनाओं के लिए, आवाज़ों, स्रोत रिकॉर्डिंग और पहचान योग्य समानताओं से जुड़ी अधिकारों की जांच करें। किसी रिकॉर्डिंग का उपयोग करने की अनुमति में वक्ता को क्लोन करने की अनुमति स्वतः शामिल नहीं होती। यदि जनित संवाद को किसी वास्तविक व्यक्ति के शब्दों के रूप में गलत समझा जा सकता है, तो लागू सहमति और प्रकटीकरण आवश्यकताओं की समीक्षा करें। जब आपको किसी मौजूदा क्लिप में संवाद या चरित्र के प्रदर्शन को समायोजित करने की आवश्यकता हो, तो हमारा AI video editor आपको लक्षित परिवर्तन करने में मदद कर सकता है। प्रकाशित करने से पहले हमेशा परिणाम की समीक्षा करें।
क्या जांचें | क्या सुनें या देखें | व्यावहारिक समाधान |
उच्चारण | नाम और अपरिचित शब्द | वाक्यांश को पुनः शब्दबद्ध करें या यदि उपलब्ध हों तो उच्चारण नियंत्रणों का उपयोग करें |
गति | जल्दीबाज़ी वाली बोलचाल या असहज अंतराल | वाक्य को छोटा करें या विरामों को समायोजित करें |
अभिव्यक्ति | ऐसा जोर जिससे अर्थ बदल जाए | चरित्र की अभिप्रेत भावना को स्पष्ट करें |
संगति | लंबे अंश में चरित्र की आवाज बनाए रखें | आउटपुट की शुरुआत और अंत की तुलना करें |
वीडियो संवाद | क्या शब्द हावभाव और अभिव्यक्तियों से मेल खाते हैं | पूरे दृश्य की समीक्षा करें और उसकी दिशा को परिष्कृत करें |
अंत
सबसे अच्छा AI वॉइस जनरेटर इस पर निर्भर करता है कि आप एक बोले जाने वाला ट्रैक बना रहे हैं, मौजूदा ऑडियो को संशोधित कर रहे हैं, या स्क्रीन पर बोलने वाला कोई किरदार बना रहे हैं। ऊपर बताए गए छह टूल उस कार्य के अलग-अलग हिस्सों को समर्थन देते हैं। यदि आपके प्रोजेक्ट को संवाद, चरित्र की गतिविधि और दृश्य एक साथ विकसित करने की जरूरत है, तो Kling 4.0 दृश्य बनाने और वैकल्पिक प्रदर्शन परीक्षण करने के लिए संदर्भ-निर्देशित तरीका प्रदान करता है।
सामान्य प्रश्न
क्या वॉयस क्लोनिंग अवैध है?
वॉइस क्लोनिंग अपने आप में अवैध नहीं है। फिर भी, यदि आप किसी व्यक्ति की आवाज़ बिना उनकी सहमति के इस्तेमाल करते हैं, तो इससे आपको कानूनी मुसीबत हो सकती है। देशों और क्षेत्रों के नियम अलग-अलग होते हैं, और वे अक्सर गोपनीयता, व्यक्तित्व अधिकार, प्रतिरूपण या भ्रामक वाणिज्यिक उपयोग से जुड़े होते हैं। उस परियोजना के लिए, जिसके लिए आपको काम करने की अनुमति दी गई है, आवाज़ क्लोन करने और ऐसा ऑडियो गढ़ने के बीच स्पष्ट अंतर है जो किसी वास्तविक व्यक्ति से ऐसी बातें कहलवा दे जो उसने कभी कही ही नहीं। किसी भी पहचानी जा सकने वाली मानव आवाज़ का उपयोग करने से पहले हमेशा स्थानीय नियमों की जानकारी लें और उचित सहमति प्राप्त करें।
क्या AI आवाज़ें हँस सकती हैं, फुसफुसा सकती हैं, या भाव प्रकट कर सकती हैं?
कई AI वॉइस मॉडल हंसी, मुलायम फुसफुसाहट, उत्साहित स्वर या यहाँ तक कि उदासी जैसी अभिव्यंजक चीज़ें निभा सकते हैं। आपके पास कितना नियंत्रण है यह इस पर निर्भर करता है कि आप कौन सा टूल इस्तेमाल कर रहे हैं; कुछ आपको विवरणात्मक प्रॉम्प्ट जोड़ने, प्रदर्शन मार्कर लगाने या वॉइस पैरामीटर समायोजित करने देते हैं। ध्यान रखें, हर मॉडल निर्देशों पर अलग तरह से प्रतिक्रिया करता है। पहले एक छोटा स्निपेट परीक्षण करना समझदारी है, ताकि आप सुनिश्चित कर सकें कि भावना स्वाभाविक रूप से पहुँच रही है और आपके संदेश से ध्यान नहीं भटक रहा।
क्या एक AI वॉइस मेकर कई पात्रों के लिए अलग-अलग आवाज़ें बना सकता है?
कुछ AI वॉइस मेकर कई वक्ताओं का समर्थन करते हैं, लेकिन क्षमताएं टूल के अनुसार भिन्न होती हैं। Kling AI पर, आप अपने प्रॉम्प्ट में प्रत्येक पात्र के संवाद, भाषा, टोन और प्रतिक्रियाओं का वर्णन कर सकते हैं। बार-बार दिखने वाले पात्रों के लिए, आप एक Element बना या चुन सकते हैं और एक आवाज़ को जोड़ सकते हैं ताकि पहचानने योग्य वोकल पहचान स्थापित करने में मदद मिले। उत्पन्न संवाद, टाइमिंग और पात्रों की क्रियाओं की समीक्षा करें ताकि सुनिश्चित हो सके कि प्रत्येक वक्ता अलग पहचान बनाए रखे।
AI वॉइस जनरेटर और AI वॉइस चेंजर में क्या अंतर है?
AI वॉइस जनरेटर नया ऑडियो बनाता है, जबकि AI वॉइस चेंजर मौजूदा वॉइस रिकॉर्डिंग को संशोधित करता है। Kling AI पर, आप अपने प्रॉम्प्ट में बैकग्राउंड साउंड इफेक्ट्स का विवरण दे सकते हैं। कैरेक्टर वॉइस के लिए, आप किसी Element को बना या चुन सकते हैं और आवाज़ को बाइंड कर सकते हैं ताकि पात्र की वोकल पहचान स्थापित करने में मदद मिले। Kling 4.0 के साथ, आप विज़ुअल्स के साथ-साथ संवाद भी जनरेट कर सकते हैं, जिससे एक ही वीडियो में कैरेक्टर की बोलचाल, क्रियाएं और अभिव्यक्तियां एकसाथ जुड़ जाती हैं। यदि आप मौजूदा वॉइस रिकॉर्डिंग में परिवर्तन करना चाहते हैं, तो AI वॉइस चेंजर अधिक उपयुक्त हो सकता है।
क्या AI वॉइस जनरेटर वीडियो में स्वाभाविक लगने वाले संवाद बना सकते हैं?
हाँ। कुछ AI voice जनरेटर स्वतंत्र ऑडियो पर ध्यान केंद्रित करते हैं, जबकि AI video generation टूल चरित्र के प्रदर्शन और दृश्यों के साथ संवाद भी बना सकते हैं। Kling AI में, हमारा Kling 4.0 मॉडल नौ भाषाओं में native audio-visual generation का समर्थन करता है, जिसमें बेहतर lip-sync alignment शामिल है ताकि भाषण को ऑन-स्क्रीन क्रियाओं से जोड़ने में मदद मिल सके। अधिक स्वाभाविक परिणामों के लिए, अपने प्रॉम्प्ट में प्रत्येक चरित्र के tone, emotions, pauses, और reactions का वर्णन करें, फिर उत्पन्न संवाद और समय-निर्धारण की समीक्षा करें।