Модели text-to-video способны превратить написанную сцену в видео с движением камеры, звуком и несколькими планами. Однако итоговый ролик всё ещё может не соответствовать запросу, двигаться неловко или позволить персонажу либо продукту меняться от одного кадра к другому. В этой статье разбираем, почему эти различия важны, что проверить перед выбором модели и как Kling VIDEO 3.0 справляется с управлением кадрами, движением, звуком и визуальной согласованностью.
Что такое модели text-to-video?
Модели text-to-video используют генеративный ИИ, чтобы превращать описания на естественном языке в видео. Запрос может задавать объект, окружение, действие, движение камеры и визуальный стиль. Если модель поддерживает звук, она может добавлять диалоги, фоновое звучание и другие звуковые подсказки.
Модели text-to-video и генераторы ИИ text-to-video часто воспринимают как одно и то же, но они выполняют разные роли:
Модель text-to-video | Генератор ИИ text-to-video | |
Что это такое | Система искусственного интеллекта, которая интерпретирует запрос и генерирует видео | Продукт или интерфейс, который люди используют для доступа к генерации текста в видео |
Что он обрабатывает | Интерпретация запроса, генерация сцен, движение и непрерывность во времени | Функции, построенные вокруг модели, такие как управление кадром, референсные входы, аудио, длительность, соотношение сторон, редактирование и экспорт |
Почему это важно | Модель напрямую влияет на качество видео, движение и визуальную согласованность | Генератор определяет, насколько большим будет ваш творческий контроль и что вы сможете сделать с видео впоследствии |
Модель определяет, что именно генерируется, тогда как генератор видео на основе ИИ определяет, как вы получаете доступ к этим возможностям, управляете процессом и работаете с готовым видео.
Как работают модели преобразования текста в видео?
Модели преобразования текста в видео превращают текстовый запрос в последовательность движущихся изображений. Точный процесс различается в зависимости от модели, но обычно включает понимание запроса, построение сжатого представления сцены, определение того, как объекты меняются со временем и поддержание постоянства результата от одного момента к другому.
1. Интерпретировать запрос
Модель ИИ для преобразования текста в видео начинает с того, что определяет основные инструкции в запросе, включая:
- объект
- действие
- обстановку
- визуальный стиль
- направление камеры
- диалоги или другие звуковые подсказки, когда они поддерживаются
| промпт: «Велосипедист едет по дождливой улице в центре города, а камера следует за ним сзади.» |
Это краткое описание содержит несколько указаний, которые должны взаимодействовать. Велосипедист движется вперед, камера следует сзади, а дождь, улица, освещение и окружение должны быть согласованы в одном кадре.
Другими словами, промпт описывает не только то, что должно появиться на экране. Он также задает взаимосвязи между объектом, движением, камерой и окружением.
2. Создайте сжатое представление видео
После прочтения запроса системе нужна рабочая репрезентация сцены до того, как она станет готовым видеоматериалом. Конкретный метод зависит от архитектуры модели.
Многие основанные на диффузии модели преобразования текста в видео работают в пространстве сжатых представлений, а не обрабатывают кадры в полном разрешении с самого начала. Они начинают с шума и постепенно формируют его в соответствии с запросом, выводя на свет объект, обстановку, освещение, композицию и другие визуальные детали. Работа в этом сжатом пространстве уменьшает объём данных, обрабатываемых во время генерации, а когда сцена уже приобрела форму, результат декодируется в видимые видеокадры.
3. Сгенерируйте движение и взаимодействия
Видео должно показывать, что происходит от одного момента к следующему. Модель должна управлять движением, взаимодействием объектов и изменениями точки зрения, не разрушая сцену.
- Движение: персонаж, который поворачивается, идет или тянется, должен менять позу и положение шаг за шагом, а не перескакивать из одного состояния в другое.
- Взаимодействие с объектом: действия должны иметь четкую последовательность. Если кто-то поднимает чашку, рука должна дотянуться до нее и коснуться, прежде чем чашка начнет двигаться.
- Камера и пространство: панорамы, наклоны, наезды и трекинг меняют точку зрения, но объект и окружение должны оставаться привязанными к одному и тому же пространству.
Статичному изображению нужно описать лишь один момент. Видео должно учитывать то, что происходит между моментами.
4. Поддерживайте временную и аудиовизуальную согласованность
По мере развития видео людям, объектам и звуку необходимо сохранять согласованность во времени. Это главным образом сводится к двум типам согласованности:
- Временная согласованность: Персонажи, продукты, одежда, реквизит, освещение и фоны не должны меняться без очевидной причины от одного момента к следующему. Даже после перехода от крупного плана к общему или при смене угла камеры тот же человек или тот же продукт должны по-прежнему легко распознаваться.
- Аудиовизуальная согласованность: Диалоги, движения губ, мимика, фоновые звуки и действия на экране должны происходить в нужный момент. Когда персонаж говорит, движения рта должны соответствовать диалогу, а шаги или звуки ударов — совпадать с действием, которому они принадлежат.
Для чего можно использовать ИИ преобразования текста в видео?
ИИ преобразования текста в видео хорошо работает в ситуациях, когда идею нужно увидеть, прежде чем имеет смысл запускать её в полном масштабе. Он помогает с ранним творческим тестированием, сценами, которые сложно снять, и проектами, которым требуется несколько визуальных направлений до начала производства.
Создавайте видеоролики для социальных сетей
У социального контента короткий срок актуальности, поэтому устраивать новую съемку для каждого поста или концепции кампании редко имеет смысл. Один промпт может создать клипы для тизеров, объявлений, публикаций кампании или коротких сюжетных видео без повторной сборки продакшн-площадки каждый раз. Создатели также могут опробовать разные настройки, движения камеры и визуальные направления, прежде чем остановиться на одной версии.
Превратите идеи продукта в маркетинговые видео
Текст и статичные макеты не всегда показывают, как продукт будет выглядеть, когда он движется в сцене. Технология text-to-video ИИ позволяет маркетологам помещать один и тот же продукт в разные среды, исследовать рекламные концепции и тестировать визуальные приемы на более раннем этапе процесса. Если продукт появляется в нескольких кадрах, результаты также показывают, насколько хорошо его форма, цвет и ключевые детали сохраняются от одного кадра к другому.
Создавайте короткие сюжетные сцены
Короткий рассказ становится сложнее планировать, как только в него входят несколько кадров, действия персонажей, смены камеры и диалоги. ИИ text-to-video может разложить эти элементы по последовательности, упрощая проверку порядка кадров, ритма и тайминга реплик до того, как каждая сцена будет построена отдельно. Это особенно полезно для коротких кинематографичных работ, в которых история зависит не только от одного непрерывного кадра.
Визуализируйте концепции и раскадровки
Тритмент или раскадровка могут объяснить, что должно произойти, но оценить тайминг и движение камеры сложнее на статичной странице. Превращение идеи в движение дает режиссерам, дизайнерам и креативным командам опыт, более близкий к окончательному просмотру. Они могут сравнивать кадрирование, тестировать переходы и замечать слабые моменты, пока изменения все еще легко вносить.
Создавайте образовательные и объясняющие видеоролики
Некоторые объекты сложно запечатлеть на камеру, потому что они дорогостоящие, абстрактные, недоступные или их невозможно инсценировать. ИИ для преобразования текста в видео может проиллюстрировать процесс, воссоздать окружение или показать событие, которое нельзя снять напрямую. Для объяснительных роликов, учебных материалов и контента для занятий движение может сделать концепцию более понятной, когда статичного изображения недостаточно.
Как выбрать лучшую модель ИИ для преобразования текста в видео для своего проекта?
Ни одна модель ИИ для преобразования текста в видео не подходит для абсолютно всех проектов. Начните с того, что вы хотите создать, а затем определите, какие возможности наиболее важны для этой задачи. Основные параметры для сравнения — соответствие запросу, движение и физическая правдоподобность, стабильность, творческий контроль, звук, а также ограничения выходного материала и рабочего процесса.
Соответствие запросу
Во-первых, проверьте, действительно ли модель следует запросу. Тема, действие, обстановка, визуальный стиль и направление камеры должны присутствовать вместе, а не ограничиваться только самыми очевидными деталями. Если вы просите показать велосипедиста, едущего под дождём, пока камера следует сзади, то райдер, погода, движение и точка обзора должны быть на месте. То, что модель упускает, может сказать вам не меньше, чем то, насколько отполированным выглядит видео.
Движение и физическая правдоподобность
Действия должны разворачиваться в понятной последовательности. Ходьба, повороты, потягивания, столкновения и движение камеры должны переходить из одного состояния в другое без резких скачков. Важна и физическая взаимосвязь: рука должна соприкасаться с объектом до того, как тот начнёт двигаться; приземление должно воздействовать на тело; а волосы, ткань, вода или свободные предметы должны реагировать на близкое движение, а не вести себя сами по себе.
Согласованность персонажей и продукта
Один и тот же объект должен оставаться узнаваемым, даже когда меняется кадрирование, угол или дистанция. Лица, одежда, форма продукта, цвет, реквизит, освещение и другие определяющие детали не должны произвольно смещаться. Многокадровые сцены усложняют задачу, поэтому проекты, построенные вокруг повторяющихся персонажей или продуктов, следует проверять на наличие референсных изображений, описаний объекта или другого способа переноса визуальной идентичности из кадра в кадр.
Творческий контроль и управление камерой
Когда у сцены уже есть четкое визуальное направление, управление имеет значение. Кадрирование, движение камеры, порядок кадров, референсные входные данные, соотношение сторон и многокадровая структура — все это влияет на то, насколько результат соответствует исходной задумке. Более точный контроль также означает, что вам реже придется перезапускать всю последовательность только ради изменения угла, перестановки кадра или исправления композиции.
Поддержка аудио
Аудиовозможности сильно различаются между моделями. Одни создают только визуальный ряд, другие способны генерировать диалоги, фоновый звук и эффекты вместе с видеорядом. Для сцен с большим количеством диалогов проверьте, совпадают ли голос, движения рта, мимика и тайминг. Шаги, удары и звуки окружающей среды также должны попадать в соответствующие действия.
Продолжительность, разрешение и рабочий процесс
Обратите внимание на ограничения, влияющие на итоговое видео, включая длительность генерации, поддерживаемые соотношения сторон, доступные разрешения и параметры экспорта. Короткий ролик для соцсетей и многокадровая продуктовая сцена могут иметь очень разные требования к выходному материалу.
Не менее важно то, что происходит после генерации. Можете ли вы продлить клип, повторно использовать тот же объект, переработать один кадр, сгенерировать звук заново или продолжить монтаж без начала с нуля? Небольшие изменения не должны заставлять вас перестраивать всю последовательность.
Для разных проектов нужны разные приоритеты. Начните с типа видео, которое вы создаёте, затем сосредоточьтесь на наиболее важных возможностях:
Если вы хотите создавать | Определите приоритеты | Почему это важно |
Короткие социальные видео | Точность следования подсказке, соотношения сторон, рабочий процесс | Социальный контент быстро меняется, поэтому результат должен оставаться близким к идее, соответствовать распространённым форматам платформ и быть простым для доработки. |
Продуктовые и маркетинговые видеоролики | Согласованность продукта, соответствие промпту, разрешение | Форма продукта, цвет, брендинг и ключевые детали должны оставаться стабильными во всех кадрах, при этом итоговый материал всё равно должен соответствовать требованиям кампании или презентации. |
Короткие повествовательные или кинематографические сцены | Движение и физическая правдоподобность, управление камерой, согласованность между несколькими кадрами | Действия персонажей, смены камеры и переходы между сценами должны соединяться по всей последовательности без явного визуального смещения. |
Видео, основанные на диалогах | Поддержка аудио, синхронизация губ, согласованность персонажей | Диалог, движения рта, мимика и идентичность персонажа должны оставаться согласованными, а звук должен поступать в нужный момент. |
Предпросмотры концепций и раскадровки | Творческий контроль и управление камерой, референсные входные данные, гибкость внесения правок | Цель состоит в том, чтобы на раннем этапе протестировать кадрирование, направление камеры, ритм и альтернативные идеи, пока изменения все еще легко вносить. |
Образовательные и объяснительные видео | Соответствие запросу, движение и физическая правдоподобность, рабочий процесс | Визуальный ряд должен точно объяснять процесс или идею, оставаться понятным для восприятия движения и позволять вносить правки при изменении содержания. |
Что можно сделать с Kling VIDEO 3.0?
Самое сложное в текстовом видео — не получить один красивый кадр. Сложность в том, чтобы тема, действие, направление камеры, звук и мелкие визуальные детали из запроса проявлялись так, как вы задумали. По мере того как запросы становятся детальнее и сцены включают больше планов, модели приходится отслеживать все больше элементов от момента к моменту.
Kling VIDEO 3.0 создана вокруг этих требований, предлагая более точную интерпретацию подсказок, многокадровый сторителлинг, согласованность объектов, встроенный звук, гибкую длительность и рендеринг текста. Вместо того чтобы писать описание и просто ждать, что получится, вы можете формировать, как развивается история, когда меняется камера, как объекты переходят из кадра в кадр и где в сцену входит звук.
Точнее понимать и следовать подсказкам
Kling VIDEO 3.0 может интерпретировать многослойные подсказки, которые объединяют объекты, действия, окружение, указания для камеры и повествовательную структуру. Это помогает сложным запросам text-to-video оставаться ближе к задуманной сцене, особенно когда они включают несколько действий, запланированные движения камеры или конкретную последовательность событий.
Сохраняйте персонажей и продукты согласованными между кадрами
Персонаж может выглядеть корректно в одном кадре и все же заметно меняться под другим углом. В многокадровом видео лица могут смещаться, детали одежды — плыть, а цвет, форма или характерные особенности продукта могут меняться от кадра к кадру.
В поддерживаемых рабочих процессах VIDEO 3.0 с опорой на референсы вы можете использовать несколько референсных изображений, чтобы обеспечить дополнительное визуальное сопровождение и закрепить повторяющегося персонажа, продукт или другой ключевой объект при изменениях кадрирования, угла и окружения. Эти референсы дают модели больше информации о внешнем виде объекта и ключевых визуальных деталях, помогая снизить явный визуальный дрейф в сценах с повторяющимися персонажами, продуктовых кадрах и фирменном контенте.

Создавайте многокадровые истории с лучшим контролем темпа
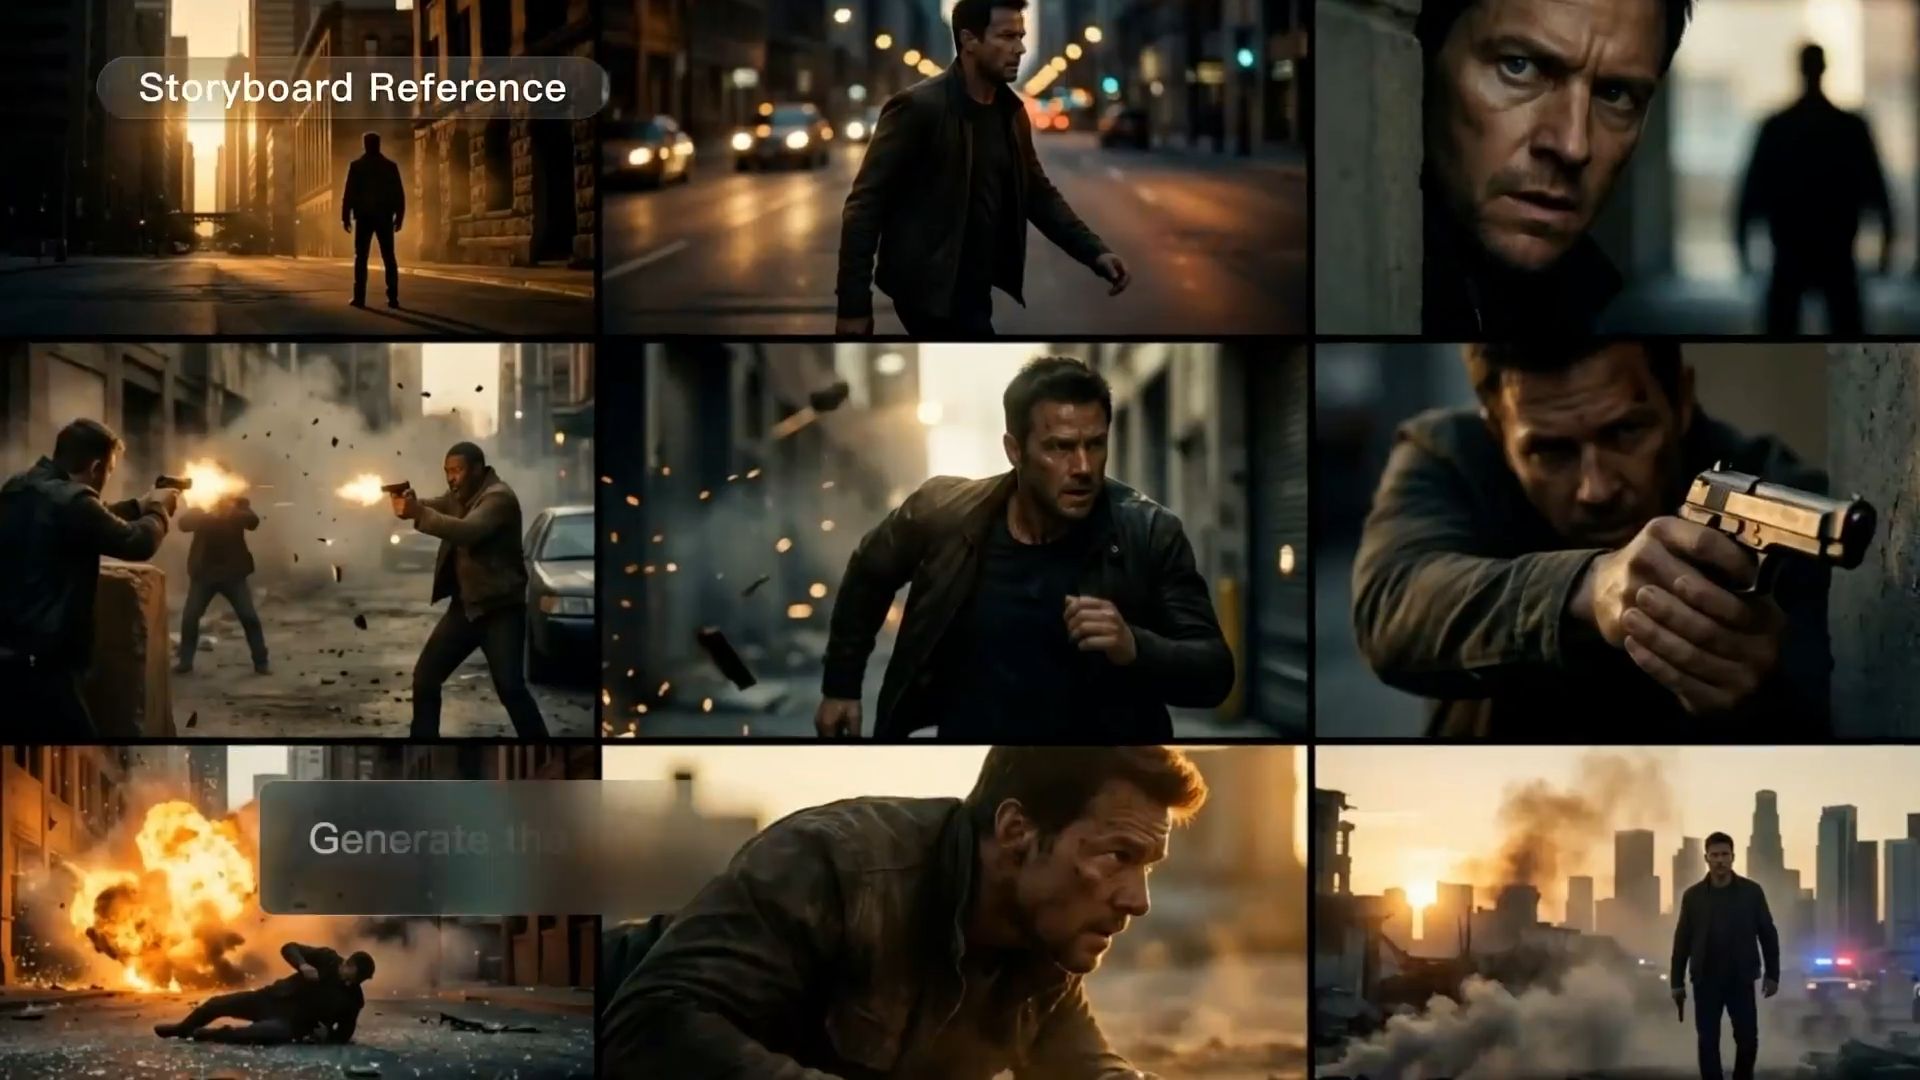
Один кадр обычно легко контролировать. Сложности начинаются, когда истории нужны крупные планы, общие планы, разные позиции камеры и смены сцен. Если генерировать каждый кадр отдельно, впоследствии приходится больше собирать материал, и становится сложнее сохранить темп и целостность всей последовательности.
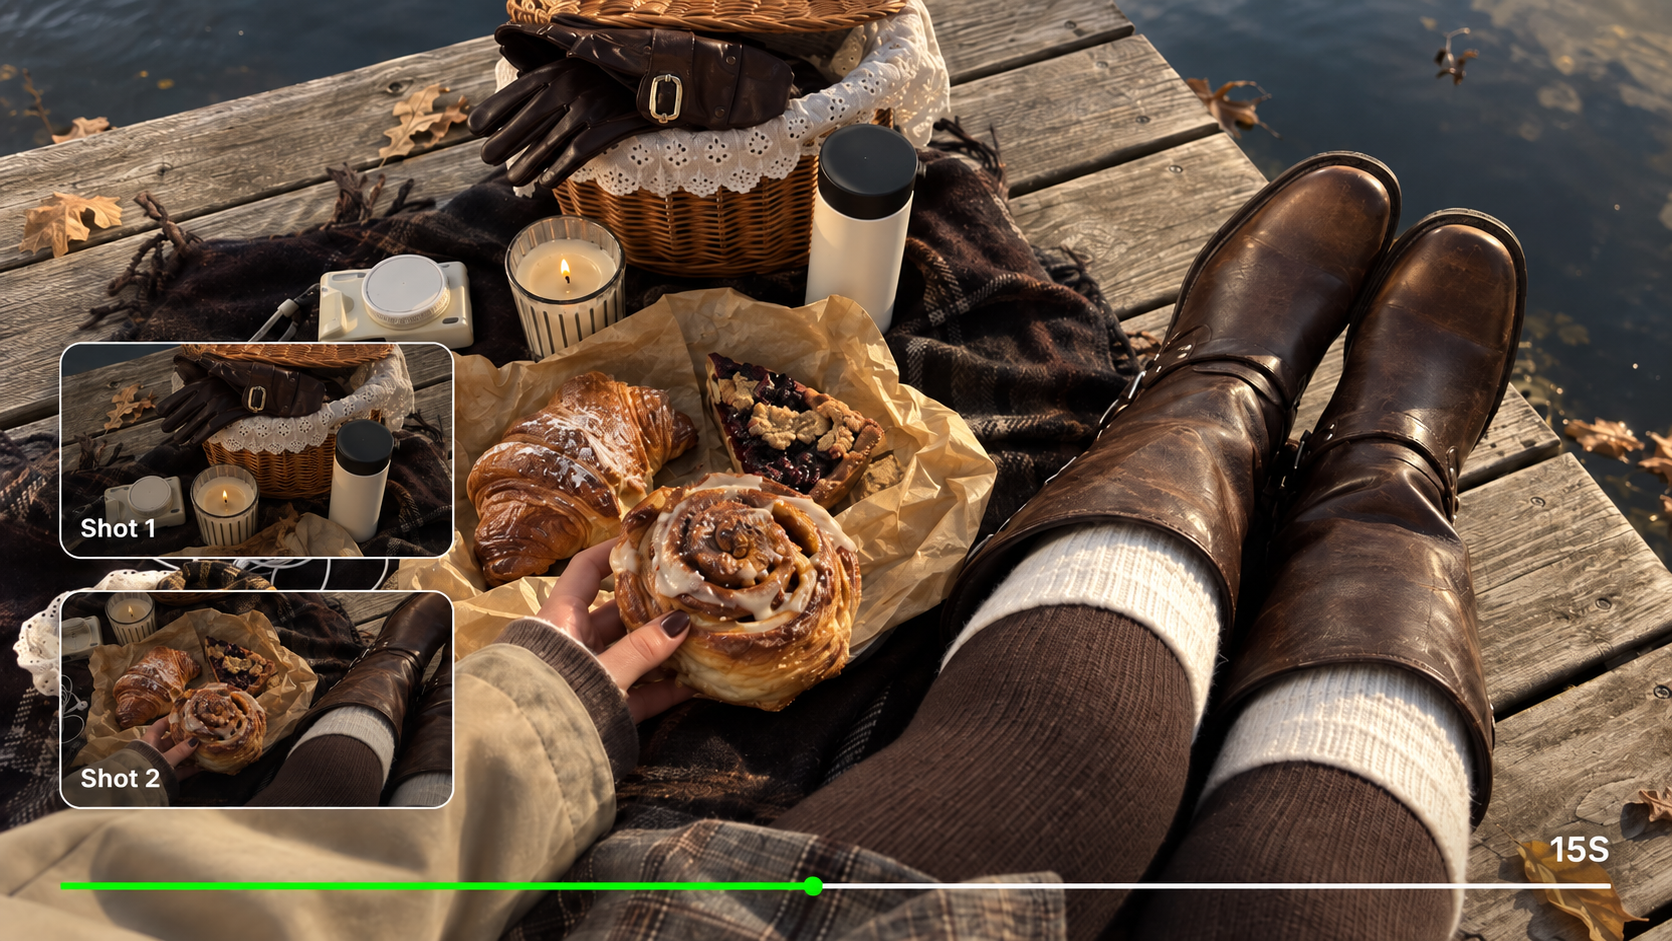
Функция Multi-Shot в Kling VIDEO 3.0 может обрабатывать несколько кадров за одну генерацию, превращая один запрос в связную последовательность вместо набора разрозненных клипов. Для заранее спланированной последовательности Custom Multi-Shot позволяет задать содержание, порядок и длительность отдельных кадров, чтобы монтаж и темп были определены ещё до начала генерации.
Создавайте диалоги и звуки сцены одновременно
Когда видеомодель создаёт только визуальный ряд, работа над сценами с диалогами требует дополнительных усилий. Голоса, фоновый звук, эффекты и тайминг приходится добавлять позже. Если в сцене несколько персонажей, нужно ещё отслеживать, кто произносит каждую реплику и совпадает ли звук с нужным действием на экране.
Функция Native Audio в Kling VIDEO 3.0 генерирует диалоги, фоновый звук и другие аудиодорожки вместе с видео. В сценах с несколькими персонажами вы можете назначать реплики разным дикторам; поддерживаются китайский, английский, японский, корейский и испанский языки, а также соответствующие диалекты и акценты. Речь, актёрская игра и звуковое оформление сцены создаются в рамках одного процесса генерации, а не накладываются на немой ролик позже.
Создавайте более длинные истории — до 15 секунд и с выводом в 4K
Kling VIDEO 3.0 предоставляет создателям больше пространства для проработки каждой сцены, обеспечивая гибкую генерацию длительностью от 3 до 15 секунд для взаимодействия персонажей, многокадрового повествования, диалогов и переходов. В поддерживаемых рабочих процессах вывод до 4K сохраняет более тонкие детали, текстуры и общую визуальную чёткость, помогая создателям переходить от ранних концепций к отполированному контенту для рекламы, демонстраций продуктов, кинематографического повествования и многого другого.
Конец
Стоящие вашего внимания модели преобразования текста в видео делают больше, чем просто оживляют промпт: они следуют вашим намерениям, двигаются естественно, поставляются со звуком и удерживают объект устойчивым между кадрами. С точки зрения этих критериев Kling VIDEO 3.0 объединяет генерацию, управляемую промптом, контроль Multi-Shot, стабильность объекта и нативный звук в одном месте. Откройте Kling, опишите свою сцену и наблюдайте, как она оживает за одну генерацию.
Часто задаваемые вопросы
Как выбрать лучшие модели ИИ для преобразования текста в видео в 2026 году?
Начните с того, какое видео вы хотите создать, а затем сравните модели, ориентируясь на эту задачу. Многокадровый сторителлинг больше полагается на управление камерой и согласованность образов. Сцены с большим количеством диалогов требуют качественного звука, четкой синхронизации губ и убедительной игры персонажей, тогда как создание продуктового и рекламного контента сильнее зависит от точности выполнения промпта, устойчивости объекта и качества результата. Важны также длительность и разрешение, поскольку быстрый тест и готовый материал редко имеют одинаковые требования. Kling VIDEO 3.0 объединяет режимы Multi-Shot, Native Audio, соблюдение промптов и генерацию до 15 секунд для многокадровых историй, сцен, построенных на диалогах, и проектов, где один и тот же персонаж или продукт должен оставаться узнаваемым в разных кадрах.
Может ли преобразование текста в видео с помощью ИИ включать звук?
Да. Kling VIDEO 3.0 может генерировать диалоги, фоновые звуки и эффекты вместе с видео, поэтому вам не нужно добавлять аудио позже. Вы можете вписать реплики прямо в подсказку, назначить их конкретным персонажам и выбрать язык, диалект или акцент. Его преобразование текста в речь может превращать эти реплики в голоса персонажей на китайском, английском, японском, корейском и испанском языках. Это означает меньше отдельной работы по озвучке и меньше монтажа звука после генерации видео.
Какой длины может быть сгенерированное видео?
Длительность видео зависит от модели. Kling VIDEO 3.0 поддерживает гибкую генерацию от 3 до 15 секунд. Более короткие ролики хорошо подходят для быстрых действий и социального контента, а более длинные оставляют больше времени для подводки, диалогов и многокадрового сторителлинга. Для готовых видео, которым требуется более тонкая визуальная детализация, поддерживаемые режимы также предлагают вывод до 4K, обеспечивая большую четкость текстурам продуктов, деталям персонажей и глубине сцены.
Нужны ли мне навыки видеомонтажа?
Если вы хотите внести изменения после генерации, рабочий процесс редактирования VIDEO 3.0 Omni от Kling позволяет модифицировать существующий видеоматериал с помощью инструкций на естественном языке, включая смену фона, объекты, стиль или кадрирование.