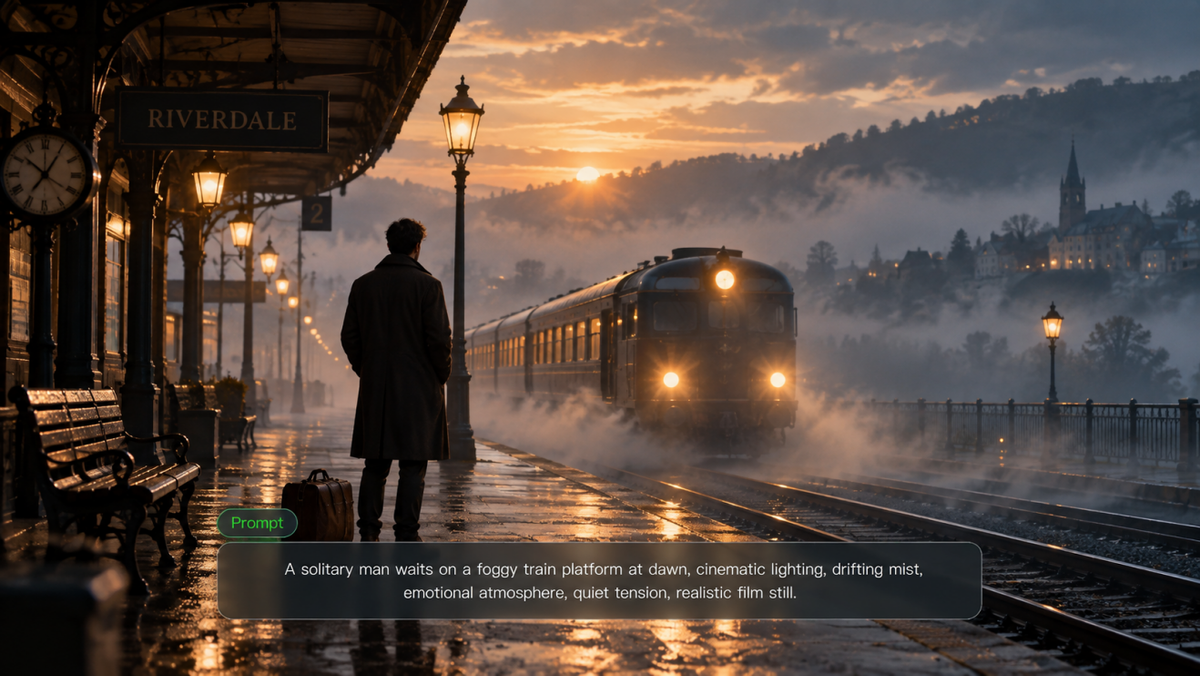
Text-zu-Video-Modelle können eine geschriebene Szene in ein Video mit Kamerabewegung, Ton und mehreren Einstellungen verwandeln. Der Haken ist, dass ein fertiger Clip den Prompt trotzdem verfehlen, sich ungeschickt bewegen oder zulassen kann, dass sich eine Figur oder ein Produkt von einer Einstellung zur nächsten verändert. Dieser Artikel beleuchtet, warum diese Unterschiede wichtig sind, was vor der Auswahl eines Modells zu prüfen ist und wie Kling VIDEO 3.0 die Steuerung von Einstellungen, Bewegung, Audio und visuelle Kontinuität handhabt.
Was sind Text-zu-Video-Modelle?
Text-zu-Video-Modelle nutzen generative KI, um Beschreibungen in natürlicher Sprache in Video umzuwandeln. Ein Prompt kann Motiv, Umgebung, Handlung, Kamerabewegung und visuellen Stil festlegen. Wenn das Modell Audio unterstützt, kann es auch Dialoge, Umgebungsgeräusche und andere akustische Hinweise enthalten.
Text-zu-Video-Modelle und Text-zu-Video-KI-Generatoren werden oft als dasselbe betrachtet, erfüllen aber unterschiedliche Aufgaben:
Text-zu-Video-Modell | Text-zu-Video-KI-Generator | |
Was es ist | Das KI-System, das den Prompt interpretiert und das Video generiert | Das Produkt oder die Benutzeroberfläche, über die Menschen auf die Text-zu-Video-Generierung zugreifen. |
Was es übernimmt | Prompt-Interpretation, Szenengenerierung, Bewegung und zeitliche Kontinuität | Funktionen, die rund um das Modell aufgebaut sind, wie etwa Shot-Steuerungen, Referenzeingaben, Audio, Dauer, Seitenverhältnis, Bearbeitung und Export. |
Warum es wichtig ist | Das Modell beeinflusst direkt die Videoqualität, die Bewegung und die visuelle Konsistenz | Der Generator beeinflusst, wie viel kreative Kontrolle Sie haben und was Sie anschließend mit dem Video tun können |
Das Modell bestimmt, was generiert wird, während ein KI-Videogenerator festlegt, wie Sie auf diese Möglichkeiten zugreifen, den Prozess steuern und mit dem fertigen Video arbeiten.
Wie funktionieren Text-zu-Video-Modelle?
Text-zu-Video-Modelle verwandeln eine schriftliche Eingabe in eine Sequenz bewegter Bilder. Der genaue Prozess variiert je nach Modell, umfasst aber im Allgemeinen das Verstehen der Eingabe, den Aufbau einer komprimierten Darstellung der Szene, die Ausarbeitung, wie sich Dinge im Laufe der Zeit verändern, und das Sicherstellen, dass das Ergebnis von einem Moment zum nächsten konsistent bleibt.
1. Den Prompt interpretieren
Ein Text-zu-Video-KI-Modell beginnt damit, die wichtigsten Anweisungen im Prompt zu identifizieren, darunter:
- das Motiv
- die Handlung
- die Umgebung
- der visuelle Stil
- die Kamerarichtung
- Dialog- oder andere Audiohinweise, sofern unterstützt
| prompt: “Ein Radfahrer fährt durch eine regnerische Innenstadtstraße, während die Kamera von hinten folgt.” |
Diese kurze Beschreibung enthält mehrere Anweisungen, die zusammenarbeiten müssen. Der Radfahrer bewegt sich vorwärts, die Kamera folgt von hinten, und Regen, Straße, Beleuchtung und Umgebung müssen innerhalb derselben Einstellung stimmig sein.
Mit anderen Worten beschreibt der Prompt mehr als das, was auf dem Bildschirm erscheinen soll. Er definiert auch Beziehungen zwischen Motiv, Bewegung, Kamera und Umgebung.
2. Erstelle eine komprimierte Videodarstellung
Nachdem das System den Prompt gelesen hat, benötigt es eine praktikable Darstellung der Szene, bevor sie zu fertiggestelltem Filmmaterial wird. Die genaue Methode hängt von der Architektur des Modells ab.
Viele diffusionsbasierte Text-zu-Video-Modelle arbeiten in einem komprimierten Darstellungsraum, anstatt von Anfang an Bilder in voller Auflösung zu verarbeiten. Sie beginnen mit Rauschen und formen es nach und nach gemäß dem Prompt, wodurch Motiv, Umgebung, Beleuchtung, Komposition und andere visuelle Details sichtbar werden. Die Arbeit in diesem komprimierten Raum verringert die während der Generierung verarbeitete Datenmenge, und sobald die Szene Gestalt angenommen hat, wird das Ergebnis in sichtbare Videobilder dekodiert.
3. Bewegung und Interaktionen erzeugen
Ein Video muss zeigen, was von einem Moment zum nächsten geschieht. Das Modell muss Bewegung, Objektinteraktionen und Perspektivwechsel verarbeiten können, ohne die Szene zu stören.
- Bewegung: Eine Figur, die sich dreht, läuft oder nach etwas greift, sollte Pose und Position Schritt für Schritt verändern, statt von einem Zustand in den anderen zu springen.
- Objektinteraktion: Handlungen benötigen eine klare Reihenfolge. Wenn jemand eine Tasse aufhebt, muss die Hand sie erst erreichen und berühren, bevor die Tasse sich bewegt.
- Kamera und Raum: Schwenks, Neigungen, Heranfahrten und Kamerafahrten verändern den Blickwinkel, doch Motiv und Umgebung müssen weiterhin im selben Raum verankert bleiben.
Ein Standbild muss nur einen Moment beschreiben. Ein Video muss berücksichtigen, was zwischen den Momenten geschieht.
4. Temporale und audiovisuelle Konsistenz aufrechterhalten
Während sich das Video entfaltet, müssen Menschen, Objekte und Ton im Laufe der Zeit stimmig bleiben. Das läuft vor allem auf zwei Arten von Konsistenz hinaus:
- Temporale Konsistenz: Charaktere, Produkte, Kleidung, Requisiten, Beleuchtung und Hintergründe sollten sich nicht ohne ersichtlichen Grund von einem Moment zum nächsten verändern. Selbst nach einem Schnitt von einer Nahaufnahme zu einer Totalen oder einer Änderung des Kamerawinkels sollte dieselbe Person oder dasselbe Produkt weiterhin leicht zu erkennen sein.
- Audiovisuelle Konsistenz: Dialog, Lippenbewegungen, Gesichtsausdrücke, Geräuschkulisse und Aktionen auf dem Bildschirm müssen zum richtigen Zeitpunkt stattfinden. Wenn eine Figur spricht, sollten sich die Lippenbewegungen mit dem Dialog decken, während Schritte oder Aufprallgeräusche mit der Aktion zusammenfallen sollten, zu der sie gehören.
Wofür können Sie Text-zu-Video-KI einsetzen?
Text-zu-Video-KI funktioniert gut in Situationen, in denen eine Idee erst gesehen werden muss, bevor sich die Produktion im großen Maßstab lohnt. Sie kann bei frühem kreativen Testing, bei schwer zu drehenden Szenen und bei Projekten helfen, die mehrere visuelle Richtungen benötigen, bevor die Produktion beginnt.
Erstellen Sie Social-Media-Videos
Social-Content hat eine kurze Halbwertszeit, daher ergibt es selten Sinn, für jeden Beitrag oder jede Kampagnenidee ein neues Shooting anzusetzen. Ein Prompt kann Clips für Teaser, Ankündigungen, Kampagnen-Posts oder kurze, geschichtengetriebene Videos erzeugen, ohne jedes Mal das Produktions-Setup neu aufzubauen. Kreative können auch unterschiedliche Einstellungen, Kamerafahrten und visuelle Richtungen ausprobieren, bevor sie sich auf eine Version festlegen.
Produktideen in Marketingvideos verwandeln
Texte und statische Mockups zeigen nicht immer, wie ein Produkt aussieht, sobald es sich durch eine Szene bewegt. Text-zu-Video-KI ermöglicht es Vermarkter:innen, dasselbe Produkt in verschiedenen Umgebungen zu platzieren, Werbekonzepte zu erkunden und visuelle Treatments früher im Prozess zu testen. Wenn das Produkt in mehreren Einstellungen auftaucht, zeigen die Ergebnisse auch, wie gut seine Form, Farbe und charakteristischen Details von einer Aufnahme zur nächsten bestehen bleiben.
Kurze erzählerische Szenen erstellen
Eine Kurzgeschichte wird schwieriger zu planen, sobald sie mehrere Einstellungen, Charakteraktionen, Kamerawechsel und Dialoge umfasst. Text-zu-Video-KI kann diese Elemente in eine Sequenz übertragen, wodurch es einfacher wird, Einstellungsreihenfolge, Tempo und Dialogtiming zu testen, bevor jede Szene separat erstellt wird. Das ist besonders hilfreich für kurze filmische Stücke, bei denen die Geschichte von mehr als einer einzigen durchgehenden Einstellung abhängt.
Konzepte und Storyboards visualisieren
Ein Treatment oder ein Storyboard kann erklären, was passieren soll, aber Timing und Kamerabewegung lassen sich auf einer statischen Seite schwerer beurteilen. Wenn man die Idee in Bewegung umsetzt, erhalten Regisseure, Designer und Kreativteams etwas, das der finalen Seherfahrung näherkommt. Sie können das Framing vergleichen, Übergänge testen und schwache Momente entdecken, solange sich Änderungen noch leicht vornehmen lassen.
Lehr- und Erklärvideos erstellen
Einige Motive sind schwer mit der Kamera festzuhalten, weil sie teuer, abstrakt, unzugänglich oder nicht inszenierbar sind. Text-zu-Video-KI kann einen Prozess veranschaulichen, eine Umgebung rekonstruieren oder ein Ereignis zeigen, das sich nicht direkt filmen lässt. Für Erklärvideos, Schulungsmaterial und Unterrichtsinhalte kann Bewegung ein Konzept leichter verständlich machen, wenn ein Standbild nicht genug zeigt.
Wie wählen Sie das beste Text-zu-Video-KI-Modell für Ihr Projekt aus?
Kein einzelnes Text-zu-Video-KI-Modell passt zu jedem Projekt. Beginnen Sie mit dem, was Sie erstellen möchten, und entscheiden Sie dann, welche Fähigkeiten für diese Aufgabe am wichtigsten sind. Die wichtigsten Vergleichskriterien sind Prompt-Treue, Bewegung und physikalische Plausibilität, Konsistenz, kreative Kontrolle, Audio sowie die Grenzen von Ausgabe und Workflow.
Prompt-Treue
Überprüfen Sie zuerst, ob das Modell der Eingabeaufforderung tatsächlich folgt. Motiv, Aktion, Umgebung, visueller Stil und Kameraführung sollten gemeinsam erscheinen, statt nur die offensichtlichsten Details. Wenn Sie beispielsweise einen Radfahrer verlangen, der durch den Regen fährt, während die Kamera von hinten folgt, sollten Fahrer, Wetter, Bewegung und Blickwinkel alle vorhanden sein. Was das Modell weglässt, kann Ihnen ebenso viel verraten wie der Eindruck, wie ausgefeilt das Filmmaterial wirkt.
Bewegung und physische Plausibilität
Handlungen sollten sich in einer klaren Reihenfolge entfalten. Gehen, Drehen, Greifen, Zusammenstöße und Kamerabewegungen sollten von einem Zustand zum nächsten übergehen, ohne plötzliche Sprünge. Auch physische Interaktion ist wichtig: Eine Hand sollte Kontakt herstellen, bevor sich ein Objekt bewegt, eine Landung sollte den Körper beeinflussen, und Haar, Stoff, Wasser oder lose Objekte sollten auf Bewegungen in der Nähe reagieren, statt sich unabhängig zu verhalten.
Konsistenz von Charakteren und Produkten
Das gleiche Motiv sollte erkennbar bleiben, wenn sich Bildausschnitt, Winkel oder Abstand ändern. Gesichter, Kleidung, Produktform, Farbe, Requisiten, Beleuchtung und andere prägende Details sollten nicht ohne Grund abweichen. Mehrfachaufnahmen erschweren das, daher sollten Projekte, die um wiederkehrende Figuren oder Produkte herum aufgebaut sind, auch auf Referenzbilder, Motivreferenzen oder eine andere Möglichkeit geprüft werden, die visuelle Identität von Einstellung zu Einstellung beizubehalten.
Kreative Kontrolle und Kameraführung
Wenn eine Szene bereits eine klare visuelle Richtung hat, ist Kontrolle entscheidend. Bildausschnitt, Kamerabewegung, Reihenfolge der Aufnahmen, Referenzeingaben, Seitenverhältnis und Mehrfachstruktur beeinflussen allesamt, wie eng das Ergebnis der ursprünglichen Idee entspricht. Präzisere Kontrolle bedeutet auch, dass Sie eine gesamte Sequenz weniger wahrscheinlich erneut ausführen müssen, nur um einen Winkel zu ändern, eine Aufnahme neu anzuordnen oder die Komposition zu korrigieren.
Audio-Unterstützung
Audiofunktionen unterscheiden sich stark zwischen den Modellen. Manche erzeugen nur visuelle Inhalte, während andere zusammen mit dem Filmmaterial Dialoge, Umgebungsgeräusche und Effekte erstellen können. Bei dialoglastigen Szenen sollten Sie prüfen, ob Stimme, Mundbewegung, Mimik und Timing weiterhin aufeinander abgestimmt sind. Schritte, Einschläge und Umgebungsgeräusche sollten ebenfalls mit den zugehörigen Aktionen zusammenfallen.
Dauer, Auflösung und Workflow
Beachten Sie die Grenzen, die das endgültige Video beeinflussen, einschließlich Generationslänge, unterstützter Seitenverhältnisse, verfügbarer Auflösungen und Exportoptionen. Ein kurzer Social-Clip und eine Produktszene mit mehreren Einstellungen können sehr unterschiedliche Anforderungen an das Ergebnis stellen.
Ebenso wichtig ist, was nach der Generierung passiert. Können Sie den Clip verlängern, dasselbe Motiv wiederverwenden, eine Einstellung überarbeiten, Audio erneut generieren oder mit der Bearbeitung fortfahren, ohne von vorn beginnen zu müssen? Kleine Änderungen sollten Sie nicht dazu zwingen, die gesamte Sequenz neu aufzubauen.
Unterschiedliche Projekte erfordern unterschiedliche Prioritäten. Beginnen Sie mit der Art von Video, das Sie erstellen, und konzentrieren Sie sich dann auf die Fähigkeiten, die am wichtigsten sind:
Wenn Sie Folgendes erstellen möchten | Priorisieren Sie | Warum das wichtig ist |
Kurze Social-Videos | Einhaltung des Prompts, Seitenverhältnisse, Workflow | Soziale Inhalte bewegen sich schnell, daher muss das Ergebnis nah an der Idee bleiben, gängige Plattformformate erfüllen und sich leicht überarbeiten lassen. |
Produkt- und Marketingvideos | Produktkonsistenz, Einhaltung der Prompts, Auflösung | Produktform, Farbe, Branding und wichtige Details müssen über die Aufnahmen hinweg stabil bleiben, während das finale Filmmaterial dennoch den Anforderungen der Kampagne oder Präsentation entspricht. |
Kurze narrative oder filmische Szenen | Bewegung und physikalische Plausibilität, Kamerasteuerung, Konsistenz über mehrere Einstellungen | Charakteraktionen, Kamerawechsel und Szenenübergänge müssen über die Sequenz hinweg verbunden sein, ohne offensichtliches visuelles Abdriften. |
Dialoggesteuerte Videos | Audio-Unterstützung, lip sync, Charakterkonsistenz | Dialog, Mundbewegung, Mimik und Charakteridentität müssen abgestimmt bleiben, während der Ton zum richtigen Zeitpunkt eintreffen sollte. |
Konzeptvorschauen und Storyboards | Kreative Kontrolle und Kamerasteuerung, Referenzeingaben, Überarbeitungsflexibilität | Das Ziel besteht darin, frühzeitig Kadrierung, Kameraführung, Timing und alternative Ideen zu testen, solange Änderungen noch leicht vorzunehmen sind. |
Lehr- und Erklärvideos | Einhaltung des Prompts, Bewegung und physikalische Plausibilität, Workflow | Die visuellen Darstellungen müssen einen Prozess oder eine Idee präzise erklären, Bewegungen leicht nachvollziehbar halten und Überarbeitungen ermöglichen, wenn sich der Inhalt ändert. |
Was können Sie mit Kling VIDEO 3.0 tun?
Der schwierige Teil bei Text-zu-Video besteht nicht darin, eine gut aussehende Aufnahme zu erhalten. Es geht darum, das Motiv, die Handlung, die Kameraführung, den Ton und kleine visuelle Details aus dem Prompt so erscheinen zu lassen, wie Sie es beabsichtigt haben. Je detaillierter die Prompts werden und je mehr Aufnahmen die Szenen hinzufügen, desto mehr muss das Modell von einem Moment zum nächsten nachverfolgen.
Kling VIDEO 3.0 wurde um diese Anforderungen herum entwickelt, mit einer stärkeren Interpretation von Prompts, Storytelling über mehrere Shots, Motivkonsistenz, nativer Audioausgabe, flexibler Dauer und Textrendering. Anstatt eine Beschreibung zu schreiben und einfach abzuwarten, was zurückkommt, können Sie bestimmen, wie sich die Geschichte entfaltet, wann die Kamera wechselt, wie Motive über Einstellungen hinweg weitergeführt werden und wo der Ton in die Szene einsetzt.
Prompts genauer verstehen und befolgen
Kling VIDEO 3.0 kann gestaffelte Prompts interpretieren, die Motive, Aktionen, Umgebungen, Kameraführung und Erzählstruktur kombinieren. Dadurch bleiben komplexe Text-zu-Video-Prompts näher an der beabsichtigten Szene, insbesondere wenn sie mehrere Aktionen, geplante Kamerabewegungen oder eine bestimmte Abfolge von Ereignissen beinhalten.
Figuren und Produkte über Einstellungen hinweg konsistent halten
Eine Figur kann in einer Aufnahme richtig wirken und sich aus einem anderen Blickwinkel dennoch deutlich verändern. In Multi-Shot-Videos können Gesichter sich verschieben, Kleidungsdetails abdriften, und die Farbe, Form oder charakteristischen Merkmale eines Produkts können sich von einer Aufnahme zur nächsten ändern.
In unterstützten referenzgestützten VIDEO 3.0-Workflows können Sie mehrere Referenzbilder verwenden, um zusätzliche visuelle Orientierung zu bieten und eine wiederkehrende Figur, ein Produkt oder ein anderes zentrales Motiv über Änderungen bei Bildausschnitt, Blickwinkel und Umgebung hinweg zu verankern. Diese Referenzen geben dem Modell mehr Informationen über das Erscheinungsbild und die wichtigsten visuellen Details des Motivs und helfen dabei, offensichtliches visuelles Abdriften in Szenen mit wiederkehrenden Figuren, Produktaufnahmen und Markeninhalten zu reduzieren.

Erstellen Sie Multishot-Geschichten mit mehr Kontrolle über das Tempo
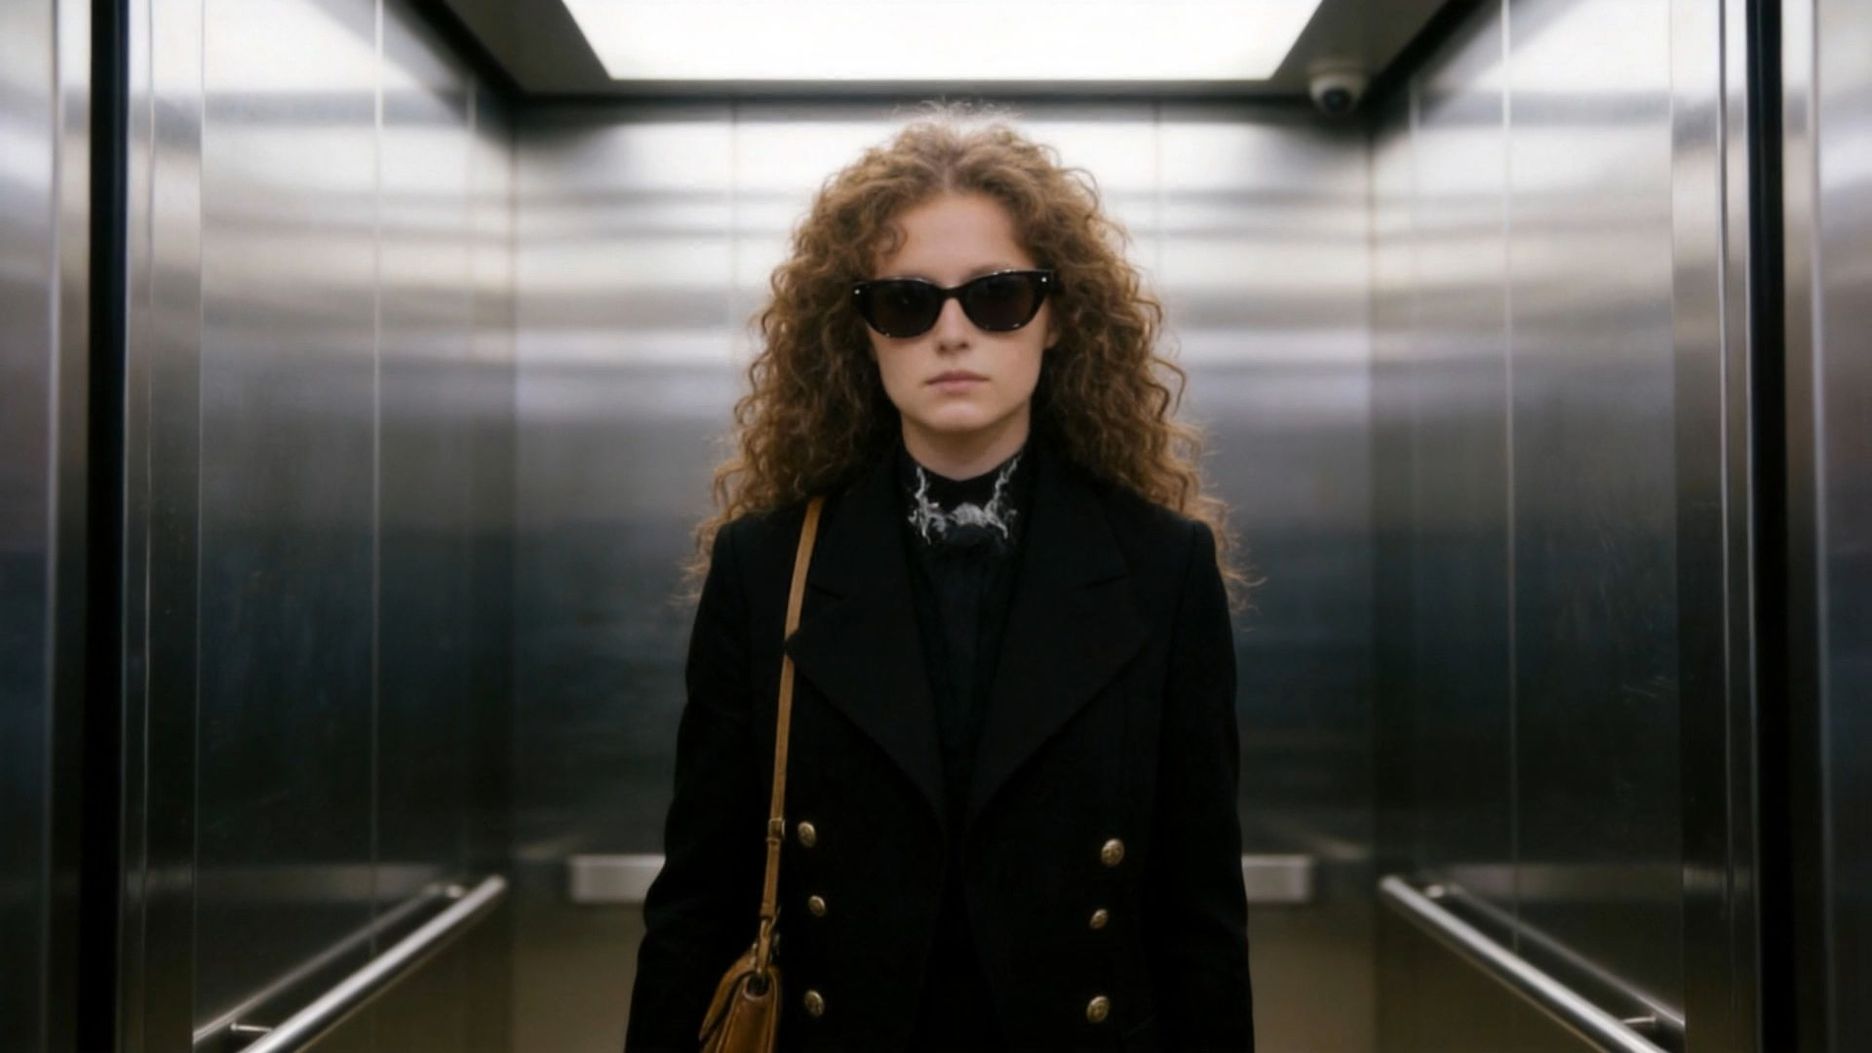
Eine einzelne Einstellung ist normalerweise gut zu handhaben. Die Herausforderung beginnt, wenn eine Geschichte Nahaufnahmen, Totale, unterschiedliche Kamerapositionen und Szenenwechsel braucht. Jede Einstellung separat zu generieren bedeutet später mehr Montagearbeit, und es wird schwieriger, Tempo und Kontinuität über die gesamte Sequenz hinweg intakt zu halten.
Multi-Shot von Kling VIDEO 3.0 kann mehrere Einstellungen in einer Generation verarbeiten und verwandelt einen einzelnen Prompt in eine zusammenhängende Sequenz statt in eine Sammlung isolierter Clips. Für eine geplante Sequenz ermöglicht Custom Multi-Shot, Inhalt, Reihenfolge und Dauer der einzelnen Einstellungen festzulegen, sodass Schnitte und Tempo bereits vor Beginn der Generierung stehen.
Dialog und Szenensound gemeinsam erzeugen
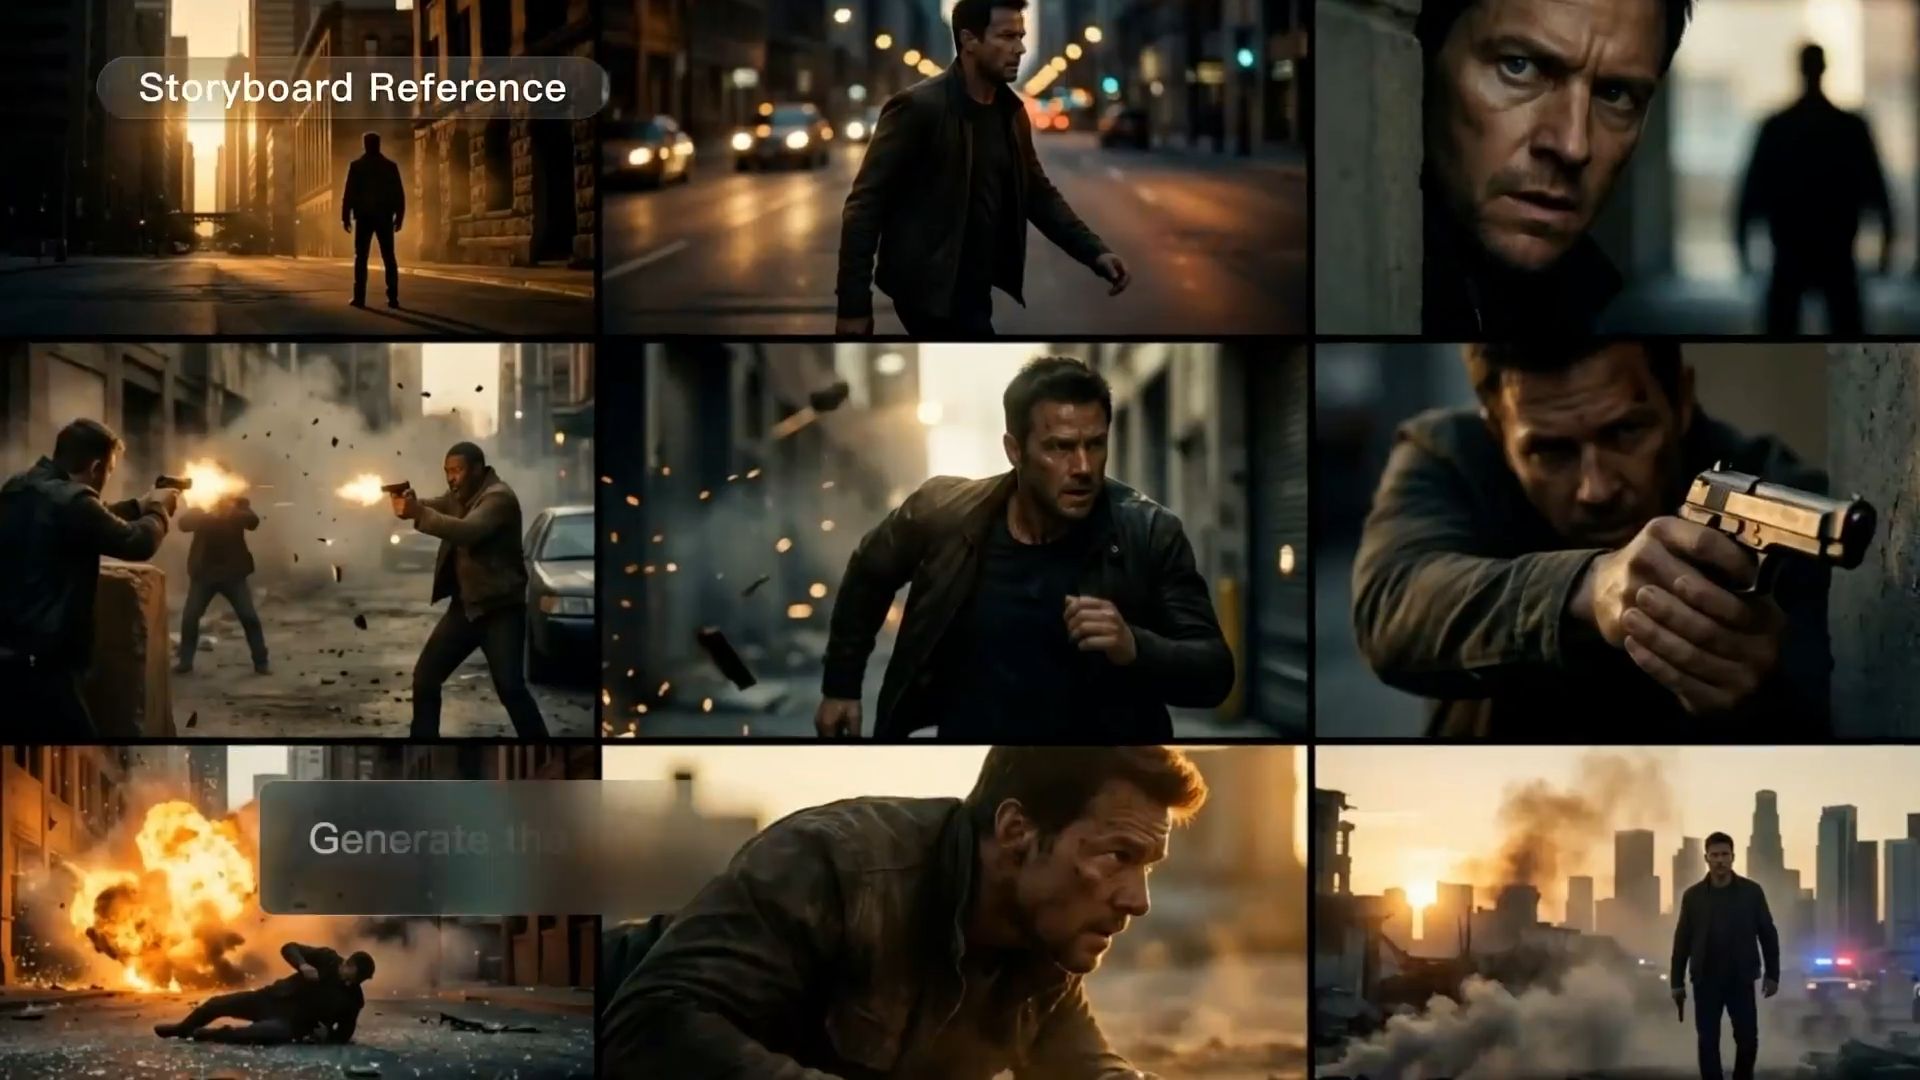
Wenn ein Videomodell nur visuelle Inhalte erzeugt, bringen Dialogszenen zusätzlichen Aufwand mit sich. Stimmen, Umgebungsgeräusche, Effekte und Timing müssen anschließend bearbeitet werden. Fügt man mehrere Charaktere hinzu, muss man außerdem nachverfolgen, wer welche Zeile spricht und ob der Ton zur richtigen Aktion auf dem Bildschirm passt.
Die Native Audio-Funktion von Kling VIDEO 3.0 erzeugt Dialoge, Umgebungsgeräusche und andere Audioelemente zusammen mit dem Video. In Szenen mit mehreren Figuren können Sie unterschiedliche Sprecher zuweisen, mit Unterstützung für Chinesisch, Englisch, Japanisch, Koreanisch und Spanisch sowie die jeweils unterstützten Dialekte und Akzente. Sprache, Figurenperformance und Szenenklang werden im selben Durchgang erzeugt, statt später auf einen stummen Clip gelegt zu werden.
Erstellen Sie längere Geschichten mit bis zu 15 Sekunden und 4K-Ausgabe
Kling VIDEO 3.0 gibt Kreativen mehr Spielraum, jede Szene auszugestalten, mit einer flexiblen Generierung von 3 bis 15 Sekunden für Figureninteraktionen, mehrteilige Geschichten, Dialoge und Übergänge. In unterstützten Workflows bewahrt eine Ausgabe mit bis zu 4K feinere Details, Texturen und die allgemeine visuelle Klarheit und hilft Kreativen, von frühen Konzepten zu ausgefeilten Inhalten für Werbung, Produktpräsentationen, filmische Erzählungen und mehr überzugehen.
Das Ende
Die Text-zu-Video-Modelle, die Ihre Zeit wert sind, animieren nicht nur einen Prompt: Sie folgen Ihrer Absicht, bewegen sich natürlich, kommen mit Ton an und halten ein Motiv über mehrere Einstellungen hinweg stabil. Anhand dieser Kriterien vereint Kling VIDEO 3.0 promptgesteuerte Generierung, Multi-Shot-Kontrolle, Subject Consistency und native Audioausgabe an einem Ort. Öffnen Sie Kling, schreiben Sie Ihre Szene und sehen Sie zu, wie sie in nur einer einzigen Generierung zum Leben erwacht.
Häufig gestellte Fragen
Wie wähle ich unter den besten Text-zu-Video-KI-Modellen im Jahr 2026 aus?
Beginnen Sie mit der Art von Video, das Sie erstellen möchten, und vergleichen Sie dann Modelle, die für diese Aufgabe geeignet sind. Multi-Shot-Erzählungen legen mehr Gewicht auf Kamerasteuerung und Charakterkonsistenz. Dialoglastige Szenen erfordern überzeugenden Ton, Lippensynchronität und Charakterperformance, während Produkt- und Werbearbeiten stärker von Prompt-Treue, Motivstabilität und Ausgabequalität abhängen. Auch Länge und Auflösung sind wichtig, da ein schneller Test und ein fertiges Stück selten dieselben Anforderungen haben. Kling VIDEO 3.0 kombiniert Multi-Shot, Native Audio, Prompt-Treue und Generationen von bis zu 15 Sekunden für Multi-Shot-Geschichten, dialoggetriebene Szenen und Projekte, bei denen derselbe Charakter oder dasselbe Produkt über mehrere Einstellungen hinweg erkennbar bleiben muss.
Kann KI-Text-zu-Video auch Ton enthalten?
Ja. Kling VIDEO 3.0 kann zusammen mit dem Video Dialoge, Umgebungsgeräusche und Effekte generieren, sodass Sie den Ton nicht nachträglich hinzufügen müssen. Sie können die Zeilen direkt in den Prompt schreiben, sie bestimmten Figuren zuweisen und Sprache, Dialekt oder Akzent auswählen. Seine text-to-speech-Funktion kann diese Zeilen in Charakterstimmen auf Chinesisch, Englisch, Japanisch, Koreanisch und Spanisch verwandeln. Das bedeutet weniger separate Vertonungsarbeit und weniger Audiomontage, nachdem das Video generiert wurde.
Wie lang kann ein generiertes Video sein?
Die Videolänge variiert je nach Modell. Kling VIDEO 3.0 unterstützt eine flexible Generierung von 3 bis 15 Sekunden. Kürzere Clips eignen sich gut für schnelle Aktionen und Social-Content, während längere Clips mehr Zeit für Aufbau, Dialoge und mehrteilige Erzählungen lassen. Für fertige Videos, die feinere visuelle Details benötigen, bieten die unterstützten Modi außerdem eine Ausgabe mit bis zu 4K, wodurch Produkttexturen, Charakterdetails und die Tiefe der Szenen klarer werden.
Brauche ich Videobearbeitungskenntnisse?
Wenn Sie nach der Generierung Änderungen vornehmen möchten, ermöglicht Ihnen der VIDEO 3.0 Omni-Bearbeitungsworkflow von Kling, bestehendes Filmmaterial mit Anweisungen in natürlicher Sprache zu bearbeiten, einschließlich des Änderns von Hintergründen, von Motiven, des Stils oder des Bildausschnitts.