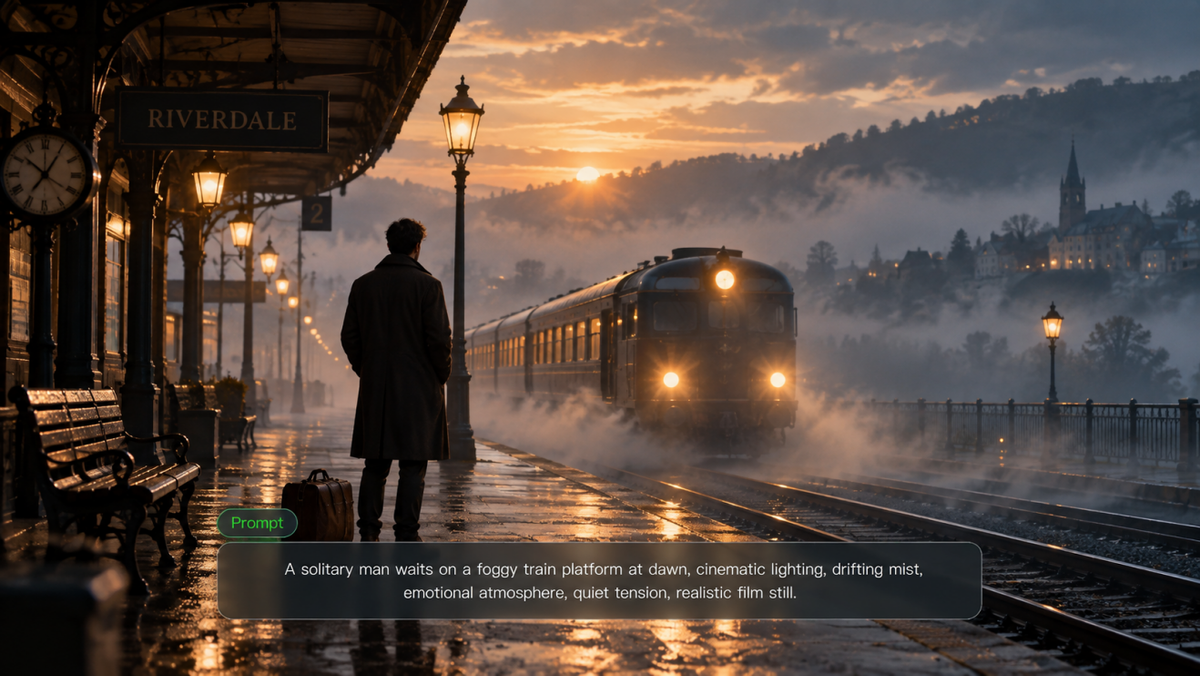
Model teks-ke-video dapat mengubah adegan tertulis menjadi video dengan pergerakan kamera, suara, dan beberapa bidikan. Persoalannya, klip yang sudah jadi masih bisa meleset dari prompt, bergerak canggung, atau membiarkan karakter atau produk berubah dari satu bidikan ke bidikan berikutnya. Artikel ini membahas mengapa perbedaan tersebut penting, apa yang perlu diperiksa sebelum memilih model, dan bagaimana Kling VIDEO 3.0 menangani kontrol bidikan, gerakan, audio, dan kontinuitas visual.
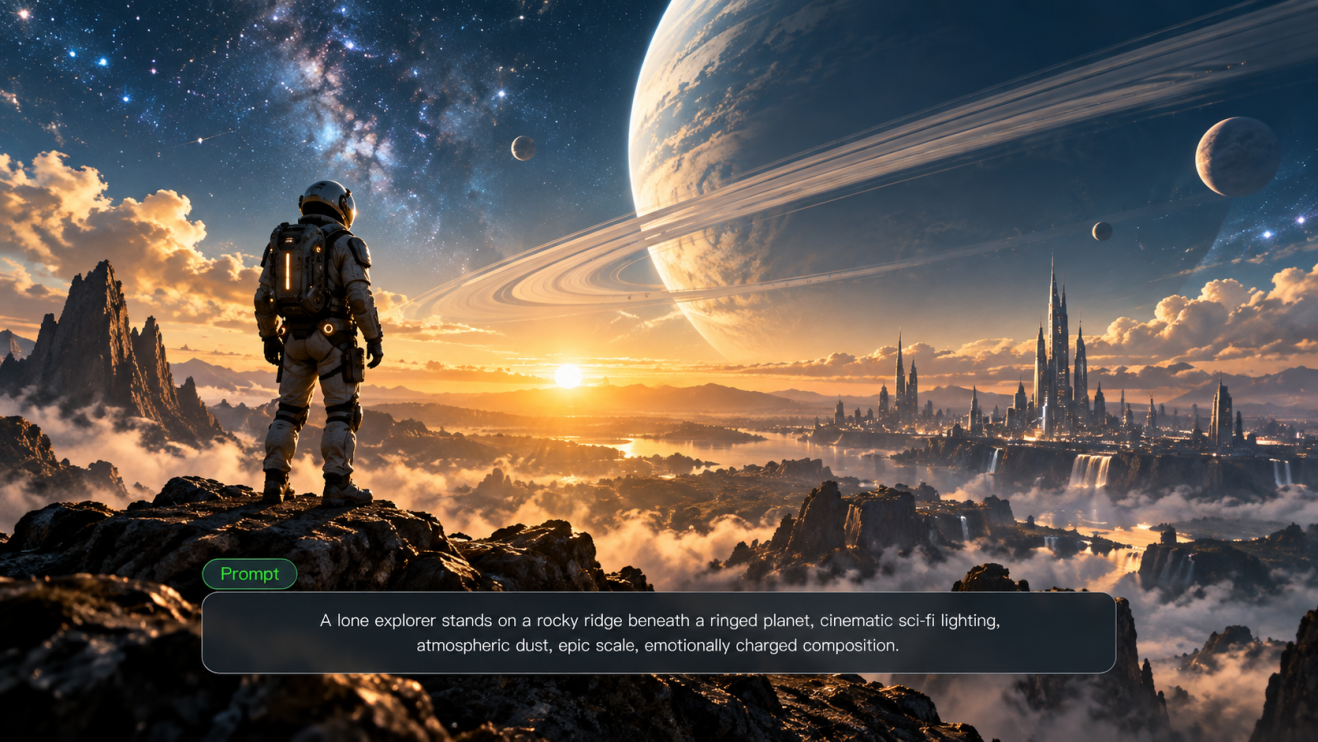
Apa Itu Model Teks-ke-Video?
Model teks-ke-video menggunakan AI generatif untuk mengubah deskripsi bahasa alami menjadi video. Prompt dapat menentukan subjek, latar, aksi, pergerakan kamera, dan gaya visual. Jika model mendukung audio, model tersebut juga dapat menyertakan dialog, suara ambien, dan isyarat audio lainnya.
Model teks-ke-video dan generator AI teks-ke-video sering dianggap sebagai hal yang sama, tetapi keduanya memiliki peran yang berbeda:
Model Teks-ke-Video | Generator AI Teks-ke-Video | |
Apa itu | Sistem AI yang menafsirkan prompt dan menghasilkan video | Produk atau antarmuka yang digunakan orang untuk mengakses pembuatan teks-ke-video |
Apa yang ditangani | Penafsiran prompt, pembuatan adegan, gerakan, dan kontinuitas seiring waktu | Fitur yang dibangun di sekitar model, seperti kontrol bidikan, masukan referensi, audio, durasi, rasio aspek, pengeditan, dan ekspor |
Mengapa hal ini penting | Model secara langsung memengaruhi kualitas video, gerakan, dan konsistensi visual | Generator memengaruhi seberapa besar kendali kreatif yang Anda miliki dan apa yang dapat Anda lakukan dengan video setelahnya. |
Model menentukan apa yang dihasilkan, sementara generator video AI menentukan bagaimana Anda mengakses kemampuan tersebut, mengendalikan prosesnya, dan bekerja dengan video yang telah selesai.
Bagaimana Model Teks-ke-Video Bekerja?
Model teks-ke-video mengubah prompt tertulis menjadi rangkaian gambar bergerak. Proses pastinya berbeda-beda menurut model, tetapi umumnya melibatkan memahami prompt, membangun representasi terkompresi dari adegan, menentukan bagaimana hal-hal berubah seiring waktu, dan menjaga hasil tetap konsisten dari satu momen ke momen berikutnya.
1. Menafsirkan Prompt
Sebuah model AI teks-ke-video memulai dengan mengidentifikasi instruksi utama dalam prompt, termasuk:
- subjek
- aksi
- latar
- gaya visual
- arah kamera
- dialog atau isyarat audio lainnya, bila didukung
| prompt: “Seorang pesepeda mengayuh melalui jalan pusat kota yang diguyur hujan sementara kamera mengikuti dari belakang.” |
Deskripsi singkat itu memuat beberapa instruksi yang harus bekerja bersama. Pesepeda bergerak maju, kamera mengikuti dari belakang, dan hujan, jalan, pencahayaan, serta lingkungan harus masuk akal dalam bidikan yang sama.
Dengan kata lain, prompt tersebut menjelaskan lebih dari sekadar apa yang harus muncul di layar. Itu juga menetapkan hubungan antara subjek, gerakan, kamera, dan lingkungan.
2. Bangun Representasi Video Terkompresi
Setelah membaca prompt, sistem memerlukan representasi yang dapat digunakan dari adegan tersebut sebelum menjadi rekaman akhir. Metode yang tepat bergantung pada arsitektur model.
Banyak model teks-ke-video berbasis difusi bekerja dalam ruang representasi terkompresi alih-alih memproses frame resolusi penuh sejak awal. Mereka memulai dengan noise dan secara bertahap membentuknya sesuai dengan prompt, menghadirkan subjek, latar, pencahayaan, komposisi, dan detail visual lainnya ke dalam tampilan. Bekerja dalam ruang terkompresi ini mengurangi jumlah data yang ditangani selama proses generasi, dan setelah adegan terbentuk, hasilnya didekodekan menjadi frame video yang terlihat.
3. Hasilkan Gerakan dan Interaksi
Video harus menampilkan apa yang terjadi dari satu momen ke momen berikutnya. Model perlu menangani pergerakan, interaksi objek, dan perubahan sudut pandang tanpa merusak adegan.
- Pergerakan: Karakter yang berputar, berjalan, atau meraih harus mengubah pose dan posisi selangkah demi selangkah, alih-alih meloncat tiba-tiba dari satu keadaan ke keadaan lain.
- Interaksi objek: Tindakan memerlukan urutan yang jelas. Jika seseorang mengambil cangkir, tangan harus meraihnya dan melakukan kontak sebelum cangkir bergerak.
- Kamera dan ruang: Pan, tilt, push-in, dan tracking shot mengubah sudut pandang, tetapi subjek dan lingkungan tetap harus tertambat di ruang yang sama.
Gambar diam hanya perlu menggambarkan satu momen. Video harus memperhitungkan apa yang terjadi di antara momen.
4. Pertahankan Konsistensi Temporal dan Audio-Visual
Seiring video berlangsung, orang, objek, dan suara perlu tetap koheren dari waktu ke waktu. Ini terutama bermuara pada dua jenis konsistensi:
- Konsistensi temporal: Karakter, produk, pakaian, properti, pencahayaan, dan latar belakang tidak boleh berubah tanpa alasan yang jelas dari satu momen ke momen berikutnya. Bahkan setelah pemotongan dari pengambilan gambar dekat ke pengambilan gambar lebar atau perubahan sudut kamera, orang atau produk yang sama harus tetap mudah dikenali.
- Konsistensi audio-visual: Dialog, gerakan bibir, ekspresi wajah, suara latar, dan aksi di layar harus terjadi pada waktu yang tepat. Saat karakter berbicara, gerakan mulut harus sesuai dengan dialog, sementara suara langkah kaki atau benturan harus jatuh bersamaan dengan aksi yang terkait.
Untuk Apa Anda Bisa Menggunakan AI Teks-ke-Video?
AI teks-ke-video bekerja dengan baik dalam situasi ketika sebuah ide perlu dilihat sebelum layak diproduksi secara penuh. Ini dapat membantu pengujian kreatif awal, adegan yang sulit diambil, dan proyek yang membutuhkan beberapa arah visual sebelum produksi dimulai.
Buat Video Media Sosial
Konten sosial memiliki masa simpan yang pendek, sehingga mengatur pengambilan gambar baru untuk setiap unggahan atau konsep kampanye jarang masuk akal. Sebuah prompt dapat menghasilkan klip untuk teaser, pengumuman, unggahan kampanye, atau video pendek berbasis cerita tanpa harus membangun ulang setup produksi setiap kali. Kreator juga dapat mencoba pengaturan, pergerakan kamera, dan arahan visual yang berbeda sebelum menetapkan versi akhir.
Ubah Ide Produk Menjadi Video Pemasaran
Copy dan mockup statis tidak selalu menunjukkan bagaimana tampilan sebuah produk ketika bergerak melalui sebuah adegan. AI teks-ke-video memungkinkan pemasar menempatkan produk yang sama di lingkungan berbeda, mengeksplorasi konsep iklan, dan menguji perlakuan visual lebih awal dalam proses. Jika produk muncul di beberapa bidikan, hasilnya juga menunjukkan seberapa baik bentuk, warna, dan detail penentuannya bertahan dari satu bidikan ke bidikan berikutnya.
Bangun Adegan Naratif Pendek
Sebuah cerita pendek menjadi lebih sulit direncanakan ketika mencakup beberapa pengambilan gambar, aksi karakter, perubahan kamera, dan dialog. AI teks-ke-video dapat memetakan elemen-elemen tersebut ke dalam sebuah urutan, sehingga lebih mudah untuk menguji urutan pengambilan gambar, tempo, dan penjadwalan dialog sebelum setiap adegan dibangun secara terpisah. Hal ini sangat membantu untuk potongan sinematik pendek di mana cerita bergantung pada lebih dari satu pengambilan gambar kontinu.
Memvisualisasikan Konsep dan Storyboard
Sebuah treatment atau storyboard dapat menjelaskan apa yang seharusnya terjadi, tetapi pengaturan waktu dan pergerakan kamera lebih sulit dinilai di halaman statis. Mengubah ide menjadi gerakan memberi sutradara, desainer, dan tim kreatif sesuatu yang lebih mendekati pengalaman menonton akhir. Mereka dapat membandingkan pembingkaian, menguji transisi, dan menangkap momen lemah saat perubahan masih mudah dilakukan.
Membuat Video Edukatif dan Penjelas
Beberapa subjek sulit ditangkap dengan kamera karena mahal, abstrak, tidak dapat diakses, atau mustahil untuk dipentaskan. AI teks-ke-video dapat mengilustrasikan sebuah proses, merekonstruksi sebuah latar, atau menampilkan sebuah peristiwa yang tidak dapat direkam secara langsung. Untuk materi penjelasan, pelatihan, dan konten kelas, gerakan dapat mempermudah pemahaman konsep ketika gambar diam tidak cukup menunjukkan detail.
Bagaimana Memilih Model AI Teks-ke-Video Terbaik untuk Proyek Anda?
Tidak ada satu pun model AI teks-ke-video yang cocok untuk setiap proyek. Mulailah dengan apa yang ingin Anda buat, lalu tentukan kemampuan mana yang paling penting untuk pekerjaan tersebut. Hal utama yang perlu dibandingkan adalah kepatuhan terhadap prompt, gerakan dan kelayakan fisik, konsistensi, kontrol kreatif, audio, serta batas output dan alur kerja.
Kepatuhan terhadap Prompt
Pertama, periksa apakah model benar-benar mengikuti prompt. Subjek, aksi, latar, gaya visual, dan arah kamera seharusnya semuanya muncul bersama, bukan hanya detail yang paling jelas. Jika Anda meminta seorang pesepeda yang mengayuh di tengah hujan sementara kamera mengikuti dari belakang, pengendara, cuaca, gerakan, dan sudut pandang semuanya harus ada. Apa yang diabaikan model bisa mengatakan sama banyaknya dengan seberapa rapi tampilan rekamannya.
Gerakan dan Kelogisan Fisik
Aksi harus berlangsung dalam urutan yang jelas. Berjalan, berputar, meraih, tabrakan, dan gerakan kamera harus berpindah dari satu keadaan ke keadaan berikutnya tanpa lompatan mendadak. Interaksi fisik juga penting: tangan harus menyentuh sebelum sebuah objek bergerak, pendaratan harus memengaruhi tubuh, dan rambut, kain, air, atau objek bebas harus merespons gerakan di sekitarnya alih-alih bergerak sendiri.
Konsistensi Karakter dan Produk
Subjek yang sama harus tetap mudah dikenali ketika pembingkaian, sudut, atau jarak berubah. Wajah, pakaian, bentuk produk, warna, properti, pencahayaan, dan detail penentu lainnya tidak boleh berubah tanpa alasan. Adegan multi-shot membuat hal ini semakin sulit, jadi proyek yang dibangun di sekitar karakter atau produk berulang juga harus diperiksa untuk gambar referensi, referensi subjek, atau cara lain untuk mempertahankan identitas visual dari satu bidikan ke bidikan berikutnya.
Kontrol Kreatif dan Kamera
Ketika sebuah adegan sudah memiliki arahan visual yang jelas, kontrol menjadi penting. Pembingkaian, pergerakan kamera, urutan bidikan, masukan referensi, rasio aspek, dan struktur multi-shot semuanya memengaruhi seberapa rapat hasilnya dengan gagasan asli. Kontrol yang lebih halus juga berarti Anda tidak perlu menjalankan ulang seluruh rangkaian hanya untuk mengubah sudut, menyusun ulang sebuah bidikan, atau memperbaiki komposisi.
Dukungan Audio
Kemampuan audio sangat berbeda antar model. Beberapa hanya menghasilkan visual, sementara yang lain dapat membuat dialog, suara latar, dan efek bersama rekaman. Untuk adegan dengan banyak dialog, periksa apakah suara, gerakan mulut, ekspresi wajah, dan waktu tetap selaras. Langkah kaki, benturan, dan suara lingkungan juga harus terjadi bersamaan dengan aksi yang terkait.
Durasi, Resolusi, dan Alur Kerja
Perhatikan batasan yang memengaruhi video akhir, termasuk panjang generasi, rasio aspek yang didukung, resolusi yang tersedia, dan opsi ekspor. Klip sosial pendek dan adegan produk multi-shot dapat memiliki kebutuhan output yang sangat berbeda.
Yang terjadi setelah proses generasi sama pentingnya. Bisakah Anda memperpanjang klip, menggunakan kembali subjek yang sama, merevisi satu bidikan, menghasilkan ulang audio, atau melanjutkan pengeditan tanpa harus memulai dari awal? Perubahan kecil seharusnya tidak memaksa Anda membangun ulang seluruh urutan.
Setiap proyek memerlukan prioritas yang berbeda. Mulailah dengan jenis video yang Anda buat, lalu fokuslah pada kemampuan yang paling penting:
Jika Anda Ingin Membuat | Prioritaskan | Mengapa Ini Penting |
Video sosial pendek | Kepatuhan terhadap prompt, rasio aspek, alur kerja | Konten sosial bergerak cepat, jadi keluaran perlu tetap dekat dengan idenya, sesuai dengan format platform umum, dan mudah direvisi. |
Video produk dan pemasaran | Konsistensi produk, kepatuhan terhadap prompt, resolusi | Bentuk, warna, branding, dan detail kunci produk perlu tetap stabil di seluruh bidikan sekaligus memastikan rekaman akhir tetap memenuhi kebutuhan kampanye atau presentasi. |
Adegan naratif atau sinematik pendek | Gerakan dan kelayakan fisik, kontrol kamera, konsistensi multi-shot | Aksi karakter, perubahan kamera, dan transisi adegan harus terhubung di sepanjang urutan tanpa penyimpangan visual yang jelas. |
Video yang digerakkan oleh dialog | Dukungan audio, sinkronisasi bibir, konsistensi karakter | Dialog, gerakan mulut, performa wajah, dan identitas karakter harus tetap selaras, sementara suara harus hadir pada waktu yang tepat. |
Pratinjau konsep dan storyboard | Kontrol kreatif dan kamera, masukan referensi, fleksibilitas revisi | Tujuannya adalah menguji pembingkaian, arah kamera, tempo, dan gagasan alternatif sejak awal, ketika perubahan masih mudah dilakukan. |
Video edukasi dan penjelasan | Kepatuhan terhadap prompt, gerakan dan kelayakan fisik, alur kerja | Visualnya perlu menjelaskan proses atau ide secara akurat, menjaga gerakan tetap mudah diikuti, dan memungkinkan revisi ketika konten berubah. |
Apa yang Bisa Anda Lakukan dengan Kling VIDEO 3.0?
The hard part of text-to-video is not getting one good-looking shot. It is getting the subject, action, camera direction, sound, and small visual details from the prompt to show up the way you intended. As prompts become more detailed and scenes add more shots, the model has more to keep track of from one moment to the next.
Kling VIDEO 3.0 dibangun berdasarkan tuntutan tersebut, dengan interpretasi prompt yang lebih kuat, penceritaan multi-shot, konsistensi subjek, audio bawaan, durasi fleksibel, dan perenderan teks. Alih-alih menulis deskripsi dan sekadar menunggu apa yang kembali, Anda dapat membentuk bagaimana cerita berkembang, kapan kamera berubah, bagaimana subjek terbawa di setiap pengambilan gambar, dan di mana suara memasuki adegan.
Memahami dan Mengikuti Prompt dengan Lebih Akurat
Kling VIDEO 3.0 dapat menafsirkan prompt berlapis yang menggabungkan subjek, aksi, latar, arahan kamera, dan struktur naratif. Hal ini membantu prompt teks-ke-video yang kompleks tetap mendekati adegan yang dimaksud, terutama ketika mencakup banyak aksi, pergerakan kamera yang telah direncanakan, atau urutan peristiwa tertentu.
Menjaga Karakter dan Produk Tetap Konsisten di Seluruh Pengambilan Gambar
Sebuah karakter bisa terlihat tepat dalam satu bidikan namun tetap berubah secara mencolok dari sudut lain. Dalam video multi-shot, wajah dapat bergeser, detail pakaian bisa melenceng, dan warna, bentuk, atau fitur penentu sebuah produk dapat berubah dari satu bidikan ke bidikan berikutnya.
Dalam alur kerja VIDEO 3.0 berbantuan referensi yang didukung, Anda dapat menggunakan beberapa gambar referensi untuk memberikan panduan visual tambahan dan membantu menambatkan karakter, produk, atau subjek kunci yang berulang di tengah perubahan framing, sudut, dan latar. Referensi ini memberi model lebih banyak informasi tentang penampilan subjek dan detail visual utama, membantu mengurangi pergeseran visual yang jelas dalam adegan karakter berulang, bidikan produk, dan konten bermerek.

Bangun Cerita Multi-Shot dengan Kontrol Lebih Besar atas Tempo
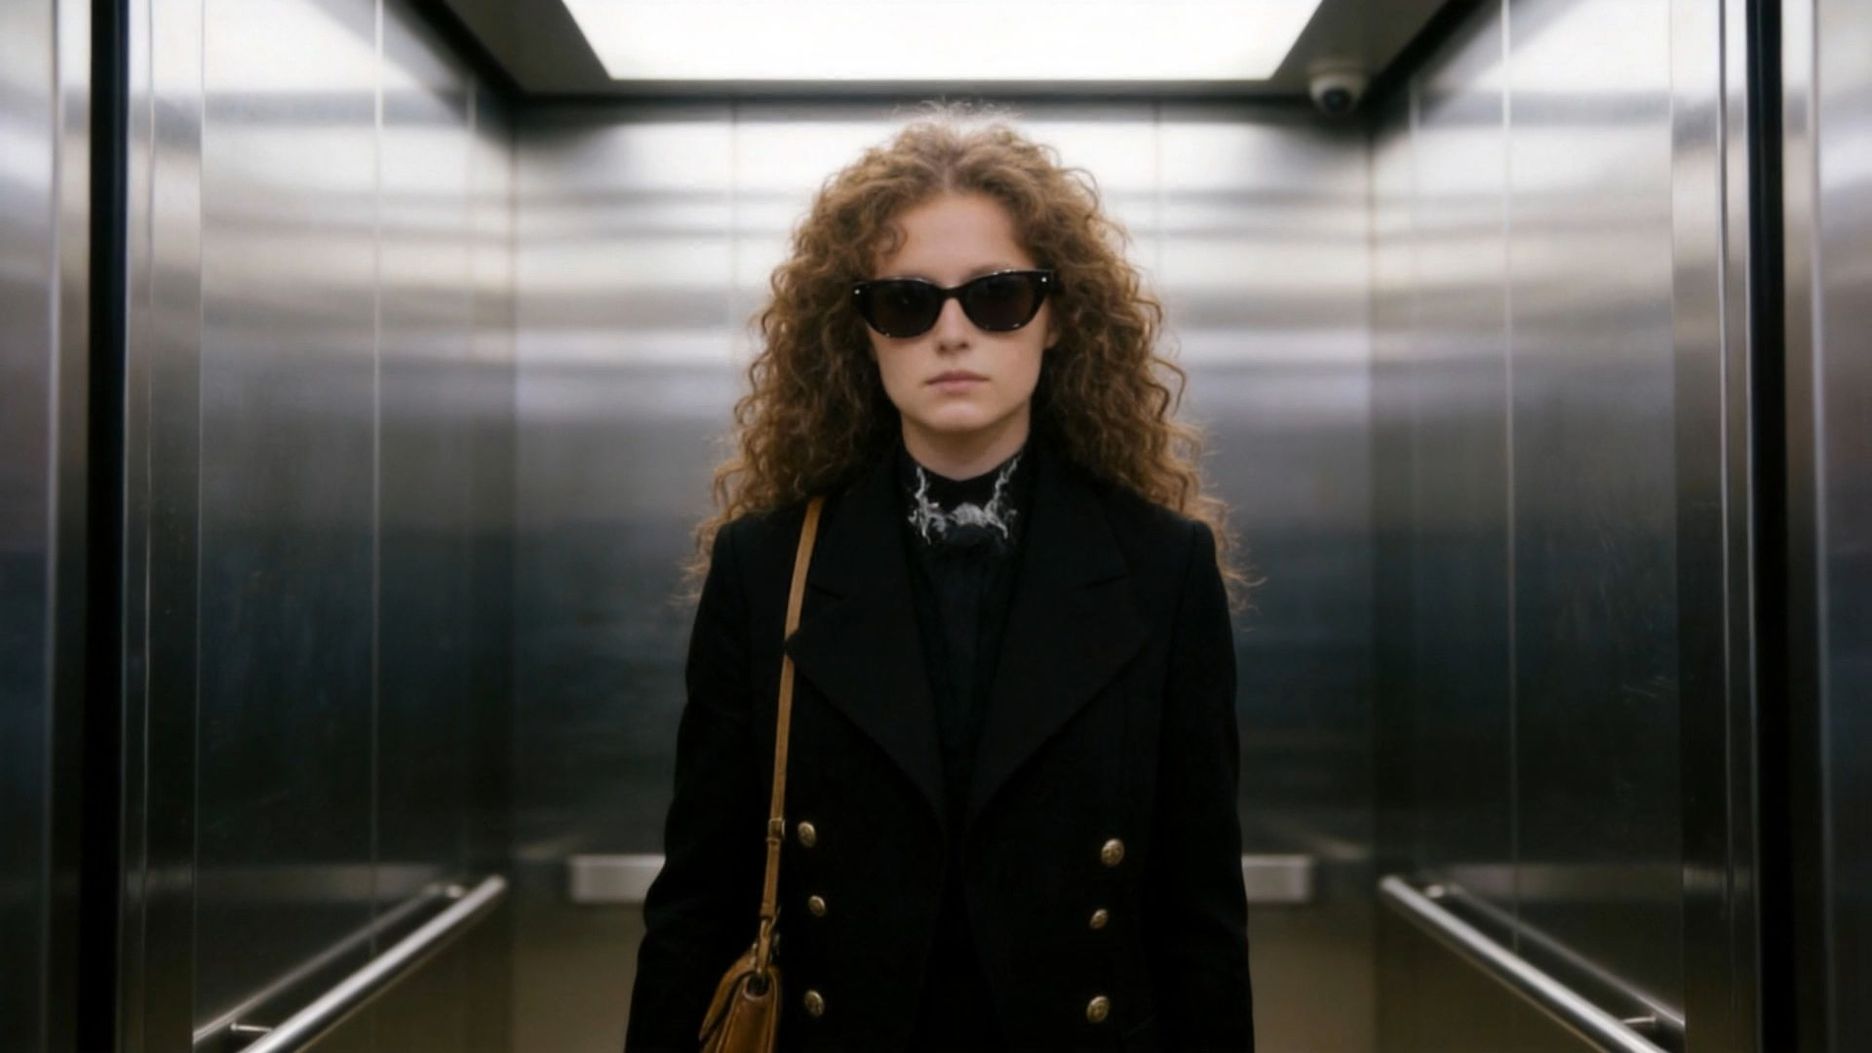
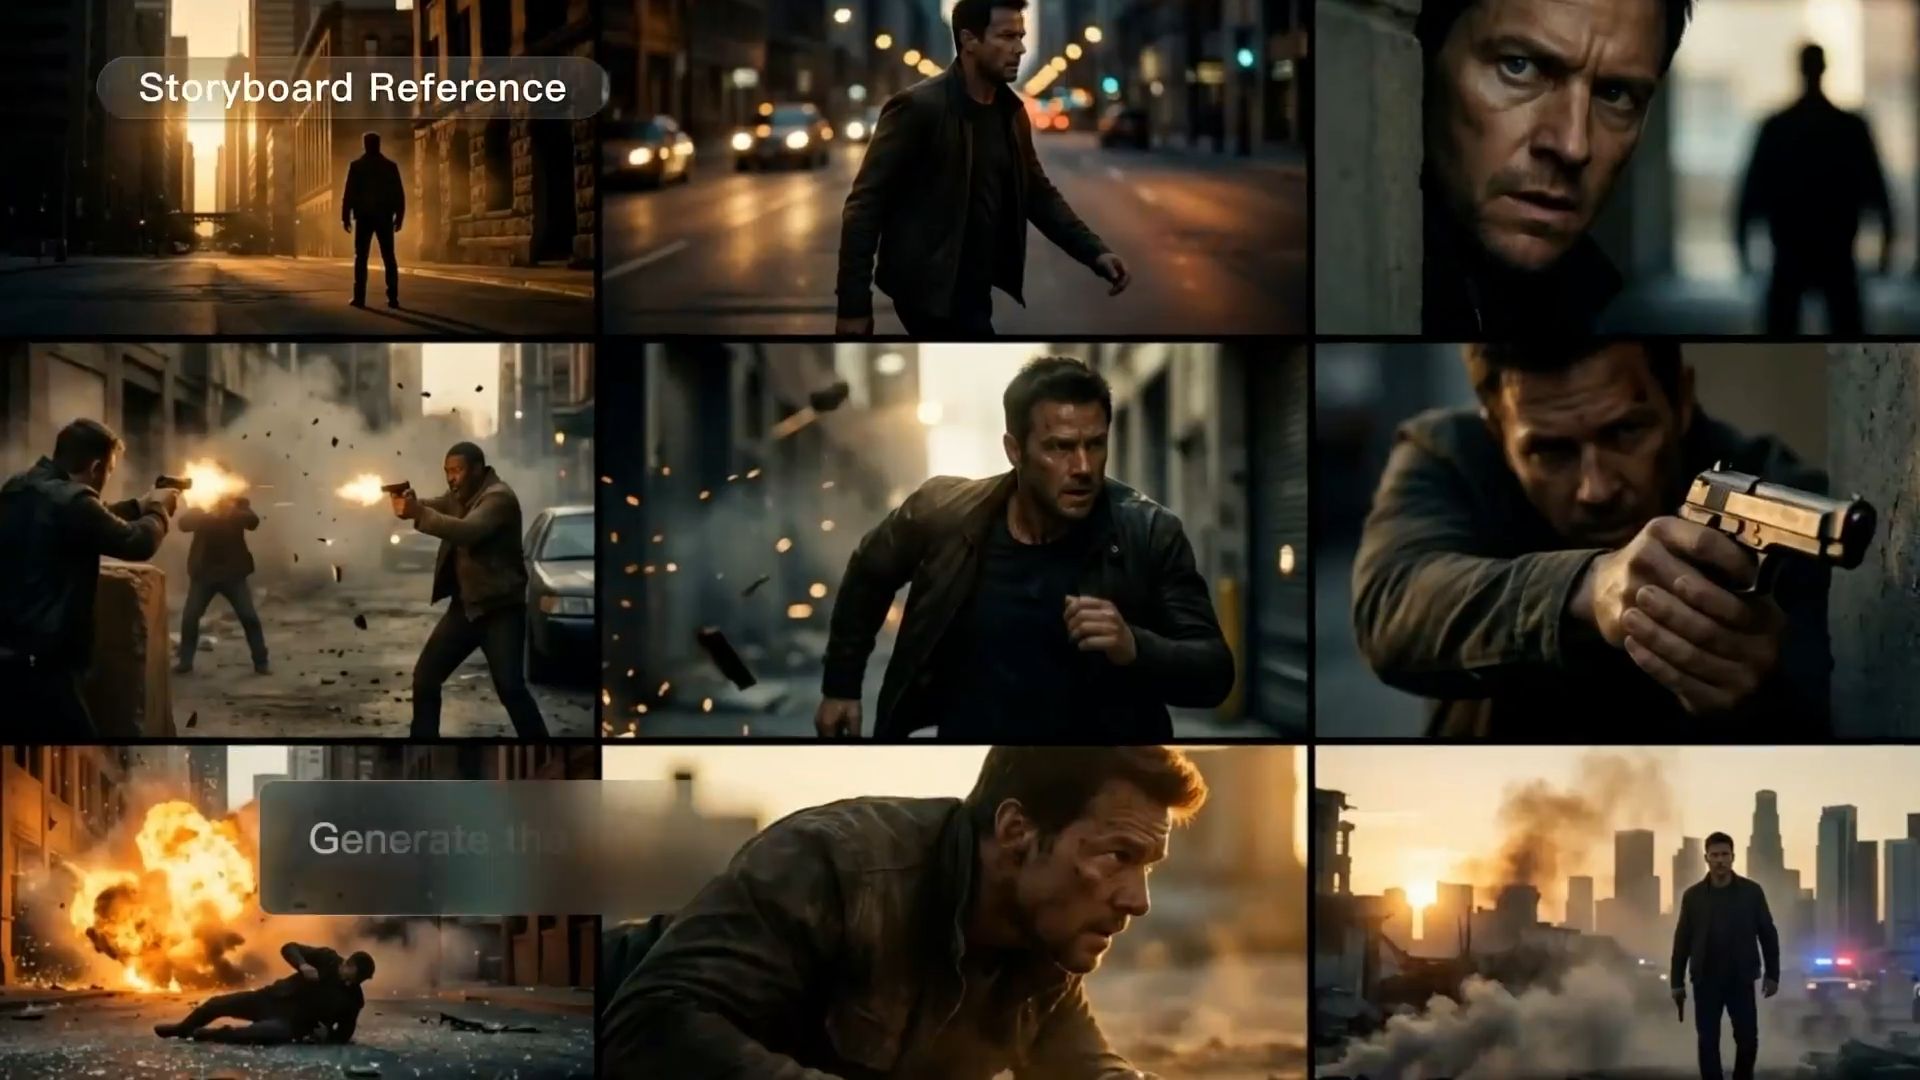
Satu pengambilan gambar biasanya mudah ditangani. Tantangan dimulai ketika sebuah cerita membutuhkan close-up, wide shot, posisi kamera berbeda, dan perubahan adegan. Menghasilkan setiap pengambilan secara terpisah berarti lebih banyak perakitan di kemudian hari, dan menjadi lebih sulit menjaga tempo dan kontinuitas tetap utuh di seluruh rangkaian.
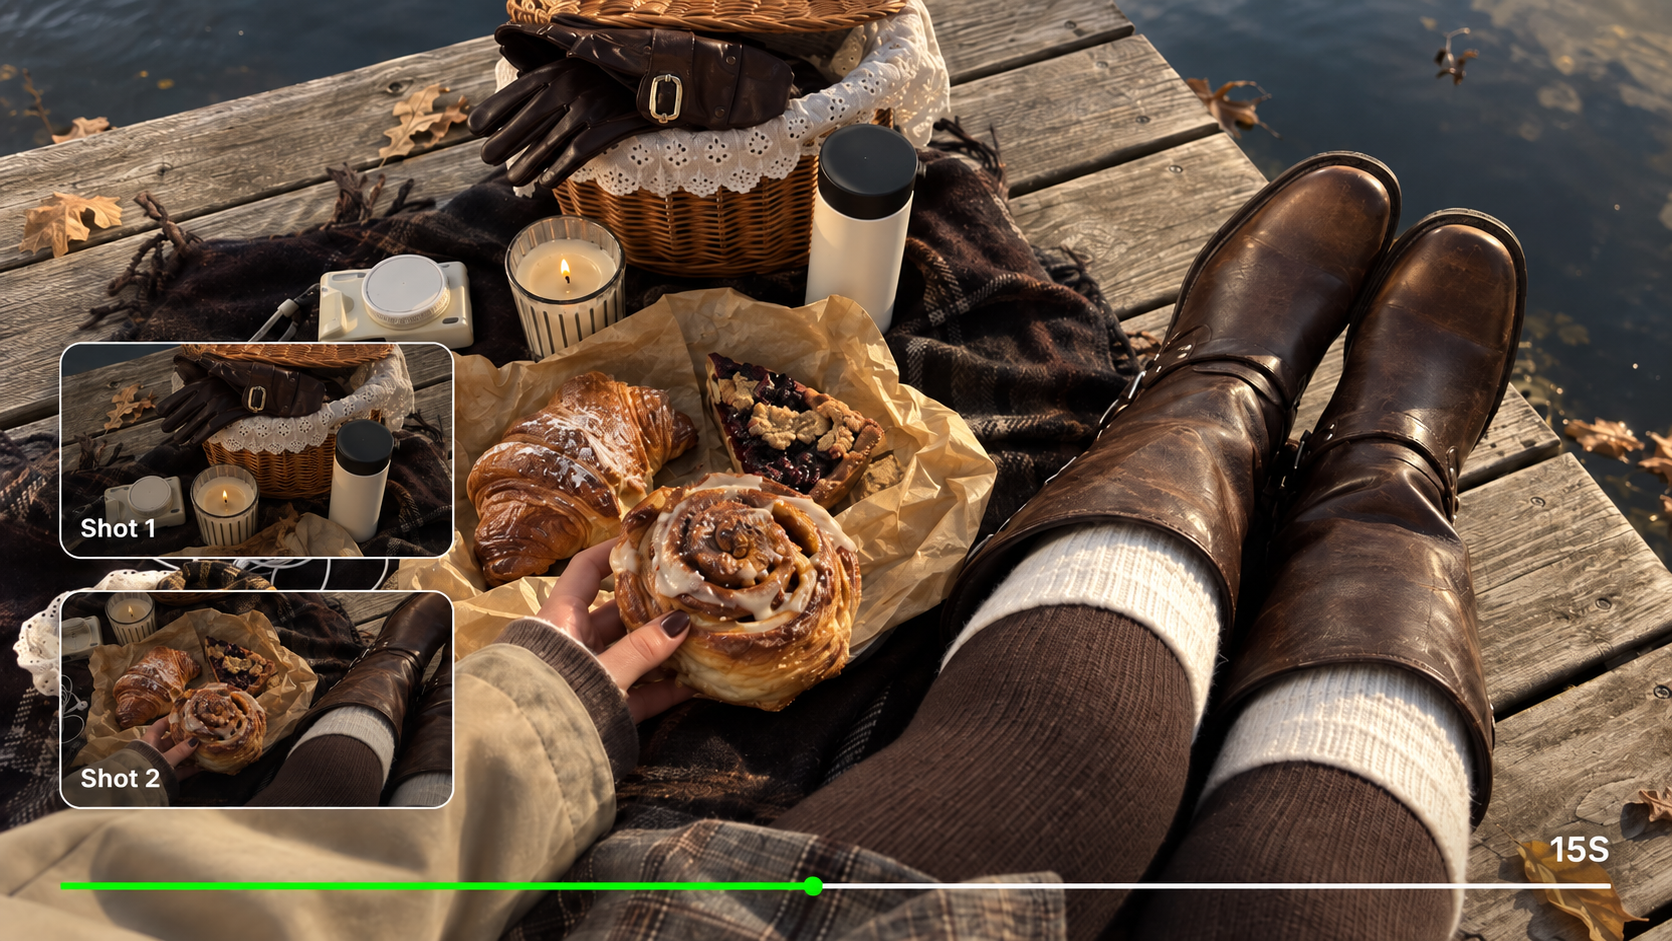
Multi-Shot milik Kling VIDEO 3.0 dapat menangani beberapa pengambilan dalam satu generasi, mengubah satu prompt menjadi sebuah rangkaian yang saling terhubung alih-alih sekumpulan klip terpisah. Untuk rangkaian yang sudah direncanakan, Custom Multi-Shot memungkinkan Anda menentukan konten, urutan, dan durasi tiap pengambilan, sehingga potongan dan tempo sudah diatur sebelum proses generasi dimulai.
Hasilkan Dialog dan Suara Adegan Secara Bersamaan
Ketika sebuah model video hanya menghasilkan visual, adegan dialog memerlukan pekerjaan tambahan. Suara, latar, efek, dan penyesuaian waktu semuanya harus ditangani setelahnya. Tambahkan beberapa karakter, dan Anda juga perlu melacak siapa yang mengucapkan setiap baris dan apakah suara tersebut tiba bersamaan dengan aksi yang tepat di layar.
Native Audio milik Kling VIDEO 3.0 menghasilkan dialog, suara latar, dan audio lainnya bersamaan dengan video. Dalam adegan multi-karakter, Anda dapat menugaskan dialog kepada pembicara yang berbeda, dengan dukungan untuk bahasa Mandarin, Inggris, Jepang, Korea, dan Spanyol, beserta dialek dan aksen yang didukung. Ujaran, performa karakter, dan suara adegan dibangun dalam proses generasi yang sama alih-alih ditumpuk di atas klip tanpa suara kemudian.
Buat Cerita Lebih Panjang hingga 15 Detik dan Output 4K
Kling VIDEO 3.0 memberi para kreator ruang lebih untuk mengembangkan setiap adegan, dengan generasi fleksibel 3–15 detik untuk interaksi karakter, penceritaan multi-shot, dialog, dan transisi. Dalam alur kerja yang didukung, output hingga 4K mempertahankan detail lebih halus, tekstur, dan kejernihan visual keseluruhan, membantu kreator beralih dari konsep awal ke konten matang untuk periklanan, pameran produk, penceritaan sinematik, dan lainnya.
Tamat
Model teks-ke-video yang layak Anda gunakan melakukan lebih dari sekadar menganimasikan sebuah prompt: model-model tersebut mengikuti niat Anda, bergerak secara alami, hadir dengan suara, dan menjaga subjek tetap stabil di seluruh bidikan. Diukur berdasarkan kriteria tersebut, Kling VIDEO 3.0 menghadirkan generasi berbasis prompt, kontrol Multi-Shot, Konsistensi Subjek, dan audio asli dalam satu tempat. Buka Kling, tulis adegan Anda, dan saksikan semuanya hidup dalam satu generasi.
FAQ
Bagaimana Cara Saya Memilih di Antara Model AI Teks-ke-Video Terbaik pada 2026?
Mulailah dengan jenis video yang ingin Anda buat, lalu bandingkan model berdasarkan pekerjaan tersebut. Penceritaan multi-shot memberi bobot lebih pada kontrol kamera dan konsistensi karakter. Adegan dengan banyak dialog membutuhkan audio yang kuat, sinkronisasi bibir, dan performa karakter, sementara pekerjaan produk dan iklan lebih bergantung pada kepatuhan terhadap prompt, stabilitas subjek, dan kualitas output. Panjang dan resolusi juga penting, karena uji cepat dan karya final jarang memiliki persyaratan yang sama. Kling VIDEO 3.0 menggabungkan Multi-Shot, Audio Native, kepatuhan terhadap prompt, dan generasi hingga 15 detik untuk cerita multi-shot, adegan yang didorong dialog, dan proyek di mana karakter atau produk yang sama perlu tetap mudah dikenali di berbagai shot.
Bisakah AI Text to Video Menyertakan Suara?
Ya. Kling VIDEO 3.0 dapat menghasilkan dialog, suara ambient, dan efek bersamaan dengan videonya, jadi Anda tidak perlu menambahkan audio setelahnya. Anda dapat menuliskan dialog langsung ke prompt, menetapkannya ke karakter tertentu, dan memilih bahasa, dialek, atau aksen. Kemampuan text-to-speech-nya dapat mengubah baris tersebut menjadi suara karakter dalam bahasa Mandarin, Inggris, Jepang, Korea, dan Spanyol. Itu berarti lebih sedikit pekerjaan sulih suara terpisah dan lebih sedikit perakitan audio setelah video dihasilkan.
Seberapa Panjang Video yang Dapat Dihasilkan?
Durasi video berbeda-beda tergantung model. Kling VIDEO 3.0 mendukung pembuatan yang fleksibel dari 3 hingga 15 detik. Klip yang lebih pendek cocok untuk aksi singkat dan konten sosial, sementara klip yang lebih panjang memberi lebih banyak waktu untuk pembukaan, dialog, dan penceritaan multi-shot. Untuk video jadi yang memerlukan detail visual lebih halus, mode yang didukung juga menawarkan keluaran hingga 4K, memberikan tekstur produk, detail karakter, dan kedalaman adegan yang lebih jelas.
Apakah Saya Memerlukan Keahlian Pengeditan Video?
Jika Anda ingin melakukan perubahan setelah pembuatan, alur kerja pengeditan VIDEO 3.0 Omni milik Kling memungkinkan Anda memodifikasi rekaman yang ada dengan instruksi bahasa alami, termasuk mengubah latar belakang, subjek, gaya, atau pembingkaian.