テキストから動画へのモデルは、書かれたシーンをカメラワークや音声、複数のショットを備えた動画に変換できる。難しいのは、完成したクリップでもプロンプトを外したり、不自然に動いたり、ショットごとにキャラクターや製品が変わってしまうことがある点だ。本記事では、そうした違いが重要になる理由と、モデルを選ぶ前に確認すべき事項、そして Kling VIDEO 3.0 がショット制御、モーション、オーディオ、視覚的連続性をどのように処理するのかを解説する。
テキストから動画へのモデルとは?
テキストから動画へのモデル は生成AIを使って自然言語の説明を動画に変換する。プロンプトでは、被写体、舞台設定、アクション、カメラの動き、ビジュアルスタイルを指定できる。モデルがオーディオに対応していれば、セリフや環境音、その他の音声キューも含められる。
テキストから動画へのモデルとテキストから動画へのAIジェネレーターは同じものとして扱われることが多いが、果たす役割は異なる。
テキストから動画へのモデル | テキストから動画へのAIジェネレーター | |
それが何か | プロンプトを解釈し、動画を生成するAIシステム | 人々がテキストから動画生成にアクセスするために使う製品またはインターフェース |
扱う内容 | プロンプトの解釈、シーン生成、動き、時間を通した連続性 | ショット制御、参照入力、音声、再生時間、アスペクト比、編集、書き出しなど、モデルを中心に構築された機能 |
なぜ重要なのか | モデルは動画の画質、動き、視覚的一貫性に直接影響します | ジェネレーターは、どれだけ創造的に制御できるか、そしてその後に動画で何ができるかに影響します |
モデルは何が生成されるかを決め、一方でAI動画ジェネレーター は、それらの機能へのアクセス方法、プロセスの制御方法、完成した動画の扱い方を決めます
テキストから動画へのモデルはどのように機能するのか?
テキストから動画へのモデルは、書かれたプロンプトを動く画像のシーケンスに変換します。具体的なプロセスはモデルによって異なりますが、一般的にはプロンプトを理解し、シーンの圧縮された表現を構築し、時間の経過とともに物事がどのように変化するかを計算し、瞬間から瞬間まで結果を一貫させることが含まれます。
1. プロンプトを解釈する
text-to-video AIモデルは、プロンプトに含まれる主な指示を特定することから始めます。これには次のような内容が含まれます:
- 主題
- 動作
- 設定
- 視覚的スタイル
- カメラの向き
- 対応している場合は、セリフやその他の音声キュー
| prompt: “カメラが後方から追跡する中、サイクリストが雨のダウンタウンの通りを走り抜ける。” |
その短い説明には、連携して機能する必要があるいくつかの指示が含まれている。サイクリストは前進し、カメラは後方から追従し、雨や街路、照明、周囲が同じショットの中で整合性を持たなければならない。
言い換えれば、そのプロンプトは画面に何を映すべきか以上のことを説明している。それは被写体、動き、カメラ、環境の間の関係も設定している。
2. 圧縮された動画表現を構築する
プロンプトを読み取った後、システムは完成した映像になる前にシーンの実用的な表現を必要とする。具体的な方法はモデルのアーキテクチャに依存する。
多くの拡散型テキストから動画へのモデルは、最初からフル解像度のフレームを処理するのではなく、圧縮された表現空間で動作する。モデルはノイズから開始し、プロンプトに従って徐々にそれを整形し、被写体や背景、照明、構図などの視覚的なディテールを浮かび上がらせる。この圧縮空間で作業することで生成中に扱うデータ量が減り、シーンが形を成したら結果が目に見える動画フレームとしてデコードされる。
3. 動きとインタラクションを生成する
動画はある瞬間から次の瞬間までに何が起きるかを示さなければならない。モデルはシーンを破綻させずに動きや物体同士の相互作用、視点の変化を処理する必要がある。
- 動き:キャラクターが向きを変える、歩く、または手を伸ばすときは、ある状態から別の状態にパッと切り替わるのではなく、段階的にポーズと位置を変化させるべきです。
- オブジェクトとの相互作用:動作には明確な順序が必要です。誰かがカップを拾い上げる場合、カップが動く前に手がカップに伸びて接触する必要があります。
- カメラとスペース:パン、チルト、プッシュイン、トラッキングショットは視点を変化させますが、被写体と周囲は同じ空間に固定され続ける必要があります。
静止画は1つの瞬間だけを描写すれば十分です。動画は、瞬間と瞬間の間に起こることまで考慮しなければなりません。
4. 時間的および視聴覚的一貫性を維持する
映像が進行するにつれて、人、物体、音は時間を通じて整合性を保つ必要があります。これは主に2種類の一貫性に集約されます。
- 時間的な一貫性:キャラクター、製品、衣装、小道具、照明、背景は、明確な理由もなく瞬間ごとに変化してはならない。クローズアップからワイドショットへのカットやカメラアングルの変更があっても、同じ人物や製品は引き続き容易に認識できるべきである。
- 視聴覚の一貫性:セリフ、口の動き、表情、環境音、画面上の動きは適切なタイミングで起こる必要がある。キャラクターが話すときは、口の動きがセリフに合致し、足音や衝撃音はそれぞれのアクションと同時に鳴るべきだ。
テキストから動画へのAIはどのように活用できるのか?
大規模に制作する価値があるかどうかを判断する前にアイデアを目で確認する必要がある場面で、テキストから動画へのAIは効果的に機能する。初期のクリエイティブテスト、撮影が難しいシーン、制作開始前に複数のビジュアル方向性が求められるプロジェクトに役立つ。
ソーシャルメディア動画を制作する
ソーシャルコンテンツの賞味期限は短いため、投稿やキャンペーンコンセプトごとに新たな撮影を手配するのはほとんど意味がありません。プロンプトを使えば、毎回撮影体制を作り直さなくても、ティーザーや告知、キャンペーン投稿、短いストーリー主導の動画向けのクリップを生成できます。クリエイターは、最終版を決める前に、さまざまな設定やカメラワーク、ビジュアルの方向性を試すこともできます。
製品アイデアをマーケティング動画に変える
文章や静的なモックアップだけでは、シーンの中を動いているときに製品がどのように見えるかを必ずしも示せません。テキストから動画へのAIを使えば、マーケターは同じ製品を異なる環境に配置し、広告のコンセプトを検討し、プロセスの早い段階でビジュアル表現を検証できます。製品が複数のショットにわたって登場する場合でも、その形状や色、特徴的なディテールがショットごとにどの程度一貫して再現されるかが結果からわかります。
短いナラティブシーンを構築する
複数のショットやキャラクターの動き、カメラの切り替え、会話が加わると、短いストーリーの計画は難しくなる。テキストから動画へのAIはそれらの要素をシーケンスにマッピングし、各シーンを個別に構築する前にショットの順番、テンポ、セリフのタイミングをテストしやすくする。これは、単一の連続ショット以上にストーリーが依存する短いシネマティック作品で特に役立つ。
コンセプトと絵コンテを可視化する
トリートメントや絵コンテは何が起こるべきかを説明できるが、静的なページではタイミングやカメラワークを見極めるのは難しい。アイデアを動きに変えることで、監督、デザイナー、クリエイティブチームは完成形に近い視聴体験を得られる。フレーミングを比較し、トランジションを試し、変更が容易なうちに弱い瞬間を見つけることができる。
教育・解説動画を作成する
高価であったり、抽象的であったり、アクセスが難しかったり、演出することが不可能だったりするため、カメラで捉えるのが難しい題材もあります。Text-to-video AI は、プロセスを描写したり、状況を再現したり、直接撮影できない出来事を示したりできます。解説動画、トレーニング教材、授業用コンテンツでは、静止画だけでは十分に伝わらない概念でも、動きを付けることで理解しやすくなります。
プロジェクトに最適な Text-to-video AI モデルを選ぶには?
あらゆるプロジェクトに完璧に適した単一の Text-to-video AI モデルは存在しません。まず作りたいものを明確にし、その仕事で重視すべき能力を決めましょう。比較すべき主なポイントは、プロンプトの忠実度、動きと物理的な妥当性、一貫性、クリエイティブコントロール、オーディオ、そして出力とワークフローの制限です。
プロンプトの忠実度
まず、モデルが実際にプロンプトに従っているかを確認してください。主題、動作、設定、ビジュアルスタイル、カメラの方向は、最も明白なディテールだけでなくすべてが揃って現れるべきです。雨の中を自転車で走る人をカメラが後方から追いかけるように求めたなら、ライダー、天候、動き、視点がすべてそろっているはずです。モデルが省略するものは、映像の仕上がりと同じくらい多くを語ります。
動きと物理的なもっともらしさ
動作は明確な順序で展開する必要があります。歩く、向きを変える、手を伸ばす、衝突する、カメラが動くといった動きは、唐突な飛びを生じさせずにある状態から次の状態へと移行しなければなりません。物理的な相互作用も重要です。物が動き始める前に手が接触し、着地は身体に影響を与え、髪や布、水、浮遊物は周囲の動きに反応し、勝手に振る舞うのではなくなるべきです。
キャラクターと製品の一貫性
フレーミング、アングル、距離が変わっても同じ被写体が識別できる状態であるべきです。顔、衣服、製品の形状、色、小道具、ライティング、その他の決定的なディテールが理由なくぶれてはいけません。複数ショットのシーンではこれが難しくなるため、繰り返し登場するキャラクターや製品に基づくプロジェクトでは、参照画像や被写体リファレンス、あるいはショット間で視覚的アイデンティティを維持する別の方法が用意されているか確認する必要があります。
クリエイティブとカメラのコントロール
シーンに明確なビジュアルの方向性が既にある場合、コントロールが重要になります。フレーミング、カメラの動き、ショットの順序、参照入力、アスペクト比、複数ショットの構成はすべて、結果が元のアイデアにどれほど忠実になるかに影響します。より細かなコントロールがあれば、単にアングルを変えたりショットを並べ替えたり構図を整えたりするだけでシーケンス全体を再実行する必要が少なくなります。
オーディオサポート
音声機能はモデルによって大きく異なります。視覚だけを生成するものもあれば、映像に合わせてセリフ、環境音、効果音まで作成できるものもあります。会話主体のシーンでは、声、口の動き、表情、タイミングが揃っているか確認しましょう。足音、衝撃音、環境音も、それぞれのアクションにしっかり合っている必要があります。
長さ、解像度、ワークフロー
生成時間、サポートされるアスペクト比、利用可能な解像度、書き出しオプションなど、最終的な動画に影響する制限を確認しましょう。短いSNS向けクリップと複数ショットのプロダクトシーンでは、求められる出力が大きく異なる場合があります。
生成後に何ができるかも同じくらい重要です。クリップを延長したり、同じ被写体を再利用したり、1ショットだけを修正したり、音声を再生成したり、最初からやり直すことなく編集を続けたりできますか?わずかな変更で全体のシーケンスを作り直す必要があってはなりません。
プロジェクトによって優先事項は異なります。まずは作成している動画の種類から考え、そのうえで最も重要な機能に注目しましょう。
作成したいもの | 優先する項目 | 重要な理由 |
短尺のソーシャル動画 | プロンプトの再現性、アスペクト比、ワークフロー | ソーシャルコンテンツは動きが速いため、成果物はコンセプトに忠実であり、一般的なプラットフォームのフォーマットに適合し、容易に修正できる必要があります。 |
製品およびマーケティング動画 | 製品の一貫性、プロンプトの遵守、解像度 | 製品の形状、色、ブランディング、主要なディテールはショット間で安定して保たれ、最終映像がキャンペーンやプレゼンテーションの要件を満たす必要があります。 |
短いナラティブまたはシネマティックなシーン | 動きと物理的な妥当性、カメラ制御、複数ショット間の一貫性 | キャラクターの動き、カメラの切り替え、シーンの遷移は、視覚的なずれが目立たないようにシーケンス全体でつながっている必要があります。 |
会話主導の動画 | 音声サポート、lip sync,キャラクターの一貫性 | 会話、口の動き、表情演技、キャラクターのアイデンティティは整合している必要があり、音声は適切なタイミングで届くべきです。 |
コンセプトプレビューとストーリーボード | クリエイティブとカメラの制御、リファレンス入力、修正の柔軟性 | 目的は、変更がまだ容易な早い段階で、フレーミング、カメラ演出、ペーシング、代替案をテストすることです。 |
教育用および解説動画 | プロンプト遵守、動きと物理的妥当性、ワークフロー | ビジュアルはプロセスやアイデアを正確に説明し、動きを追いやすく保ち、コンテンツが変化した際に修正できるようにする必要があります。 |
Kling VIDEO 3.0で何ができるのか?
テキストから映像を生成する難しさは、見栄えの良いショットを1つ得ることではありません。重要なのは、被写体、アクション、カメラ演出、サウンド、そしてプロンプトに含まれる細かな視覚的ディテールを、意図したとおりに反映させることです。プロンプトがより詳細になり、シーンにショットが増えるほど、モデルは瞬間ごとに追跡すべき要素が多くなります。
Kling VIDEO 3.0 はこうした要求に合わせて構築されており、より強力なプロンプト解釈、マルチショットのストーリーテリング、被写体の一貫性、ネイティブオーディオ、柔軟な再生時間、そしてテキストレンダリングを備えています。説明文を書いて結果をただ待つのではなく、物語の展開、カメラが切り替わるタイミング、被写体がショットをまたいでどのように維持されるか、そして音がどこでシーンに入るかを形作ることができます。
プロンプトをより正確に理解し、従う
Kling VIDEO 3.0 は、被写体、アクション、設定、カメラの指示、ナラティブ構造を組み合わせた多層的なプロンプトを解釈できます。これにより、複数のアクションや計画されたカメラの動き、特定のイベントの順序が含まれる場合でも、複雑なテキストから動画へのプロンプトが意図したシーンにより忠実に近づきます。
ショットをまたいでキャラクターと製品の一貫性を維持
あるショットではキャラクターが正しく見えていても、別の角度になると目立って変わってしまう場合があります。複数ショットの動画では、顔がずれたり、衣服のディテールがぶれたり、製品の色や形、特徴的な要素がショットごとに変わってしまうことがあります。
サポートされているリファレンス支援付きのVIDEO 3.0ワークフローでは、複数のリファレンス画像を使用して追加の視覚的ガイダンスを提供し、フレーミングや角度、シチュエーションが変化しても繰り返し登場するキャラクターや製品、その他の重要な被写体を固定できます。これらのリファレンスは被写体の外見や主要な視覚的ディテールについてより多くの情報をモデルに与え、繰り返し登場するキャラクターのシーンや製品ショット、ブランドコンテンツで目立つビジュアルドリフトを抑えるのに役立ちます。

ペースをより細かく制御してマルチショットのストーリーを構築する
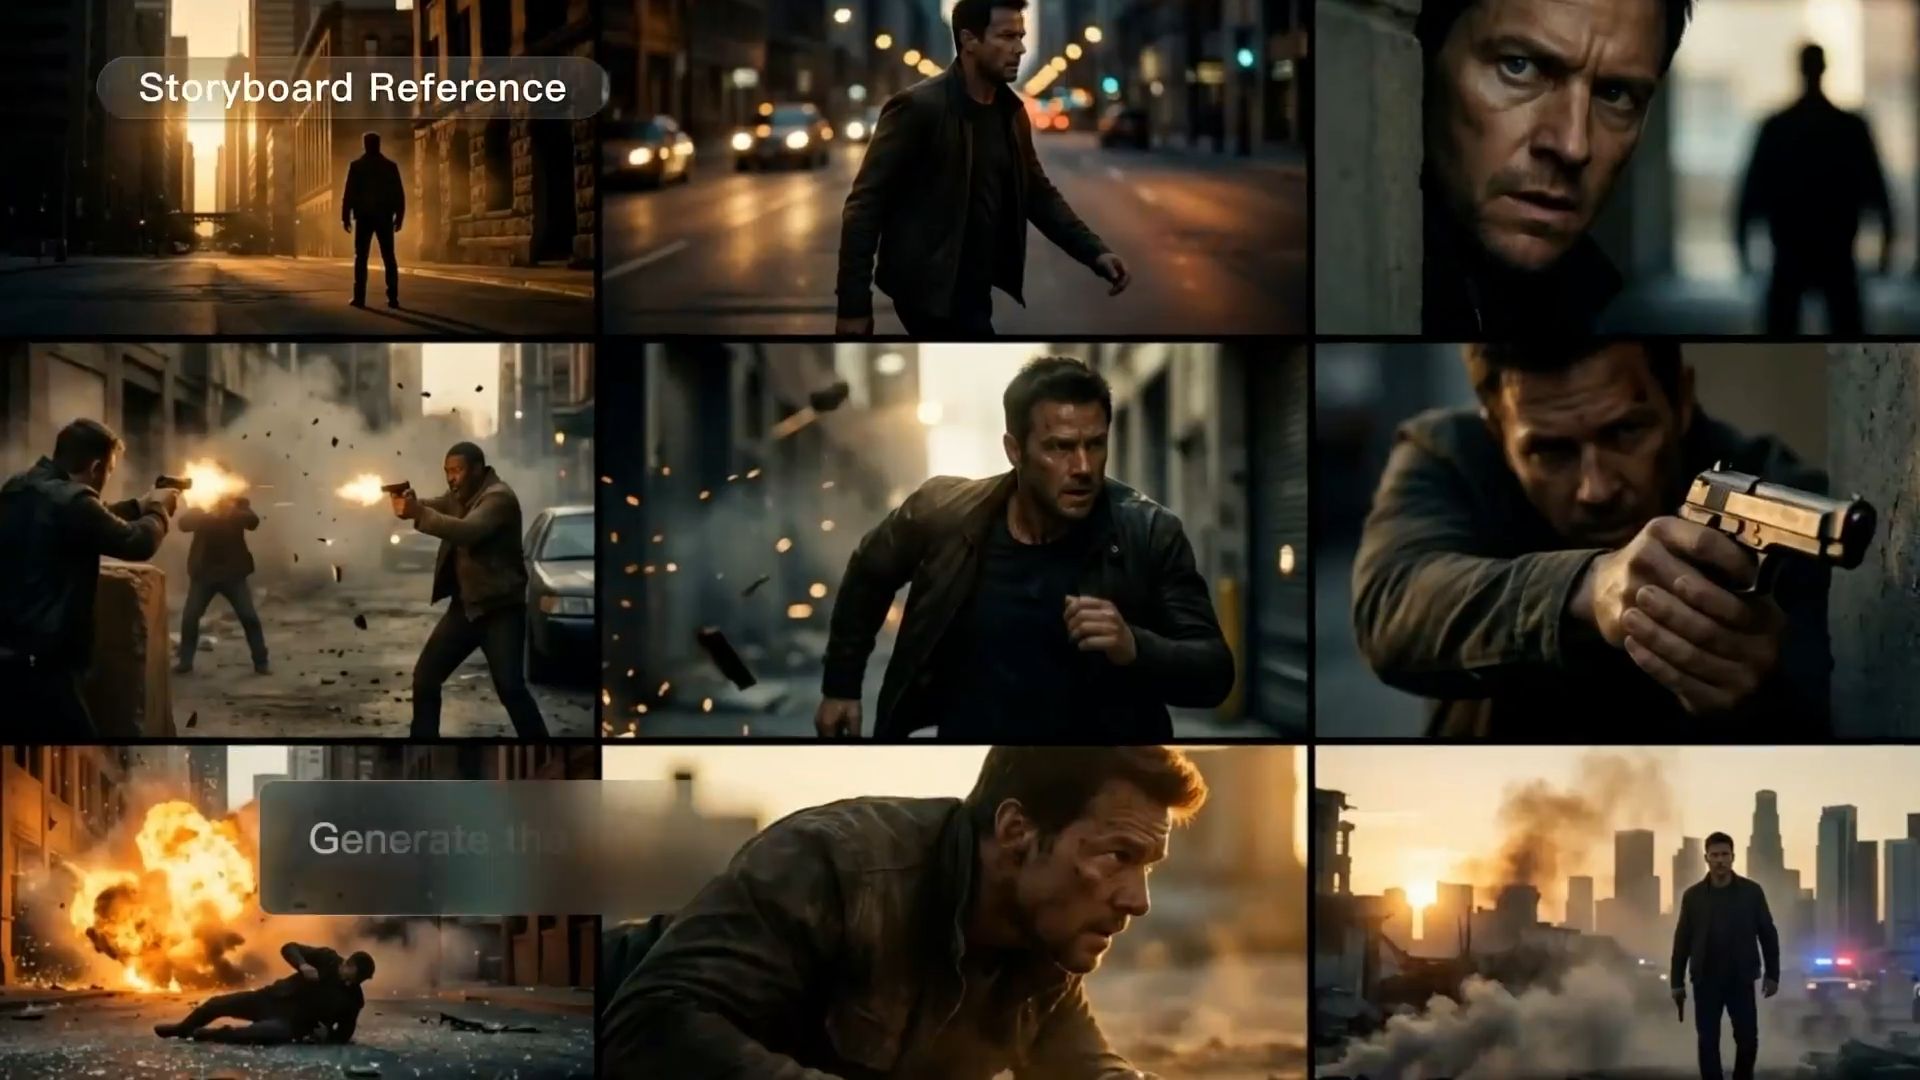
単一のショットならたいていは扱いやすい。物語にクローズアップやワイドショット、さまざまなカメラ位置、シーン転換が必要になってくると難易度が上がる。ショットごとに別々に生成すると、あとで組み立てる工程が増え、シーケンス全体でリズムと連続性を保つのが難しくなる。
Kling VIDEO 3.0のマルチショットは、一度の生成で複数のショットを処理し、分断されたクリップの集まりではなく、単一のプロンプトをつながったシーケンスに変換する。計画済みのシーケンス向けには、カスタム・マルチショットを使って各ショットの内容、順序、尺を指定できるため、生成を始める前にカットとテンポを決めておける。
ダイアログとシーンのサウンドを同時に生成
映像モデルがビジュアルだけを生成する場合、会話シーンには追加の作業が発生する。声や環境音、効果音、タイミングはすべて後から調整しなければならない。登場人物が増えると、誰がどのセリフを話すのか、音が画面上のアクションと合っているかまで管理する必要がある。
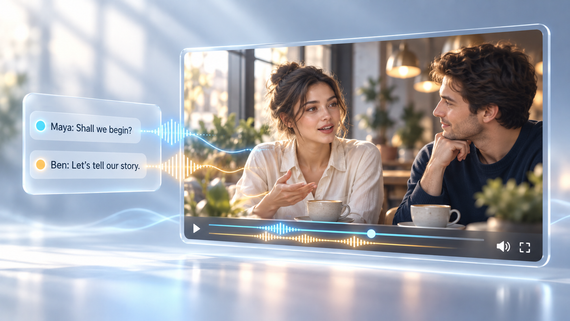
Kling VIDEO 3.0のNative Audio機能は、映像とともにダイアログ、環境音、その他のオーディオを生成します。複数キャラクターのシーンでは、中国語、英語、日本語、韓国語、スペイン語などの対応言語と方言・アクセントに対応し、話者ごとにセリフを割り当てられます。音声、キャラクターの演技、シーンのサウンドは、後から無音クリップに重ねるのではなく、同一の生成プロセスに組み込まれています。
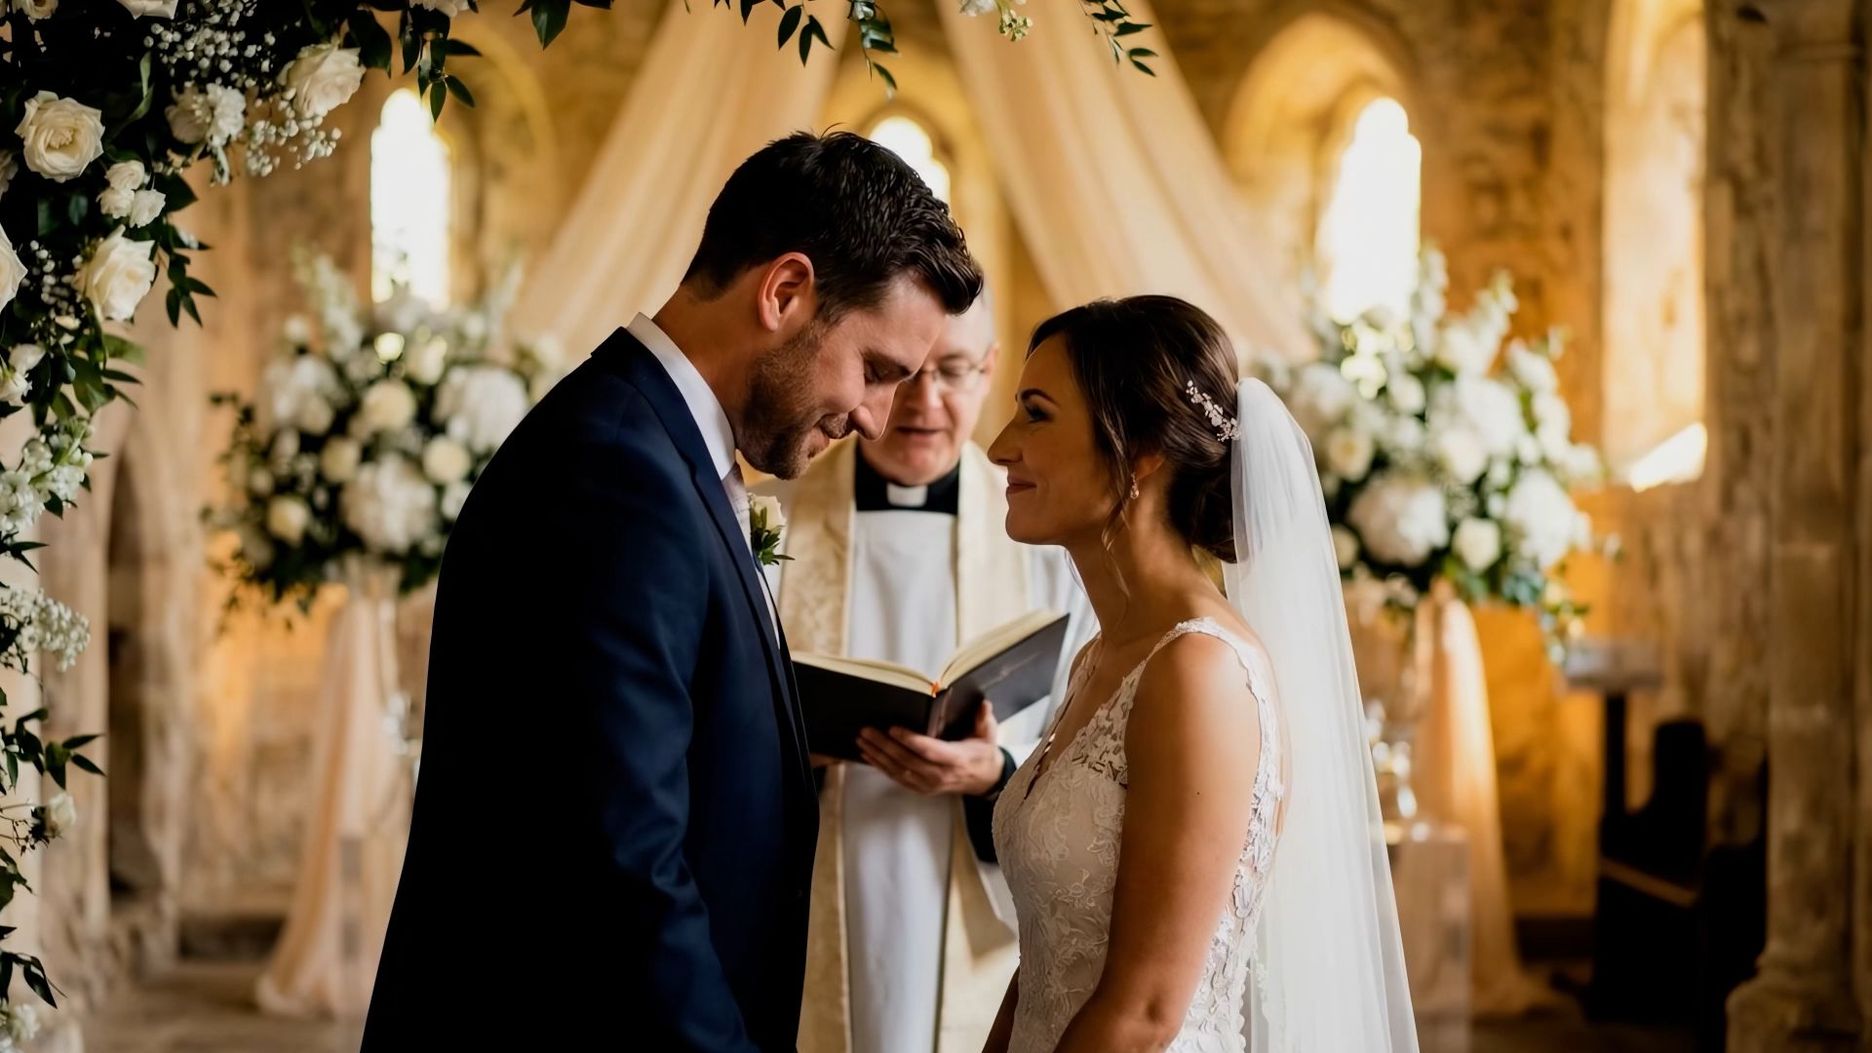
最長15秒と4K出力でより長いストーリーを制作
Kling VIDEO 3.0は、キャラクターのやり取り、複数ショットのストーリーテリング、ダイアログ、トランジションのために柔軟な3~15秒の生成を提供し、クリエイターが各シーンをより自由に展開できるようにします。対応するワークフローでは、最大4K出力によってより細かなディテールや質感、全体的な視覚的鮮明さを保持し、広告、製品紹介、映画的なストーリーテリングなどに向けて、初期コンセプトから洗練されたコンテンツへと進めることを支援します。
終わり
あなたの時間を費やす価値のあるテキストから動画へのモデルは、プロンプトをアニメーション化するだけではありません。意図に従い、自然に動き、音声を伴い、ショットをまたいでも被写体を安定して保持します。そうした基準で測ると、Kling VIDEO 3.0 はプロンプト主導の生成、マルチショット制御、被写体の一貫性、ネイティブオーディオをひとつにまとめます。Kling を開き、シーンを書き上げ、単一の生成でそれが命を吹き込まれるのを見届けてください。
よくある質問
2026年に最高のテキストから動画へのAIモデルの中からどのように選べばよいですか?
作りたい動画の種類を決めてから、その用途に合わせてモデルを比較しましょう。マルチショットのストーリーテリングでは、カメラのコントロールとキャラクターの一貫性がより重要になります。会話中心のシーンでは、優れた音声、リップシンク、キャラクターの演技が求められます。一方、製品紹介や広告制作では、プロンプトの遵守、被写体の安定性、出力品質がより重視されます。短いテストと完成品では要求が異なることが多いため、長さと解像度も重要です。Kling VIDEO 3.0 は、マルチショット、ネイティブ音声、プロンプトの遵守、最大15秒までの生成を組み合わせ、マルチショットの物語や会話主体のシーン、同じキャラクターや製品をショットをまたいで認識できるようにする必要があるプロジェクトを支援します。
AIのテキストから動画生成は音声を含められるのか?
はい。Kling VIDEO 3.0 は映像と同時に会話、環境音、効果音を生成できるため、あとから音声を追加する必要はありません。セリフを直接プロンプトに書き込み、特定のキャラクターに割り当て、言語、方言、アクセントを選択できます。その text-to-speech機能によって、そのセリフを中国語、英語、日本語、韓国語、スペイン語のキャラクターボイスに変換できます。つまり、別途ナレーションを収録する作業や、生成後の音声編集の手間が減るということです。
生成される動画はどれくらいの長さにできますか?
動画の長さはモデルによって異なります。Kling VIDEO 3.0 は3秒から15秒まで柔軟に生成をサポートします。短いクリップは素早い動きやソーシャル向けコンテンツに適しており、長いクリップなら盛り上げや会話、複数ショットのストーリーテリングに時間を割けます。完成度の高い動画で細かなビジュアルが必要な場合は、対応モードで最大4Kまで出力でき、製品の質感やキャラクターのディテール、シーンの奥行きをより鮮明に表現します。
動画編集のスキルは必要ですか?
生成後に変更を加えたい場合は、Kling の VIDEO 3.0 Omni 編集ワークフローによって、背景の変更や被写体、スタイル、フレーミングを含む自然言語の指示で既存の映像を編集できます。