Tekst-naar-video-modellen kunnen een geschreven scène omzetten in video met camerabeweging, geluid en meerdere shots. Het lastige is dat een afgewerkte clip de prompt nog steeds kan missen, onhandig kan bewegen of een personage of product van het ene shot naar het andere kan laten veranderen. Dit artikel bekijkt waarom die verschillen ertoe doen, wat je moet controleren voordat je een model kiest, en hoe Kling VIDEO 3.0 shotcontrole, beweging, audio en visuele continuïteit aanpakt.
Wat zijn tekst-naar-video-modellen?
Tekst-naar-video-modellen gebruiken generatieve AI om beschrijvingen in natuurlijke taal in video om te zetten. Een prompt kan het onderwerp, de setting, de actie, de camerabeweging en de visuele stijl specificeren. Als het model audio ondersteunt, kan het ook dialoog, omgevingsgeluid en andere audiocues bevatten.
Tekst-naar-video-modellen en tekst-naar-video-AI-generatoren worden vaak als hetzelfde gezien, maar ze vervullen verschillende rollen:
Tekst-naar-video-model | Tekst-naar-video-AI-generator | |
Wat het is | Het AI-systeem dat de prompt interpreteert en de video genereert | Het product of de interface die mensen gebruiken om toegang te krijgen tot tekst-naar-video-generatie |
Wat het afhandelt | Interpretatie van prompts, scènegeneratie, beweging en continuïteit in de tijd | Functies rond het model, zoals opnamebesturing, referentie-invoer, audio, duur, beeldverhouding, bewerking en export |
Waarom het ertoe doet | Het model heeft directe invloed op de videokwaliteit, beweging en visuele consistentie | De generator bepaalt hoeveel creatieve controle je hebt en wat je achteraf met de video kunt doen |
Het model bepaalt wat er wordt gegenereerd, terwijl een AI video generator bepaalt hoe je toegang krijgt tot die mogelijkheden, het proces aanstuurt en met de afgewerkte video werkt.
Hoe werken tekst-naar-video-modellen?
Tekst-naar-video-modellen zetten een geschreven prompt om in een reeks bewegende beelden. Het exacte proces verschilt per model, maar omvat doorgaans het begrijpen van de prompt, het opbouwen van een gecomprimeerde representatie van de scène, uitwerken hoe dingen in de tijd veranderen en ervoor zorgen dat het resultaat van moment tot moment consistent blijft.
1. Interpreteer de prompt
Een tekst-naar-video-AI-model begint met het identificeren van de belangrijkste instructies in de prompt, waaronder:
- het onderwerp
- de actie
- de omgeving
- de visuele stijl
- de cameragerichting
- dialoog of andere audiocues, wanneer ondersteund
| prompt: "Een fietser rijdt door een regenachtige straat in het centrum terwijl de camera van achteren volgt." |
Die korte beschrijving bevat verschillende instructies die moeten samenwerken. De fietser beweegt naar voren, de camera volgt van achteren, en de regen, straat, verlichting en omgeving moeten binnen hetzelfde shot kloppen.
Met andere woorden, de prompt beschrijft meer dan wat er op het scherm moet verschijnen. Hij legt ook relaties vast tussen het onderwerp, de beweging, de camera en de omgeving.
2. Bouw een gecomprimeerde videorepresentatie
Nadat de prompt is gelezen, heeft het systeem een werkbare representatie van de scène nodig voordat deze wordt omgezet in afgewerkte beelden. De exacte methode hangt af van de architectuur van het model.
Veel op diffusie gebaseerde tekst-naar-video-modellen werken in een gecomprimeerde representatieruimte in plaats van vanaf het begin beelden met volledige resolutie te verwerken. Ze beginnen met ruis en vormen die geleidelijk naar de prompt, waardoor onderwerp, setting, belichting, compositie en andere visuele details zichtbaar worden. Werken in deze gecomprimeerde ruimte vermindert de hoeveelheid gegevens die tijdens de generatie moet worden verwerkt, en zodra de scène vorm heeft gekregen, wordt het resultaat gedecodeerd naar zichtbare videoframes.
3. Genereer beweging en interacties
Video moet laten zien wat er van het ene moment op het andere gebeurt. Het model moet beweging, interacties tussen objecten en veranderingen in gezichtspunt aankunnen zonder de scène te verstoren.
- Beweging: Een personage dat draait, loopt of reikt moet stap voor stap van houding en positie veranderen, in plaats van van de ene toestand naar de andere te springen.
- Objectinteractie: Handelingen hebben een duidelijke volgorde nodig. Als iemand een kopje oppakt, moet de hand het eerst bereiken en contact maken voordat het kopje beweegt.
- Camera en ruimte: Panbewegingen, kantelingen, push-ins en trackingopnamen veranderen het gezichtspunt, maar het onderwerp en de omgeving moeten wel verankerd blijven in dezelfde ruimte.
Een stilstaand beeld hoeft slechts één moment te beschrijven. Video moet rekening houden met wat er tussen de momenten gebeurt.
4. Zorg voor temporele en audiovisuele consistentie
Naarmate de video zich ontvouwt, moeten mensen, objecten en geluid in de loop van de tijd coherent blijven. Dit komt vooral neer op twee soorten consistentie:
- Temporele consistentie: Personages, producten, kleding, rekwisieten, belichting en achtergronden mogen niet zonder duidelijke reden van het ene moment op het andere veranderen. Zelfs na een overgang van een close-up naar een wide shot of een verandering van camerahoek moet dezelfde persoon of hetzelfde product nog steeds gemakkelijk te herkennen zijn.
- Audio-visuele consistentie: Dialoog, lipbewegingen, gezichtsuitdrukkingen, omgevingsgeluid en acties op het scherm moeten op het juiste moment plaatsvinden. Wanneer een personage spreekt, moet de mondbeweging overeenkomen met de dialoog, terwijl voetstappen of inslaggeluiden moeten samenvallen met de actie waarbij ze horen.
Waarvoor kun je tekst-naar-video-AI gebruiken?
Tekst-naar-video-AI werkt goed in situaties waarin een idee eerst moet worden gezien voordat het de moeite waard is om het op volledige schaal te produceren. Het kan helpen bij vroege creatieve tests, scènes die moeilijk te filmen zijn, en projecten die meerdere visuele richtingen nodig hebben voordat de productie start.
Maak video's voor sociale media
Sociale content heeft een korte houdbaarheid, dus een nieuwe shoot regelen voor elke post of campagneconcept heeft zelden zin. Een prompt kan clips opleveren voor teasers, aankondigingen, campagneposts of korte verhaalgestuurde video's zonder telkens de productie-opzet opnieuw te moeten opbouwen. Makers kunnen ook verschillende instellingen, camerabewegingen en visuele richtingen uitproberen voordat ze zich op een versie vastleggen.
Verander productideeën in marketingvideo's
Copy en statische mock-ups laten niet altijd zien hoe een product eruitziet zodra het door een scène beweegt. Tekst-naar-video-AI stelt marketeers in staat hetzelfde product in verschillende omgevingen te plaatsen, advertentieconcepten te verkennen en visuele uitwerkingen eerder in het proces te testen. Als het product in meerdere opnamen verschijnt, laten de resultaten ook zien hoe goed de vorm, kleur en kenmerkende details standhouden van de ene opname tot de volgende.
Bouw korte verhalende scènes
Een kort verhaal wordt moeilijker te plannen zodra het meerdere shots, handelingen van personages, camerawissels en dialogen bevat. Tekst-naar-video-AI kan die elementen in een reeks plaatsen, waardoor het gemakkelijker wordt om de volgorde van shots, het tempo en de dialoogtiming te testen voordat elke scène afzonderlijk wordt opgebouwd. Dit is vooral nuttig voor korte cinematografische stukken waarin het verhaal afhankelijk is van meer dan één enkele doorlopende opname.
Concepten en storyboards visualiseren
Een treatment of storyboard kan uitleggen wat er moet gebeuren, maar timing en camerabeweging zijn moeilijker te beoordelen op een statische pagina. Het idee in beweging omzetten geeft regisseurs, ontwerpers en creatieve teams iets dat dichter bij de uiteindelijke kijkervaring komt. Ze kunnen de kadrering vergelijken, overgangen testen en zwakke momenten opsporen terwijl wijzigingen nog eenvoudig door te voeren zijn.
Educatieve en uitlegvideo's maken
Sommige onderwerpen zijn moeilijk vast te leggen met een camera omdat ze duur, abstract, ontoegankelijk of onmogelijk te ensceneren zijn. Tekst-naar-video-AI kan een proces illustreren, een scène reconstrueren of een gebeurtenis laten zien die niet rechtstreeks kan worden gefilmd. Voor explainers, trainingsmateriaal en lesinhoud kan beweging een concept gemakkelijker te begrijpen maken wanneer een stilstaand beeld niet genoeg laat zien.
Hoe kies je het beste tekst-naar-video-AI-model voor je project?
Geen enkel tekst-naar-video-AI-model is geschikt voor elk project. Begin met wat je wilt maken en bepaal vervolgens welke mogelijkheden voor die taak het belangrijkst zijn. De belangrijkste zaken om te vergelijken zijn prompt-naleving, beweging en fysieke plausibiliteit, consistentie, creatieve controle, audio en de beperkingen van de output en de workflow.
Prompt-naleving
Controleer eerst of het model de prompt daadwerkelijk volgt. Het onderwerp, de actie, de setting, de visuele stijl en de camerarichting zouden allemaal samen moeten voorkomen in plaats van alleen de meest voor de hand liggende details. Als je vraagt om een fietser die door de regen rijdt terwijl de camera van achteren volgt, moeten de fietser, het weer, de beweging en het perspectief allemaal aanwezig zijn. Wat het model weglaat kan je net zo veel vertellen als hoe gepolijst de beelden ogen.
Beweging en fysieke plausibiliteit
Acties moeten zich in een duidelijke volgorde ontvouwen. Lopen, draaien, reiken, botsingen en camerabewegingen moeten van de ene toestand naar de volgende gaan zonder plotselinge sprongen. Fysieke interactie is ook belangrijk: een hand moet contact maken voordat een object beweegt, een landing moet effect hebben op het lichaam, en haar, stof, water of losse objecten moeten reageren op nabijgelegen beweging in plaats van zich op eigen houtje te gedragen.
Consistentie van personage en product
Hetzelfde onderwerp moet herkenbaar blijven wanneer het kader, de hoek of de afstand verandert. Gezichten, kleding, productvorm, kleur, rekwisieten, belichting en andere bepalende details mogen niet zonder reden afwijken. Scenes met meerdere shots maken dit lastiger, dus projecten die draaien om terugkerende personages of producten moeten ook worden gecontroleerd op referentiebeelden, onderwerpverwijzingen of een andere manier om de visuele identiteit van shot naar shot mee te nemen.
Creatieve en cameracontrole
Wanneer een scène al een duidelijke visuele richting heeft, is controle belangrijk. Kadering, camerabeweging, volgorde van shots, referentie-inputs, beeldverhouding en multishotstructuur bepalen allemaal hoe nauw het resultaat aansluit op het oorspronkelijke idee. Fijnmazige controle betekent ook dat je minder snel een hele reeks opnieuw hoeft te draaien alleen om een hoek te wijzigen, een shot te herschikken of de compositie te corrigeren.
Audio-ondersteuning
Audiomogelijkheden verschillen sterk tussen modellen. Sommige genereren alleen beeld, terwijl andere samen met het materiaal dialoog, omgevingsgeluid en effecten kunnen maken. Controleer bij dialogrijke scènes of stem, mondbeweging, gezichtsuitdrukking en timing op elkaar blijven afgestemd. Voetstappen, inslagen en omgevingsgeluiden moeten ook samenvallen met de actie waarbij ze horen.
Duur, resolutie en workflow
Kijk naar de limieten die de uiteindelijke video beïnvloeden, waaronder de generatielengte, ondersteunde beeldverhoudingen, beschikbare resoluties en exportopties. Een korte socialmediaclip en een productscène met meerdere shots kunnen heel andere outputvereisten hebben.
Wat er na de generatie gebeurt, is minstens zo belangrijk. Kun je de clip verlengen, hetzelfde onderwerp opnieuw gebruiken, één shot herzien, audio opnieuw genereren of doorgaan met bewerken zonder helemaal opnieuw te beginnen? Kleine wijzigingen mogen je niet dwingen de volledige sequentie opnieuw op te bouwen.
Verschillende projecten vragen om verschillende prioriteiten. Begin met het type video dat je maakt en concentreer je vervolgens op de mogelijkheden die het meest van belang zijn:
Als je wilt creëren | Geef prioriteit aan | Waarom dit belangrijk is |
Korte socialvideo's | Nauwkeurigheid van prompts, beeldverhoudingen, workflow | Sociale content beweegt snel, dus de output moet dicht bij het idee blijven, passen binnen gangbare platformformaten en gemakkelijk aan te passen zijn. |
Product- en marketingvideo's | Productconsistentie, naleving van prompts, resolutie | De vorm, kleur, branding en belangrijkste details van het product moeten over shots heen stabiel blijven, terwijl het uiteindelijke beeldmateriaal nog steeds aan de campagne- of presentatiebehoeften voldoet. |
Korte narratieve of cinematografische scènes | Beweging en fysieke plausibiliteit, camerabeheersing, consistentie over meerdere shots | Handelingen van personages, camerawisselingen en scèneovergangen moeten over de hele sequentie op elkaar aansluiten zonder duidelijke visuele afwijking. |
Dialooggestuurde video's | Ondersteuning voor audio, lip-sync, consistentie van personages | Dialoog, mondbewegingen, gezichtsacteerwerk en de identiteit van het personage moeten op elkaar afgestemd blijven, terwijl het geluid op het juiste moment moet binnenkomen. |
Conceptvoorbeelden en storyboards | Creatieve en cameraregie, referentie-inputs, flexibiliteit voor revisies | Het doel is om in een vroeg stadium framing, camerarichting, tempo en alternatieve ideeën te testen, terwijl wijzigingen nog gemakkelijk aan te brengen zijn. |
Educatieve en uitlegvideo's | Naleving van prompts, beweging en fysieke plausibiliteit, workflow | De visuals moeten een proces of idee nauwkeurig uitleggen, de beweging gemakkelijk te volgen houden en herzieningen mogelijk maken wanneer de inhoud verandert. |
Wat kun je doen met Kling VIDEO 3.0?
The hard part of text-to-video is not getting one good-looking shot. It is getting the subject, action, camera direction, sound, and small visual details from the prompt to show up the way you intended. As prompts become more detailed and scenes add more shots, the model has more to keep track of from one moment to the next.
Kling VIDEO 3.0 is opgebouwd rond die eisen, met sterkere promptinterpretatie, storytelling met meerdere shots, onderwerpconsistentie, native audio, flexibele duur en tekstrendering. In plaats van een beschrijving te schrijven en simpelweg te wachten om te zien wat je terugkrijgt, kun je vormgeven hoe het verhaal zich ontvouwt, wanneer de camera verandert, hoe onderwerpen over shots heen worden meegenomen en waar geluid de scène binnenkomt.
Prompts nauwkeuriger begrijpen en volgen
Kling VIDEO 3.0 kan gelaagde prompts interpreteren die onderwerpen, acties, omgevingen, camerarichting en narratieve structuur combineren. Dat helpt complexe text-to-video-prompts dichter bij de bedoelde scène te blijven, vooral wanneer ze meerdere acties, geplande camerabewegingen of een specifieke volgorde van gebeurtenissen bevatten.
Houd personages en producten consistent tussen shots
Een personage kan er in één shot goed uitzien en toch vanuit een andere hoek merkbaar veranderen. In video met meerdere shots kunnen gezichten verschuiven, kunnen kledingdetails afdwalen en kunnen de kleur, vorm of kenmerkende eigenschappen van een product van het ene shot naar het volgende veranderen.
In ondersteunde VIDEO 3.0-workflows met referentieondersteuning kun je meerdere referentieafbeeldingen gebruiken om extra visuele begeleiding te bieden en een terugkerend personage, product of ander belangrijk onderwerp te verankeren bij veranderingen in kadrering, hoek en setting. Deze referenties geven het model meer informatie over het uiterlijk van het onderwerp en belangrijke visuele details, waardoor duidelijke visuele drift afneemt in scènes met terugkerende personages, productshots en branded content.

Creëer multi-shot-verhalen met meer controle over het tempo
Een enkele opname is doorgaans beheersbaar. De uitdaging begint wanneer een verhaal close-ups, wide shots, verschillende cameraposities en scènewisselingen nodig heeft. Elke opname afzonderlijk genereren betekent later meer montage, en het wordt moeilijker om tempo en continuïteit in de hele reeks intact te houden.
De Multi-Shot-functie van Kling VIDEO 3.0 kan meerdere opnamen in één generatie verwerken, waardoor een enkele prompt verandert in een verbonden reeks in plaats van een verzameling losse clips. Voor een geplande sequentie laat Custom Multi-Shot je de inhoud, volgorde en duur van afzonderlijke opnamen vastleggen, zodat de cuts en het tempo vastliggen voordat de generatie start.
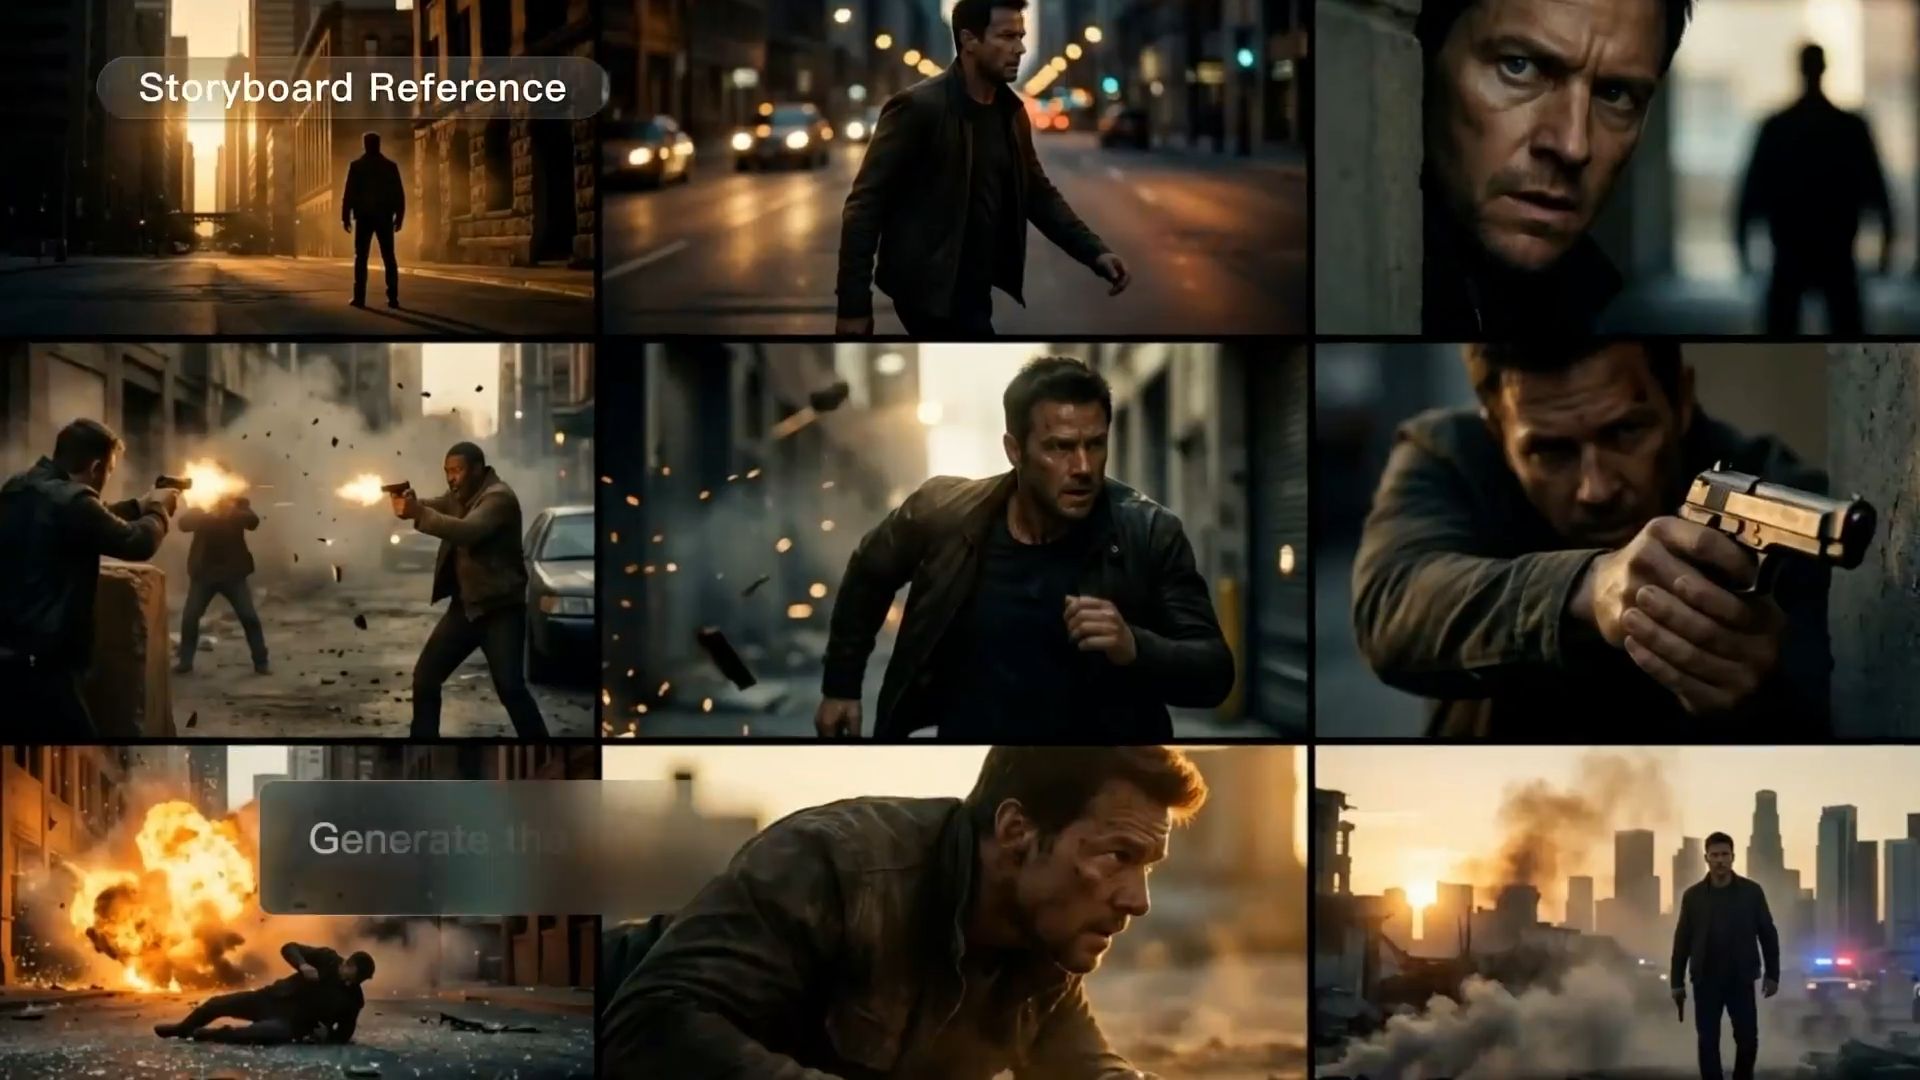
Genereer dialoog en scèngeluid tegelijk
Wanneer een videomodel alleen beeld produceert, leveren dialoogscènes extra werk op. Stemmen, omgevingsgeluid, effecten en timing moeten allemaal achteraf worden verzorgd. Voeg meerdere personages toe en je moet ook bijhouden wie welke zin zegt en of het geluid bij de juiste actie in beeld terechtkomt.
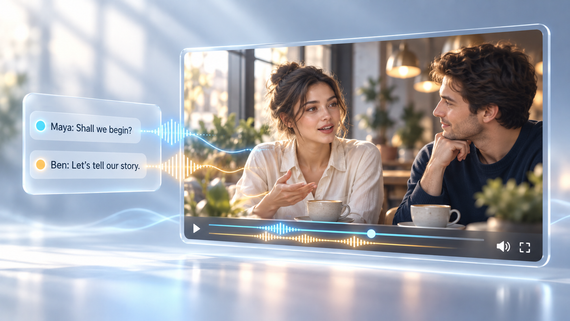
Native Audio van Kling VIDEO 3.0 genereert dialogen, omgevingsgeluid en andere audio samen met de video. In scènes met meerdere personages kun je regels toewijzen aan verschillende sprekers, met ondersteuning voor Chinees, Engels, Japans, Koreaans en Spaans, samen met ondersteunde dialecten en accenten. Spraak, de prestaties van personages en het geluid van de scène zijn opgenomen in dezelfde generatie in plaats van later over een stille clip te worden gelegd.
Maak langere verhalen met een duur tot 15 seconden en 4K-uitvoer
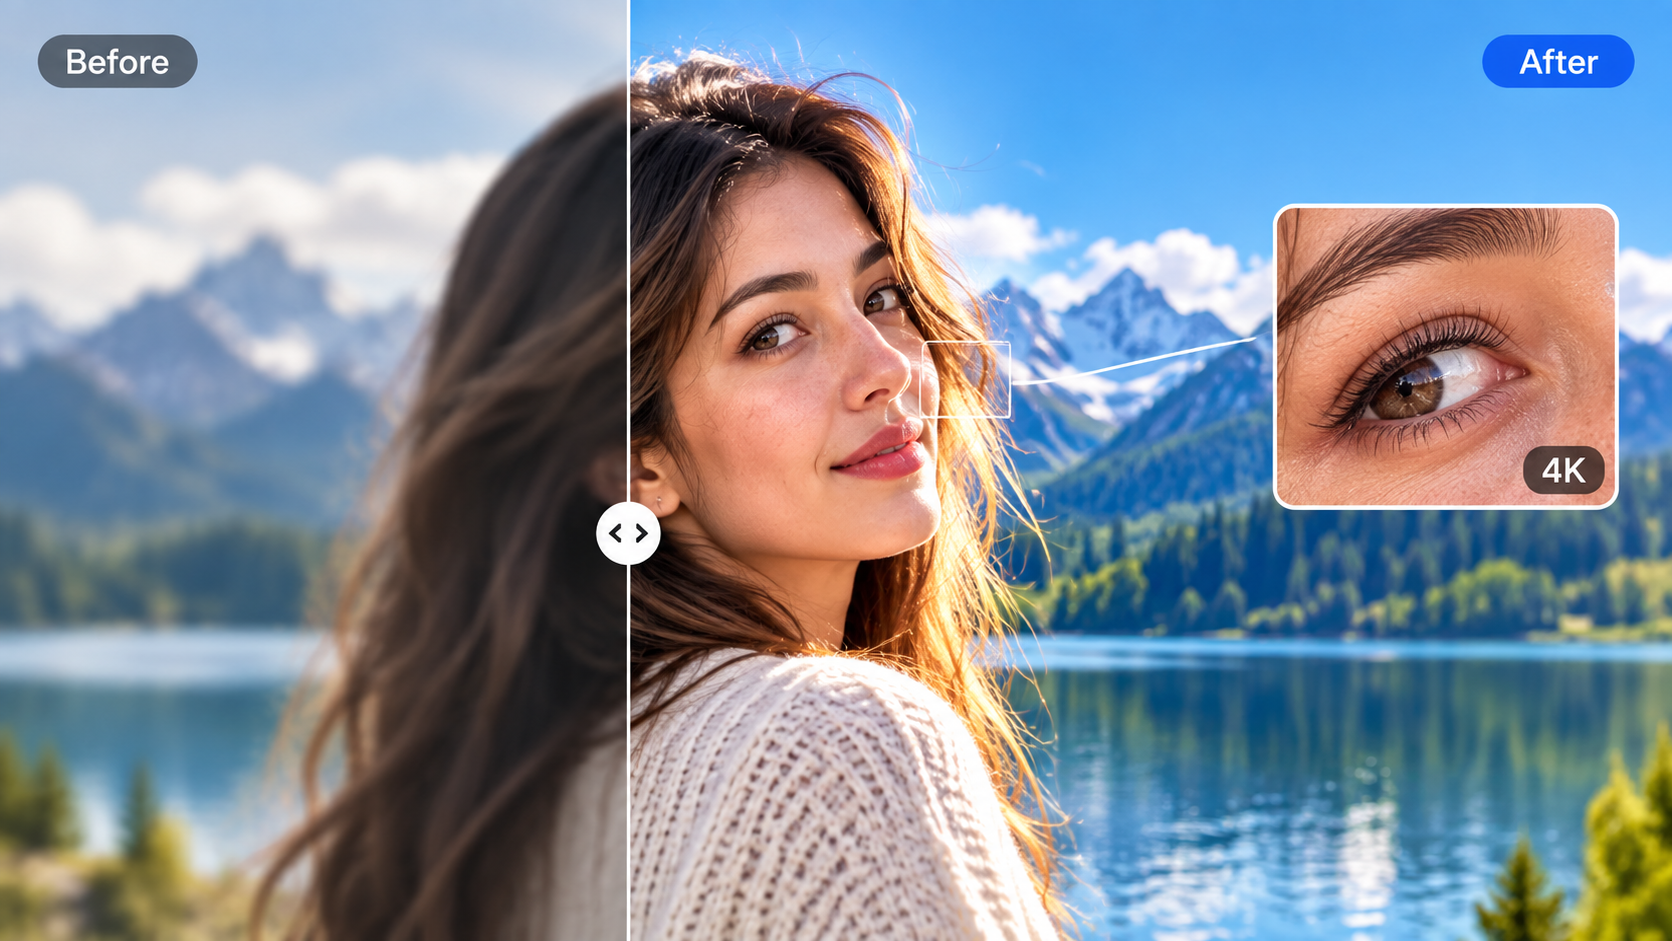
Kling VIDEO 3.0 geeft makers meer ruimte om elke scène te ontwikkelen, met flexibele generaties van 3–15 seconden voor interacties tussen personages, verhalen met meerdere shots, dialogen en overgangen. In ondersteunde workflows behoudt uitvoer tot 4K fijnere details, texturen en de algehele visuele helderheid, waardoor makers kunnen doorgroeien van vroege concepten naar gepolijste content voor reclame, productpresentaties, filmische storytelling en meer.
Het einde
De tekst-naar-video-modellen die je tijd waard zijn, doen meer dan een prompt animeren: ze volgen je intentie, bewegen natuurlijk, komen met geluid en houden een onderwerp stabiel over verschillende shots. Afgezet tegen die criteria bundelt Kling VIDEO 3.0 promptgestuurde generatie, Multi-Shot-besturing, onderwerpconsistentie en native audio op één plek. Open Kling, schrijf je scène en zie hoe die tot leven komt in één enkele generatie.
Veelgestelde vragen
Hoe kies ik tussen de beste tekst-naar-video-AI-modellen in 2026?
Begin met het type video dat je wilt maken en vergelijk vervolgens modellen die bij die taak passen. Multi-shot-verhalen leggen meer nadruk op camerabediening en karakterconsistentie. Dialoogrijke scènes vragen om sterke audio, lipsynchronisatie en overtuigende personagevertolking, terwijl product- en advertentiewerk meer afhankelijk is van naleving van prompts, onderwerpstabiliteit en uitvoerkwaliteit. Lengte en resolutie zijn ook belangrijk, omdat een snelle test en een afgewerkt stuk zelden dezelfde vereisten hebben. Kling VIDEO 3.0 combineert Multi-Shot, Native Audio, naleving van prompts en generatie tot 15 seconden voor multi-shot-verhalen, dialooggestuurde scènes en projecten waarbij hetzelfde personage of product herkenbaar moet blijven tussen verschillende shots.
Kan AI-tekst-naar-video geluid bevatten?
Ja. Kling VIDEO 3.0 kan dialoog, omgevingsgeluid en effecten samen met de video genereren, zodat je het audiobestand niet achteraf hoeft toe te voegen. Je kunt de zinnen rechtstreeks in de prompt schrijven, ze aan specifieke personages toewijzen en de taal, het dialect of het accent kiezen. De text-to-speech-functie kan die zinnen omzetten in stemgeluid voor personages in het Chinees, Engels, Japans, Koreaans en Spaans. Dat betekent minder afzonderlijk voice-overwerk en minder audiomontage nadat de video is gegenereerd.
Hoe lang kan een gegenereerde video zijn?
De videolengte varieert per model. Kling VIDEO 3.0 ondersteunt flexibele generaties van 3 tot 15 seconden. Kortere clips werken goed voor snelle acties en social content, terwijl langere clips meer tijd laten voor opbouw, dialoog en storytelling met meerdere shots. Voor afgewerkte video’s die fijnere visuele details nodig hebben, bieden ondersteunde modi ook uitvoer tot 4K, waardoor producttexturen, personagedetails en scenediepte meer helderheid krijgen.
Heb ik videobewerkingsvaardigheden nodig?
Als je na de generatie wijzigingen wilt aanbrengen, laat de VIDEO 3.0 Omni-bewerkingsworkflow van Kling je bestaande beelden aanpassen met instructies in natuurlijke taal, waaronder achtergronden wijzigen, onderwerpen, stijl of kadrering.