Modele tekst-do-wideo mogą zamieniać opis sceny na wideo z ruchem kamery, dźwiękiem i wieloma ujęciami. Problem w tym, że gotowy klip nadal może odbiegać od promptu, poruszać się niezgrabnie lub pozwalać, by postać albo produkt zmieniały się między ujęciami. W tym artykule przyglądamy się, dlaczego te różnice mają znaczenie, na co zwrócić uwagę przed wyborem modelu oraz jak Kling VIDEO 3.0 radzi sobie z kontrolą ujęć, ruchem, dźwiękiem i spójnością wizualną.
Czym są modele tekst-do-wideo?
Modele tekst-do-wideo wykorzystują generatywną sztuczną inteligencję do zamiany opisów w języku naturalnym na wideo. Prompt może określać temat, scenerię, akcję, ruch kamery i styl wizualny. Jeśli model obsługuje dźwięk, może również zawierać dialogi, dźwięki otoczenia i inne wskazówki audio.
Modele tekst-do-wideo i generatory AI tekst-do-wideo często są traktowane jako to samo, lecz pełnią różne role:
Model tekst-do-wideo | Generator AI tekst-do-wideo | |
Czym jest | System AI, który interpretuje prompt i generuje wideo | Produkt lub interfejs, z którego ludzie korzystają, aby uzyskać dostęp do generowania tekst-do-wideo |
Co obsługuje | Interpretacja promptu, generowanie scen, ruch i ciągłość w czasie | Funkcje zbudowane wokół modelu, takie jak kontrola ujęć, wejścia referencyjne, audio, czas trwania, proporcje obrazu, edycja i eksport |
Dlaczego to ma znaczenie | Model bezpośrednio wpływa na jakość wideo, ruch i spójność wizualną | Generator wpływa na to, jaką masz kontrolę kreatywną oraz co możesz zrobić z wideo później |
Model określa, co zostaje wygenerowane, natomiast AI video generator określa, w jaki sposób uzyskujesz dostęp do tych możliwości, kontrolujesz proces i pracujesz z gotowym wideo.
Jak działają modele tekst-do-wideo?
Modele tekst-do-wideo zamieniają tekstową podpowiedź w sekwencję ruchomych obrazów. Dokładny proces różni się w zależności od modelu, ale zazwyczaj obejmuje zrozumienie podpowiedzi, zbudowanie skompresowanej reprezentacji sceny, określenie, jak rzeczy zmieniają się w czasie, oraz utrzymanie spójności wyniku z chwili na chwilę.
1. Zinterpretuj polecenie
Model text-to-video AI zaczyna od identyfikacji głównych instrukcji w prompcie, w tym:
- temat
- działanie
- sceneria
- styl wizualny
- kierunek kamery
- dialog lub inne wskazówki dźwiękowe, gdy są obsługiwane
| polecenie: “Rowerzysta jedzie przez deszczową ulicę w centrum miasta, podczas gdy kamera podąża za nim od tyłu.” |
Ten krótki opis zawiera kilka instrukcji, które muszą ze sobą współdziałać. Rowerzysta jedzie do przodu, kamera podąża z tyłu, a deszcz, ulica, oświetlenie i otoczenie muszą być spójne w tym samym ujęciu.
Innymi słowy, polecenie opisuje więcej niż tylko to, co powinno znaleźć się na ekranie. Ustanawia również relacje między bohaterem, ruchem, kamerą i otoczeniem.
2. Zbuduj skompresowaną reprezentację wideo
Po odczytaniu promptu system potrzebuje użytecznej reprezentacji sceny, zanim stanie się ona gotowym materiałem filmowym. Dokładna metoda zależy od architektury modelu.
Wiele modeli text-to-video opartych na dyfuzji działa w skompresowanej przestrzeni reprezentacji, zamiast od razu przetwarzać klatki w pełnej rozdzielczości. Zaczynają od szumu i stopniowo kształtują go zgodnie z promptem, wydobywając na wierzch temat, scenerię, oświetlenie, kompozycję i inne szczegóły wizualne. Praca w tej skompresowanej przestrzeni zmniejsza ilość danych przetwarzanych podczas generacji, a gdy scena nabierze kształtu, wynik jest dekodowany na widoczne klatki wideo.
3. Generowanie ruchu i interakcji
Wideo musi pokazywać, co dzieje się z chwili na chwilę. Model musi obsługiwać ruch, interakcje obiektów i zmiany punktu widzenia, nie zaburzając sceny.
- Ruch: Postać obracająca się, idąca lub sięgająca powinna zmieniać pozę i pozycję krok po kroku, zamiast przeskakiwać z jednego stanu do drugiego.
- Interakcja z obiektem: Działania muszą mieć wyraźną kolejność. Jeśli ktoś podnosi kubek, dłoń musi najpierw do niego sięgnąć i nawiązać kontakt, zanim kubek się poruszy.
- Kamera i przestrzeń: Panoramy, pochylenia, najazdy i ujęcia śledzące zmieniają punkt widzenia, ale temat i otoczenie wciąż muszą pozostać zakotwiczone w tej samej przestrzeni.
Statyczny obraz musi opisać tylko jedną chwilę. Wideo musi uwzględniać to, co dzieje się pomiędzy chwilami.
4. Zachowuj spójność czasową i audiowizualną
W miarę jak wideo się rozwija, ludzie, obiekty i dźwięk muszą pozostawać spójne w czasie. Sprowadza się to głównie do dwóch rodzajów spójności:
- Spójność czasowa: Postacie, produkty, stroje, rekwizyty, oświetlenie i tła nie powinny zmieniać się bez wyraźnego powodu z chwili na chwilę. Nawet po cięciu ze zbliżenia na szeroki plan lub po zmianie kąta kamery ta sama osoba lub produkt powinny nadal być łatwe do rozpoznania.
- Spójność audiowizualna: Dialog, ruch warg, mimika, dźwięki otoczenia i działania na ekranie muszą następować we właściwym momencie. Gdy postać mówi, ruch ust powinien odpowiadać dialogowi, a kroki lub odgłosy uderzeń powinny zgrywać się z odpowiednimi działaniami.
Do czego możesz wykorzystać Text-to-Video AI?
Text-to-video AI sprawdza się w sytuacjach, gdy pomysł trzeba zobaczyć, zanim warto będzie go produkować na pełną skalę. Może pomóc we wczesnych testach kreatywnych, w scenach trudnych do sfilmowania oraz w projektach, które przed startem produkcji wymagają kilku kierunków wizualnych.
Twórz filmy na media społecznościowe
Treści w mediach społecznościowych mają krótki okres żywotności, więc organizowanie nowego planu zdjęciowego do każdego posta lub koncepcji kampanii rzadko ma sens. Jedno polecenie może wygenerować klipy do teaserów, ogłoszeń, postów kampanijnych lub krótkich filmów fabularnych, bez konieczności każdorazowego odtwarzania całej produkcyjnej scenografii. Twórcy mogą też wypróbować różne ustawienia, ruchy kamery i kierunki wizualne, zanim zdecydują się na ostateczną wersję.
Przekształcaj pomysły na produkty w filmy marketingowe
Tekst i statyczne makiety nie zawsze pokazują, jak produkt będzie wyglądał, gdy będzie poruszał się w scenie. Sztuczna inteligencja typu text-to-video pozwala marketerom umieszczać ten sam produkt w różnych środowiskach, eksplorować koncepcje reklamowe i testować wizualne opracowania na wcześniejszym etapie procesu. Jeśli produkt pojawia się w kilku ujęciach, rezultaty pokazują również, jak dobrze jego kształt, kolor i kluczowe detale wypadają z jednego ujęcia na kolejne.
Twórz krótkie sceny narracyjne
Krótka opowieść staje się trudniejsza do zaplanowania, gdy obejmuje kilka ujęć, działania bohaterów, zmiany kamer i dialogu. AI tekst-do-wideo potrafi odwzorować te elementy w sekwencję, co ułatwia testowanie kolejności ujęć, tempa i synchronizacji dialogu, zanim każda scena zostanie zbudowana osobno. Jest to szczególnie pomocne w krótkich formach filmowych, w których opowieść opiera się na czymś więcej niż jednym ciągłym ujęciu.
Wizualizuj koncepcje i storyboardy
Treatment lub storyboard może wyjaśnić, co powinno się wydarzyć, ale na statycznej stronie trudniej ocenić wyczucie czasu i ruch kamery. Przekucie pomysłu w ruch daje reżyserom, projektantom i zespołom kreatywnym coś bliższego finalnemu doświadczeniu widza. Mogą porównywać kadrowanie, testować przejścia i wychwytywać słabsze momenty, gdy wprowadzanie zmian jest wciąż łatwe.
Twórz filmy edukacyjne i wyjaśniające
Niektóre tematy są trudne do uchwycenia kamerą, ponieważ są kosztowne, abstrakcyjne, niedostępne lub niemożliwe do zainscenizowania. Sztuczna inteligencja typu text-to-video może zilustrować proces, odtworzyć scenerię lub pokazać wydarzenie, którego nie da się sfilmować bezpośrednio. W przypadku materiałów wyjaśniających, szkoleniowych i klasowych ruch może ułatwić zrozumienie pojęcia, gdy nieruchomy obraz nie pokazuje wystarczająco wiele.
Jak wybrać najlepszy model AI typu text-to-video dla swojego projektu?
Żaden pojedynczy model AI typu text-to-video nie jest odpowiedni dla każdego projektu. Zacznij od tego, co chcesz stworzyć, a następnie zdecyduj, które możliwości są najważniejsze dla danego zadania. Główne elementy porównania to zgodność z promptem, ruch i wiarygodność fizyczna, spójność, kontrola twórcza, dźwięk oraz ograniczenia dotyczące wyniku i przepływu pracy.
Zgodność z promptem
Najpierw sprawdź, czy model faktycznie podąża za poleceniem. Temat, działanie, sceneria, styl wizualny i kierunek kamery powinny pojawiać się razem, a nie tylko w najbardziej oczywistych szczegółach. Jeśli poprosisz o rowerzystę jadącego w deszczu, gdy kamera podąża za nim od tyłu, postać, pogoda, ruch i punkt widzenia powinny być obecne. To, co model pomija, może powiedzieć ci tyle samo, co to, jak dopracowany wygląda materiał.
Ruch i wiarygodność fizyczna
Akcje powinny przebiegać w klarownej kolejności. Chodzenie, obracanie się, sięganie, kolizje i ruch kamery powinny przechodzić z jednego stanu do kolejnego bez nagłych przeskoków. Liczy się też interakcja fizyczna: dłoń powinna nawiązać kontakt, zanim obiekt się poruszy, lądowanie powinno wpływać na ciało, a włosy, tkaniny, woda czy luźne przedmioty powinny reagować na pobliski ruch zamiast zachowywać się niezależnie.
Spójność postaci i produktu
Ten sam obiekt powinien pozostać rozpoznawalny, gdy zmienia się kadr, kąt lub odległość. Twarze, ubrania, kształt produktu, kolor, rekwizyty, oświetlenie i inne definiujące szczegóły nie powinny bez powodu się zmieniać. Sceny z wieloma ujęciami utrudniają to zadanie, dlatego projekty oparte na powracających postaciach lub produktach powinny być również sprawdzane pod kątem obrazów referencyjnych, odniesień do obiektu lub innego sposobu przeniesienia tożsamości wizualnej z ujęcia na ujęcie.
Kontrola kreatywna i pracy kamery
Kiedy scena ma już wyraźny kierunek wizualny, kontrola ma znaczenie. Kadrowanie, ruch kamery, kolejność ujęć, materiały referencyjne, proporcje kadru i struktura wieloujęciowa wpływają na to, jak blisko rezultat odpowiada pierwotnemu zamysłowi. Dokładniejsza kontrola oznacza też, że rzadziej będziesz musieć uruchamiać całą sekwencję ponownie tylko po to, aby zmienić kąt, przestawić ujęcie lub poprawić kompozycję.
Obsługa dźwięku
Możliwości audio różnią się znacznie między modelami. Niektóre generują wyłącznie obraz, podczas gdy inne potrafią tworzyć dialog, dźwięki tła i efekty wraz z materiałem filmowym. W scenach z dużą liczbą dialogów sprawdź, czy głos, ruch ust, mimika i synchronizacja czasowa pozostają spójne. Kroki, uderzenia i dźwięki otoczenia powinny również wypadać razem z odpowiadającymi im zdarzeniami.
Czas trwania, rozdzielczość i przepływ pracy
Zwróć uwagę na ograniczenia, które wpływają na finalne wideo, w tym długość generacji, obsługiwane proporcje obrazu, dostępne rozdzielczości i opcje eksportu. Krótki klip do mediów społecznościowych i scena produktowa składająca się z wielu ujęć mogą mieć bardzo odmienne wymagania dotyczące wynikowego materiału.
To, co dzieje się po wygenerowaniu, jest równie ważne. Czy możesz wydłużyć klip, ponownie użyć tego samego obiektu, poprawić jedno ujęcie, ponownie wygenerować dźwięk lub kontynuować edycję bez zaczynania od nowa? Drobne zmiany nie powinny zmuszać cię do odbudowy całej sekwencji.
Różne projekty wymagają różnych priorytetów. Zacznij od określenia typu wideo, które tworzysz, a następnie skup się na najważniejszych możliwościach:
Jeśli chcesz stworzyć | Nadaj priorytet | Dlaczego to ważne |
Krótkie filmy do mediów społecznościowych | Zgodność z promptem, proporcje obrazu, przepływ pracy | Treści w mediach społecznościowych zmieniają się szybko, więc rezultat musi pozostać blisko pomysłu, wpisywać się w typowe formaty platform i być łatwy do poprawy. |
Filmy produktowe i marketingowe | Spójność produktu, zgodność z poleceniem, rozdzielczość | Kształt, kolor, branding i kluczowe szczegóły produktu muszą pozostać stabilne we wszystkich ujęciach, aby końcowy materiał nadal spełniał potrzeby kampanii lub prezentacji. |
Krótkie sceny narracyjne lub filmowe | Ruch i fizyczna wiarygodność, kontrola kamery, spójność między ujęciami | Działania postaci, zmiany kamery i przejścia między scenami muszą łączyć się w całej sekwencji bez oczywistego wizualnego dryfu. |
Filmy oparte na dialogu | Obsługa dźwięku, synchronizacja ust, spójność postaci | Dialog, ruch ust, ekspresja twarzy i tożsamość postaci muszą pozostawać spójne, a dźwięk powinien pojawiać się we właściwym momencie. |
Podglądy koncepcji i storyboardy | Kontrola kreatywna i kamerowa, wejścia referencyjne, elastyczność poprawek | Celem jest wczesne przetestowanie kadrowania, prowadzenia kamery, tempa oraz alternatywnych pomysłów, gdy zmiany wciąż są łatwe do wprowadzenia. |
Filmy edukacyjne i objaśniające | Zgodność z poleceniem, ruch i fizyczna wiarygodność, przepływ pracy | Materiał wizualny musi dokładnie wyjaśniać proces lub ideę, zapewniać łatwe do śledzenia ruchy oraz umożliwiać wprowadzanie poprawek, gdy treść się zmienia. |
Co możesz zrobić z Kling VIDEO 3.0?
Trudność w generowaniu wideo na podstawie tekstu polega nie na uzyskaniu pojedynczego, dobrze wyglądającego ujęcia, lecz na tym, by podmiot, akcja, prowadzenie kamery, dźwięk i drobne detale wizualne z polecenia pojawiły się dokładnie tak, jak zamierzałeś. W miarę jak polecenia stają się bardziej szczegółowe, a sceny zyskują kolejne ujęcia, model musi śledzić coraz więcej elementów z chwili na chwilę.
Kling VIDEO 3.0 został stworzony wokół tych potrzeb, z lepszą interpretacją promptów, wielo-ujęciowym opowiadaniem historii, spójnością bohaterów, natywnym dźwiękiem, elastycznym czasem trwania i renderowaniem tekstu. Zamiast pisać opis i po prostu czekać, co wróci, możesz kształtować, jak rozwija się historia, kiedy zmienia się ujęcie kamery, jak bohaterowie przenoszą się pomiędzy kadrami oraz gdzie dźwięk pojawia się w scenie.
Jeszcze dokładniejsze rozumienie i wykonywanie promptów
Kling VIDEO 3.0 potrafi interpretować warstwowe prompty łączące obiekty, działania, scenerie, prowadzenie kamery i strukturę narracyjną. Dzięki temu złożone prompty text-to-video pozostają bliższe zamierzonej scenie, zwłaszcza gdy obejmują wiele działań, zaplanowane ruchy kamery lub określoną sekwencję zdarzeń.
Zachowuj spójność bohaterów i produktów w kolejnych ujęciach
Postać może w jednym ujęciu wyglądać poprawnie, a mimo to zauważalnie się zmieniać pod innym kątem. W materiale wideo z wieloma ujęciami twarze mogą się przesuwać, detale ubioru mogą się rozjeżdżać, a kolor, kształt lub cechy charakterystyczne produktu mogą się zmieniać między ujęciami.
W obsługiwanych przepływach pracy VIDEO 3.0 wspomaganych obrazami referencyjnymi możesz wykorzystać wiele obrazów referencyjnych, aby zapewnić dodatkowe wskazówki wizualne i pomóc zakotwiczyć powracającą postać, produkt lub inny kluczowy obiekt mimo zmian kadrowania, kąta i otoczenia. Te odniesienia dostarczają modelowi więcej informacji o wyglądzie obiektu i kluczowych detalach wizualnych, co pomaga ograniczyć wyraźne dryfowanie wizualne w scenach z powracającymi postaciami, ujęciach produktowych i treściach markowych.

Twórz wieloujęciowe historie z większą kontrolą nad tempem
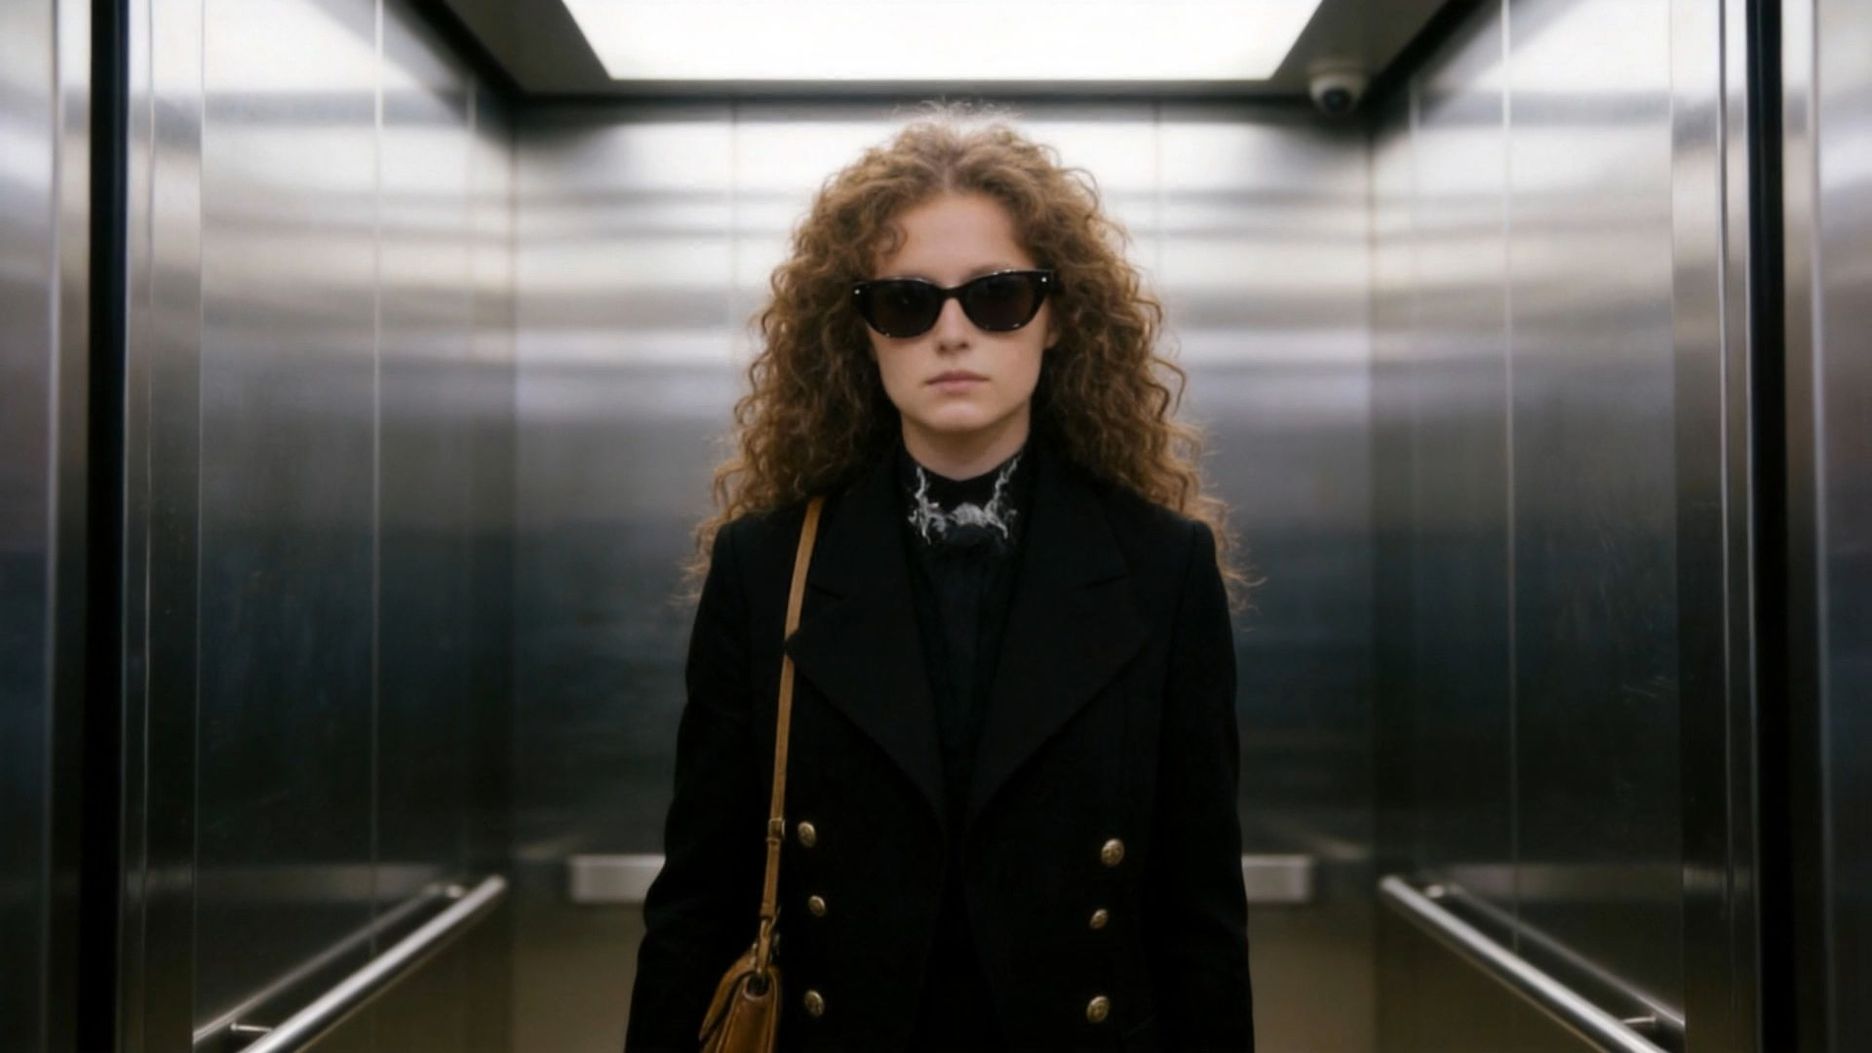
Pojedyncze ujęcie jest zazwyczaj łatwe do opanowania. Wyzwanie zaczyna się, gdy historia wymaga zbliżeń, szerokich kadrów, różnych ustawień kamery oraz zmian scen. Generowanie każdego ujęcia oddzielnie oznacza więcej montażu później i utrudnia utrzymanie tempa oraz ciągłości w całej sekwencji.
Funkcja Multi-Shot rozwiązania Kling VIDEO 3.0 potrafi obsłużyć kilka ujęć w jednej generacji, zamieniając pojedynczy prompt w spójną sekwencję zamiast zestawu odizolowanych klipów. W przypadku zaplanowanej sekwencji funkcja Custom Multi-Shot pozwala zdefiniować treść, kolejność i długość poszczególnych ujęć, dzięki czemu cięcia i tempo są ustalone, zanim rozpocznie się generowanie.
Generuj dialog i dźwięk sceny jednocześnie
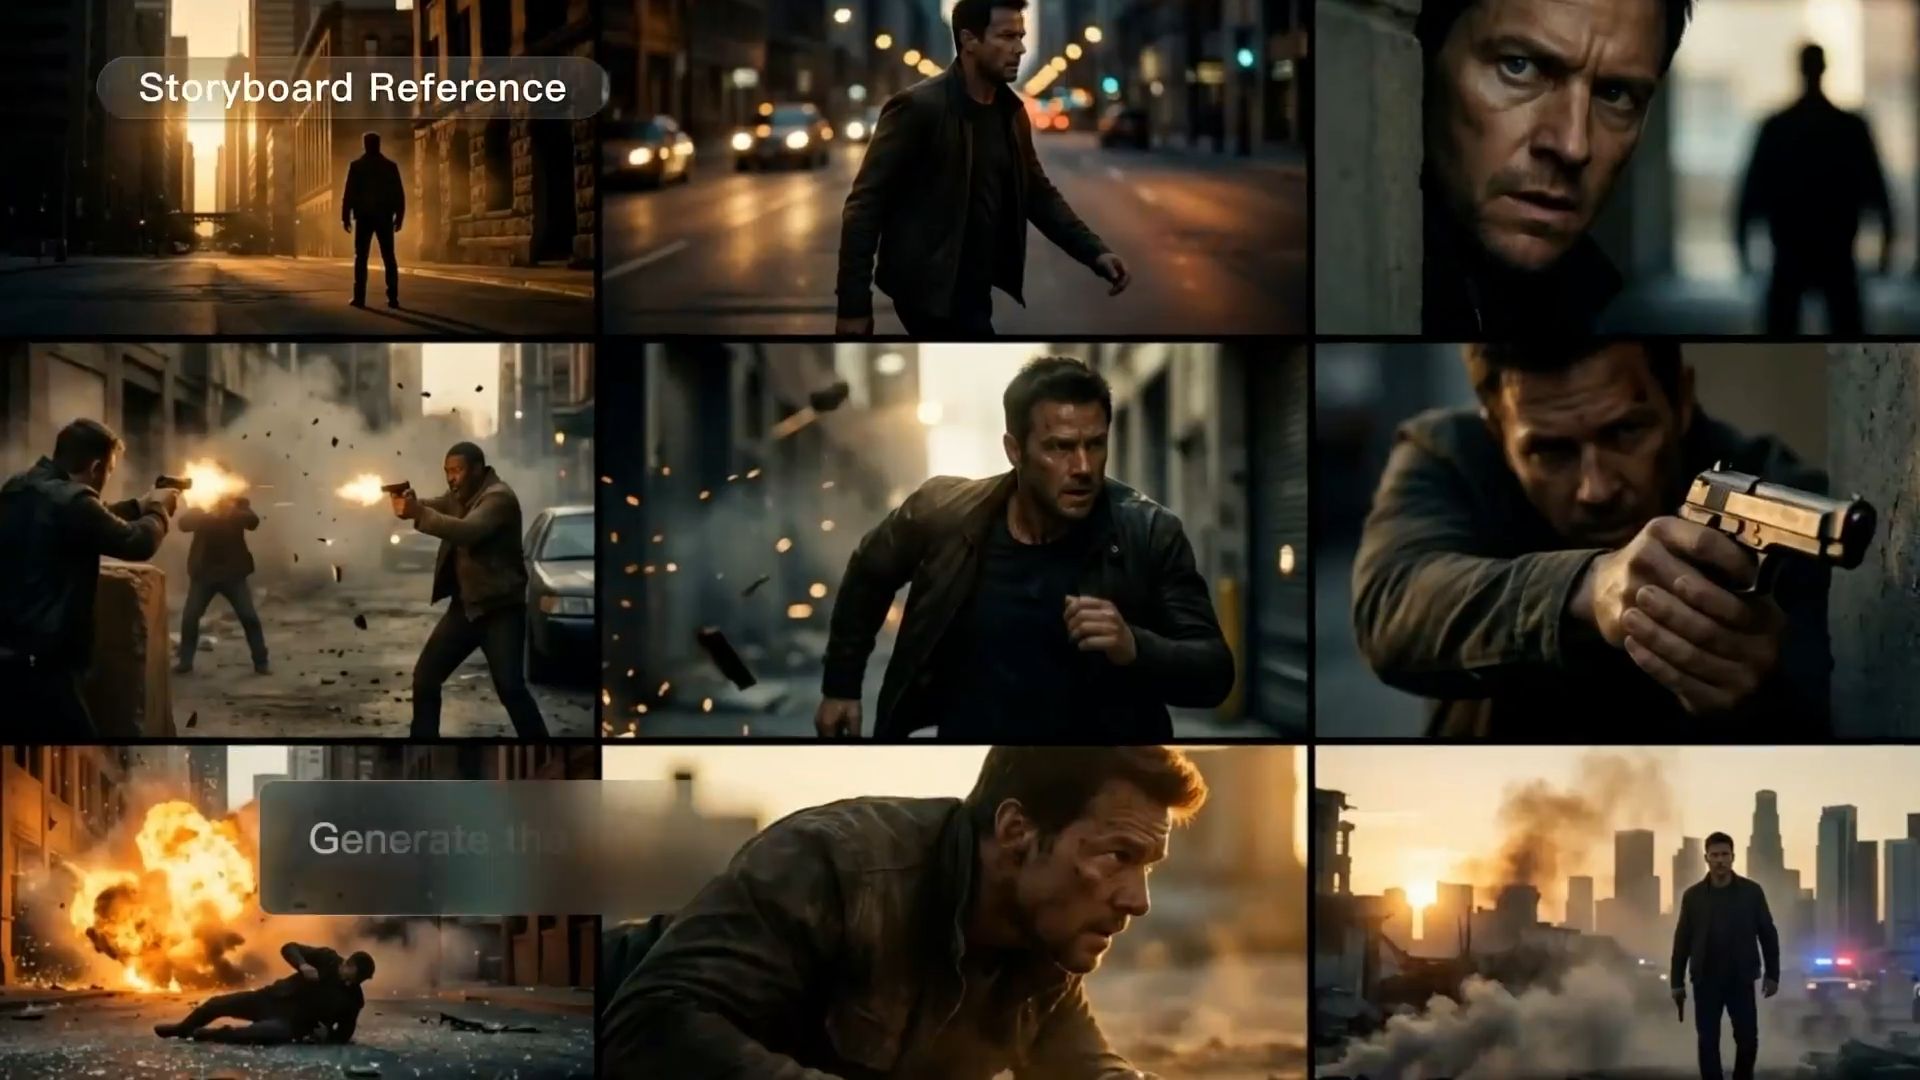
Gdy model wideo generuje wyłącznie obraz, sceny dialogowe wymagają dodatkowej pracy. Głosy, dźwięki tła, efekty i synchronizacja muszą zostać dodane później. Jeśli dodasz kilku bohaterów, musisz też pilnować, kto wypowiada każdą kwestię i czy dźwięk zgrywa się z odpowiednią akcją na ekranie.
Funkcja Native Audio w Kling VIDEO 3.0 generuje dialog, dźwięki otoczenia oraz inne elementy audio razem z wideo. W scenach z wieloma postaciami możesz przypisywać kwestie różnym rozmówcom, korzystając ze wsparcia dla języków chińskiego, angielskiego, japońskiego, koreańskiego i hiszpańskiego, a także obsługiwanych dialektów i akcentów. Mowa, gra postaci oraz dźwięk sceny są wbudowane w ten sam proces generowania, zamiast być nakładane później na niemy klip.
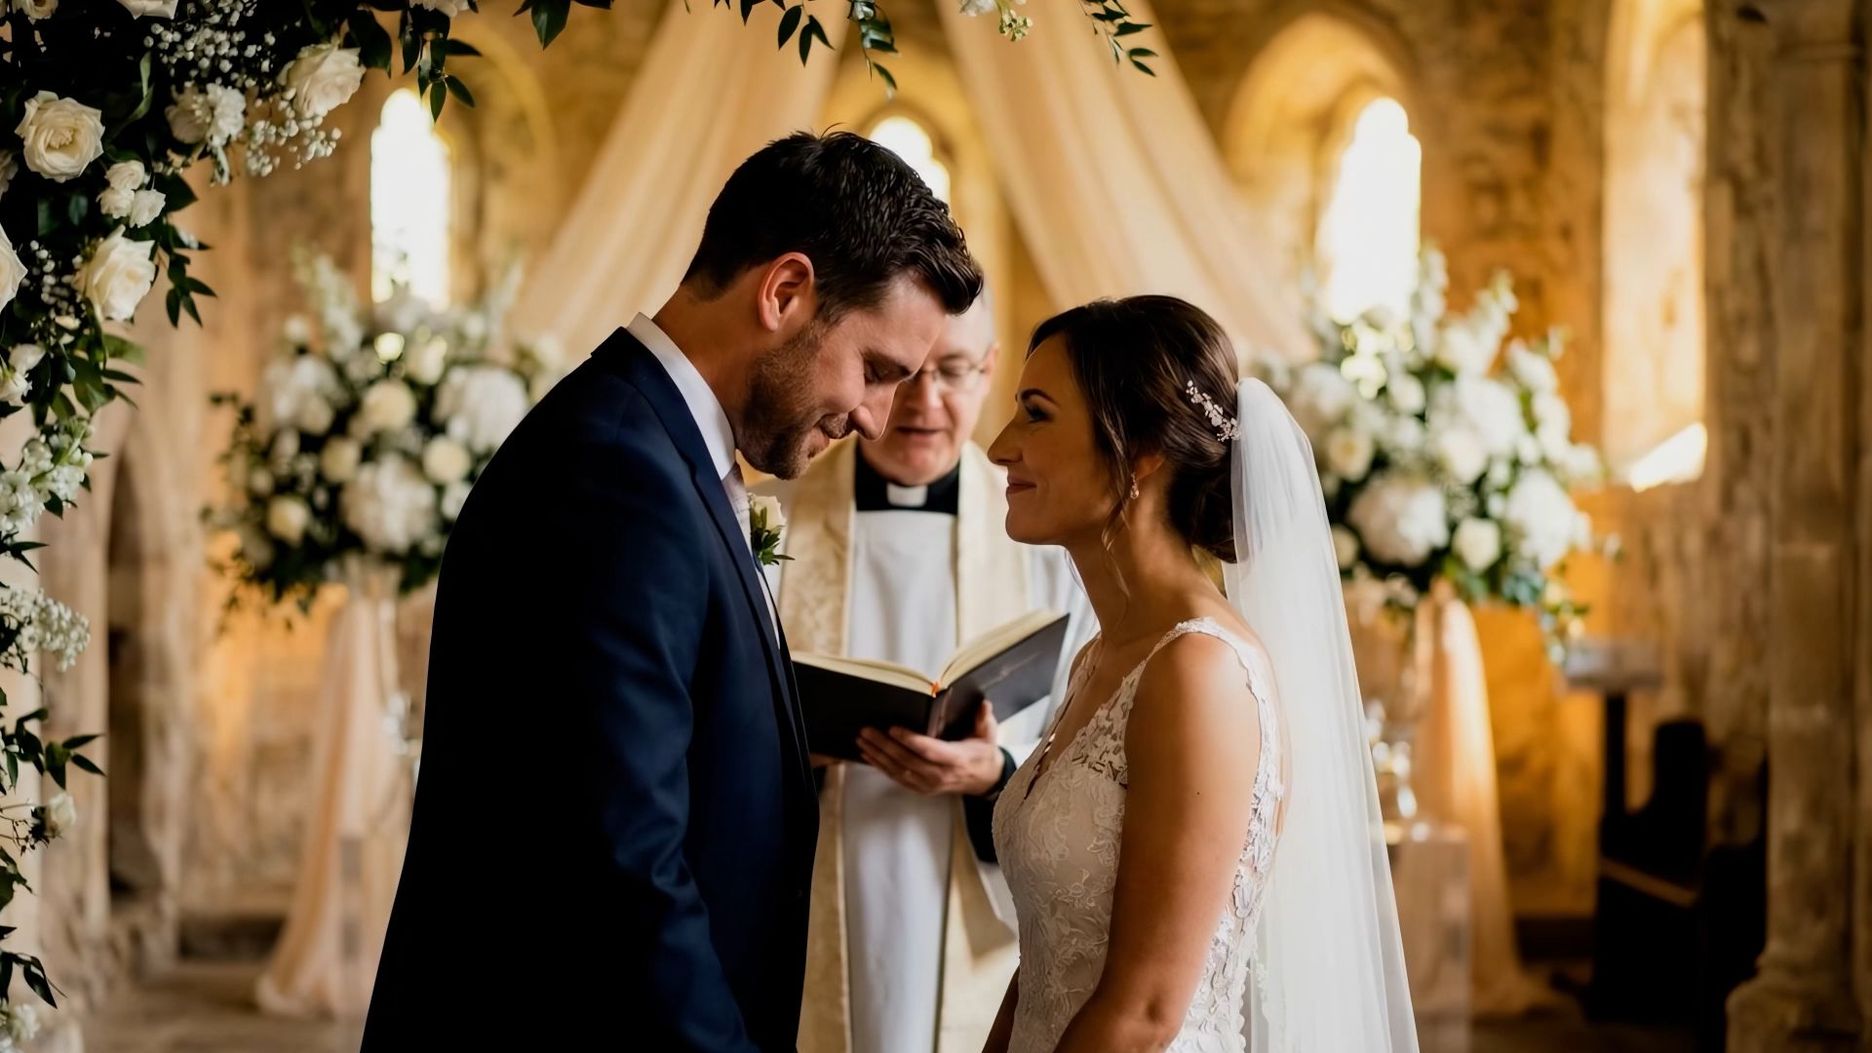
Twórz dłuższe historie z czasem do 15 sekund i wyjściem 4K
Kling VIDEO 3.0 daje twórcom więcej przestrzeni na rozwijanie każdej sceny dzięki elastycznemu generowaniu trwającemu od 3 do 15 sekund dla interakcji postaci, wieloklatkowego opowiadania, dialogów i przejść. W obsługiwanych przepływach pracy wyjście do 4K zachowuje drobniejsze detale, tekstury i ogólną klarowność obrazu, pomagając twórcom przejść od wczesnych koncepcji do dopracowanych materiałów na potrzeby reklam, prezentacji produktów, filmowej narracji i nie tylko.
Koniec
Modele tekst-do-wideo warte twojego czasu robią więcej niż tylko animują prompt: podążają za twoją intencją, poruszają się naturalnie, towarzyszy im dźwięk i utrzymują temat stabilnie pomiędzy ujęciami. W zestawieniu z tymi kryteriami Kling VIDEO 3.0 łączy w jednym miejscu generowanie sterowane promptem, kontrolę Multi-Shot, Subject Consistency i natywny dźwięk. Otwórz Kling, opisz swoją scenę i zobacz, jak ożywa w trakcie pojedynczego generowania.
Najczęściej zadawane pytania
Jak wybrać spośród najlepszych modeli AI tekst-do-wideo w 2026 roku?
Zacznij od rodzaju wideo, które chcesz stworzyć, a następnie porównaj modele pod kątem tego zadania. Narracja Multi-Shot kładzie większy nacisk na kontrolę nad kamerą i spójność postaci. Sceny bogate w dialogi wymagają solidnego dźwięku, synchronizacji ust i gry postaci, podczas gdy praca nad produktami i reklamami bardziej zależy od zgodności z poleceniem, stabilności tematu i jakości wyjściowej. Długość i rozdzielczość też mają znaczenie, ponieważ szybki test i gotowe dzieło rzadko mają te same wymagania. Kling VIDEO 3.0 łączy Multi-Shot, Native Audio, zgodność z poleceniem oraz generowanie do 15 sekund dla opowieści z wieloma ujęciami, scen napędzanych dialogiem i projektów, w których ta sama postać lub produkt musi pozostać rozpoznawalna w kolejnych ujęciach.
Czy AI Text to Video może zawierać dźwięk?
Tak. Kling VIDEO 3.0 może generować dialog, dźwięk otoczenia i efekty razem z wideo, więc nie musisz dodawać dźwięku później. Możesz wpisać kwestie bezpośrednio w prompt, przypisać je do konkretnych postaci i wybrać język, dialekt lub akcent. Jej funkcja text-to-speech może zamienić te kwestie w głosy postaci po chińsku, angielsku, japońsku, koreańsku i hiszpańsku. To oznacza mniej osobnej pracy nad dubbingiem i mniej montażu dźwięku po wygenerowaniu wideo.
Jak długo może trwać wygenerowane wideo?
Długość wideo zależy od modelu. Kling VIDEO 3.0 obsługuje elastyczne generowanie od 3 do 15 sekund. Krótsze klipy sprawdzają się przy szybkich akcjach i treściach społecznościowych, podczas gdy dłuższe dają więcej czasu na budowanie napięcia, dialog i wielokadrowe opowiadanie historii. W przypadku gotowych wideo wymagających bardziej precyzyjnych detali wizualnych obsługiwane tryby oferują także renderowanie do 4K, zapewniając większą klarowność teksturom produktów, detalom postaci i głębi scen.
Czy potrzebuję umiejętności montażu wideo?
Jeśli chcesz wprowadzać zmiany po generowaniu, workflow edycji Kling VIDEO 3.0 Omni pozwala modyfikować istniejące nagrania za pomocą instrukcji w języku naturalnym, w tym zmianę tła, obiektów, stylu lub kadrowania.