Генеративний ШІ вже посів усталене місце у відеовиробництві: моделі генерації відео ШІ використовуються для соціального контенту, реклами, запусків продуктів і короткої розповіді. У міру того як генеративні відеомоделі ШІ стають частиною професійного виробництва, автори порівнюють, як різні моделі ШІ для генерації відео реагують на підказки, референсні матеріали, звук і режисуру кадрів. Цей посібник порівнює 10 відеомоделей ШІ за цими виробничими параметрами, а потім детальніше розглядає, як серія Kling VIDEO 3.0 працює з підказками, референсними активами, багатокадровою режисурою та аудіо в межах одного робочого процесу.
Що таке моделі генерації відео ШІ?
Моделі генерації відео ШІ — це системи, які створюють, редагують або анімують відео на основі тексту, зображень, референсних матеріалів чи наявних записів. Вони працюють у часовому вимірі, а не розглядають кожен кадр окремо, враховуючи зміни в русі об'єктів, освітленні, положенні камери та структурі сцени.
Початкове введення має значення, адже різні моделі створені на основі різних підходів до роботи.
Type | Starting Point | What It Does | Best Suited For |
Written prompt | Builds a scene from a description of the subject, setting, action, framing, or camera movement | Starting from an idea without an existing visual | |
Still image | Adds movement to the subject, environment, or camera while keeping the image as the visual base | Animating a person, product, artwork, or scene with an established look | |
Multimodal and Reference-Based Video | Text, images, video, or multiple references | Uses several inputs to guide appearance, motion, characters, products, or shot structure | Projects that need more continuity or tighter direction across a shot or sequence |
Що відрізняє моделі генерації відео ШІ?
На перший погляд багато моделей відео ШІ здатні виконувати схожі базові завдання. Різницю набагато легше помітити, коли ви дивитеся, як вони дотримуються інструкцій, утримують сцену стабільною, керують кадрами та працюють зі звуком.
Відповідність промпту: Наскільки точно модель виконує інструкції щодо розміщення об'єкта, дії, композиції, темпу та руху камери.
Рух і узгодженість: Чи виглядає рух природно та чи залишаються люди, продукти, одяг або середовище впізнаваними протягом відео.
Рідна аудіодоріжка: Деякі моделі можуть генерувати діалоги, фоновий звук і ефекти разом із відео, тоді як інші потребують окремого аудіоетапу.
Багатоплановість і керування камерою: Деякі моделі зосереджуються на одному короткому кадрі, тоді як інші можуть опрацьовувати зміни кадрів, ракурси, рухи камери та багатопланові послідовності.
Роздільна здатність і тривалість: Моделі відрізняються тим, як довго вони можуть генерувати та яку вихідну роздільну здатність підтримують, що впливає на типи проєктів, для яких вони найбільше підходять.
Які найкращі моделі генерації відео на основі ШІ у 2026 році?
Не існує єдиної моделі, яка була б найкращою для кожного відеопроєкту. Нижче ми порівнюємо 10 актуальних моделей генерації відео на основі ШІ за показниками руху, референсів, звуку, режисури кадру, тривалості та якості результату.
Model | Useful For | Inputs | Reference Consistency | Native Audio | Multi-Shot / Camera Control | Duration / Output | Considerations |
| Multi-shot scenes, recurring characters, multilingual dialogue in five languages, reference-led workflows | Text, images, start/end frames and Elements; Omni accepts broader combinations of reference material | Elements can carry characters, products and other recurring subjects across shots | Yes | Multi-shot generation, custom shot timing, framing, angles and camera movement | Up to 15s; 4K output is available in supported workflows | Projects built around several references, reusable characters or voice-linked Elements are better matched to VIDEO 3.0 Omni. | |
Google Veo 3.1 | Short scenes where picture and sound are generated together | Text, image, video extension, first/last frames and up to three reference images | Reference images and frame inputs can anchor subjects and composition | Yes | First/last-frame input, prompt-led camera direction and video extension | 4, 6 or 8s; 720p, 1080p or 4K depending on the setting | Reference-image, 1080p and 4K generations use an 8-second duration. |
Runway Gen-4.5 | Detailed prompts, timed action and camera-led shots | Text or text plus image | An input image establishes the visual starting point | Audio is handled outside Gen-4.5 generation | Detailed prompt-based camera and action direction | 2–10s; 720p | Gen-4.5 currently outputs at 720p, while other parts of the Runway platform handle additional production tasks. |
Seedance 2.5 | Longer sequences and projects built from several references | Text plus image, video and audio references | Supports large reference sets across subjects, scenes and sound | Yes | Multi-shot structure, shot transitions, camera work and timestamp-level editing | Up to 30s per generation, with extension | Its broader reference set gives teams more material to organize before generation. |
Wan 3.0 | Longer projects drawing on several types of source material | Text, images, video, audio, documents and web pages | Multimodal references can be carried into the same generation | Yes | Long-form sequences, continuous camera movement and multimodal direction | Up to 30s; 1080p | Availability and supported resources can vary by market and access route. |
Luma Ray3.2 | Reworking, restyling or redirecting footage that already exists | Source video, prompt and keyframes | Preserves structure from the source while allowing visual changes | Not a central part of the Ray3.2 workflow | Up to 64 keyframes can anchor specific moments in the source-video timeline | Designed around source-video workflows | Ray3.2 is currently focused primarily on source-video workflows, especially video-to-video generation. |
MiniMax Hailuo 2.3 | Human motion, action and expressive performance | Text and image | Image input can establish the subject before motion is added | Not listed as part of the Hailuo 2.3 model itself | Responds to motion and camera instructions | 6 or 10s; 768p or 1080p depending on mode | Current 1080p options are tied to shorter generations. |
PixVerse V6 | Short narrative pieces, social video and effects-led scenes | Text, image, references, first/last frames and extension workflows | Reference-to-video tools support recurring visual material | Yes | Native multi-shot and camera direction | 1–15s; up to 1080p | The 15-second window suits short formats; longer pieces need more than one generation. |
Vidu Q3 Series | Character-led scenes, dialogue in three languages and short narratives | Text, image, start/end frames and references depending on the Q3 variant | Reference-to-video is available across the Q3 family | Yes | Frame-level camera and pacing controls | Up to 16s; up to 1080p depending on variant | Current native audio-video output lists English, Japanese and Chinese. |
Adobe Firefly Video Model | Brand work and projects that continue through Adobe tools | Text, image and composition-reference workflows | Images or composition references can guide the generated shot | Sound is handled through other parts of the Firefly workflow | Camera, framing and composition settings | 5s; up to 1080p | Adobe’s own video model currently works in five-second generations, with longer projects assembled through a wider workflow. |
*Характеристики відображають публічно задокументовані можливості, доступні на момент написання. Функції, доступ і параметри виведення можуть змінюватися в міру оновлення моделей.
Порівняння також показує, чому ці моделі складно розмістити в єдиному рейтингу. Вони, як правило, підходять для різних типів робіт:
- Багатокадрові та референсно керовані проєкти: Kling VIDEO 3.0 / 3.0 Omni, Seedance 2.5 і Wan 3.0
- Короткі, чітко зрежисовані сцени: Veo 3.1 і Runway Gen-4.5
- Робота з рухом або наявними матеріалами: Hailuo 2.3 для фізичних виступів, а Ray3.2 — для роботи з уже відзнятим матеріалом
- Короткі наративні та авторські проєкти: PixVerse і Vidu
- Виробництво на базі Adobe: Firefly
Найкраща відповідність залежить від матеріалу, з якого ви починаєте, і від того, які завдання має виконувати готове відео.
Як обрати професійну модель генерації відео на базі ШІ?
Почніть із завдання, яке маєте перед собою. Те, що ви створюєте, які матеріали вже доступні та які деталі мають залишитися незмінними, зазвичай розкажуть вам більше, ніж довгий список характеристик моделі.
Consider | Ask | Check For |
Video Type | Is it a product clip, dialogue scene, short narrative, or a revision of existing footage? | A model that matches the length, pacing, and structure of the piece |
Source Material | Are you working from text, an image, several references, or an existing video? | Support for the material you already plan to use |
Continuity | Which details need to stay recognizable from one shot to the next? | Tools for keeping characters, products, locations, clothing, or voices consistent |
Shot Planning | Do you need fixed framing, camera moves, exact timing, or several shots in sequence? | Start and end frames, camera settings, shot timing, or multi-shot options |
Finishing | What still needs to happen after the first clip is generated? | Enough length and resolution, plus the audio and editing options the final piece requires |
Перший результат має значення, але це лише частина роботи. Модель, яка добре працює під час правок, додаткових дублів, озвучення, монтажу та фінальної передачі, може бути кращим вибором, ніж та, що створює лише найбільш ефектний перший ролик.
Як створити відео на ШІ за допомогою Kling VIDEO 3.0?
Коли ви знаєте, що найважливіше для вашого проєкту, можете перетворити ці вибори на робочу конфігурацію. За допомогою серії Kling VIDEO 3.0 ви можете почати з тексту або наявного зображення, встановити початкові та фінальні кадри, зберегти впізнаваність важливих об’єктів за допомогою Elements і додати діалоги, звук або кілька кадрів перед рендерингом кліпу.
Крок 1: Оберіть, як ви хочете почати
Почніть з матеріалу, який уже маєте.
- Текст-у-відео: Опишіть об’єкт, дію, оточення та роботу камери, коли ідея починається словами.
| Prompt: Aerial shot of blue waves pounding against the rocks, creating a vast and magnificent scene. |
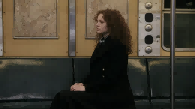
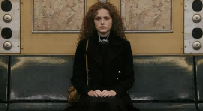
- Зображення-у-відео: Почніть з наявного персонажа або локації, а потім опишіть рух і поведінку камери, які хочете додати. Kling VIDEO 3.0 використовує референси зображень, щоб допомогти зберегти зовнішність об’єкта під час розвитку сцени. VIDEO 3.0 Omni додає прив’язку елементів, що спрощує повторне використання того самого персонажа чи об’єкта в різних сценах і відео. Навіть коли камера зумує, панорамує або нахиляється, ці робочі процеси на основі референсів допомагають підтримувати послідовнішу візуальну айдентику.
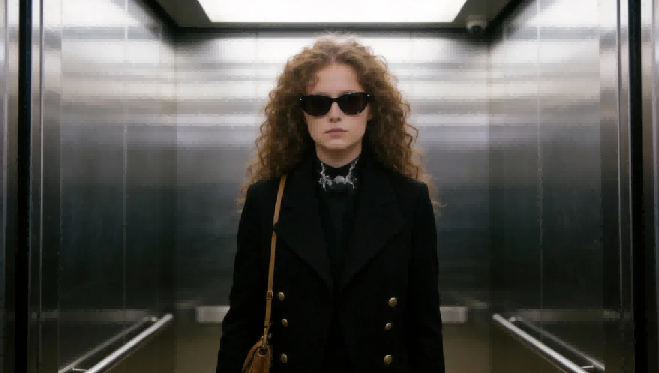
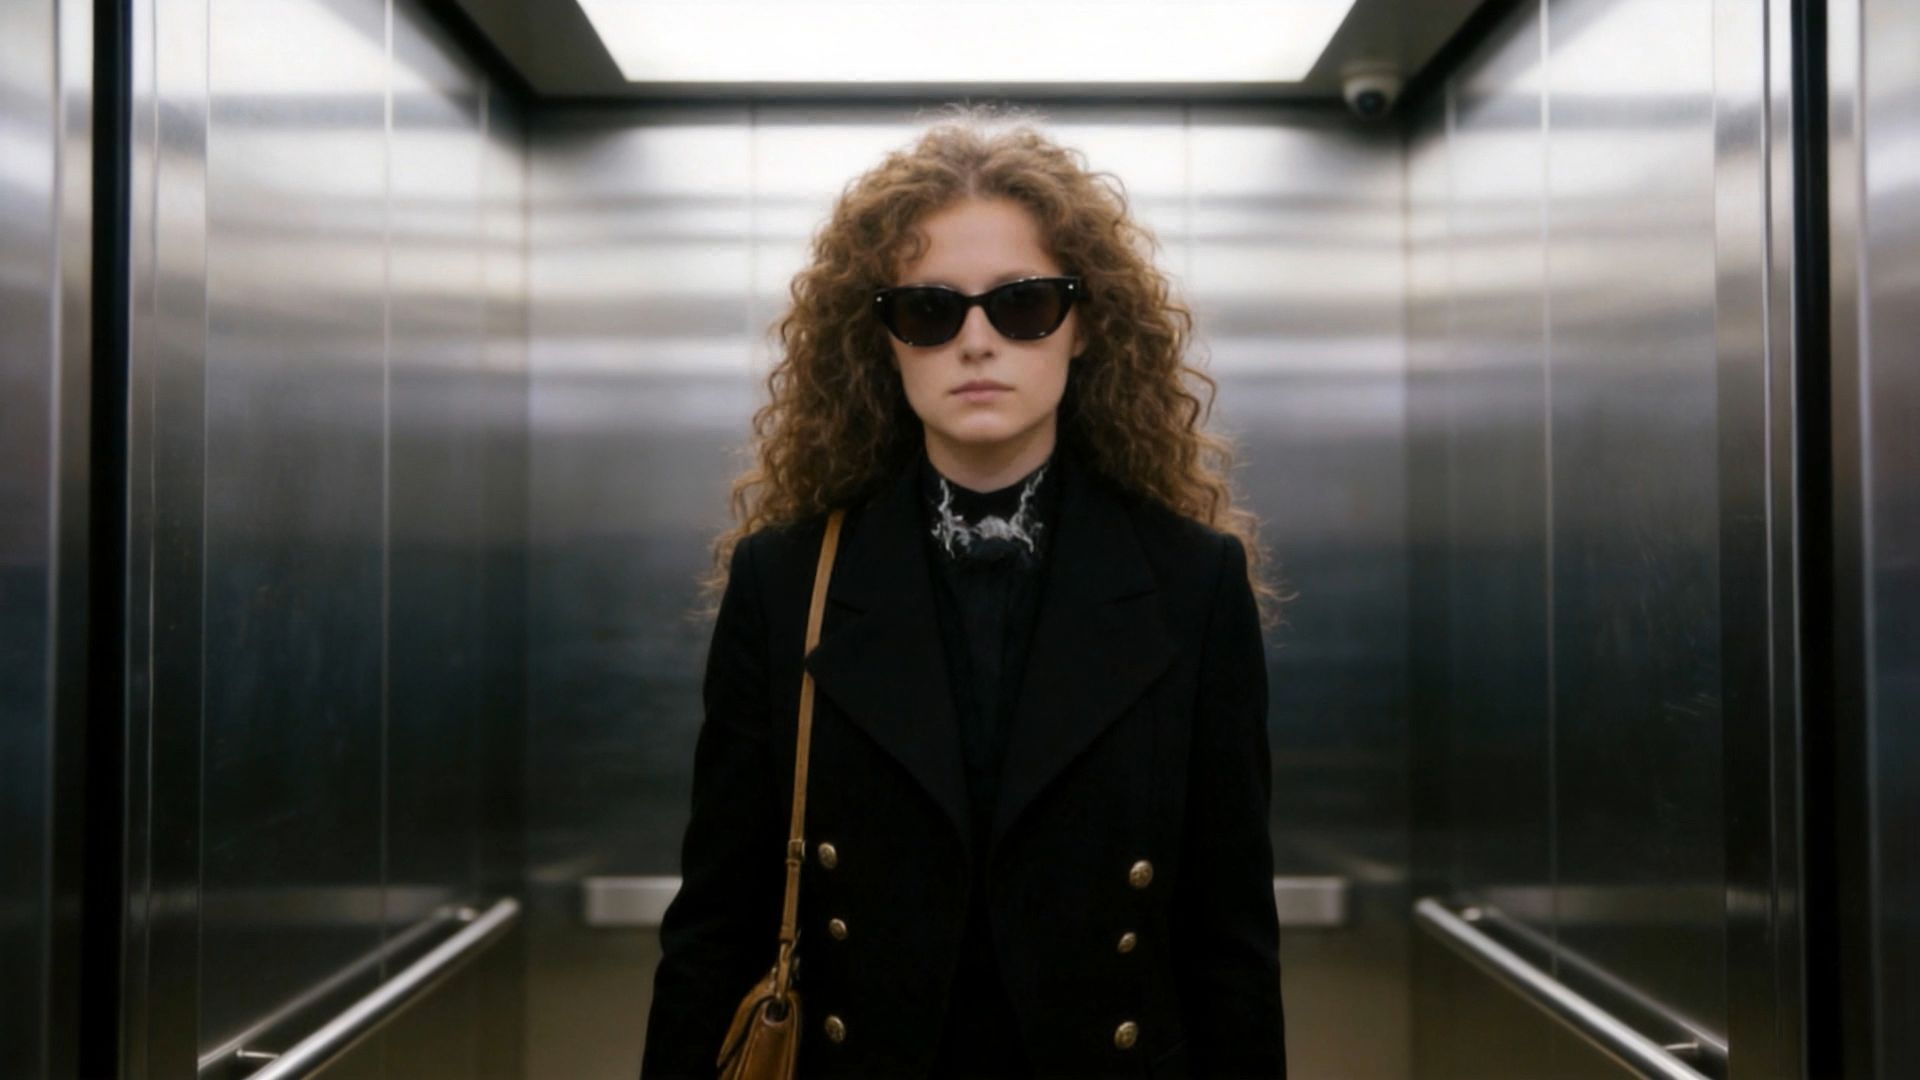
| Prompt: Authentic workplace texture, one continuous long take without any cuts. The camera follows the professional woman steadily in a medium shot throughout, moving in sync with her: the camera tracks her as she walks and freezes instantly when she pauses, with natural and smooth movements and fluid camera work. The woman walks forward out of the elevator, and the elevator doors close slowly and naturally behind her; she steps into the office area, takes off her sunglasses by hand, tucks them into her commuter bag casually, and nods politely to colleagues passing by; she pauses briefly, the camera freezes in sync, she hangs her commuter bag on the coat rack in the office area, then takes off her outer coat and hangs it on the same rack; after hanging up her clothes, she walks forward again, the camera tracks her in sync; a young man in a formal shirt walks towards her, hands her a document and a signature pen, she pauses, the camera freezes in sync, takes them and signs the document; after signing, she walks forward again, the camera tracks her in sync; finally, she walks to her desk, sits down by the chair, reaches out to pick up a cup of tea on the desk, and sips it with her head down, her movements relaxed and natural. | ||
Start Frame | ||
| ||
Character Reference | ||
|  |  |
Video | ||
| ||
Крок 2: Опишіть сцену, діалог і звук.
Коли вихідний матеріал визначено, опишіть, що відбувається в сцені та що має чути аудиторія.
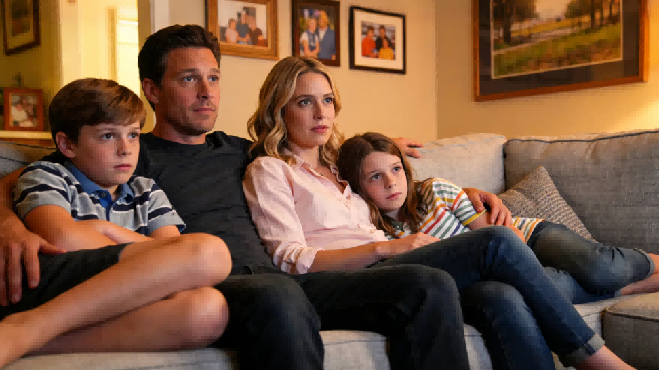
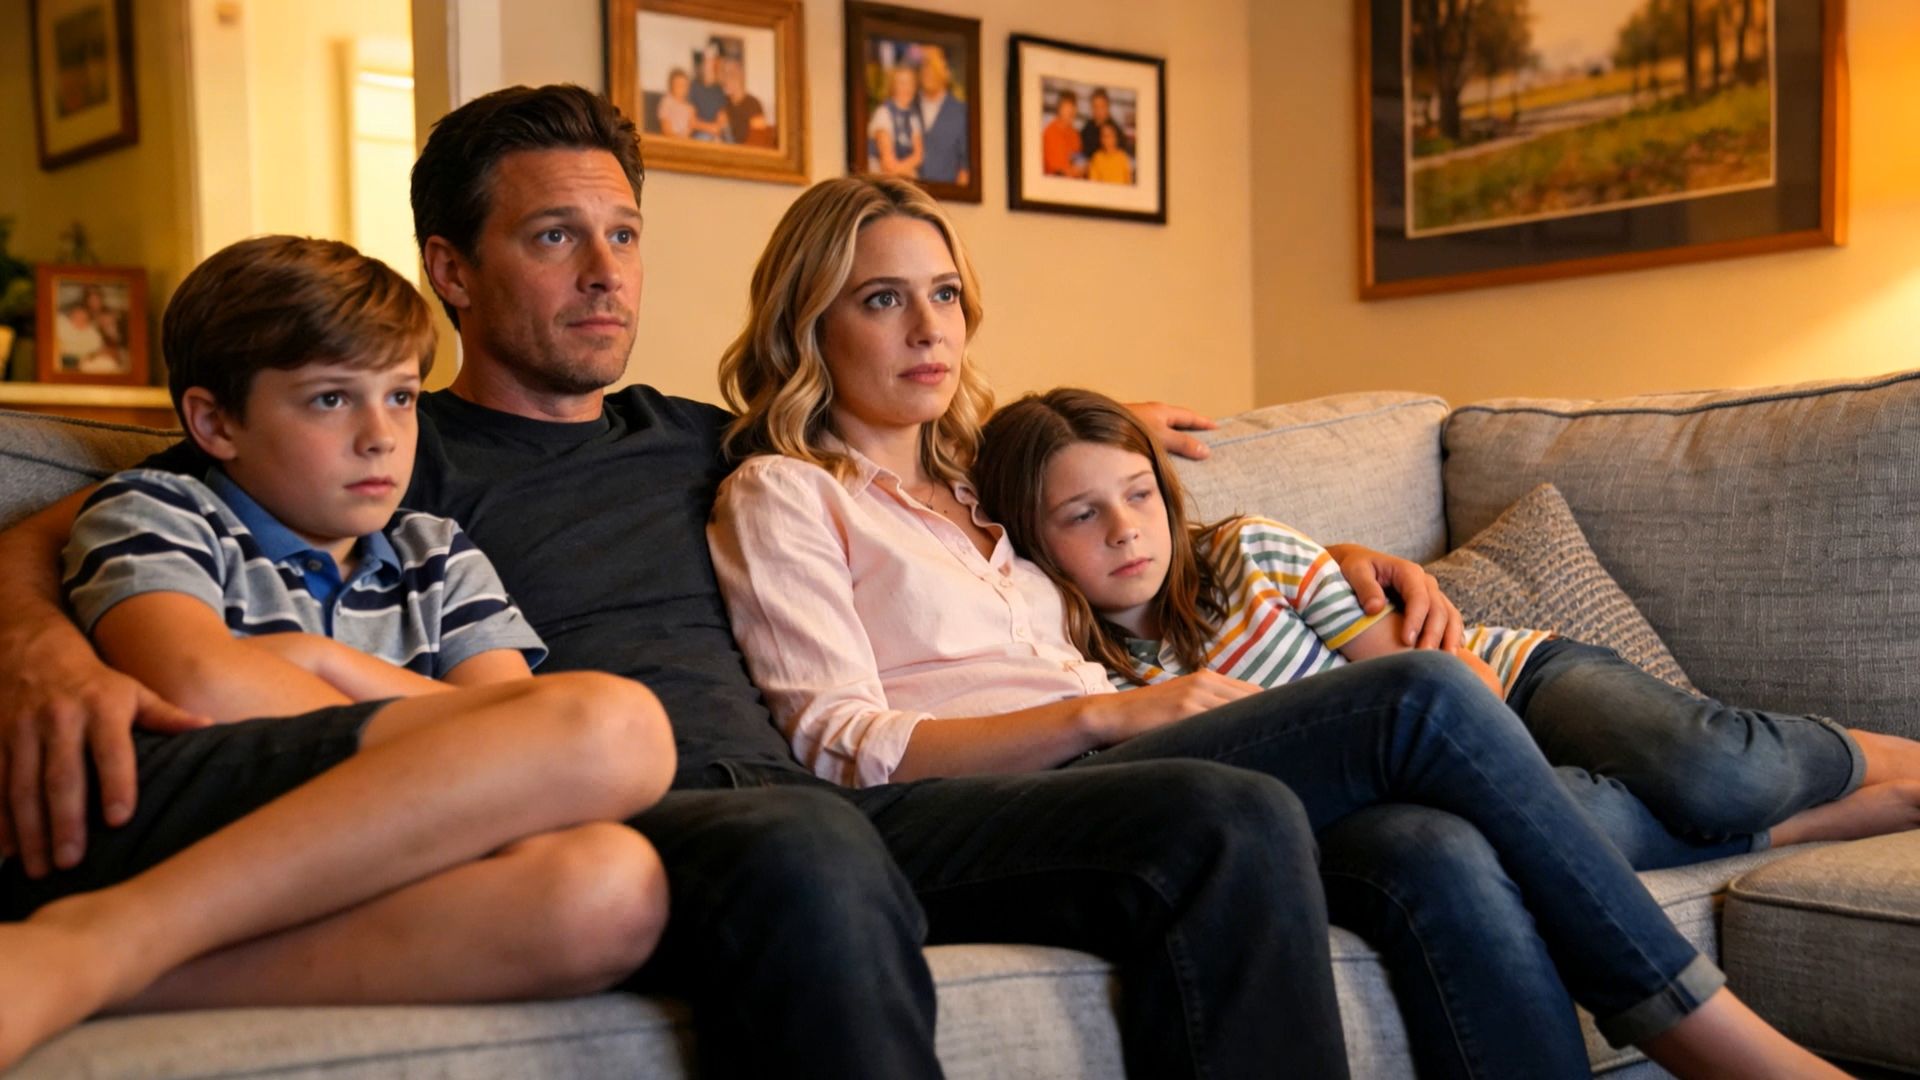
Сформулюйте підказку навколо теми, дії, обстановки та камери. Якщо сцена містить діалоги, поєднайте кожну репліку з персонажем, який має її вимовити. Kling VIDEO 3.0 може зіставити кожну репліку з відповідним промовцем, коли у сцені беруть участь кілька персонажів.
Image |
|
| Prompt: Home setting with a faint hum of the living room air conditioner in the background for a realistic daily vibe. Mom (softly, in a surprised tone): Wow, I didn’t expect this plot at all. Dad (in a low voice, agreeing, in a calm tone): Yeah, it’s totally unexpected. Never thought that would happen. Boy (in an excited tone): It’s the best twist ever! Girl (nodding along, in an enthusiastic tone): I can’t believe they did that! |
Video |
|
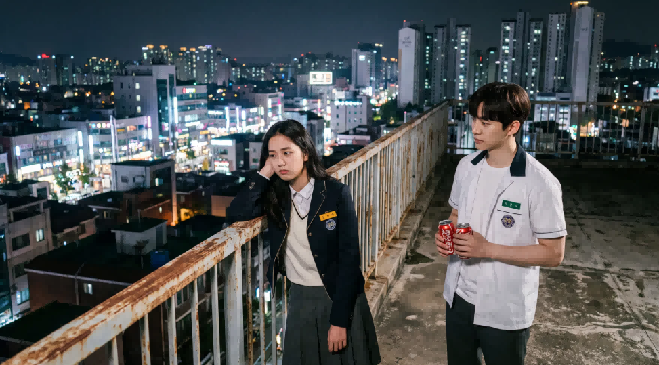
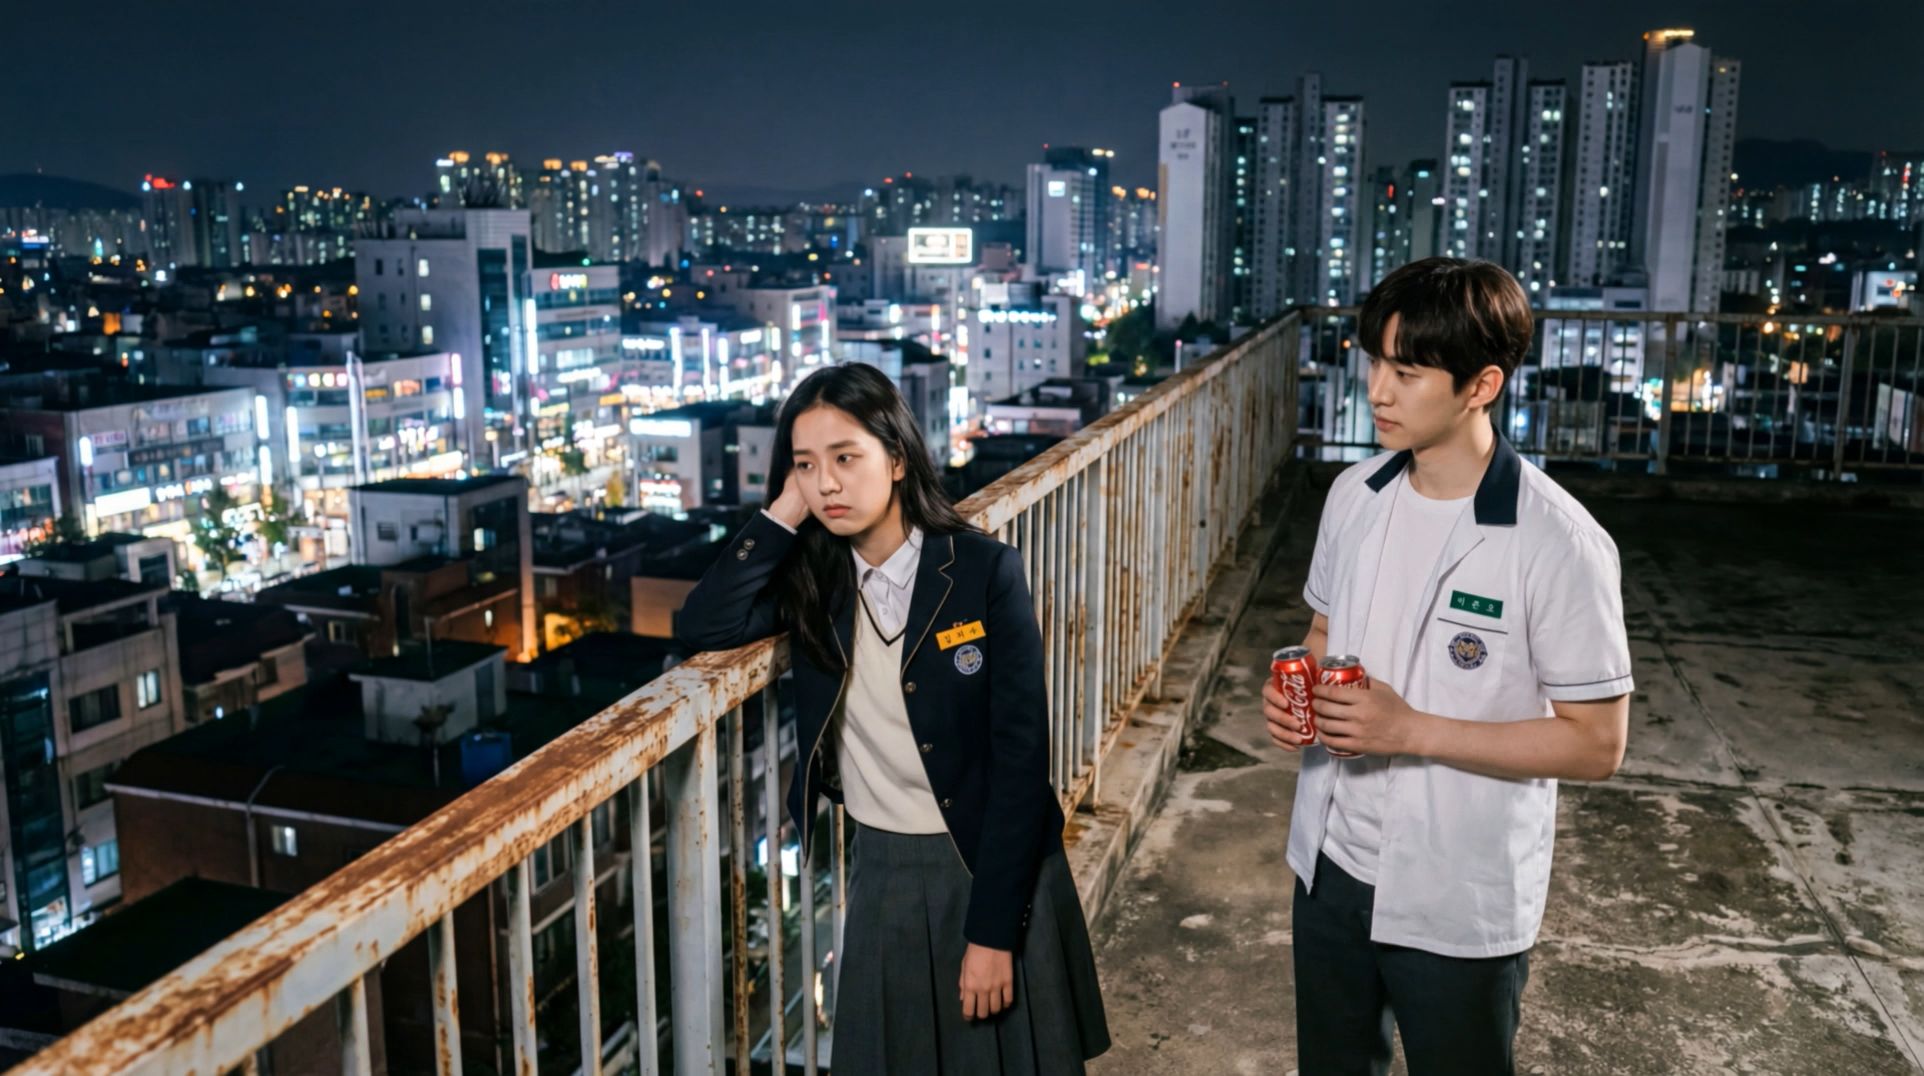
Ви також можете включити фонові звуки та інший аудіоматеріал у ту саму підказку. Native Audio дозволяє одночасно генерувати діалоги, фоновий звук і візуальні елементи. Наразі діалоги підтримують китайську, англійську, японську, корейську та іспанську мови, включно зі змішаномовними сценами та підтримуваними акцентами чи діалектами.
Image |
|
| Prompt: On the rooftop of a Korean high school, distant city lights glimmer in the background with a soft wind rustling, and stars twinkle in the night sky. The girl leans against the railing, lost in thought. The boy walks over with two cans of cola, hands one to her, and she takes it and pops the tab open. Boy (casual tone, Korean): "숙제 다 했어? 왜 여기 있어?" Girl (sighing, Korean): "시험이 너무 무서워". Boy (gentle tone, Korean): “걱정 마, 넌 잘할 거야.” |
|
Якщо елемент персонажа вже має збережений голос, підключений через Kling VIDEO 3.0 Omni, вам не потрібно повторно описувати той самий голос у підказці.
Крок 3: Оберіть Single-Shot або Multi-Shot
Залишайте Multi-Shot вимкненим, коли дія найкраще сприймається як один безперервний дубль. Якщо послідовність потребує кількох ракурсів, увімкніть його.
Kling VIDEO 3.0 може використати підказку, щоб організувати ці зміни в зв'язну послідовність, включно зі змінами кадрування, точки зору та ракурсу камери.
Image |
|
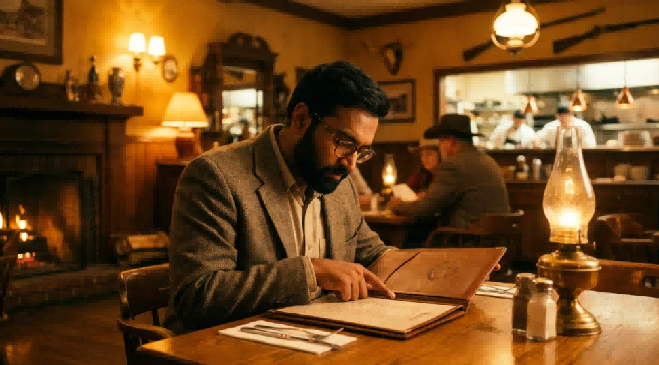
| Prompt: A middle-aged man is ordering food in a Western restaurant. He speaks in English with an Indian accent and says: "excuse me, I would like to order a seafood pasta, and a filet mignon. medium-rare", then he looks up and continues: “And, do you have any drink recommendations?” |
Video |
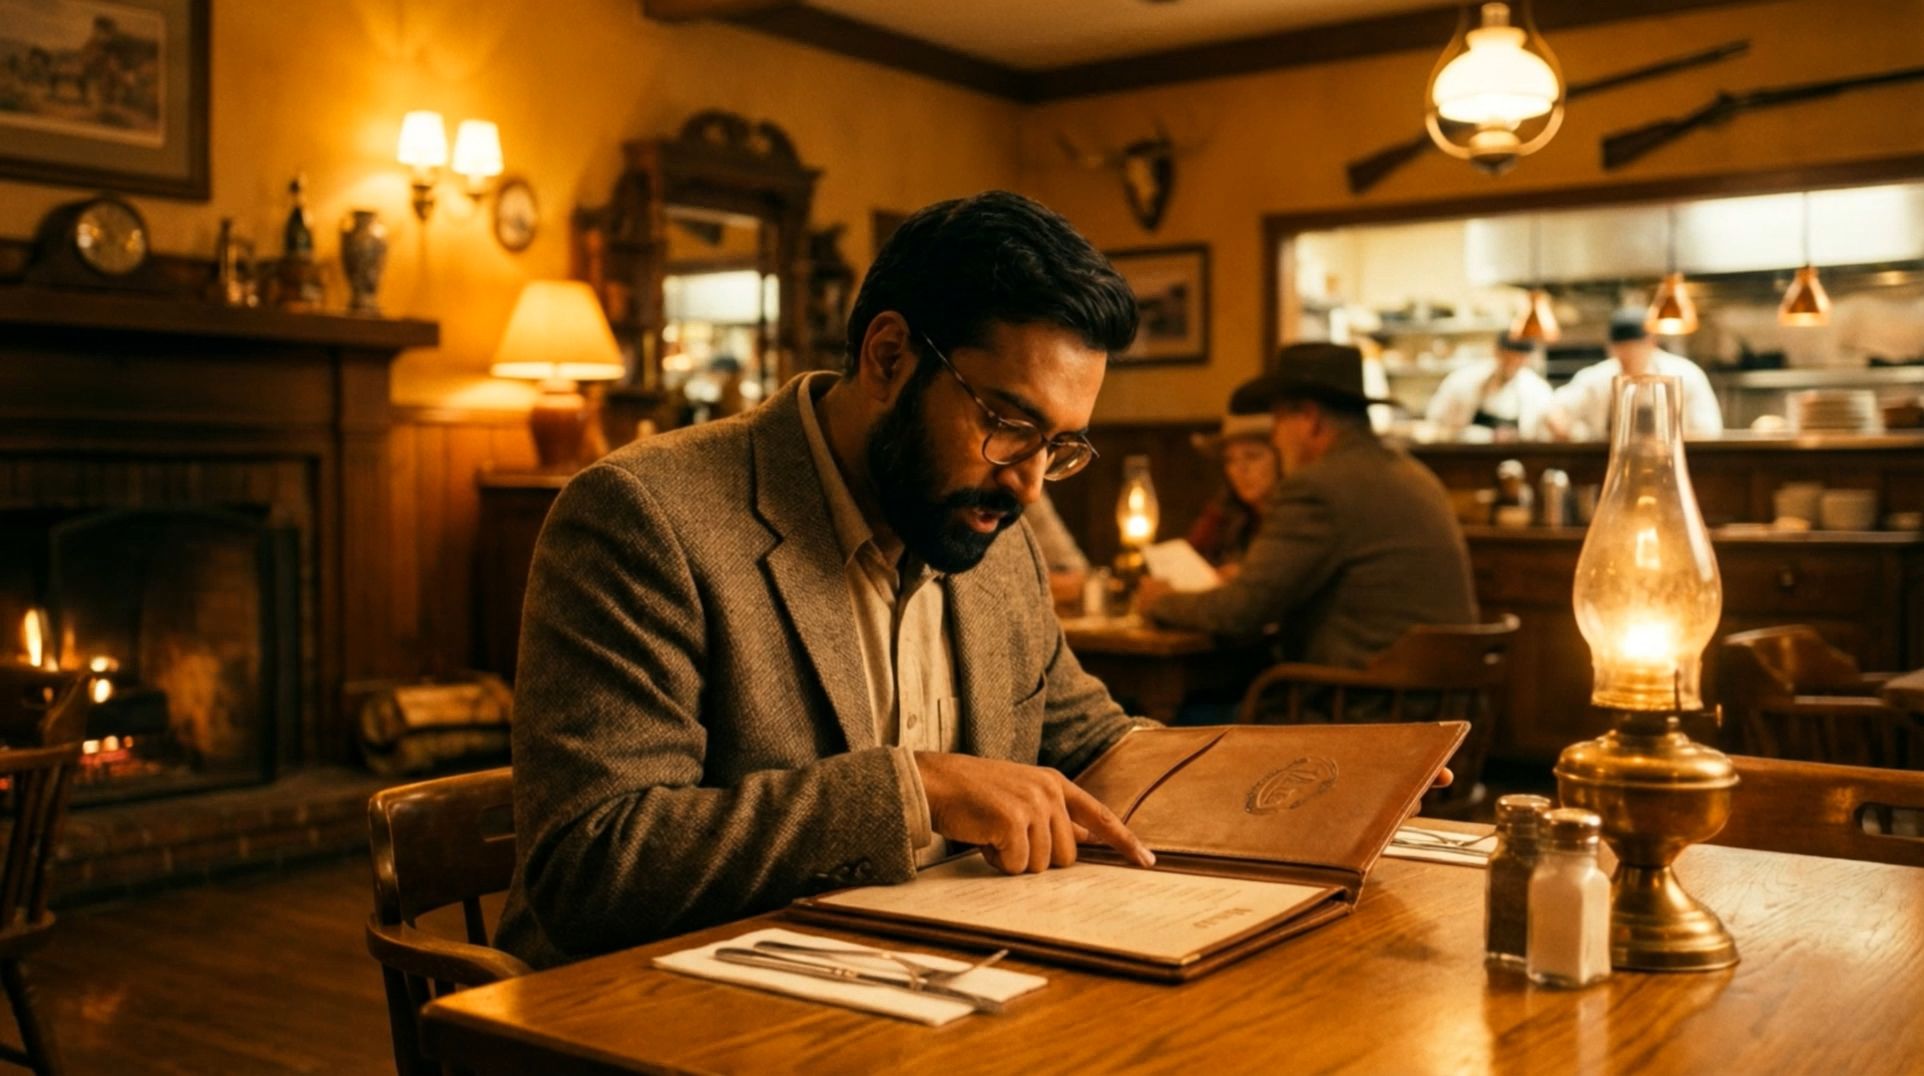
|
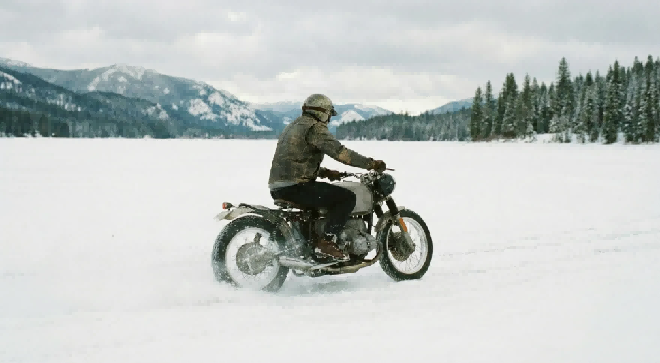
Для більш конкретних вказівок скористайтеся Custom Multi-Shot. Ви можете описати кожен кадр окремо і задати його тривалість, що полегшує перехід від загального плану до крупного, зміну точки зору під час діалогу або показ тієї самої дії з кількох ракурсів.
Image | |||||
| |||||
| Shot 1, Low-angle rear wide shot, tracking behind the rider as they move forward. | Shot 2, Low-angle side close-up, a detailed shot of the motorcycle wheel. | Shot 3, First-person POV from the rider, with the handlebars and instrument panel visible ahead. | Shot 4, Frontal medium shot, tracking backward in front of the motorcycle, the rider’s helmet facing the camera. | Shot 5, Side-on eye-level tracking shot with slight lateral movement. | Shot 6, High-angle wide shot with a gentle downward tilt. The camera rises as the snowmobile rides deeper into the snowfield, leaving winding tracks carved into the pristine white snow, with snow-covered forests scattered on both sides. |
Video | |||||
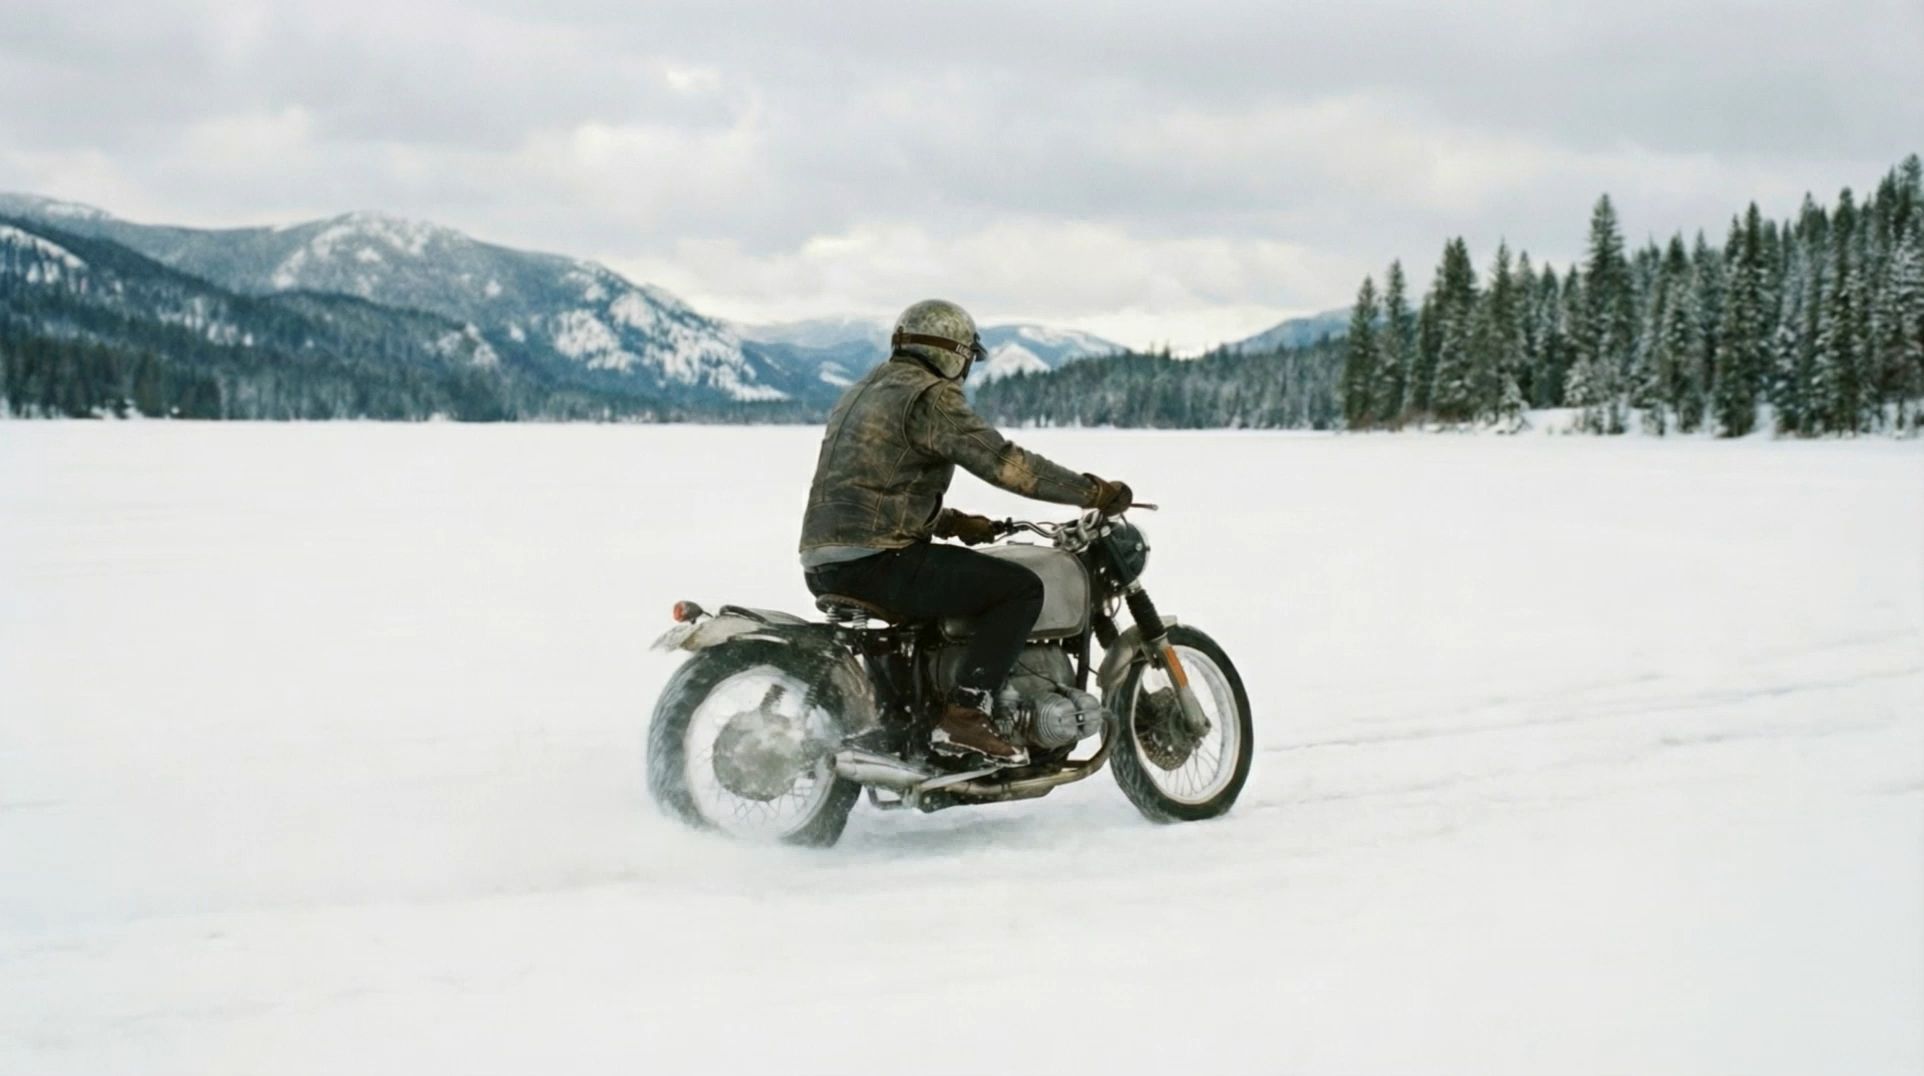
| |||||
Крок 4: Встановіть тривалість і згенеруйте
Узгодьте тривалість із тим, що відбувається на екрані. Kling VIDEO 3.0 працює з 3 до 15 секунд, залишаючи достатньо простору для швидких реакцій, довших дублів або послідовності, складеної з кількох кадрів.
Встановіть фінальний формат перед рендерингом. Оберіть 720p, 1080p або 4K з кадруванням 16:9, 1:1 або 9:16. Формат 16:9 підходить для YouTube, вебсайтів, презентацій і широкоформатних кампаній; 1:1 добре працює для публікацій у стрічці та візуалів, зосереджених на продукті; 9:16 пасує для TikTok, Reels, Shorts та інших мобільних розміщень.
Kling VIDEO 3.0 проти VIDEO 3.0 Omni: який варто використовувати?
Kling VIDEO 3.0 і Kling VIDEO 3.0 Omni обидва підтримують нативне аудіо, Multi-Shot та генерацію тривалістю до 15 секунд, хоча доступність функцій може відрізнятися залежно від режиму введення. Різниця починається в тому, як ви створюєте сцену. VIDEO 3.0 більше спирається на підказки, тоді як VIDEO 3.0 Omni надає довідковим матеріалам більшу роль у процесі.
1. Оберіть Kling VIDEO 3.0 для
- Перетворення тексту на відео та зображення на відео
- Генерації початкового та фінального кадрів
- Послідовностей Multi-Shot
- Багатомовних діалогів та сцен з кількома персонажами
- Відео, сформовані переважно за допомогою текстових підказок
2. Виберіть Kling VIDEO 3.0 Omni для
- Кілька референсів зображень та елементів в одному налаштуванні
- Елементи, створені з відео
- Персонажі, що повертаються, або брендовані об’єкти
- Голоси персонажів, які ви хочете використати знову
- Сцени, що значною мірою залежать від візуальних референсів та збереження впізнаваності персонажів
VIDEO 3.0 — природний вибір, коли більшість сцени описана у промпті. VIDEO 3.0 Omni має більше сенсу, коли зображення, Elements, відеореференси або збережені голоси потрібно зберегти протягом відео. Докладніше про дві моделі читайте у нашому посібнику Kling VIDEO 3.0 vs Kling VIDEO 3.0 Omni.
Як отримати кращі результати від моделей генерації відео ШІ
Слабкий кліп не завжди означає, що модель не підходить для завдання. Часто достатньо невеликого коригування брифу, вихідних матеріалів або постановки кадру, щоб наблизити наступну версію до бажаного результату.
Пишіть промпти як вказівки до кадру
Описуйте, що відбувається у кадрі, замість того щоб перевантажувати промпт словами про настрій.
Замість цього: Красивий кінематографічний рекламний ролик розкішних парфумів.
Спробуйте: Крупний план скляного флакона парфумів на темній кам’яній поверхні. Камера повільно наближається, поки вузький промінь світла проходить через флакон.
Використовуйте референси для зовнішності та руху
Текст може описувати, що має відбуватися, тоді як зображення та Elements допомагають зберігати впізнаваними обличчя, продукти, вбрання або локації у різних кадрах.
Коли важливе конкретне виконання, Motion Control може застосовувати рухи та міміку з завантаженого відео або з Motion Library до одного зображення персонажа. Зображення визначає зовнішність персонажа, а референс руху спрямовує, як цей персонаж рухається.
Змінюйте лише одну річ за раз
Коли кліп близький до завершення, коригуйте лише те, що потребує доопрацювання. Уповільнюйте камеру, якщо вона рухається надто швидко, змініть таймінг, якщо монтажний перехід настає занадто рано, або посильте візуальне джерело, якщо зображення починає відхилятися. Так легше побачити, яке редагування покращило наступну версію.
Кінець.
Моделі створення відео на основі ШІ тепер менше відрізняються тим, чи здатні вони згенерувати кліп, і більше тим, як вони працюють з рухом, референсами, звуком, структурою кадрів і візуальною безперервністю. Kling VIDEO 3.0 об'єднує ці аспекти за допомогою референсів зображень, Native Audio та інструментів Multi Shot. VIDEO 3.0 Omni розширює ці можливості завдяки Element binding, забезпечуючи повторюваним персонажам і об'єктам більш послідовну присутність у проєктах, створених із кількох зображень, відеореференсів та повторно використовуваних голосів.
Поширені запитання
Яка найкраща модель генерації відео ШІ у 2026 році?
Не існує єдиної моделі генерації відео ШІ, яка підходить для кожного типу відео. Правильний вибір залежить від вашого вихідного матеріалу та від того, наскільки вам потрібен контроль над рухом, звуком, операторською роботою та повторюваними об'єктами. Kling VIDEO 3.0 — професійна модель генерації відео ШІ, створена як для індивідуальних креаторів, так і для професійних продакшн-команд; вона поєднує кіношний рівень рідного 4K із рідним звуком, оповіддю Multi Shot та розширеним творчим контролем. VIDEO 3.0 Omni розширює цей робочий процес для складніших проєктів, що включають кілька візуальних референсів, багаторазових персонажів і Elements, пов'язані з голосом, а також дає можливість креаторам редагувати відео тривалістю до 10 секунд.
На що варто звертати увагу, порівнюючи моделі генерації відео ШІ?
Подивіться, як кожен варіант справляється з рухом, референсами, звуком, режисурою кадру, тривалістю та фінальною якістю зображення. Те, що буде найважливішим, залежить від проєкту. Сцени з великою кількістю діалогів потребують чіткої мови та повторюваних персонажів, які залишаються впізнаваними, тоді як у роботі з продуктом частіше наголошують на точних візуалах, продуманій роботі камери та деталях, що зберігаються від кадру до кадру.
Чи можуть моделі генерації відео на основі ШІ створювати звук?
Деякі так. Native Audio створює мову, фонові шуми та інші звуки разом із відеорядом, а не залишає їх для окремого етапу дубляжу чи саундтреку. Kling VIDEO 3.0 також уміє працювати з багатомовними діалогами та синхронізованим з губами мовленням. Коли персонаж говорить, призначення репліки безпосередньо цій людині допомагає зберегти прив’язку голосу до потрібного моменту на екрані.
Якої тривалості можуть бути відео, згенеровані ШІ?
Довжина залежить від моделі. Деякі інструменти створені для дуже коротких кліпів, а інші дозволяють довші послідовності. Kling VIDEO 3.0 підтримує до 15 секунд за одне генерування, включаючи сцени Multi-Shot. Цього достатньо для короткого сюжетного акценту, моменту з продуктом або короткого матеріалу для соцмереж без розбиття ідеї на кілька окремих кліпів.