Maaaring gawing video ng mga modelong text-to-video ang isang nakasulat na eksena na may galaw ng kamera, tunog, at maraming shot. Ang hamon ay maaari pa ring hindi tumama sa prompt ang natapos na clip, gumalaw nang alanganin, o hayaang magbago ang isang karakter o produkto mula sa isang shot patungo sa kasunod na shot. Tinitingnan ng artikulong ito kung bakit mahalaga ang mga pagkakaibang iyon, ano ang dapat suriin bago pumili ng modelo, at kung paano pinangangasiwaan ng Kling VIDEO 3.0 ang kontrol sa shot, galaw, audio, at biswal na pagpapatuloy.
Ano ang mga Modelong Text-to-Video?
Mga modelong text-to-video ay gumagamit ng generative AI upang gawing video ang mga paglalarawang nasa natural na wika. Maaaring tukuyin ng isang prompt ang paksa, tagpuan, aksyon, galaw ng kamera, at istilong biswal. Kapag sinusuportahan ng modelo ang audio, maaari rin nitong isama ang diyalogo, ambient sound, at iba pang mga audio cue.
Madalas ituring na pareho ang mga modelong text-to-video at mga text-to-video AI generator, ngunit magkaiba ang ginagampanan nilang papel:
Modelong Text-to-Video | Text-to-Video na AI Generator | |
Kung ano ito | Ang AI system na nagbibigay-kahulugan sa prompt at lumilikha ng video | Ang produkto o interface na ginagamit ng mga tao upang ma-access ang paglikha ng text-to-video |
Ano ang pinangangasiwaan nito | Pagpapakahulugan ng prompt, pagbuo ng eksena, galaw, at pagpapatuloy sa paglipas ng panahon | Mga tampok na nakapalibot sa modelo, tulad ng mga kontrol sa shot, mga reference input, audio, tagal, aspect ratio, pag-edit, at pag-export |
Bakit ito mahalaga | Direktang naaapektuhan ng modelo ang kalidad ng video, galaw, at visual na pagkakapare-pareho | Ang generator ang tumutukoy kung gaano kalaki ang malikhaing kontrol na mayroon ka at kung ano ang magagawa mo sa video pagkatapos nito |
Tinutukoy ng modelo kung ano ang nalilikha, samantalang ang AI na tagalikha ng video ang tumutukoy sa kung paano mo maa-access ang mga kakayahang iyon, makokontrol ang proseso, at makakatrabaho ang natapos na video.
Paano Gumagana ang mga Text-to-Video na Modelo?
Pinapalitan ng mga text-to-video na modelo ang isang nakasulat na prompt sa isang sunod-sunod na gumagalaw na mga imahe. Nagkakaiba-iba ang eksaktong proseso depende sa modelo, ngunit karaniwan itong kinabibilangan ng pag-unawa sa prompt, pagbuo ng compressed na representasyon ng eksena, pagtukoy kung paano nagbabago ang mga bagay sa paglipas ng panahon, at pagpapanatiling pare-pareho ng resulta sa bawat sandali.
1. Unawain ang Prompt
Nagsisimula ang isang AI na text-to-video na modelo sa pagtukoy sa mga pangunahing tagubilin sa prompt, kabilang ang:
- ang paksa
- ang aksyon
- ang tagpuan
- ang biswal na estilo
- ang direksyon ng kamera
- mga dayalogo o iba pang palatandaan sa tunog, kapag sinusuportahan
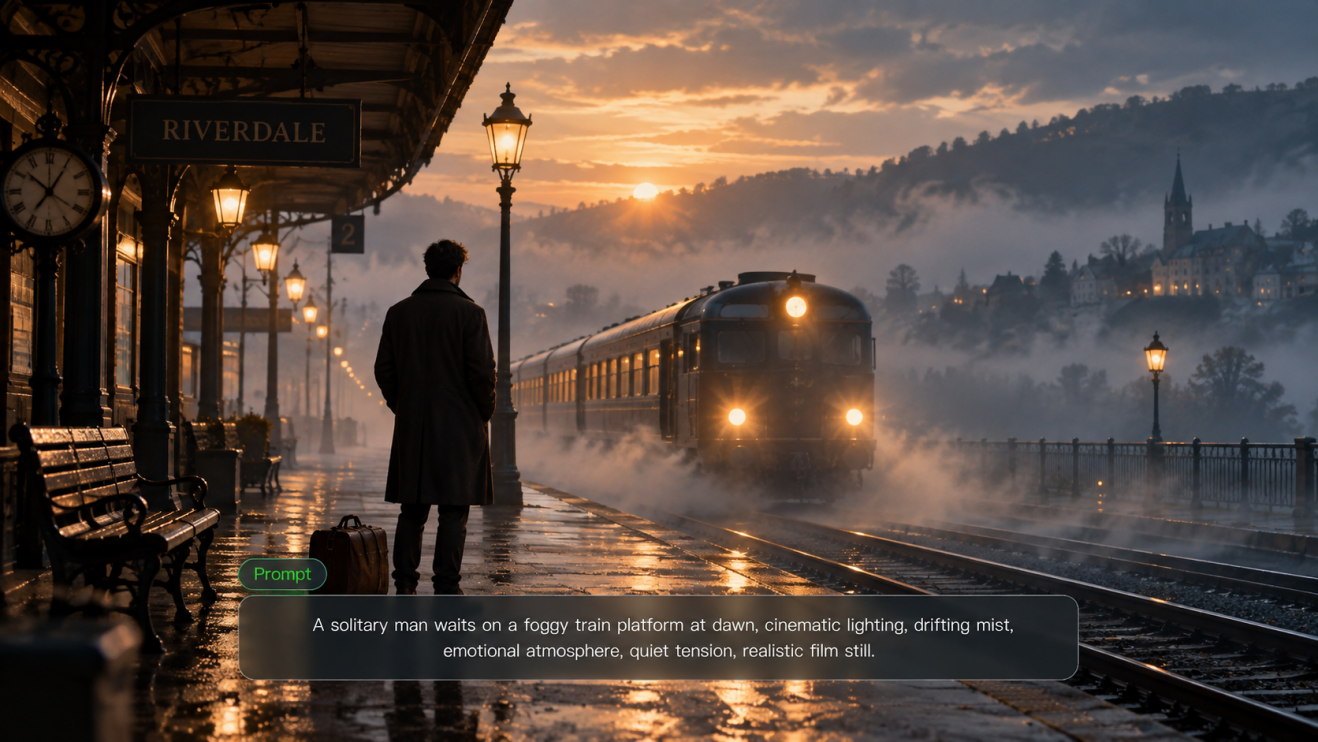
| prompt: “Isang siklista ang dumadaan sa isang basang kalsada sa downtown habang sinusundan siya ng kamera mula sa likuran.” |
Ang maikling paglalarawang iyon ay naglalaman ng ilang tagubiling kailangang magtulungan. Ang siklista ay sumusulong, sinusundan ng kamera mula sa likuran, at ang ulan, kalsada, pag-iilaw, at kapaligiran ay kailangang magkaayon sa iisang kuha.
Sa madaling salita, inilalarawan ng prompt higit pa sa kung ano ang dapat lumabas sa screen. Itinatakda rin nito ang mga ugnayan sa pagitan ng paksa, galaw, kamera, at kapaligiran.
2. Bumuo ng Naka-compress na Representasyon ng Video
Pagkatapos basahin ang prompt, kailangan ng system ng isang magagamit na representasyon ng eksena bago ito maging tapos na footage. Ang eksaktong paraan ay nakadepende sa arkitektura ng modelo.
Maraming diffusion-based text-to-video na modelo ang gumagana sa isang compressed na puwang ng representasyon sa halip na magproseso ng full-resolution na mga frame mula sa simula. Nagsisimula sila sa ingay at dahan-dahang hinuhubog iyon ayon sa prompt, inilalabas ang paksa, tagpuan, pag-iilaw, komposisyon, at iba pang biswal na detalye. Ang pagtatrabaho sa compressed na puwang na ito ay nagpapababa sa dami ng datos na hinahawakan habang lumilikha, at kapag nabuo na ang eksena, ida-decode ang resulta sa nakikitang mga frame ng video.
3. Bumuo ng Galaw at Interaksiyon
Kailangang ipakita ng video kung ano ang nangyayari mula sa isang sandali hanggang sa susunod. Kailangang makayanan ng modelo ang paggalaw, interaksiyon ng mga bagay, at mga pagbabago sa pananaw nang hindi sinisira ang eksena.
- Galaw: Ang isang karakter na umiikot, naglalakad, o umaabot ay dapat baguhin ang pustura at posisyon nang hakbang-hakbang, sa halip na biglang tumalon mula sa isang estado patungo sa iba.
- Pakikipag-ugnayan sa bagay: Kailangang may malinaw na pagkakasunod ang mga kilos. Kung may kukuha ng tasa, dapat munang abutin ng kamay at dumikit dito bago gumalaw ang tasa.
- Kamera at espasyo: Ang mga pan, tilt, push-in, at tracking shot ay nagbabago ng pananaw, ngunit kailangang manatiling nakapirmi sa parehong espasyo ang paksa at kapaligiran.
Ang isang nakapirming imahe ay kailangan lamang ilarawan ang isang sandali. Kailangang isaalang-alang ng video ang nangyayari sa pagitan ng mga sandali.
4. Panatilihin ang Temporal at Audio-Visual na Pagkakapare-pareho
Habang umuusad ang video, kailangang manatiling magkakaugnay ang mga tao, bagay, at tunog sa paglipas ng panahon. Pangunahing nahahati ito sa dalawang uri ng pagkakapare-pareho:
- Pagkakapareho sa paglipas ng panahon: Hindi dapat nagbabago ang mga karakter, produkto, kasuotan, props, ilaw, at background nang walang malinaw na dahilan mula sa isang sandali patungo sa susunod. Kahit pagkatapos ng pagputol mula sa close-up tungo sa wide shot o pagbabago ng anggulo ng kamera, dapat pa ring madaling makilala ang parehong tao o produkto.
- Pagkakapareho ng audio at biswal: Kailangang mangyari sa tamang oras ang dayalogo, galaw ng labi, ekspresyon ng mukha, tunog sa paligid, at mga aksyon sa screen. Kapag nagsasalita ang isang karakter, dapat tumugma ang galaw ng bibig sa dayalogo, samantalang ang yabag o tunog ng tama ay dapat sabayan ang aksyong pinanggagalingan nito.
Para saan mo magagamit ang AI na Text-to-Video?
Mahusay gumana ang AI na text-to-video sa mga sitwasyon kung saan kailangang makita muna ang isang ideya bago ito katumbas gawin sa buong saklaw. Makakatulong ito sa maagang pagsusuri ng mga malikhaing konsepto, sa mga eksenang mahirap kunan, at sa mga proyektong nangangailangan ng ilang direksyong biswal bago magsimula ang produksyon.
Gumawa ng mga Video para sa Social Media
Maikli ang buhay ng social content, kaya bihirang makatuwiran ang mag-ayos ng panibagong shoot para sa bawat post o konsepto ng kampanya. Maaaring makagawa ang isang prompt ng mga clip para sa mga teaser, anunsiyo, post ng kampanya, o maiikling video na pinangungunahan ng kuwento nang hindi muling binubuo ang setup ng produksyon sa bawat pagkakataon. Maaari ring subukan ng mga creator ang iba-ibang setting, galaw ng kamera, at direksiyong biswal bago pumili ng isang bersyon.
Gawing mga Marketing Video ang mga Ideya sa Produkto
Ang copy at mga static mockup ay hindi laging nagpapakita kung ano ang hitsura ng isang produkto kapag gumagalaw na ito sa isang eksena. Pinapayagan ng text-to-video AI ang mga marketer na ilagay ang parehong produkto sa iba-ibang kapaligiran, galugarin ang mga konsepto ng ad, at subukan ang mga visual treatment nang mas maaga sa proseso. Kung lumilitaw ang produkto sa ilang shot, ibinubunyag din ng mga resulta kung gaano kahusay na nananatili ang hugis, kulay, at mga detalyeng naglalarawan nito mula sa isang shot hanggang sa susunod.
Bumuo ng Maiikling Eksenang May Kuwento
Mas nagiging mahirap planuhin ang isang maikling kuwento kapag kasama na ang ilang shot, kilos ng karakter, pagbabago ng kamera, at diyalogo. Maaaring italâ ng text-to-video AI ang mga elementong iyon sa isang pagkakasunod-sunod, na nagpapadali sa pagsusuri ng pagkakasunod ng shot, pacing, at tiyempo ng diyalogo bago itayo nang hiwalay ang bawat eksena. Lalo itong kapaki-pakinabang para sa maiikling pirasong sinematiko kung saan nakasalalay ang kuwento sa higit pa sa iisang tuloy-tuloy na shot.
Isalarawan ang mga Konsepto at mga Storyboard
Maaaring ipaliwanag ng isang treatment o storyboard kung ano ang dapat mangyari, ngunit mas mahirap husgahan ang timing at galaw ng kamera sa isang pahinang walang galaw. Ang paglalapat ng ideya sa galaw ay nagbibigay sa mga direktor, designer, at creative team ng mas malapit sa aktuwal na karanasang mapapanood. Maaari nilang ihambing ang framing, subukan ang mga transition, at makita ang mahihinang sandali habang madali pa ang paggawa ng mga pagbabago.
Gumawa ng mga Video na Pang-edukasyon at Paliwanag
Ang ilang paksa ay mahirap kunan sa kamera dahil mahal, abstrakto, hindi madaling ma-access, o imposibleng i-stage. Maaaring ilarawan ng text-to-video AI ang isang proseso, muling buuin ang isang tagpuan, o magpakita ng kaganapang hindi maaaring direktang i-film. Para sa mga explainer, materyal sa pagsasanay, at nilalaman sa silid-aralan, maaaring gawing mas madaling maunawaan ng galaw ang isang konsepto kapag hindi sapat ang ipinapakita ng isang larawang walang galaw.
Paano Pipiliin ang Pinakamahusay na Text-to-Video AI Model para sa Iyong Proyekto?
Walang iisang text-to-video AI model ang angkop para sa bawat proyekto. Magsimula sa kung ano ang nais mong gawin, pagkatapos ay tukuyin kung aling mga kakayahan ang pinakamahalaga para sa gawaing iyon. Ang mga pangunahing dapat ihambing ay ang pagsunod sa prompt, galaw at pisikal na pagiging kapani-paniwala, pagkakapare-pareho, malikhaing kontrol, audio, at mga limitasyon ng output at workflow.
Pagsunod sa Prompt
Una, tiyakin kung talagang sinusunod ng modelo ang prompt. Dapat lumitaw nang magkakasama ang paksa, aksyon, tagpuan, estilong biswal, at direksyon ng kamera sa halip na ang pinaka-halatang detalye lamang. Kung humiling ka ng isang siklista na nagbibisikleta sa ulan habang sinusundan siya ng kamera mula sa likuran, dapat nandoon ang siklista, lagay ng panahon, galaw, at punto de bista. Ang mga iniiwan ng modelo ay makapagsasabi nang kasing dami ng sinasabi ng kinis ng bidyo.
Galaw at Pisikal na Pagiging Kapani-paniwala
Ang mga aksyon ay dapat maganap sa malinaw na pagkakasunod-sunod. Ang paglalakad, pagliko, pag-abot, mga banggaan, at paggalaw ng kamera ay dapat lumipat mula sa isang estado patungo sa susunod nang walang biglaang pagtalon. Mahalaga rin ang pisikal na interaksiyon: dapat munang dumikit ang kamay bago gumalaw ang isang bagay, dapat maapektuhan ng paglapag ang katawan, at ang buhok, tela, tubig, o maluluwag na bagay ay dapat tumugon sa kalapit na galaw sa halip na kumilos nang mag-isa.
Pagkakapare-pareho ng Tauhan at Produkto
Dapat manatiling nakikilala ang parehong paksa kapag nagbago ang framing, anggulo, o distansya. Hindi dapat magbago nang walang dahilan ang mga mukha, damit, hugis ng produkto, kulay, props, ilaw, at iba pang nagtatakdang detalye. Mas pinapahirap ito ng mga eksenang maraming shot, kaya dapat ding suriin ang mga proyektong nakabatay sa paulit-ulit na mga karakter o produkto para sa mga imaheng sanggunian, sangguniang paksa, o iba pang paraan upang madala ang visual na pagkakakilanlan mula shot hanggang shot.
Pagkamalikhain at Kontrol sa Kamera
Kapag malinaw na ang visual na direksyon ng isang eksena, mahalaga ang kontrol. Nakaaapekto ang framing, galaw ng kamera, pagkakasunod ng mga shot, mga reference input, aspect ratio, at estruktura ng multi-shot sa kung gaano kalapit ang resulta sa orihinal na ideya. Ang mas pinong kontrol ay nangangahulugan ding mas malamang na hindi mo kailangang ulitin ang buong sequence para lang baguhin ang isang anggulo, ayusin muli ang pagkakasunod ng shot, o itama ang komposisyon.
Suporta sa Audio
Malaki ang pagkakaiba ng mga kakayahan sa audio sa pagitan ng mga modelo. May ilan na larawan lang ang nalilikha, habang ang iba ay kayang bumuo ng diyalogo, tunog ng kapaligiran, at mga epekto kasama ng footage. Para sa mga eksenang puno ng diyalogo, suriin kung nananatiling magkakatugma ang boses, galaw ng bibig, ekspresyon ng mukha, at tiyempo. Dapat ding sumabay sa kaugnay na aksyon ang mga yapak, tama, at tunog ng kapaligiran.
Tagal, Resolusyon, at Daloy ng Trabaho
Suriin ang mga limitasyong nakaaapekto sa pinal na video, kabilang ang haba ng pagbuo, suportadong aspect ratio, magagamit na resolusyon, at mga opsyon sa pag-export. Ang maikling social clip at multi-shot na eksena ng produkto ay maaaring may napakaibang mga pangangailangan sa output.
Kasinghalaga rin ang nangyayari pagkatapos ng pagbuo. Maaari mo bang pahabain ang clip, gamitin muli ang parehong subject, baguhin ang isang shot, muling bumuo ng audio, o ipagpatuloy ang pag-edit nang hindi nagsisimula muli? Hindi dapat pilitin ng maliliit na pagbabago na muling buuin mo ang buong sequence.
Magkakaibang proyekto ang nangangailangan ng magkakaibang prayoridad. Magsimula sa uri ng video na ginagawa mo, pagkatapos ay ituon ang pansin sa mga kakayahang pinakamahalaga:
Kung Nais Mong Lumikha | Bigyang-priyoridad | Bakit Ito Mahalaga |
Maiikling social na video | Pagsunod sa prompt, mga aspect ratio, daloy ng trabaho | Mabilis gumalaw ang social content, kaya kailangang manatiling malapit sa ideya ang output, magkasya sa karaniwang format ng platform, at madaling baguhin. |
Mga video ng produkto at marketing | Pagkakapare-pareho ng produkto, pagsunod sa prompt, resolusyon | Kailangang manatiling pare-pareho ang hugis, kulay, branding, at mahahalagang detalye ng produkto sa iba’t ibang kuha habang natutugunan pa rin ng panghuling footage ang mga pangangailangan ng kampanya o presentasyon. |
Maikling salaysay o mga eksenang sinematiko | Paggalaw at pisikal na pagiging kapani-paniwala, kontrol sa camera, pagkakapare-pareho sa maraming kuha | Ang mga kilos ng karakter, mga pagbabago sa kamera, at mga transisyon ng eksena ay kailangang magkakaugnay sa kabuuan ng pagkakasunod-sunod nang walang halatang paglihis sa biswal. |
Mga video na nakatuon sa diyalogo | Suporta sa audio, lip sync, pagkakapare-pareho ng karakter | Ang diyalogo, galaw ng bibig, pag-arte ng mukha, at pagkakakilanlan ng karakter ay kailangang manatiling magkahanay, habang dapat dumating ang tunog sa tamang sandali. |
Mga paunang silip ng konsepto at mga storyboard | Pagkontrol sa pagkamalikhain at kamera, mga sangguniang input, kakayahang umangkop sa mga rebisyon | Ang layunin ay subukan ang framing, direksyon ng kamera, pacing, at mga alternatibong ideya nang maaga, habang madali pang gawin ang mga pagbabago. |
Mga bidyong pang-edukasyon at nagpapaliwanag | Pagsunod sa prompt, galaw at pisikal na pagiging kapani-paniwala, daloy ng trabaho | Kailangang ipaliwanag nang tama ng mga biswal ang isang proseso o ideya, panatilihing madaling sundan ang galaw, at magbigay-daan sa mga rebisyon kapag nagbago ang nilalaman. |
Ano ang Maaari Mong Magawa gamit ang Kling VIDEO 3.0?
Ang mahirap na bahagi ng text-to-video ay hindi lang ang pagkakaroon ng isang magandang kuha. Ito ay ang pagpapakita ng paksa, aksyon, direksyon ng kamera, tunog, at maliliit na detalyeng biswal mula sa prompt sa paraang inasahan mo. Habang mas nagiging detalyado ang mga prompt at mas maraming kuha ang idinadagdag sa mga eksena, mas marami ang kailangang subaybayan ng modelo mula sa isang sandali hanggang sa susunod.
Kling VIDEO 3.0 ay binuo upang matugunan ang mga pangangailangang iyon, na may mas malakas na interpretasyon ng prompt, multi-shot na pagku-kuwento, pagkakapare-pareho ng paksa, katutubong audio, nababagong haba, at pag-render ng teksto. Sa halip na magsulat ng isang paglalarawan at simpleng maghintay kung ano ang ibabalik, maaari mong hubugin kung paano umaandar ang kuwento, kung kailan nagbabago ang kamera, kung paano naipapasa ang mga paksa sa bawat kuha, at kung saan pumapasok ang tunog sa eksena.
Mas Tumpak na Pag-unawa at Pagsunod sa mga Prompt
Kayang bigyang-kahulugan ng Kling VIDEO 3.0 ang patong-patong na mga prompt na pinagsasama ang mga paksa, mga aksyon, mga setting, direksiyon ng kamera, at estruktura ng naratibo. Tinutulungan nitong manatiling mas malapit sa inaasahang eksena ang mga masalimuot na text-to-video na prompt, lalo na kapag may kinalaman sa maraming aksyon, planadong paggalaw ng kamera, o tiyak na pagkakasunud-sunod ng mga pangyayari.
Panatilihing Konsistent ang mga Tauhan at Produkto sa Bawat Kuha
Maaaring magmukhang tama ang isang karakter sa isang kuha ngunit mapansin pa rin ang pagbabago mula sa ibang anggulo. Sa multi-shot na video, maaaring magbago ang mga mukha, maaaring lumihis ang mga detalye ng kasuotan, at maaaring mag-iba ang kulay, hugis, o mga naglalarawang tampok ng isang produkto mula sa isang kuha hanggang sa susunod.
Sa mga suportadong reference-assisted VIDEO 3.0 na workflow, maaari kang gumamit ng maraming reference image upang magbigay ng karagdagang gabay na biswal at tulungang iangkla ang paulit-ulit na karakter, produkto, o iba pang pangunahing paksa sa kabila ng mga pagbabago sa framing, anggulo, at setting. Nagbibigay ang mga reperensiyang ito sa modelo ng mas maraming impormasyon tungkol sa hitsura ng paksa at mahahalagang detalyeng biswal, na tumutulong mabawasan ang malinaw na pag-anod ng biswal sa mga eksenang may umuulit na karakter, mga kuha ng produkto, at branded na nilalaman.

Bumuo ng mga Multi-Shot na Kuwento na Mas May Kontrol sa Takbo
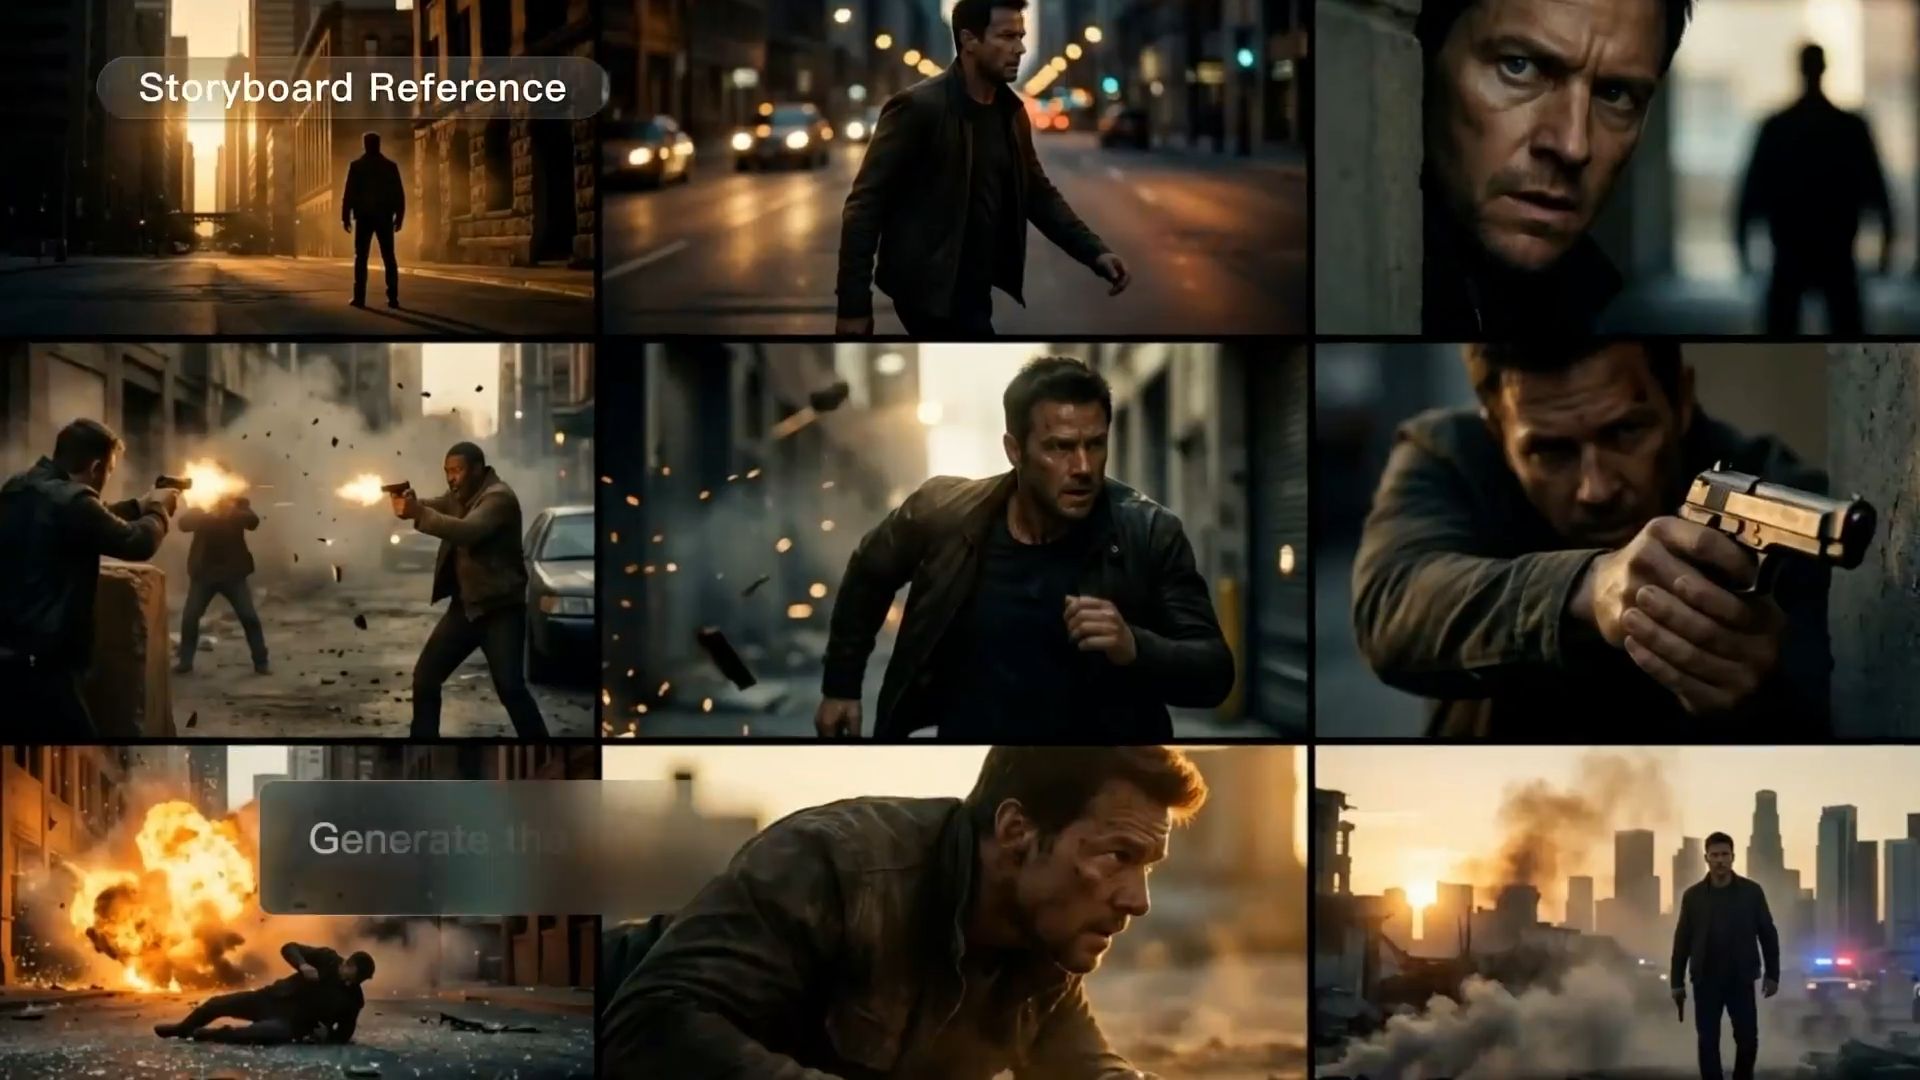
Ang isang kuha lang ay karaniwang kayang pamahalaan. Nagsisimula ang hamon kapag ang isang kuwento ay nangangailangan ng mga close-up, mga wide shot, iba't ibang posisyon ng kamera, at mga pagbabago ng eksena. Ang paglikha ng bawat kuha nang magkakahiwalay ay nangangahulugan ng mas maraming pag-e-edit paglaon, at nagiging mas mahirap panatilihing buo ang pacing at continuity sa buong sunod-sunod na kuha.
Kayang hawakan ng Multi-Shot ng Kling VIDEO 3.0 ang ilang kuha sa iisang generation, kaya nagiging magkakaugnay na sequence ang isang prompt sa halip na magkakahiwalay na clip. Para sa planadong sequence, hinahayaan ka ng Custom Multi-Shot na tukuyin ang nilalaman, pagkakasunod, at tagal ng bawat kuha, kaya naitatalaga na ang mga cut at pacing bago magsimula ang generation.
Bumuo ng Diyalogo at Tunog ng Eksena nang Magkasabay
Kapag puro biswal lang ang ginagawa ng isang modelo ng video, may dagdag na trabaho sa mga eksenang may diyalogo. Kailangang asikasuhin pagkatapos ang mga boses, ambient na tunog, mga epekto, at timing. Kapag nagdagdag ka pa ng ilang karakter, kailangan mo ring subaybayan kung sino ang nagsasabi ng bawat linya at kung tugma ang tunog sa tamang aksyon sa screen.
Ang Native Audio ng Kling VIDEO 3.0 ay lumilikha ng diyalogo, ambient sound, at iba pang audio kasabay ng video. Sa mga eksenang may maraming karakter, maaari mong italaga ang mga linya sa iba-ibang tagapagsalita, na may suporta para sa Chinese, English, Japanese, Korean, at Spanish, kasama ng mga sinusuportahang diyalekto at punto. Ang pagsasalita, pagganap ng mga karakter, at tunog ng eksena ay isinama na sa parehong henerasyon sa halip na idugtong pa sa isang tahimik na clip pagkatapos.
Lumikha ng Mas Mahahabang Kuwento na Hanggang 15 Segundo at 4K Output
Nagbibigay ang Kling VIDEO 3.0 sa mga creator ng mas maraming espasyo upang paunlarin ang bawat eksena, sa pamamagitan ng nababagay na 3–15 segundong pagbuo para sa interaksiyon ng mga karakter, multi-shot na pagkukuwento, diyalogo, at mga transition. Sa mga sinusuportahang daloy ng trabaho, pinapanatili ng hanggang 4K output ang mas pino pang detalye, mga texture, at kabuuang linaw ng visual, na tumutulong sa mga creator na magmula sa mga unang konsepto hanggang sa pinakintab na nilalaman para sa advertising, pagpapakita ng produkto, cinematic storytelling, at marami pa.
Ang Wakas
Ang mga text-to-video na modelong sulit sa oras mo ay higit pa sa pag-animate ng isang prompt: sinusunod nila ang iyong layunin, kumikilos nang natural, dumarating na may tunog, at pinananatiling matatag ang isang paksa sa iba't ibang kuha. Kung susukatin batay sa mga pamantayang iyon, pinagsasama ng Kling VIDEO 3.0 ang prompt-driven generation, Multi-Shot control, Subject Consistency, at native audio sa iisang lugar. Buksan ang Kling, isulat ang iyong eksena, at panoorin itong mabuhay sa iisang generation.
Mga FAQ
Paano Ako Pipili sa mga Pinakamagagandang Text-to-Video na Modelo ng AI sa 2026?
Magsimula sa uri ng video na gusto mong gawin, saka ihambing ang mga modelo para sa gawaing iyon. Ang Multi-shot na pagku-kuwento ay nagbibigay ng mas malaking diin sa kontrol sa kamera at pagkakapare-pareho ng karakter. Ang mga eksenang mabigat sa dayalogo ay nangangailangan ng matibay na audio, tamang lip sync, at mahusay na pagganap ng karakter, habang ang paggawa ng produkto at ad ay higit na umaasa sa pagsunod sa prompt, katatagan ng subject, at kalidad ng output. Mahalaga rin ang haba at resolusyon, dahil bihirang magkapareho ng mga pangangailangan ang isang mabilis na pagsubok at ang tapos na piraso. Pinagsasama ng Kling VIDEO 3.0 ang Multi-Shot, Native Audio, pagsunod sa prompt, at pagbuo ng hanggang 15 segundo para sa mga multi-shot na kuwento, mga eksenang pinatatakbo ng dayalogo, at mga proyektong kailangang manatiling madaling makilala ang parehong karakter o produkto sa bawat shot.
Maaari bang may Kasamang Tunog ang AI Text to Video?
Oo. Ang Kling VIDEO 3.0 ay makakalikha ng dayalogo, tunog sa paligid, at mga epekto kasabay ng video, kaya hindi mo na kailangang idagdag ang audio pagkatapos. Maaari mong isulat ang mga linya direkta sa prompt, italaga ang mga ito sa mga partikular na karakter, at pumili ng wika, diyalekto, o akento. Ang kakayahan nitong text-to-speech ay kayang gawing mga boses ng karakter ang mga linyang iyon sa Tsino, Ingles, Hapones, Koreano, at Kastila. Ibig sabihin, mas kaunting hiwalay na voiceover na trabaho at mas kaunting pagbuo ng audio pagkatapos malikha ang video.
Gaano kahaba maaaring maging ang nabuong video?
Nag-iiba ang haba ng video depende sa modelo. Sinusuportahan ng Kling VIDEO 3.0 ang nababagong paglikha mula 3 hanggang 15 segundo. Mainam ang mas maiikling clip para sa mabilisang kilos at nilalaman sa social media, habang ang mas mahahabang clip ay nagbibigay ng mas maraming oras para sa pagbuo, dayalogo, at multi-shot na pagsasalaysay. Para sa tapos na mga video na nangangailangan ng mas pino pang detalye sa biswal, nag-aalok din ang mga suportadong mode ng output na hanggang 4K, na nagbibigay ng mas malinaw na mga tekstura ng produkto, detalye ng karakter, at lalim ng eksena.
Kailangan ko ba ng kasanayan sa pag-e-edit ng video?
Kung nais mong gumawa ng mga pagbabago pagkatapos ng pagbuo, pinapayagan ka ng VIDEO 3.0 Omni editing workflow ng Kling na baguhin ang umiiral na footage gamit ang mga tagubiling natural na wika, kabilang ang pagpapalit ng mga background, mga subject, istilo, o framing.