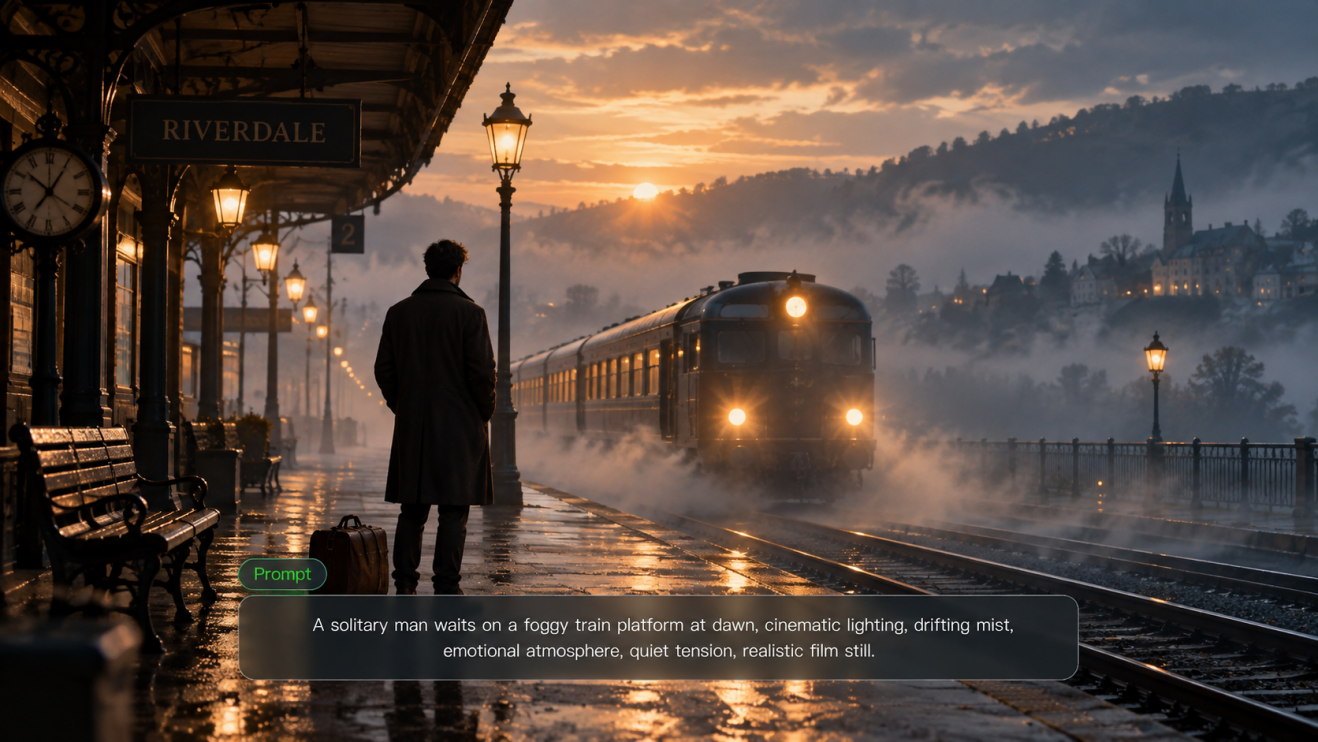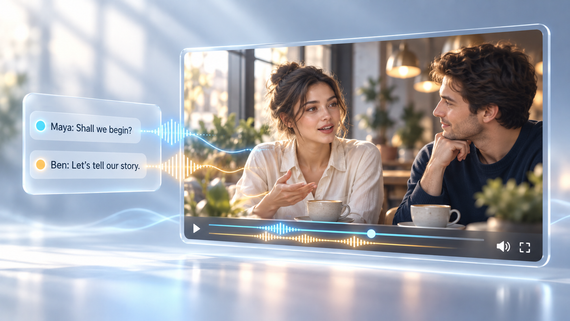
Les modèles texte-vidéo peuvent transformer une scène écrite en vidéo avec mouvements de caméra, son et multiples plans. Le problème, c'est qu'un clip fini peut encore manquer la cible du prompt, se déplacer de manière maladroite, ou laisser un personnage ou un produit changer d'un plan à l'autre. Cet article examine pourquoi ces différences comptent, ce qu'il faut vérifier avant de choisir un modèle, et comment Kling VIDEO 3.0 gère le contrôle des plans, le mouvement, l'audio et la continuité visuelle.
Que sont les modèles texte-vidéo ?
Les modèles texte-vidéo utilisent l'IA générative pour transformer des descriptions en langage naturel en vidéo. Un prompt peut préciser le sujet, le décor, l'action, le mouvement de caméra et le style visuel. Si le modèle prend en charge l'audio, il peut également inclure des dialogues, des sons d'ambiance et d'autres indices audio.
Les modèles texte-vidéo et les générateurs IA texte-vidéo sont souvent considérés comme la même chose, mais ils jouent des rôles différents :
Modèle texte-vidéo | Générateur IA texte-vidéo | |
Ce que c'est | Le système d'IA qui interprète l'invite et génère la vidéo | Le produit ou l'interface que les gens utilisent pour accéder à la génération texte-vers-vidéo |
Ce qu'il gère | Interprétation de l'invite, génération de scènes, mouvement et continuité dans le temps | Fonctionnalités construites autour du modèle, telles que les contrôles de prise de vue, les entrées de référence, l'audio, la durée, le format d'image, le montage et l'export |
Pourquoi c'est important | Le modèle influence directement la qualité vidéo, le mouvement et la cohérence visuelle | Le générateur influe sur le degré de contrôle créatif que vous possédez et sur ce que vous pouvez faire avec la vidéo ensuite |
Le modèle détermine ce qui est généré, tandis qu'un générateur vidéo IA détermine comment vous accédez à ces capacités, contrôlez le processus et travaillez avec la vidéo finale.
Comment fonctionnent les modèles texte-vers-vidéo ?
Les modèles texte-vers-vidéo transforment une invite écrite en une séquence d'images animées. Le processus exact varie selon le modèle, mais il consiste généralement à comprendre l'invite, à construire une représentation compressée de la scène, à déterminer comment les éléments évoluent au fil du temps et à maintenir un résultat cohérent d'un moment à l'autre.
1. Interpréter l'invite
Un modèle text-to-video AI commence par identifier les principales instructions dans l'invite, notamment :
- le sujet
- l'action
- le décor
- le style visuel
- la direction de la caméra
- des dialogues ou d'autres indices audio, lorsque c'est pris en charge
| prompt : “Un cycliste roule dans une rue de centre-ville sous la pluie tandis que la caméra le suit par l’arrière.” |
Cette courte description contient plusieurs instructions qui doivent fonctionner ensemble. Le cycliste avance, la caméra suit depuis l'arrière, et la pluie, la rue, l'éclairage et les environs doivent avoir du sens dans le même plan.
Autrement dit, le prompt décrit plus que ce qui devrait apparaître à l'écran. Il définit également les relations entre le sujet, le mouvement, la caméra et l'environnement.
2. Construire une représentation vidéo compressée
Après lecture du prompt, le système a besoin d'une représentation exploitable de la scène avant qu'elle ne devienne un métrage finalisé. La méthode exacte dépend de l'architecture du modèle.
De nombreux modèles texte-vers-vidéo basés sur la diffusion travaillent dans un espace de représentation compressé plutôt que de traiter des images en pleine résolution dès le départ. Ils commencent avec du bruit et le façonnent progressivement selon le prompt, faisant apparaître le sujet, le décor, l'éclairage, la composition et d'autres détails visuels. Travailler dans cet espace compressé réduit la quantité de données manipulée pendant la génération, et une fois la scène formée, le résultat est décodé en images vidéo visibles.
3. Générer le mouvement et les interactions
La vidéo doit montrer ce qui se passe d'un moment à l'autre. Le modèle doit gérer le mouvement, l'interaction entre les objets et les changements de point de vue sans briser la scène.
- Mouvement : un personnage qui tourne, marche ou tend la main devrait changer de pose et de position étape par étape, plutôt que de passer brutalement d'un état à un autre.
- Interaction avec les objets : les actions doivent suivre un ordre clair. Si quelqu'un prend une tasse, la main doit l'atteindre et entrer en contact avant que la tasse ne bouge.
- Caméra et espace : les panoramiques, les inclinaisons, les travellings avant et les plans de suivi modifient le point de vue, mais le sujet et l'environnement doivent néanmoins rester ancrés dans le même espace.
Une image fixe n'a qu'à décrire un moment. La vidéo doit prendre en compte ce qui se passe entre les moments.
4. Maintenir la cohérence temporelle et audiovisuelle
Au fil de la vidéo, les personnes, les objets et le son doivent rester cohérents dans le temps. Cela se résume principalement à deux types de cohérence :
- Cohérence temporelle : Les personnages, produits, vêtements, accessoires, éclairages et arrière-plans ne devraient pas changer sans raison évidente d'un moment à l'autre. Même après une coupe d'un plan rapproché à un plan large ou un changement d'angle de caméra, la même personne ou le même produit doit rester facile à reconnaître.
- Cohérence audiovisuelle : Le dialogue, les mouvements des lèvres, les expressions faciales, le son d'ambiance et les actions à l'écran doivent se produire au bon moment. Lorsqu'un personnage parle, le mouvement de la bouche doit correspondre au dialogue, tandis que les bruits de pas ou d'impact doivent arriver en même temps que l'action à laquelle ils appartiennent.
À quoi peut servir l'IA de texte en vidéo ?
L'IA de texte en vidéo fonctionne bien dans les situations où une idée doit être visualisée avant qu'il ne vaille la peine de la produire à grande échelle. Elle peut aider aux premiers tests créatifs, aux scènes difficiles à tourner et aux projets qui nécessitent plusieurs orientations visuelles avant le début de la production.
Créer des vidéos pour les réseaux sociaux
Le contenu social a une courte durée de vie, donc organiser un nouveau tournage pour chaque publication ou concept de campagne a rarement du sens. Une invite peut produire des clips pour des teasers, des annonces, des publications de campagne ou de courtes vidéos basées sur une histoire sans reconstruire à chaque fois la configuration de production. Les créateurs peuvent aussi tester différents réglages, mouvements de caméra et directions visuelles avant de se fixer sur une version.
Transformez les idées de produit en vidéos marketing
Les textes publicitaires et maquettes statiques ne montrent pas toujours l’apparence d’un produit lorsqu’il se déplace dans une scène. L’IA texte-vers-vidéo permet aux spécialistes du marketing de placer le même produit dans différents environnements, d’explorer des concepts publicitaires et de tester des traitements visuels plus tôt dans le processus. Si le produit apparaît dans plusieurs plans, les résultats révèlent également dans quelle mesure sa forme, sa couleur et ses détails déterminants restent cohérents d’un plan à l’autre.
Créez de courtes scènes narratives
Il devient plus difficile de planifier une courte histoire dès qu'elle comprend plusieurs plans, des actions de personnages, des changements de caméra et des dialogues. L'IA texte-vidéo peut organiser ces éléments en une séquence, ce qui facilite les tests de l'ordre des plans, du rythme et du minutage des dialogues avant que chaque scène ne soit construite séparément. Cela est particulièrement utile pour les courts formats cinématographiques où l'histoire repose sur plus qu'un seul plan continu.
Visualiser des concepts et des storyboards
Un traitement ou un storyboard peut expliquer ce qui doit se produire, mais le timing et les mouvements de caméra sont plus difficiles à évaluer sur une page statique. Transformer l'idée en mouvement offre aux réalisateurs, designers et équipes créatives une expérience plus proche du rendu final. Ils peuvent comparer les cadrages, tester les transitions et repérer les moments faibles tant que les modifications restent faciles à apporter.
Créer des vidéos éducatives et explicatives
Certains sujets sont difficiles à capturer à la caméra parce qu'ils sont coûteux, abstraits, inaccessibles ou impossibles à mettre en scène. L'IA de texte vers vidéo peut illustrer un processus, reconstituer un décor ou montrer un événement qui ne peut pas être filmé directement. Pour les contenus explicatifs, les supports de formation et les ressources de classe, le mouvement peut rendre un concept plus facile à comprendre lorsqu'une image fixe ne suffit pas.
Comment choisir le meilleur modèle d'IA de texte vers vidéo pour votre projet ?
Aucun modèle d'IA de texte vers vidéo unique ne convient à chaque projet. Commencez par ce que vous voulez créer, puis décidez quelles capacités comptent le plus pour cette tâche. Les principaux éléments à comparer sont l'adhésion au prompt, le mouvement et la plausibilité physique, la cohérence, le contrôle créatif, l'audio, ainsi que les limites de la production et du flux de travail.
Adhésion au prompt
Tout d'abord, vérifiez si le modèle suit réellement l'invite. Le sujet, l'action, le décor, le style visuel et la direction de la caméra devraient tous apparaître ensemble plutôt que seulement les détails les plus évidents. Si vous demandez un cycliste traversant la pluie tandis que la caméra suit par derrière, le cycliste, la météo, le mouvement et le point de vue devraient tous être présents. Ce que le modèle omet peut vous en dire autant que la qualité de finition des séquences.
Mouvement et plausibilité physique
Les actions devraient se dérouler dans un ordre clair. Marcher, tourner, tendre le bras, les collisions et le mouvement de la caméra devraient passer d'un état au suivant sans sauts brusques. L'interaction physique compte également : une main devrait entrer en contact avant qu'un objet ne bouge, un atterrissage devrait affecter le corps, et les cheveux, les tissus, l'eau ou les objets lâches devraient répondre aux mouvements proches au lieu de se comporter de manière autonome.
Cohérence des personnages et des produits
Le même sujet doit rester reconnaissable lorsque le cadrage, l'angle ou la distance change. Les visages, les vêtements, la forme du produit, la couleur, les accessoires, l'éclairage et d'autres détails déterminants ne devraient pas dériver sans raison. Les scènes multi-plans rendent cela plus difficile, donc les projets construits autour de personnages ou de produits récurrents doivent également être vérifiés pour des images de référence, des références de sujet ou une autre manière de transporter l'identité visuelle d'un plan à l'autre.
Contrôle créatif et caméra
Lorsqu'une scène possède déjà une direction visuelle claire, le contrôle compte. Le cadrage, le mouvement de caméra, l'ordre des plans, les entrées de référence, le format d'image et la structure multi-plans influencent tous la fidélité du résultat à l'idée d'origine. Un contrôle plus fin signifie également que vous êtes moins susceptible de relancer toute une séquence simplement pour changer un angle, réorganiser un plan ou corriger la composition.
Prise en charge audio
Les capacités audio varient beaucoup d'un modèle à l'autre. Certains génèrent uniquement des visuels, tandis que d'autres peuvent créer des dialogues, des ambiances sonores et des effets avec les images. Pour les scènes riches en dialogues, vérifiez si la voix, le mouvement de la bouche, l'expression du visage et le timing restent alignés. Les bruits de pas, les impacts et les sons environnementaux doivent également tomber en même temps que l'action à laquelle ils appartiennent.
Durée, résolution et flux de travail
Examinez les limites qui affectent la vidéo finale, notamment la durée de génération, les formats d'image pris en charge, les résolutions disponibles et les options d'exportation. Un court clip pour les réseaux sociaux et une scène produit à plusieurs plans peuvent avoir des exigences de sortie très différentes.
Ce qui se passe après la génération compte tout autant. Pouvez-vous prolonger le clip, réutiliser le même sujet, retoucher un plan, régénérer l'audio ou poursuivre le montage sans tout recommencer ? De petits ajustements ne devraient pas vous obliger à reconstruire toute la séquence.
Différents projets exigent des priorités différentes. Commencez par le type de vidéo que vous réalisez, puis concentrez-vous sur les capacités qui comptent le plus :
Si vous souhaitez créer | Priorisez | Pourquoi c'est important |
Des vidéos sociales courtes | Respect du prompt, rapports d'aspect, flux de travail | Le contenu social évolue rapidement, le rendu doit donc rester proche de l'idée, correspondre aux formats courants des plateformes et être facile à réviser. |
Vidéos de produit et de marketing | Cohérence du produit, respect du prompt, résolution | La forme du produit, sa couleur, son image de marque et ses détails clés doivent rester stables d'un plan à l'autre, tout en garantissant que la séquence finale réponde aux besoins de la campagne ou de la présentation. |
Scènes narratives ou cinématographiques courtes | Mouvement et plausibilité physique, contrôle de la caméra, cohérence multi-plans | Les actions des personnages, les changements de caméra et les transitions de scène doivent s'enchaîner dans toute la séquence sans dérive visuelle évidente. |
Vidéos axées sur le dialogue | Prise en charge audio, synchronisation labiale, cohérence des personnages | Le dialogue, le mouvement de la bouche, l'expressivité du visage et l'identité des personnages doivent rester alignés, tandis que le son doit arriver au bon moment. |
Aperçus de concepts et storyboards | Contrôle créatif et de la caméra, entrées de référence, flexibilité des révisions | L'objectif est de tester le cadrage, la direction de la caméra, le rythme et des idées alternatives dès le début, tant que les modifications sont encore faciles à effectuer. |
Vidéos éducatives et explicatives | Respect du prompt, mouvement et plausibilité physique, flux de travail | Les visuels doivent expliquer un processus ou une idée avec précision, maintenir un mouvement facile à suivre et permettre des révisions lorsque le contenu change. |
Que pouvez-vous faire avec Kling VIDEO 3.0 ?
La partie difficile de la génération texte-vers-vidéo n'est pas d'obtenir un seul plan réussi. C'est de faire en sorte que le sujet, l'action, la direction de la caméra, le son et les petits détails visuels du prompt apparaissent comme vous l'aviez prévu. À mesure que les prompts deviennent plus détaillés et que les scènes ajoutent davantage de plans, le modèle doit suivre un nombre croissant d'éléments d'un moment à l'autre.
Kling VIDEO 3.0 est conçu pour répondre à ces exigences, avec une interprétation des prompts plus robuste, une narration multi-plans, une cohérence des sujets, un son natif, une durée flexible et un rendu du texte. Plutôt que d'écrire une description et d'attendre simplement de voir ce qui revient, vous pouvez façonner la manière dont l'histoire se déroule, à quel moment la caméra change, comment les sujets sont maintenus d'un plan à l'autre, et où le son entre en scène.
Comprendre et suivre les prompts avec plus de précision
Kling VIDEO 3.0 peut interpréter des prompts à plusieurs niveaux qui combinent sujets, actions, décors, indications de caméra et structure narrative. Cela aide les prompts texte-vers-vidéo complexes à rester plus proches de la scène prévue, en particulier lorsqu'ils impliquent plusieurs actions, des mouvements de caméra planifiés ou une séquence d'événements spécifique.
Maintenir la cohérence des personnages et des produits d'un plan à l'autre
Un personnage peut paraître correct dans un plan et pourtant changer de manière perceptible sous un autre angle. Dans une vidéo multi-plans, les visages peuvent se déplacer, les détails des vêtements peuvent dériver, et la couleur, la forme ou les caractéristiques distinctives d’un produit peuvent changer d’un plan à l’autre.
Dans les flux de travail VIDEO 3.0 assistés par référence pris en charge, vous pouvez utiliser plusieurs images de référence pour fournir des indications visuelles supplémentaires et aider à ancrer un personnage récurrent, un produit ou un autre sujet clé malgré les changements de cadrage, d’angle et de décor. Ces références donnent au modèle davantage d’informations sur l’apparence du sujet et sur ses principaux détails visuels, ce qui contribue à réduire la dérive visuelle évidente dans les scènes à personnage récurrent, les plans produits et les contenus de marque.

Construisez des histoires multi-plans avec un contrôle accru du rythme
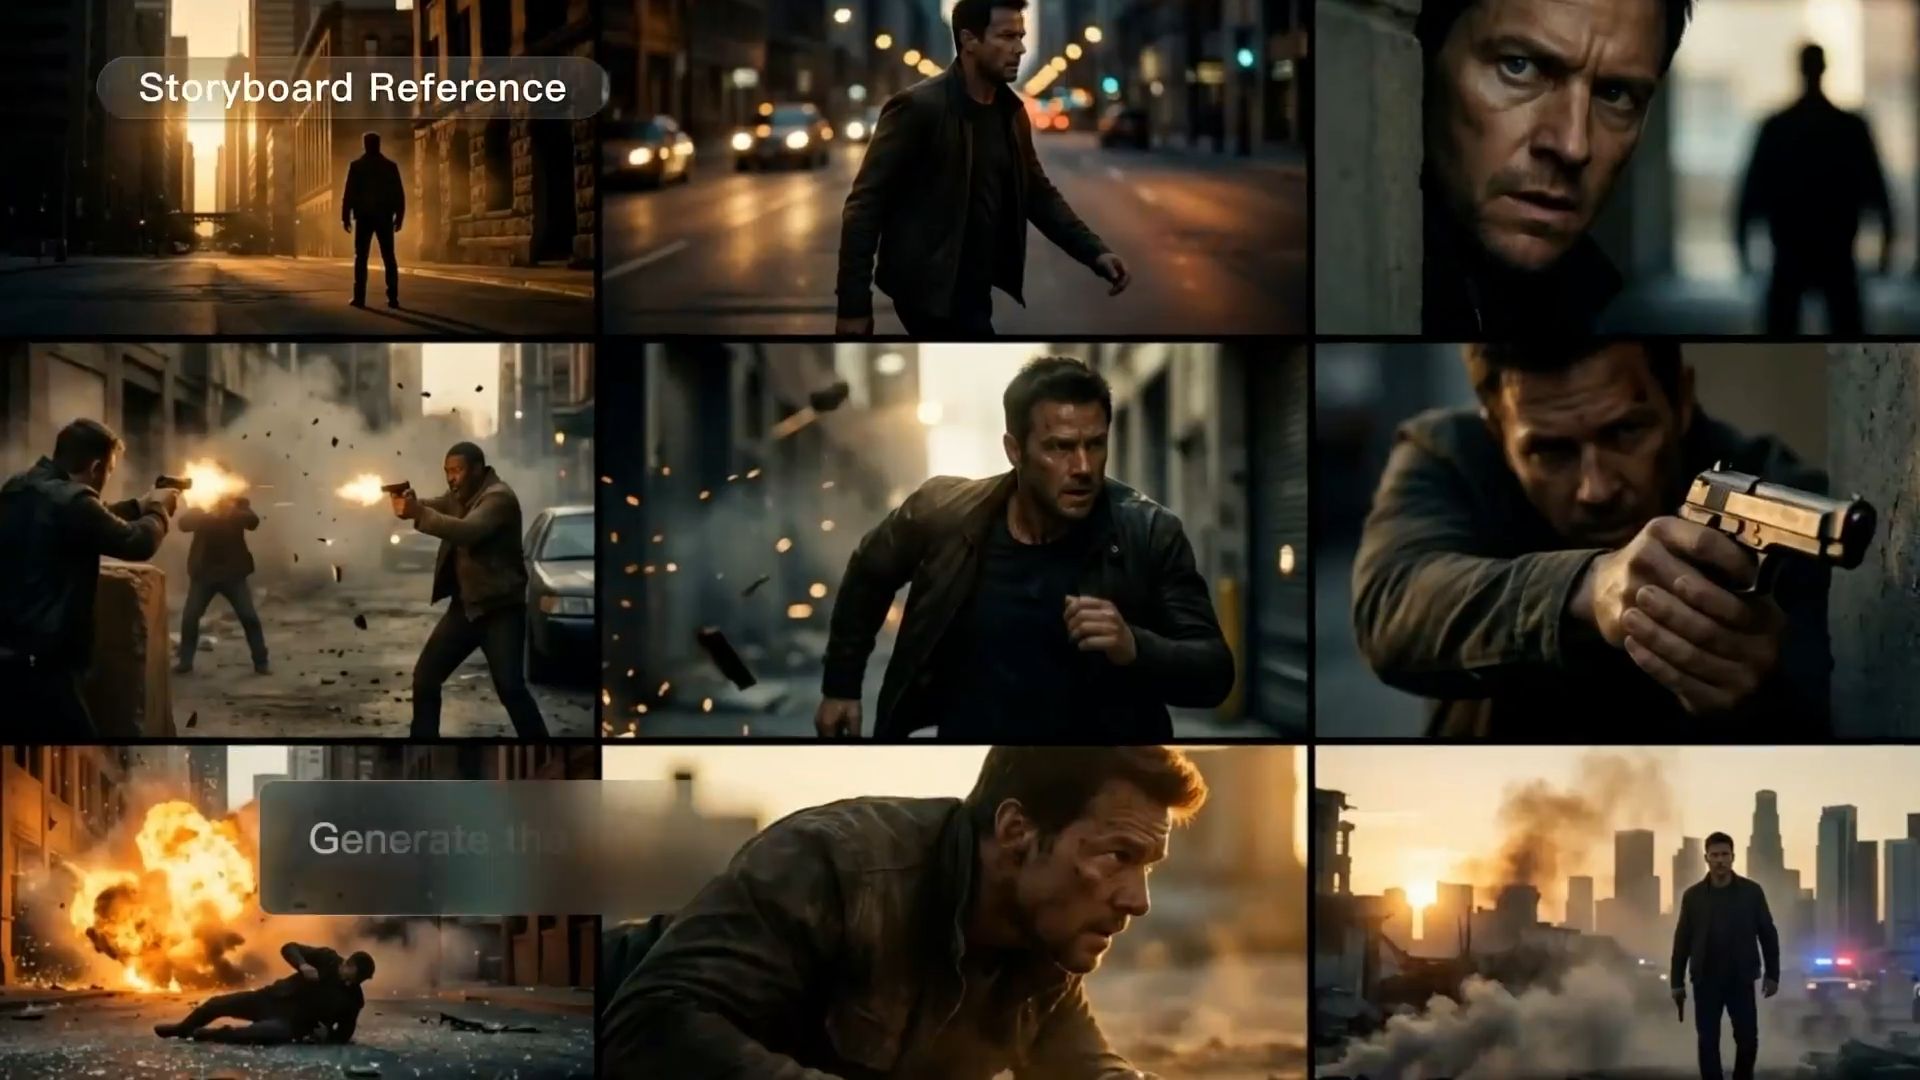
Un seul plan est généralement gérable. Le défi commence lorsqu'une histoire a besoin de plans rapprochés, de plans larges, de différentes positions de caméra et de changements de scène. Générer chaque plan séparément signifie davantage d'assemblage ensuite, et il devient plus difficile de maintenir le rythme et la continuité sur l'ensemble de la séquence.
La fonctionnalité Multi-Shot de Kling VIDEO 3.0 peut gérer plusieurs plans en une seule génération, transformant une simple invite en une séquence liée plutôt qu'en un ensemble de clips isolés. Pour une séquence planifiée, Custom Multi-Shot vous permet de définir le contenu, l'ordre et la durée de chaque plan, de sorte que les coupes et le rythme soient fixés avant le début de la génération.
Générez ensemble le dialogue et le son de la scène
Lorsqu'un modèle vidéo ne produit que des visuels, les scènes de dialogue exigent un travail supplémentaire. Les voix, le son ambiant, les effets et le timing doivent tous être gérés après coup. Ajoutez plusieurs personnages, et il faut aussi suivre qui prononce chaque réplique et vérifier si le son correspond à la bonne action à l'écran.
La fonction Native Audio de Kling VIDEO 3.0 génère dialogues, ambiance sonore et autres éléments audio avec la vidéo. Dans des scènes à plusieurs personnages, vous pouvez attribuer des répliques à différents locuteurs, avec prise en charge du chinois, de l'anglais, du japonais, du coréen et de l'espagnol, ainsi que des dialectes et accents pris en charge. La voix, l'interprétation des personnages et le son des scènes sont intégrés dans la même génération, plutôt que d'être superposés ultérieurement sur un clip muet.
Créez des histoires plus longues avec jusqu'à 15 secondes et une sortie 4K
Kling VIDEO 3.0 offre aux créateurs plus de marge pour développer chaque scène, avec une génération flexible de 3 à 15 secondes pour les interactions entre personnages, les récits multi-plans, les dialogues et les transitions. Dans les flux de travail pris en charge, une sortie pouvant atteindre 4K préserve les détails les plus fins, les textures et la clarté visuelle globale, aidant les créateurs à passer des premiers concepts à des contenus aboutis pour la publicité, les présentations de produits, les récits cinématographiques et plus encore.
La fin
Les modèles texte-vers-vidéo qui valent votre temps font plus que simplement animer une invite : ils suivent votre intention, se déplacent naturellement, arrivent avec du son et maintiennent un sujet stable d’un plan à l’autre. Mesuré selon ces critères, Kling VIDEO 3.0 réunit la génération guidée par invite, le contrôle Multi-Shot, la cohérence du sujet et l’audio natif en un seul endroit. Ouvrez Kling, écrivez votre scène, et regardez-la prendre vie en une seule génération.
FAQ
Comment choisir parmi les meilleurs modèles d’IA texte-vers-vidéo en 2026 ?
Commencez par définir le type de vidéo que vous souhaitez réaliser, puis comparez les modèles en fonction de cette tâche. La narration multi-plan met davantage l'accent sur le contrôle de la caméra et la cohérence des personnages. Les scènes riches en dialogues exigent un audio solide, une synchronisation labiale et une performance des personnages convaincante, tandis que les travaux autour des produits et des publicités dépendent davantage du respect du prompt, de la stabilité du sujet et de la qualité de sortie. La durée et la résolution comptent également, car un test rapide et une pièce finalisée n'ont que rarement les mêmes exigences. Kling VIDEO 3.0 combine Multi-Shot, Native Audio, le respect du prompt et une génération allant jusqu'à 15 secondes pour les histoires multi-plan, les scènes portées par les dialogues et les projets où le même personnage ou produit doit rester reconnaissable d'un plan à l'autre.
La conversion texte en vidéo par l'IA peut-elle inclure du son ?
Oui. Kling VIDEO 3.0 peut générer des dialogues, des sons d'ambiance et des effets en même temps que la vidéo, vous n'avez donc pas besoin d'ajouter l'audio après coup. Vous pouvez écrire les répliques directement dans le prompt, les attribuer à des personnages spécifiques et choisir la langue, le dialecte ou l'accent. Sa capacité text-to-speech peut transformer ces répliques en voix de personnages en chinois, en anglais, en japonais, en coréen et en espagnol. Cela signifie moins de travail de voix off séparé et moins d'assemblage audio après la génération de la vidéo.
Quelle peut être la durée d'une vidéo générée ?
La durée de la vidéo varie selon le modèle. Kling VIDEO 3.0 prend en charge une génération flexible de 3 à 15 secondes. Les clips plus courts fonctionnent bien pour des actions rapides et du contenu social, tandis que les clips plus longs laissent plus de temps pour la montée en puissance, les dialogues et la narration multi-plans. Pour des vidéos finalisées nécessitant des détails visuels plus fins, les modes pris en charge offrent également une sortie jusqu'en 4K, offrant davantage de clarté aux textures des produits, aux détails des personnages et à la profondeur des scènes.
Ai-je besoin de compétences en montage vidéo ?
Si vous souhaitez effectuer des modifications après la génération, le flux de travail d'édition VIDEO 3.0 Omni de Kling vous permet de modifier des séquences existantes à l'aide d'instructions en langage naturel, y compris changer les arrière-plans, les sujets, le style ou le cadrage.