टेक्स्ट-टू-वीडियो मॉडल किसी लिखित दृश्य को कैमरा मूवमेंट, साउंड और कई शॉट्स के साथ वीडियो में बदल सकते हैं। लेकिन समस्या यह है कि तैयार क्लिप फिर भी प्रॉम्प्ट से भटक सकती है, अटपटा मूव कर सकती है, या एक शॉट से अगले शॉट तक किसी चरित्र या प्रोडक्ट को बदलने दे सकती है। यह लेख बताता है कि ये अंतर क्यों मायने रखते हैं, मॉडल चुनने से पहले क्या जांचना चाहिए, और Kling VIDEO 3.0 शॉट नियंत्रण, मोशन, ऑडियो और विज़ुअल निरंतरता को कैसे संभालता है।
टेक्स्ट-टू-वीडियो मॉडल क्या हैं?
टेक्स्ट-टू-वीडियो मॉडल जनरेटिव AI का उपयोग प्राकृतिक भाषा के वर्णनों को वीडियो में बदलने के लिए करते हैं। कोई प्रॉम्प्ट विषय, सेटिंग, क्रिया, कैमरा मूवमेंट और विज़ुअल स्टाइल निर्दिष्ट कर सकता है। यदि मॉडल ऑडियो को सपोर्ट करता है, तो वह संवाद, माहौल की आवाज़ें और अन्य ऑडियो संकेत भी शामिल कर सकता है।
टेक्स्ट-टू-वीडियो मॉडल और टेक्स्ट-टू-वीडियो AI जेनरेटर को अक्सर एक ही चीज़ माना जाता है, लेकिन उनकी भूमिकाएँ अलग होती हैं:
टेक्स्ट-टू-वीडियो मॉडल | टेक्स्ट-टू-वीडियो AI जेनरेटर | |
यह क्या है | प्रॉम्प्ट को समझने और वीडियो उत्पन्न करने वाला AI सिस्टम | वह उत्पाद या इंटरफ़ेस जिसका उपयोग लोग टेक्स्ट-टू-वीडियो जनरेशन तक पहुँचने के लिए करते हैं |
यह क्या संभालता है | प्रॉम्प्ट की व्याख्या, दृश्य निर्माण, गति, और समय के साथ निरंतरता | मॉडल के आसपास निर्मित फीचर्स, जैसे शॉट नियंत्रण, संदर्भ इनपुट, ऑडियो, अवधि, आस्पेक्ट अनुपात, संपादन, और एक्सपोर्ट |
यह क्यों महत्वपूर्ण है | मॉडल वीडियो की गुणवत्ता, गति, और दृश्य संगतता पर सीधे असर डालता है | जनरेटर यह प्रभावित करता है कि आपके पास कितना रचनात्मक नियंत्रण है और आप बाद में वीडियो के साथ क्या कर सकते हैं। |
मॉडल तय करता है कि क्या उत्पन्न होगा, जबकि एक AI वीडियो जनरेटर यह निर्धारित करता है कि आप उन क्षमताओं तक कैसे पहुँचते हैं, प्रक्रिया को कैसे नियंत्रित करते हैं, और तैयार वीडियो के साथ कैसे काम करते हैं।
टेक्स्ट-टू-वीडियो मॉडल कैसे काम करते हैं?
टेक्स्ट-टू-वीडियो मॉडल एक लिखित प्रॉम्प्ट को चलती छवियों की श्रृंखला में बदल देते हैं। सटीक प्रक्रिया मॉडल के अनुसार बदलती है, लेकिन आम तौर पर इसमें प्रॉम्प्ट को समझना, दृश्य का एक संपीड़ित निरूपण बनाना, यह समझना शामिल होता है कि समय के साथ चीजें कैसे बदलती हैं, और परिणाम को पल-पल एकसमान बनाए रखना।
1. प्रॉम्प्ट की व्याख्या करें
एक टेक्स्ट-टू-वीडियो AI मॉडल प्रॉम्प्ट में मुख्य निर्देशों की पहचान से शुरुआत करता है, जिनमें शामिल हैं:
- विषय
- क्रिया
- परिदृश्य
- दृश्य शैली
- कैमरे की दिशा
- संवाद या अन्य ऑडियो संकेत, जब समर्थित हों
| प्रॉम्प्ट: "एक साइकिल सवार बारिश से भीगी डाउनटाउन सड़क से गुजरता है जबकि कैमरा पीछे से उसका पीछा करता है।" |
उस संक्षिप्त विवरण में कई निर्देश शामिल हैं जिन्हें साथ मिलकर काम करना होता है। साइकिल सवार आगे बढ़ता है, कैमरा पीछे से पीछा करता है, और बारिश, सड़क, प्रकाश और परिवेश को उसी शॉट में तार्किक रूप से मेल खाना चाहिए।
अन्य शब्दों में, प्रॉम्प्ट स्क्रीन पर दिखाई देने वाली चीज़ों से अधिक का वर्णन करता है। यह विषय, गति, कैमरा और परिवेश के बीच संबंध भी निर्धारित करता है।
2. संकुचित वीडियो प्रतिनिधित्व बनाएँ
प्रॉम्प्ट पढ़ने के बाद, सिस्टम को दृश्य का एक उपयोगी निरूपण चाहिए, इससे पहले कि वह तैयार फुटेज बन जाए। सटीक तरीका मॉडल की आर्किटेक्चर पर निर्भर करता है।
कई डिफ्यूज़न-आधारित टेक्स्ट-टू-वीडियो मॉडल शुरुआत से पूर्ण-रिज़ॉल्यूशन फ़्रेम संसाधित करने के बजाय एक संपीड़ित निरूपण स्थान में काम करते हैं। वे शोर से शुरू करते हैं और धीरे-धीरे उसे प्रॉम्प्ट के अनुसार आकार देते हैं, जिससे विषय, सेटिंग, प्रकाश व्यवस्था, संरचना और अन्य दृश्य विवरण सामने आते हैं। इस संपीड़ित स्थान में काम करने से जनरेशन के दौरान संभाले जाने वाले डेटा की मात्रा कम हो जाती है, और एक बार दृश्य आकार ले लेता है, तो परिणाम को दृश्यमान वीडियो फ़्रेमों में डिकोड किया जाता है।
3. गति और पारस्परिक क्रियाएँ उत्पन्न करें
वीडियो को यह दिखाना होता है कि एक पल से अगले पल तक क्या होता है। मॉडल को आंदोलन, वस्तु पारस्परिक क्रिया और दृश्य को बिगाड़े बिना दृष्टिकोण में बदलाव को संभालना होता है।
- गतिविधि: कोई पात्र मुड़ते, चलते या हाथ बढ़ाते समय एक अवस्था से दूसरी पर झटके से जाने के बजाय चरणबद्ध तरीके से मुद्रा और स्थिति बदलना चाहिए।
- वस्तु के साथ परस्पर क्रिया: क्रियाओं का स्पष्ट क्रम होना जरूरी है। यदि कोई व्यक्ति कप उठाता है, तो हाथ को पहले कप तक पहुँचकर उससे संपर्क करना चाहिए, उसके बाद ही कप हिलना चाहिए।
- कैमरा और स्थान: पैन, टिल्ट, पुश-इन और ट्रैकिंग शॉट दृष्टिकोण बदलते हैं, लेकिन विषय और परिवेश को फिर भी उसी स्थान में स्थिर रहना चाहिए।
एक स्थिर छवि को केवल एक क्षण का वर्णन करना होता है। वीडियो को क्षणों के बीच क्या होता है, इसका भी ध्यान रखना पड़ता है।
4. समयगत और ऑडियो-विजुअल संगति बनाए रखें
जैसे-जैसे वीडियो आगे बढ़ता है, लोगों, वस्तुओं और ध्वनि को समय के साथ संगत रहना चाहिए। यह मुख्य रूप से दो प्रकार की संगति पर निर्भर करता है:
- कालिक स्थिरता: पात्र, उत्पाद, परिधान, प्रॉप्स, प्रकाश, और पृष्ठभूमियाँ बिना किसी स्पष्ट कारण एक क्षण से अगले क्षण तक नहीं बदलनी चाहिए। क्लोज़-अप से वाइड शॉट पर कट होने पर या कैमरा कोण बदलने के बाद भी, उसी व्यक्ति या उत्पाद को अभी भी आसानी से पहचाना जा सके।
- ऑडियो-विज़ुअल स्थिरता: संवाद, होंठों की गति, चेहरे के हावभाव, परिवेशी ध्वनि, और ऑन-स्क्रीन क्रियाएँ सही समय पर घटित होनी चाहिए। जब कोई किरदार बोलता है, तो मुंह की गति संवाद से मेल खानी चाहिए, जबकि कदमों की आहट या प्रभाव की ध्वनियाँ उसी क्रिया के साथ होनी चाहिए जिनसे वे संबंधित हैं।
आप Text-to-video AI का उपयोग किस लिए कर सकते हैं?
Text-to-video AI उन स्थितियों में अच्छी तरह काम करती है जहाँ किसी विचार को बड़े पैमाने पर उत्पादन करने से पहले देखना आवश्यक हो। यह प्रारंभिक रचनात्मक परीक्षण, ऐसे दृश्य जो शूट करना कठिन है, और उन परियोजनाओं में मदद कर सकती है जिन्हें उत्पादन शुरू होने से पहले कई दृश्य दिशाओं की आवश्यकता होती है।
सोशल मीडिया वीडियो बनाएं
सोशल कंटेंट की शेल्फ लाइफ छोटी होती है, इसलिए हर पोस्ट या अभियान अवधारणा के लिए नया शूट आयोजित करना शायद ही समझ में आता है. एक प्रॉम्प्ट टीज़रों, घोषणाओं, अभियान पोस्टों या छोटी कहानी-प्रधान वीडियो के लिए क्लिप तैयार कर सकता है, बिना हर बार प्रोडक्शन सेटअप को फिर से बनाने की ज़रूरत के. क्रिएटर्स किसी एक संस्करण पर ठहरने से पहले विभिन्न सेटिंग्स, कैमरा मूव्स और दृश्य निर्देशों को भी आज़मा सकते हैं.
उत्पाद विचारों को मार्केटिंग वीडियो में बदलें
कॉपी और स्थिर मॉकअप हमेशा यह नहीं दिखाते कि किसी दृश्य में चलते समय उत्पाद कैसा दिखाई देगा. टेक्स्ट-टू-वीडियो AI मार्केटर्स को उसी उत्पाद को अलग-अलग परिवेशों में रखने, विज्ञापन अवधारणाओं का पता लगाने, और प्रक्रिया के शुरुआती चरण में दृश्य उपचारों का परीक्षण करने देता है. यदि उत्पाद कई शॉट्स में दिखाई देता है, तो परिणाम यह भी बताते हैं कि एक शॉट से अगले शॉट तक उसकी आकृति, रंग और परिभाषित विवरण कितनी अच्छी तरह टिके रहते हैं.
संक्षिप्त कथात्मक दृश्य बनाएं
एक लघु कहानी की योजना बनाना तब कठिन हो जाता है जब उसमें कई शॉट, चरित्र क्रियाएँ, कैमरा परिवर्तन और संवाद शामिल हो जाते हैं। Text-to-video AI उन तत्वों को एक अनुक्रम में मैप कर सकता है, जिससे प्रत्येक दृश्य को अलग-अलग बनाने से पहले शॉट क्रम, गति और संवाद टाइमिंग का परीक्षण करना आसान हो जाता है। यह विशेष रूप से छोटे सिनेमैटिक हिस्सों के लिए उपयोगी है जहाँ कहानी एक ही निरंतर शॉट से अधिक पर निर्भर करती है।
अवधारणाओं और स्टोरीबोर्ड को दृश्य रूप दें
एक ट्रीटमेंट या स्टोरीबोर्ड यह समझा सकता है कि क्या होना चाहिए, लेकिन समय-निर्धारण और कैमरा मूवमेंट को स्थिर पृष्ठ पर जाँचना मुश्किल होता है। विचार को गति में बदल देने से निर्देशकों, डिजाइनरों और क्रिएटिव टीमों को अंतिम देखने के अनुभव के अधिक निकट कुछ मिलता है। वे फ्रेमिंग की तुलना कर सकते हैं, ट्रांज़िशन का परीक्षण कर सकते हैं, और कमज़ोर क्षणों को पकड़ सकते हैं, जबकि बदलाव करना अभी भी आसान होता है।
शैक्षिक और व्याख्यात्मक वीडियो बनाएं
कुछ विषयों को कैमरे पर कैप्चर करना कठिन होता है क्योंकि वे महंगे, अमूर्त, अप्राप्य, या मंचित करना असंभव होते हैं। टेक्स्ट-टू-वीडियो AI किसी प्रक्रिया को दर्शा सकता है, किसी सेटिंग का पुनर्निर्माण कर सकता है, या ऐसी घटना दिखा सकता है जिसे सीधे फिल्माया नहीं जा सकता। व्याख्यात्मक सामग्री, प्रशिक्षण सामग्री, और कक्षा की सामग्री में, जब एक स्थिर छवि पर्याप्त जानकारी नहीं दिखाती, तब गति किसी अवधारणा को समझना आसान बना सकती है।
अपने प्रोजेक्ट के लिए सर्वश्रेष्ठ टेक्स्ट-टू-वीडियो AI मॉडल कैसे चुनें?
प्रत्येक प्रोजेक्ट के लिए कोई एकल टेक्स्ट-टू-वीडियो AI मॉडल उपयुक्त नहीं होता। आप क्या बनाना चाहते हैं, इससे शुरुआत करें, फिर तय करें कि उस काम के लिए किन क्षमताओं का सबसे अधिक महत्व है। तुलना करने के प्रमुख घटक हैं प्रॉम्प्ट का पालन, गति और भौतिक सम्मतता, स्थिरता, क्रिएटिव नियंत्रण, ऑडियो, और आउटपुट तथा वर्कफ़्लो की सीमाएँ।
प्रॉम्प्ट का पालन
सबसे पहले, जांचें कि मॉडल वास्तव में प्रॉम्प्ट का पालन करता है या नहीं। विषय, क्रिया, सेटिंग, दृश्य शैली और कैमरा दिशा सभी एक साथ दिखाई देने चाहिए, न कि केवल सबसे स्पष्ट विवरण। यदि आप बारिश में साइकिल चला रहे साइकिल चालक के लिए कहते हैं जबकि कैमरा पीछे से पीछा करता है, तो सवार, मौसम, गति और दृष्टिकोण सभी वहाँ होने चाहिए। फुटेज कितनी परिष्कृत दिखती है, यह जितना बताती है, मॉडल जो छोड़ देता है, वह भी उतना ही बता सकता है।
गति और भौतिक विश्वसनीयता
क्रियाओं को स्पष्ट क्रम में आगे बढ़ना चाहिए। चलना, मुड़ना, हाथ बढ़ाना, टक्करों और कैमरा मूवमेंट को अचानक छलांग के बिना एक अवस्था से अगली अवस्था की ओर बढ़ना चाहिए। भौतिक अंतःक्रिया भी महत्वपूर्ण है: किसी वस्तु के हिलने से पहले हाथ को संपर्क करना चाहिए, लैंडिंग का शरीर पर प्रभाव होना चाहिए, और बाल, कपड़ा, पानी या ढीली वस्तुओं को अपने आप व्यवहार करने के बजाय आसपास की गति पर प्रतिक्रिया देनी चाहिए।
चरित्र और उत्पाद स्थिरता
फ्रेमिंग, कोण या दूरी बदलने पर भी वही विषय पहचानने योग्य बना रहना चाहिए। चेहरों, वस्त्र, उत्पाद के आकार, रंग, प्रॉप्स, प्रकाश व्यवस्था और अन्य परिभाषित विवरणों को बिना कारण भटकना नहीं चाहिए। मल्टी-शॉट दृश्यों में यह कठिन हो जाता है, इसलिए आवर्ती पात्रों या उत्पादों पर आधारित परियोजनाओं में भी संदर्भ छवियों, विषय संदर्भों या शॉट से शॉट तक दृश्य पहचान बनाए रखने के दूसरे तरीकों की जांच करनी चाहिए।
रचनात्मक और कैमरा नियंत्रण
जब किसी दृश्य की दृश्य दिशा पहले से स्पष्ट हो, तो नियंत्रण मायने रखता है। फ्रेमिंग, कैमरा मूवमेंट, शॉट क्रम, संदर्भ इनपुट, आस्पेक्ट अनुपात, और मल्टी-शॉट संरचना इस बात को प्रभावित करते हैं कि परिणाम मूल विचार से कितना मेल खाता है। अधिक सूक्ष्म नियंत्रण का मतलब यह भी है कि आपको केवल कोण बदलने, शॉट को पुनः क्रमबद्ध करने या संयोजन सुधारने के लिए पूरे अनुक्रम को फिर से चलाने की संभावना कम होती है।
ऑडियो समर्थन
ऑडियो क्षमताएँ मॉडलों के बीच काफी भिन्न होती हैं। कुछ केवल दृश्य ही उत्पन्न करते हैं, जबकि अन्य फुटेज के साथ संवाद, परिवेश ध्वनि और प्रभाव बना सकते हैं। संवाद-प्रधान दृश्यों के लिए, यह जाँचें कि आवाज़, मुख की गति, चेहरे का हावभाव और टाइमिंग समन्वित बने रहते हैं या नहीं। कदमों की आवाज़, टकराव और पर्यावरणीय ध्वनियाँ भी उसी क्रिया के साथ मेल खानी चाहिए जिनसे वे संबंधित हैं।
अवधि, रिज़ॉल्यूशन, और वर्कफ़्लो
उन सीमाओं को देखें जो अंतिम वीडियो को प्रभावित करती हैं, जिनमें निर्माण की अवधि, समर्थित आस्पेक्ट अनुपात, उपलब्ध रिज़ॉल्यूशन और निर्यात विकल्प शामिल हैं। एक छोटा सोशल क्लिप और एक बहु-शॉट उत्पाद दृश्य की आउटपुट आवश्यकताएँ बहुत अलग हो सकती हैं।
निर्माण के बाद क्या होता है, यह भी उतना ही महत्वपूर्ण है। क्या आप क्लिप को बढ़ा सकते हैं, उसी विषय को फिर से उपयोग कर सकते हैं, किसी एक शॉट को संशोधित कर सकते हैं, ऑडियो को फिर से बना सकते हैं, या बिना शुरुआत से शुरू किए संपादन जारी रख सकते हैं? छोटे बदलावों को आपको पूरी सीक्वेंस फिर से बनाने के लिए मजबूर नहीं करना चाहिए।
विभिन्न परियोजनाओं के लिए विभिन्न प्राथमिकताएँ आवश्यक होती हैं। आप जो वीडियो बना रहे हैं, उसके प्रकार से शुरू करें, फिर उन क्षमताओं पर ध्यान केंद्रित करें जो सबसे अधिक मायने रखती हैं:
यदि आप बनाना चाहते हैं | प्राथमिकता दें | यह क्यों महत्वपूर्ण है |
लघु सोशल वीडियो | प्रॉम्प्ट अनुपालन, आस्पेक्ट अनुपात, वर्कफ़्लो | सोशल सामग्री तेजी से आगे बढ़ती है, इसलिए आउटपुट को विचार के करीब रहना, सामान्य प्लेटफ़ॉर्म फ़ॉर्मेट में फिट होना और संशोधन करने में आसान होना चाहिए। |
उत्पाद और मार्केटिंग वीडियो | उत्पाद संगति, प्रॉम्प्ट अनुपालन, रेज़ोल्यूशन | उत्पाद का आकार, रंग, ब्रांडिंग और प्रमुख विवरण शॉट्स के दौरान स्थिर रहने चाहिए, जबकि अंतिम फुटेज फिर भी अभियान या प्रस्तुति की आवश्यकताओं को पूरा करे। |
लघु कथात्मक या सिनेमैटिक दृश्य | मोशन और भौतिक यथार्थता, कैमरा नियंत्रण, मल्टी-शॉट संगति | किरदारों की क्रियाएं, कैमरा परिवर्तन, और दृश्य संक्रमणों को पूरे अनुक्रम में बिना किसी स्पष्ट दृश्य विचलन के आपस में जुड़े रहना चाहिए। |
संवाद-प्रधान वीडियो | ऑडियो समर्थन, लिप सिंक, किरदार की संगति | संवाद, मुंह की गति, चेहरे का प्रदर्शन, और किरदार की पहचान को एकसमान रहना चाहिए, जबकि ध्वनि सही समय पर पहुंचनी चाहिए। |
कॉन्सेप्ट प्रीव्यू और स्टोरीबोर्ड | रचनात्मक और कैमरा नियंत्रण, संदर्भ इनपुट, संशोधन में लचीलापन | उद्देश्य यह है कि जब बदलाव करना अभी भी आसान हो, तब फ्रेमिंग, कैमरा दिशा, गति और वैकल्पिक विचारों का जल्द परीक्षण किया जाए। |
शैक्षणिक और व्याख्यात्मक वीडियो | प्रॉम्प्ट अनुपालन, गति और भौतिक संभाव्यता, कार्यप्रवाह | दृश्य सामग्री को किसी प्रक्रिया या विचार को सटीक रूप से समझाना चाहिए, गति को आसानी से अनुसरणीय रखना चाहिए, और जब सामग्री बदलती है तो संशोधन की अनुमति देनी चाहिए। |
Kling VIDEO 3.0 के साथ आप क्या कर सकते हैं?
टेक्स्ट-टू-वीडियो का कठिन भाग किसी एक आकर्षक शॉट को पाना नहीं है। चुनौती यह है कि प्रॉम्प्ट में बताए गए विषय, क्रिया, कैमरा दिशा, ध्वनि और सूक्ष्म दृश्य विवरण उसी तरह प्रकट हों जैसा आपने इरादा किया था। जैसे-जैसे प्रॉम्प्ट अधिक विस्तृत होते जाते हैं और दृश्यों में अधिक शॉट जुड़ते जाते हैं, मॉडल को एक क्षण से अगले क्षण तक और अधिक तत्वों पर निगरानी रखनी पड़ती है।
Kling VIDEO 3.0 उन मांगों के इर्द-गिर्द बनाया गया है, जिसमें अधिक मजबूत प्रॉम्प्ट व्याख्या, मल्टी-शॉट कहानी कहने, विषय की सुसंगतता, नेटिव ऑडियो, लचीली अवधि और टेक्स्ट रेंडरिंग शामिल हैं। विवरण लिखकर और सिर्फ यह देखने के लिए प्रतीक्षा करने के बजाय कि क्या वापस आता है, आप यह आकार दे सकते हैं कि कहानी कैसे खुलती है, कैमरा कब बदलता है, विषय शॉट्स में कैसे आगे बढ़ते हैं, और ध्वनि दृश्य में कहाँ प्रवेश करती है।
प्रॉम्प्ट को अधिक सटीकता से समझें और उनका पालन करें
Kling VIDEO 3.0 स्तरीय प्रॉम्प्ट की व्याख्या कर सकता है जो विषयों, क्रियाओं, सेटिंग्स, कैमरा दिशा और नैरेटिव संरचना को जोड़ते हैं। यह जटिल टेक्स्ट-से-वीडियो प्रॉम्प्ट को इच्छित दृश्य के करीब बनाए रखने में मदद करता है, खासकर जब उनमें कई क्रियाएँ, योजनाबद्ध कैमरा मूव्स या घटनाओं का एक विशिष्ट क्रम शामिल होता है।
शॉट्स के बीच पात्रों और उत्पादों को सुसंगत रखें
एक पात्र एक शॉट में सही दिख सकता है और फिर भी दूसरे कोण से देखने पर स्पष्ट रूप से बदल सकता है। मल्टी-शॉट वीडियो में, चेहरे बदल सकते हैं, कपड़ों के विवरण भटक सकते हैं, और किसी उत्पाद का रंग, आकार या परिभाषित विशेषताएँ एक शॉट से अगले शॉट तक बदल सकती हैं।
समर्थित संदर्भ-सहायता प्राप्त VIDEO 3.0 कार्यप्रवाहों में, आप कई संदर्भ चित्रों का उपयोग अतिरिक्त दृश्य मार्गदर्शन देने और बदलते फ्रेमिंग, कोण और सेटिंग में एक बार-बार आने वाले पात्र, उत्पाद या अन्य प्रमुख विषय को स्थिर रखने में मदद करने के लिए कर सकते हैं। ये संदर्भ मॉडल को विषय के स्वरूप और मुख्य दृश्य विवरणों के बारे में अधिक जानकारी देते हैं, जिससे बार-बार आने वाले पात्र वाले दृश्यों, उत्पाद शॉट्स और ब्रांडेड सामग्री में स्पष्ट दृश्य भटकाव कम करने में मदद मिलती है।

गति पर अधिक नियंत्रण के साथ मल्टी-शॉट कहानियाँ बनाएँ
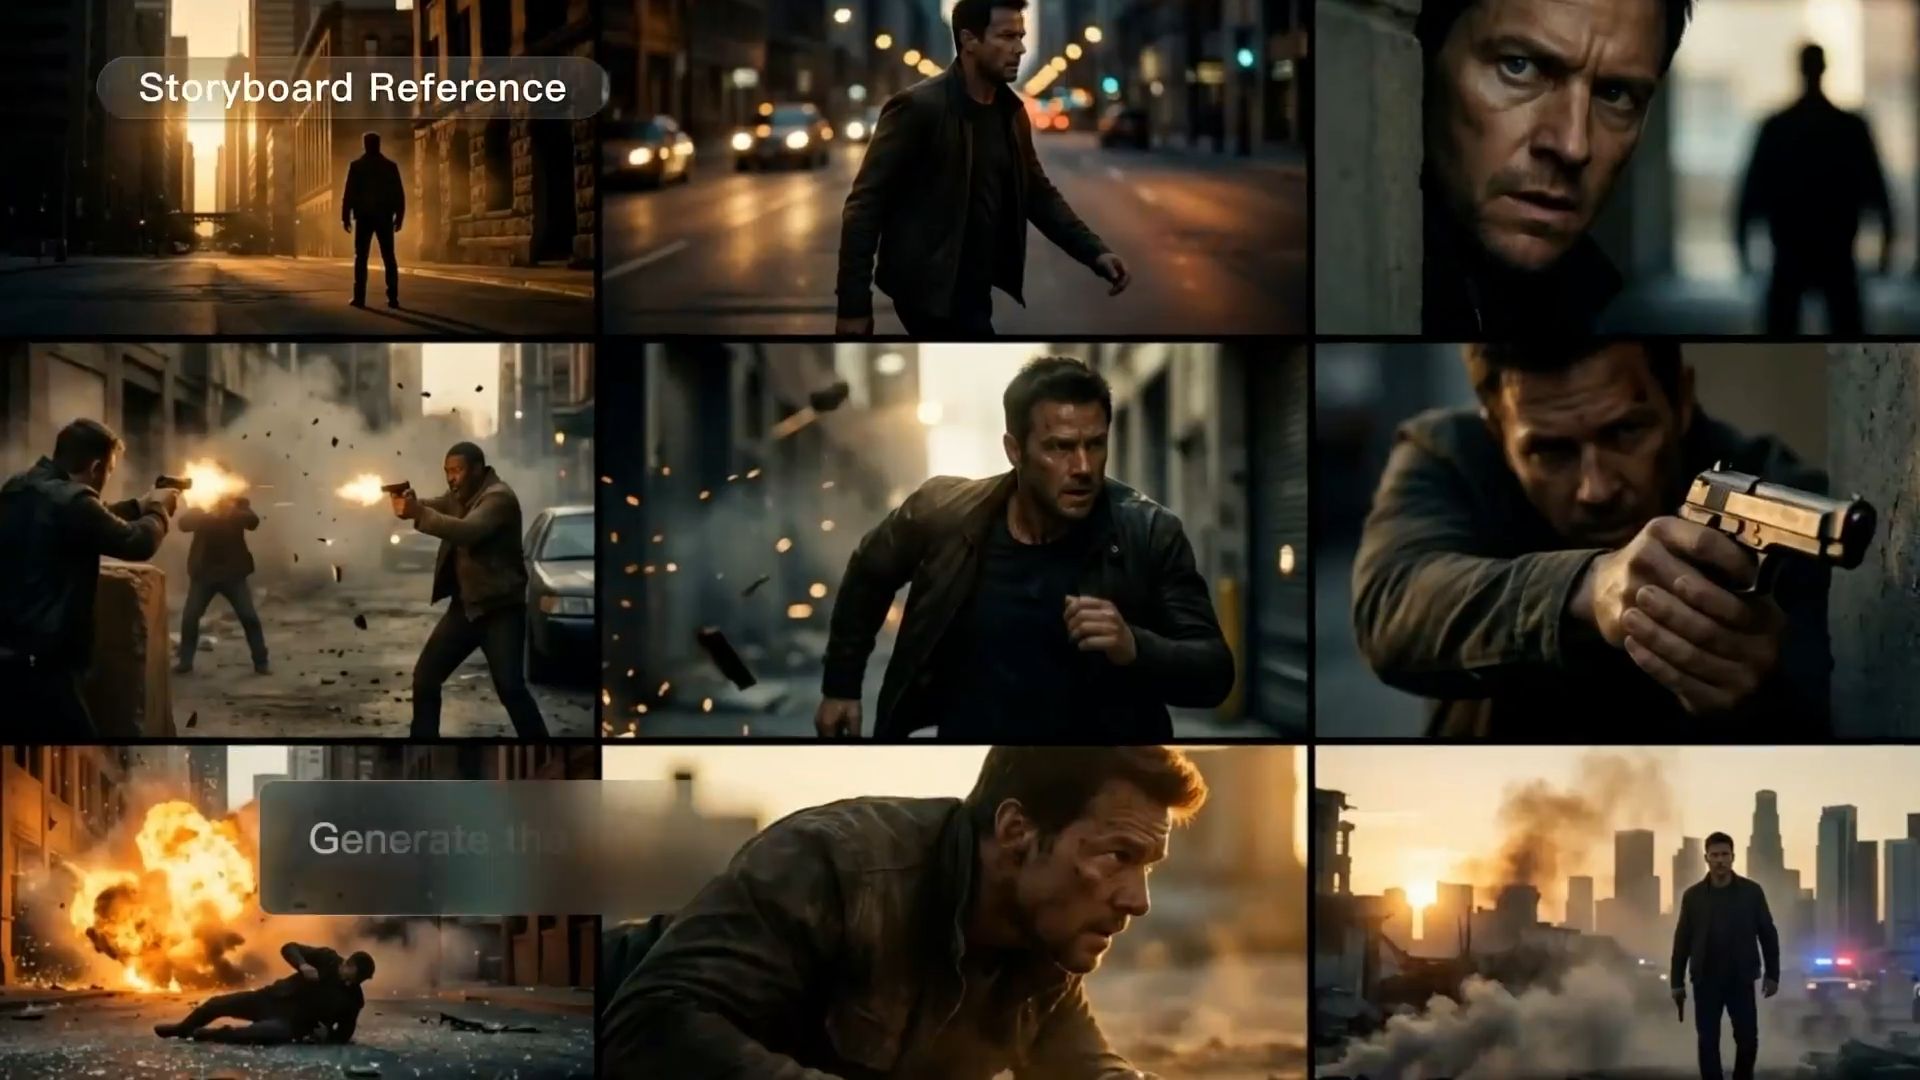
एक ही शॉट आमतौर पर संभालना आसान होता है। चुनौती तब शुरू होती है जब कहानी को क्लोज़-अप, वाइड शॉट, अलग-अलग कैमरा पोज़िशन और सीन परिवर्तन की आवश्यकता होती है। प्रत्येक शॉट को अलग-अलग जनरेट करने का मतलब है बाद में अधिक असेंबली करना, और पूरे अनुक्रम में गति और निरंतरता बनाए रखना कठिन हो जाता है।
Kling VIDEO 3.0 का Multi-Shot एक ही जनरेशन में कई शॉट संभाल सकता है, जिससे एकल प्रॉम्प्ट अलग-अलग क्लिप्स के सेट के बजाय एक जुड़े हुए अनुक्रम में बदल जाता है। योजनाबद्ध अनुक्रम के लिए, Custom Multi-Shot आपको प्रत्येक शॉट की सामग्री, क्रम और अवधि निर्धारित करने देता है, ताकि कट और गति जनरेशन शुरू होने से पहले ही तय हो जाएं।
संवाद और दृश्य ध्वनि को साथ में उत्पन्न करें
जब कोई वीडियो मॉडल केवल दृश्य तैयार करता है, तो संवाद वाले दृश्य अतिरिक्त काम लेकर आते हैं। आवाज़ें, परिवेशी ध्वनि, प्रभाव और टाइमिंग सभी को बाद में संभालना पड़ता है। कई पात्र जोड़ दें, तो आपको यह भी देखना होता है कि कौन सा किरदार कौन सी पंक्ति कह रहा है और क्या ध्वनि स्क्रीन पर सही क्रिया के साथ मेल खा रही है।
Kling VIDEO 3.0 का Native Audio वीडियो के साथ संवाद, परिवेश ध्वनि और अन्य ऑडियो उत्पन्न करता है। बहुपात्र दृश्यों में, आप विभिन्न वक्ताओं को संवाद सौंप सकते हैं, जिनमें चीनी, अंग्रेज़ी, जापानी, कोरियाई और स्पेनिश के साथ समर्थित बोलियाँ और उच्चारण शामिल हैं। भाषण, पात्र प्रदर्शन और दृश्य ध्वनि को उसी जनरेशन में समाहित किया जाता है, ताकि बाद में मौन क्लिप पर परतदार करने की आवश्यकता न पड़े।
15 सेकंड और 4K आउटपुट तक के साथ लंबी कहानियाँ बनाएँ
Kling VIDEO 3.0 क्रिएटर्स को हर दृश्य विकसित करने के लिए अधिक स्थान देता है, जिसमें पात्र इंटरैक्शन, बहु-शॉट कहानी, संवाद और ट्रांज़िशन के लिए लचीली 3–15 सेकंड जनरेशन मौजूद है। समर्थित वर्कफ़्लो में, 4K तक आउटपुट सूक्ष्म विवरण, बनावट और समग्र दृश्य स्पष्टता को सुरक्षित रखता है, जिससे क्रिएटर्स को प्रारंभिक अवधारणाओं से विज्ञापन, उत्पाद प्रदर्शन, सिनेमाई कहानी और अन्य के लिए परिष्कृत कंटेंट तक पहुँचने में मदद मिलती है।
अंत
आपके समय के योग्य टेक्स्ट-टू-वीडियो मॉडल केवल एक प्रॉम्प्ट को एनिमेट करने से अधिक करते हैं: वे आपके इरादे का पालन करते हैं, स्वाभाविक रूप से चलते हैं, ध्वनि के साथ आते हैं, और शॉट्स के बीच विषय को स्थिर रखते हैं। उन मानदंडों के अनुसार मापने पर, Kling VIDEO 3.0 प्रॉम्प्ट-चालित जनरेशन, मल्टी-शॉट नियंत्रण, सब्जेक्ट कंसिस्टेंसी, और नेटिव ऑडियो को एक ही स्थान पर एक साथ लाता है। Kling खोलें, अपना दृश्य लिखें, और इसे एक ही जनरेशन में जीवंत होते देखें।
अक्सर पूछे जाने वाले प्रश्न
2026 में सर्वोत्तम टेक्स्ट-टू-वीडियो AI मॉडलों में से कैसे चुनूँ?
जिस तरह का वीडियो आप बनाना चाहते हैं, उससे शुरुआत करें, फिर उस काम के लिए मॉडलों की तुलना करें। मल्टी-शॉट स्टोरीटेलिंग कैमरा नियंत्रण और चरित्र स्थिरता पर अधिक जोर देती है। संवाद-प्रधान दृश्य मज़बूत ऑडियो, लिप सिंक और चरित्र प्रदर्शन की मांग करते हैं, जबकि उत्पाद और विज्ञापन कार्य प्रॉम्प्ट अनुपालन, विषय स्थिरता और आउटपुट गुणवत्ता पर अधिक निर्भर करते हैं। लंबाई और रिज़ॉल्यूशन भी मायने रखते हैं, क्योंकि एक तेज़ परीक्षण और एक तैयार टुकड़ा शायद ही कभी समान आवश्यकताएँ रखते हैं। Kling VIDEO 3.0 मल्टी-शॉट, नेटिव ऑडियो, प्रॉम्प्ट अनुपालन और 15 सेकंड तक की जनरेशन को संयोजित करता है, ताकि मल्टी-शॉट कहानियाँ, संवाद-प्रधान दृश्य और वे प्रोजेक्ट जिनमें वही चरित्र या उत्पाद शॉट्स के बीच पहचान योग्य बने रहना चाहिए, संभाले जा सकें।
क्या AI टेक्स्ट टू वीडियो में ध्वनि शामिल हो सकती है?
हाँ। Kling VIDEO 3.0 वीडियो के साथ संवाद, वातावरणीय ध्वनि और प्रभाव उत्पन्न कर सकता है, इसलिए आपको बाद में ऑडियो जोड़ने की ज़रूरत नहीं पड़ती। आप पंक्तियों को सीधे प्रॉम्प्ट में लिख सकते हैं, उन्हें विशिष्ट पात्रों को सौंप सकते हैं, और भाषा, उपभाषा या उच्चारण चुन सकते हैं। इसकी text-to-speech क्षमता इन पंक्तियों को चीनी, अंग्रेज़ी, जापानी, कोरियाई और स्पेनिश में चरित्र आवाज़ों में बदल सकती है। इसका मतलब है कि अलग वॉइसओवर कार्य और वीडियो बनने के बाद ऑडियो असेंबली की ज़रूरत कम हो जाती है।
जनरेट किया गया वीडियो कितना लंबा हो सकता है?
वीडियो की लंबाई मॉडल के अनुसार बदलती है। Kling VIDEO 3.0 3 से 15 सेकंड तक लचीली जेनरेशन का समर्थन करता है। छोटे क्लिप तेज़ क्रियाओं और सोशल कंटेंट के लिए उपयुक्त होते हैं, जबकि लंबे क्लिप बिल्डअप, संवाद और मल्टी-शॉट कहानी कहने के लिए अधिक समय छोड़ते हैं। तैयार वीडियो जिनमें अधिक सूक्ष्म दृश्य विवरण चाहिए, उनके लिए समर्थित मोड 4K तक आउटपुट भी प्रदान करते हैं, जिससे उत्पाद की बनावट, पात्रों के विवरण और दृश्य गहराई अधिक स्पष्ट हो जाती है।
क्या मुझे वीडियो संपादन कौशल की आवश्यकता है?
यदि आप जनरेशन के बाद बदलाव करना चाहते हैं, तो Kling के VIDEO 3.0 Omni एडिटिंग वर्कफ़्लो से आप नैचुरल-लैंग्वेज निर्देशों के साथ मौजूदा फुटेज में बदलाव कर सकते हैं, जिसमें पृष्ठभूमि बदलना, विषय, शैली या फ्रेमिंग शामिल है।