I modelli text-to-video possono trasformare una scena scritta in un video con movimento di camera, suono e più riprese. Il problema è che un clip finito può comunque non rispettare il prompt, muoversi in modo innaturale o permettere che un personaggio o un prodotto cambino da una ripresa all'altra. Questo articolo esamina perché queste differenze contano, cosa verificare prima di scegliere un modello e come Kling VIDEO 3.0 gestisce il controllo delle riprese, il movimento, l'audio e la continuità visiva.
Cosa sono i modelli text-to-video?
I modelli text-to-video utilizzano l'IA generativa per trasformare descrizioni in linguaggio naturale in video. Un prompt può specificare il soggetto, l'ambientazione, l'azione, il movimento di camera e lo stile visivo. Se il modello supporta l'audio, può includere anche dialoghi, suoni ambientali e altri segnali sonori.
I modelli text-to-video e i generatori text-to-video basati sull'IA spesso vengono considerati la stessa cosa, ma svolgono ruoli diversi:
Modello text-to-video | Generatore AI text-to-video | |
Di cosa si tratta | Il sistema di intelligenza artificiale che interpreta il prompt e genera il video | Il prodotto o l'interfaccia che le persone utilizzano per accedere alla generazione da testo a video |
Che cosa gestisce | Interpretazione del prompt, generazione delle scene, movimento e continuità nel tempo | Funzionalità sviluppate attorno al modello, come controlli delle inquadrature, input di riferimento, audio, durata, rapporto d'aspetto, montaggio ed esportazione |
Perché è importante | Il modello influisce direttamente sulla qualità video, sul movimento e sulla coerenza visiva | Il generatore influisce su quanto controllo creativo hai e su cosa puoi fare con il video successivamente |
Il modello determina ciò che viene generato, mentre un generatore video di IA stabilisce come accedi a tali funzionalità, come controlli il processo e come lavori con il video finito.
Come funzionano i modelli text-to-video?
I modelli text-to-video trasformano un prompt scritto in una sequenza di immagini in movimento. Il processo esatto varia in base al modello, ma in genere comporta la comprensione del prompt, la costruzione di una rappresentazione compressa della scena, la determinazione di come le cose cambiano nel tempo e il mantenimento del risultato coerente da un momento all'altro.
1. Interpretare il prompt
Un modello intelligenza artificiale da testo a video inizia identificando le principali istruzioni nel prompt, tra cui:
- il soggetto
- l'azione
- l'ambientazione
- lo stile visivo
- la direzione della videocamera
- dialoghi o altri segnali audio, quando supportati
| prompt: “Un ciclista percorre una strada del centro sotto la pioggia mentre la videocamera lo segue da dietro.” |
Quella breve descrizione contiene diverse istruzioni che devono funzionare insieme. Il ciclista si muove in avanti, la videocamera segue da dietro e la pioggia, la strada, l'illuminazione e l'ambiente circostante devono risultare coerenti all'interno della stessa inquadratura.
In altre parole, il prompt descrive più di ciò che dovrebbe apparire sullo schermo. Stabilisce anche le relazioni tra il soggetto, il movimento, la videocamera e l'ambiente.
2. Crea una rappresentazione video compressa
Dopo aver letto il prompt, il sistema ha bisogno di una rappresentazione funzionante della scena prima che diventi filmato finito. Il metodo esatto dipende dall'architettura del modello.
Molti modelli testo-video basati sulla diffusione lavorano in uno spazio di rappresentazione compresso piuttosto che elaborare fotogrammi a piena risoluzione fin dall'inizio. Partono dal rumore e lo modellano gradualmente in base al prompt, portando il soggetto, l'ambientazione, l'illuminazione, la composizione e altri dettagli visivi in vista. Lavorare in questo spazio compresso riduce la quantità di dati gestita durante la generazione e, una volta che la scena ha preso forma, il risultato viene decodificato in fotogrammi video visibili.
3. Generare movimento e interazioni
Il video deve mostrare cosa accade da un momento all'altro. Il modello deve gestire il movimento, l'interazione tra oggetti e i cambiamenti di punto di vista senza rompere la scena.
- Movimento: un personaggio che si gira, cammina o allunga la mano dovrebbe cambiare posa e posizione passo dopo passo, invece di scattare da uno stato all'altro.
- Interazione con gli oggetti: le azioni devono avere un ordine chiaro. Se qualcuno prende una tazza, la mano deve raggiungerla e toccarla prima che la tazza si muova.
- Camera e spazio: panoramiche, inclinazioni, avanzamenti e carrellate cambiano il punto di vista, ma il soggetto e l'ambiente devono comunque rimanere ancorati nello stesso spazio.
Un'immagine statica deve descrivere solo un momento. Il video deve tenere conto di ciò che accade tra un momento e l'altro.
4. Mantieni la coerenza temporale e audiovisiva
Con lo svolgersi del video, persone, oggetti e suono devono rimanere coerenti nel tempo. Questo si riduce principalmente a due tipi di coerenza:
- Coerenza temporale: Personaggi, prodotti, abbigliamento, oggetti di scena, illuminazione e sfondi non dovrebbero cambiare senza una ragione chiara da un momento all'altro. Anche dopo un taglio da un primo piano a un'inquadratura ampia o un cambio di angolazione della camera, la stessa persona o lo stesso prodotto dovrebbero essere ancora facili da riconoscere.
- Coerenza audio-visiva: Il dialogo, il movimento delle labbra, le espressioni facciali, il suono ambientale e le azioni sullo schermo devono verificarsi al momento giusto. Quando un personaggio parla, il movimento della bocca dovrebbe corrispondere al dialogo, mentre i passi o i suoni degli impatti dovrebbero coincidere con l'azione a cui appartengono.
A cosa puoi utilizzare l'IA da testo a video?
L'IA da testo a video funziona bene in situazioni in cui un'idea deve essere vista prima che valga la pena realizzarla su larga scala. Può aiutare con le prime prove creative, le scene difficili da girare e i progetti che hanno bisogno di diverse direzioni visive prima dell'inizio della produzione.
Crea video per i social media
I contenuti social hanno una breve durata, quindi organizzare un nuovo shooting per ogni post o concept di campagna raramente ha senso. Un prompt può generare clip per teaser, annunci, post di campagna o brevi video narrativi senza dover ricostruire ogni volta il setup di produzione. I creator possono anche provare diverse ambientazioni, movimenti di camera e direzioni visive prima di scegliere una versione.
Trasforma le idee di prodotto in video di marketing
Il copy e i mockup statici non mostrano sempre come apparirà un prodotto quando si muove in una scena. L'IA da testo a video permette ai marketer di collocare lo stesso prodotto in ambienti diversi, esplorare concept pubblicitari e testare i trattamenti visivi nelle fasi iniziali del processo. Se il prodotto compare in più inquadrature, i risultati rivelano anche quanto bene forma, colore e dettagli distintivi si mantengano da una scena all'altra.
Crea brevi scene narrative
Un racconto breve diventa più difficile da pianificare una volta che include diverse inquadrature, azioni dei personaggi, cambi di camera e dialoghi. L'IA text-to-video può mappare quegli elementi in una sequenza, rendendo più facile testare l'ordine delle inquadrature, il ritmo e il timing dei dialoghi prima che ogni scena venga costruita separatamente. Questo è particolarmente utile per brevi pezzi cinematografici in cui la storia dipende da più di un'unica ripresa continua.
Visualizza concetti e storyboard
Un treatment o uno storyboard possono spiegare cosa dovrebbe accadere, ma il timing e il movimento della camera sono più difficili da valutare su una pagina statica. Trasformare l'idea in movimento offre a registi, designer e team creativi qualcosa di più vicino all'esperienza di visione finale. Possono confrontare l'inquadratura, testare le transizioni e individuare i momenti deboli quando le modifiche sono ancora facili da apportare.
Creare video educativi e informativi
Alcuni soggetti sono difficili da catturare con la telecamera perché sono costosi, astratti, inaccessibili o impossibili da mettere in scena. L'IA da testo a video può illustrare un processo, ricostruire un'ambientazione o mostrare un evento che non può essere filmato direttamente. Per video esplicativi, materiale di formazione e contenuti didattici, il movimento può rendere un concetto più facile da comprendere quando un'immagine fissa non mostra abbastanza.
Come scegliere il miglior modello di IA da testo a video per il tuo progetto?
Nessun modello di IA da testo a video è adatto a ogni progetto. Parti da ciò che vuoi realizzare, quindi decidi quali capacità contano di più per quel lavoro. Gli aspetti principali da confrontare sono l'aderenza al prompt, il movimento e la plausibilità fisica, la coerenza, il controllo creativo, l'audio e i limiti dell'output e del flusso di lavoro.
Aderenza al prompt
Per prima cosa, verifica se il modello segue davvero il prompt. Il soggetto, l'azione, l'ambientazione, lo stile visivo e la direzione della telecamera dovrebbero comparire tutti insieme anziché solo i dettagli più evidenti. Se chiedi un ciclista che pedala sotto la pioggia mentre la telecamera lo segue da dietro, il ciclista, le condizioni meteo, il movimento e il punto di vista devono essere tutti presenti. Ciò che il modello omette può dirti tanto quanto l'aspetto rifinito delle riprese.
Movimento e plausibilità fisica
Le azioni dovrebbero svolgersi in un ordine chiaro. Camminare, voltarsi, allungare la mano, le collisioni e il movimento della telecamera dovrebbero passare da uno stato al successivo senza salti improvvisi. Anche l'interazione fisica conta: una mano dovrebbe entrare in contatto prima che un oggetto si muova, un atterraggio dovrebbe influenzare il corpo e capelli, tessuti, acqua o oggetti sciolti dovrebbero reagire al movimento circostante invece di comportarsi autonomamente.
Coerenza del personaggio e del prodotto
Lo stesso soggetto dovrebbe rimanere riconoscibile quando cambiano l'inquadratura, l'angolazione o la distanza. Volti, abbigliamento, forma del prodotto, colore, oggetti di scena, illuminazione e altri dettagli distintivi non dovrebbero variare senza motivo. Le scene con più riprese lo rendono più difficile, quindi i progetti costruiti attorno a personaggi o prodotti ricorrenti dovrebbero essere verificati per immagini di riferimento, riferimenti al soggetto o un altro modo per mantenere l'identità visiva da una ripresa all'altra.
Controllo creativo e della camera
Quando una scena ha già una direzione visiva chiara, il controllo è fondamentale. Inquadratura, movimento della camera, ordine delle riprese, input di riferimento, rapporto d'aspetto e struttura multi-shot influenzano tutti quanto il risultato rispecchi l'idea originale. Un controllo più preciso significa anche che è meno probabile dover rigenerare un'intera sequenza solo per cambiare un'angolazione, riordinare una ripresa o correggere la composizione.
Supporto audio
Le capacità audio variano molto tra i modelli. Alcuni generano solo elementi visivi, mentre altri possono creare dialoghi, suono ambientale ed effetti insieme alle riprese. Per le scene ricche di dialoghi, verifica che la voce, il movimento della bocca, l'espressione facciale e la tempistica rimangano allineati. I passi, gli impatti e i suoni ambientali dovrebbero inoltre coincidere con l'azione a cui appartengono.
Durata, Risoluzione e Flusso di lavoro
Considera i limiti che influenzano il video finale, inclusa la lunghezza di generazione, i rapporti d'aspetto supportati, le risoluzioni disponibili e le opzioni di esportazione. Un breve clip social e una scena di prodotto multi-shot possono avere requisiti di output molto diversi.
Ciò che accade dopo la generazione è altrettanto importante. Puoi estendere la clip, riutilizzare lo stesso soggetto, rivedere un'inquadratura, rigenerare l'audio o continuare a modificare senza ricominciare da capo? Piccoli cambiamenti non dovrebbero costringerti a ricostruire l'intera sequenza.
Progetti diversi richiedono priorità diverse. Inizia dal tipo di video che stai realizzando, poi concentrati sulle funzionalità che contano di più:
Se vuoi creare | Dai priorità a | Perché è importante |
Brevi video social | Fedeltà al prompt, proporzioni, flusso di lavoro | I contenuti social si muovono rapidamente, quindi il risultato deve rimanere vicino all'idea, adattarsi ai formati comuni delle piattaforme ed essere facile da rivedere. |
Video di prodotto e marketing | Coerenza del prodotto, aderenza al prompt, risoluzione | La forma del prodotto, il colore, il branding e i dettagli chiave devono rimanere stabili tra le riprese, mentre il filmato finale deve comunque soddisfare le esigenze della campagna o della presentazione. |
Brevi scene narrative o cinematografiche | Movimento e plausibilità fisica, controllo della telecamera, coerenza tra più inquadrature | Le azioni dei personaggi, i cambi di camera e le transizioni tra le scene devono collegarsi lungo la sequenza senza evidenti scostamenti visivi. |
Video guidati dai dialoghi | Supporto audio, sincronizzazione labiale, coerenza dei personaggi | I dialoghi, il movimento della bocca, l'espressività facciale e l'identità del personaggio devono restare allineati, mentre il suono dovrebbe arrivare al momento giusto. |
Anteprime dei concept e storyboard | Controllo creativo e della camera, input di riferimento, flessibilità nelle revisioni | L'obiettivo è testare l'inquadratura, la direzione della camera, il ritmo e le idee alternative in fase iniziale, quando le modifiche sono ancora facili da apportare. |
Video educativi e video esplicativi | Aderenza al prompt, movimento e plausibilità fisica, flusso di lavoro | Le immagini devono spiegare con precisione un processo o un'idea, mantenere i movimenti facili da seguire e consentire revisioni quando il contenuto cambia. |
Che cosa puoi fare con Kling VIDEO 3.0?
La parte difficile del text-to-video non è ottenere un'unica inquadratura dall'aspetto gradevole. È far sì che il soggetto, l'azione, la direzione della camera, l'audio e i piccoli dettagli visivi dal prompt si manifestino nel modo previsto. Man mano che i prompt diventano più dettagliati e le scene aggiungono più inquadrature, il modello ha sempre più elementi da seguire da un momento all'altro.
Kling VIDEO 3.0 è costruito attorno a tali esigenze, con un'interpretazione dei prompt più accurata, narrazione multi-shot, coerenza dei soggetti, audio nativo, durata flessibile e rendering del testo. Invece di scrivere una descrizione e limitarti ad aspettare di vedere cosa torna, puoi modellare come si sviluppa la storia, quando cambia la camera, come i soggetti proseguono da una ripresa all'altra e dove il suono entra in scena.
Comprendi e segui i prompt con maggiore precisione
Kling VIDEO 3.0 può interpretare prompt stratificati che combinano soggetti, azioni, ambientazioni, direzione della camera e struttura narrativa. Questo aiuta i prompt text-to-video complessi a rimanere più vicini alla scena prevista, soprattutto quando coinvolgono più azioni, movimenti di camera pianificati o una sequenza specifica di eventi.
Mantieni coerenti personaggi e prodotti tra le riprese
Un personaggio può apparire corretto in un'inquadratura e comunque cambiare in modo evidente da un'altra angolazione. In un video multi-shot, i volti possono spostarsi, i dettagli degli abiti possono variare e il colore, la forma o le caratteristiche distintive di un prodotto possono cambiare da una ripresa all'altra.
Nei flussi di lavoro VIDEO 3.0 supportati con assistenza tramite riferimenti, puoi usare più immagini di riferimento per fornire indicazioni visive aggiuntive e aiutare ad ancorare un personaggio, un prodotto o un altro soggetto chiave ricorrente durante i cambi di inquadratura, angolazione e ambientazione. Questi riferimenti forniscono al modello maggiori informazioni sull'aspetto del soggetto e sui dettagli visivi fondamentali, contribuendo a ridurre una deriva visiva evidente nelle scene con personaggi ricorrenti, nelle riprese di prodotto e nei contenuti di brand.

Crea storie multi-shot con un maggiore controllo sul ritmo
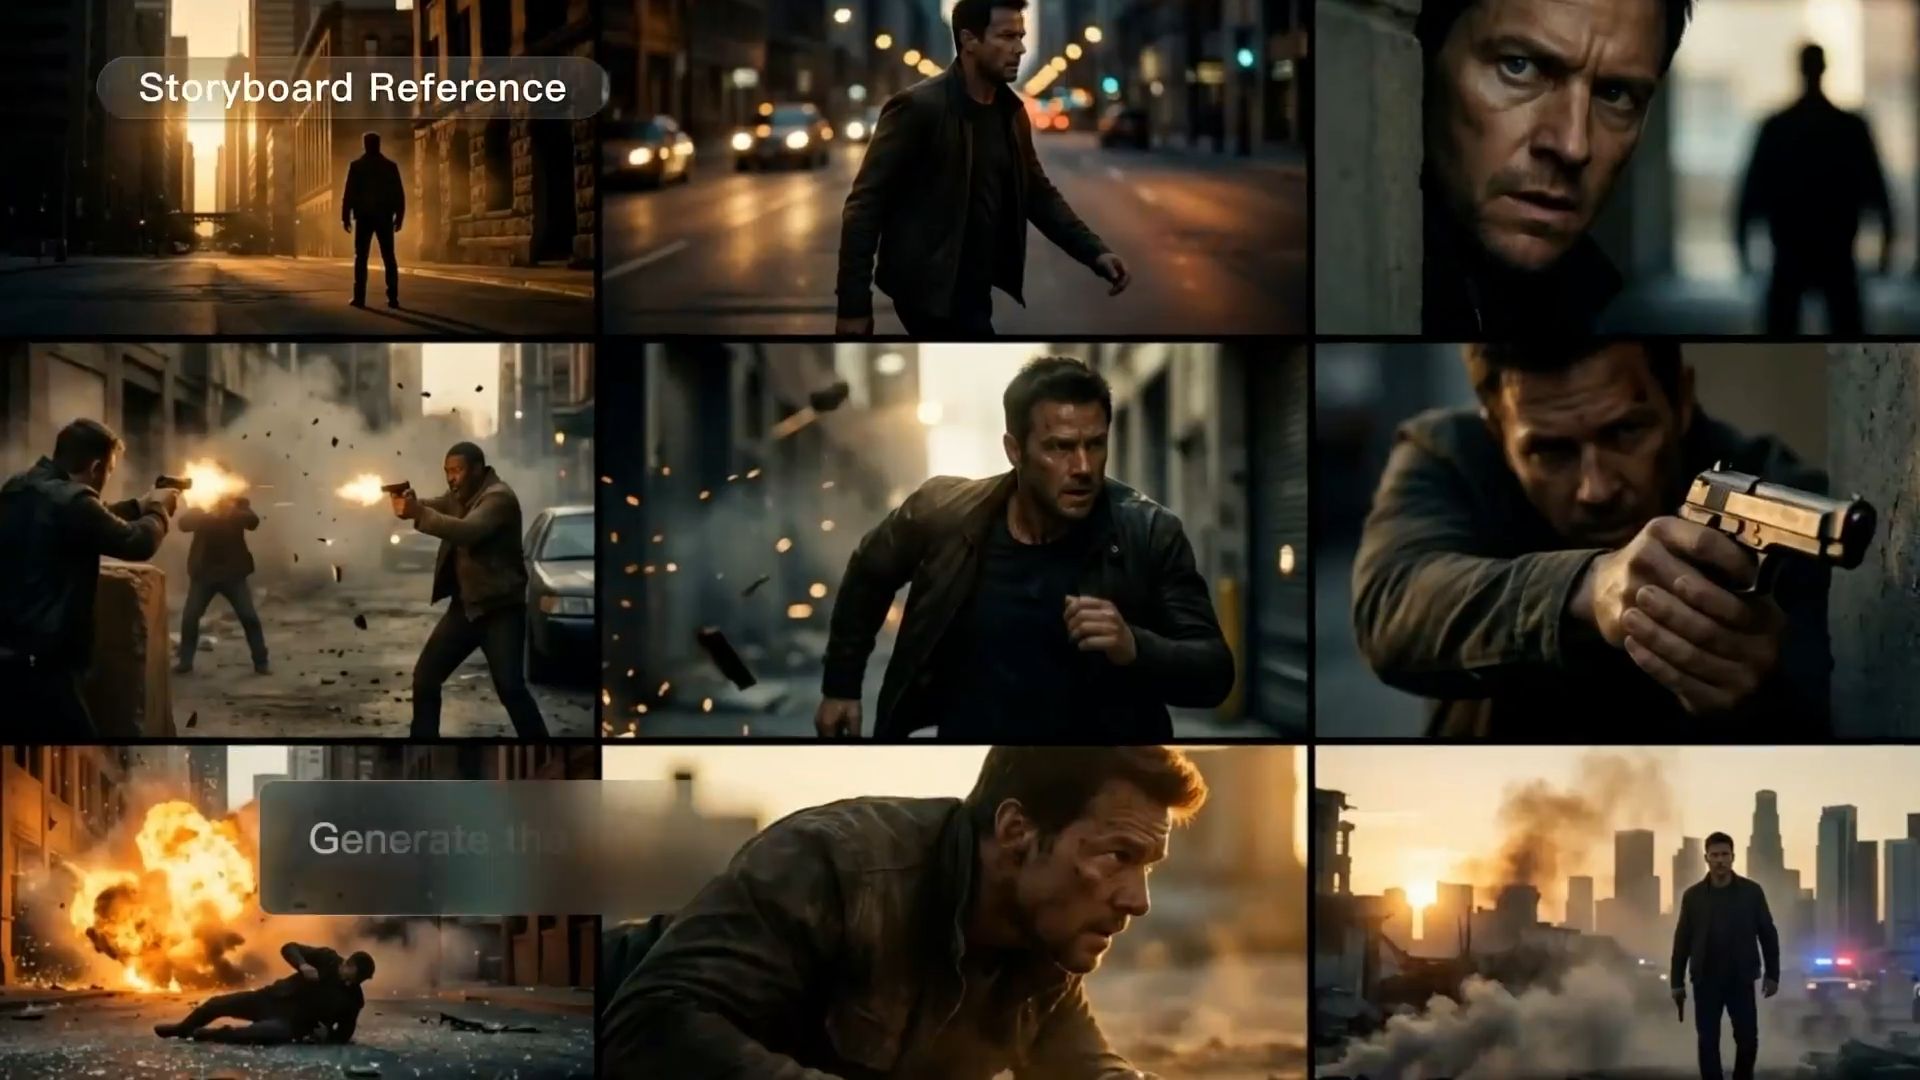
Un'unica inquadratura è di solito gestibile. La difficoltà inizia quando una storia richiede primi piani, campi lunghi, diverse posizioni della macchina da presa e cambi di scena. Generare ogni inquadratura separatamente significa più montaggio in seguito, e diventa più difficile mantenere ritmo e continuità intatti lungo la sequenza.
Il Multi-Shot di Kling VIDEO 3.0 può gestire più inquadrature in un'unica generazione, trasformando un singolo prompt in una sequenza connessa invece di un insieme di clip isolate. Per una sequenza pianificata, Custom Multi-Shot ti consente di definire il contenuto, l'ordine e la durata delle singole inquadrature, così tagli e ritmo sono impostati prima che inizi la generazione.
Genera dialoghi e suono di scena insieme
Quando un modello video produce solo immagini, le scene con dialoghi comportano lavoro extra. Voci, suono ambientale, effetti e sincronizzazione devono essere gestiti in seguito. Aggiungi più personaggi, e devi anche tenere traccia di chi pronuncia ogni battuta e se l'audio coincide con l'azione giusta sullo schermo.
L'Audio Nativo di Kling VIDEO 3.0 genera dialoghi, suoni ambientali e altri elementi audio insieme al video. Nelle scene con più personaggi, puoi assegnare le battute a diversi interlocutori, con supporto per cinese, inglese, giapponese, coreano e spagnolo, oltre ai dialetti e agli accenti supportati. Voce, interpretazione dei personaggi e suono della scena sono integrati nella stessa generazione invece di essere applicati successivamente a una clip muta.
Crea storie più lunghe con fino a 15 secondi e output in 4K
Kling VIDEO 3.0 offre ai creatori più spazio per sviluppare ogni scena, con una generazione flessibile da 3 a 15 secondi per le interazioni tra personaggi, la narrazione multi-shot, i dialoghi e le transizioni. Nei flussi di lavoro supportati, un output fino a 4K preserva i dettagli più fini, le texture e la chiarezza visiva complessiva, aiutando i creatori a passare dai primi concept a contenuti rifiniti per pubblicità, presentazioni di prodotto, narrazione cinematografica e altro ancora.
Fine
I modelli text-to-video degni del tuo tempo fanno più che animare un prompt: seguono la tua intenzione, si muovono in modo naturale, arrivano con l'audio e mantengono un soggetto stabile tra le inquadrature. Misurato rispetto a questi criteri, Kling VIDEO 3.0 riunisce la generazione guidata da prompt, il controllo Multi-Shot, la Coerenza del Soggetto e l'audio nativo in un unico posto. Apri Kling, scrivi la tua scena e guardala prendere vita in un'unica generazione.
Domande frequenti
Come faccio a scegliere tra i migliori modelli di IA text-to-video nel 2026?
Inizia dal tipo di video che vuoi realizzare, poi confronta i modelli adatti a quel compito. Il racconto multi-shot dà più peso al controllo della camera e alla coerenza dei personaggi. Le scene ricche di dialoghi richiedono un audio solido, sincronizzazione labiale e interpretazione dei personaggi, mentre il lavoro su prodotti e pubblicità dipende maggiormente dall'aderenza al prompt, dalla stabilità del soggetto e dalla qualità dell'output. Anche durata e risoluzione contano, perché un test rapido e un prodotto finito raramente hanno gli stessi requisiti. Kling VIDEO 3.0 combina Multi-Shot, Native Audio, aderenza al prompt e generazione fino a 15 secondi per storie multi-shot, scene guidate dai dialoghi e progetti in cui lo stesso personaggio o prodotto deve rimanere riconoscibile tra le inquadrature.
Il Text to Video con AI può includere l'audio?
Sì. Kling VIDEO 3.0 può generare dialoghi, suoni ambientali ed effetti insieme al video, così non devi aggiungere l'audio in seguito. Puoi scrivere le battute direttamente nel prompt, assegnarle a personaggi specifici e scegliere la lingua, il dialetto o l'accento. La sua capacità di sintesi vocale può trasformare quelle battute in voci dei personaggi in cinese, inglese, giapponese, coreano e spagnolo. Questo significa meno lavoro di doppiaggio separato e meno montaggio audio dopo che il video è stato generato.
Quanto può essere lungo un video generato?
La lunghezza del video varia a seconda del modello. Kling VIDEO 3.0 supporta una generazione flessibile da 3 a 15 secondi. I clip più brevi funzionano bene per azioni rapide e contenuti social, mentre quelli più lunghi lasciano più tempo per la costruzione, i dialoghi e lo storytelling multi-shot. Per i video finiti che richiedono un dettaglio visivo più fine, le modalità supportate offrono anche output fino a 4K, conferendo maggiore chiarezza alle texture dei prodotti, ai dettagli dei personaggi e alla profondità delle scene.
Ho bisogno di competenze di montaggio video?
Se desideri apportare modifiche dopo la generazione, il flusso di lavoro di editing VIDEO 3.0 Omni di Kling ti consente di modificare il filmato esistente con istruzioni in linguaggio naturale, inclusi modificare gli sfondi, soggetti, stile o inquadratura.