Model teks ke video boleh menukar adegan bertulis menjadi video dengan pergerakan kamera, bunyi, dan pelbagai shot. Cabarannya ialah klip yang siap masih boleh tersasar daripada prompt, bergerak canggung, atau membiarkan watak atau produk berubah dari satu shot ke shot berikutnya. Artikel ini melihat mengapa perbezaan tersebut penting, apa yang perlu diperiksa sebelum memilih model, dan bagaimana Kling VIDEO 3.0 mengendalikan kawalan shot, pergerakan, audio, dan kesinambungan visual.
Apakah Model Teks ke Video?
Model teks ke video menggunakan AI generatif untuk menukar huraian bahasa semula jadi menjadi video. Prompt boleh menyatakan subjek, latar, aksi, pergerakan kamera, dan gaya visual. Jika model menyokong audio, ia juga boleh memasukkan dialog, bunyi ambien, dan petunjuk audio lain.
Model teks ke video dan penjana AI teks ke video sering dianggap perkara yang sama, tetapi mereka memainkan peranan yang berbeza:
Model Teks ke Video | Penjana AI Teks ke Video | |
Apakah ia | Sistem AI yang mentafsir prompt dan menghasilkan video | Produk atau antara muka yang digunakan orang untuk mengakses penjanaan teks-ke-video |
Apa yang dikendalikannya | Pentafsiran prompt, penjanaan adegan, pergerakan, dan kesinambungan dari semasa ke semasa | Ciri yang dibina di sekeliling model, seperti kawalan penggambaran, input rujukan, audio, tempoh, nisbah aspek, penyuntingan, dan eksport |
Mengapa ia penting | Model tersebut secara langsung mempengaruhi kualiti video, pergerakan dan konsistensi visual | Penjana tersebut mempengaruhi sejauh mana kawalan kreatif yang anda miliki dan apa yang boleh anda lakukan dengan video selepas itu |
Model menentukan apa yang dijana, manakala penjana video AI menentukan bagaimana anda mengakses keupayaan tersebut, mengawal proses dan bekerja dengan video yang siap.
Bagaimanakah Model Teks-ke-Video Berfungsi?
Model teks-ke-video menukar gesaan bertulis kepada urutan imej bergerak. Proses tepatnya berbeza mengikut model, tetapi secara amnya melibatkan memahami gesaan tersebut, membina representasi termampat bagi adegan, menentukan bagaimana perkara berubah dari masa ke masa, dan memastikan hasilnya konsisten dari satu detik ke detik berikutnya.
1. Mentafsirkan Prompt
Model AI teks-ke-video bermula dengan mengenal pasti arahan utama dalam prompt, termasuk:
- subjek
- tindakan
- tetapan
- gaya visual
- arah kamera
- dialog atau petunjuk audio lain, apabila disokong
| prompt: “Seorang penunggang basikal menunggang melalui jalan pusat bandar yang hujan sementara kamera mengikutinya dari belakang.” |
Penerangan ringkas itu mengandungi beberapa arahan yang perlu berfungsi bersama. Penunggang basikal bergerak ke hadapan, kamera mengikuti dari belakang, dan hujan, jalan, pencahayaan, serta persekitaran perlu masuk akal dalam satu rakaman yang sama.
Dalam kata lain, prompt menerangkan lebih daripada apa yang sepatutnya muncul di skrin. Ia juga menetapkan hubungan antara subjek, pergerakan, kamera, dan persekitaran.
2. Bina Perwakilan Video Termampat
Selepas membaca prompt, sistem memerlukan representasi adegan yang boleh digunakan sebelum ia menjadi rakaman siap. Kaedah tepat bergantung pada seni bina model.
Banyak model teks-ke-video berasaskan difusi berfungsi dalam ruang perwakilan termampat dan bukannya memproses bingkai resolusi penuh sejak awal. Mereka bermula dengan hingar dan secara beransur-ansur membentuknya mengikut prompt, menampilkan subjek, latar, pencahayaan, komposisi, dan butiran visual lain. Bekerja dalam ruang termampat ini mengurangkan jumlah data yang dikendalikan semasa penjanaan, dan setelah adegan terbentuk, hasilnya dinyahkod menjadi bingkai video yang boleh dilihat.
3. Jana Gerakan dan Interaksi
Video perlu menunjukkan apa yang berlaku dari satu saat ke saat berikutnya. Model perlu mengendalikan pergerakan, interaksi objek, dan perubahan sudut pandang tanpa memecahkan adegan.
- Pergerakan: Watak yang berpusing, berjalan, atau menghulur tangan patut menukar pose dan kedudukan secara berperingkat, bukannya beralih secara mendadak dari satu keadaan ke keadaan yang lain.
- Interaksi objek: Tindakan memerlukan urutan yang jelas. Jika seseorang mengambil cawan, tangan perlu mencapainya dan melakukan sentuhan sebelum cawan bergerak.
- Kamera dan ruang: Pan, tilt, push-in dan rakaman jejak mengubah sudut pandang, namun subjek dan persekitaran masih perlu kekal berpaut pada ruang yang sama.
Imej statik hanya perlu menggambarkan satu detik. Video perlu mengambil kira apa yang berlaku di antara detik-detik tersebut.
4. Kekalkan Konsistensi Temporal dan Audio-Visual
Apabila video berlangsung, orang, objek dan bunyi perlu kekal koheren dari semasa ke semasa. Ini terutamanya bergantung pada dua jenis konsistensi:
- Konsistensi temporal: Watak, produk, pakaian, prop, pencahayaan, dan latar belakang tidak seharusnya berubah tanpa sebab yang jelas dari satu saat ke saat berikutnya. Walaupun selepas potongan daripada rakaman dekat ke rakaman lebar atau perubahan sudut kamera, orang atau produk yang sama masih perlu mudah dikenali.
- Konsistensi audio-visual: Dialog, pergerakan bibir, ekspresi wajah, bunyi ambien, dan tindakan di skrin perlu berlaku pada masa yang tepat. Apabila seorang watak bercakap, pergerakan mulut perlu sepadan dengan dialog, manakala bunyi langkah atau hentaman harus tiba serentak dengan tindakan yang berkaitan.
Untuk Apa Anda Boleh Menggunakan AI Teks-ke-Video?
AI teks-ke-video berfungsi dengan baik dalam situasi di mana sesuatu idea perlu dilihat sebelum berbaloi untuk dihasilkan pada skala penuh. Ia boleh membantu dengan ujian kreatif awal, babak yang sukar untuk dirakam, dan projek yang memerlukan beberapa arah visual sebelum penggambaran bermula.
Cipta Video Media Sosial
Kandungan sosial mempunyai jangka hayat yang pendek, jadi mengatur penggambaran baharu untuk setiap hantaran atau konsep kempen jarang masuk akal. Satu prompt boleh menghasilkan klip untuk penggoda, pengumuman, hantaran kempen, atau video cerita pendek tanpa perlu membina semula set produksi setiap kali. Pencipta juga boleh mencuba tetapan berbeza, pergerakan kamera, dan hala tuju visual sebelum memilih satu versi.
Tukar Idea Produk Menjadi Video Pemasaran
Salinan dan mockup statik tidak selalu menunjukkan rupa produk apabila ia bergerak melalui sesuatu babak. AI teks-ke-video membolehkan pemasar meletakkan produk yang sama dalam persekitaran berbeza, meneroka konsep iklan, dan menguji rawatan visual pada peringkat awal proses. Jika produk muncul merentasi beberapa babak, hasilnya turut mendedahkan sejauh mana bentuk, warna, dan butiran penentunya kekal konsisten dari satu babak ke babak seterusnya.
Bina Babak Naratif Pendek
Merancang cerita pendek menjadi lebih sukar apabila ia merangkumi beberapa rakaman, tindakan watak, perubahan kamera, dan dialog. AI teks-ke-video boleh memetakan unsur-unsur tersebut ke dalam satu urutan, memudahkan pengujian susunan rakaman, tempo, dan masa dialog sebelum setiap babak dibangunkan secara berasingan. Ini amat membantu untuk karya sinematik pendek yang bergantung pada lebih daripada satu rakaman berterusan tunggal.
Visualisasikan Konsep dan Papan Cerita
Sebuah treatment atau papan cerita boleh menerangkan apa yang sepatutnya berlaku, tetapi masa dan pergerakan kamera lebih sukar dinilai pada halaman statik. Mengubah idea itu menjadi gerakan memberikan pengarah, pereka, dan pasukan kreatif sesuatu yang lebih hampir kepada pengalaman tontonan akhir. Mereka boleh membandingkan pembingkaian, menguji peralihan, dan mengesan detik lemah sementara perubahan masih mudah dilakukan.
Hasilkan Video Pendidikan dan Penerangan
Sesetengah subjek sukar dirakam menggunakan kamera kerana ia mahal, abstrak, sukar diakses, atau mustahil dipentaskan. AI teks-ke-video boleh menggambarkan proses, membina semula persekitaran, atau menunjukkan peristiwa yang tidak dapat dirakam secara langsung. Untuk video penerangan, bahan latihan, dan kandungan bilik darjah, pergerakan boleh menjadikan sebuah konsep lebih mudah difahami apabila imej pegun tidak menunjukkan maklumat yang mencukupi.
Bagaimana Memilih Model AI Teks-ke-Video Terbaik untuk Projek Anda?
Tiada satu pun model AI teks-ke-video yang sesuai untuk setiap projek. Mulakan dengan apa yang anda mahu hasilkan, kemudian tentukan keupayaan mana yang paling penting untuk tugas tersebut. Perkara utama untuk dibandingkan ialah pematuhan prompt, pergerakan dan kebolehlaksanaan fizikal, konsistensi, kawalan kreatif, audio, serta had output dan aliran kerja.
Pematuhan Prompt
Pertama, semak sama ada model benar-benar mengikut prompt. Subjek, tindakan, suasana, gaya visual, dan arah kamera semuanya perlu muncul serentak dan bukannya hanya butiran yang paling jelas. Jika anda meminta seorang penunggang basikal yang mengayuh melalui hujan sementara kamera mengikuti dari belakang, penunggang, cuaca, pergerakan, dan sudut pandang semuanya harus ada. Apa yang ditinggalkan oleh model boleh menceritakan sama banyaknya dengan betapa kemasnya rakaman itu kelihatan.
Pergerakan dan Kebolehpercayaan Fizikal
Tindakan perlu berlangsung dalam urutan yang jelas. Berjalan, berpusing, mencapai, perlanggaran, dan pergerakan kamera harus bergerak dari satu keadaan ke keadaan seterusnya tanpa lompatan mengejut. Interaksi fizikal juga penting: tangan harus menyentuh sebelum objek bergerak, pendaratan perlu memberi kesan kepada badan, dan rambut, fabrik, air atau objek longgar harus bertindak balas terhadap pergerakan berdekatan dan bukannya bertindak sendiri.
Konsistensi Watak dan Produk
Subjek yang sama harus kekal boleh dikenali apabila pembingkaian, sudut, atau jarak berubah. Wajah, pakaian, bentuk produk, warna, prop, pencahayaan, dan perincian penentu lain tidak seharusnya menyimpang tanpa sebab. Adegan berbilang tangkapan menjadikannya lebih sukar, jadi projek yang dibina sekitar watak atau produk berulang juga harus diperiksa bagi imej rujukan, rujukan subjek, atau cara lain untuk mengekalkan identiti visual dari satu tangkapan ke tangkapan seterusnya.
Kawalan Kreatif dan Kamera
Apabila sesuatu adegan sudah mempunyai arah visual yang jelas, kawalan menjadi penting. Pembingkaian, pergerakan kamera, susunan tangkapan, input rujukan, nisbah aspek, dan struktur berbilang tangkapan semuanya mempengaruhi sejauh mana hasilnya sepadan dengan idea asal. Kawalan yang lebih halus juga bermakna anda kurang berkemungkinan menjalankan semula keseluruhan urutan hanya untuk menukar sudut, menyusun semula tangkapan, atau membetulkan komposisi.
Sokongan Audio
Keupayaan audio berbeza banyak antara model. Ada yang menghasilkan visual sahaja, manakala yang lain boleh mencipta dialog, bunyi ambien, dan kesan bersama rakaman. Untuk babak yang banyak dialog, semak sama ada suara, pergerakan mulut, ekspresi wajah, dan pemasaan kekal seiring. Bunyi langkah, hentaman, dan bunyi persekitaran juga harus berlaku serentak dengan aksi yang berkaitan.
Tempoh, Resolusi, dan Aliran Kerja
Perhatikan had yang menjejaskan video akhir, termasuk tempoh penjanaan, nisbah aspek yang disokong, resolusi tersedia, dan pilihan eksport. Klip sosial pendek dan babak produk berbilang syot boleh mempunyai keperluan output yang sangat berbeza.
Apa yang berlaku selepas penjanaan sama pentingnya. Bolehkah anda memanjangkan klip, menggunakan semula subjek yang sama, menyemak semula satu syot, menjana semula audio, atau meneruskan penyuntingan tanpa bermula dari awal? Perubahan kecil tidak seharusnya memaksa anda membina semula keseluruhan urutan.
Projek yang berbeza memerlukan keutamaan yang berbeza. Mulakan dengan jenis video yang anda buat, kemudian fokus pada keupayaan yang paling penting:
Jika Anda Mahu Mencipta | Utamakan | Mengapa Ia Penting |
Video sosial pendek | Pematuhan prompt, nisbah aspek, aliran kerja | Kandungan sosial bergerak pantas, jadi output perlu kekal dekat dengan idea, sesuai dengan format platform biasa, dan mudah untuk disemak semula. |
Video produk dan pemasaran | Konsistensi produk, pematuhan prompt, resolusi | Bentuk produk, warna, penjenamaan, dan butiran utama perlu kekal stabil merentasi setiap rakaman sementara rakaman akhir masih memenuhi keperluan kempen atau pembentangan. |
Adegan naratif pendek atau sinematik | Pergerakan dan kebolehlaksanaan fizikal, kawalan kamera, konsistensi berbilang rakaman | Tindakan watak, perubahan kamera, dan peralihan adegan perlu saling terhubung sepanjang urutan tanpa hanyutan visual yang ketara. |
Video berteraskan dialog | Sokongan audio, penyegerakan bibir, konsistensi watak | Dialog, pergerakan mulut, persembahan wajah, dan identiti watak perlu kekal selaras, sementara bunyi harus tiba pada saat yang tepat. |
Pratonton konsep dan papan cerita | Kawalan kreatif dan kamera, input rujukan, fleksibiliti semakan | Matlamatnya ialah untuk menguji pembingkaian, arah kamera, tempo, dan idea alternatif lebih awal, sementara perubahan masih mudah dilakukan. |
Video pendidikan dan penerangan | Pematuhan prompt, pergerakan dan kemunasabahan fizikal, aliran kerja | Visual perlu menerangkan proses atau idea dengan tepat, memastikan pergerakan mudah diikuti, dan membenarkan semakan apabila kandungan berubah. |
Apakah yang boleh anda lakukan dengan Kling VIDEO 3.0?
Bahagian paling sukar dalam teks-ke-video bukanlah mendapatkan satu tangkapan yang kelihatan bagus. Ia adalah memastikan subjek, aksi, arah kamera, bunyi, dan butiran visual kecil daripada prompt muncul seperti yang anda maksudkan. Apabila prompt menjadi lebih terperinci dan babak menambah lebih banyak tangkapan, model mempunyai lebih banyak perkara untuk diikuti dari satu saat ke saat berikutnya.
Kling VIDEO 3.0 dibina berdasarkan tuntutan tersebut, dengan interpretasi prompt yang lebih kuat, penceritaan berbilang shot, konsistensi subjek, audio natif, tempoh fleksibel, dan renderan teks. Daripada menulis penerangan dan hanya menunggu untuk melihat apa yang kembali, anda boleh membentuk bagaimana cerita berkembang, bila kamera berubah, bagaimana subjek dibawa merentas shot, dan di mana bunyi memasuki adegan.
Memahami dan Mengikuti Prompt dengan Lebih Tepat
Kling VIDEO 3.0 boleh mentafsir prompt berlapis yang menggabungkan subjek, tindakan, tetapan, arah kamera, dan struktur naratif. Ini membantu prompt teks-ke-video yang kompleks kekal lebih dekat dengan adegan yang dimaksudkan, terutamanya apabila ia melibatkan pelbagai tindakan, gerakan kamera terancang, atau urutan peristiwa tertentu.
Kekalkan Watak dan Produk Konsisten Merentasi Shot
Watak boleh kelihatan betul dalam satu babak namun masih berubah dengan ketara dari sudut lain. Dalam video berbilang babak, wajah mungkin berubah, butiran pakaian boleh tersasar, dan warna, bentuk atau ciri penentu sesuatu produk mungkin berubah dari satu babak ke babak berikutnya.
Dalam aliran kerja VIDEO 3.0 dengan bantuan rujukan yang disokong, anda boleh menggunakan beberapa imej rujukan untuk memberikan panduan visual tambahan dan membantu menambat watak, produk atau subjek utama yang berulang merentas perubahan dalam pembingkaian, sudut dan latar. Rujukan ini memberikan model lebih banyak maklumat tentang rupa subjek dan butiran visual utama, membantu mengurangkan hanyutan visual yang ketara dalam adegan watak berulang, rakaman produk dan kandungan berjenama.

Bina Cerita Berbilang Babak dengan Lebih Kawalan ke atas Rentak
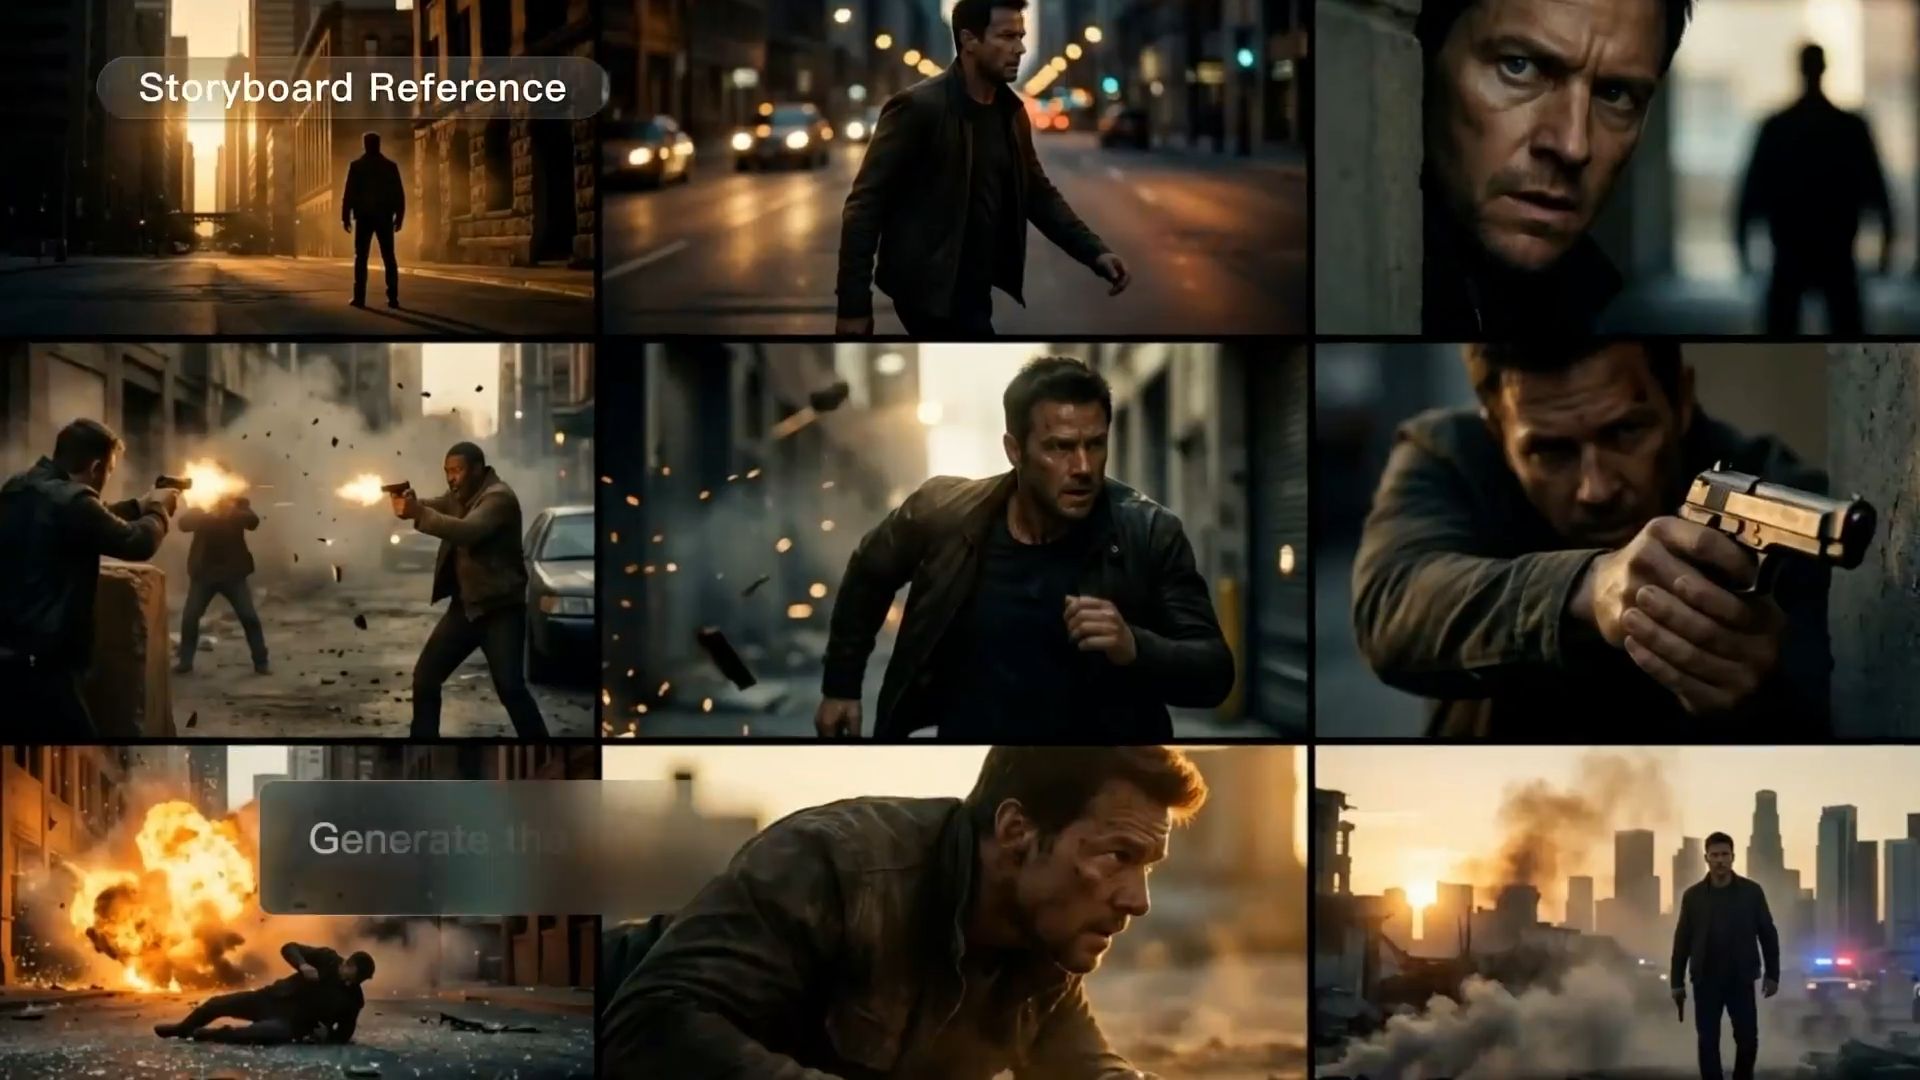
Satu shot biasanya boleh diurus. Cabaran bermula apabila sesuatu cerita memerlukan close-up, shot lebar, kedudukan kamera berbeza, dan pertukaran adegan. Menjana setiap shot secara berasingan bermakna lebih banyak kerja penyusunan kemudian, dan semakin sukar untuk mengekalkan rentak serta kesinambungan sepanjang urutan tersebut.
Multi-Shot Kling VIDEO 3.0 boleh mengendalikan beberapa shot dalam satu generasi, menukarkan prompt tunggal kepada urutan yang saling berhubung dan bukannya set klip terpencil. Untuk urutan yang dirancang, Custom Multi-Shot membolehkan anda menentukan kandungan, susunan, dan tempoh setiap shot, supaya potongan dan rentak ditetapkan sebelum penjanaan bermula.
Hasilkan Dialog dan Bunyi Adegan Secara Serentak
Apabila model video menghasilkan visual sahaja, adegan dialog memerlukan kerja tambahan. Suara, bunyi ambien, efek, dan pemasaan semuanya perlu diurus kemudian. Tambahkan beberapa watak, dan anda juga perlu menjejak siapa yang menyampaikan setiap dialog serta memastikan bunyi sepadan dengan aksi yang betul di skrin.
Audio Asli Kling VIDEO 3.0 menjana dialog, bunyi ambien dan audio lain bersama video. Dalam adegan berbilang watak, anda boleh memberikan dialog kepada pembicara berbeza, dengan sokongan untuk Bahasa Cina, Bahasa Inggeris, Bahasa Jepun, Bahasa Korea dan Bahasa Sepanyol, serta dialek dan aksen yang disokong. Pertuturan, persembahan watak dan bunyi adegan terbina dalam generasi yang sama dan bukannya ditindihkan pada klip senyap kemudian.
Cipta Cerita Lebih Panjang dengan Sehingga 15 Saat dan Output 4K
Kling VIDEO 3.0 memberi pencipta lebih ruang untuk membangunkan setiap adegan, dengan penjanaan fleksibel 3–15 saat bagi interaksi watak, penceritaan berbilang shot, dialog dan peralihan. Dalam aliran kerja yang disokong, output sehingga 4K mengekalkan perincian halus, tekstur dan kejelasan visual keseluruhan, membantu pencipta bergerak daripada konsep awal kepada kandungan yang digilap untuk pengiklanan, pameran produk, penceritaan sinematik dan banyak lagi.
Tamat
Model teks ke video yang berbaloi dengan masa anda melakukan lebih daripada sekadar menganimasikan prompt: model tersebut mengikuti niat anda, bergerak secara semula jadi, hadir bersama audio, dan mengekalkan subjek stabil merentasi setiap shot. Diukur terhadap kriteria itu, Kling VIDEO 3.0 menggabungkan penjanaan dipacu prompt, kawalan Multi-Shot, konsistensi subjek, dan audio natif dalam satu platform. Buka Kling, tulis babak anda, dan saksikan ia hidup dengan satu penjanaan.
Soalan Lazim
Bagaimana Saya Memilih Antara Model AI Teks ke Video Terbaik pada tahun 2026?
Mulakan dengan jenis video yang anda mahu hasilkan, kemudian bandingkan model yang sesuai dengan tugas itu. Penceritaan multi-shot memberikan lebih penekanan pada kawalan kamera dan konsistensi watak. Babak yang banyak dialog memerlukan audio yang mantap, penyegerakan bibir, dan persembahan watak, manakala kerja produk dan iklan lebih bergantung pada pematuhan terhadap prompt, kestabilan subjek, dan kualiti output. Panjang dan resolusi juga penting, kerana ujian pantas dan kerja siap jarang mempunyai keperluan yang sama. Kling VIDEO 3.0 menggabungkan Multi-Shot, Audio Asli, pematuhan terhadap prompt, dan penjanaan sehingga 15 saat untuk cerita multi-shot, babak yang dipacu dialog, dan projek di mana watak atau produk yang sama perlu kekal boleh dikenali merentasi shot.
Bolehkah Teks ke Video AI Menyertakan Bunyi?
Ya. Kling VIDEO 3.0 boleh menjana dialog, bunyi persekitaran dan kesan bersama video, jadi anda tidak perlu menambah audio selepas itu. Anda boleh menulis dialog tersebut terus ke dalam prompt, menetapkannya kepada watak tertentu, dan memilih bahasa, dialek atau loghat. Keupayaan text-to-speechnya boleh menukarkan dialog tersebut menjadi suara watak dalam bahasa Cina, Inggeris, Jepun, Korea dan Sepanyol. Ini bermakna kerja alih suara berasingan yang lebih sedikit dan kurang penyusunan audio selepas video dijana.
Berapa Panjangkah Video Terjana?
Panjang video berbeza mengikut model. Kling VIDEO 3.0 menyokong penjanaan fleksibel antara 3 hingga 15 saat. Klip yang lebih pendek berfungsi baik untuk aksi pantas dan kandungan sosial, manakala klip yang lebih panjang memberikan lebih banyak masa untuk pembinaan, dialog dan penceritaan berbilang babak. Untuk video siap yang memerlukan perincian visual yang lebih halus, mod yang disokong turut menawarkan output sehingga 4K, memberikan tekstur produk, perincian watak dan kedalaman adegan lebih kejelasan.
Adakah Saya Memerlukan Kemahiran Penyuntingan Video?
Jika anda ingin membuat perubahan selepas penjanaan, aliran kerja penyuntingan VIDEO 3.0 Omni milik Kling membolehkan anda mengubah rakaman sedia ada dengan arahan bahasa semula jadi, termasuk mengubah latar belakang, subjek, gaya atau pembingkaian.