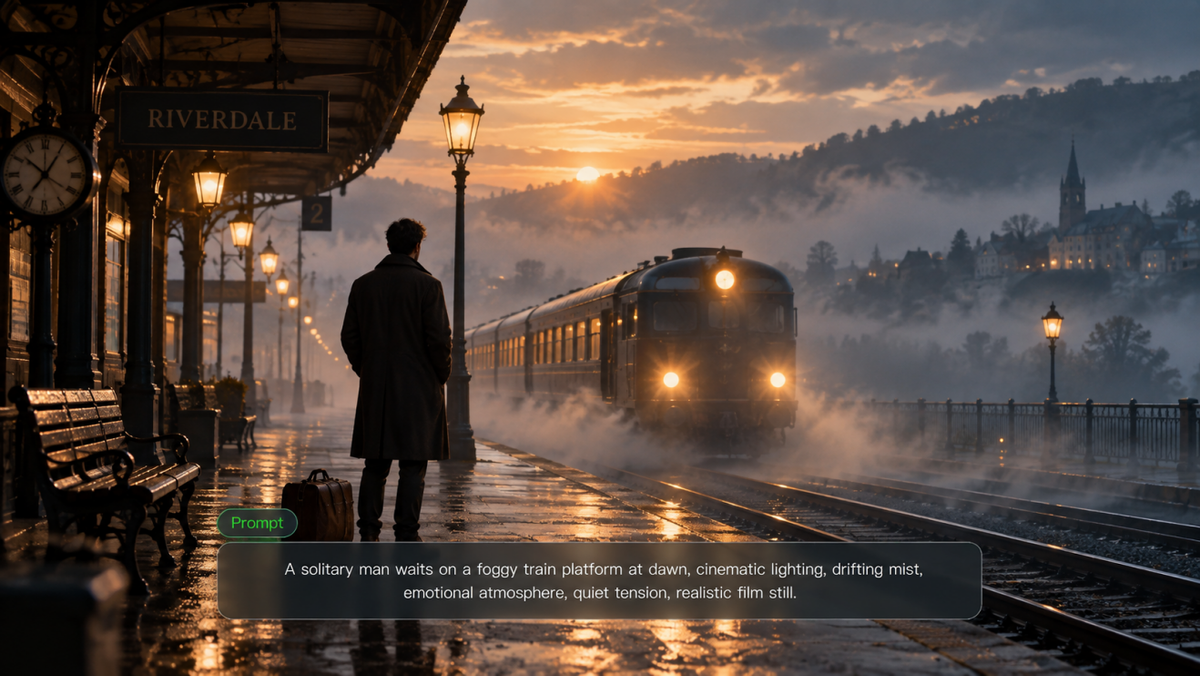
โมเดลแปลงข้อความเป็นวิดีโอสามารถเปลี่ยนฉากที่เขียนไว้ให้กลายเป็นวิดีโอที่มีการเคลื่อนกล้อง เสียง และหลายช็อตได้ สิ่งที่ต้องระวังคือคลิปที่เสร็จแล้วอาจยังไม่ตรงกับพรอมต์ เคลื่อนไหวอย่างน่าอึดอัด หรือปล่อยให้ตัวละครหรือสินค้าเปลี่ยนไปจากหนึ่งช็อตไปอีกช็อต บทความนี้อธิบายว่าความแตกต่างเหล่านั้นสำคัญอย่างไร สิ่งที่ควรตรวจสอบก่อนเลือกโมเดล และวิธีที่ Kling VIDEO 3.0 จัดการการควบคุมช็อต การเคลื่อนไหว เสียง และความต่อเนื่องทางภาพ
โมเดลแปลงข้อความเป็นวิดีโอคืออะไร?
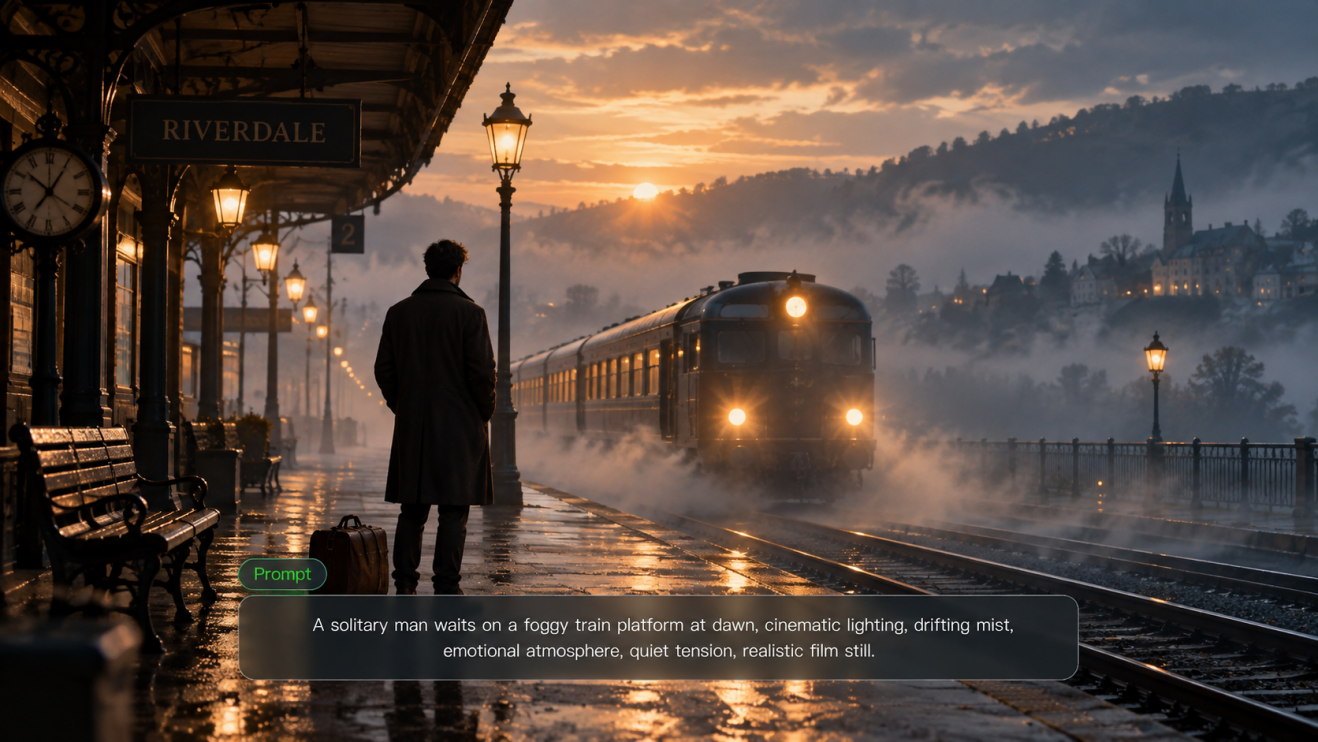
โมเดลแปลงข้อความเป็นวิดีโอ ใช้ AI เชิงสร้างสรรค์เพื่อเปลี่ยนคำบรรยายภาษาธรรมชาติให้เป็นวิดีโอ พรอมต์สามารถระบุหัวเรื่อง ฉาก การกระทำ การเคลื่อนกล้อง และสไตล์ภาพได้ หากโมเดลรองรับเสียง ก็สามารถใส่บทสนทนา เสียงบรรยากาศ และสัญญาณเสียงอื่น ๆ ได้ด้วย
โมเดลแปลงข้อความเป็นวิดีโอและตัวสร้าง AI แปลงข้อความเป็นวิดีโอมักถูกมองว่าเป็นสิ่งเดียวกัน แต่จริง ๆ แล้วมีบทบาทต่างกัน:
โมเดลแปลงข้อความเป็นวิดีโอ | ตัวสร้าง AI แปลงข้อความเป็นวิดีโอ | |
คืออะไร | ระบบ AI ที่ตีความพรอมต์และสร้างวิดีโอ | ผลิตภัณฑ์หรืออินเทอร์เฟซที่ผู้คนใช้เพื่อเข้าถึงการสร้างวิดีโอจากข้อความ |
สิ่งที่จัดการ | การตีความพรอมต์ การสร้างฉาก การเคลื่อนไหว และความต่อเนื่องตลอดช่วงเวลา | ฟีเจอร์ที่สร้างขึ้นรอบโมเดล เช่น การควบคุมช็อต อินพุตอ้างอิง เสียง ระยะเวลา อัตราส่วนกว้างยาว การตัดต่อ และการส่งออก |
เหตุใดจึงสำคัญ | โมเดลมีผลโดยตรงต่อคุณภาพวิดีโอ การเคลื่อนไหว และความสม่ำเสมอทางภาพ | ตัวสร้างมีผลต่อระดับการควบคุมด้านความคิดสร้างสรรค์ที่คุณมีและสิ่งที่คุณสามารถทำกับวิดีโอภายหลังได้ |
โมเดลเป็นตัวกำหนดว่าสิ่งใดจะถูกสร้างขึ้น ในขณะที่ AI video generator เป็นตัวกำหนดว่าคุณจะเข้าถึงความสามารถเหล่านั้นได้อย่างไร ควบคุมกระบวนการ และทำงานกับวิดีโอที่เสร็จสมบูรณ์อย่างไร
โมเดลข้อความสู่วิดีโอทำงานอย่างไร?
โมเดลข้อความสู่วิดีโอจะแปลงข้อความพรอมต์ให้เป็นลำดับของภาพเคลื่อนไหว กระบวนการที่แน่ชัดจะแตกต่างกันไปตามโมเดล แต่โดยทั่วไปจะเกี่ยวข้องกับการทำความเข้าใจพรอมต์ การสร้างตัวแทนของฉากในรูปแบบที่บีบอัด การคำนวณว่าทุกอย่างเปลี่ยนแปลงไปตามเวลาอย่างไร และการรักษาผลลัพธ์ให้สม่ำเสมอจากช่วงเวลาหนึ่งไปยังอีกช่วงหนึ่ง
1. ตีความพรอมต์
โมเดล AI แปลงข้อความเป็นวิดีโอ เริ่มต้นด้วยการระบุคำสั่งหลักในพรอมต์ ได้แก่:
- ตัวแบบ
- การกระทำ
- ฉาก
- สไตล์ภาพ
- ทิศทางของกล้อง
- บทสนทนาหรือสัญญาณเสียงอื่น ๆ เมื่อมีการรองรับ
| พรอมต์: “นักปั่นจักรยานขี่ผ่านถนนใจกลางเมืองที่ฝนตกขณะที่กล้องติดตามอยู่ด้านหลัง” |
คำอธิบายสั้น ๆ นั้นประกอบด้วยคำสั่งหลายข้อที่ต้องทำงานร่วมกัน นักปั่นจักรยานเคลื่อนไปข้างหน้า กล้องติดตามจากด้านหลัง และฝน ถนน แสง และสภาพแวดล้อมโดยรอบต้องสอดคล้องกันภายในช็อตเดียวกัน
กล่าวอีกนัยหนึ่ง พรอมต์อธิบายมากกว่าสิ่งที่ควรปรากฏบนหน้าจอ มันยังกำหนดความสัมพันธ์ระหว่างตัวแบบ การเคลื่อนไหว กล้อง และสภาพแวดล้อมด้วย
2. สร้างการแทนวิดีโอแบบบีบอัด
หลังจากอ่านพรอมต์แล้ว ระบบจำเป็นต้องมีการแทนภาพของฉากที่สามารถใช้งานได้ก่อนที่จะกลายเป็นฟุตเทจที่เสร็จสมบูรณ์ วิธีการที่แน่นอนขึ้นอยู่กับสถาปัตยกรรมของโมเดล
โมเดล text-to-video ที่อาศัยวิธี diffusion จำนวนมากทำงานในพื้นที่การแทนภาพที่ถูกบีบอัดแทนที่จะประมวลผลเฟรมความละเอียดเต็มตั้งแต่เริ่มต้น พวกมันเริ่มจากสัญญาณรบกวนแล้วค่อย ๆ ปรับให้เป็นรูปตามพรอมต์ นำเอาประธาน ฉาก แสง องค์ประกอบภาพ และรายละเอียดภาพอื่น ๆ ให้ปรากฏขึ้น การทำงานในพื้นที่ที่ถูกบีบอัดนี้ช่วยลดปริมาณข้อมูลที่ต้องจัดการระหว่างการสร้าง และเมื่อฉากมีรูปขึ้นแล้ว ผลลัพธ์จะถูกถอดรหัสออกมาเป็นเฟรมวิดีโอที่มองเห็นได้
3. สร้างการเคลื่อนไหวและปฏิสัมพันธ์
วิดีโอต้องแสดงให้เห็นว่าเกิดอะไรขึ้นจากช่วงหนึ่งไปอีกช่วงหนึ่ง โมเดลต้องสามารถจัดการการเคลื่อนไหว ปฏิสัมพันธ์ของวัตถุ และการเปลี่ยนมุมมองโดยไม่ทำให้ฉากเสียหาย
- การเคลื่อนไหว: ตัวละครที่หมุน เดิน หรือเอื้อมควรเปลี่ยนท่าทางและตำแหน่งทีละขั้น มากกว่าที่จะเปลี่ยนฉับพลันจากสถานะหนึ่งไปอีกสถานะหนึ่ง.
- การโต้ตอบกับวัตถุ: การกระทำต้องมีลำดับที่ชัดเจน หากมีคนหยิบถ้วย มือจะต้องเอื้อมไปถึงและสัมผัสก่อนที่ถ้วยจะขยับ.
- กล้องและพื้นที่: การแพน การทิลต์ การดันกล้องเข้า และการถ่ายติดตามเปลี่ยนมุมมอง แต่ตัวแบบและสิ่งแวดล้อมยังคงต้องยึดอยู่ในพื้นที่เดียวกัน.
ภาพนิ่งต้องอธิบายเพียงช่วงเวลาหนึ่งเท่านั้น วิดีโอต้องคำนึงถึงสิ่งที่เกิดขึ้นระหว่างช่วงเวลาเหล่านั้น.
4. รักษาความสม่ำเสมอด้านเวลาและภาพ-เสียง
เมื่อวิดีโอดำเนินไป ผู้คน วัตถุ และเสียงจำเป็นต้องสอดคล้องกันตลอดเวลา สิ่งนี้โดยหลักแล้วเกี่ยวข้องกับความสม่ำเสมอสองประเภท:
- ความสอดคล้องตามลำดับเวลา: ตัวละคร ผลิตภัณฑ์ เสื้อผ้า อุปกรณ์ประกอบฉาก แสง และฉากหลังไม่ควรเปลี่ยนไปโดยไม่มีเหตุผลชัดเจนจากช่วงเวลาหนึ่งไปอีกช่วงหนึ่ง แม้หลังจากตัดจากภาพระยะใกล้ไปเป็นภาพมุมกว้างหรือเปลี่ยนมุมกล้อง บุคคลหรือผลิตภัณฑ์เดียวกันยังควรสามารถจดจำได้อย่างง่ายดาย.
- ความสอดคล้องด้านภาพและเสียง: บทสนทนา การขยับริมฝีปาก สีหน้าท่าทาง เสียงบรรยากาศ และการกระทำบนหน้าจอจำเป็นต้องเกิดในจังหวะที่ถูกต้อง เมื่อมีตัวละครพูด การขยับปากควรสอดคล้องกับบทสนทนา ขณะที่เสียงฝีเท้าหรือเสียงกระทบควรลงจังหวะพร้อมกับการกระทำนั้น.
คุณสามารถใช้ Text-to-Video AI ทำอะไรได้บ้าง?
Text-to-video AI ใช้งานได้ดีในสถานการณ์ที่แนวคิดจำเป็นต้องถูกมองเห็นก่อนจึงจะคุ้มค่าที่จะผลิตเต็มรูปแบบ เครื่องมือนี้ช่วยในการทดสอบความคิดสร้างสรรค์ช่วงแรก ฉากที่ถ่ายทำยาก และโปรเจ็กต์ที่ต้องการทิศทางภาพหลายแบบก่อนเริ่มการผลิต.
สร้างวิดีโอโซเชียลมีเดีย
คอนเทนต์โซเชียลมีอายุการใช้งานสั้น การจัดกองถ่ายใหม่สำหรับทุกโพสต์หรือแนวคิดแคมเปญจึงแทบไม่คุ้มค่า พรอมต์สามารถสร้างคลิปสำหรับทีเซอร์ การประกาศ โพสต์แคมเปญ หรือวิดีโอนำเสนอเรื่องสั้นได้โดยไม่ต้องตั้งค่าการผลิตใหม่ทุกครั้ง ผู้สร้างยังสามารถลองการตั้งค่า การเคลื่อนกล้อง และทิศทางภาพที่แตกต่างกันก่อนจะตกลงใจเลือกรุ่นหนึ่ง
เปลี่ยนไอเดียสินค้าให้เป็นวิดีโอการตลาด
คำโฆษณาและม็อกอัปแบบภาพนิ่งไม่สามารถแสดงให้เห็นเสมอไปว่าผลิตภัณฑ์จะดูอย่างไรเมื่อเคลื่อนที่ผ่านฉาก AI แปลงข้อความเป็นวิดีโอช่วยให้นักการตลาดวางผลิตภัณฑ์เดียวกันลงในสภาพแวดล้อมที่แตกต่าง สำรวจคอนเซ็ปต์โฆษณา และทดสอบการจัดการภาพได้ตั้งแต่ช่วงต้นกระบวนการ หากผลิตภัณฑ์ปรากฏในหลายช็อต ผลลัพธ์ยังเผยให้เห็นว่ารูปร่าง สี และรายละเอียดสำคัญของมันคงอยู่จากช็อตหนึ่งไปอีกช็อตได้ดีเพียงใด
สร้างฉากเล่าเรื่องสั้นๆ
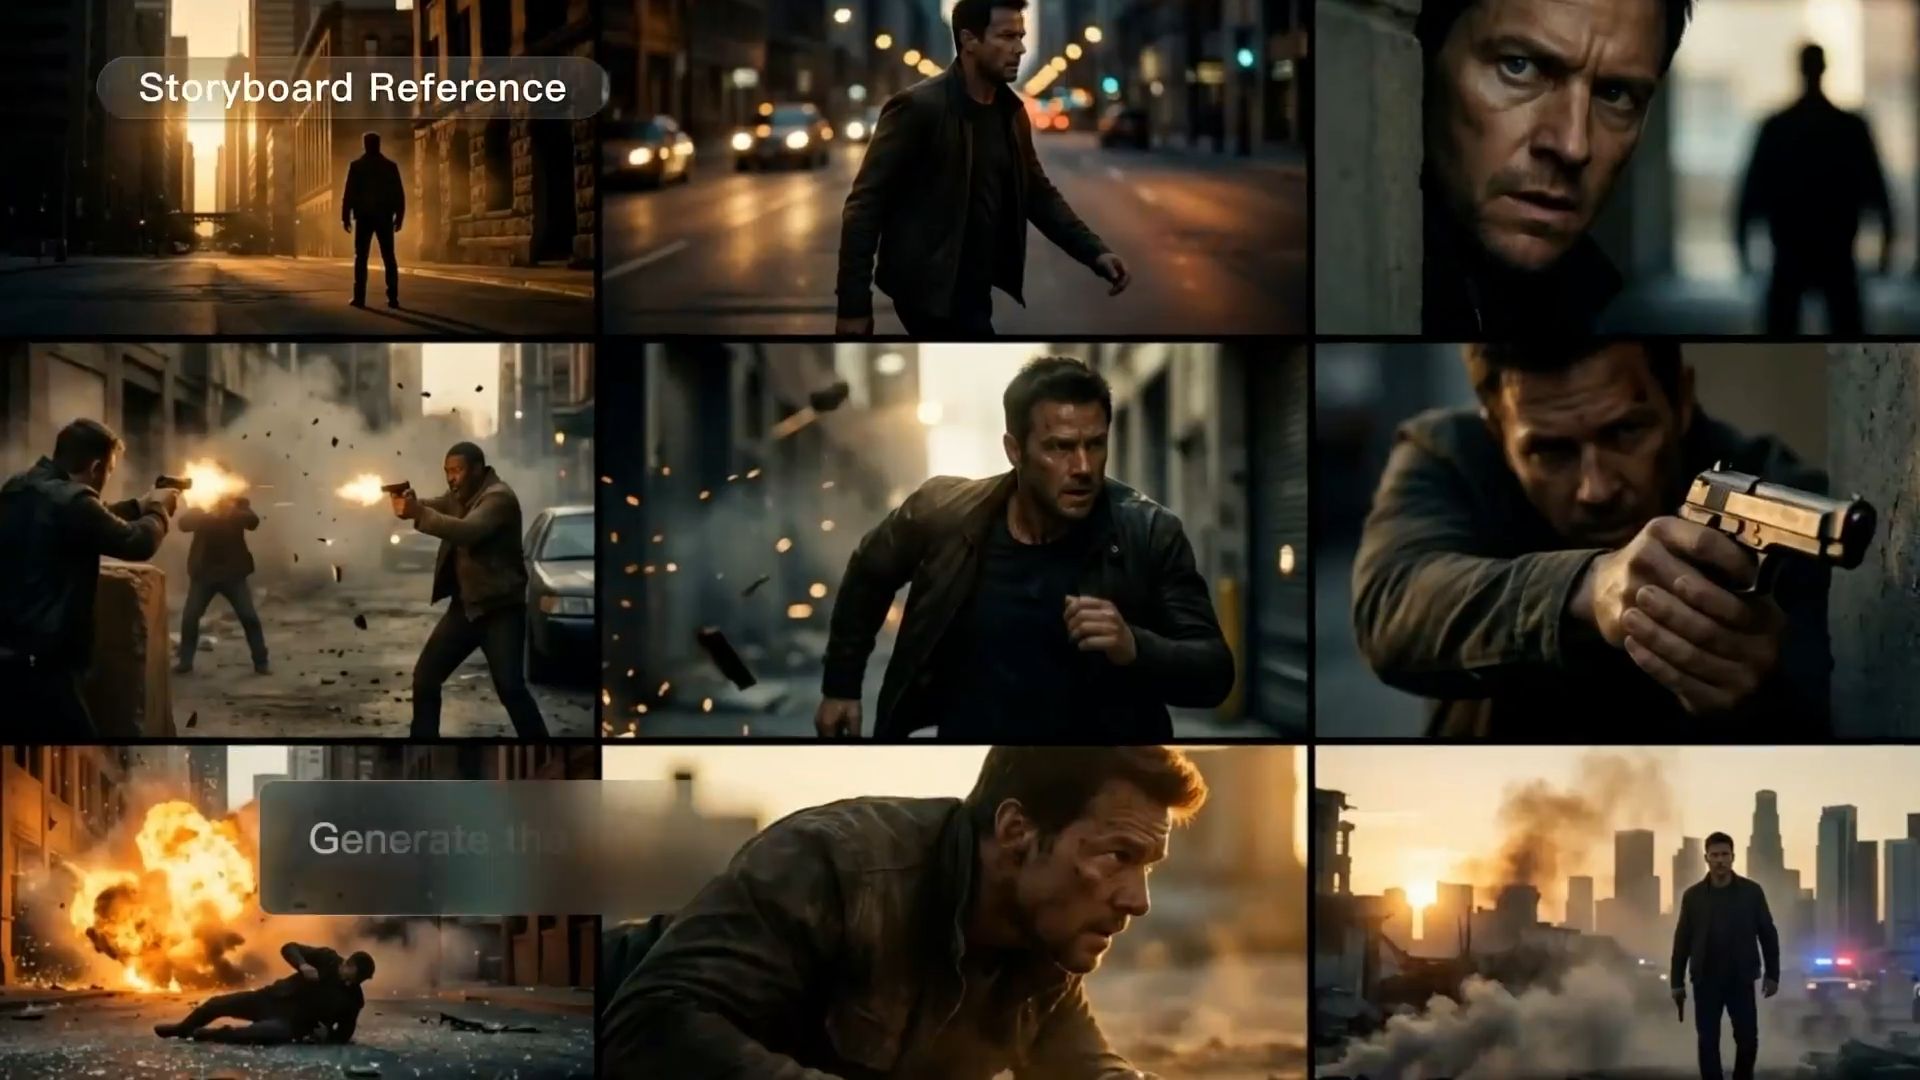
เรื่องสั้นจะวางแผนได้ยากขึ้นเมื่อมีหลายช็อต การกระทำของตัวละคร การเปลี่ยนกล้อง และบทสนทนา AI แปลงข้อความเป็นวิดีโอสามารถจัดองค์ประกอบเหล่านั้นเป็นลำดับ ทำให้ทดสอบลำดับช็อต จังหวะ และเวลาในการสนทนาได้ง่ายขึ้นก่อนที่แต่ละฉากจะถูกสร้างแยกจากกัน สิ่งนี้มีประโยชน์อย่างยิ่งสำหรับผลงานภาพยนตร์สั้นที่เรื่องราวต้องพึ่งพามากกว่าช็อตต่อเนื่องเพียงช็อตเดียว
มองเห็นภาพแนวคิดและสตอรีบอร์ด
ทรีตเมนต์หรือสตอรีบอร์ดสามารถอธิบายสิ่งที่ควรเกิดขึ้นได้ แต่จังหวะเวลาและการเคลื่อนไหวของกล้องประเมินได้ยากบนหน้ากระดาษนิ่ง การเปลี่ยนแนวคิดให้กลายเป็นภาพเคลื่อนไหวทำให้ผู้กำกับ นักออกแบบ และทีมสร้างสรรค์ได้สัมผัสประสบการณ์ใกล้เคียงกับการชมเวอร์ชันสุดท้าย พวกเขาสามารถเปรียบเทียบการจัดเฟรม ทดสอบการเปลี่ยนฉาก และจับช่วงที่อ่อนแอได้ในขณะที่การปรับเปลี่ยนยังทำได้ง่าย
สร้างวิดีโอการสอนและวิดีโออธิบาย
หัวข้อบางอย่างจับภาพด้วยกล้องได้ยากเพราะมีราคาแพง เป็นนามธรรม เข้าถึงไม่ได้ หรือจัดฉากไม่ได้เลย AI แปลงข้อความเป็นวิดีโอสามารถอธิบายกระบวนการ สร้างฉากขึ้นใหม่ หรือแสดงเหตุการณ์ที่ไม่สามารถถ่ายทำโดยตรงได้ สำหรับวิดีโออธิบาย สื่อการฝึกอบรม และเนื้อหาในห้องเรียน การเคลื่อนไหวช่วยให้เข้าใจแนวคิดได้ง่ายขึ้นเมื่อภาพนิ่งให้ข้อมูลไม่เพียงพอ
จะเลือกโมเดล AI แปลงข้อความเป็นวิดีโอที่ดีที่สุดสำหรับโปรเจกต์ของคุณอย่างไร?
ไม่มีโมเดล AI แปลงข้อความเป็นวิดีโอใดโมเดลเดียวที่เหมาะกับทุกโปรเจกต์ เริ่มจากสิ่งที่คุณต้องการสร้าง แล้วตัดสินว่าคุณสมบัติใดสำคัญที่สุดสำหรับงานนั้น สิ่งหลักที่ควรเปรียบเทียบได้แก่ ความสามารถในการยึดตามพรอมต์ การเคลื่อนไหวและความสมจริงทางกายภาพ ความสม่ำเสมอ การควบคุมเชิงสร้างสรรค์ เสียง รวมถึงขีดจำกัดของผลลัพธ์และเวิร์กโฟลว์
การยึดตามพรอมต์
อันดับแรก ตรวจสอบว่าโมเดลปฏิบัติตามพรอมป์จริงหรือไม่ หัวเรื่อง การกระทำ ฉาก สไตล์ภาพ และทิศทางของกล้องควรปรากฏพร้อมกัน ไม่ใช่เฉพาะรายละเอียดที่เด่นชัดที่สุดเท่านั้น หากคุณขอให้สร้างภาพนักปั่นจักรยานที่ขี่ฝ่าสายฝนพร้อมกล้องติดตามจากด้านหลัง นักปั่น สภาพอากาศ การเคลื่อนไหว และมุมมองควรปรากฏครบถ้วน สิ่งที่โมเดลละไว้สามารถบอกคุณได้พอ ๆ กับความเนียนของภาพที่ได้
การเคลื่อนไหวและความสมจริงทางกายภาพ
การกระทำควรดำเนินไปตามลำดับที่ชัดเจน การเดิน การหมุน การเอื้อม การชน และการเคลื่อนของกล้องควรเปลี่ยนจากสถานะหนึ่งไปยังอีกสถานะโดยไม่กระตุกทันที ปฏิสัมพันธ์ทางกายภาพก็สำคัญเช่นกัน: มือควรสัมผัสก่อนที่วัตถุจะเคลื่อน การลงพื้นควรส่งผลกับร่างกาย และเส้นผม ผ้า น้ำ หรือวัตถุหลวม ๆ ควรตอบสนองต่อการเคลื่อนไหวใกล้เคียงแทนที่จะเคลื่อนได้เอง
ความสม่ำเสมอของตัวละครและผลิตภัณฑ์
หัวข้อเดียวกันควรยังคงจดจำได้เมื่อการจัดเฟรม มุม หรือระยะเปลี่ยนไป ใบหน้า เสื้อผ้า รูปร่างผลิตภัณฑ์ สี อุปกรณ์ประกอบฉาก แสง และรายละเอียดสำคัญอื่น ๆ ไม่ควรเปลี่ยนไปโดยไม่มีเหตุผล ฉากหลายช็อตทำให้เรื่องนี้ยากขึ้น ดังนั้นโปรเจ็กต์ที่สร้างขึ้นรอบตัวละครหรือผลิตภัณฑ์ที่ปรากฏซ้ำควรตรวจสอบภาพอ้างอิง การอ้างอิงตัวแบบ หรือวิธีอื่นในการถ่ายทอดเอกลักษณ์ทางภาพจากช็อตหนึ่งไปยังอีกช็อตหนึ่ง
การสร้างสรรค์และการควบคุมกล้อง
เมื่อฉากมีทิศทางภาพที่ชัดเจนอยู่แล้ว การควบคุมมีความสำคัญ การจัดเฟรม การเคลื่อนกล้อง ลำดับช็อต อินพุตอ้างอิง อัตราส่วนภาพ และโครงสร้างหลายช็อต ล้วนส่งผลต่อความใกล้เคียงระหว่างผลลัพธ์กับแนวคิดดั้งเดิม การควบคุมที่ละเอียดขึ้นยังหมายความว่าคุณมีแนวโน้มน้อยลงที่จะต้องรันลำดับทั้งหมดใหม่เพียงเพื่อเปลี่ยนมุม จัดลำดับช็อตใหม่ หรือแก้ไของค์ประกอบ
การรองรับเสียง
ความสามารถด้านเสียงแตกต่างกันมากระหว่างโมเดล บางตัวสร้างได้เฉพาะภาพ ในขณะที่บางตัวสามารถสร้างบทสนทนา เสียงบรรยากาศ และเอฟเฟ็กต์พร้อมกับฟุตเทจได้ สำหรับฉากที่มีบทสนทนามาก ให้ตรวจสอบว่าเสียง การเคลื่อนไหวของปาก สีหน้าท่าทาง และจังหวะเวลายังคงสอดคล้องกันหรือไม่ เสียงฝีเท้า การกระแทก และเสียงสภาพแวดล้อมก็ควรจะตรงกับการเคลื่อนไหวที่เกี่ยวข้องด้วย
ระยะเวลา ความละเอียด และเวิร์กโฟลว์
พิจารณาข้อจำกัดที่ส่งผลต่อวิดีโอสุดท้าย รวมถึงความยาวที่สร้างได้ อัตราส่วนภาพที่รองรับ ความละเอียดที่มีให้ และตัวเลือกการส่งออก คลิปสั้นสำหรับโซเชียลกับฉากผลิตภัณฑ์ที่มีหลายช็อตอาจมีข้อกำหนดการส่งออกที่แตกต่างกันมาก
สิ่งที่เกิดขึ้นหลังการสร้างก็สำคัญไม่แพ้กัน คุณสามารถยืดความยาวคลิป ใช้ตัวแบบเดิมซ้ำ แก้ไขหนึ่งช็อต สร้างเสียงใหม่ หรือแก้ไขต่อโดยไม่ต้องเริ่มต้นใหม่ได้หรือไม่ การเปลี่ยนแปลงเล็กน้อยไม่ควรบังคับให้คุณต้องสร้างลำดับทั้งหมดใหม่
โครงการที่ต่างกันย่อมต้องให้ความสำคัญต่างกัน เริ่มจากประเภทของวิดีโอที่คุณกำลังสร้าง แล้วจึงเน้นความสามารถที่สำคัญที่สุด:
หากคุณต้องการสร้าง | ให้ความสำคัญกับ | เหตุผลที่สำคัญ |
วิดีโอสั้นสำหรับโซเชียล | การยึดตามพรอมต์, อัตราส่วนภาพ, เวิร์กโฟลว์ | เนื้อหาโซเชียลเคลื่อนไหวอย่างรวดเร็ว ดังนั้นผลลัพธ์จึงต้องอยู่ใกล้เคียงกับไอเดีย เข้ากับรูปแบบแพลตฟอร์มที่ใช้กันทั่วไป และปรับแก้ได้ง่าย |
วิดีโอสินค้าและการตลาด | ความสม่ำเสมอของสินค้า, การยึดตามพรอมต์, ความละเอียด | รูปร่าง สี แบรนด์ของสินค้า และรายละเอียดสำคัญต้องคงที่ในทุกช็อต ขณะที่ฟุตเทจสุดท้ายยังตอบโจทย์ความต้องการของแคมเปญหรือการนำเสนอ |
ฉากเล่าเรื่องสั้นหรือฉากเชิงภาพยนตร์ | การเคลื่อนไหวและความสมจริงทางกายภาพ, การควบคุมกล้อง, ความสม่ำเสมอระหว่างหลายช็อต | การเคลื่อนไหวของตัวละคร การเปลี่ยนกล้อง และการเปลี่ยนฉากต้องเชื่อมต่อกันตลอดลำดับโดยไม่เกิดการลอยของภาพที่เห็นได้ชัด |
วิดีโอที่ขับเคลื่อนด้วยบทสนทนา | การรองรับเสียง, การซิงก์ริมฝีปาก, ความสม่ำเสมอของตัวละคร | บทสนทนา การขยับปาก การแสดงบนใบหน้า และอัตลักษณ์ของตัวละครต้องคงสอดคล้องกัน ขณะที่เสียงควรมาถึงในจังหวะที่ถูกต้อง |
พรีวิวแนวคิดและสตอรี่บอร์ด | การควบคุมด้านความคิดสร้างสรรค์และกล้อง, อินพุตอ้างอิง, ความยืดหยุ่นในการแก้ไข | เป้าหมายคือการทดสอบการจัดกรอบ การกำกับกล้อง จังหวะ และแนวคิดทางเลือกตั้งแต่เนิ่นๆ ในขณะที่การเปลี่ยนแปลงยังทำได้ง่าย |
วิดีโอเพื่อการศึกษาและวิดีโออธิบาย | การยึดตามพรอมต์ การเคลื่อนไหวและความเป็นไปได้ทางกายภาพ เวิร์กโฟลว์ | ภาพต้องอธิบายกระบวนการหรือแนวคิดได้อย่างถูกต้อง ให้การเคลื่อนไหวง่ายต่อการติดตาม และเปิดโอกาสให้ปรับแก้ได้เมื่อเนื้อหาเปลี่ยน |
คุณทำอะไรได้บ้างด้วย Kling VIDEO 3.0?
ส่วนที่ยากของการแปลงข้อความเป็นวิดีโอไม่ใช่การได้ช็อตที่ดูดีเพียงช็อตเดียว แต่คือการทำให้ตัวแบบ การกระทำ ทิศทางกล้อง เสียง และรายละเอียดภาพเล็กๆ จากพรอมต์ปรากฏขึ้นตามที่คุณตั้งใจ เมื่อพรอมต์มีรายละเอียดมากขึ้นและฉากเพิ่มจำนวนช็อต โมเดลก็ต้องติดตามสิ่งต่างๆ ให้ทันจากช่วงเวลาหนึ่งไปยังอีกช่วงเวลาหนึ่งมากขึ้น
Kling VIDEO 3.0 ถูกสร้างขึ้นมาเพื่อตอบโจทย์ความต้องการเหล่านั้น ด้วยความสามารถในการตีความพรอมต์ที่แข็งแกร่งขึ้น การเล่าเรื่องหลายช็อต ความสม่ำเสมอของตัวแบบ เสียงแบบเนทีฟ ระยะเวลาที่ยืดหยุ่น และการเรนเดอร์ข้อความ แทนที่จะเขียนคำบรรยายแล้วรอดูผลลัพธ์เฉย ๆ คุณสามารถกำหนดได้ว่าบทเรื่องจะดำเนินไปอย่างไร เมื่อกล้องเปลี่ยนมุม ตัวแบบเชื่อมต่อกันระหว่างช็อตอย่างไร และเสียงจะเข้ามาในฉากตรงไหน
เข้าใจและทำตามพรอมต์ได้แม่นยำยิ่งขึ้น
Kling VIDEO 3.0 สามารถตีความพรอมต์แบบหลายชั้นที่ผสมผสานตัวแบบ การกระทำ ฉาก ทิศทางกล้อง และโครงสร้างเรื่องราวเข้าด้วยกัน สิ่งนี้ช่วยให้พรอมต์ text-to-video ที่ซับซ้อนรักษาความใกล้เคียงกับฉากที่ตั้งใจไว้ได้มากขึ้น โดยเฉพาะเมื่อมีหลายการกระทำ การขยับกล้องที่วางแผนไว้ หรือมีลำดับเหตุการณ์เฉพาะ
รักษาความสม่ำเสมอของตัวละครและผลิตภัณฑ์ตลอดทุกช็อต
ตัวละครอาจดูถูกต้องในช็อตหนึ่งแต่ยังคงเปลี่ยนไปอย่างเห็นได้ชัดเมื่อมองจากมุมอื่น ในวิดีโอแบบหลายช็อต ใบหน้าอาจขยับ รายละเอียดเสื้อผ้าอาจเบี่ยง และสี รูปร่าง หรือคุณลักษณะเด่นของผลิตภัณฑ์อาจเปลี่ยนไปจากช็อตหนึ่งไปสู่อีกช็อตหนึ่ง
ในเวิร์กโฟลว์ VIDEO 3.0 ที่รองรับการช่วยด้วยภาพอ้างอิง คุณสามารถใช้ภาพอ้างอิงหลายภาพเพื่อให้คำแนะนำทางภาพเพิ่มเติมและช่วยยึดโยงตัวละครที่ปรากฏซ้ำ ผลิตภัณฑ์ หรือหัวข้อสำคัญอื่น ๆ ให้คงอยู่แม้จะมีการเปลี่ยนกรอบภาพ มุม และฉากอันหลากหลาย การอ้างอิงเหล่านี้มอบข้อมูลเพิ่มเติมให้กับโมเดลเกี่ยวกับลักษณะภายนอกและรายละเอียดทางภาพสำคัญของหัวข้อ ซึ่งช่วยลดการลอยของภาพที่เห็นได้ชัดในฉากตัวละครที่ปรากฏซ้ำ ช็อตสินค้า และคอนเทนต์ที่มีแบรนด์
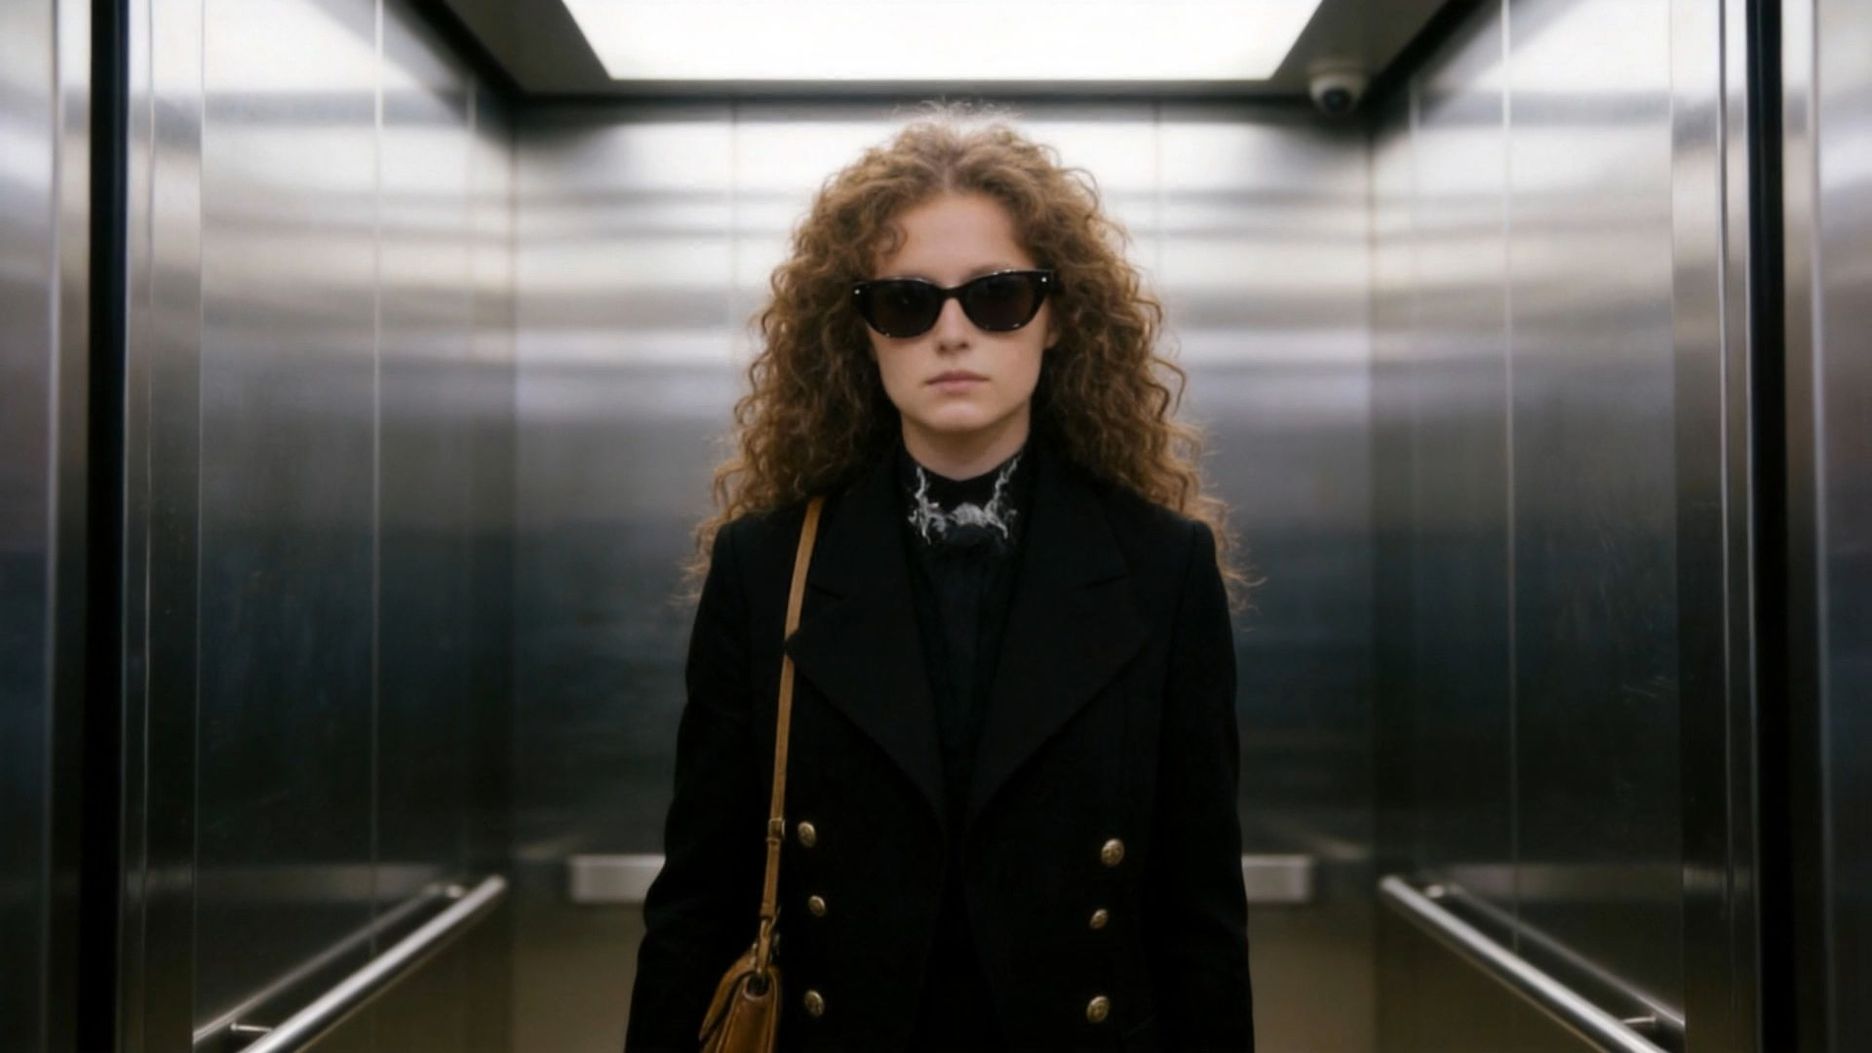

สร้างเรื่องราวแบบหลายช็อตพร้อมการควบคุมจังหวะที่มากขึ้น
ช็อตเดียวโดยทั่วไปจัดการได้ไม่ยาก ความท้าทายเกิดขึ้นเมื่อเรื่องราวต้องการภาพระยะใกล้ มุมกว้าง ตำแหน่งกล้องที่แตกต่าง และการเปลี่ยนฉาก การสร้างแต่ละช็อตแยกกันหมายถึงต้องประกอบเพิ่มเติมในภายหลัง และยิ่งรักษาจังหวะและความต่อเนื่องของลำดับได้ยากขึ้น
Multi-Shot ของ Kling VIDEO 3.0 สามารถจัดการหลายช็อตในการสร้างครั้งเดียว เปลี่ยนพรอมต์เดียวให้กลายเป็นลำดับที่เชื่อมต่อกันแทนที่จะเป็นคลิปแยกกัน สำหรับลำดับที่วางแผนไว้ Custom Multi-Shot ช่วยให้คุณกำหนดเนื้อหา ลำดับ และระยะเวลาของแต่ละช็อต เพื่อให้จังหวะการตัดและความเร็วถูกกำหนดไว้ก่อนเริ่มสร้าง
สร้างบทสนทนาและเสียงประกอบฉากพร้อมกัน
เมื่อโมเดลวิดีโอสร้างเฉพาะภาพ ฉากบทสนทนาจึงตามมาด้วยงานเพิ่มเติม เสียงพูด เสียงบรรยากาศ เอฟเฟ็กต์ และจังหวะเวลา ล้วนต้องจัดการภายหลัง หากมีตัวละครหลายคน คุณยังต้องติดตามว่าใครพูดแต่ละบรรทัด และว่าเสียงนั้นตรงกับการกระทำบนหน้าจอหรือไม่
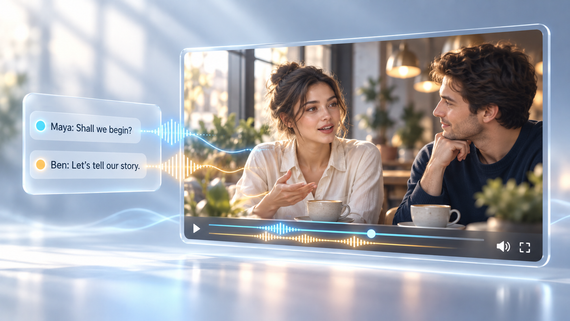
ฟีเจอร์ Native Audio ของ Kling VIDEO 3.0 จะสร้างบทสนทนา เสียงบรรยากาศ และเสียงอื่น ๆ พร้อมกับวิดีโอ ในฉากที่มีหลายตัวละคร คุณสามารถมอบบทพูดให้ผู้พูดแต่ละคนได้ โดยรองรับภาษาจีน อังกฤษ ญี่ปุ่น เกาหลี และสเปน รวมถึงสำเนียงและภาษาถิ่นที่รองรับ เสียงพูด การแสดงของตัวละคร และเสียงประกอบฉากถูกผสานอยู่ในกระบวนการสร้างเดียวกัน แทนที่จะนำมาใส่ทับบนคลิปเงียบในภายหลัง
สร้างเรื่องราวที่ยาวขึ้นได้สูงสุด 15 วินาที พร้อมเอาต์พุตระดับ 4K
Kling VIDEO 3.0 มอบพื้นที่ให้ครีเอเตอร์พัฒนาฉากแต่ละฉากได้มากขึ้น ด้วยการสร้างที่ยืดหยุ่นตั้งแต่ 3–15 วินาทีสำหรับการปฏิสัมพันธ์ของตัวละคร การเล่าเรื่องแบบหลายช็อต บทสนทนา และการเปลี่ยนฉาก ในเวิร์กโฟลว์ที่รองรับ เอาต์พุตสูงสุดระดับ 4K จะช่วยรักษารายละเอียด เนื้อสัมผัส และความคมชัดของภาพโดยรวม ช่วยให้ครีเอเตอร์ก้าวจากแนวคิดเริ่มต้นไปสู่คอนเทนต์ที่ผ่านการขัดเกลาเพื่อการโฆษณา การนำเสนอสินค้า การเล่าเรื่องเชิงภาพยนตร์ และอื่น ๆ
จบ
โมเดลเท็กซ์สู่วิดีโอที่คุ้มค่ากับเวลาของคุณทำได้มากกว่าแค่ทำให้พรอมต์ขยับได้: พวกมันทำตามเจตนาของคุณ เคลื่อนไหวอย่างเป็นธรรมชาติ มาพร้อมเสียง และรักษาตัวแบบให้คงที่ตลอดทุกช็อต เมื่อประเมินจากเกณฑ์เหล่านี้ Kling VIDEO 3.0 นำการสร้างที่ขับเคลื่อนด้วยพรอมต์ การควบคุม Multi-Shot ความสม่ำเสมอของตัวแบบ และเสียงเนทีฟมารวมไว้ในที่เดียว เปิด Kling เขียนฉากของคุณ แล้วดูมันมีชีวิตขึ้นมาภายในการสร้างเพียงครั้งเดียว
คำถามที่พบบ่อย
ฉันจะเลือกจากโมเดล AI แปลงข้อความเป็นวิดีโอที่ดีที่สุดในปี 2026 ได้อย่างไร?
เริ่มจากประเภทของวิดีโอที่คุณต้องการสร้าง แล้วค่อยเปรียบเทียบโมเดลที่ออกแบบมาสำหรับงานนั้น การเล่าเรื่องแบบหลายช็อตให้ความสำคัญกับการควบคุมกล้องและความสม่ำเสมอของตัวละครมากขึ้น ฉากที่เต็มไปด้วยบทสนทนาต้องการระบบเสียงที่แข็งแกร่ง การซิงก์ริมฝีปาก และการแสดงของตัวละคร ในขณะที่งานผลิตภัณฑ์และโฆษณาพึ่งพาการยึดตามพรอมต์ ความเสถียรของวัตถุ และคุณภาพของผลลัพธ์ ความยาวและความละเอียดก็สำคัญเช่นกัน เพราะการทดสอบอย่างรวดเร็วกับงานที่เสร็จสมบูรณ์มักมีข้อกำหนดไม่เหมือนกัน Kling VIDEO 3.0 ผสาน Multi-Shot, Native Audio, การยึดตามพรอมต์ และการสร้างวิดีโอนานสูงสุด 15 วินาที สำหรับเรื่องราวหลายช็อต ฉากที่ขับเคลื่อนด้วยบทสนทนา และโปรเจ็กต์ที่ต้องการให้ตัวละครหรือผลิตภัณฑ์เดียวกันยังคงเป็นที่จดจำได้ในแต่ละช็อต
AI Text to Video สามารถใส่เสียงได้หรือไม่?
ใช่ Kling VIDEO 3.0 สามารถสร้างบทสนทนา เสียงบรรยากาศ และเอฟเฟ็กต์พร้อมกับวิดีโอได้ ดังนั้นคุณจึงไม่จำเป็นต้องเพิ่มเสียงในภายหลัง คุณสามารถเขียนบทพูดลงในพรอมต์ได้โดยตรง กำหนดให้กับตัวละครเฉพาะ และเลือกภาษา สำเนียง หรือการออกเสียงได้ ความสามารถการแปลงข้อความเป็นเสียงของมันสามารถเปลี่ยนบทเหล่านั้นให้เป็นเสียงของตัวละครในภาษาจีน อังกฤษ ญี่ปุ่น เกาหลี และสเปน ซึ่งหมายความว่าคุณต้องทำงานพากย์เสียงแยกต่างหากน้อยลงและประกอบเสียงเพิ่มเติมหลังจากสร้างวิดีโอเสร็จน้อยลง
วิดีโอที่สร้างขึ้นสามารถยาวได้แค่ไหน?
ความยาวของวิดีโอจะแตกต่างกันไปตามโมเดล Kling VIDEO 3.0 รองรับการสร้างแบบยืดหยุ่นตั้งแต่ 3 ถึง 15 วินาที คลิปที่สั้นกว่าจะเหมาะกับการเคลื่อนไหวที่รวดเร็วและคอนเทนต์โซเชียล ในขณะที่คลิปที่ยาวกว่าจะเปิดเวลาให้การปูเรื่อง บทสนทนา และการเล่าเรื่องแบบหลายช็อตมากขึ้น สำหรับวิดีโอที่เสร็จสมบูรณ์ซึ่งต้องการรายละเอียดภาพที่ละเอียดกว่า โหมดที่รองรับยังสามารถส่งออกได้สูงสุดถึง 4K ให้รายละเอียดพื้นผิวสินค้า รายละเอียดตัวละคร และความลึกของฉากคมชัดขึ้น
ฉันจำเป็นต้องมีทักษะการตัดต่อวิดีโอหรือไม่?
หากคุณต้องการทำการเปลี่ยนแปลงหลังการสร้าง เวิร์กโฟลว์การตัดต่อ VIDEO 3.0 Omni ของ Kling ช่วยให้คุณแก้ไขฟุตเทจที่มีอยู่ด้วยคำสั่งภาษาธรรมชาติ รวมถึง การเปลี่ยนพื้นหลัง ตัวแบบ สไตล์ หรือการจัดเฟรม