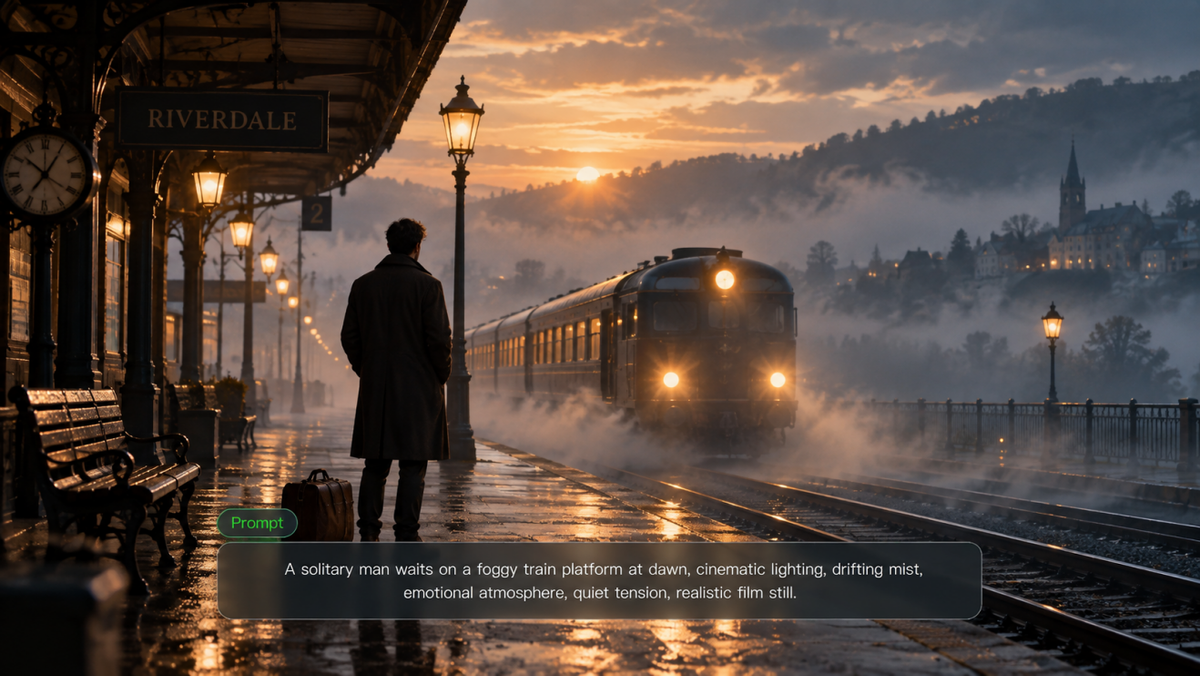
Моделі текст-у-відео можуть перетворити описану словами сцену на відео з рухом камери, звуком і кількома кадрами. Проте готовий ролик усе ще може не відповідати підказці, рухатися незграбно або дозволяти персонажу чи продукту змінюватися від одного кадру до наступного. Ця стаття розглядає, чому ці відмінності важливі, що перевірити перед вибором моделі та як Kling VIDEO 3.0 забезпечує керування кадрами, рух, аудіо й візуальну цілісність.
Що таке моделі текст-у-відео?
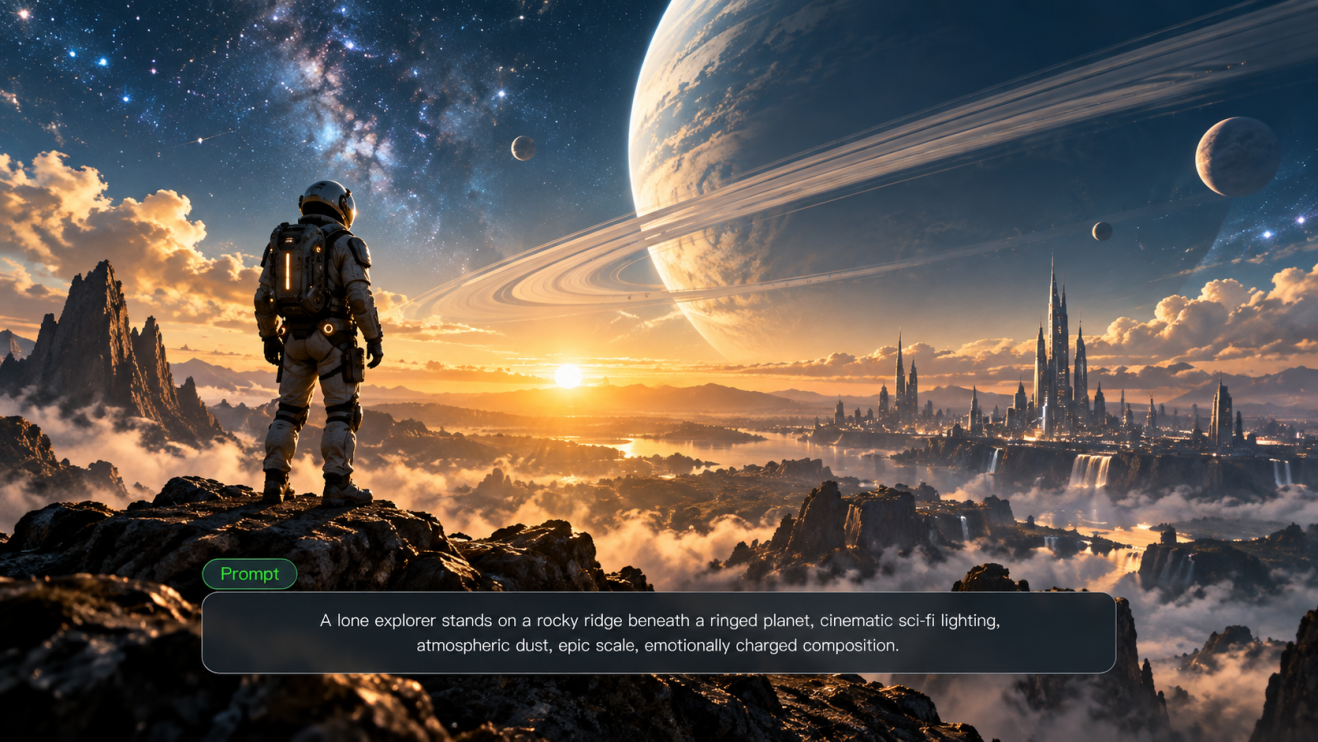
Моделі текст-у-відео використовують генеративний ШІ, щоб перетворювати описи природною мовою на відео. Підказка може визначати тему, місце дії, дію, рух камери та візуальний стиль. Якщо модель підтримує аудіо, вона також може включати діалоги, фонові звуки та інші аудіосигнали.
Моделі текст-у-відео та генератори ШІ текст-у-відео часто вважають тим самим, проте вони виконують різні ролі:
Модель текст-у-відео | Генератор ШІ текст-у-відео | |
Що це таке | Система ШІ, яка інтерпретує запит і генерує відео | Продукт або інтерфейс, яким користуються люди, щоб отримати доступ до генерації відео з тексту |
Що він опрацьовує | Інтерпретація запитів, створення сцен, рух і безперервність у часі | Функції, побудовані навколо моделі, такі як керування кадрами, референсні вхідні дані, аудіо, тривалість, співвідношення сторін, редагування та експорт |
Чому це важливо | Модель безпосередньо впливає на якість відео, рух і візуальну узгодженість | Генератор визначає, наскільки великий у вас творчий контроль і що ви зможете зробити з відео згодом |
Модель визначає, що саме буде згенеровано, тоді як генератор відео на основі ШІ визначає, як ви отримуєте доступ до цих можливостей, контролюєте процес і працюєте з готовим відео.
Як працюють моделі перетворення тексту у відео?
Моделі перетворення тексту у відео перетворюють написаний запит на послідовність рухомих зображень. Точний процес відрізняється залежно від моделі, але зазвичай включає розуміння запиту, створення стислої репрезентації сцени, визначення того, як об’єкти змінюються з часом, і підтримання послідовності результату від одного моменту до іншого.
1. Інтерпретуйте підказку
Модель ШІ для перетворення тексту на відео починає з визначення основних інструкцій у підказці, зокрема:
- об’єкт
- дія
- локація
- візуальний стиль
- напрямок камери
- діалог або інші аудіопідказки, якщо це підтримується
| запит: "Велосипедист їде дощовою вулицею в центрі міста, а камера слідує позаду." |
Цей короткий опис містить кілька інструкцій, які мають працювати разом. Велосипедист рухається вперед, камера слідує ззаду, а дощ, вулиця, освітлення й оточення мають бути узгодженими в одному кадрі.
Іншими словами, запит описує більше, ніж просто те, що має з'явитися на екрані. Він також встановлює взаємозв'язки між об'єктом, рухом, камерою та оточенням.
2. Створіть стиснене представлення відео
Після прочитання підказки система потребує робочого представлення сцени, перш ніж вона перетвориться на готовий відеоматеріал. Точний метод залежить від архітектури моделі.
Багато моделей текст-у-відео на основі дифузії працюють у стисненому просторі представлень, а не обробляють кадри з повною роздільною здатністю від самого початку. Вони починають із шуму і поступово формують його відповідно до підказки, виводячи у поле зору об’єкт, налаштування, освітлення, композицію та інші візуальні деталі. Робота в цьому стисненому просторі зменшує обсяг даних, що опрацьовуються під час генерації, і щойно сцена набуває форми, результат декодується у видимі відеокадри.
3. Генеруйте рух і взаємодії
Відео має показувати, що відбувається від одного моменту до наступного. Модель повинна обробляти рух, взаємодію об’єктів і зміни точки зору, не руйнуючи сцену.
- Рух: персонаж, що повертається, йде або тягнеться, має змінювати позу та положення поступово, крок за кроком, а не перескакувати з одного стану в інший.
- Взаємодія з об'єктами: дії мають відбуватися в чіткій послідовності. Якщо хтось бере чашку, рука повинна дотягнутися до неї та торкнутися її, перш ніж чашка почне рухатись.
- Камера і простір: панорами, нахили, наближення та трекінгові проходки змінюють точку зору, але об'єкт і оточення все одно мають залишатися закріпленими в тому самому просторі.
Нерухоме зображення описує лише один момент. Відео повинно враховувати те, що відбувається між моментами.
4. Підтримуйте часову й аудіовізуальну узгодженість
У міру розвитку відео люди, об'єкти та звук мають залишатися узгодженими в часі. Це переважно зводиться до двох видів узгодженості:
- Тимчасова узгодженість: Персонажі, продукти, одяг, реквізит, освітлення та фони не повинні без очевидної причини змінюватися від одного моменту до наступного. Навіть після переходу від крупного плану до загального або зміни ракурсу камери ту саму людину чи продукт усе ще має бути легко впізнати.
- Аудіовізуальна узгодженість: Діалоги, рух губ, міміка, фоновий звук та дії на екрані мають відбуватися у належний момент. Коли персонаж говорить, рух губ має збігатися з діалогом, а звуки кроків чи ударів повинні синхронізуватися з дією, до якої належать.
Для чого можна використовувати ШІ текст-у-відео?
ШІ текст-у-відео добре працює в ситуаціях, коли ідею потрібно побачити, перш ніж варто запускати повномасштабне виробництво. Він може допомогти з раннім креативним тестуванням, сценами, які важко зняти, та проєктами, що потребують кількох візуальних напрямів до початку виробництва.
Створюйте відео для соцмереж
Соціальний контент має короткий термін життя, тож організовувати нову зйомку для кожної публікації чи концепції кампанії рідко має сенс. Промпт може згенерувати кліпи для тизерів, анонсів, публікацій кампаній або коротких сюжетних відео без необхідності щоразу перебудовувати знімальний процес. Креатори також можуть випробувати різні налаштування, рухи камери та візуальні напрямки, перш ніж зупинитися на одній версії.
Перетворюйте ідеї продукту на маркетингові відео
Текст і статичні макети не завжди показують, як виглядатиме продукт, коли він рухається сценою. Текст-у-відео ШІ дозволяє маркетологам розміщувати той самий продукт у різних середовищах, досліджувати рекламні концепції та тестувати візуальні рішення на ранніх етапах процесу. Якщо продукт з’являється в кількох кадрах, результати також показують, наскільки добре його форма, колір і визначальні деталі зберігаються від одного кадру до наступного.
Створюйте короткі сюжетні сцени
Коротке оповідання стає складнішим для планування, щойно воно включає кілька кадрів, дії персонажів, зміни камери та діалог. ШІ перетворення тексту на відео може зіставити ці елементи в послідовність, що полегшує тестування порядку кадрів, ритму й таймінгу діалогу ще до того, як кожну сцену створять окремо. Це особливо корисно для коротких кінематографічних робіт, де сюжет залежить від більш ніж одного безперервного кадру.
Візуалізуйте концепції та сторіборди
Тритмент або сторіборд може пояснити, що має відбутися, але час і рух камери важче оцінити на статичній сторінці. Перетворення ідеї на рух дає режисерам, дизайнерам і креативним командам щось ближче до остаточного глядацького досвіду. Вони можуть порівнювати кадрування, тестувати переходи й помічати слабкі моменти, поки зміни ще легко вносити.
Створюйте навчальні та пояснювальні відео
Деякі об’єкти важко зафіксувати на камеру, тому що вони дорогі, абстрактні, недоступні або неможливо відтворити. Текст-у-відео ШІ може проілюструвати процес, реконструювати обстановку або показати подію, яку не можна зняти безпосередньо. Для пояснювальних матеріалів, навчальних ресурсів і класного контенту рух може зробити концепцію легшою для розуміння, коли статичне зображення не показує достатньо.
Як обрати найкращу модель текст-у-відео ШІ для вашого проєкту?
Жодна єдина модель текст-у-відео ШІ не підходить для кожного проєкту. Почніть із того, що ви хочете створити, а потім визначте, які можливості мають найбільше значення для цього завдання. Основні речі для порівняння — це відповідність запиту, рух і фізична правдоподібність, послідовність, творчий контроль, аудіо, а також обмеження виходу й робочого процесу.
Відповідність запиту
Спершу перевірте, чи модель справді дотримується запиту. Тема, дія, оточення, візуальний стиль і напрям камери мають з'являтися разом, а не лише найочевидніші деталі. Якщо ви просите показати велосипедиста, який їде крізь дощ, а камера слідує ззаду, то велосипедист, погода, рух і точка зору мають бути присутні. Те, що модель опускає, може сказати вам не менше, ніж те, наскільки відшліфованими виглядають кадри.
Рух і фізична правдоподібність
Дії мають розгортатися у чіткій послідовності. Кроки, повороти, потягування, зіткнення та рух камери повинні переходити з одного стану в інший без раптових стрибків. Важлива і фізична взаємодія: рука має торкатися об’єкта, перш ніж той почне рухатися; приземлення повинно впливати на тіло; а волосся, тканина, вода чи вільні предмети мають реагувати на сусідній рух, а не поводитися самостійно.
Послідовність персонажів і продукту
Один і той самий об'єкт має залишатися впізнаваним, навіть коли змінюються кадрування, кут або відстань. Обличчя, одяг, форма продукту, колір, реквізит, освітлення та інші визначальні деталі не повинні змінюватися без причини. Багатокадрові сцени ускладнюють це, тож проєкти, побудовані навколо повторюваних персонажів або продуктів, також слід перевіряти на наявність референсних зображень, референсів персонажів або іншого способу перенесення візуальної ідентичності з кадру до кадру.
Креативність та керування камерою
Коли сцена вже має чіткий візуальний напрям, контроль має значення. Кадрування, рух камери, порядок кадрів, референсні вхідні дані, співвідношення сторін і багатокадрова структура впливають на те, наскільки результат відповідає початковій ідеї. Точніший контроль також означає, що вам рідше доведеться запускати всю послідовність знову лише для того, щоб змінити кут, переставити кадр або виправити композицію.
Підтримка аудіо
Можливості роботи зі звуком сильно різняться між моделями. Деякі генерують лише візуальний ряд, тоді як інші можуть створювати діалоги, фоновий звук і ефекти разом із відеоматеріалом. Для сцен з великою кількістю діалогів перевірте, чи залишаються узгодженими голос, рухи рота, міміка та таймінг. Кроки, удари та звуки довкілля також мають синхронізуватися з відповідною дією.
Тривалість, роздільна здатність і робочий процес
Подивіться на обмеження, які впливають на фінальне відео, зокрема тривалість генерації, підтримувані співвідношення сторін, доступні роздільні здатності та варіанти експорту. Короткий соціальний ролик і багатокадрова продуктова сцена можуть мати кардинально різні вимоги до результату.
Те, що відбувається після генерації, є не менш важливим. Чи можете ви подовжити кліп, повторно використати той самий об'єкт, переробити окремий кадр, згенерувати звук заново або продовжити монтаж без перезапуску з нуля? Невеликі зміни не повинні змушувати вас перебудовувати всю послідовність.
Різні проєкти потребують різних пріоритетів. Почніть із типу відео, яке ви створюєте, а потім зосередьтеся на можливостях, що мають найбільше значення:
Якщо ви хочете створити | Віддавайте перевагу | Чому це важливо |
Короткі відео для соцмереж | Дотримання промпту, співвідношення сторін, робочий процес | Соціальний контент рухається швидко, тому результат має залишатися близьким до ідеї, відповідати поширеним форматам платформ і легко піддаватися редагуванню. |
Продуктові та маркетингові відео | Послідовність продукту, дотримання промпту, роздільна здатність | Форма продукту, колір, брендинг і ключові деталі мають залишатися стабільними між кадрами, водночас фінальний відеоряд повинен відповідати вимогам кампанії чи презентації. |
Короткі сюжетні або кінематографічні сцени | Рух і фізична правдоподібність, керування камерою, узгодженість між кількома кадрами. | Дії персонажів, зміни камери та переходи між сценами мають поєднуватися упродовж усієї послідовності без помітного візуального дрейфу. |
Відео, побудовані на діалогах | Підтримка аудіо, синхронізація губ, цілісність образу персонажа | Діалоги, рухи рота, міміка та ідентичність персонажів мають залишатися узгодженими, а звук повинен з'являтися в потрібний момент. |
Попередні перегляди концепцій і сторіборди | Творчий контроль і керування камерою, опорні вхідні матеріали, гнучкість для правок | Мета полягає в тому, щоб на ранньому етапі протестувати кадрування, напрямок камери, темп і альтернативні ідеї, поки зміни ще легко вносити. |
Навчальні та пояснювальні відеоролики | Відповідність підказці, рух і фізична правдоподібність, робочий процес | Візуальні матеріали мають точно пояснювати процес або ідею, робити рухи легкими для відстеження та дозволяти вносити правки, коли змінюється контент. |
Що ви можете зробити з Kling VIDEO 3.0?
Найскладніша частина тексту-в-відео полягає не в тому, щоб отримати один гарний кадр. Складність у тому, щоб забезпечити, аби суб'єкт, дія, напрямок камери, звук і дрібні візуальні деталі з підказки з'являлися так, як ви задумали. Коли підказки стають детальнішими, а сцени доповнюються більшою кількістю кадрів, моделі доводиться відстежувати ще більше з моменту в момент.
Kling VIDEO 3.0 побудовано навколо цих вимог, із покращеним тлумаченням запитів, багатокадровим сторітелінгом, узгодженістю об'єктів, вбудованим звуком, гнучкою тривалістю та відтворенням тексту. Замість того, щоб написати опис і просто чекати результату, ви можете формувати, як розгортається історія, коли змінюється камера, як об'єкти переходять між кадрами та де звук входить у сцену.
Точніше розумійте й виконуйте запити
Kling VIDEO 3.0 може інтерпретувати багаторівневі запити, що поєднують об'єкти, дії, налаштування, напрямок камери та наративну структуру. Це допомагає складним текст-у-відео запитам залишатися ближчими до задуманої сцени, особливо коли вони включають кілька дій, заплановані рухи камери або певну послідовність подій.
Зберігайте послідовність персонажів і продуктів між кадрами
Персонаж може виглядати правильно в одному кадрі, але помітно змінюватися під іншим кутом. У багатокадровому відео обличчя можуть зміщуватися, деталі одягу — відхилятися, а колір, форма чи визначальні характеристики продукту можуть змінюватися від одного кадру до іншого.
У підтримуваних робочих процесах VIDEO 3.0 з референсною підтримкою ви можете використовувати кілька референсних зображень, щоб надати додаткові візуальні підказки й допомогти закріпити повторюваного персонажа, продукт або інший ключовий об’єкт попри зміни кадрування, кута й оточення. Ці референси дають моделі більше інформації про зовнішність об’єкта та ключові візуальні деталі, допомагаючи зменшити очевидний візуальний дрейф у сценах із повторюваними персонажами, кадрах продуктів і брендованому контенті.

Створюйте багатокадрові історії з більшим контролем над темпом
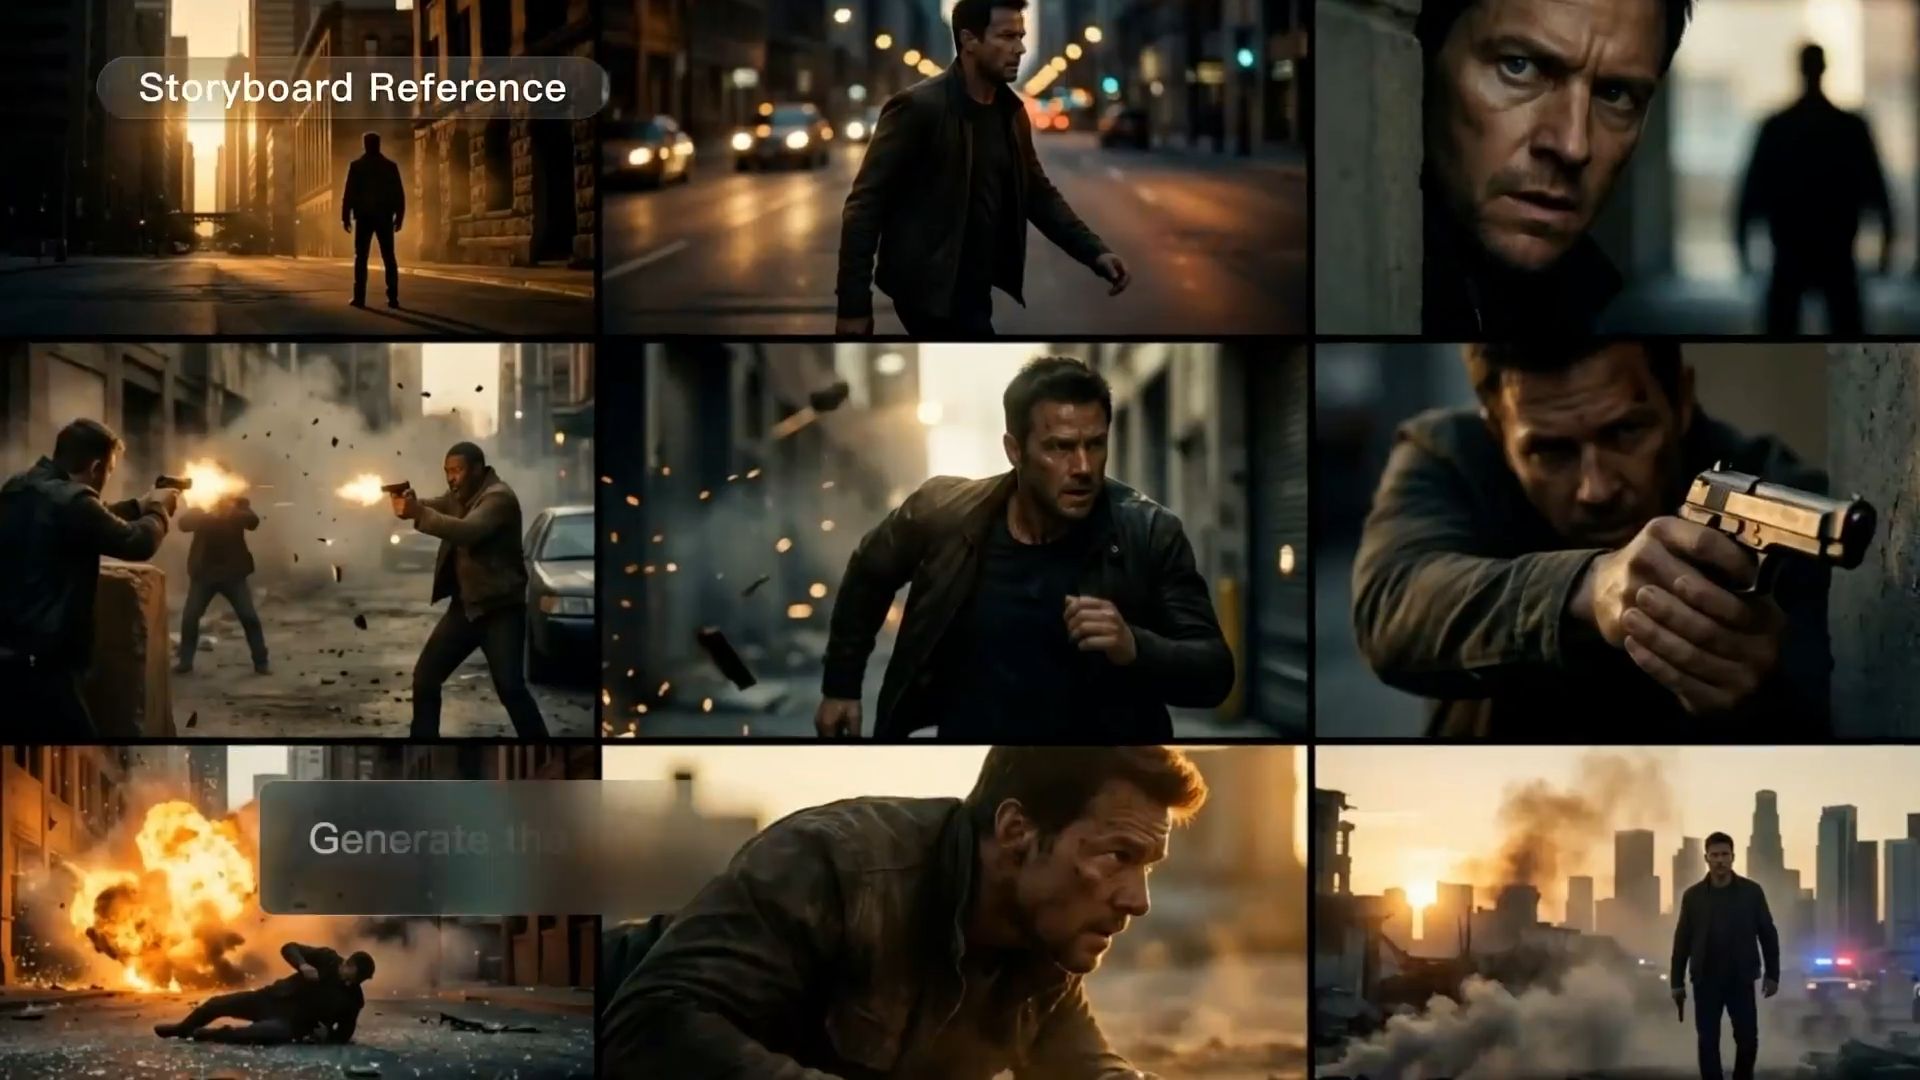
Один кадр зазвичай не становить проблем. Складнощі починаються, коли історії потрібні крупні плани, широкі кадри, різні позиції камери та зміни сцен. Генерація кожного кадру окремо означає більше монтажу згодом, і стає важче зберігати темп і безперервність у всій послідовності.
Функція Multi-Shot у Kling VIDEO 3.0 може опрацьовувати кілька кадрів за одну генерацію, перетворюючи єдиний запит на пов'язану послідовність, а не на набір ізольованих кліпів. Для запланованої послідовності Custom Multi-Shot дозволяє визначити вміст, порядок і тривалість окремих кадрів, тож монтаж і темп задаються ще до початку генерації.
Створюйте діалоги та звук сцени одночасно
Коли відеомодель створює лише зображення, сцени з діалогами вимагають додаткової роботи. Голоси, фонові звуки, ефекти й синхронізацію доводиться додавати пізніше. Якщо є кілька персонажів, потрібно ще й стежити, хто промовляє кожну репліку та чи збігається звук із відповідною дією на екрані.
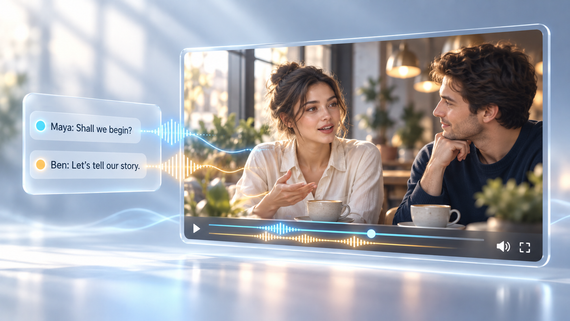
Функція Native Audio в Kling VIDEO 3.0 генерує діалоги, фонові звуки та інший аудіосупровід разом із відео. У багатоперсонажних сценах ви можете призначати репліки різним мовцям, з підтримкою китайської, англійської, японської, корейської та іспанської мов, а також відповідних діалектів і акцентів. Мова, акторська гра персонажів і звуковий супровід сцени інтегруються одразу під час генерації, а не накладаються згодом на беззвучний ролик.
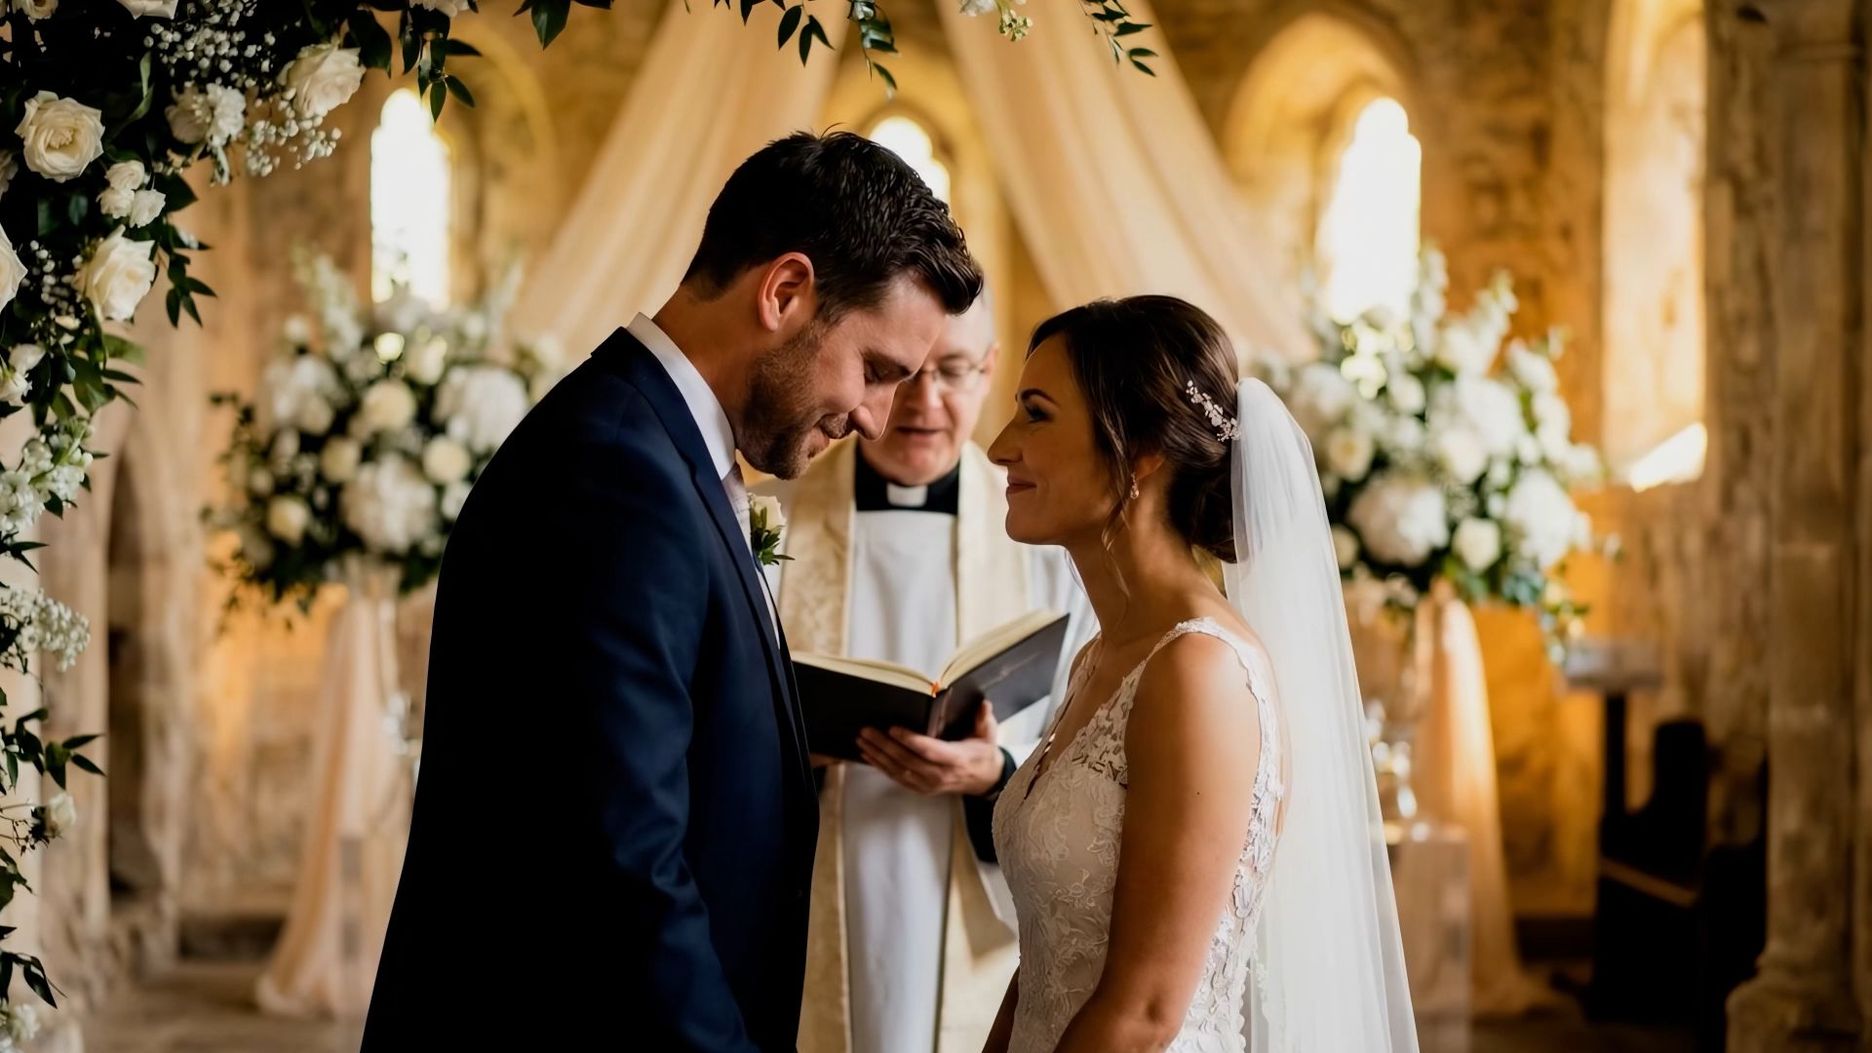
Створюйте довші історії тривалістю до 15 секунд і з виведенням у 4K
Kling VIDEO 3.0 надає авторам більше простору для опрацювання кожної сцени, пропонуючи гнучку генерацію тривалістю 3–15 секунд для взаємодій між персонажами, багатокадрового сторітелінгу, діалогів і переходів. У підтримуваних робочих процесах виведення до 4K зберігає найдрібніші деталі, текстури та загальну чіткість зображення, допомагаючи авторам переходити від ранніх концепцій до відшліфованого контенту для реклами, демонстрацій продуктів, кінематографічного сторітелінгу тощо.
Кінець
Моделі перетворення тексту на відео, які справді варті вашого часу, роблять більше, ніж просто анімувати підказку: вони відстежують ваш намір, рухаються природно, додають звук і утримують об’єкт стабільним між кадрами. За цими критеріями Kling VIDEO 3.0 поєднує у собі генерацію, керовану підказками, контроль Multi-Shot, сталість об’єкта та рідний звук в одному місці. Відкрийте Kling, опишіть свою сцену — і спостерігайте, як вона оживає за одну генерацію.
Поширені запитання
Як обрати серед найкращих текст-у-відео моделей ШІ у 2026 році?
Почніть з типу відео, яке ви хочете створити, а потім порівняйте моделі, що відповідають цьому завданню. Багатокадрове оповідання робить більший акцент на контролі камери та послідовності персонажів. Сцени з великою кількістю діалогів потребують якісного звуку, синхронізації губ і переконливої гри персонажів, тоді як робота з продуктами та рекламою більше залежить від відповідності підказці, стабільності об'єкта та якості результату. Важливими є також тривалість і роздільна здатність, адже швидкий тест і завершена робота рідко мають однакові вимоги. Kling VIDEO 3.0 поєднує Multi-Shot, Native Audio, відповідність підказці та генерацію тривалістю до 15 секунд для багатокадрових історій, сцен, керованих діалогом, і проєктів, де той самий персонаж або продукт має залишатися впізнаваним у різних кадрах.
Чи може ШІ для перетворення тексту у відео містити звук?
Так. Kling VIDEO 3.0 може генерувати діалоги, фонові звуки та ефекти разом із відео, тому вам не потрібно додавати звук потім. Ви можете вписати репліки безпосередньо в підказку, призначити їх конкретним персонажам і обрати мову, діалект або акцент. Її можливість text-to-speech може перетворювати ці репліки на голоси персонажів китайською, англійською, японською, корейською та іспанською. Це означає менше окремої роботи з озвучування та менше збирання аудіо після створення відео.
Якої довжини може бути згенероване відео?
Тривалість відео залежить від моделі. Kling VIDEO 3.0 підтримує гнучке створення тривалістю від 3 до 15 секунд. Коротші кліпи добре підходять для швидких дій і соціального контенту, тоді як довші залишають більше часу для розвитку, діалогів і багатокадрового сторітелінгу. Для готових відео, яким потрібна тонша візуальна деталізація, підтримувані режими також пропонують вихід аж до 4K, що надає текстурам продукту, деталям персонажів і глибині сцени більше чіткості.
Чи потрібні мені навички відеомонтажу?
Якщо вам потрібно внести зміни після генерації, робочий процес редагування VIDEO 3.0 Omni від Kling дозволяє коригувати наявні кадри за допомогою інструкцій природною мовою, включно із зміною фону, об'єктів, стилю або кадрування.