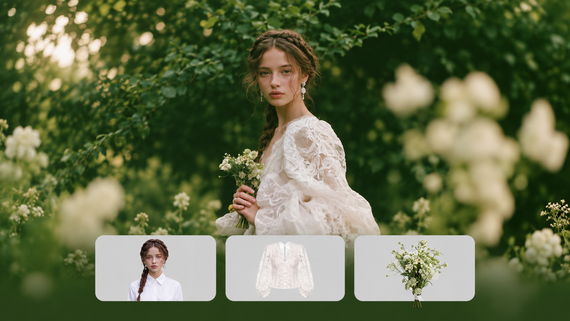
AI generatif kini memiliki peran yang mapan dalam produksi video, dengan model generasi video AI digunakan di seluruh konten sosial, periklanan, peluncuran produk, dan penceritaan bentuk pendek. Ketika model video AI generatif menjadi bagian dari produksi profesional, para kreator membandingkan bagaimana berbagai model AI untuk generasi video merespons prompt, aset referensi, audio, dan arahan pengambilan gambar. Panduan ini membandingkan 10 model video AI di sepanjang dimensi produksi tersebut, kemudian meninjau lebih dekat bagaimana seri Kling VIDEO 3.0 bekerja dengan prompt, aset referensi, arahan multi-shot, dan audio dalam alur kerja yang sama.
Apa Itu Model Generasi Video AI?
Model generasi video AI adalah sistem yang membuat, mengedit, atau menganimasi video dari teks, gambar, materi referensi, atau rekaman yang sudah ada. Model tersebut bekerja lintas waktu alih-alih memperlakukan setiap frame secara terpisah, dengan memperhitungkan perubahan gerakan subjek, pencahayaan, posisi kamera, dan struktur adegan.
Input awal penting karena model yang berbeda dibangun berdasarkan cara kerja yang berbeda.
Tipe | Titik Awal | Apa yang Dilakukannya | Paling Cocok Untuk |
Prompt tertulis | Membangun sebuah adegan dari deskripsi tentang subjek, latar, aksi, framing, atau pergerakan kamera | Memulai dari sebuah ide tanpa visual yang sudah ada | |
Gambar statis | Menambahkan gerakan pada subjek, lingkungan, atau kamera sambil mempertahankan gambar sebagai basis visual | Menganimasikan seseorang, produk, karya seni, atau adegan dengan tampilan yang sudah mapan | |
Video Multimodal dan Berbasis Referensi | Teks, gambar, video, atau beberapa referensi | Menggunakan beberapa masukan untuk memandu penampilan, gerakan, karakter, produk, atau struktur pengambilan gambar | Proyek yang memerlukan lebih banyak kontinuitas atau arahan yang lebih ketat dalam sebuah shot atau sekuens |
Apa yang Membuat Model Generasi Video AI Berbeda?
Pada pandangan pertama, banyak model video AI dapat menangani tugas dasar serupa. Perbedaannya menjadi jauh lebih mudah terlihat setelah Anda melihat bagaimana mereka mengikuti instruksi, menjaga stabilitas adegan, mengatur pengambilan gambar, dan menangani suara.
Kepatuhan terhadap Prompt: Seberapa akurat model mengikuti instruksi untuk penempatan subjek, aksi, komposisi, tempo, dan pergerakan kamera.
Pergerakan dan Konsistensi: Apakah pergerakan terlihat alami dan apakah orang, produk, pakaian, atau lingkungan tetap dapat dikenali sepanjang video.
Audio Bawaan: Beberapa model dapat menghasilkan dialog, suara ambien, dan efek bersamaan dengan video, sementara yang lain memerlukan langkah audio terpisah.
Multi-Shot dan Kontrol Kamera: Beberapa model berfokus pada satu pengambilan pendek, sementara yang lain dapat menangani pergantian pengambilan, sudut kamera, pergerakan kamera, dan urutan multi-shot.
Resolusi dan Durasi: Model berbeda-beda dalam seberapa lama mereka dapat menghasilkan dan resolusi keluaran apa yang mereka dukung, yang dapat memengaruhi jenis proyek yang paling sesuai bagi mereka.
Apa Model Generasi Video AI Terbaik pada 2026?
Tidak ada satu model pun yang bekerja paling baik untuk setiap proyek video. Di bawah ini, kami membandingkan 10 model generasi video AI saat ini berdasarkan gerakan, referensi, suara, arahan pengambilan gambar, durasi, dan kualitas keluaran.
Model | Berguna Untuk | Masukan | Konsistensi Referensi | Audio Asli | Multi-Shot / Kontrol Kamera | Durasi / Output | Pertimbangan |
| Adegan multi-shot, karakter berulang, dialog multibahasa dalam lima bahasa, alur kerja berbasis referensi | Teks, gambar, bingkai awal/akhir dan Elements; Omni menerima kombinasi materi referensi yang lebih luas | Elements dapat membawa karakter, produk, dan subjek berulang lainnya di berbagai bidikan | Ya | Generasi multi-shot, penyesuaian waktu bidikan, pembingkaian, sudut, dan pergerakan kamera | Hingga 15 detik; output 4K tersedia dalam alur kerja yang didukung | Proyek yang dibangun di sekitar beberapa referensi, karakter yang dapat digunakan kembali, atau elemen yang tertaut dengan suara lebih sesuai dipadankan dengan VIDEO 3.0 Omni. | |
Google Veo 3.1 | Adegan pendek di mana gambar dan suara dihasilkan secara bersamaan. | Teks, gambar, ekstensi video, frame pertama/terakhir, dan hingga tiga gambar referensi. | Gambar referensi dan input frame dapat mengaitkan subjek dan komposisi. | Ya | Masukan frame pertama/terakhir, arah kamera dipandu prompt dan perpanjangan video | 4, 6 atau 8 detik; 720p, 1080p atau 4K tergantung pengaturannya | Generasi gambar referensi, 1080p, dan 4K menggunakan durasi 8 detik. |
Runway Gen-4.5 | Prompt terperinci, aksi terjadwal, dan bidikan dipandu kamera | Teks atau teks plus gambar | Sebuah gambar input menetapkan titik awal visual. | Audio ditangani di luar proses generasi Gen-4.5. | Pengarahan kamera dan aksi berbasis prompt yang terperinci. | 2–10 dtk; 720p | Gen-4.5 saat ini menghasilkan keluaran pada 720p, sementara bagian lain dari platform Runway menangani tugas produksi tambahan. |
Seedance 2.5 | Urutan yang lebih panjang dan proyek yang dibangun dari beberapa referensi | Teks plus referensi gambar, video, dan audio | Mendukung kumpulan referensi besar lintas subjek, adegan, dan suara | Ya | Struktur multi-shot, transisi antar shot, kerja kamera, dan pengeditan pada tingkat penanda waktu | Hingga 30 detik per generasi, dengan perpanjangan | Kumpulan referensi yang lebih luas memberi tim lebih banyak materi untuk diatur sebelum proses generasi. |
Wan 3.0 | Proyek yang lebih panjang yang memanfaatkan beberapa jenis materi sumber | Teks, gambar, video, audio, dokumen, dan halaman web | Referensi multimodal dapat dibawa ke dalam generasi yang sama | Ya | Sekuen berdurasi panjang, pergerakan kamera berkelanjutan, dan pengarahan multimodal | Hingga 30 detik; 1080p | Ketersediaan dan sumber daya yang didukung dapat berbeda menurut pasar dan jalur akses. |
Luma Ray3.2 | Mengerjakan ulang, mengubah gaya, atau mengarahkan kembali cuplikan yang sudah ada | Video sumber, prompt, dan keyframe | Mempertahankan struktur dari sumber sambil memungkinkan perubahan visual | Bukan bagian utama dari alur kerja Ray3.2 | Hingga 64 keyframe dapat menambatkan momen tertentu dalam linimasa video sumber | Dirancang berdasarkan alur kerja video sumber | Ray3.2 saat ini terutama berfokus pada alur kerja video sumber, khususnya generasi video-ke-video |
MiniMax Hailuo 2.3 | Gerakan manusia, aksi, dan performa ekspresif | Teks dan gambar | Masukan gambar dapat menetapkan subjek sebelum gerakan ditambahkan | Tidak tercantum sebagai bagian dari model Hailuo 2.3 itu sendiri | Merespons instruksi gerakan dan kamera | 6 atau 10 detik; 768p atau 1080p bergantung pada mode | Opsi 1080p saat ini terkait dengan generasi yang lebih singkat. |
PixVerse V6 | Potongan naratif pendek, video sosial, dan adegan yang dipandu efek | Teks, gambar, referensi, frame pertama/terakhir, dan alur kerja ekstensi | Alat referensi-ke-video mendukung materi visual berulang | Ya | Multi-shot native dan pengarahan kamera | 1–15 detik; hingga 1080p | Jendela 15 detik cocok untuk format pendek; karya yang lebih panjang memerlukan lebih dari satu kali generasi. |
Seri Vidu Q3 | Adegan yang dipimpin karakter, dialog dalam tiga bahasa, dan narasi pendek | Teks, gambar, frame awal/akhir, dan referensi bergantung pada varian Q3 | Reference-to-video tersedia di seluruh keluarga Q3 | Ya | Kontrol kamera dan tempo pada tingkat frame | Hingga 16 detik; hingga 1080p tergantung variannya | Output audio-video native saat ini mencantumkan bahasa Inggris, Jepang, dan Tionghoa. |
Adobe Firefly Video Model | Pekerjaan merek dan proyek yang berlanjut melalui alat Adobe | Alur kerja teks, gambar, dan referensi komposisi | Gambar atau referensi komposisi dapat memandu bidikan yang dihasilkan | Suara ditangani melalui bagian lain dari alur kerja Firefly | Pengaturan kamera, pembingkaian, dan komposisi | 5 dtk; hingga 1080p | Model video milik Adobe saat ini bekerja dalam generasi berdurasi lima detik, dengan proyek yang lebih panjang dirakit melalui alur kerja yang lebih luas. |
*Spesifikasi mencerminkan kemampuan yang terdokumentasi secara publik pada saat penulisan. Fitur, akses, dan pengaturan keluaran dapat berubah seiring pembaruan model.
Perbandingan ini juga menunjukkan alasan mengapa model-model ini sulit ditempatkan dalam satu peringkat. Mereka cenderung cocok untuk jenis pekerjaan yang berbeda:
- Proyek multi-shot dan dipandu referensi: Kling VIDEO 3.0 / 3.0 Omni, Seedance 2.5, dan Wan 3.0
- Adegan pendek dengan pengarahan ketat: Veo 3.1 dan Runway Gen-4.5
- Pekerjaan gerakan atau rekaman yang sudah ada: Hailuo 2.3 untuk performa fisik, dan Ray3.2 untuk bekerja dari rekaman yang sudah diambil.
- Proyek naratif pendek dan kreator: PixVerse dan Vidu
- Produksi berbasis Adobe: Firefly
Kecocokan terbaik bergantung pada materi yang Anda miliki sejak awal dan apa yang perlu dilakukan oleh video yang sudah jadi.
Bagaimana Memilih Model Pembuatan Video AI Profesional?
Mulailah dari pekerjaan yang ada di depan Anda. Apa yang sedang Anda buat, materi apa yang sudah tersedia, dan detail mana yang harus tetap tidak berubah biasanya akan memberi tahu Anda lebih banyak daripada daftar panjang spesifikasi model.
Pertimbangkan | Tanyakan | Periksa |
Jenis Video | Apakah ini klip produk, adegan dialog, narasi pendek, atau revisi rekaman yang sudah ada? | Model yang sesuai dengan durasi, tempo, dan struktur karya tersebut |
Materi Sumber | Apakah Anda bekerja dari teks, sebuah gambar, beberapa referensi, atau video yang sudah ada? | Dukungan untuk materi yang sudah Anda rencanakan untuk digunakan |
Kontinuitas | Detail mana yang harus tetap dikenali dari satu shot ke shot berikutnya? | Alat untuk menjaga karakter, produk, lokasi, pakaian, atau suara tetap konsisten |
Perencanaan Shot | Apakah Anda memerlukan pembingkaian tetap, pergerakan kamera, waktu yang presisi, atau beberapa bidikan secara berurutan? | Frame awal dan akhir, pengaturan kamera, penentuan waktu bidikan, atau opsi multi-bidikan |
Penyelesaian | Apa yang masih perlu dilakukan setelah klip pertama dihasilkan? | Panjang dan resolusi yang memadai, ditambah opsi audio dan penyuntingan yang dibutuhkan oleh karya akhir |
Hasil pertama itu penting, tetapi itu hanya satu bagian dari pekerjaan. Model yang bekerja dengan baik selama revisi, bidikan tambahan, suara, penyuntingan, dan distribusi mungkin merupakan pilihan yang lebih baik daripada model yang hanya menghasilkan klip pertama yang paling mencolok.
Bagaimana Cara Membuat Video AI dengan Kling VIDEO 3.0?
Begitu Anda mengetahui apa yang paling penting untuk proyek Anda, Anda dapat mengubah pilihan tersebut menjadi pengaturan yang berfungsi. Dengan Seri Kling VIDEO 3.0, Anda dapat mulai dengan teks atau gambar yang sudah ada, menetapkan frame pembuka dan penutup, menjaga subjek penting tetap dikenali dengan Elements, dan menambahkan dialog, suara, atau beberapa bidikan sebelum merender klip.
Langkah 1: Pilih Cara Anda Ingin Memulai
Mulailah dengan materi yang sudah Anda miliki.
- Text-to-Video: Jelaskan subjek, aksi, latar, dan kamera ketika ide dimulai dalam kata-kata.
| Prompt: Pengambilan gambar udara gelombang biru yang menghantam bebatuan, menciptakan pemandangan yang luas dan megah. |
- Image-to-Video: Mulailah dari karakter atau lokasi yang sudah ada, lalu jelaskan gerakan dan perilaku kamera yang ingin Anda perkenalkan. Kling VIDEO 3.0 menggunakan referensi gambar untuk membantu mempertahankan penampilan subjek saat adegan berkembang. VIDEO 3.0 Omni menambahkan pengikatan Element, sehingga lebih mudah menggunakan kembali karakter atau subjek yang sama di berbagai adegan dan video. Bahkan ketika kamera memperbesar, menggeser, atau memiringkan, alur kerja berbasis referensi ini membantu menjaga identitas visual yang lebih konsisten.
| Prompt: Tekstur tempat kerja yang autentik, satu pengambilan panjang berkelanjutan tanpa potongan. Kamera mengikuti wanita profesional tersebut secara stabil dalam shot medium sepanjang adegan, bergerak selaras dengannya: kamera melacaknya saat ia berjalan dan berhenti seketika ketika ia berhenti, dengan gerakan yang alami dan halus serta kerja kamera yang mulus. Wanita itu berjalan maju keluar dari lift, dan pintu lift menutup perlahan dan alami di belakangnya; dia melangkah ke area kantor, melepas kacamata hitamnya dengan tangan, menyelipkannya ke dalam tas komuternya secara santai, dan mengangguk sopan kepada rekan kerja yang lewat; dia berhenti sejenak, kamera ikut membeku secara sinkron, dia menggantung tas komuternya pada rak mantel di area kantor, lalu melepas mantel luarnya dan menggantungnya di rak yang sama; setelah menggantung pakaiannya, dia berjalan maju lagi, kamera melacaknya secara sinkron; seorang pria muda dengan kemeja formal berjalan ke arahnya, menyerahkan sebuah dokumen dan pena tanda tangan, dia berhenti, kamera ikut membeku secara sinkron, mengambilnya dan menandatangani dokumen tersebut;setelah menandatangani, dia berjalan maju lagi, kamera mengikuti gerakannya secara sinkron; akhirnya, dia berjalan ke mejanya, duduk di kursi, meraih cangkir teh di atas meja, dan menyesapnya sambil menunduk, gerakannya santai dan alami. | ||
Frame Awal | ||
| ||
Referensi Karakter | ||
| ||
Video | ||
| ||
Langkah 2: Jelaskan Adegan, Dialog, dan Suara
Setelah materi awal Anda siap, jelaskan apa yang terjadi dalam adegan dan apa yang seharusnya didengar penonton.
Tulis prompt yang mencakup subjek, aksi, latar, dan kamera. Jika adegan mencakup dialog, pasangkan setiap baris dengan karakter yang harus mengucapkannya. Kling VIDEO 3.0 dapat mencocokkan setiap baris dengan pembicara yang tepat ketika beberapa karakter berbagi adegan tersebut.
Gambar |
|
| Prompt: Suasana rumah dengan dengungan samar dari AC ruang tamu di latar belakang untuk nuansa keseharian yang realistis. Ibu (pelan, dengan nada terkejut): Wah, aku sama sekali tidak menyangka alurnya begini. Ayah (dengan suara rendah, setuju, bernada tenang): Ya, ini benar-benar di luar dugaan. Tak pernah terpikir itu akan terjadi. Anak laki-laki (dengan nada bersemangat): Ini plot twist terbaik yang pernah ada! Anak perempuan (ikut mengangguk, dengan nada antusias): Aku tidak percaya mereka melakukan itu! |
Video |
|
Anda juga dapat menyertakan suara ambien dan audio lainnya dalam prompt yang sama. Audio Native memungkinkan dialog, suara latar, dan visual dihasilkan secara bersamaan. Dialog saat ini mendukung bahasa Tionghoa, Inggris, Jepang, Korea, dan Spanyol, termasuk adegan campuran bahasa serta aksen atau dialek yang didukung.
Gambar |
|
| Prompt: Di atap sebuah sekolah menengah Korea, cahaya kota yang jauh berkilau di latar belakang dengan angin lembut yang berdesir, dan bintang-bintang berkelip di langit malam. Gadis itu bersandar pada pagar, larut dalam pikirannya. Anak laki-laki itu berjalan mendekat dengan dua kaleng cola, menyerahkan salah satunya kepadanya, dan ia menerimanya lalu membuka tabnya. Boy (nada santai, Korean): "숙제 다 했어? 왜 여기 있어?" Girl (menghela napas, Korean): "시험이 너무 무서워". Boy (nada lembut, Korean): "걱정 마, 넌 잘할 거야." |
|
Jika sebuah elemen karakter sudah memiliki suara tersimpan yang terpasang dengan Kling VIDEO 3.0 Omni, Anda tidak perlu menjelaskan suara yang sama lagi di dalam prompt.
Langkah 3: Pilih Single-Shot atau Multi-Shot
Biarkan Multi-Shot tetap nonaktif ketika aksi paling baik dilakukan sebagai satu pengambilan kontinu. Jika rangkaian membutuhkan beberapa tampilan, aktifkan.
Kling VIDEO 3.0 dapat menggunakan prompt untuk mengatur perubahan tersebut menjadi rangkaian yang saling terhubung, termasuk pergeseran dalam pembingkaian, sudut pandang, dan sudut kamera.
Gambar |
|
| Prompt: Seorang pria paruh baya sedang memesan makanan di sebuah restoran Barat. Ia berbicara dalam bahasa Inggris dengan aksen India dan berkata: "excuse me, I would like to order a seafood pasta, and a filet mignon. medium-rare", lalu ia menengadah dan melanjutkan: "And, do you have any drink recommendations?" |
Video |
|
Untuk arahan yang lebih spesifik, gunakan Custom Multi-Shot. Anda dapat mendeskripsikan setiap bidikan secara terpisah dan menetapkan durasinya, sehingga lebih mudah berpindah dari wide shot ke close-up, mengganti sudut pandang selama dialog, atau menampilkan aksi yang sama dari beberapa sudut.
Gambar | |||||
| |||||
| Pengambilan 1, bidikan lebar bersudut rendah dari belakang, mengikuti di belakang pengendara saat mereka bergerak maju. | Pengambilan 2, close-up samping bersudut rendah, bidikan detail roda sepeda motor. | Bidikan 3, POV orang pertama dari pengendara, dengan setang dan panel instrumen terlihat di depan. | Bidikan 4, Bidikan medium frontal, bergerak mundur di depan sepeda motor, helm pengendara menghadap kamera. | Bidikan 5, Bidikan pelacakan setinggi mata dari samping dengan sedikit pergerakan lateral. | Bidikan 6, Bidikan lebar dari sudut tinggi dengan kemiringan lembut ke bawah. Kamera naik saat motor salju melaju lebih dalam ke ladang salju, meninggalkan jejak berkelok yang terukir di salju putih nan bersih, dengan hutan bersalju tersebar di kedua sisi. |
Video | |||||
| |||||
Langkah 4: Atur Durasi dan Hasilkan
Samakan durasinya dengan apa yang terjadi di layar. Kling VIDEO 3.0 bekerja dari 3 hingga 15 detik, memberikan ruang yang cukup untuk reaksi cepat, pengambilan gambar yang lebih panjang, atau rangkaian yang dibangun dari beberapa bidikan.
Tetapkan format akhir sebelum melakukan rendering. Pilih 720p, 1080p, atau 4K, dengan framing 16:9, 1:1, atau 9:16. Format 16:9 cocok untuk YouTube, situs web, presentasi, dan kampanye layar lebar; 1:1 sangat cocok untuk unggahan feed dan visual berfokus produk; 9:16 pas untuk TikTok, Reels, Shorts, dan penempatan mobile-first lainnya.
Kling VIDEO 3.0 vs VIDEO 3.0 Omni: Mana yang Harus Anda Gunakan?
Kling VIDEO 3.0 dan Kling VIDEO 3.0 Omni keduanya mendukung Native Audio, Multi-Shot, dan pembuatan hingga 15 detik, meskipun ketersediaan fitur dapat berbeda menurut mode input. Perbedaannya mulai terasa pada cara Anda membangun adegan. VIDEO 3.0 lebih bergantung pada prompt, sedangkan VIDEO 3.0 Omni memberi peran yang lebih besar pada materi referensi dalam prosesnya.
1. Pilih Kling VIDEO 3.0 untuk
- Teks ke video dan gambar ke video
- Generasi bingkai awal dan akhir
- Urutan multi-shot
- Dialog multibahasa dan adegan dengan beberapa karakter
- Video yang dibentuk terutama melalui prompt tertulis
2. Pilih Kling VIDEO 3.0 Omni untuk
- Beberapa referensi gambar dan Elements dalam satu set
- Elements yang dibuat dari video
- Karakter yang kembali atau subjek bermerek
- Suara karakter yang ingin Anda gunakan lagi
- Adegan yang sangat bergantung pada referensi visual dan menjaga subjek tetap mudah dikenali
VIDEO 3.0 adalah pilihan alami ketika sebagian besar adegan dijelaskan dalam prompt. VIDEO 3.0 Omni lebih masuk akal ketika gambar, Elements, referensi video, atau suara tersimpan perlu dibawa ke seluruh video. Untuk melihat lebih dekat kedua model tersebut, baca panduan Kling VIDEO 3.0 vs Kling VIDEO 3.0 Omni.
Cara Mendapatkan Hasil yang Lebih Baik dari Model Generasi Video AI
Cuplikan yang lemah tidak selalu menjadi tanda bahwa model tersebut tidak cocok untuk tugasnya. Sering kali, penyesuaian kecil pada brief, materi sumber, atau arahan pengambilan gambar sudah cukup untuk membuat versi berikutnya lebih mendekati yang Anda inginkan.
Tulis Prompt Layaknya Arahan Pengambilan Gambar
Jelaskan apa yang terjadi di dalam frame alih-alih memenuhi prompt dengan kata-kata suasana.
Alih-alih: Iklan parfum mewah sinematik yang indah.
Cobalah: Close-up sebuah botol parfum kaca di atas permukaan batu gelap. Kamera perlahan bergerak mendekat saat seberkas cahaya sempit melintas di sepanjang botol.
Gunakan Referensi untuk Penampilan dan Gerakan
Teks dapat menggambarkan apa yang seharusnya terjadi, sementara gambar dan Elements membantu menjaga wajah, produk, pakaian, atau lokasi tetap mudah dikenali di berbagai pengambilan gambar.
Ketika performa tertentu penting, Motion Control dapat menerapkan gerakan dan ekspresi wajah dari video yang diunggah atau Motion Library ke satu gambar karakter. Gambar tersebut menentukan penampilan karakter, sementara referensi gerakan membimbing bagaimana karakter tersebut bergerak.
Ubah Satu Hal pada Satu Waktu
Ketika sebuah klip sudah mendekati hasil yang diinginkan, sesuaikan hanya bagian yang perlu dikerjakan. Perlambat kamera jika bergerak terlalu cepat, ubah waktu jika potongan muncul terlalu dini, atau perkuat sumber visual jika penampilan mulai bergeser. Hal ini memudahkan untuk melihat suntingan mana yang meningkatkan versi berikutnya.
Selesai
Model generasi video AI kini semakin sedikit berbeda dalam hal apakah mereka dapat menghasilkan sebuah klip dan semakin banyak dalam cara mereka menangani gerakan, referensi, suara, struktur shot, dan kontinuitas visual. Kling VIDEO 3.0 menyatukan area-area ini dengan referensi gambar, Native Audio, dan alat Multi Shot. VIDEO 3.0 Omni memperluas kemampuan ini dengan Element binding, memberikan karakter dan subjek yang muncul berulang kehadiran yang lebih konsisten di seluruh proyek yang dibangun dari banyak gambar, referensi video, dan suara yang dapat digunakan kembali.
FAQ
Apa model generasi video AI terbaik pada tahun 2026?
Tidak ada satu pun model pembuatan video AI yang cocok untuk setiap jenis video. Pilihan yang tepat bergantung pada materi sumber Anda dan seberapa banyak kontrol yang Anda perlukan terhadap gerakan, suara, kerja kamera, dan subjek berulang. Kling VIDEO 3.0 adalah model pembuatan video AI profesional yang dibuat untuk kreator individu maupun tim produksi profesional, yang menggabungkan Native 4K setingkat sinema dengan Native Audio, penceritaan Multi Shot, dan kontrol kreatif tingkat lanjut. VIDEO 3.0 Omni memperluas alur kerja ini untuk proyek yang lebih kompleks yang melibatkan banyak referensi visual, karakter yang dapat digunakan kembali, serta Elements yang ditautkan ke suara, sekaligus memungkinkan kreator mengedit video hingga sepanjang 10 detik.
Apa yang Harus Anda Cari Saat Membandingkan Model Pembuatan Video AI?
Perhatikan bagaimana setiap opsi bekerja dengan gerakan, referensi, suara, arah pengambilan gambar, durasi, dan kualitas gambar akhir. Hal yang paling penting akan berbeda menurut proyek. Adegan dengan banyak dialog membutuhkan tuturan yang jelas dan karakter berulang yang tetap mudah dikenali, sementara pekerjaan produk sering kali lebih menekankan visual yang akurat, kerja kamera yang terarah, dan detail yang konsisten dari satu bidikan ke bidikan berikutnya.
Apakah Model Pembuatan Video AI Dapat Menghasilkan Suara?
Beberapa memang bisa. Native Audio membuat tuturan, suasana, dan suara lain bersama visual alih-alih menundanya ke langkah pengisian suara atau skoring terpisah. Kling VIDEO 3.0 juga dapat menangani dialog multibahasa dan sinkron bibir tuturan. Ketika sebuah karakter berbicara, menetapkan dialog tersebut langsung kepada orang itu membantu mempertahankan suara tetap selaras dengan momen yang tepat di layar.
Seberapa Panjang Video yang Dihasilkan AI?
Panjang bervariasi menurut model. Beberapa alat dibuat untuk klip yang sangat pendek, sementara lainnya memungkinkan rangkaian yang lebih panjang. Kling VIDEO 3.0 mendukung hingga 15 detik dalam satu generasi, termasuk adegan Multi-Shot. Itu sudah cukup untuk sebuah beat cerita singkat, momen produk, atau konten sosial pendek tanpa memecah ide menjadi beberapa klip terpisah.