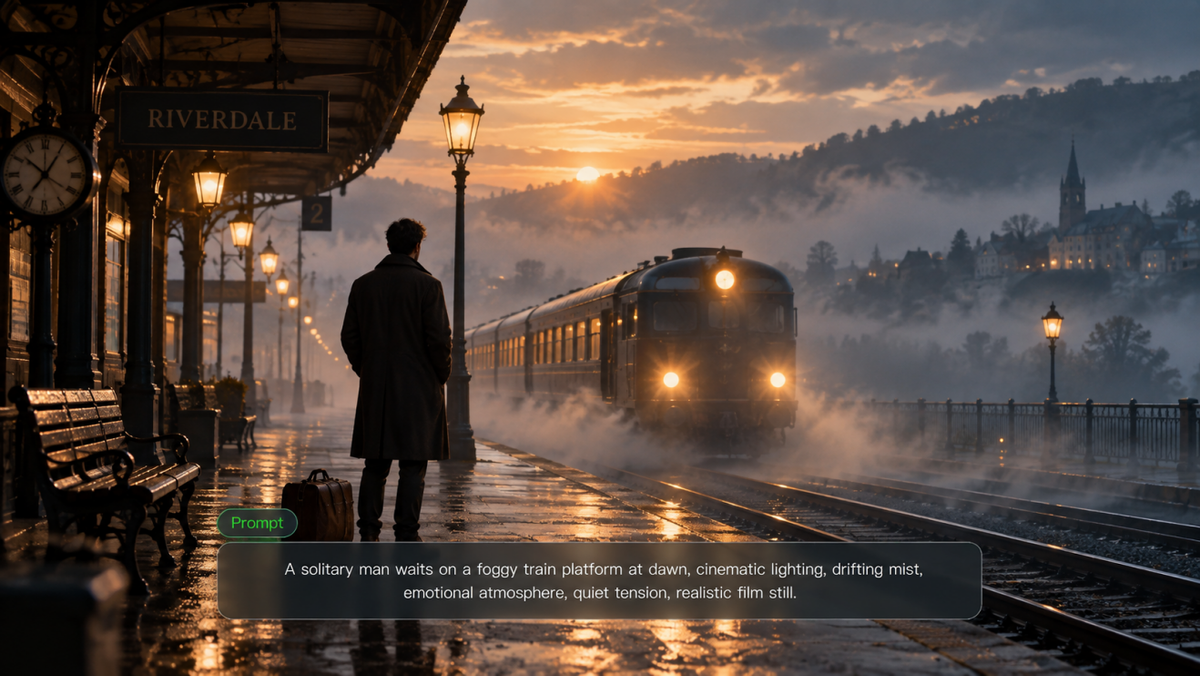
Os modelos de texto para vídeo podem transformar uma cena escrita em vídeo com movimento de câmera, som e múltiplos planos. A questão é que um clipe finalizado ainda pode não corresponder ao prompt, apresentar movimentos desajeitados ou deixar que um personagem ou produto mude de um plano para o outro. Este artigo analisa por que essas diferenças importam, o que verificar antes de escolher um modelo e como o Kling VIDEO 3.0 lida com o controle de planos, movimento, áudio e continuidade visual.
O que são modelos de texto para vídeo?
Modelos de texto para vídeo utilizam IA generativa para transformar descrições em linguagem natural em vídeo. Um prompt pode especificar o assunto, o cenário, a ação, o movimento de câmera e o estilo visual. Se o modelo oferecer suporte a áudio, também pode incluir diálogo, som ambiente e outros sinais sonoros.
Os modelos de texto para vídeo e os geradores de IA de texto para vídeo frequentemente são tratados como a mesma coisa, mas desempenham funções diferentes:
Modelo de texto para vídeo | Gerador de IA de texto para vídeo | |
O que é | O sistema de IA que interpreta o prompt e gera o vídeo | O produto ou interface que as pessoas usam para acessar a geração de texto para vídeo |
O que ele processa | Interpretação do prompt, geração de cenas, movimento e continuidade ao longo do tempo | Recursos construídos em torno do modelo, como controles de tomada, entradas de referência, áudio, duração, proporção de aspecto, edição e exportação |
Por que isso importa | O modelo afeta diretamente a qualidade do vídeo, o movimento e a consistência visual | O gerador influencia quanto controle criativo você tem e o que pode fazer com o vídeo depois |
O modelo determina o que é gerado, enquanto um gerador de vídeo por IA determina como você acessa esses recursos, controla o processo e trabalha com o vídeo finalizado.
Como funcionam os modelos de texto para vídeo?
Os modelos de texto para vídeo transformam um prompt escrito em uma sequência de imagens em movimento. O processo exato varia conforme o modelo, mas geralmente envolve compreender o prompt, construir uma representação compactada da cena, determinar como as coisas mudam ao longo do tempo e manter o resultado consistente de um momento para o outro.
1. Interpretar o prompt
Um modelo de IA de texto para vídeo começa identificando as principais instruções no prompt, incluindo:
- o assunto
- a ação
- o cenário
- o estilo visual
- a direção da câmera
- diálogo ou outros sinais sonoros, quando suportados
| prompt: “Um ciclista percorre uma rua central chuvosa enquanto a câmera o acompanha por trás.” |
Essa breve descrição contém várias instruções que precisam funcionar em conjunto. O ciclista avança, a câmera o acompanha por trás, e a chuva, a rua, a iluminação e o entorno precisam fazer sentido dentro da mesma tomada.
Em outras palavras, o prompt descreve mais do que deve aparecer na tela. Ele também define relações entre o sujeito, o movimento, a câmera e o ambiente.
2. Construa uma Representação de Vídeo Compactada
Após ler o prompt, o sistema precisa de uma representação utilizável da cena antes que ela se torne uma filmagem finalizada. O método exato depende da arquitetura do modelo.
Muitos modelos de texto para vídeo baseados em difusão trabalham em um espaço de representação comprimido em vez de processar quadros em resolução total desde o início. Eles começam com ruído e gradualmente o moldam de acordo com o prompt, trazendo o sujeito, o cenário, a iluminação, a composição e outros detalhes visuais à tona. Trabalhar nesse espaço comprimido reduz a quantidade de dados manipulados durante a geração e, quando a cena toma forma, o resultado é decodificado em quadros de vídeo visíveis.
3. Gerar movimento e interações
O vídeo precisa mostrar o que acontece de um momento para o outro. O modelo precisa lidar com movimento, interação entre objetos e mudanças de ponto de vista sem quebrar a cena.
- Movimento: Um personagem virando, andando ou estendendo o braço deve mudar de pose e posição passo a passo, em vez de saltar de um estado para outro.
- Interação com objetos: As ações precisam de uma ordem clara. Se alguém pega uma xícara, a mão precisa alcançá-la e fazer contato antes que a xícara se mova.
- Câmera e espaço: Panorâmicas, inclinações, avanços e travellings mudam o ponto de vista, mas o sujeito e o entorno ainda precisam permanecer ancorados no mesmo espaço.
Uma imagem estática só precisa descrever um momento. O vídeo precisa considerar o que acontece entre os momentos.
4. Mantenha a Consistência Temporal e Audiovisual
À medida que o vídeo se desenrola, pessoas, objetos e som precisam permanecer coerentes ao longo do tempo. Isso se resume principalmente a dois tipos de consistência:
- Consistência temporal: Personagens, produtos, roupas, adereços, iluminação e cenários não devem mudar sem motivo claro de um momento para o outro. Mesmo após um corte de um close para um plano geral ou uma mudança de ângulo de câmera, a mesma pessoa ou produto ainda deve ser fácil de reconhecer.
- Consistência audiovisual: Diálogo, movimento labial, expressões faciais, som ambiente e ações em cena precisam acontecer no momento certo. Quando um personagem fala, o movimento da boca deve corresponder ao diálogo, enquanto passos ou sons de impacto devem coincidir com a ação à qual pertencem.
Para que você pode usar IA de texto para vídeo?
A IA de texto para vídeo funciona bem em situações em que uma ideia precisa ser vista antes de valer a pena produzi-la em grande escala. Ela pode ajudar em testes criativos iniciais, cenas difíceis de filmar e projetos que precisam de várias direções visuais antes do início da produção.
Crie vídeos para redes sociais
O conteúdo social tem vida útil curta, portanto organizar uma nova filmagem para cada publicação ou conceito de campanha raramente faz sentido. Um prompt pode produzir clipes para teasers, anúncios, publicações de campanha ou vídeos curtos guiados por histórias sem reconstruir a configuração de produção a cada vez. Os criadores também podem experimentar diferentes configurações, movimentos de câmera e direções visuais antes de decidir por uma versão.
Transforme ideias de produtos em vídeos de marketing
Textos e maquetes estáticas nem sempre mostram como um produto ficará quando estiver em movimento por uma cena. A IA de texto para vídeo permite que os profissionais de marketing coloquem o mesmo produto em diferentes ambientes, explorem conceitos de anúncio e testem tratamentos visuais mais cedo no processo. Se o produto aparece em várias cenas, os resultados também revelam quão bem sua forma, cor e detalhes definidores se mantêm de uma tomada para a outra.
Crie cenas narrativas curtas
Uma história curta torna-se mais difícil de planejar quando inclui vários planos, ações de personagens, mudanças de câmera e diálogo. A IA de texto para vídeo pode mapear esses elementos em uma sequência, tornando mais fácil testar a ordem dos planos, o ritmo e o tempo do diálogo antes que cada cena seja construída separadamente. Isso é especialmente útil para peças cinematográficas curtas em que a história depende de mais do que um único plano contínuo.
Visualizar conceitos e storyboards
Um tratamento ou storyboard pode explicar o que deve acontecer, mas o timing e o movimento de câmera são mais difíceis de avaliar em uma página estática. Transformar a ideia em movimento dá a diretores, designers e equipes criativas algo mais próximo da experiência de visualização final. Eles podem comparar enquadramentos, testar transições e detectar momentos fracos enquanto as mudanças ainda são fáceis de fazer.
Criar vídeos educacionais e explicativos
Alguns assuntos são difíceis de capturar em câmera porque são caros, abstratos, inacessíveis ou impossíveis de encenar. A IA de texto para vídeo pode ilustrar um processo, reconstruir um cenário ou mostrar um evento que não pode ser filmado diretamente. Para explicadores, materiais de treinamento e conteúdo de sala de aula, o movimento pode tornar um conceito mais fácil de compreender quando uma imagem estática não mostra o suficiente.
Como escolher o melhor modelo de IA de texto para vídeo para o seu projeto?
Nenhum modelo de IA de texto para vídeo é adequado para todos os projetos. Comece com o que você deseja criar e, em seguida, decida quais recursos são mais importantes para essa tarefa. Os principais aspectos a comparar são a aderência ao prompt, o movimento e a plausibilidade física, a consistência, o controle criativo, o áudio e os limites do resultado e do fluxo de trabalho.
Aderência ao prompt
Primeiro, verifique se o modelo realmente segue o prompt. O sujeito, a ação, o cenário, o estilo visual e a direção de câmera devem aparecer todos juntos em vez de apenas os detalhes mais óbvios. Se você pedir por um ciclista percorrendo a chuva enquanto a câmera o acompanha por trás, o ciclista, o clima, o movimento e o ponto de vista devem estar presentes. O que o modelo deixa de fora pode dizer tanto quanto o quão polido o vídeo parece.
Movimento e plausibilidade física
As ações devem se desenrolar em uma ordem clara. Caminhar, virar, alcançar, colisões e movimento de câmera devem passar de um estado para o próximo sem saltos repentinos. A interação física também é importante: uma mão deve fazer contato antes que um objeto se mova, um pouso deve afetar o corpo, e cabelo, tecido, água ou objetos soltos devem responder ao movimento próximo em vez de se comportarem por conta própria.
Consistência de personagem e produto
O mesmo sujeito deve permanecer reconhecível quando o enquadramento, o ângulo ou a distância mudam. Rostos, vestuário, formato do produto, cor, adereços, iluminação e outros detalhes definidores não devem variar sem motivo. Cenas com vários planos tornam isto mais difícil, pelo que projetos construídos em torno de personagens ou produtos recorrentes também devem ser verificados quanto a imagens de referência, referências do sujeito ou outra forma de transportar a identidade visual de plano para plano.
Controlo Criativo e de Câmara
Quando uma cena já tem uma direção visual clara, o controlo é importante. O enquadramento, o movimento da câmara, a ordem dos planos, as entradas de referência, a proporção e a estrutura de múltiplos planos influenciam o quão de perto o resultado corresponde à ideia original. Um controlo mais fino também significa que é menos provável que tenha de voltar a executar uma sequência inteira só para alterar um ângulo, reorganizar um plano ou corrigir a composição.
Suporte de Áudio
As capacidades de áudio variam bastante entre os modelos. Alguns geram apenas visuais, enquanto outros podem criar diálogo, som ambiente e efeitos junto com as imagens. Para cenas com muito diálogo, verifique se a voz, o movimento da boca, a expressão facial e a sincronização permanecem alinhados. Passos, impactos e sons ambientais também precisam coincidir com a ação à qual pertencem.
Duração, resolução e fluxo de trabalho
Observe os limites que afetam o vídeo final, incluindo comprimento de geração, proporções suportadas, resoluções disponíveis e opções de exportação. Um clipe social curto e uma cena de produto com múltiplas tomadas podem ter requisitos de saída muito diferentes.
O que acontece após a geração é igualmente importante. Você consegue estender o clipe, reutilizar o mesmo sujeito, revisar uma tomada, regenerar o áudio ou continuar editando sem recomeçar do zero? Pequenas mudanças não deveriam obrigá-lo a reconstruir toda a sequência.
Projetos diferentes exigem prioridades diferentes. Comece pelo tipo de vídeo que está a criar e depois concentre-se nas capacidades que mais importam:
Se quiser criar | Dê prioridade | Porque é importante |
Vídeos curtos para redes sociais | Aderência ao prompt, rátios de aspeto, fluxo de trabalho | O conteúdo social se movimenta rapidamente, portanto a saída precisa permanecer próxima da ideia, adequar-se aos formatos comuns das plataformas e ser fácil de revisar. |
Vídeos de produto e marketing | Consistência do produto, aderência ao prompt, resolução | A forma, a cor, o branding e os detalhes essenciais do produto precisam permanecer estáveis entre os planos, enquanto o material final ainda atende às necessidades da campanha ou apresentação. |
Cenas narrativas ou cinematográficas curtas | Movimento e plausibilidade física, controle de câmera, consistência entre múltiplos planos | As ações das personagens, as mudanças de câmara e as transições de cena precisam ligar-se ao longo da sequência sem deriva visual evidente. |
Vídeos orientados pelo diálogo | Suporte de áudio, lip sync, consistência dos personagens | Diálogo, movimento da boca, performance facial e identidade das personagens precisam manter-se alinhados, enquanto o som deve surgir no momento certo. |
Pré-visualizações de conceitos e storyboards | Controlo criativo e de câmara, entradas de referência, flexibilidade para revisões | O objetivo é testar o enquadramento, a direção de câmera, o ritmo e ideias alternativas logo no início, enquanto as mudanças ainda são fáceis de fazer. |
Vídeos educativos e explicativos | Aderência ao prompt, movimento e plausibilidade física, fluxo de trabalho | Os visuais precisam explicar um processo ou ideia com precisão, manter o movimento fácil de acompanhar e permitir revisões quando o conteúdo mudar. |
O que você pode fazer com Kling VIDEO 3.0?
A parte difícil do texto para vídeo não é obter uma tomada bonita. É fazer com que o assunto, a ação, a direção de câmera, o som e os pequenos detalhes visuais do prompt apareçam do jeito que você pretendia. À medida que os prompts se tornam mais detalhados e as cenas adicionam mais tomadas, o modelo tem mais coisas para acompanhar de um momento para o outro.
Kling VIDEO 3.0 é construída em torno dessas demandas, com interpretação de prompts mais robusta, narrativa com múltiplas tomadas, consistência de personagens, áudio nativo, duração flexível e renderização de texto. Em vez de escrever uma descrição e simplesmente esperar para ver o que retorna, você pode moldar como a história se desenrola, quando a câmera muda, como os personagens se mantêm ao longo das tomadas e onde o som entra em cena.
Compreenda e Siga Prompts com Mais Precisão
Kling VIDEO 3.0 pode interpretar prompts em camadas que combinam personagens, ações, cenários, direção de câmera e estrutura narrativa. Isso ajuda prompts complexos de texto para vídeo a permanecerem mais próximos da cena pretendida, especialmente quando envolvem múltiplas ações, movimentos de câmera planejados ou uma sequência específica de eventos.
Mantenha Personagens e Produtos Consistentes entre os Planos
Um personagem pode parecer do jeito certo em uma tomada e ainda assim mudar de forma perceptível em outro ângulo. Em vídeos com múltiplas tomadas, rostos podem se deslocar, detalhes de roupas podem se desalinhar e a cor, a forma ou as características definidoras de um produto podem mudar de uma tomada para a seguinte.
Em fluxos de trabalho VIDEO 3.0 assistidos por referência compatíveis, você pode usar várias imagens de referência para fornecer orientação visual adicional e ajudar a ancorar um personagem recorrente, um produto ou outro assunto principal ao longo das mudanças de enquadramento, ângulo e cenário. Essas referências oferecem ao modelo mais informações sobre a aparência do assunto e detalhes visuais essenciais, ajudando a reduzir a deriva visual evidente em cenas com personagens recorrentes, tomadas de produto e conteúdos de marca.
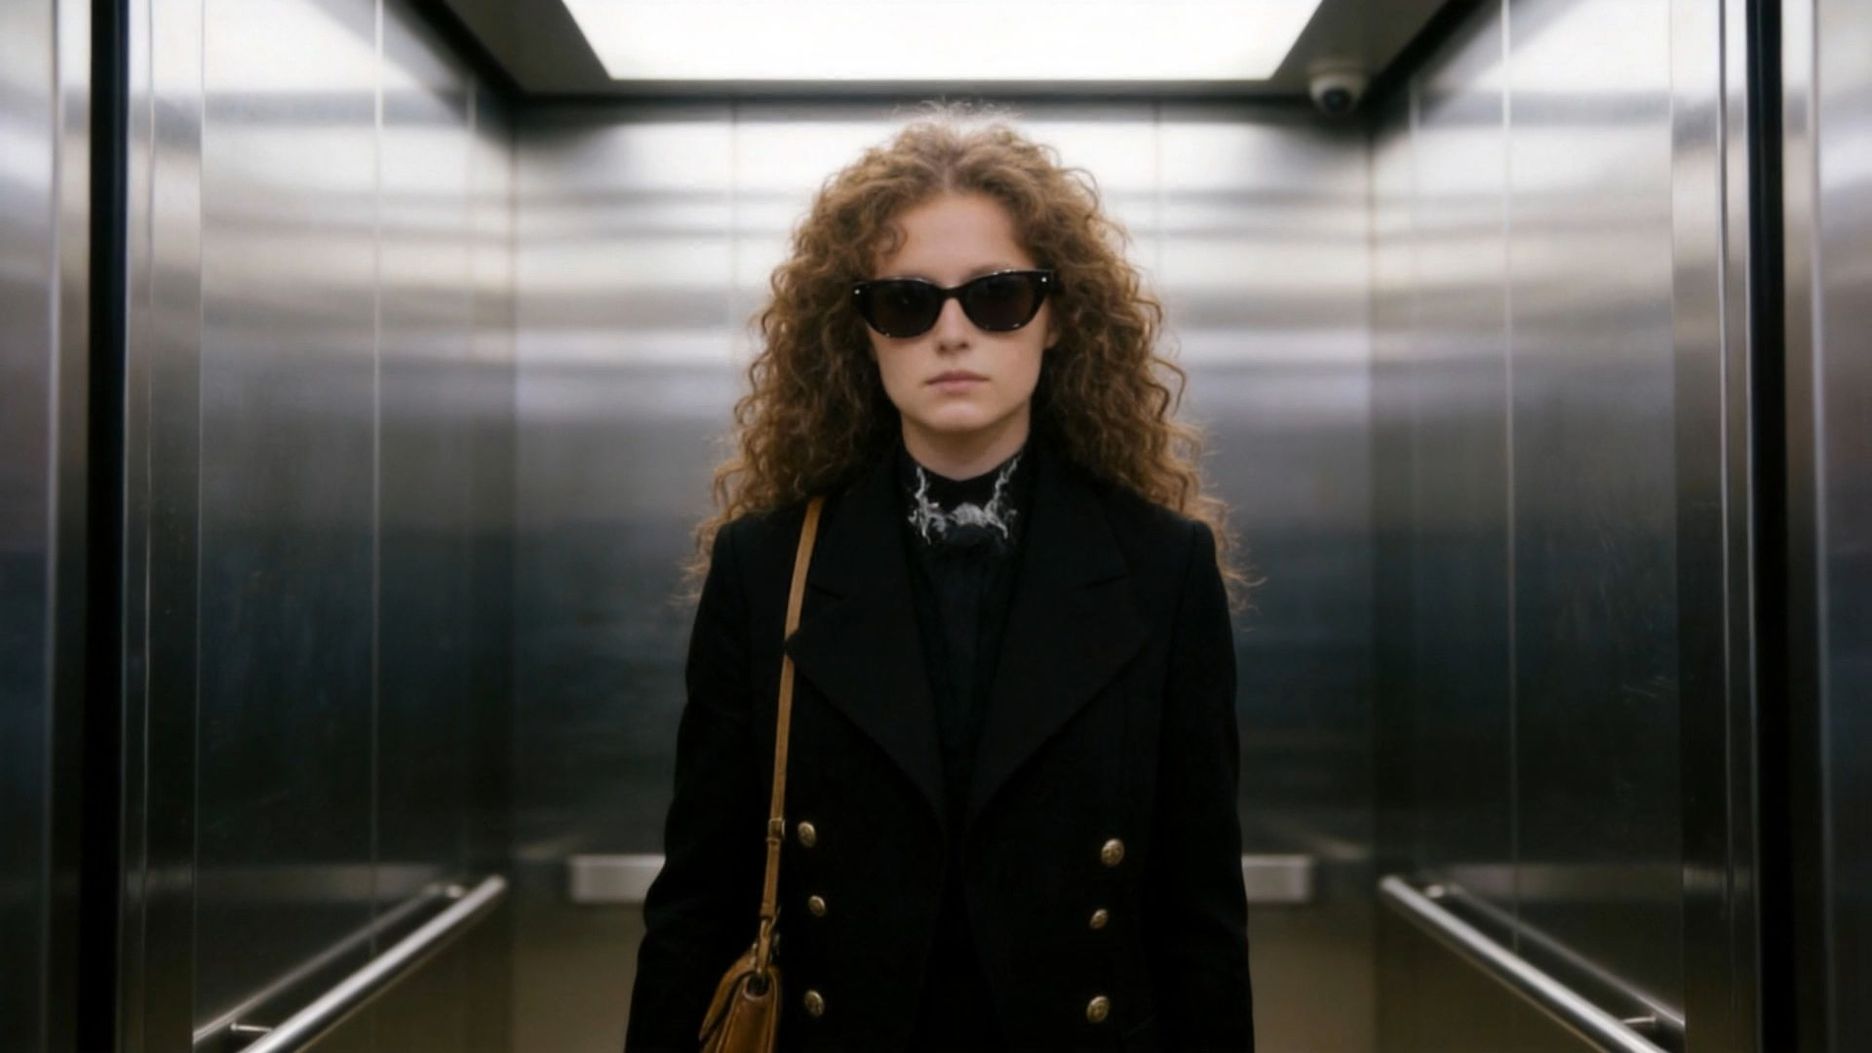

Crie histórias com múltiplas tomadas com mais controle sobre o ritmo
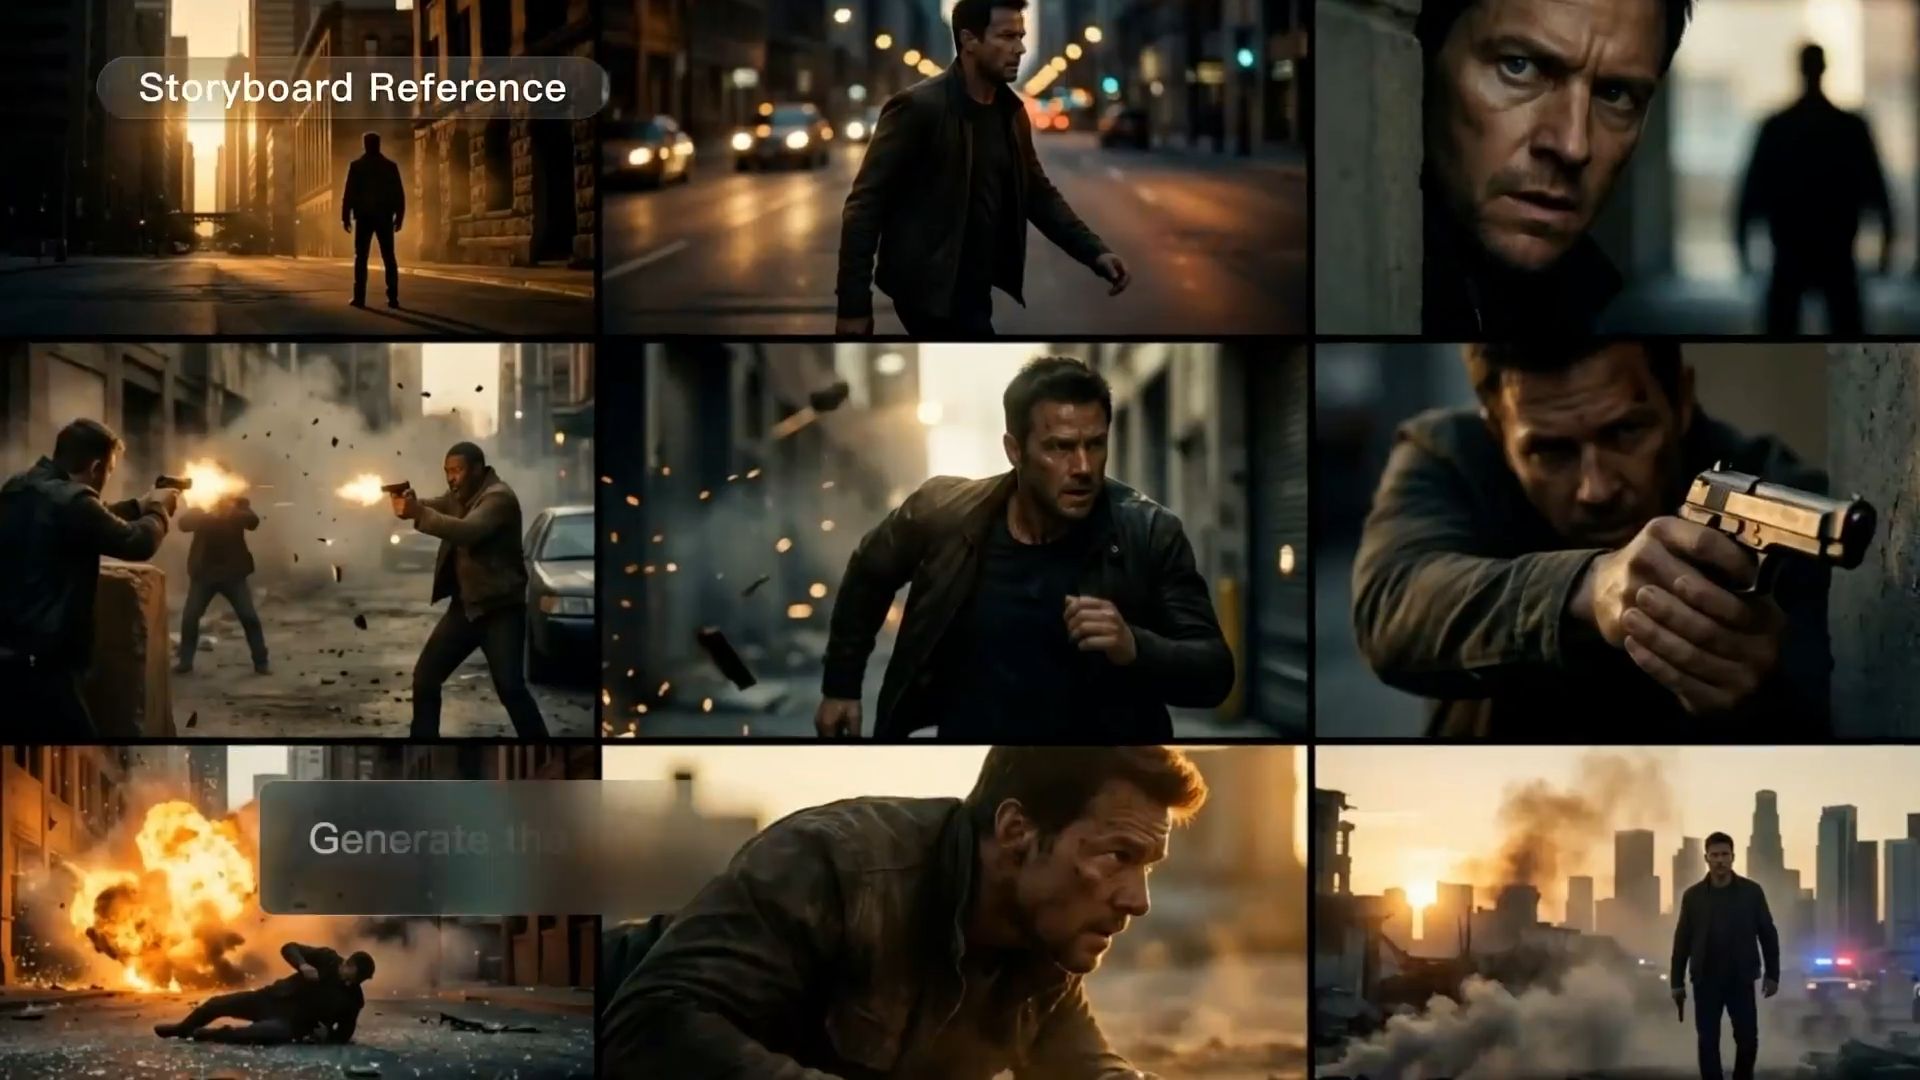
Um único plano geralmente é administrável. O desafio começa quando uma história precisa de close-ups, planos abertos, diferentes posições de câmera e mudanças de cena. Gerar cada plano separadamente significa mais montagem depois, e fica mais difícil manter o ritmo e a continuidade intactos ao longo da sequência.
O Multi-Shot do Kling VIDEO 3.0 pode lidar com vários planos em uma única geração, transformando um único prompt em uma sequência conectada em vez de um conjunto de clipes isolados. Para uma sequência planejada, o Custom Multi-Shot permite definir o conteúdo, a ordem e a duração de tomadas individuais, de modo que os cortes e o ritmo estejam definidos antes que a geração comece.
Gere diálogo e som da cena juntos
Quando um modelo de vídeo produz apenas imagens, as cenas de diálogo dão trabalho extra. Vozes, som ambiente, efeitos e sincronização precisam ser tratados posteriormente. Ao acrescentar vários personagens, também é necessário acompanhar quem diz cada fala e se o som coincide com a ação correta em cena.
O Áudio Nativo do Kling VIDEO 3.0 gera diálogos, som ambiente e outros áudios junto com o vídeo. Em cenas com vários personagens, você pode atribuir falas a diferentes locutores, com suporte para chinês, inglês, japonês, coreano e espanhol, além dos dialetos e sotaques compatíveis. A fala, a atuação dos personagens e o som da cena são incorporados à mesma geração em vez de serem sobrepostos a um clipe silencioso posteriormente.
Crie histórias mais longas com até 15 segundos e saída 4K
Kling VIDEO 3.0 oferece aos criadores mais espaço para desenvolver cada cena, com geração flexível de 3 a 15 segundos para interações entre personagens, narrativa multi-shot, diálogos e transições. Nos fluxos de trabalho compatíveis, a saída de até 4K preserva detalhes mais finos, texturas e a clareza visual geral, ajudando os criadores a avançar de conceitos iniciais para conteúdo polido para publicidade, demonstrações de produtos, narrativa cinematográfica e muito mais.
Fim
Os modelos de texto para vídeo que valem seu tempo fazem mais do que animar um prompt: eles seguem sua intenção, movem-se de forma natural, trazem som e mantêm um sujeito estável entre as tomadas. Medido por esses critérios, o Kling VIDEO 3.0 reúne geração orientada por prompt, controle Multi-Shot, consistência de sujeito e áudio nativo em um só lugar. Abra o Kling, escreva a sua cena e veja-a ganhar vida em uma única geração.
Perguntas frequentes
Como escolher entre os melhores modelos de IA de texto para vídeo em 2026?
Comece com o tipo de vídeo que você deseja fazer e, em seguida, compare os modelos com base nessa tarefa. A narrativa Multi-Shot dá mais peso ao controle de câmera e à consistência dos personagens. Cenas com muito diálogo exigem áudio potente, sincronia labial e boa atuação dos personagens, enquanto trabalhos de produto e anúncios dependem mais da aderência ao prompt, da estabilidade do assunto e da qualidade do resultado. Comprimento e resolução também importam, já que um teste rápido e uma peça finalizada raramente têm os mesmos requisitos. Kling VIDEO 3.0 combina Multi-Shot, áudio nativo, aderência ao prompt e geração de até 15 segundos para histórias multi-shot, cenas conduzidas por diálogos e projetos em que o mesmo personagem ou produto precisa permanecer reconhecível entre as tomadas.
A conversão de texto em vídeo por IA pode incluir som?
Sim. Kling VIDEO 3.0 pode gerar diálogo, som ambiente e efeitos junto com o vídeo, para que você não precise adicionar o áudio depois. Você pode escrever as falas diretamente no prompt, atribuí-las a personagens específicos e escolher o idioma, dialeto ou sotaque. Sua capacidade de texto para fala pode transformar essas falas em vozes de personagens em chinês, inglês, japonês, coreano e espanhol. Isso significa menos trabalho separado de narração e menos montagem de áudio depois que o vídeo é gerado.
Qual pode ser a duração de um vídeo gerado?
A duração do vídeo varia conforme o modelo. Kling VIDEO 3.0 oferece geração flexível de 3 a 15 segundos. Clipes mais curtos funcionam bem para ações rápidas e conteúdo social, enquanto clipes mais longos deixam mais tempo para preparação, diálogo e narrativa com múltiplos planos. Para vídeos finalizados que precisam de detalhes visuais mais refinados, os modos compatíveis também oferecem saída em até 4K, dando mais clareza às texturas de produtos, aos detalhes dos personagens e à profundidade da cena.
Eu preciso de habilidades de edição de vídeo?
Se quiser fazer alterações após a geração, o fluxo de trabalho de edição VIDEO 3.0 Omni da Kling permite modificar o material existente com instruções em linguagem natural, incluindo alterar fundos, sujeitos, estilo ou enquadramento.