Вибір найкращого AI-інструмента для відео із синхронізацією губ — це більше, ніж просто узгодження рухів рота з аудіо. Він має допомагати зберігати стабільність облич, міміки й деталей відео протягом усього ролика. У цьому путівнику ми порівнюємо провідні AI-інструменти для синхронізації губ у 2026 році та розглядаємо два робочі процеси Kling AI: використання інструмента Lip Sync для додавання синхронізованої мови або співу до наявного відео з персонажем і застосування Native Audio у серії VIDEO 3.0 для створення нових сцен діалогу із синхронізованою мовою, мімічною грою та звуком із самого початку.
Що робить AI-інструмент синхронізації губ хорошим?
Вибір найкращого AI-інструмента для відео із синхронізацією губ передбачає більше, ніж перевірку того, чи збігаються рухи рота з аудіо. До ключових факторів порівняння належать точність синхронізації, сталість відтворення облич, обробка рухів, гнучкість вхідних даних, мовна підтримка та ефективність у сценаріях з кількома спікерами.
Фактор порівняння | На що звернути увагу | Чому це важливо |
Аудіовізуальна синхронізація | Рухи рота, що відповідають звукам мовлення, паузам і ритму речень | Незначні проблеми з таймінгом можуть створити враження, що діалог відірваний від відео |
Стабільність обличчя та обробка рухів | Стабільні риси обличчя, міміка, рухи голови, ракурси камери та візуальні деталі | Спікер має залишатися впізнаваним протягом усього відео |
Гнучкість введення | Підтримка наявних відео, персонажів, аватарів і сцен, згенерованих ШІ | Різні творці починають із різних матеріалів та виробничих потреб |
Багатомовна та голосова підтримка | Підтримка різних мов, голосів і стилів мовлення | Важливо для перекладу, локалізації та глобальної аудиторії |
Обробка сцен із кількома мовцями | Точне зіставлення мовців і синхронізація діалогів у розмовах | Допомагає зберігати голос кожної людини узгодженим із відповідним мовцем |
6 найкращих відеоінструментів ШІ для синхронізації губ у 2026 році
Інструменти синхронізації губ на основі ШІ працюють по-різному. Деякі створені для додавання нового мовлення до наявних відео, тоді як інші поєднують синхронізацію губ із перекладом, аватарами або згенерованими ШІ сценами. Найкращий варіант залежить від вихідних матеріалів і типу відео, яке ви хочете створити.
У таблиці нижче порівнюються шість інструментів ШІ для синхронізації губ за параметрами синхронізації відео, перекладу, створення відео ШІ та сцен із кількома мовцями.
Інструмент | Основне використання | Як використовується синхронізація губ | Багатомовність і локалізація | Діалоги та кілька мовців |
Kling AI | Синхронізація губ для наявних відео з персонажами та генерація нативних діалогів для нових ШІ-відео | Використовуйте спеціалізований інструмент Lip Sync, щоб узгодити завантажене або синтезоване мовлення Text-to-Speech з наявним підтримуваним відео персонажа, або скористайтеся Native Audio у VIDEO 3.0 / VIDEO 3.0 Omni, щоб згенерувати діалог і синхронізовану візуальну подачу в новому відео. | Серія VIDEO 3.0 підтримує нативну генерацію діалогів китайською, англійською, японською, корейською та іспанською мовами, включно зі змішаними мовами, діалектами та акцентами. | Серія VIDEO 3.0 підтримує багатоперсонажні діалоги з репліками, прив'язаними до конкретних дикторів, і синхронізованою мімікою. |
Vozo AI | Дубляж і локалізація для наявних відео | Нове або перекладене мовлення зіставляється з мовцем в оригінальних кадрах | Побудовано навколо перекладу відео та локалізованого голосового контенту | Підтримує локалізацію з кількома мовцями |
HeyGen | Аватарні відео та перекладений відеоконтент | Мовлення синхронізується з аватарами або мовцями після зміни голосу чи перекладу | Сильний акцент на багатомовному перекладі відео | Підтримує контент з аватарами та кількома спікерами |
Sync Labs | Ліп-синк для виробництва та інтеграцій | Аудіо можна синхронізувати з наявним відео за допомогою спеціальних інструментів ліп-синку | Підтримка мов залежить від налаштувань виробничого середовища | Можна використовувати для синхронізації діалогів |
PixVerse | Створення коротких відео за допомогою ШІ | До згенерованого контенту з персонажами можна додати синхронізацію губ | Варіанти мов залежать від функції | Підтримує розмовні сцени з персонажами |
CapCut | Редагування соціальних відео та контент творців | Синхронізацію губ можна виконувати за допомогою редагування та функцій із підтримкою ШІ | Параметри перекладу залежать від інструмента та регіону | Залежить від використовуваних можливостей редагування |
Який підхід до синхронізації губ підходить для вашого відео?
Синхронізація губ служить різним цілям залежно від відео, яке ви створюєте. Існуючі кадри, перекладений контент та новостворені сцени потребують різних підходів.
Ваша відправна точка | Що ви хочете створити | Рекомендований метод | Інструменти, які варто розглянути |
У вас уже є відео з персонажем | Замініть мовлення, додайте новий діалог або синхронізуйте нове аудіо | Синхронізація губ у наявному відео | Kling AI, Vozo AI, Sync Labs |
У вас є відео іншою мовою | Створіть локалізовані версії для різних аудиторій | Переклад + генерація голосу + синхронізація губ | HeyGen, Vozo AI, Kling AI* |
У вас є зображення персонажа або аватар | Змусьте персонажа говорити з синхронізованими виразами | Генерація персонажа, що говорить, або аватара | Аватар Kling AI, HeyGen |
Ви хочете створити нову сцену з нуля | Створюйте персонажів, діалоги та візуальні елементи разом | Генерація відео ШІ з нативним аудіо | Kling AI |
Ви створюєте діалог або сюжетну сцену | Підтримуйте природність діалогу між кількома персонажами | Генерація діалогу між кількома персонажами | Kling AI |
*Kling Lip Sync може синхронізувати підготовлений аудіозапис цільовою мовою або доступні перетворення тексту в мовлення голоси з підтримуваним відео персонажа.
Два способи створити відео ШІ із синхронізованими губами за допомогою Kling AI
Варіант 1: Додайте синхронізацію губ до наявного відео персонажа
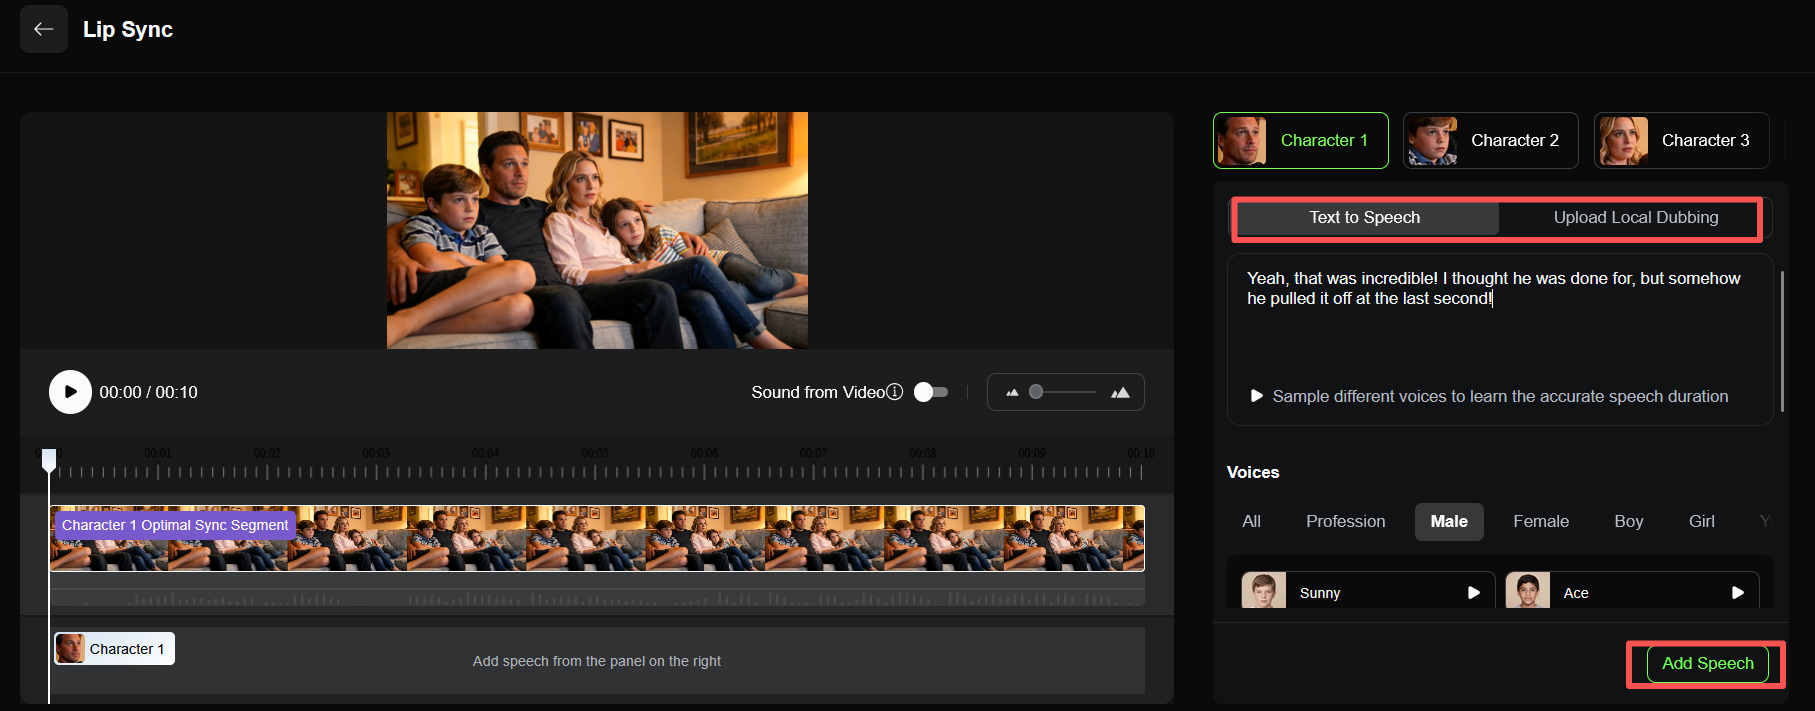
Якщо у вас уже є підтримуване відео Kling персонажа ШІ, скористайтеся інструментом Kling AI Lip Sync, щоб додати нову мову або спів без необхідності відтворювати сцену з нуля. Ви можете завантажити власне аудіо або скористатися функцією перетворення тексту в мовлення, а потім синхронізувати рухи рота персонажа з новим голосом.
Крок 1: Виберіть чітке відео персонажа
Виберіть підтримуваний кліп Kling AI з повністю чітко видимим обличчям. Чіткий огляд рота полегшує оцінку того, чи залишається нове мовлення синхронізованим протягом усього кліпу. Kling AI Lip Sync підтримує реалістичних, 3D та 2D людських персонажів. Якщо персонаж відвертається від камери або рот частково закритий, переконайтеся, що основні фрагменти мовлення все ще показують достатньо обличчя, щоб синхронізація працювала коректно.
Крок 2: Додайте аудіо або введіть сценарій
Завантажте озвучення або вокальну доріжку чи скористайтеся Text to Speech, щоб згенерувати голос зі сценарію. Якщо аудіо довше за відео, обріжте його перед генерацією. Ви також можете налаштувати швидкість Text to Speech, коли рядок має відповідати коротшому кліпу. Тримайте сценарій максимально близьким до доступного часу відео, щоб подача не здавалася поспішною або не залишала тривалих пауз.
Крок 3: Згенеруйте та перегляньте синхронізацію губ
Створіть версію з синхронізованими губами й перегляньте весь кліп, включно зі швидшими фразами, паузами та закінченнями речень. Якщо якась частина мовлення здається завчасною або запізнілою, спершу перевірте тривалість і темп аудіо. Ви можете прибрати зайві паузи з завантаженої доріжки або відрегулювати швидкість перетворення тексту на мовлення перед повторною генерацією. Спостерігайте за всім обличчям персонажа, а також за ротом, особливо коли в оригінальному відео є більш виразні емоції чи рухи голови.

Варіант 2: згенеруйте діалог із синхронізацією губ за допомогою серії VIDEO 3.0
Якщо ви хочете створити нову діалогову сцену, а не додавати мовлення до наявного відео, Kling VIDEO 3.0 і VIDEO 3.0 Omni можуть разом згенерувати діалог, рухи губ, міміку, візуальний ряд, атмосферу та звукові ефекти через Native Audio. Якщо сцена відразу містить кількох персонажів, що говорять, ви можете скористатися Text to Video AI і вказати:
- хто говорить
- що говорить кожен персонаж
- порядок, у якому вони говорять
- мова або акцент
- що робить кожен персонаж під час розмови
| Prompt: Чоловік і жінка сидять одне навпроти одного в тихому сучасному кафе вночі. Чоловік говорить першим англійською з м'яким американським акцентом, трохи нахиляється вперед і каже: «Я не думав, що ти прийдеш». Жінка дивиться на нього, на мить зупиняється, потім відповідає англійською з британським акцентом: «Я ледь не передумала». Вона ледь усміхається і повільно ставить чашку з кавою. Чоловік виглядає здивованим і починає відповідати, але вона повертається до вікна, перш ніж він знову заговорить. Зберігайте чіткий ритм діалогу з природним рухом губ, тонкими мімічними виразами та реалістичними паузами між кожним мовцем. |
VIDEO 3.0 підтримує багатоперсонажні діалоги китайською, англійською, японською, корейською та іспанською мовами, а також змішаномовні діалоги, діалекти й акценти. Кілька персонажів можуть ділити одну сцену без потреби створювати для кожного мовця окремий кліп і зшивати фрагменти пізніше.
With Native Audio, dialogue, ambience, and sound effects can be generated with the visuals. You can describe spoken lines, room tone, footsteps, or other sounds in the prompt so they become part of the scene instead of being added one layer at a time after the visuals are finished. For short story scenes, conversations, and product videos with spoken lines, this cuts down on separate audio work after generation.
Якщо ви хочете, щоб камера рухалася разом із розмовою, використовуйте Multi-Shot у Kling генераторі відео ШІ. Сцена може переходити від двопланового кадру до крупного плану людини, яка говорить, а потім переходити до реакції іншого персонажа. Multi-Shot може налаштовувати зміни кадрів, композицію й ракурси камери на основі підказки. Якщо у вас уже запланована послідовність, Custom Multi-Shot дає змогу самостійно визначати вміст і тривалість кожного кадру. VIDEO 3.0 підтримує генерації тривалістю від 3 до 15 секунд, тож коротка послідовність може містити діалог, реакції, рух персонажів і кілька змін камери.
VIDEO 3.0 Omni розширює цей робочий процес для створення, що більше спирається на референси, поєднуючи Native Audio зі стабільністю персонажів на основі елементів та ширшими мультимодальними входами.
Разом ці елементи керування дозволяють створити діалогову сцену, у якій мовлення, синхронізація губ, реакції персонажів, звук і зміни камери вже працюють в одній послідовності, а не збираються по частинах згодом.
Зображення |
| Підказка: Сонячне світло наповнює старі вулиці Мадрида. Перед придорожньою пекарнею китайська туристка та турист-чоловік у сірій худі йдуть до продавця, обидва з чемними усмішками. Жіноча туристка (говорить трохи повільно, з незграбним акцентом, іспанською): Disculpe, ¿dónde está la plaza mayor? Іспанський продавець із білим волоссям (трохи повертається та вказує вперед, легким і життєрадісним тоном, іспанською): Por allí, a dos calles. Muy cerca. Туристка киває, щоб висловити подяку. Турист-чоловік також киває на знак згоди й каже (іспанською): Muchas gracias. Продавець усміхається та киває у відповідь. Потім двоє туристів розвертаються й прямують у вказаному напрямку. |
Результати |
Які найпоширеніші проблеми з синхронізацією руху губ і як їх усунути?
Під час генерації синхронізації губ. може виникнути кілька поширених невідповідностей. Вони часто спричинені вихідним відео, таймінгом аудіо, довжиною сценарію або напрямком спікера. Ось як визначити причину й скоригувати її.
Виправлення залежить від робочого процесу, який ви використовуєте. З інструментом Lip Sync проблеми зазвичай пов’язано з відео джерельного персонажа, таймінгом аудіо або довжиною сценарію. У Native Audio у VIDEO 3.0 чи VIDEO 3.0 Omni сцени з кількома персонажами також можуть залежати від того, наскільки чітко в підказці розподілено кожного спікера та його репліку.
Проблема | Можлива причина | Що спробувати |
Рот рухається надто рано або надто пізно | Новий аудіозапис не відповідає часуванню оригінального кліпу, або подача занадто швидка чи занадто повільна | Обріжте довгі паузи, скоротіть репліку або відрегулюйте швидкість голосу перед повторною генерацією |
Обличчя змінюється, поки персонаж говорить | У вихідному відео обмежена деталізація обличчя, різкі повороти голови, розмиття руху або частини обличчя закриті | Використовуйте кадри, де обличчя й рот залишаються видимими протягом основних озвучених частин |
Рух щелепи або рота виглядає перебільшеним | Репліка містить швидку або сильну артикуляцію, яка не відповідає видимому руху у вихідному відеоматеріалі | Спробуйте коротшу репліку, повільнішу подачу або кадри з чіткішим фронтальним чи тричвертним ракурсом |
Синхронізація починається добре, але пізніше відхиляється | Довге речення, нерівномірний темп або зайві паузи поступово відсувають аудіо від таймінгу відео | Перегляньте весь кліп, потім скоротіть речення або приберіть паузи поблизу точки, де починається відхилення |
Здається, говорить не той персонаж | Підказка недостатньо чітко визначає порядок мовців або розподіл реплік | Вкажіть, хто промовляє кожну репліку, збережіть чіткий порядок мовлення та ясно відокремлюйте діалоги кожного персонажа |
Перекладений діалог звучить поспіхом | Перекладене речення вимовляється довше, ніж оригінальна репліка | Перепишіть переклад із урахуванням тривалості мовлення, а не дослівної відповідності джерелу, а потім за потреби відкоригуйте швидкість голосу |
Для синхронізації руху губ спершу перевірте вихідний кліп, часові позначки аудіо та довжину сценарію. Для сцен з власним аудіо також переконайтеся, що кожен мовець, кожна репліка та порядок мовлення чітко визначені, перш ніж додавати більше деталей до решти підказки.
Кінець
Найкращий відео-ШІ для синхронізації руху губ має робити мовлення невіддільною частиною виступу, зберігаючи точність рухів рота, коли персонаж рухається або промовляє довші репліки, водночас підтримуючи риси обличчя та природну експресію. Для наявного підтримуваного відео з персонажем Kling AI рішення Kling AI Lip Sync дозволяє додавати нову промову чи спів без необхідності відтворювати сцену з нуля. Якщо ви створюєте діалогову сцену з нуля, Kling VIDEO 3.0 може генерувати діалоги, рухи губ, міміку, звук і зміни планів одночасно завдяки Native Audio, багатоперсонажним діалогам та Multi-Shot. Це скорочує окрему роботу з підбору голосу, руху рота й змін камери на етапі постпродакшену, допомагаючи фінальній сцені залишатися більш цілісною завдяки стійкішій синхронізації губ і послідовнішій грі персонажів.
Поширені запитання
Який ШІ має найкращу синхронізацію губ?
Найкращий штучний інтелект для синхронізації губ залежить від того, що ви створюєте. Для наявного підтримуваного відео з персонажем Kling AI, Kling AI Lip Sync призначений для додавання нових реплік або співу; для перекладених відео інструменти, такі як HeyGen і Vozo AI, більше зосереджені на дубляжі та локалізації; а для аватарних відео у форматі ведучого HeyGen побудований навколо робочих процесів, що керуються аватаром. Якщо ви створюєте нову діалогову сцену з нуля, Kling VIDEO 3.0 може згенерувати мовлення, рух губ, міміку та звук одночасно в одній сцені. Обирайте інструмент залежно від вихідного матеріалу та від того, чи потрібна вам проста заміна мовлення, переклад, презентація з аватаром або повністю згенерована діалогова сцена.
Чи може програмне забезпечення для синхронізації губ на ШІ працювати з кількома мовами?
Так, але підтримка мов залежить від функції. Kling Lip Sync може синхронізувати завантажену мову або спів, тоді як Text to Speech використовує голоси, доступні в інструменті. Для новостворених сцен VIDEO 3.0 підтримує діалоги китайською, англійською, японською, корейською та іспанською мовами, включно зі змішаномовними розмовами. Варіанти мов можуть відрізнятися залежно від версії моделі, тож перевірте налаштування, показані у версії, якою ви користуєтеся.
Чи можу я використовувати власне аудіо в Kling Lip Sync?
Так. Kling Lip Sync дозволяє завантажувати власний закадровий голос або аудіо зі співом. Якщо аудіо довше за відео, ви можете обрізати його перед генерацією. Використовуйте чіткий запис і вихідний матеріал, де обличчя залишається видимим під час основних фрагментів мовлення. Після генерації перевірте швидші репліки, паузи, довші голосні звуки та моменти з активнішими рухами голови, щоб переконатися, що рот і далі синхронізується з аудіо.
У чому різниця між Kling Lip Sync і VIDEO 3.0 Native Audio?
Kling Lip Sync додає нове мовлення або спів до наявного підтримуваного відео персонажа, тоді як VIDEO 3.0 Native Audio створює відео та звук разом із самого початку. За допомогою VIDEO 3.0 діалоги, рух губ, звук і Multi-Shot можуть бути вбудовані в нову сцену. Використовуйте Kling Lip Sync, коли у вас уже є підтримуване відео персонажа Kling AI, яке ви хочете зберегти; використовуйте VIDEO 3.0 або VIDEO 3.0 Omni, коли сцену з діалогом ще потрібно створити.