أصبح للذكاء الاصطناعي التوليدي دور راسخ في إنتاج الفيديو، إذ تُستخدم نماذج توليد الفيديو بالذكاء الاصطناعي عبر محتوى الشبكات الاجتماعية والإعلانات وإطلاق المنتجات وسرد القصص القصيرة. ومع دخول نماذج الفيديو التوليدية إلى الإنتاج الاحترافي، يقارن المبدعون كيفية استجابة نماذج الذكاء الاصطناعي المختلفة لتوليد الفيديو للأوامر، وأصول المراجع، والصوت، وتوجيه اللقطات. يقارن هذا الدليل 10 نماذج فيديو بالذكاء الاصطناعي عبر هذه الأبعاد الإنتاجية، ثم يسلط الضوء على كيفية عمل سلسلة Kling VIDEO 3.0 مع الأوامر، وأصول المراجع، وتوجيه اللقطات المتعددة، والصوت ضمن سير العمل نفسه.
ما هي نماذج توليد الفيديو بالذكاء الاصطناعي؟
نماذج توليد الفيديو بالذكاء الاصطناعي هي أنظمة تنشئ الفيديو أو تعدله أو تحركه انطلاقًا من النص أو الصور أو المواد المرجعية أو اللقطات القائمة. تعمل عبر الزمن بدلاً من معالجة كل إطار بمعزل، حيث تأخذ في الحسبان تغيّرات حركة الموضوع، والإضاءة، وموضع الكاميرا، وبنية المشهد.
تُعَدُّ نقطة الإدخال الأولية مهمة لأن النماذج المختلفة مبنية على طرق عمل مختلفة.
النوع | نقطة البداية | ما الذي يفعله | الأفضل لـ |
موجه مكتوب | ينشئ مشهدا من وصف للموضوع أو الإعداد أو الحركة أو التكوين أو حركة الكاميرا | يبدأ من فكرة دون وجود مرئي مسبق | |
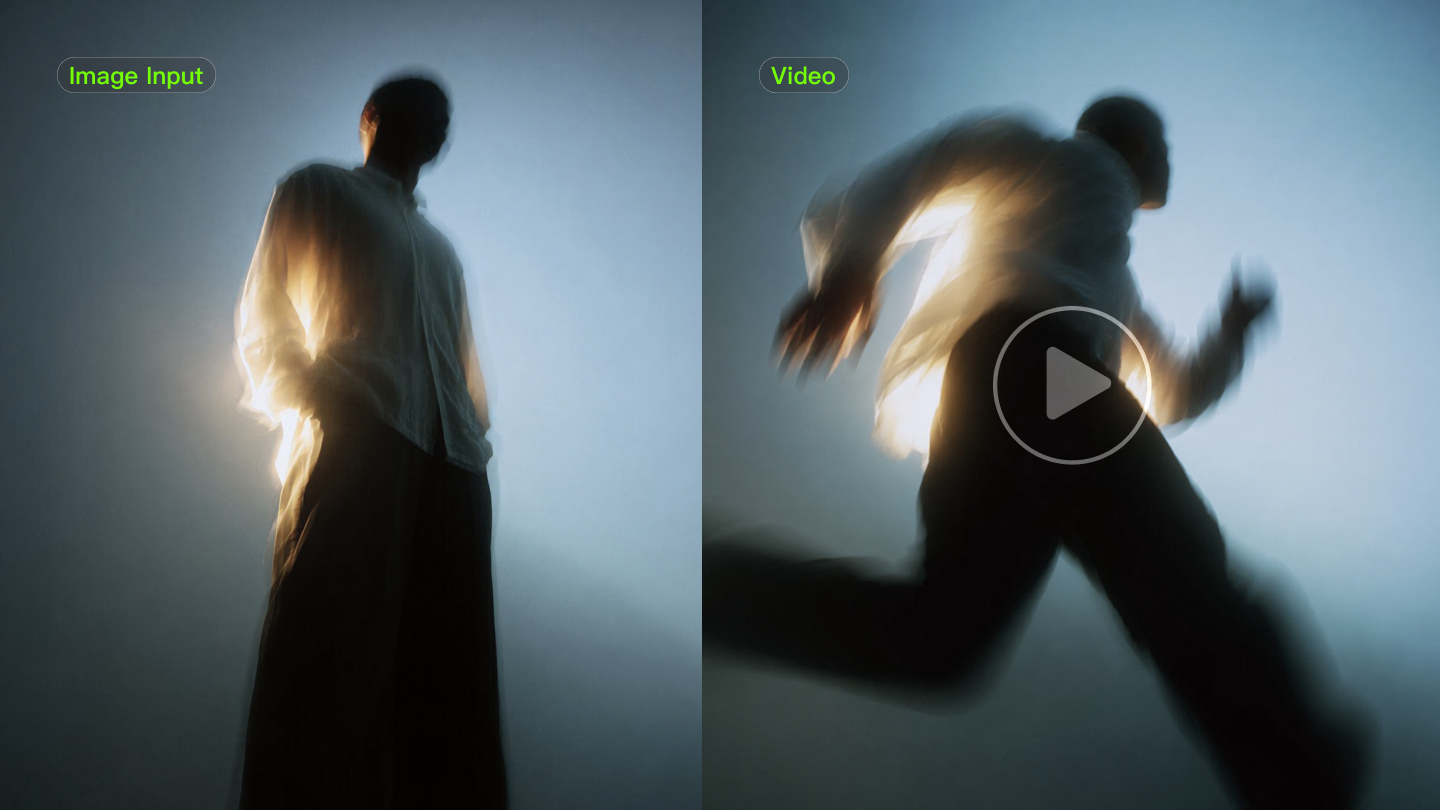
صورة ثابتة | يضيف حركة إلى الموضوع أو البيئة أو الكاميرا مع الحفاظ على الصورة كقاعدة بصرية | تحريك شخص أو منتج أو عمل فني أو مشهد بمظهر راسخ | |
فيديو متعدد الوسائط قائم على المراجع | النصوص، الصور، الفيديو، أو مراجع متعددة | يستخدم عدة مدخلات لتوجيه المظهر أو الحركة أو الشخصيات أو المنتجات أو بنية اللقطة | المشروعات التي تحتاج إلى مزيد من الاستمرارية أو توجيه أكثر إحكامًا عبر لقطة أو تسلسل |
ما الذي يجعل نماذج توليد الفيديو بالذكاء الاصطناعي مختلفة؟
للوهلة الأولى، يمكن للعديد من نماذج الفيديو المعتمدة على الذكاء الاصطناعي التعامل مع مهام أساسية متشابهة. يصبح من الأسهل بكثير ملاحظة الاختلافات عندما تنظر إلى كيفية اتباعها للتعليمات، والحفاظ على ثبات المشهد، وإدارة اللقطات، والتعامل مع الصوت.
الالتزام بالموجه: مدى دقة اتباع النموذج للتعليمات المتعلقة بتموضع الموضوع، والحركة، والتكوين، والإيقاع، وحركة الكاميرا.
الحركة والاتساق: ما إذا كانت الحركة تبدو طبيعية وما إذا كان الأشخاص أو المنتجات أو الملابس أو البيئات تظل قابلة للتعرّف عليها طوال الفيديو.
الصوت الأصلي: يمكن لبعض النماذج توليد الحوارات والصوت المحيطي والمؤثرات مع الفيديو، بينما يحتاج بعضها الآخر إلى خطوة صوتية منفصلة.
اللقطات المتعددة والتحكم في الكاميرا: تركز بعض النماذج على لقطة قصيرة واحدة، بينما يمكن لأخرى التعامل مع تبديل اللقطات، وزوايا الكاميرا، وحركات الكاميرا، وتسلسلات متعددة اللقطات.
الدقة والمدة: تختلف النماذج في المدة الزمنية التي يمكنها التوليد لها وفي دقة الإخراج التي تدعمها، مما يؤثر في أنواع المشاريع التي تناسبها بشكل أفضل.
ما أفضل نماذج توليد الفيديو بالذكاء الاصطناعي في عام 2026؟
لا يوجد نموذج واحد يعمل على النحو الأمثل لكل مشروع فيديو. فيما يلي نقارن بين 10 نماذج حالية لتوليد الفيديو بالذكاء الاصطناعي من حيث الحركة، والمراجع، والصوت، وتوجيه اللقطة، والمدة، وجودة الإخراج.
النموذج | مفيد لـ | المدخلات | اتساق المراجع | الصوت الأصلي | متعدد اللقطات / التحكم في الكاميرا | المدة / الإخراج | اعتبارات |
| مشاهد متعددة اللقطات، شخصيات متكررة، حوار متعدد اللغات بخمس لغات، سير عمل قائمة على المراجع | النصوص، الصور، إطارات البداية/النهاية وElements؛ Omni تقبل تركيبات أوسع من المواد المرجعية | يمكن لـElements نقل الشخصيات والمنتجات والموضوعات المتكررة الأخرى عبر اللقطات | نعم | إنشاء متعدد اللقطات، توقيت مخصص للقطات، تأطير، زوايا وحركة الكاميرا | حتى 15 ثانية؛ إخراج بدقة 4K متاح في سير العمل المدعومة | تتوافق المشاريع المبنية حول عدة مراجع، أو شخصيات قابلة لإعادة الاستخدام، أو عناصر مرتبطة بالصوت بشكل أفضل مع VIDEO 3.0 Omni. | |
Google Veo 3.1 | مشاهد قصيرة يتم فيها توليد الصورة والصوت معًا. | نص، صورة، امتداد فيديو، الإطارات الأولى/الأخيرة وحتى ثلاث صور مرجعية. | يمكن لصور المرجع ومدخلات الإطارات تثبيت الموضوعات والتكوين. | نعم | إدخال الإطار الأول/الأخير، توجيه الكاميرا المعتمد على المطالبة وتمديد الفيديو | 4 أو 6 أو 8 ثوانٍ؛ 720p أو 1080p أو 4K حسب الإعداد | توليدات الصورة المرجعية ودقة 1080p و4K تستخدم مدة زمنية قدرها 8 ثوانٍ. |
Runway Gen-4.5 | مطالبات مفصلة، حركة محددة التوقيت ولقطات تقودها الكاميرا | نص أو نص مع صورة | تحدد صورة الإدخال نقطة البداية البصرية | يُعالَج الصوت خارج عملية توليد Gen-4.5 | توجيه مفصل للكاميرا والحركة قائم على المطالبات | 2–10 ثوانٍ؛ 720p | يُخرِج Gen-4.5 حاليًا بدقة 720p، بينما تتولى الأجزاء الأخرى من منصة Runway مهام الإنتاج الإضافية. |
Seedance 2.5 | تسلسلات أطول ومشروعات مبنية على عدة مراجع | نص بالإضافة إلى مراجع الصور والفيديو والصوت | يدعم مجموعات مرجعية كبيرة عبر الموضوعات والمشاهد والصوت | نعم | بنية متعددة اللقطات، انتقالات اللقطات، العمل بالكاميرا وتحرير على مستوى الطوابع الزمنية | حتى 30 ثانية لكل توليد، مع إمكانية التمديد | يوفر نطاق المراجع الأوسع للفرق مواد أكثر لتنظيمها قبل عملية التوليد. |
Wan 3.0 | مشاريع أطول تستند إلى عدة أنواع من المواد المصدرية | نصوص، صور، فيديو، صوت، مستندات وصفحات ويب | يمكن إدراج المراجع متعددة الوسائط في عملية التوليد نفسها | نعم | تسلسلات طويلة الشكل، حركة كاميرا مستمرة وتوجيه متعدد الوسائط | حتى 30 ثانية؛ 1080p | يمكن أن تختلف الإتاحة والموارد المدعومة حسب السوق ومسار الوصول. |
Luma Ray3.2 | إعادة العمل أو إعادة الأسلوب أو إعادة توجيه اللقطات الموجودة بالفعل | الفيديو المصدر، والموجه، والإطارات الرئيسية | يحافظ على البنية من المصدر مع السماح بإجراء تغييرات بصرية | ليس جزءًا محوريًا من سير عمل Ray3.2 | يمكن لما يصل إلى 64 لقطة مفتاحية تثبيت لحظات محددة في المخطط الزمني للفيديو المصدر | مصمم حول سير عمل الفيديو المصدر | يركز Ray3.2 حاليًا بشكل أساسي على سير عمل الفيديو المصدر، وخاصة توليد الفيديو إلى فيديو |
MiniMax Hailuo 2.3 | الحركة البشرية، والأفعال، والأداء التعبيري | النص والصورة | يمكن لمدخل الصورة تحديد الموضوع قبل إضافة الحركة | غير مُدرج كجزء من نموذج Hailuo 2.3 نفسه | يستجيب لتعليمات الحركة والكاميرا | 6 أو 10 ثوانٍ؛ 768p أو 1080p حسب الوضع | الخيارات الحالية بدقة 1080p مرتبطة بعمليات توليد أقصر. |
PixVerse V6 | مقاطع سردية قصيرة، وفيديو اجتماعي، ومشاهد تقودها المؤثرات. | النص، والصورة، والمراجع، والإطارات الأولى والأخيرة، وتدفقات عمل التمديد. | أدوات تحويل المرجع إلى فيديو تدعم المواد البصرية المتكررة. | نعم | دعم متعدد اللقطات أصلي وتوجيه للكاميرا | 1–15 ثانية؛ بدقة تصل إلى 1080p | نافذة الخمس عشرة ثانية تناسب الصيغ القصيرة؛ الأعمال الأطول تحتاج إلى أكثر من عملية توليد واحدة. |
سلسلة Vidu Q3 | مشاهد محورها الشخصيات، وحوارات بثلاث لغات، وسرديات قصيرة | نص، صورة، إطارات بداية/نهاية ومراجع اعتمادًا على نسخة Q3 | التحويل من المرجع إلى الفيديو متاح عبر عائلة Q3 | نعم | ضوابط الكاميرا والإيقاع على مستوى الإطار | حتى 16 ثانية؛ تصل إلى 1080p بحسب المتغير | تسرد مخرجات الصوت والفيديو الأصلية الحالية الإنجليزية واليابانية والصينية. |
نموذج الفيديو Adobe Firefly | أعمال العلامات التجارية والمشاريع التي تستمر عبر أدوات Adobe | سير عمل النصوص والصور ومراجع التكوين | يمكن للصور أو مراجع التكوين أن توجه اللقطة المُولَّدة | يُعالَج الصوت عبر أجزاء أخرى من سير عمل Firefly | إعدادات الكاميرا والتأطير والتكوين | 5 ثوانٍ؛ حتى 1080p | يعمل نموذج الفيديو الخاص بأدوبي حاليًا بتوليدات مدتها خمس ثوانٍ، بينما تُجمَّع المشاريع الأطول عبر سير عمل أوسع. |
*المواصفات تعكس القدرات الموثقة علنًا والمتاحة وقت كتابة هذه السطور. قد تتغير الميزات وطرق الوصول وإعدادات الإخراج مع تحديث النماذج.
توضح المقارنة أيضًا سبب صعوبة وضع هذه النماذج في ترتيب واحد. فهي تميل إلى التوافق مع أنواع مختلفة من العمل:
- مشاريع متعددة اللقطات وموجهة بالمرجع: Kling VIDEO 3.0 / 3.0 Omni، Seedance 2.5، و Wan 3.0
- مشاهد قصيرة موجهة بدقة: Veo 3.1 و Runway Gen-4.5
- أعمال الحركة أو اللقطات الموجودة مسبقًا: Hailuo 2.3 للأداء الجسدي، و Ray3.2 للعمل انطلاقًا من اللقطات المصوَّرة مسبقًا
- مشروعات السرد القصير ومشروعات صانعي المحتوى: PixVerse وVidu
- إنتاج قائم على Adobe: Firefly
يعتمد التوافق الأنسب على المواد التي تبدأ بها وما يحتاج الفيديو النهائي إلى القيام به.
كيف تختار نموذجًا احترافيًا لتوليد الفيديو بالذكاء الاصطناعي؟
ابدأ بالمهمة التي أمامك. ما الذي تصنعه، وما المواد المتاحة بالفعل، وأي التفاصيل يجب أن تظل دون تغيير سيخبرك عادةً أكثر من قائمة طويلة من مواصفات النماذج.
ضع في الاعتبار | اسأل | تحقق من |
نوع الفيديو | هل هو مقطع منتج، مشهد حواري، سرد قصير، أم مراجعة للقطات موجودة؟ | نموذج يتناسب مع طول القطعة وإيقاعها وبنيتها |
المادة المصدرية | هل تعمل انطلاقًا من نص، أو صورة، أو عدة مراجع، أم من فيديو موجود بالفعل؟ | دعم للمادة التي تخطط بالفعل لاستخدامها |
الاستمرارية | ما التفاصيل التي تحتاج إلى البقاء قابلة للتعرّف من لقطة إلى أخرى؟ | أدوات للحفاظ على اتساق الشخصيات أو المنتجات أو المواقع أو الملابس أو الأصوات |
تخطيط اللقطات | هل تحتاج إلى تأطير ثابت، أو حركات كاميرا، أو توقيتًا دقيقًا، أو عدة لقطات متتابعة؟ | إطارات البداية والنهاية، إعدادات الكاميرا، توقيت اللقطة، أو خيارات اللقطات المتعددة |
الإنهاء | ما الذي يحتاج إلى الحدوث بعد إنشاء المقطع الأول؟ | طول ودقة كافيان، إضافةً إلى خيارات الصوت والمونتاج التي يتطلبها العمل النهائي |
النتيجة الأولى مهمة، لكنها جزء واحد فقط من العمل. قد يكون النموذج الذي يعمل جيدًا عبر المراجعات واللقطات الإضافية والصوت والمونتاج والتسليم خيارًا أفضل من النموذج الذي ينتج مجرد المقطع الأول الأكثر لفتًا للانتباه.
كيف تنشئ فيديو بالذكاء الاصطناعي باستخدام Kling VIDEO 3.0؟
بمجرد أن تعرف ما هو الأكثر أهمية لمشروعك، يمكنك تحويل تلك الاختيارات إلى إعداد عملي. مع سلسلة Kling VIDEO 3.0، يمكنك البدء بنص أو بصورة موجودة مسبقًا، تعيين الإطارات الافتتاحية والختامية، الحفاظ على العناصر المهمة قابلة للتعرّف باستخدام Elements، وإضافة حوار أو صوت أو عدة لقطات قبل تصيير المقطع.
الخطوة 1: اختر الطريقة التي تريد أن تبدأ بها.
ابدأ بالمادة المتوفرة لديك بالفعل.
- تحويل النص إلى فيديو: صف الموضوع، والإجراء، والمشهد، والكاميرا عندما تبدأ الفكرة بالكلمات.
| الموجه: لقطة جوية لأمواج زرقاء تضرب الصخور، لتخلق مشهدًا واسعًا ومهيبًا. |
- تحويل الصورة إلى فيديو: ابدأ من شخصية موجودة مسبقًا، أو موقع، ثم صف الحركة وسلوك الكاميرا الذي تريد إدخاله. Kling VIDEO 3.0 يستخدم مراجع الصور للمساعدة في الحفاظ على مظهر الموضوع أثناء تطور المشهد. VIDEO 3.0 Omni يضيف ربط العناصر، مما يجعل إعادة استخدام الشخصية أو الموضوع نفسه عبر المشاهد ومقاطع الفيديو المختلفة أسهل. حتى عندما تقوم الكاميرا بالتقريب أو التحريك أو الإمالة، تساعد سير العمل المستندة إلى المراجع هذه على الحفاظ على هوية بصرية أكثر اتساقًا.
| الموجّه: ملمس مكان عمل أصيل، لقطة طويلة متواصلة واحدة من دون أي قطوع. تتبع الكاميرا المرأة المهنية بثبات في لقطة متوسطة طوال الوقت، وتتحرك بتناغم معها: تتعقبها الكاميرا وهي تمشي وتتوقف فورًا عندما تتوقف، مع حركات طبيعية وسلسة وعمل كاميرا انسيابي. تسير المرأة إلى الأمام خارج المصعد، وتغلق أبواب المصعد ببطء وبشكل طبيعي خلفها؛ تدخل إلى منطقة المكتب، تنزع نظارتها الشمسية بيدها، تضعها بعفوية في حقيبة تنقلها اليومية، وتومئ بأدب للزملاء المارين؛ تتوقف للحظة، تتجمد الكاميرا بتناغم، تعلّق حقيبة تنقلها على علاقة المعاطف في منطقة المكتب، ثم تخلع معطفها الخارجي وتعقده على الحامل نفسه؛ بعد تعليق ملابسها، تمشي إلى الأمام مجددًا، تلاحقها الكاميرا بتناغم؛ يتجه نحوها شاب يرتدي قميصًا رسميًا، يناولها مستندًا وقلم توقيع، تتوقف، تتجمد الكاميرا بتناغم، تأخذهما وتوقّع الوثيقة؛ بعد التوقيع، تسير إلى الأمام مرة أخرى، وتتابعها الكاميرا بالتزامن؛ أخيرًا، تمشي إلى مكتبها، تجلس بجوار الكرسي، تمد يدها لالتقاط فنجان شاي على المكتب، وترشف منه ورأسها منحنٍ، وحركاتها مرتاحة وطبيعية. | ||
إطار البداية | ||
| ||
مرجع الشخصية | ||
| ||
فيديو | ||
| ||
الخطوة 2: وصف المشهد والحوار والصوت
بعد أن تُحدِّد المادة التي ستنطلق منها، صِف ما يحدث في المشهد وما ينبغي أن يسمعه الجمهور.
اكتب الأمر حول الموضوع، والفعل، والإعداد، والكاميرا. إذا كان المشهد يتضمن حوارًا، فأقرن كل سطر بالشخصية التي ينبغي أن تقوله. يمكن لـ Kling VIDEO 3.0 مطابقة كل سطر مع المتحدث المناسب عندما يشترك عدد من الشخصيات في المشهد.
صورة |
|
| التوجيه: بيئة منزلية مع طنين خافت لتكييف هواء غرفة المعيشة في الخلفية لإضفاء أجواء يومية واقعية. الأم (بهدوء، بنبرة متفاجئة): واو، لم أتوقع هذه الحبكة على الإطلاق. الأب (بصوت منخفض، موافقًا، بنبرة هادئة): نعم، الأمر غير متوقع تمامًا. لم يخطر ببالي أن ذلك سيحدث. الولد (بنبرة متحمسة): إنه أفضل منعطف على الإطلاق! الفتاة (وهي تهز رأسها موافقة، بنبرة حماسية): لا أصدق أنهم فعلوا ذلك! |
فيديو |
|
يمكنك أيضًا تضمين الصوت المحيطي ومواد صوتية أخرى في التوجيه نفسه. تتيح Native Audio إنشاء الحوار والصوت الخلفي والمرئيات معًا. ويدعم الحوار حاليًا اللغات الصينية والإنجليزية واليابانية والكورية والإسبانية، بما في ذلك المشاهد متعددة اللغات واللهجات أو اللكنات المدعومة.
صورة |
|
| الموجه: على سطح مدرسة ثانوية كورية، تتألق أضواء المدينة البعيدة في الخلفية مع نسيم لطيف يهمس، والنجوم تتلألأ في سماء الليل. الفتاة تستند إلى الدرابزين، شاردة الذهن. يتقدم الفتى حاملاً علبتين من الكولا، يناولها واحدة، فتأخذها وتفتح لسانها المعدني. الفتى (بنبرة عفوية، بالكورية): "숙제 다 했어? 왜 여기 있어?" الفتاة (وهي تتنهد، بالكورية): "시험이 너무 무서워". الفتى (بنبرة لطيفة، بالكورية): "걱정 마, 넌 잘할 거야." |
|
إذا كان عنصر الشخصية يحتوي بالفعل على صوت محفوظ مرتبط بـ Kling VIDEO 3.0 Omni، فلست بحاجة إلى وصف الصوت نفسه مرة أخرى في الموجه.
الخطوة 3: اختر لقطة واحدة أو لقطات متعددة
أبقِ Multi-Shot متوقفة عندما يعمل المشهد بشكل أفضل كلقطة متواصلة واحدة. إذا تطلب التسلسل عدة وجهات نظر، فعّله.
يمكن لـ Kling VIDEO 3.0 استخدام التوجيه لتنظيم تلك التغييرات في تسلسل مترابط، بما في ذلك التحولات في التأطير ووجهة النظر وزاوية الكاميرا.
صورة |
|
| التوجيه: رجل في منتصف العمر يطلب الطعام في مطعم غربي. يتحدث الإنجليزية بلكنة هندية ويقول: "عذرًا، أود أن أطلب باستا بالمأكولات البحرية، وقطعة فيليه ميغنون متوسطة النضج"، ثم يرفع نظره ويتابع: "وهل لديكم أي توصيات للمشروبات؟" |
فيديو |
|
للحصول على توجيه أكثر تحديدًا، استخدم ميزة اللقطات المتعددة المخصصة. يمكنك وصف كل لقطة على حدة وتحديد مدتها، مما يسهل الانتقال من لقطة واسعة إلى لقطة قريبة، أو تبديل وجهات النظر أثناء الحوار، أو عرض الفعل نفسه من عدة زوايا.
صورة | |||||
| |||||
| اللقطة 1، لقطة واسعة من الخلف بزاوية منخفضة، تتبع الراكب أثناء تقدمه إلى الأمام. | اللقطة 2، لقطة قريبة جانبية بزاوية منخفضة، لقطة تفصيلية لعجلة الدراجة النارية. | اللقطة 3، منظور الشخص الأول من السائق، مع ظهور المقود ولوحة العدادات أمامه. | اللقطة 4، لقطة متوسطة من الأمام، تتبع متراجع أمام الدراجة النارية، خوذة السائق متجهة نحو الكاميرا. | اللقطة 5، لقطة تتبع جانبية على مستوى العين مع حركة جانبية طفيفة. | اللقطة 6، لقطة واسعة بزاوية عالية مع ميل لطيف إلى الأسفل. ترتفع الكاميرا بينما تواصل دراجة الثلج التوغل أعمق في حقل الثلج، تاركة مسارات متعرجة منقوشة في الثلج الأبيض النقي، مع غابات مغطاة بالثلوج متناثرة على الجانبين. |
فيديو | |||||
| |||||
الخطوة 4: اضبط الطول وابدأ التوليد
طابق الطول مع ما يحدث على الشاشة. Kling VIDEO 3.0 تعمل من 3 إلى 15 ثانية، ما يوفر مساحة كافية لردود الفعل السريعة، واللقطات الأطول، أو تسلسل مُكوَّن من عدة لقطات.
حدِّد التنسيق النهائي قبل التصيير. اختر 720p أو 1080p أو 4K، مع أُطُر 16:9 أو 1:1 أو 9:16. يُناسب 16:9 يو فر يو يوتيوب، والمواقع الإلكترونية، والعروض التقديمية، والحملات ذات الشاشة العريضة؛ ويعمل 1:1 بشكل جيد مع منشورات الخلاصة والمرئيات التي تركز على المنتج؛ بينما يتلاءم 9:16 مع تيك توك، وريلز، وشورتس، وغيرها من المواضع الموجهة للهواتف المحمولة.
Kling VIDEO 3.0 مقابل VIDEO 3.0 Omni: أيّهما ينبغي أن تستخدمه؟
Kling VIDEO 3.0 وKling VIDEO 3.0 Omni يدعمان كلاهما Native Audio وMulti-Shot والتوليد حتى 15 ثانية، رغم أن توفر الميزات قد يختلف حسب وضع الإدخال. يبدأ الاختلاف بينهما في كيفية بناء المشهد. يعتمد VIDEO 3.0 أكثر على المطالبات، بينما يمنح VIDEO 3.0 Omni المواد المرجعية دورًا أكبر في العملية.
1. اختر Kling VIDEO 3.0 من أجل
- تحويل النص إلى فيديو وتحويل الصورة إلى فيديو
- توليد إطارات البداية والنهاية
- سلاسل متعددة اللقطات
- حوارات متعددة اللغات ومشاهد تضم عدة شخصيات
- مقاطع فيديو يتم تشكيلها أساسًا عبر الأوامر النصية
2. اختر Kling VIDEO 3.0 Omni لـ
- عدة مراجع للصور وعناصر في إعداد واحد
- عناصر تم إنشاؤها من الفيديو
- شخصيات تظهر مجددًا أو مواضيع ذات علامة تجارية
- أصوات الشخصيات التي ترغب في استخدامها مرة أخرى
- مشاهد تعتمد اعتمادًا كبيرًا على المراجع البصرية وتحافظ على قابلية التعرّف على الموضوعات
يعد VIDEO 3.0 اختيارًا طبيعيًا عندما يكون معظم المشهد موصوفًا في المطالبة. يكون VIDEO 3.0 Omni أكثر منطقية عندما تكون هناك حاجة إلى نقل الصور أو العناصر أو مراجع الفيديو أو الأصوات المحفوظة عبر الفيديو. للاطلاع عن كثب على النموذجين، اقرأ دليلنا بعنوان Kling VIDEO 3.0 vs Kling VIDEO 3.0 Omni guide.
كيفية الحصول على نتائج أفضل من نماذج توليد الفيديو بالذكاء الاصطناعي
المقطع الضعيف ليس دائماً علامة على أن النموذج غير مناسب للمهمة. غالباً ما يكون تعديل بسيط على الموجز أو المادة المصدر أو توجيه اللقطة كافياً لدفع الإصدار التالي ليقترب مما تريده.
اكتب المطالبات كتوجيهات للقطات
اذكر ما يحدث داخل الكادر بدلاً من إغراق الموجه بكلمات تصف المزاج.
بدلاً من: إعلان عطر فاخر ذو طابع سينمائي جميل.
جرّب: لقطة قريبة لزجاجة عطر زجاجية على سطح حجري داكن. تتحرك الكاميرا ببطء إلى الداخل بينما يمر شعاع ضيق من الضوء عبر الزجاجة.
استخدم المراجع للمظهر والحركة
يمكن للنص أن يصف ما يجب أن يحدث، بينما تساعد الصور وElements في الحفاظ على تمييز الوجوه أو المنتجات أو الأزياء أو المواقع عبر اللقطات.
عندما يكون الأداء المحدد مهمًا، يمكن لـMotion Control تطبيق الحركة وتعابير الوجه من فيديو مُحمَّل أو من Motion Library على صورة شخصية واحدة. تحدد الصورة مظهر الشخصية، بينما يوجّه مرجع الحركة الطريقة التي تتحرك بها تلك الشخصية.
غيّر شيئًا واحدًا في كل مرة
عندما تكون اللقطة قريبة من المطلوب، اضبط فقط ما يحتاج إلى عمل. أبطئ الكاميرا إذا كانت تتحرك بسرعة كبيرة، غيّر التوقيت إذا جاء القطع مبكرًا جدًا، أو عزز المصدر البصري إذا بدأ المظهر في الانحراف. يجعل ذلك من السهل رؤية أي تعديل حسّن الإصدار التالي.
النهاية
تختلف نماذج توليد الفيديو بالذكاء الاصطناعي الآن بدرجة أقل من حيث قدرتها على إنتاج مقطع، وبدرجة أكبر في كيفية تعاملها مع الحركة والمراجع والصوت وبنية اللقطة والاستمرارية البصرية. يجمع Kling VIDEO 3.0 هذه الجوانب مع مراجع الصور وميزة Native Audio وأدوات Multi Shot. ويمد VIDEO 3.0 Omni هذه الإمكانات باستخدام Element binding، مما يمنح الشخصيات والموضوعات المتكررة حضورًا أكثر اتساقًا عبر المشاريع المبنية من صور متعددة، ومراجع فيديو، وأصوات قابلة لإعادة الاستخدام.
الأسئلة الشائعة
ما هو أفضل نموذج لتوليد الفيديو بالذكاء الاصطناعي في عام 2026؟
لا يوجد نموذج واحد لتوليد الفيديو بالذكاء الاصطناعي يناسب كل نوع من الفيديو. يعتمد الاختيار الصحيح على المادة المصدرية لديك وعلى مقدار التحكم الذي تحتاجه في الحركة والصوت وعمل الكاميرا والموضوعات المتكررة. Kling VIDEO 3.0 هو نموذج احترافي لتوليد الفيديو بالذكاء الاصطناعي صُمِّم لكل من المبدعين الأفراد وفرق الإنتاج الاحترافية، إذ يجمع بين جودة سينمائية بدقة 4K أصلية مع الصوت الأصلي، وسرد متعدد اللقطات، وتحكم إبداعي متقدم. يوسّع VIDEO 3.0 Omni سير العمل هذا للمشاريع الأكثر تعقيدًا التي تتضمن مراجع بصرية متعددة وشخصيات قابلة لإعادة الاستخدام وعناصر مرتبطة بالصوت، كما يتيح للمبدعين تحرير مقاطع فيديو تصل مدتها إلى 10 ثوانٍ.
ما الذي ينبغي أن تبحث عنه عند مقارنة نماذج توليد الفيديو بالذكاء الاصطناعي؟
انظر إلى كيفية أداء كل خيار فيما يتعلق بالحركة، والمراجع، والصوت، وتوجيه اللقطات، والطول، وجودة الصورة النهائية. ما يهم أكثر سيختلف من مشروع لآخر. المشاهد التي تعتمد على الحوار تتطلب كلامًا واضحًا وشخصيات متكررة تبقى سهلة التعرّف، بينما يضع العمل المتعلق بالمنتجات غالبًا وزنًا أكبر على دقة المرئيات، وعمل الكاميرا المتعمد، والتفاصيل التي تحافظ على اتساقها من لقطة إلى أخرى.
هل يمكن لنماذج توليد الفيديو بالذكاء الاصطناعي إنتاج صوت؟
بعضها يفعل ذلك. تُنشئ Native Audio الكلام، والأجواء، وأصواتًا أخرى مع الصور المرئية بدلًا من تركها لمرحلة دبلجة أو تأليف موسيقي منفصلة. يمكن لـ Kling VIDEO 3.0 أيضًا التعامل مع الحوار متعدد اللغات و متزامن مع حركة الشفاه الكلام. عندما تتحدث شخصية ما، يساعد إسناد السطر مباشرة إلى تلك الشخصية في إبقاء الصوت مرتبطًا باللحظة المناسبة على الشاشة.
إلى أي مدى يمكن أن يبلغ طول الفيديوهات المولدة بالذكاء الاصطناعي؟
يختلف الطول حسب النموذج. بُنيت بعض الأدوات للمقاطع القصيرة جدًا، بينما تتيح أخرى تسلسلات أطول. يدعم Kling VIDEO 3.0 ما يصل إلى 15 ثانية في جيل واحد، بما في ذلك مشاهد متعددة اللقطات. وهذا يكفي لإيقاع قصصي وجيز، أو لحظة منتج، أو قطعة اجتماعية قصيرة من دون تقسيم الفكرة إلى عدة مقاطع منفصلة.