إن اختيار أفضل أداة ذكاء اصطناعي لمزامنة الشفاه في الفيديو يتعلق بأكثر من مجرد مطابقة حركات الفم مع الصوت. يجب أن تساعد في الحفاظ على اتساق الوجوه والتعابير وتفاصيل الفيديو طوال المقطع. في هذا الدليل، نقارن بين أدوات الذكاء الاصطناعي الرائدة لمزامنة الشفاه في عام 2026 ونستعرض مسارين في Kling AI: استخدام أداة Lip Sync لإضافة كلام أو غناء متزامن إلى فيديو شخصية موجود، واستخدام Native Audio في سلسلة VIDEO 3.0 لإنشاء مشاهد حوار جديدة مع كلام متزامن وأداء وجهي وصوت منذ البداية.
ما الذي يجعل أداة مزامنة شفاه بالذكاء الاصطناعي جيدة؟
يستلزم اختيار أفضل أداة ذكاء اصطناعي لمزامنة الشفاه في الفيديو أكثر من مجرد التحقق مما إذا كانت حركات الفم تطابق الصوت. تشمل عوامل المقارنة الرئيسية دقة المزامنة، واتساق ملامح الوجه، والتعامل مع الحركة، ومرونة الإدخال، ودعم اللغات، وأداء المشاهد متعددة المتحدثين.
عامل المقارنة | ما الذي يجب البحث عنه | لماذا يهم |
مزامنة الصوت والصورة | تطابق حركات الفم مع أصوات الكلام، والتوقفات، وتوقيت الجمل | قد تجعل مشكلات التوقيت البسيطة الحوار يبدو منفصلاً عن الفيديو |
ثبات ملامح الوجه والتعامل مع الحركة | ملامح وجه ثابتة، وتعابير، وحركات رأس، وزوايا كاميرا، وتفاصيل بصرية | ينبغي أن يظل المتحدث قابلاً للتعرّف عليه طوال الفيديو |
مرونة الإدخال | دعم مقاطع الفيديو والشخصيات والصور الرمزية والمشاهد المولدة بالذكاء الاصطناعي القائمة بالفعل | يبدأ المبدعون المختلفون بمواد واحتياجات إنتاج مختلفة |
دعم متعدد اللغات والأصوات | دعم لغات وأصوات وأنماط حديث مختلفة | مهم للترجمة والتعريب والجمهور العالمي |
معالجة المشهد متعدد المتحدثين | مطابقة المتحدثين بدقة وتوقيت الحوار في المحادثات | يساعد على الحفاظ على صوت كل شخص متوافقًا مع المتحدث الصحيح |
6 أفضل أدوات الذكاء الاصطناعي لمزامنة حركة الشفاه للفيديو في عام 2026
أدوات مزامنة الشفاه بالذكاء الاصطناعي تعمل بطرق مختلفة. صُممت بعضُها لإضافة كلام جديد إلى الفيديوهات الحالية، بينما يجمع البعض الآخر بين مزامنة الشفاه والترجمة أو الصور الرمزية أو المشاهد المُنشأة بالذكاء الاصطناعي. يعتمد الخيار الأفضل على اللقطات التي تبدأ بها ونوع الفيديو الذي تريد صنعه.
يقارن الجدول أدناه بين ست أدوات لمزامنة الشفاه بالذكاء الاصطناعي من حيث مزامنة الفيديو والترجمة وإنشاء الفيديو بالذكاء الاصطناعي والمشاهد متعددة المتحدثين.
أداة | الاستخدام الرئيسي | كيفية استخدام مزامنة الشفاه | متعدد اللغات والتعريب | الحوار ومتعدد المتحدثين |
Kling AI | مزامنة حركة الشفاه لمقاطع الفيديو ذات الشخصيات الحالية وتوليد حوارات أصلية لمقاطع فيديو الذكاء الاصطناعي الجديدة | استخدم أداة Lip Sync المخصصة لمطابقة الصوت المُحمَّل أو المحوَّل من نص إلى كلام مع فيديو شخصية مدعوم قائم، أو استخدم الصوت الأصلي في VIDEO 3.0 / VIDEO 3.0 Omni لتوليد الحوار والأداء البصري المتزامن معاً في فيديو جديد. | تدعم سلسلة VIDEO 3.0 توليد الحوار الأصلي باللغات الصينية والإنجليزية واليابانية والكورية والإسبانية، بما في ذلك الحوارات متعددة اللغات واللهجات واللكنات. | تدعم سلسلة VIDEO 3.0 الحوار متعدد الشخصيات مع أسطر مخصصة لكل متحدث وأداء وجهي متزامن. |
Vozo AI | الدبلجة والتعريب لمقاطع الفيديو الحالية | يتم مطابقة الكلام الجديد أو المترجم مع المتحدث في اللقطات الأصلية | مبني حول ترجمة الفيديو والمحتوى الصوتي المحلي | يدعم توطين عدة متحدثين |
HeyGen | مقاطع فيديو الأفاتار ومحتوى الفيديو المترجم | يتم مزامنة الكلام مع الأفاتارات أو المتحدثين بعد تغييرات الصوت أو الترجمة | تركيز قوي على ترجمة الفيديو متعددة اللغات | يدعم محتوى الصور الرمزية ومتعدد المتحدثين |
Sync Labs | مزامنة حركة الشفاه للإنتاج وعمليات التكامل | يمكن مزامنة الصوت مع الفيديو الحالي من خلال أدوات مخصصة لمزامنة حركة الشفاه | يعتمد دعم اللغات على إعداد الإنتاج المحيط | يمكن استخدامه لمزامنة الحوار |
PixVerse | إنشاء فيديوهات ذكاء اصطناعي قصيرة | يمكن إضافة مزامنة حركة الشفاه إلى محتوى الشخصيات المولَّد | تختلف خيارات اللغة بحسب الميزة | يدعم المشاهد الحوارية القائمة على الشخصيات |
CapCut | تحرير الفيديو الاجتماعي ومحتوى المبدعين | يمكن التعامل مع مزامنة الشفاه من خلال التحرير والميزات المدعومة بالذكاء الاصطناعي | تختلف خيارات الترجمة حسب الأداة والمنطقة | يعتمد على ميزات التحرير المستخدمة |
أي نهج لمزامنة الشفاه يناسب فيديوك؟
تؤدي مزامنة الشفاه وظائف مختلفة اعتمادًا على الفيديو الذي تنشئه. تتطلب اللقطات الموجودة، والمحتوى المترجم، والمشاهد المُنشأة حديثًا نهجًا مختلفًا لكل منها.
نقطة انطلاقك | ما تريد إنشاءه | الطريقة الموصى بها | الأدوات التي ينبغي أخذها في الاعتبار |
لديك بالفعل فيديو لشخصية موجودة | استبدل الكلام، أضف حوارًا جديدًا، أو قم بمزامنة صوت جديد | مزامنة الشفاه لفيديو موجود | Kling AI, Vozo AI, Sync Labs |
لديك فيديو بلغة أخرى | أنشئ إصدارات محلية لجماهير مختلفة | الترجمة + توليد الصوت + مزامنة الشفاه | HeyGen، Vozo AI، Kling AI* |
لديك صورة شخصية أو أفاتار | اجعل شخصية تتحدث مع تعابير متزامنة | توليد شخصية متحدثة أو أفاتار | Kling AI أفاتار، HeyGen |
تريد إنشاء مشهد جديد من الصفر | أنشئ الشخصيات والحوار والمرئيات معًا | توليد الفيديو بالذكاء الاصطناعي مع صوت أصلي | Kling AI |
أنت تُنشئ محادثة أو مشهد قصة | حافظ على حوار طبيعي بين عدة شخصيات | توليد حوار متعدد الشخصيات | Kling AI |
*يمكن لـ Kling Lip Sync مزامنة صوت مستهدف مُعد مسبقًا أو أصوات تحويل النص إلى كلام المتاحة مع فيديو شخصية مدعوم.
طريقتان لإنشاء مقاطع فيديو ذكاء اصطناعي بمزامنة شفاه باستخدام Kling AI
الخيار 1: أضف مزامنة الشفاه إلى فيديو شخصية قائم
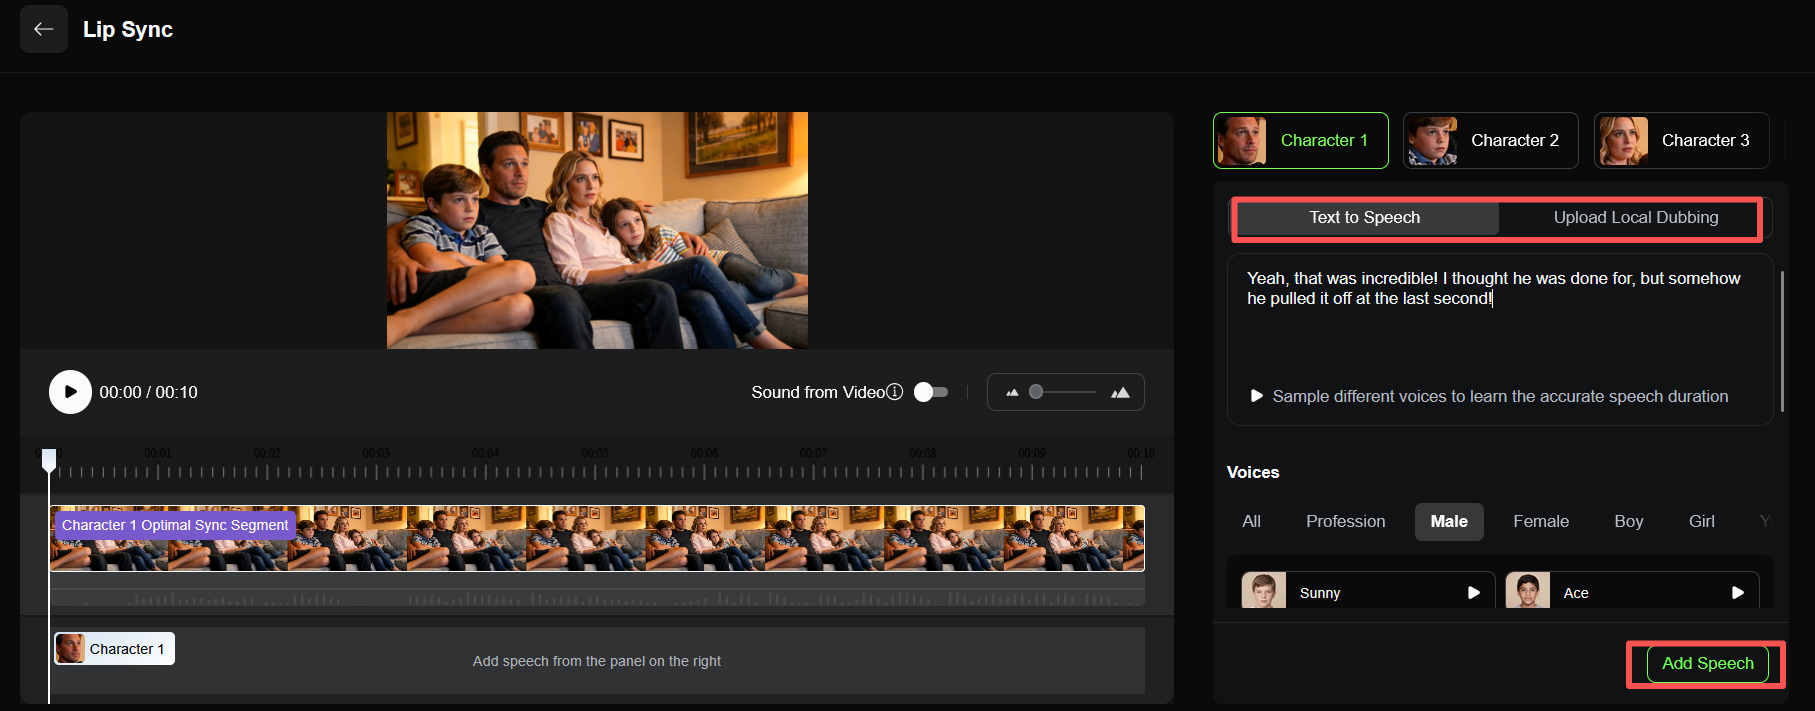
إذا كان لديك بالفعل فيديو شخصية ذكاء اصطناعي من Kling مدعوم، فاستخدم أداة Kling AI Lip Sync لإضافة كلام أو غناء جديد من دون إعادة إنشاء المشهد من البداية. يمكنك تحميل صوتك الخاص أو استخدام تحويل النص إلى كلام، ثم مزامنة حركات شفاه الشخصية مع الصوت الجديد.
الخطوة 1: اختر فيديو شخصية واضحًا
اختر مقطعًا مدعومًا من Kling AI يظهر فيه وجه كامل وواضح. إن رؤية الفم بوضوح تجعل من الأسهل الحكم على ما إذا كان الكلام الجديد يبقى متزامنًا طوال المقطع. تدعم ميزة Lip Sync في Kling AI الشخصيات البشرية الواقعية وثلاثية الأبعاد 3D وثنائية الأبعاد 2D. إذا استدار الشخصية بعيدًا عن الكاميرا أو كان الفم مغطى جزئيًا، فتأكد من أن الأجزاء الرئيسية من الكلام لا تزال تُظهر قدرًا كافيًا من الوجه لكي يعمل التزامن بوضوح.
الخطوة 2: أضف الصوت أو أدخل نصًا
حمّل تعليقًا صوتيًا أو مسار غناء، أو استخدم تحويل النص إلى كلام لإنشاء الصوت من نص مكتوب. إذا كان الصوت أطول من الفيديو، فقم بقصه قبل عملية التوليد. يمكنك أيضًا ضبط سرعة تحويل النص إلى كلام عندما يحتاج سطر ما إلى التناسب مع مقطع أقصر. حافظ على قرب النص من زمن الفيديو المتاح حتى لا يبدو الإلقاء متعجلًا أو يترك فترات توقف طويلة.
الخطوة 3: أنشئ مزامنة الشفاه وراجعها
أنشئ الإصدار المتزامن مع حركة الشفاه وشاهد المقطع الكامل، بما في ذلك العبارات الأسرع، والتوقفات، ونهايات الجمل. إذا بدا جزء من الكلام مبكرًا أو متأخرًا، فتحقق أولًا من طول الصوت وإيقاعه. يمكنك إزالة التوقفات غير الضرورية من المسار الذي تم رفعه أو ضبط سرعة التحويل من النص إلى كلام قبل التوليد مرة أخرى. راقب الوجه الكامل للشخصية إضافة إلى الفم، خاصة عندما يتضمن الفيديو الأصلي تعابير أقوى أو حركة في الرأس.

الخيار 2: إنشاء حوار متزامن مع حركة الشفاه باستخدام سلسلة VIDEO 3.0
إذا كنت ترغب في إنشاء مشهد حوار جديد بدلًا من إضافة كلام إلى فيديو موجود، فيمكن لـKling VIDEO 3.0 وVIDEO 3.0 Omni توليد الحوار، وحركة الشفاه، وتعابير الوجه، والصور المرئية، والأجواء، والمؤثرات الصوتية معًا من خلال Native Audio. إذا كان المشهد يتضمن عدة شخصيات تتحدث منذ البداية، يمكنك استخدام Text to Video AI وتحديد:
- من الذي يتحدث
- ما تقوله كل شخصية
- ترتيب الحديث
- اللغة أو اللهجة
- ما الذي تفعله كل شخصية أثناء التحدث
| التوجيه: يجلس رجل وامرأة متقابلين في مقهى حديث هادئ ليلاً. يتحدث الرجل أولاً بالإنجليزية بلكنة أمريكية هادئة، وينحني قليلاً إلى الأمام، ويقول: "لم أظن أنك ستأتين." تنظر المرأة إليه وتتوقف لبرهة، ثم ترد بالإنجليزية بلكنة بريطانية: "كنت على وشك ألا أفعل." ترسم ابتسامة صغيرة وتضع فنجان قهوتها ببطء. يبدو الرجل مندهشاً ويبدأ بالرد، لكنها تلتفت نحو النافذة قبل أن يتحدث مرة أخرى. حافظ على وضوح توقيت الحوار، مع حركة شفاه طبيعية وتعابير وجه خفيفة وتوقفات واقعية بين كل متحدث. |
يدعم VIDEO 3.0 حوارات متعددة الشخصيات بالصينية والإنجليزية واليابانية والكورية والإسبانية، إضافة إلى الحوارات متعددة اللغات، واللهجات، واللكنات. يمكن لعدة شخصيات أن تتقاسم مشهداً واحداً من دون الحاجة إلى إنشاء مقطع منفصل لكل متحدث ثم تجميع المقاطع معاً لاحقاً.
باستخدام Native Audio، يمكن إنشاء الحوار والأجواء والمؤثرات الصوتية إلى جانب العناصر البصرية. يمكنك وصف الجمل المنطوقة، ونغمة الغرفة، وخطوات الأقدام، أو أي أصوات أخرى في نص الموجه بحيث تصبح جزءًا من المشهد بدلاً من إضافتها طبقة تلو أخرى بعد اكتمال العناصر البصرية. بالنسبة لمشاهد القصص القصيرة، والمحادثات، ومقاطع الفيديو الخاصة بالمنتجات التي تتضمن سطور منطوقة، يقلل ذلك من الحاجة إلى عمل صوتي منفصل بعد التوليد.
إذا كنت تريد أن تتحرك الكاميرا مع الحوار، فاستخدم Multi-Shot في Kling AI video generator. يمكن للمشهد الانتقال من لقطة ثنائية إلى لقطة قريبة للشخص المتحدث، ثم القطع إلى رد فعل الشخصية الأخرى. يمكن لـ Multi-Shot تنظيم تغييرات اللقطات، والتأطير، وزوايا الكاميرا انطلاقًا من الأمر النصي. إذا كنت قد خططت التسلسل مسبقًا، فإن Custom Multi-Shot يتيح لك ضبط محتوى كل لقطة ومدتها بنفسك. يدعم VIDEO 3.0 توليدات تتراوح بين 3 و15 ثانية، لذا يمكن أن تتضمن سلسلة قصيرة حوارًا، وتفاعلات، وحركة الشخصيات، والعديد من تغييرات الكاميرا.
يُوسِّع VIDEO 3.0 Omni سير العمل هذا لتوفير إبداع يعتمد أكثر على المراجع، من خلال دمج Native Audio مع اتساق الشخصيات المستند إلى Element ومدخلات متعددة الوسائط أوسع نطاقًا.
وباستخدام هذه الضوابط معًا، يمكنك بناء مشهد حوار تكون فيه الكلمات، وحركة الشفاه، وتفاعلات الشخصيات، والصوت، وتغييرات الكاميرا تعمل بالفعل ضمن التسلسل نفسه بدلًا من تجميعها قطعة بعد أخرى لاحقًا.
صورة |
| الموجه: تغمر أشعة الشمس شوارع مدريد القديمة. أمام مخبز على جانب الشارع، تسير سائحة صينية وسائح يرتدي سترة بقلنسوة رمادية نحو بائع المخبز، وكلاهما يرتدي ابتسامة مهذبة. تقول السائحة (وهي تتحدث ببطء قليل وبلكنة متعثرة، بالإسبانية):Disculpe, ¿dónde está la plaza mayor? يجيب بائع المخبز الإسباني ذو الشعر الأبيض (وهو يلتفت قليلًا ويشير إلى الأمام بنبرة خفيفة ومبتهجة، بالإسبانية):Por allí, a dos calles. Muy cerca. تومئ السائحة لتعبر عن شكرها. يهمّ السائح أيضًا برأسه موافقًا ويقول (بالإسبانية): Muchas gracias. يبتسم بائع المخبز ويبادلهم الإيماء. ثم يدير السائحان وجهيهما ويسيران في الاتجاه الذي أشار إليه. |
المخرجات |
ما أكثر مشكلات مزامنة الشفاه شيوعًا وكيف يمكنك حلها؟
يمكن أن تظهر بعض حالات عدم التطابق الشائعة أثناء إنشاء مزامنة الشفاه. غالبًا ما تنبع من لقطات المصدر، أو توقيت الصوت، أو طول النص، أو توجيه المتحدث. إليك كيفية تحديد السبب وضبطه.
يعتمد الحل على سير العمل الذي تستخدمه. مع أداة Lip Sync، ترتبط المشكلات عادةً بفيديو الشخصية المصدر، أو توقيت الصوت، أو طول النص. ومع Native Audio في VIDEO 3.0 أو VIDEO 3.0 Omni، قد تعتمد المشاهد متعددة الشخصيات أيضًا على مدى وضوح تعيين كل متحدث وكل سطر في المطالبة.
المشكلة | السبب المحتمل | ما يمكن تجربته |
يتحرك الفم مبكرًا جدًا أو متأخرًا للغاية | الصوت الجديد لا يتوافق مع توقيت المقطع الأصلي، أو أن الإلقاء سريع جدًا أو بطيء جدًا | اختصر الفترات الطويلة من الصمت، قصّر الجملة، أو اضبط سرعة الصوت قبل التوليد مرة أخرى |
يتغير الوجه أثناء حديث الشخصية | يحتوي الفيديو المصدر على تفاصيل وجه محدودة، أو حركات رأس قوية، أو ضبابية حركة، أو أجزاء من الوجه مغطاة | استخدم لقطات يبقى فيها الوجه والفم مرئيين خلال المقاطع الرئيسية المنطوقة |
يبدو تحرك الفك أو الفم مبالغًا فيه | يتضمن السطر لفظًا سريعًا أو قويًا لا يتطابق مع الحركة المرئية في اللقطات الأصلية | جرّب سطرًا أقصر، أداءً أبطأ، أو لقطات بزاوية أمامية أو زاوية ثلاثة أرباع أكثر وضوحًا |
يبدأ التزامن بشكل جيد لكنه ينحرف لاحقًا | جملة طويلة، إيقاع غير منتظم، أو توقفات إضافية تدفع الصوت تدريجيًا بعيدًا عن توقيت الفيديو | شاهد المقطع كاملًا، ثم قصّر الجملة أو أزل التوقفات بالقرب من النقطة التي يبدأ عندها الانحراف |
يبدو أن الشخصية الخاطئة هي التي تتحدث | التوجيه لا يوضح ترتيب المتحدثين أو تعيين الحوار بوضوح كافٍ | اذكر من يقول كل سطر، وابقِ ترتيب الكلام صريحًا، وافصل حوار كل شخصية بوضوح. |
يبدو الحوار المترجم متسرعًا | الجملة المترجمة تستغرق وقتًا أطول في النطق مقارنة بالسطر الأصلي. | أعد صياغة الترجمة وفق طول النطق بدلاً من مطابقة المصدر كلمة بكلمة، ثم عدّل سرعة الصوت إذا لزم الأمر. |
بالنسبة لمزامنة حركة الشفاه، تحقّق أولاً من المقطع الأصلي، وتوقيت الصوت، وطول النص. وللمشاهد ذات الصوت الأصلي، تأكد أيضًا من تحديد كل متحدث، وكل سطر، وترتيب الكلام بوضوح قبل إضافة تفاصيل إضافية إلى بقية التوجيه.
النهاية
أفضل ذكاء اصطناعي لمزامنة الشفاه في الفيديو يجب أن يجعل الكلام جزءًا من الأداء، مع الحفاظ على دقة حركة الفم بينما تتحرك الشخصية أو تقدّم جُمَلًا أطول، مع الحفاظ على ملامح الوجه والتعبير الطبيعي. بالنسبة لفيديو شخصية مدعوم موجود لـ Kling AI، تتيح لك أداة Kling AI Lip Sync إضافة كلام أو غناء جديد من دون إعادة إنشاء المشهد من الصفر. وإذا كنت تنشئ مشهد حوار من الصفر، يمكن لـ Kling VIDEO 3.0 توليد الحوار، وحركة الشفاه، وتعبيرات الوجه، والصوت، وتغييرات اللقطات معًا من خلال Native Audio، وحوار متعدد الشخصيات، وMulti-Shot. يقلل ذلك من العمل المنفصل لمطابقة الصوت، وحركة الفم، وتغييرات الكاميرا في مرحلة ما بعد الإنتاج، مع المساعدة في أن يبقى المشهد النهائي متماسكًا عبر مزامنة شفاه أكثر ثباتًا وأداء شخصية أكثر اتساقًا.
الأسئلة الشائعة
أي ذكاء اصطناعي يقدّم أفضل مزامنة شفاه؟
أفضل أدوات الذكاء الاصطناعي لمزامنة الشفاه تعتمد على ما تصنعه. بالنسبة لفيديو شخصية مدعوم موجود لـ Kling AI، فإن Kling AI Lip Sync مصمم لإضافة كلام أو غناء جديد؛ ولمقاطع الفيديو المترجمة، تركّز أدوات مثل HeyGen و Vozo AI أكثر على الدبلجة والتوطين؛ أما لمقاطع الفيديو بأسلوب المقدم التي تعتمد على الصور الرمزية، فإن HeyGen مبني حول تدفقات عمل يقودها الأفاتار. إذا كنت تنشئ مشهد حوار جديداً من الصفر، فيمكن لـ Kling VIDEO 3.0 توليد الكلام وحركة الشفاه وتعابير الوجه والصوت معاً في المشهد نفسه. اختر الأداة بناءً على المواد التي تبدأ بها وما إذا كنت تحتاج إلى استبدال بسيط للكلام، أو ترجمة، أو عرض بواسطة أفاتار، أو مشهد حوار مُنشأ بالكامل.
هل يمكن لبرمجيات مزامنة الشفاه بالذكاء الاصطناعي التعامل مع لغات متعددة؟
نعم، لكن دعم اللغات يختلف حسب الميزة. يتيح Kling Lip Sync مزامنة الكلام أو الغناء الذي ترفعه، بينما تستخدم ميزة Text to Speech الأصوات المتوفرة في الأداة. بالنسبة للمشاهد المولَّدة حديثًا، يدعم VIDEO 3.0 الحوارات باللغات الصينية والإنجليزية واليابانية والكورية والإسبانية، بما في ذلك المحادثات متعددة اللغات. قد تختلف خيارات اللغة بحسب إصدار النموذج، لذا تحقَّق من الإعدادات الظاهرة في الإصدار الذي تستخدمه.
هل يمكنني استخدام صوتي الخاص في Kling Lip Sync؟
نعم. يسمح لك Kling Lip Sync برفع تعليقك الصوتي أو تسجيل الغناء الخاص بك. إذا كان الصوت أطول من الفيديو، يمكنك قصه قبل التوليد. استخدم تسجيلًا واضحًا ومقاطع مصدرية يبقى فيها الوجه مرئيًا أثناء مقاطع الكلام الأساسية. بعد التوليد، افحص المقاطع السريعة، والتوقفات، وأصوات العلة الطويلة، واللحظات التي يزداد فيها تحريك الرأس للتأكد من أن الفم لا يزال متزامنًا مع الصوت.
ما الفرق بين Kling Lip Sync وميزة VIDEO 3.0 Native Audio؟
يضيف Kling Lip Sync كلامًا جديدًا أو غناءً إلى فيديو شخصية مدعوم موجود مسبقًا، بينما ينشئ VIDEO 3.0 Native Audio الفيديو والصوت معًا منذ البداية. مع VIDEO 3.0، يمكن إدخال الحوار وحركة الشفاه والصوت وميزة Multi-Shot جميعها في المشهد الجديد. استخدم Kling Lip Sync عندما يكون لديك فيديو شخصية Kling AI مدعوم تريد الاحتفاظ به؛ واستخدم VIDEO 3.0 أو VIDEO 3.0 Omni عندما يكون مشهد الحوار لا يزال بحاجة إلى الإنشاء.