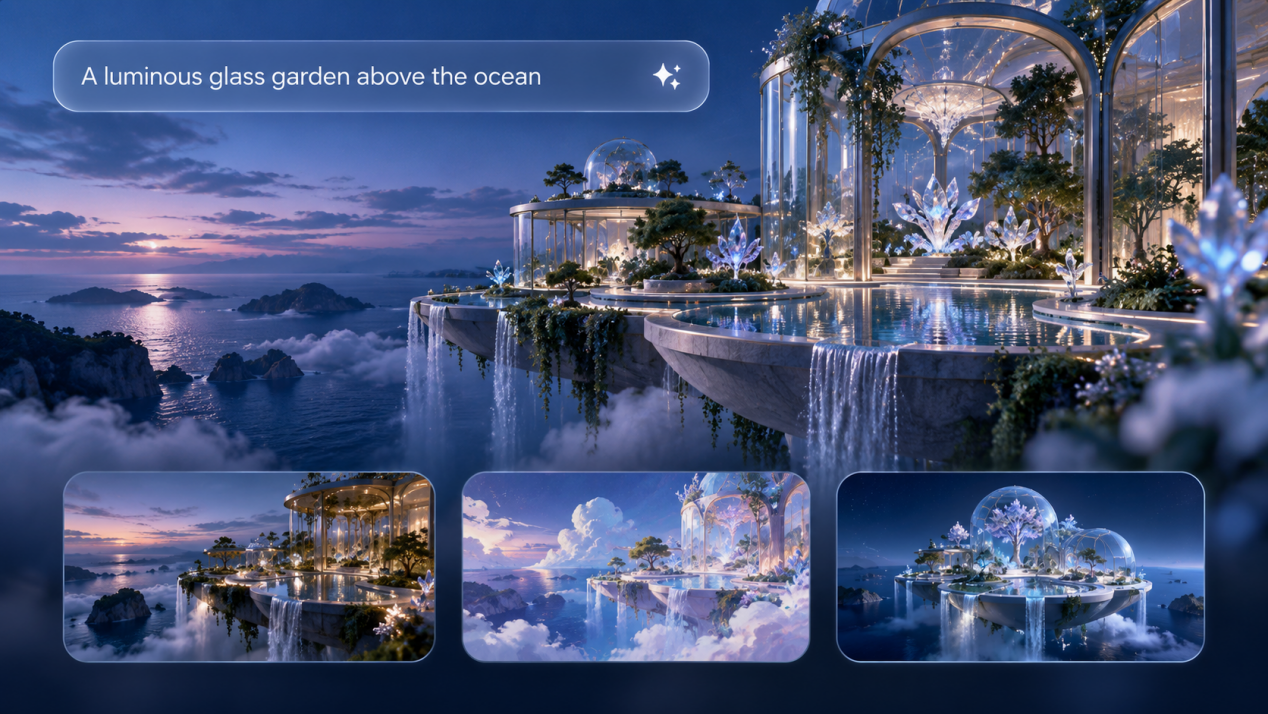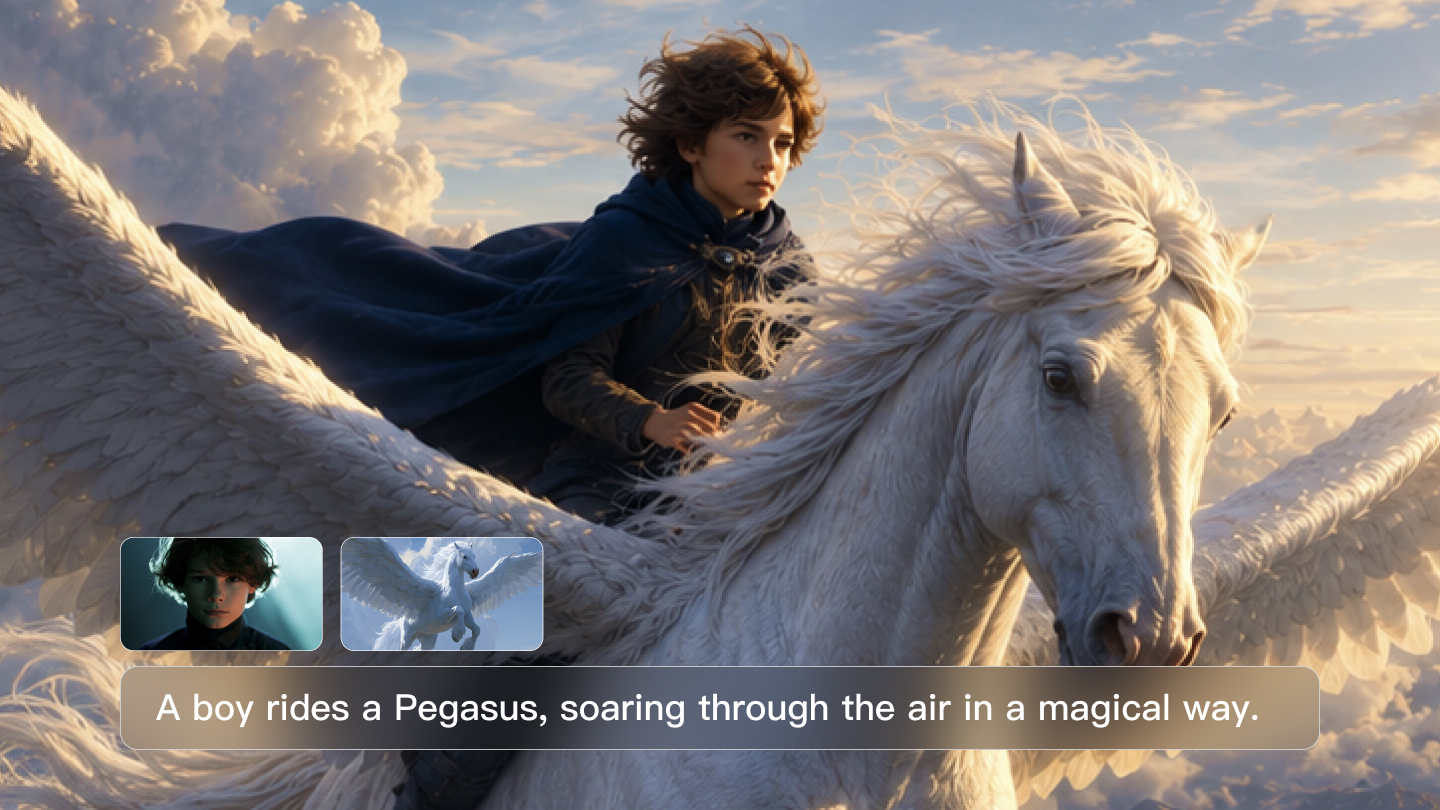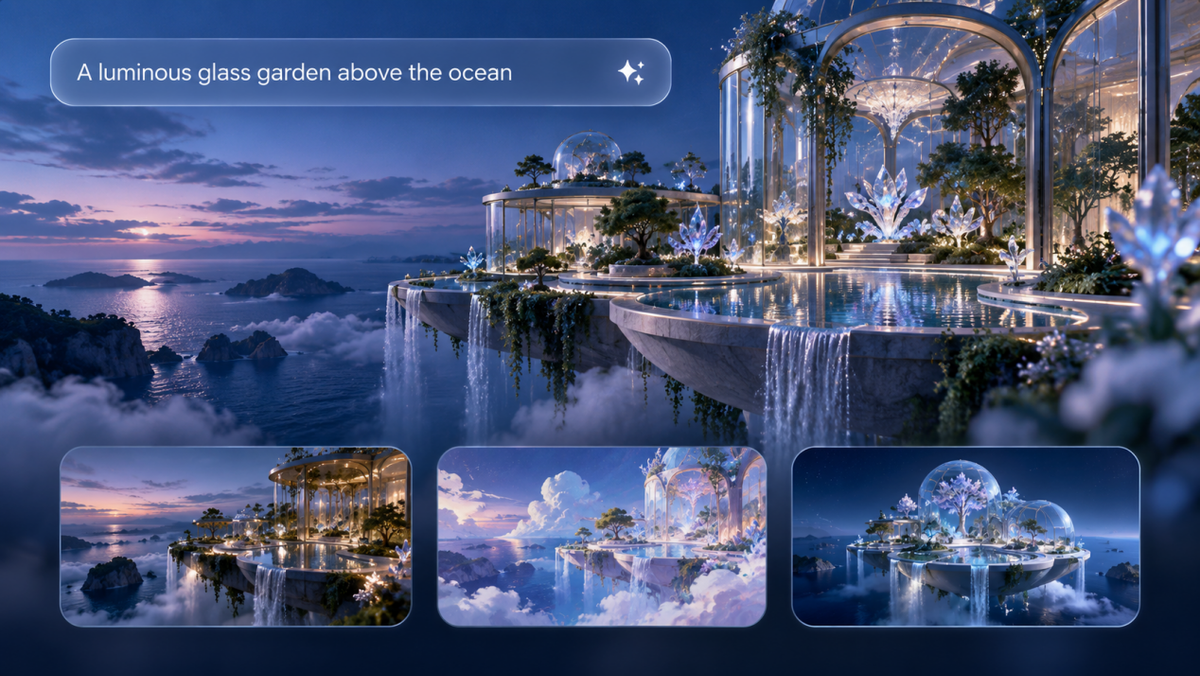
Sa isang ideya lamang o simpleng paglalarawan, kayang gawing mga biswal na konsepto ng mga modelong text-to-image ang natural na wika. Para sa mga creator, ang pinakamahusay na mga modelong text-to-image ay lampas sa simpleng pagbuo ng larawan. Kailangan nilang umunawa ng kumplikadong mga prompt, mapanatili ang pagkakapare-pareho ng biswal, at sumuporta sa patuloy na paghasa ng paglikha. Ipinapaliwanag ng gabay na ito kung paano gumagana ang mga modelong text-to-image, inihahambing ang mga kakayahang pinakamahalaga, at sinusuri kung paano pinagsasama ng Kling IMAGE 3.0 ang paglikha batay sa reference, eksaktong pag-edit, at nababagong mga workflow upang tulungan ang mga creator na buhayin ang kanilang mga ideyang biswal.
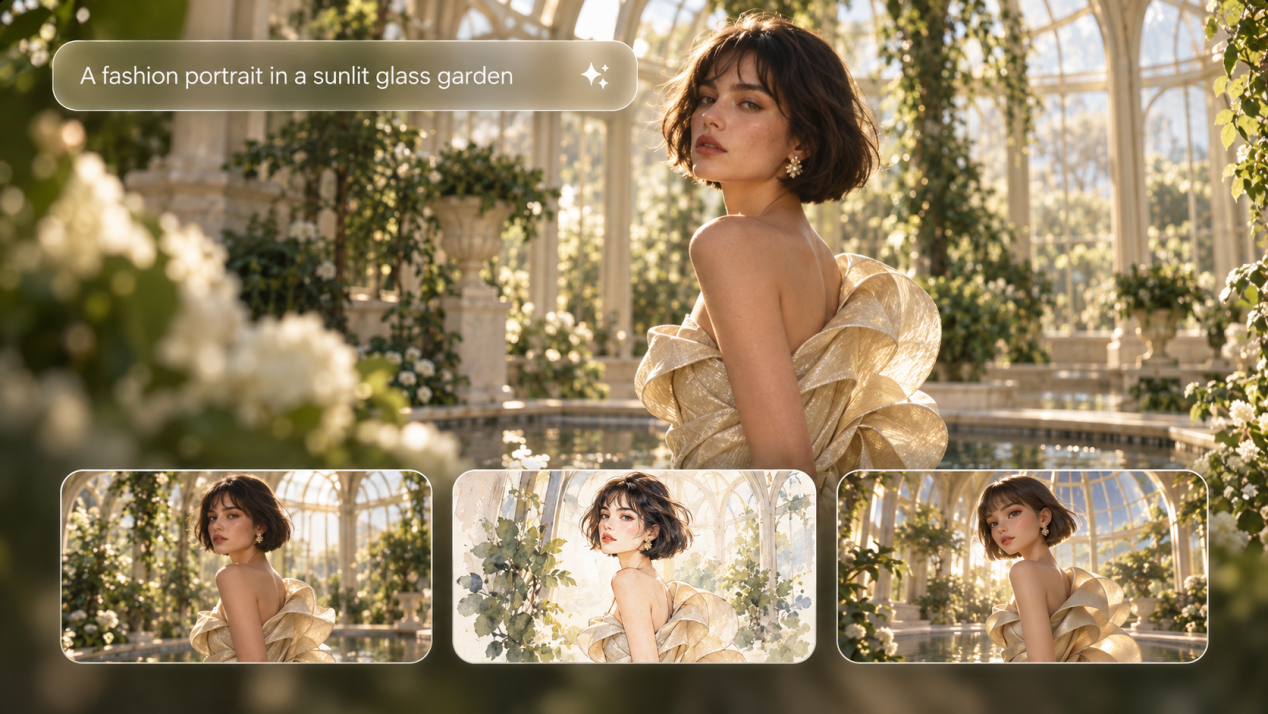
Ano ang Mga Modelong Text-to-Image?
Ang isang modelong text-to-image ay isang uri ng sistema ng artipisyal na intelihensiya na nagko-convert ng mga prompt sa natural na wika tungo sa mga digital na larawan batay sa mga detalyeng inilarawan sa prompt.
Karaniwang pinagsasama ng mga makabagong text-to-image system ang isang bahagi na nakauunawa o nag-e-encode ng prompt sa isang bahaging lumilikha ng larawan na ginagawang biswal na nilalaman ang mga tagubiling iyon. May ilang modelo ring kayang gumamit ng mga imahe at iba pang sangguniang biswal, na tumutulong sa kanilang sundan ang masalimuot na mga prompt, mapanatili ang mahahalagang detalye, at suportahan ang mas eksaktong pag-e-edit.
Halimbawa, isaalang-alang ang isang prompt:
| Prompt: Isang antigong kamera na nakalagay sa isang kahoy na mesa na may malambot na liwanag ng umaga na bumabagsak sa tanawin. |
Kailangang maunawaan ng modelo ang bagay, materyal, pagkakaayos sa espasyo, pag-iilaw, at kabuuang estilong biswal bago ito makalikha ng katugmang imahe.
Sa kasalukuyan, higit pa sa kalidad ng larawan ang saklaw ng pagsusuri sa mga text-to-image model. Lumipat na ang pokus tungo sa tumpak na pag-unawa sa prompt, paghawak sa masalimuot na mga eksena, pagpapanatili ng biswal na pagkakapare-pareho, at pagsuporta sa nababaluktot na pag-e-edit.
Paano Gumagana ang mga Text-to-Image na Modelo?
Ang mga modelong text-to-image ay nagsasalin ng mga nakasulat na paglalarawan tungo sa biswal na nilalaman sa pamamagitan ng pagkatuto kung paano nauugnay ang wika sa mga bagay, estilo, komposisyon, at iba pang detalye. Maraming makabagong sistema ang gumagamit ng mga pamamaraang nakabatay sa diffusion, kung saan ang prompt ang gumagabay sa sunud-sunod na prosesong unti-unting nagbabago ng biswal na ingay tungo sa isang tapos na larawan.
Maaaring maunawaan ang proseso sa tatlong yugto:
1.Pagkatuto kung paano nag-uugnay ang teksto sa mga larawan
Bago lumikha ng mga larawan, ang isang modelong text-to-image ay natututo mula sa malalaking dataset na naglalaman ng mga larawan na may kasamang mga paglalarawan. Sa panahon ng pagsasanay, kinikilala nito ang mga pattern sa pagitan ng mga salita at biswal na detalye, kabilang ang mga bagay, kulay, hugis, estilo, at mga ugnayang pang-espasyo. Halimbawa, natututuhan ng modelo kung paano nauugnay ang mga konsepto tulad ng “vintage camera,” “wooden desk,” at “soft morning light” sa mga tiyak na katangiang biswal.
2.Pag-unawa sa prompt
Kapag naglalagay ka ng prompt, isinasalin ng sistema ang iyong teksto sa isang format na nauunawaan nito, kinukuha ang pangunahing kahulugan at konteksto. Bagama't nag-iiba-iba ang eksaktong teknolohiya depende sa modelo—at kadalasang itinatago ng mga komersyal na sistema ang buong arkitektura nito—magkakasamang gumagana ang mga sangkap para sa teksto at bisyon upang iugnay ang iyong mga salita sa panghuling biswal na output.
3.Pagbuo ng Imahe
Marami sa makabagong mga modelong text-to-image ang gumagamit ng mga pamamaraang diffusion, bagama't maaaring gumamit ang iba pang mga modelo ng autoregressive o iba pang paraan ng pagbuo. Sa mga sistemang nakabatay sa diffusion, nagsisimula ang proseso sa biswal na ingay at unti-unting inaalis ang ingay na iyon batay sa impormasyong ibinibigay ng prompt. Sa pamamagitan ng paulit-ulit na mga hakbang ng pag-alis ng ingay, nabubuo sa imahe ang mas malinaw na mga hugis, detalye, at estilo na tumutugma sa paglalarawan. May ilang sistema na isinasagawa ang prosesong ito sa isang compressed na latent space bago i-convert ang resulta sa panghuling imahe. Kapag nabuo na ang imahe, maaari pang gumawa ng karagdagang mga pagsasaayos upang pinuhin ang mga detalye o ihanda ito para sa pag-edit.
Ano ang Nagpapakaiba sa mga Text-to-Image na Modelo?
Ang mga text-to-image na modelo ay maaaring tumugon nang napakaiba-iba sa iisang prompt. Ang ilan doon ay nagmumula sa paraan ng pagbuo ng mga larawan, habang ang ilan naman ay nagmumula sa mga uri ng input na mababasa at magagamit ng modelo.
Arkitektura ng Pagbuo
Sa antas ng pagbuo, dalawang karaniwang pamamaraan ang diffusion at autoregressive generation.
Pamamaraan | Kung Paano Ito Gumagana | Mga Karaniwang Gamit |
Mga Modelong Diffusion | Magsimula sa ingay na biswal at dahan-dahang pinuhin ito tungo sa isang imahe na ginagabayan ng prompt. | Detalyadong pagbuo ng imahe, makatotohanang mga eksena, ilustrasyon, at gawaing hinihimok ng estilo. |
Mga Modelong Autoregressive | Bumuo ng isang imahe sa pamamagitan ng paghula sa mga visual token o elemento nang sunud-sunod. | Paglikha ng larawan na bumubuo ng visual na nilalaman nang sunod-sunod sa halip na pinapainam ang ingay. |
Ang mga diffusion model ay nananatiling aktibong larangan ng pananaliksik sa text-to-image. Ang survey noong 2023 na Text-to-image Diffusion Models in Generative AI: A Survey ay nagbibigay ng kapaki-pakinabang na pangkalahatang-ideya ng mga pamamaraang text-to-image na nakabatay sa diffusion, mga dataset, mga paraan ng pagsusuri, at mga kaugnay na aplikasyon.
Multimodal na mga Input
Inilalarawan ng terminong multimodal ang mga uri ng input na magagamit ng isang modelo sa halip na kung paano ito lumilikha ng isang larawan. Ang isang multimodal na modelong panglarawan ay maaaring tumanggap ng text, mga larawan, at mga visual na reperensiya para sa paglikha batay sa reperensiya, pag-edit, o pagpapanatili ng pagkakapare-pareho ng mga karakter at produkto sa isang serye. Sa ilalim, maaari pa rin itong gumamit ng diffusion, autoregressive generation, o ibang pamamaraan, kaya maaaring pumasok ang isang modelo sa higit pa sa isang kategorya.
Ano ang Pinakamahusay na mga Text-to-Image Model sa 2026?
Para sa gabay na ito, pumili kami ng pitong kasalukuyang modelo na kumakatawan sa iba't ibang paraan ng paggawa ng imahe, pag-edit, paglikha na nakabatay sa sanggunian, at biswal na produksyon. Ang pagkakasunod-sunod ay hindi isang pagraranggo.
Modelo | Uri ng Modelo | Pinakamainam Para sa | Mahahalagang Tampok |
Modelo ng pagbuo at pag-edit ng imahe na may mga multimodal na input | Paglikha na nakabatay sa sanggunian, mga visual ng produkto, mga karakter, at detalyadong pag-edit | Gumagawa mula sa teksto o mga imahe, pinagsasama ang mga tampok mula sa hanggang 10 sanggunian, at sumusuporta sa pagpapanatili ng paksa, eksaktong mga pag-edit, at kontrol sa istilo. Sinusuportahan ng IMAGE 3.0 ang pagbuo hanggang 2K, habang ang IMAGE 3.0 Omni ay nag-aalok ng hanggang 4K. | |
Leonardo Lucid Origin | Modelo ng pagbuo ng imahe | Ilustrasyon, concept art, mga mockup ng produkto, at pangkalahatang paglikha ng imahe | Sinasaklaw ang malawak na hanay ng mga estilo, sumusunod sa detalyadong mga prompt, gumagawa ng mga larawang Full HD, at sumusuporta sa nababasang pag-render ng teksto. |
Seedream 5.0 Pro | Modelo para sa pagbuo at pag-edit ng larawan | Imahe ng produkto, infographics, mga asset sa disenyo, at lokal na pag-edit | Gumagana mula sa teksto o mga larawan, tumatanggap ng mga sanggunian, sumusuporta sa rehiyonal na pag-edit, at humahawak ng multilingual na input at pagbuo. |
Adobe Firefly Image 5 | Modelo ng pagbuo at pag-edit ng larawan | Produksiyon ng disenyo, mga asset sa marketing, at mga proyektong nakabatay sa Adobe | Lumilikha mula sa teksto, gumagamit ng mga larawang sanggunian, at nagbibigay-daan sa mga nakatutok na pag-edit sa Photoshop habang iniiwang buo ang nakapaligid na nilalaman ng larawan. |
Krea 2 Large | Modelo ng pagbuo ng larawan | Photorealismo, gawaing pinangungunahan ng estilo, at direksiyong biswal | Na-optimize para sa ekspresibong photorealismo, na may paglikha batay sa prompt at kontrol na ginagabayan ng reference sa komposisyon, paksa, at estilo. |
Luma UNI-1.1 | Pinag-isang multimodal na modelo ng imahe | Pagbuo na pinangungunahan ng reference at pagbabago ng imahe | Pinag-uugnay ang pagbuo ng imahe sa pag-edit gamit ang natural na wika at tumatanggap ng hanggang siyam na reference input sa isang kahilingan. |
Runway Gen-4 Image | Modelo ng pagbuo ng imahe sa loob ng isang plataporma ng imahe at video | Pagpapaunlad ng karakter, disenyo ng eksena, at mga proyektong kalaunan ay lumilipat sa video | Bumubuo mula sa teksto at mga sangguniang imahe, gumagamit ng hanggang tatlong sanggunian bawat pagbuo, at kayang magdala ng mga karakter, bagay, o mga biswal na katangian sa mga bagong eksena. |
Ikinukumpara ng susunod na seksyon ang mga modelong ito sa pagsunod sa prompt, paghawak sa sanggunian, pag-edit, biswal na pagkakapare-pareho, at kontrol sa estilo.
Paano nagkukumpara ang mga modelo ng Text-to-Image sa 2026?
Pinaka-nagkakaiba ang mga modelo ng text-to-image sa katumpakan ng prompt, paggamit ng sanggunian, pag-edit, biswal na pagkakapare-pareho, at kontrol sa estilo. Mas madaling mapansin ang mga pagkakaibang ito sa mga proyektong may paulit-ulit na mga imahe, mga rebisyon, mga produkto, o umuulit na mga karakter.
Lugar ng Paghahambing | Ano ang Hahambingin | Bakit Ito Mahalaga |
Pagsunod sa Prompt | Mga paksa, katangian, ugnayan ng mga bagay, komposisyon, at mga kinakailangang detalye. | Kulang pa rin ang isang pinakintab na imahe kung hindi nito natutugunan ang brief. |
Pamamahala ng Sanggunian | Bilang ng mga sanggunian, pagpapanatili ng paksa, paglipat ng estilo, at paggabay sa komposisyon. | Tumutulong ang mga sanggunian na mapanatiling madaling makilala ang isang karakter, produkto, o visual na direksiyon sa iba't ibang larawan. |
Pag-edit ng Larawan | Mga lokal na pagbabago, pag-edit gamit ang natural na wika, at kung gaano kahusay nananatiling buo ang mga bahaging hindi nagalaw. | Ang eksaktong pag-edit ay nakakatipid ng oras at iniiwasan ang muling pagbuo ng larawan mula sa simula. |
Biswal na Konsistensya | Mga tauhan, produkto, kasuotan, estilo, at umuulit na detalye sa iba’t ibang larawan o rebisyon. | Mahalaga ang matatag na mga detalye para sa serye ng larawan, mga kampanya, mga storyboard, at mga set ng produkto. |
Kontrol sa Estilo | Pag-iilaw, paleta, tekstura, hitsurang potograpiko, istilo ng ilustrasyon, at biswal na direksyon. | Ang malinaw na kontrol sa estilo ay tumutulong na manatiling konektado nang biswal ang magkakaugnay na mga larawan. |
Pagkakatugma ng Daloy ng Trabaho | Mga rebisyon, mga opsyon sa pag-export, paggamit ng image-to-video, at pagiging tugma sa iba pang malikhaing kasangkapan. | Ang nangyayari pagkatapos ng pagbuo ay maaaring kasinghalaga ng unang imahe. |
Ang modelong mahusay para sa mabilisang mga larawan ng konsepto ay maaaring hindi akma para sa serye ng produkto o proyektong karakter. Maaaring sapat na ang katumpakan ng prompt at istilo para sa isang larawan, samantalang ang paulit-ulit na trabaho ay madalas mangailangan ng mas matitibay na sanggunian, pag-edit, at pagkakapare-pareho.
Paano Pumili ng Pinakamahusay na Text-to-Image na Modelo?
Kapag pumipili ng isang AI na generator ng larawan, magsimula sa kung ano ang nais mong likhain at kung aling mga detalye ang kailangang manatiling hindi nagbabago habang binabago mo ang imahe. Ipinapakita ng talahanayan sa ibaba kung ano ang dapat hanapin sa ilang karaniwang sitwasyon.
Kung Kailangan Mo | Hanapin | Bakit Mahalaga Ito |
Mabilis na mga larawan ng konsepto | Katumpakan ng prompt, kalidad ng imahe, at saklaw ng estilo | Mas makakalapit ka sa inaasahang resulta gamit ang mas kaunting mga rebisyon. |
Mga pare-parehong karakter o produkto | Pagharap sa mga sanggunian at pagpapanatili ng detalye | Ang mga mukha, kasuotan, produkto, at iba pang tumutukoy na tampok ay kailangang manatiling nakikilala sa bawat larawan. |
Madalas na rebisyon sa mga larawan | Lokal na pag-edit at mga pagbabago sa natural na wika | Maaari mong ayusin ang isang bahagi ng larawan nang hindi muling binubuo ang buong eksena. |
Mga asset ng kampanya o serye ng imahe | Matatag na mga paksa, estilo, at komposisyon | Kailangang magbahagi ng parehong visual na direksyon ang mga magkakaugnay na imahe. |
Mga imahe na kalaunan ay lilipat sa video | Mga sangguniang imahe at mga opsyon sa imahe tungo sa video | Mas madaling dalhin sa galaw ang matatag na mga paksa at detalyeng biswal. |
Bakit Sulit Isaalang-alang ang Kling IMAGE 3.0?
Pinapayagan ka ng Kling IMAGE 3.0 na simulan ang mga likha gamit ang isang text prompt o mga larawang sanggunian, saka pinuhin ang bawat detalye gamit ang natural na wika. Higit pa sa karaniwang pagbuo, binibigyan ka nito ng malalim na kontrol sa pagkakapare-pareho ng karakter, eksaktong mga pag-edit, at pag-aangkop ng istilo, na nagbubukas ng walang katapusang malikhaing posibilidad.
Gawing Sariwang Biswal ang Masalimuot na mga Ideya
Hinahayaan ka ng IMAGE 3.0 na paghaluin ang mga visual cue mula sa maraming sanggunian at gumamit ng pang-araw-araw na wika para lampasan ang karaniwang mga pag-edit. Pagsamahin ang mga paksa sa iba’t ibang larawan, baligtarin ang pananaw ng isang eksena, o ilipat ang isang konsepto sa panibagong istilo—lahat habang nananatiling maayos at magkakaugnay ang huling resulta.
Larawan ng Sanggunian 1 | Larawan ng Sanggunian 2 | Larawan ng Output |
Prompt: Pagsamahin ang mga hayop mula sa larawan 1 at larawan 2. | ||
Panatilihing Nakikilala ang mga Tauhan, mga Produkto, at Mahahalagang Detalye
You can use up to 10 reference images in one generation. Different references can define a character, clothing, product, setting, or style while your prompt explains how those elements should come together. For portrait touch-ups, face references can help preserve recognizable facial features while you change the hairstyle, outfit, pose, or setting. If you just want to swap a face into an existing shot, you can also jump straight into Kling's face swap workflows.
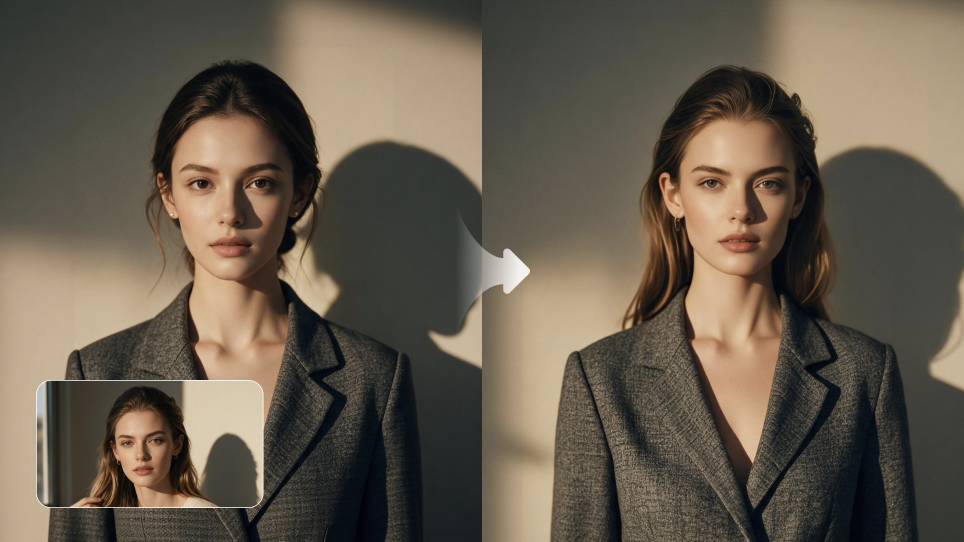
Baguhin lamang ang kailangang baguhin
Kung maayos na ang karamihan ng isang larawan, maaari mong gamitin ang Kling IMAGE 3.0 bilang isang AI photo editor upang ayusin ang mga partikular na detalye nang hindi muling binubuo ang buong eksena. Maaaring baguhin ng mga tagubiling nasa natural na wika ang laki, kulay, materyal, ekspresyon, o likuran ng isang bagay habang pinananatili ang nakapaligid na bahagi ng larawan. Magagamit mo rin ang Kling AI bilang isang watermark remover para sa mga larawang pag-aari mo o may pahintulot kang baguhin. Kasama sa iba pang mga pag-edit ang paglalagay ng kulay sa larawan, mga vintage effect, mga doodle edit, mga pagbabago sa ilaw at tono, at pagpapanumbalik ng larawan.
Panatilihin ang Pare-parehong Estilo at Tono sa mga Larawan Kung malinaw na ang direksiyong biswal mo, maaari kang gumamit ng umiiral na larawan bilang sanggunian ng estilo. Maaaring ilipat ng Kling IMAGE 3.0 ang mga elementong gaya ng mga galaw ng brush, kulay, komposisyon, at tono sa mga bagong larawan. Epektibo ito para sa mga set ng ilustrasyon, mga visual ng produkto, o branded na nilalaman kung saan kailangang lumitaw ang parehong hitsura sa higit sa isang larawan.
Larawang Sanggunian 1 | Larawang Sanggunian 2 | Larawang Kinalabasan |
Prompt: Baguhin ang istilo ng Imahe 1 sa istilo ng Imahe 2 | ||
Wakas
Magkakaiba ang mga text-to-image model sa kung saan sila pinakamahusay, kaya nakadepende ang tamang pagpili sa kung ano ang kailangan mo pagkatapos malikha ang unang imahe. Kung mabilis na konsepto lang ang kailangan mo, maaaring sapat na ang katumpakan ng prompt at kalidad ng imahe. Para sa mga biswal ng produkto, paulit-ulit na karakter, o serye ng imahe, mas mahalaga ang mga reference, pag-edit, at pagkakapare-pareho. Kung nais mong magsimula mula sa teksto o umiiral na biswal, binibigyang-daan ka ng Kling IMAGE 3.0 na pagsamahin ang mga reference, baguhin ang tiyak na detalye, at dalhin ang iisang hitsura sa mga bagong imahe. Kung nagtatayo ka ng kampanya ng produkto, umuulit na karakter, o ginagawang tapos na set ng biswal ang maagang konsepto, ang tamang modelo ay dapat gawing mas madali ang pagpapanatili ng mga detalyeng pinahahalagahan mo habang lumalaki ang proyekto.
Mga FAQ
Aling modelo ng wika ng AI ang ginagamit para sa paglikha ng text-to-image?
Walang iisang modelo ng wika na ginagamit ng bawat text-to-image system. Kung itatanong mo kung aling AI na modelo ng wika ang ginagamit para sa mga kakayahan sa paglikha ng text-to-image, nag-iiba ang sagot depende sa modelo. Gumagamit ang ilang sistema ng mga text encoder tulad ng CLIP o T5, samantalang ang iba ay gumagamit ng mga komponenteng pangwika o vision-language upang basahin ang prompt bago likhain ang imahe.
Aling AI ang Kayang Gawing Imahe ang Teksto?
Maraming modelo ng AI para sa imahe ang kayang gawing tapos na imahe ang isang nakasulat na prompt, kabilang ang Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1, at Runway Gen-4 Image. Bawat isa ay kakaiba ang paraan ng paghawak sa mga prompt, mga reference, pag-edit, at visual consistency, kaya nakadepende ang tamang modelo sa uri ng imaheng kailangan mong likhain.
Makakagamit ba ang mga text-to-image model ng mga reference na imahe?
Oo. Maraming text-to-image model ang maaaring gumamit ng mga larawang sanggunian kasabay ng written prompts, na ginagawa ang image-to-image AI na kapaki-pakinabang kapag nais mong magtrabaho mula sa umiiral na biswal sa halip na magsimula mula sa simula. Maaaring itakda ng sanggunian ang mga detalye gaya ng tauhan, produkto, pose, komposisyon, mga kulay, o istilo, habang sinasabi ng prompt sa modelo kung ano ang babaguhin. Kayang gumamit ng hanggang 10 larawang sanggunian ang Kling IMAGE 3.0 sa isang generation, na nakatutulong kapag kailangang manatiling madaling makilala ang parehong tauhan, produkto, o visual style.
Paano Ko Tatanggalin ang Background Mula sa Isang Larawan?
Kung kailangan mo ng mas malinis na larawan ng produkto, larawan sa profile, o asset sa disenyo, maaari mong alisin ang background mula sa isang larawan at panatilihing nakahiwalay ang pangunahing paksa. Ang isang transparent na background ay mahusay para sa mga listahan ng produkto, presentasyon, mga post sa social media, o mga layout kung saan kailangang ilagay ang paksa sa ibang backdrop. Pagkatapos ng pag-alis, suriin ang maliliit na gilid sa paligid ng buhok, damit, balahibo, o maliliit na bagay, pagkatapos ay panatilihing transparent ang background, magpalit sa solidong kulay, o ilagay ang paksa sa bagong eksena.