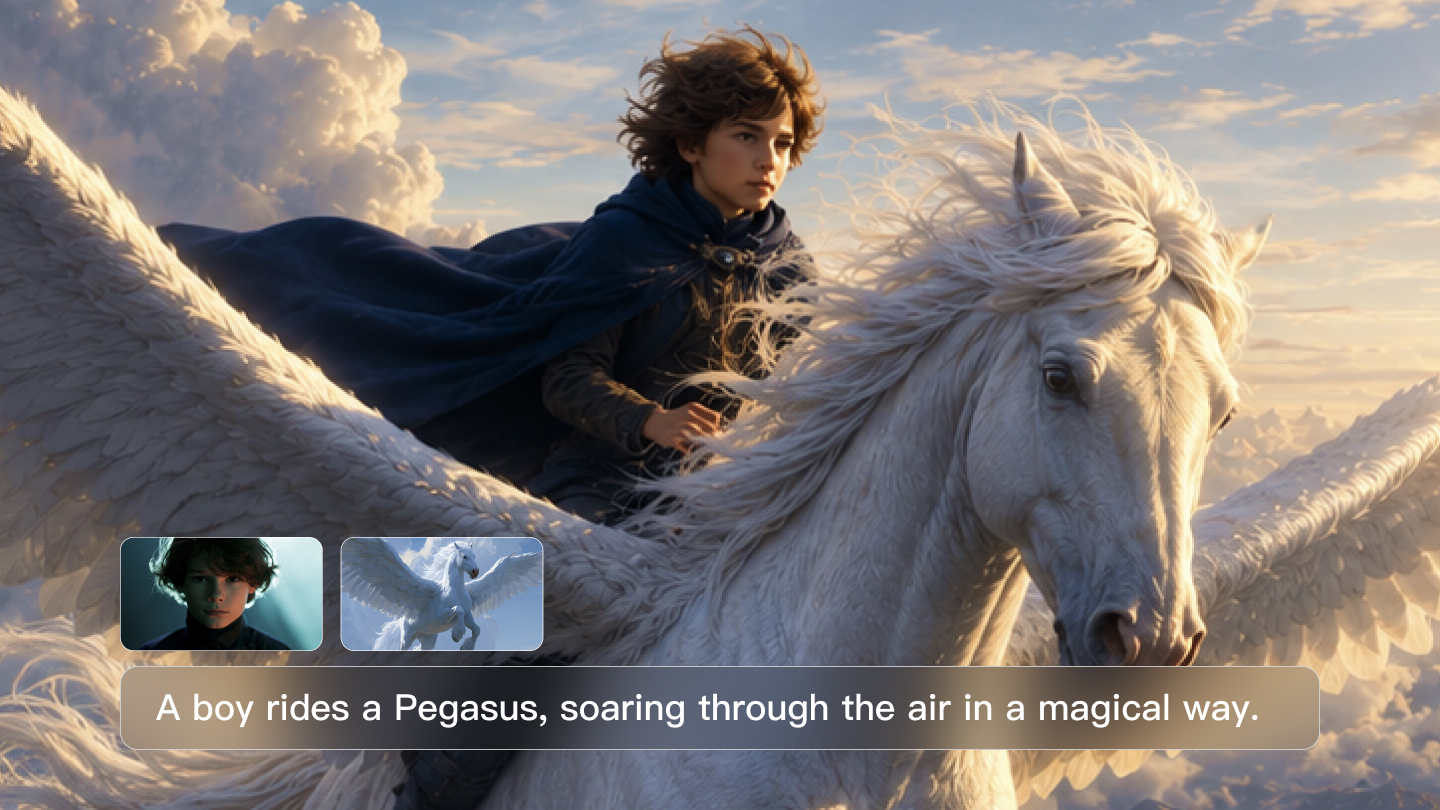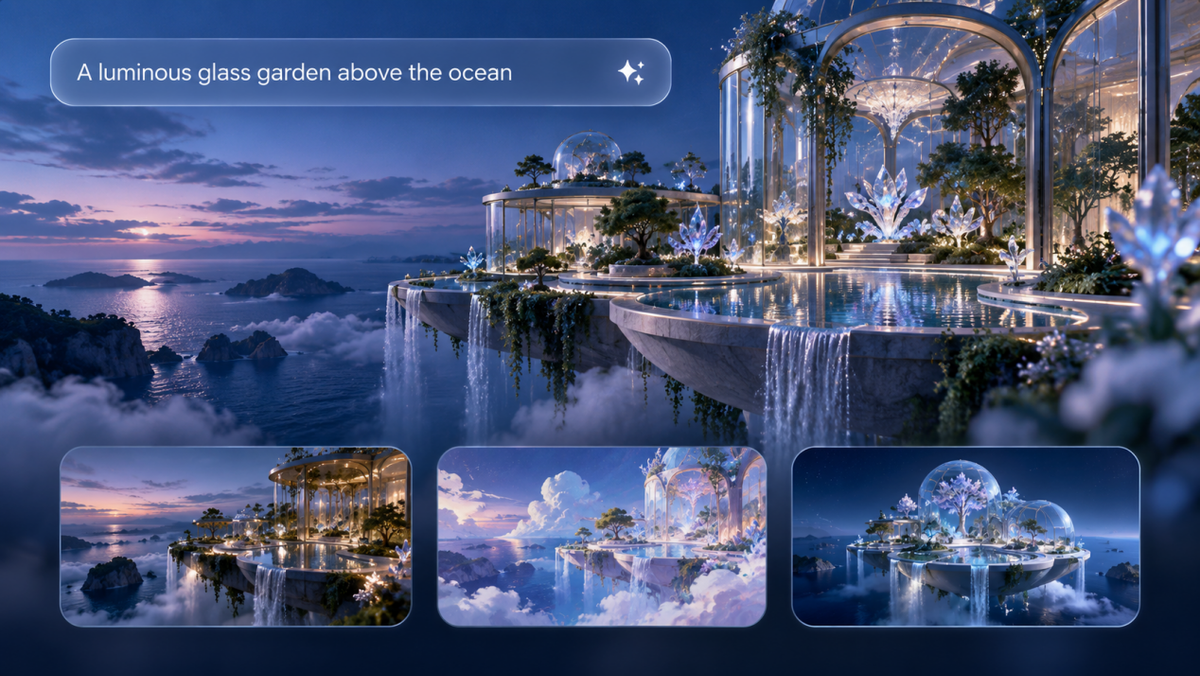
Hanya dengan idea atau deskripsi ringkas, model teks-ke-imej boleh menukar bahasa semula jadi menjadi konsep visual. Bagi pencipta, model teks-ke-imej terbaik melangkaui penjanaan imej. Model ini perlu memahami arahan yang kompleks, mengekalkan konsistensi visual, dan menyokong penambahbaikan kreatif dari semasa ke semasa. Panduan ini menerangkan cara model teks-ke-imej berfungsi, membandingkan keupayaan yang paling penting, dan meneroka bagaimana Kling IMAGE 3.0 menggabungkan penciptaan berasaskan rujukan, penyuntingan yang tepat, serta aliran kerja yang fleksibel untuk membantu pencipta merealisasikan idea visual mereka.
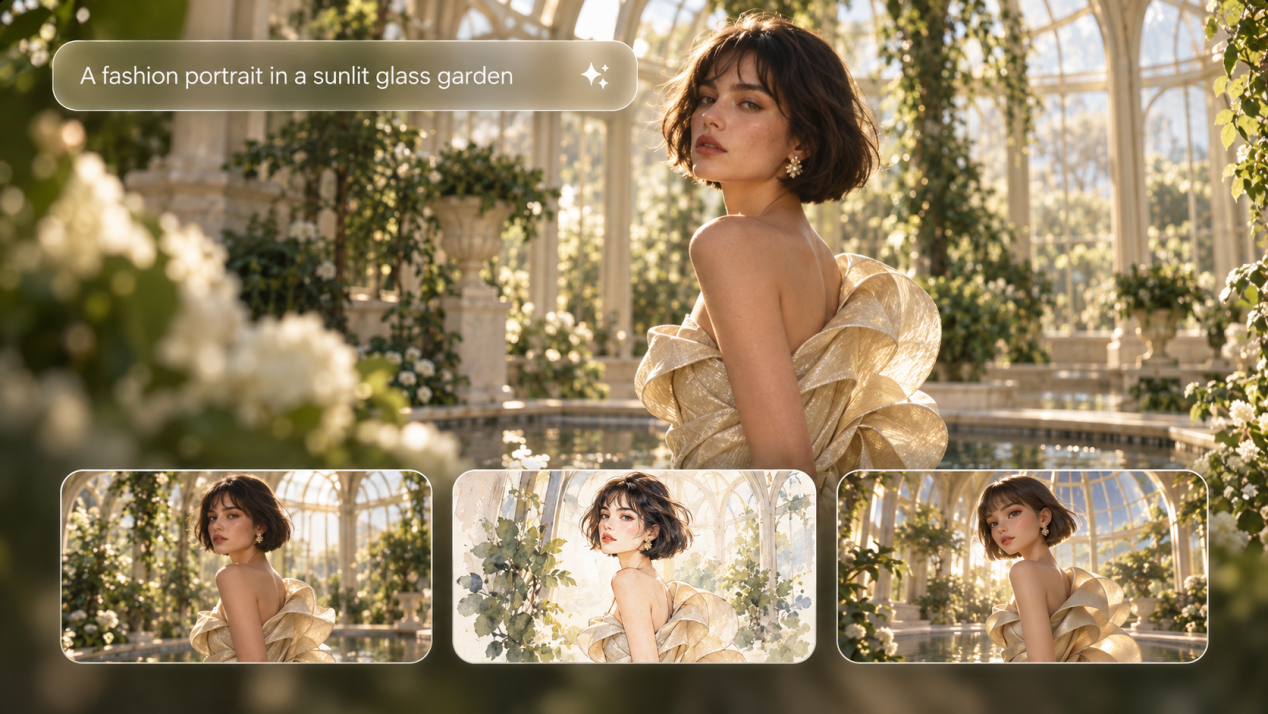
Apakah Model Teks-ke-Imej?
Satu model teks-ke-imej ialah sejenis sistem kecerdasan buatan yang menukar prompt bahasa semula jadi menjadi imej digital berdasarkan perincian yang diterangkan dalam prompt tersebut.
Sistem teks-ke-imej moden biasanya menggabungkan komponen yang memahami atau mengekod prompt dengan komponen penjanaan imej yang menukarkan arahan tersebut menjadi kandungan visual. Sesetengah model juga boleh berfungsi dengan imej dan rujukan visual lain, membantu mereka mengikuti prompt yang kompleks, mengekalkan butiran penting, dan menyokong penyuntingan yang lebih tepat.
Sebagai contoh, pertimbangkan satu prompt:
| Prompt: Sebuah kamera vintaj diletakkan di atas meja kayu dengan cahaya pagi yang lembut menyinari keseluruhan adegan. |
Model tersebut perlu memahami objek, bahan, susun atur ruang, pencahayaan, dan gaya visual keseluruhan sebelum menghasilkan imej yang sepadan.
Hari ini, menilai model teks-ke-imej melibatkan lebih daripada kualiti imej. Fokus telah beralih kepada pemahaman prompt yang tepat, mengendalikan adegan yang kompleks, mengekalkan konsistensi visual, dan menyokong penyuntingan yang fleksibel.
Bagaimanakah Model Teks-ke-Imej Berfungsi?
Model teks-ke-imej menterjemahkan penerangan bertulis menjadi kandungan visual dengan mempelajari bagaimana bahasa berkaitan dengan objek, gaya, komposisi, dan butiran lain. Banyak sistem moden menggunakan kaedah berasaskan difusi, dengan prompt membimbing proses langkah demi langkah yang secara beransur-ansur mengubah hingar visual menjadi imej siap.
Proses ini boleh difahami dalam tiga peringkat:
1.Mempelajari Bagaimana Teks Berhubung Dengan Imej
Sebelum menjana imej, model teks-ke-imej belajar daripada set data besar yang mengandungi imej yang dipadankan dengan penerangan. Semasa latihan, ia mengenal pasti corak antara perkataan dan butiran visual, termasuk objek, warna, bentuk, gaya, dan hubungan ruang. Sebagai contoh, model tersebut mempelajari bagaimana konsep seperti "kamera vintaj," "meja kayu," dan "cahaya pagi lembut" dikaitkan dengan ciri visual tertentu.
2.Memahami Prompt
Apabila anda memasukkan prompt, sistem menterjemahkan teks anda ke dalam format yang boleh difahaminya, menangkap makna teras dan konteks. Walaupun teknologi tepat berbeza mengikut model—dan sistem komersial selalunya merahsiakan keseluruhan seni bina mereka—komponen teks dan visi ini bekerjasama untuk menjambatkan kata-kata anda dengan output visual akhir.
3.Menjana Imej
Banyak model teks-ke-imej moden menggunakan kaedah difusi, walaupun model lain mungkin menggunakan pendekatan penjanaan autoregresif atau yang berbeza. Dalam sistem berasaskan difusi, proses bermula dengan hingar visual dan secara beransur-ansur menghapuskan hingar itu berdasarkan maklumat yang diberikan oleh prompt. Melalui langkah penyahhingaran berulang, imej membangunkan bentuk, perincian dan gaya yang lebih jelas yang sepadan dengan huraian. Sesetengah sistem menjalankan proses ini dalam ruang terpendam termampat sebelum menukar hasilnya kepada imej akhir. Selepas imej terbentuk, pelarasan lanjut boleh dibuat untuk memperhalusi butiran atau mempersiapkannya untuk penyuntingan.
Apakah yang Menjadikan Model Teks-ke-Imej Berbeza?
Model teks-ke-imej boleh bertindak balas dengan sangat berbeza terhadap gesaan yang sama. Sebahagian daripadanya berpunca daripada cara imej dijana, manakala sebahagian lagi daripada jenis input yang boleh dibaca dan digunakan oleh model.
Seni Bina Penjanaan
Pada peringkat penjanaan, dua pendekatan biasa ialah difusi dan penjanaan autoregresif.
Pendekatan | Cara Ia Berfungsi | Kegunaan Biasa |
Model Difusi | Mulakan dengan hingar visual dan haluskan secara beransur-ansur menjadi imej yang dipandu oleh arahan. | Penjanaan imej terperinci, adegan realistik, ilustrasi, dan kerja dipacu gaya. |
Model Autoregresif | Bina imej dengan meramal token atau elemen visual secara berurutan. | Penjanaan imej yang membina kandungan visual secara berurutan dan bukannya memperhalusi hingar. |
Model resapan kekal sebagai bidang aktif dalam penyelidikan teks-ke-imej. Tinjauan 2023 Text-to-image Diffusion Models in Generative AI: A Survey menyediakan gambaran berguna tentang kaedah teks-ke-imej berasaskan resapan, set data, pendekatan penilaian dan aplikasi berkaitan.
Input Multimodal
Multimodal menerangkan jenis input yang boleh digunakan oleh model, bukannya cara ia menjana imej. Model imej multimodal mungkin menerima teks, imej dan rujukan visual untuk penciptaan berasaskan rujukan, penyuntingan, atau mengekalkan watak serta produk yang konsisten merentasi satu siri. Pada asasnya, ia masih boleh menggunakan resapan, penjanaan autoregresif, atau kaedah lain, jadi satu model boleh termasuk dalam lebih daripada satu kategori.
Apakah Model Teks-ke-Imej Terbaik pada tahun 2026?
Untuk panduan ini, kami memilih tujuh model semasa yang mewakili pendekatan berbeza untuk penjanaan imej, penyuntingan, penciptaan berasaskan rujukan dan pengeluaran visual. Susunan ini bukan penarafan.
Model | Jenis model | Terbaik untuk | Ciri utama |
Model penjanaan dan penyuntingan imej dengan input multimodal | Penciptaan berasaskan rujukan, visual produk, watak, dan suntingan terperinci | Menjana daripada teks atau imej, menggabungkan ciri daripada sehingga 10 rujukan, dan menyokong pengekalan subjek, suntingan tepat, serta kawalan gaya. IMAGE 3.0 menyokong penjanaan sehingga 2K, manakala IMAGE 3.0 Omni menawarkan sehingga 4K. | |
Leonardo Lucid Origin | Model penjanaan imej | Ilustrasi, seni konsep, mockup produk, dan penciptaan imej umum | Meliputi pelbagai gaya, mengikuti arahan terperinci, menghasilkan imej Full HD, dan menyokong rendering teks yang jelas. |
Seedream 5.0 Pro | Model penjanaan dan penyuntingan imej | Imej produk, infografik, aset reka bentuk, dan suntingan setempat | Berfungsi daripada teks atau imej, menerima rujukan, menyokong penyuntingan serantau, dan mengendalikan input serta penjanaan berbilang bahasa. |
Adobe Firefly Image 5 | Model penjanaan dan pengeditan imej | Pengeluaran reka bentuk, aset pemasaran, dan projek berasaskan Adobe | Menjana daripada teks, berfungsi dengan imej rujukan, dan membolehkan suntingan yang disasarkan dalam Photoshop sambil meninggalkan kandungan imej sekeliling kekal utuh |
Krea 2 Large | Model penjanaan imej | Fotorealisme, kerja berteraskan gaya, dan arahan visual | Dioptimumkan untuk fotorealisme ekspresif, dengan penciptaan berasaskan prompt dan kawalan berpandukan rujukan ke atas komposisi, subjek dan gaya. |
Luma UNI-1.1 | Model imej multimodal bersatu | Generasi dipandu rujukan dan semakan imej | Menggabungkan penjanaan imej dengan penyuntingan bahasa semula jadi dan menerima sehingga sembilan input rujukan dalam satu permintaan. |
Runway Gen-4 Image | Model penjanaan imej dalam platform imej dan video | Pembangunan watak, reka bentuk adegan, dan projek yang kemudian beralih ke video | Menjana daripada teks dan imej rujukan, menggunakan sehingga tiga rujukan setiap penjanaan, dan boleh membawa watak, objek, atau sifat visual ke dalam adegan baharu. |
Bahagian seterusnya membandingkan model-model ini dalam pematuhan prompt, pengendalian rujukan, penyuntingan, konsistensi visual, dan kawalan gaya.
Bagaimana Model Teks-ke-Imej Berbanding pada tahun 2026?
Model teks-ke-imej paling ketara berbeza dari segi ketepatan prompt, penggunaan rujukan, penyuntingan, konsistensi, dan kawalan gaya. Perbezaan ini lebih mudah diperhatikan dalam projek yang melibatkan imej berulang, semakan, produk, atau watak berulang.
Kawasan Perbandingan | Apa yang Hendak Dibandingkan | Mengapa Ia Penting |
Pematuhan Prompt | Subjek, atribut, hubungan objek, komposisi, dan butiran yang diperlukan. | Imej yang digilap tetap tidak memadai jika gagal memenuhi arahan. |
Pengendalian Rujukan | Bilangan rujukan, pengekalan subjek, pemindahan gaya, dan panduan komposisi. | Rujukan membantu mengekalkan watak, produk, atau hala tuju visual agar dapat dikenali merentasi imej. |
Penyuntingan Imej | Perubahan setempat, suntingan bahasa semula jadi, dan sejauh mana kawasan yang tidak disentuh kekal utuh. | Suntingan yang tepat menjimatkan masa dan mengelakkan pembinaan semula imej dari awal. |
Konsistensi Visual | Watak, produk, pakaian, gaya, dan butiran berulang merentasi imej atau semakan. | Butiran yang stabil penting untuk siri imej, kempen, papan cerita, dan set produk. |
Kawalan Gaya | Pencahayaan, palet, tekstur, rupa fotografi, gaya ilustrasi, dan arahan visual. | Kawalan gaya yang jelas membantu memastikan imej berkaitan kekal bersambung secara visual. |
Kesesuaian Aliran Kerja | Semakan, pilihan eksport, penggunaan imej ke video, dan keserasian dengan alat kreatif lain. | Apa yang berlaku selepas penjanaan boleh sama pentingnya dengan imej pertama. |
Model yang berfungsi dengan baik untuk imej konsep pantas mungkin tidak sesuai untuk siri produk atau projek watak. Ketepatan dan gaya arahan mungkin mencukupi untuk satu imej, manakala kerja berulang selalunya memerlukan rujukan yang lebih kukuh, penyuntingan, dan konsistensi.
Bagaimana Memilih Model Teks-ke-Imej Terbaik?
Apabila memilih penjana imej AI, mulakan dengan apa yang anda ingin hasilkan dan perincian mana yang perlu kekal tidak berubah semasa anda menyemak semula imej tersebut. Jadual di bawah menunjukkan perkara yang perlu diperhatikan dalam beberapa senario biasa.
Jika Anda Memerlukan | Cari | Mengapa Ia Penting |
Imej konsep pantas | Ketepatan prompt, kualiti imej, dan julat gaya | Anda boleh mendekati hasil yang dimaksudkan dengan lebih sedikit semakan. |
Watak atau produk yang konsisten | Pengendalian rujukan dan pengekalan butiran | Wajah, pakaian, produk, dan ciri penentu lain perlu kekal mudah dikenali merentas imej. |
Semakan imej yang kerap | Penyuntingan setempat dan perubahan bahasa semula jadi | Anda boleh melaraskan satu bahagian imej tanpa membina semula keseluruhan adegan. |
Aset kempen atau siri imej | Subjek, gaya, dan komposisi yang stabil | Imej berkaitan perlu berkongsi arah visual yang sama. |
Imej yang kemudian beralih ke video | Imej rujukan dan pilihan imej-ke-video | Subjek dan butiran visual yang stabil lebih mudah dibawa ke dalam pergerakan. |
Mengapa Kling IMAGE 3.0 Wajar Dipertimbangkan?
Kling IMAGE 3.0 membolehkan anda memulakan ciptaan dengan prompt teks atau imej rujukan, kemudian menala halus setiap butiran menggunakan bahasa semula jadi. Melangkaui penjanaan standard, ia memberikan anda kawalan mendalam terhadap konsistensi watak, suntingan yang tepat, dan penalaan gaya, membuka kemungkinan kreatif yang tidak berkesudahan.
Tukarkan Idea Kompleks Menjadi Visual Baharu
IMAGE 3.0 membolehkan anda menggabungkan petunjuk visual daripada pelbagai rujukan dan menggunakan bahasa seharian untuk melampaui suntingan standard. Gabungkan subjek merentas imej, terbalikkan perspektif sesuatu adegan, atau ubah konsep ke dalam gaya yang serba baharu—semuanya sambil mengekalkan hasil akhir yang lancar dan kohesif.
Imej Rujukan 1 | Imej Rujukan 2 | Imej Output |
Arahan: Gabungkan haiwan daripada imej 1 dan imej 2. | ||
Pastikan watak, produk, dan butiran utama dapat dikenal pasti
Anda boleh menggunakan sehingga 10 imej rujukan dalam satu penjanaan. Rujukan yang berbeza boleh mentakrifkan seorang watak, pakaian, produk, tetapan atau gaya sementara arahan anda menerangkan bagaimana unsur-unsur tersebut patut digabungkan. Untuk pengemasan potret, rujukan wajah boleh membantu mengekalkan ciri wajah yang dikenali sambil anda menukar gaya rambut, pakaian, pose atau latar. Jika anda hanya mahu menggantikan wajah dalam rakaman sedia ada, anda juga boleh terus masuk ke aliran kerja face swap Kling.
Tukar Hanya Apa yang Perlu Ditukar
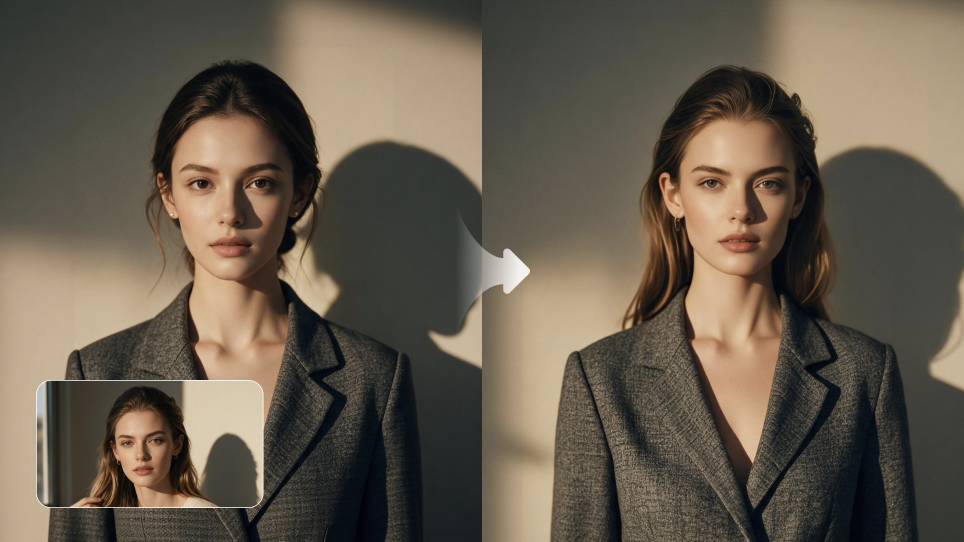
Jika kebanyakan bahagian imej sudah kelihatan betul, anda boleh menggunakan Kling IMAGE 3.0 sebagai penyunting foto AI untuk melaras butiran tertentu tanpa membina semula keseluruhan adegan. Arahan bahasa semula jadi boleh mengubah saiz, warna, bahan, ekspresi atau latar belakang sesuatu objek sambil berusaha mengekalkan bahagian imej di sekelilingnya. Anda juga boleh menggunakan Kling AI sebagai penanggal tera air untuk imej yang anda miliki atau mempunyai kebenaran untuk sunting. Penyuntingan lain termasuk pewarnaan foto, kesan vintaj, suntingan doodle, perubahan pencahayaan dan tona, serta pemulihan imej.
Kekalkan Gaya dan Nada Konsisten Merentasi Imej Jika anda sudah mempunyai hala tuju visual yang jelas, anda boleh menggunakan imej sedia ada sebagai rujukan gaya. Kling IMAGE 3.0 boleh membawa elemen seperti sapuan berus, warna, komposisi dan nada ke dalam imej baharu. Ini berkesan untuk set ilustrasi, visual produk atau kandungan berjenama di mana rupa yang sama perlu muncul merentasi lebih daripada satu imej.
Imej Rujukan 1 | Imej Rujukan 2 | Imej Keluaran |
Prompt: Tukar gaya Imej 1 kepada gaya Imej 2 | ||
Tamat
Model teks ke imej berbeza dalam apa yang mereka lakukan dengan terbaik, jadi pilihan yang betul bergantung pada apa yang anda perlukan selepas imej pertama dijana. Jika anda hanya memerlukan konsep pantas, ketepatan prompt dan kualiti imej mungkin sudah memadai. Untuk visual produk, watak berulang, atau siri imej, rujukan, penyuntingan, dan konsistensi lebih penting. Jika anda ingin bermula daripada teks atau visual sedia ada, Kling IMAGE 3.0 membolehkan anda menggabungkan rujukan, menukar butiran tertentu, dan mengekalkan rupa yang sama dalam imej baharu. Sama ada anda sedang membina kempen produk, membangunkan watak berulang, atau menukar konsep awal menjadi set visual siap, model yang betul sepatutnya memudahkan anda mengekalkan butiran yang anda utamakan apabila projek berkembang.
Soalan Lazim
Model Bahasa AI manakah yang digunakan untuk penciptaan teks ke imej?
Tiada model bahasa tunggal digunakan oleh setiap sistem teks-ke-imej. Jika anda bertanya model bahasa AI mana yang digunakan untuk kebolehan penciptaan teks-ke-imej, jawapannya berbeza mengikut model. Sesetengah sistem menggunakan pengekod teks seperti CLIP atau T5, manakala yang lain menggunakan komponen bahasa atau bahasa-visual untuk membaca prompt sebelum imej dijana.
AI manakah yang boleh menukar teks kepada imej?
Banyak model imej AI boleh menukar prompt bertulis menjadi imej siap, termasuk Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1, dan Runway Gen-4 Image. Setiap satu mengendalikan prompt, rujukan, suntingan dan konsistensi visual secara berbeza, jadi model yang betul bergantung pada jenis imej yang anda perlu hasilkan.
Bolehkah model teks-ke-imej menggunakan imej rujukan?
Ya. Banyak model teks-ke-imej boleh menggunakan imej rujukan bersama prompt bertulis, yang menjadikan AI imej-ke-imej berguna apabila anda mahu bekerja daripada visual sedia ada dan bukannya bermula dari awal. Rujukan boleh menetapkan perincian seperti watak, produk, pose, komposisi, warna, atau gaya, manakala prompt memberitahu model apa yang perlu diubah. Kling IMAGE 3.0 boleh menggunakan sehingga 10 imej rujukan dalam satu generasi, yang berguna apabila watak, produk, atau gaya visual yang sama perlu kekal dikenali.
Bagaimanakah saya mengalih keluar latar belakang daripada imej?
Jika anda memerlukan gambar produk yang lebih bersih, imej profil, atau aset reka bentuk, anda boleh mengalih keluar latar belakang daripada gambar dan mengekalkan subjek utama terpencil. Latar belakang lutsinar berfungsi dengan baik untuk senarai produk, pembentangan, siaran sosial, atau susun atur di mana subjek perlu diletakkan di atas latar yang berbeza. Selepas penyingkiran, periksa tepi halus di sekeliling rambut, pakaian, bulu, atau objek kecil, kemudian kekalkan latar belakang lutsinar, tukar kepada warna pejal, atau letakkan subjek dalam adegan baharu.