Het kiezen van de beste lip-sync video-AI-tool gaat om meer dan het laten overeenkomen van mondbewegingen met audio. Het zou moeten helpen gezichten, expressies en videodetails consistent te houden gedurende de clip. In deze gids vergelijken we toonaangevende AI-lip-sync-tools in 2026 en bekijken we twee Kling AI-workflows: de Lip Sync-tool gebruiken om gesynchroniseerde spraak of zang toe te voegen aan een bestaande karaktervideo, en Native Audio in de VIDEO 3.0-serie gebruiken om vanaf het begin nieuwe dialoogscènes te creëren met gesynchroniseerde spraak, gezichtsacteerwerk en geluid.
Wat maakt een goede AI-lip-sync-tool?
Het kiezen van de beste lip-sync video-AI-tool houdt meer in dan controleren of de mondbewegingen overeenkomen met de audio. Belangrijke vergelijkingsfactoren zijn onder meer synchronisatieprecisie, gezichtsconsistentie, bewegingsafhandeling, invoerflexibiliteit, taalondersteuning en prestaties met meerdere sprekers.
Vergelijkingsfactor | Waar je op moet letten | Waarom het belangrijk is |
Audio-visuele synchronisatie | Mondbewegingen die overeenkomen met spraakgeluiden, pauzes en de timing van zinnen | Kleine timingproblemen kunnen ervoor zorgen dat de dialoog losgekoppeld aanvoelt van de video |
Gezichtsconsistentie en omgang met beweging | Stabiele gelaatstrekken, uitdrukkingen, hoofdbewegingen, camerahoe ken en visuele details | De spreker moet gedurende de hele video herkenbaar blijven |
Invoerflexibiliteit | Ondersteuning voor bestaande video's, personages, avatars en door AI gegenereerde scènes | Verschillende makers beginnen met verschillende materialen en productiebehoeften |
Meertalige ondersteuning en spraakondersteuning | Ondersteuning voor verschillende talen, stemmen en spreekstijlen | Belangrijk voor vertaling, lokalisatie en een wereldwijd publiek |
Afhandeling van scènes met meerdere sprekers | Nauwkeurige sprekerkoppeling en dialoogtiming in gesprekken | Helpt de stem van elke persoon op de juiste spreker af te stemmen |
6 Beste AI-tools voor lip-syncvideo's in 2026
AI-lipsynchronisatietools werken op verschillende manieren. Sommige zijn gemaakt om nieuwe spraak toe te voegen aan bestaande video's, terwijl andere lip-sync combineren met vertaling, avatars of door AI gegenereerde scènes. De beste optie hangt af van het beeldmateriaal waarmee je begint en het type video dat je wilt maken.
De onderstaande tabel vergelijkt zes AI-lipsynchronisatietools op het gebied van videosynchronisatie, vertaling, AI-videocreatie en scènes met meerdere sprekers.
Tool | Belangrijkste gebruik | Hoe lip-sync wordt gebruikt | Meertalig & lokalisatie | Dialoog & meerdere sprekers |
Kling AI | Lipsynchronisatie voor bestaande personagevideo's en native dialooggeneratie voor nieuwe AI-video's | Gebruik de speciale Lip Sync-tool om geüploade of Text-to-Speech-audio te koppelen aan een bestaande ondersteunde personagevideo, of gebruik Native Audio in VIDEO 3.0 / VIDEO 3.0 Omni om samen in een nieuwe video dialoog en gesynchroniseerde visuele performance te genereren. | De VIDEO 3.0-serie ondersteunt native dialooggeneratie in het Chinees, Engels, Japans, Koreaans en Spaans, inclusief meertalige dialogen, dialecten en accenten. | De VIDEO 3.0-serie ondersteunt dialoog met meerdere personages met spreker-specifieke teksten en gesynchroniseerde gezichtsuitdrukking. |
Vozo AI | Nasynchronisatie en lokalisatie voor bestaande video's | Nieuwe of vertaalde spraak wordt gekoppeld aan de spreker in het originele videomateriaal | Gebouwd rond videovertalingen en gelokaliseerde stemcontent | Ondersteunt lokalisatie voor meerdere sprekers |
HeyGen | Avatarvideo's en vertaalde video-inhoud | Spraak wordt gesynchroniseerd met avatars of sprekers na stemwijzigingen of vertaling | Sterke focus op meertalige videovertaling | Ondersteunt avatar- en content met meerdere sprekers |
Sync Labs | Lipsynchronisatie voor productie en integraties | Audio kan worden gesynchroniseerd met bestaande video via speciale lip-synctools | Taalondersteuning is afhankelijk van de overige productie-setup | Kan worden gebruikt voor dialoogsynchronisatie |
PixVerse | AI-videocreatie in korte vorm | Lipsynchronisatie kan worden toegevoegd aan gegenereerde personage-inhoud | Taalopties verschillen per functie | Ondersteunt op personages gebaseerde gesprekscènes |
CapCut | Sociale videobewerking en content van makers | Lipsynchronisatie kan worden afgehandeld via bewerking en AI-ondersteunde functies | Vertaalopties variëren per tool en regio | Hangt af van de gebruikte bewerkingsfuncties |
Welke lipsynchronisatie-aanpak past bij je video?
Lip-sync dient verschillende doelen, afhankelijk van de video die je maakt. Bestaand beeldmateriaal, vertaald materiaal en nieuw gegenereerde scènes vereisen elk een andere aanpak.
Je startpunt | Wat je wilt maken | Aanbevolen methode | Hulpmiddelen om te overwegen |
Je hebt al een bestaande personagevideo | Vervang spraak, voeg nieuwe dialoog toe of synchroniseer nieuwe audio | Lipsynchronisatie voor bestaande video | Kling AI, Vozo AI, Sync Labs |
Je hebt een video in een andere taal | Maak gelokaliseerde versies voor verschillende doelgroepen | Vertaling + stemgeneratie + lipsynchronisatie | HeyGen, Vozo AI, Kling AI* |
Je hebt een personage-afbeelding of avatar | Laat een personage spreken met gesynchroniseerde expressies | Praatend personage of avatar generatie | Kling AI Avatar, HeyGen |
Je wilt een nieuwe scène helemaal opnieuw maken | Genereer personages, dialogen en beelden samen | AI-videogeneratie met Native Audio | Kling AI |
Je creëert een gesprek of verhalende scène | Houd de dialoog natuurlijk tussen meerdere personages | Generatie van dialogen met meerdere personages | Kling AI |
*Kling Lip Sync kan vooraf voorbereide doeltaalaudio of beschikbare text-to-speech-stemmen synchroniseren met een ondersteunde personagevideo.
Twee manieren om lipgesynchroniseerde AI-video's te maken met Kling AI
Optie 1: Voeg lipsynchronisatie toe aan een bestaande personagevideo
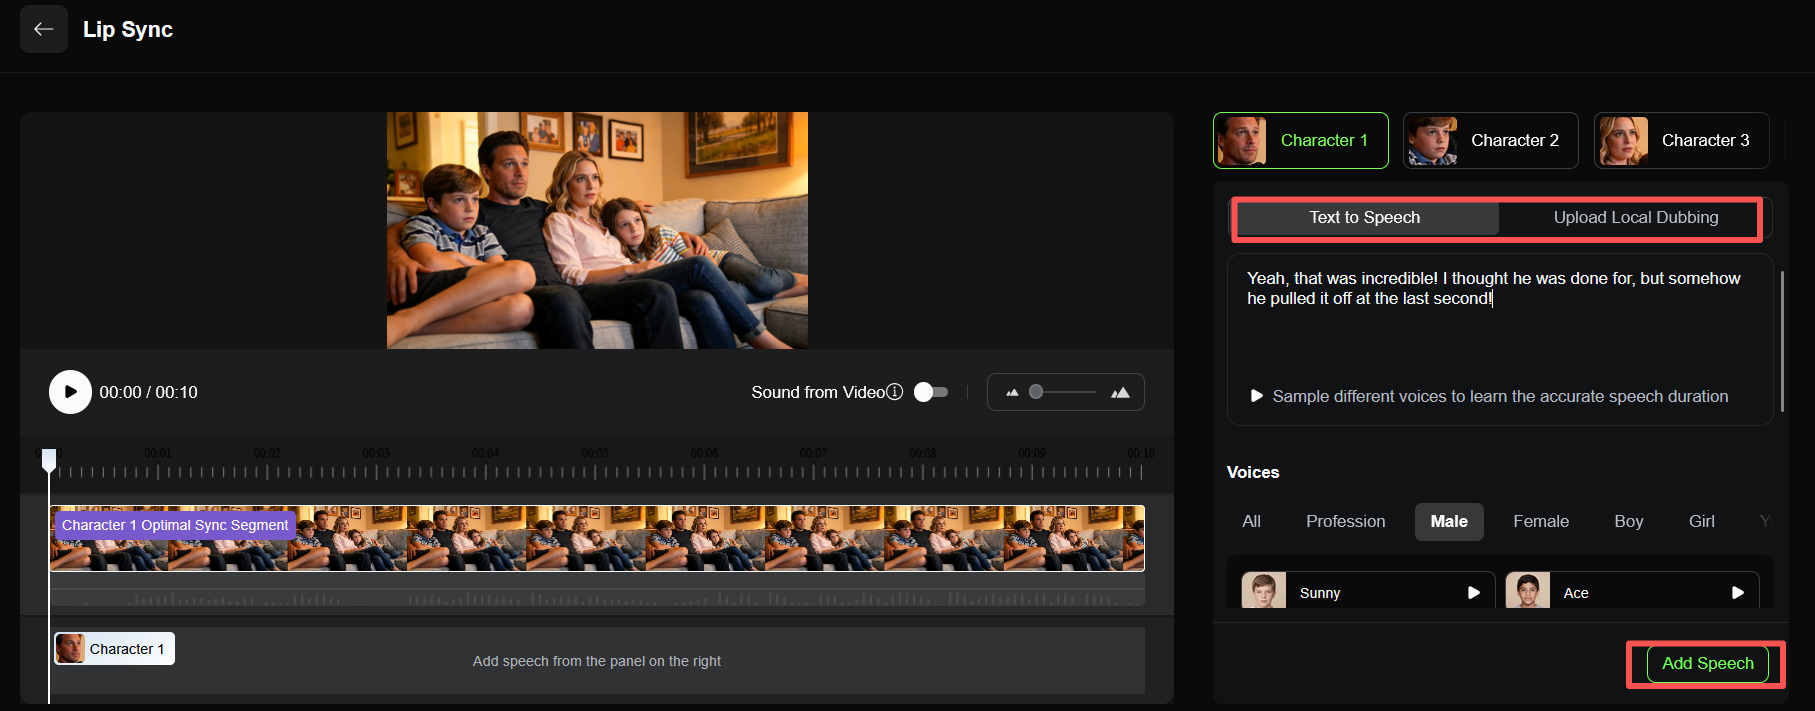
Als je al een ondersteunde Kling AI character-video hebt, gebruik dan de Kling AI Lip Sync-tool om nieuwe spraak of zang toe te voegen zonder de scène helemaal opnieuw op te bouwen. Je kunt je eigen audio uploaden of tekst-naar-spraak gebruiken en vervolgens de mondbewegingen van het personage synchroniseren met de nieuwe stem.
Stap 1: Kies een duidelijke personagevideo
Kies een ondersteunde Kling AI-clip met een volledig, duidelijk zichtbaar gezicht. Een helder zicht op de mond maakt het makkelijker te beoordelen of de nieuwe spraak gedurende de hele clip synchroon blijft. Kling AI Lip Sync ondersteunt realistische, 3D- en 2D-menselijke personages. Als het personage zich van de camera afwendt of de mond gedeeltelijk bedekt is, zorg er dan voor dat de belangrijkste sprekende passages nog steeds genoeg van het gezicht laten zien zodat de synchronisatie duidelijk werkt.
Stap 2: Audio toevoegen of een script invoeren
Upload een voice-over of zangtrack, of gebruik Text to Speech om de stem vanuit een script te genereren. Als de audio langer is dan de video, knip deze dan bij voordat je gaat genereren. Je kunt de snelheid van Text to Speech ook aanpassen wanneer een regel in een kortere clip moet passen. Houd het script dicht bij de beschikbare videotijd zodat de voordracht niet gehaast aanvoelt of lange pauzes achterlaat.
Stap 3: Genereer en controleer de lipsynchronisatie
Genereer de lipgesynchroniseerde versie en bekijk de volledige clip, inclusief snellere zinnen, pauzes en zinsafsluitingen. Als een deel van het gesproken woord te vroeg of te laat aanvoelt, controleer dan eerst de audiolengte en het tempo. Je kunt onnodige pauzes uit een geüploade track verwijderen of de Text to Speech-snelheid aanpassen voordat je opnieuw genereert. Let op zowel het volledige gezicht van het personage als de mond, vooral wanneer de oorspronkelijke video sterkere expressies of hoofdbeweging bevat.

Optie 2: Lipgesynchroniseerde dialoog genereren met de VIDEO 3.0-serie
Als je in plaats van spraak aan een bestaande video toe te voegen een nieuwe dialoogscène wilt maken, kunnen Kling VIDEO 3.0 en VIDEO 3.0 Omni via Native Audio tegelijk dialoog, lipbeweging, gezichtsuitdrukkingen, visuals, sfeer en geluidseffecten genereren. Als de scène vanaf het begin meerdere sprekende personages bevat, kun je Text to Video AI gebruiken en het volgende opgeven:
- wie er spreekt
- wat elk personage zegt
- de spreekvolgorde
- de taal of het accent
- wat elk personage doet tijdens het spreken
| Prompt: Een man en een vrouw zitten ’s avonds tegenover elkaar in een rustig, modern café. De man spreekt als eerste in het Engels met een zacht Amerikaans accent, leunt licht naar voren en zegt: “Ik had niet gedacht dat je zou komen.” De vrouw kijkt naar hem, pauzeert even en antwoordt dan in het Engels met een Brits accent: “Ik was er bijna niet.” Ze geeft een kleine glimlach en zet haar koffiekopje langzaam neer. De man kijkt verrast en begint te reageren, maar zij draait zich naar het raam voordat hij weer spreekt. Zorg dat de timing van de dialoog duidelijk is, met natuurlijke lipbewegingen, subtiele gezichtsuitdrukkingen en realistische pauzes tussen elke spreker. |
VIDEO 3.0 ondersteunt dialogen met meerdere personages in het Chinees, Engels, Japans, Koreaans en Spaans, evenals meertalige dialogen, dialecten en accenten. Meerdere personages kunnen één scène delen zonder elke spreker als een afzonderlijke clip te hoeven genereren en de stukken later aan elkaar te moeten plakken.
Met Native Audio kunnen dialoog, ambiance en geluidseffecten samen met de visuals worden gegenereerd. Je kunt gesproken zinnen, ruimtetoon, voetstappen of andere geluiden in de prompt beschrijven zodat ze deel van de scène worden in plaats van laag voor laag te worden toegevoegd nadat de visuals klaar zijn. Voor korte verhaalscènes, gesprekken en productvideo's met gesproken tekst vermindert dit het aparte audiowerk na de generatie.
Als je wilt dat de camera met het gesprek meebeweegt, gebruik dan Multi-Shot in de Kling AI-videogenerator. Een scène kan verschuiven van een two-shot naar een close-up van de persoon die spreekt, en vervolgens knippen naar de reactie van het andere personage. Multi-Shot kan wisselingen van shots, kadrering en camerahoeken vanuit de prompt regelen. Als je de sequentie al hebt gepland, kun je met Custom Multi-Shot zelf de inhoud en de duur van elk shot instellen. VIDEO 3.0 ondersteunt generaties van 3–15 seconden, zodat een korte sequentie dialoog, reacties, personagebewegingen en meerdere camerawisselingen kan bevatten.
VIDEO 3.0 Omni breidt deze workflow uit voor meer referentiegestuurde creatie en combineert Native Audio met Element-based consistentie van personages en bredere multimodale inputs.
Samen genomen stellen deze besturingselementen je in staat een dialoogscène te bouwen waarin spraak, lipbewegingen, reacties van personages, geluid en camerawisselingen al binnen dezelfde sequentie samenwerken in plaats van achteraf stuk voor stuk te worden samengesteld.
Afbeelding |
| Prompt: Zonneschijn vult de oude straten van Madrid. Voor een bakkerij aan de straatkant lopen een Chinese vrouwelijke toerist en een mannelijke toerist met een grijze hoodie op de winkelbediende af, beiden met een beleefde glimlach. Vrouwelijke toerist (spreekt iets langzamer, met een ongemakkelijk accent, in het Spaans):Disculpe, ¿dónde está la plaza mayor? Een Spaans winkelbediende met wit haar (draait zich lichtjes om en wijst naar voren, met een lichte en vrolijke toon, in het Spaans):Por allí, a dos calles. Muy cerca. De vrouwelijke toerist knikt om haar dank te uiten. De mannelijke toerist knikt ook instemmend en zegt (in het Spaans): Muchas gracias. De winkelbediende glimlacht en knikt als antwoord. De twee toeristen draaien zich vervolgens om en lopen in de aangeduide richting. |
Uitvoer |
Wat zijn de meest voorkomende lipsynchronisatieproblemen en hoe los je ze op?
Enkele veelvoorkomende mismatches kunnen optreden tijdens lip-syncgeneratie. Ze komen vaak voort uit het bronmateriaal, de audiotiming, de scriptlengte of de richting van de spreker. Zo herken je de oorzaak en pas je deze aan.
De oplossing hangt af van de workflow die je gebruikt. Met de Lip Sync-tool houden problemen meestal verband met de bronvideo van het personage, de audiotiming of de scriptlengte. Met Native Audio in VIDEO 3.0 of VIDEO 3.0 Omni kunnen scènes met meerdere personages ook afhangen van hoe duidelijk elke spreker en regel in de prompt worden toegewezen.
Probleem | Mogelijke oorzaak | Wat je kunt proberen |
De mond beweegt te vroeg of te laat | Het nieuwe geluid past niet bij de timing van het oorspronkelijke fragment, of de voordracht is te snel of te langzaam | Knip lange pauzes weg, verkort de zin of pas de spreeksnelheid aan voordat je opnieuw genereert |
Het gezicht verandert terwijl het personage spreekt | De bronvideo heeft beperkte gezichtsdetails, sterke hoofdbewegingen, bewegingsonscherpte of delen van het gezicht zijn bedekt | Gebruik beeldmateriaal waarin gezicht en mond zichtbaar blijven gedurende de belangrijkste gesproken delen |
De kaak- of mondbeweging lijkt overdreven | De zin bevat snelle of sterke articulatie die niet past bij de zichtbare beweging in de bronbeelden. | Probeer een kortere zin, een langzamere voordracht of beelden met een duidelijker vooraanzicht of driekwartaanzicht. |
De synchronisatie begint goed maar raakt later uit de pas | Een lange zin, een ongelijk tempo of extra pauzes duwen het geluid geleidelijk weg van de timing van de video. | Bekijk de volledige clip en kort de zin vervolgens in, of verwijder pauzes rond het punt waar de afwijking begint. |
Het lijkt alsof het verkeerde personage spreekt | De prompt maakt de volgorde van de sprekers of de toewijzing van de dialogen niet duidelijk genoeg. | Geef aan wie elke zin zegt, houd de spreekvolgorde expliciet en scheid de dialoog van elk personage duidelijk. |
Vertaalde dialoog voelt gehaast aan | De vertaalde zin kost meer tijd om uit te spreken dan de oorspronkelijke regel. | Herschrijf de vertaling op spreeklengte in plaats van woord voor woord de bron te volgen, en pas zo nodig de spreeksnelheid aan. |
Controleer voor Lip Sync eerst de bronclip, de audiotiming en de scriptlengte. Controleer voor Native Audio-scènes ook of elke spreker, regel en spreekvolgorde duidelijk is gedefinieerd voordat je meer details aan de rest van de prompt toevoegt.
Het einde
De beste lip-syncvideo-AI moet spraak laten aanvoelen als onderdeel van de performance, waarbij de mondbeweging nauwkeurig blijft terwijl het personage beweegt of langere zinnen uitspreekt, en tegelijkertijd gelaatskenmerken en een natuurlijke expressie behoudt. Voor een bestaande ondersteunde Kling AI-personagevideo stelt Kling AI Lip Sync je in staat om nieuwe spraak of zang toe te voegen zonder de scène vanaf nul opnieuw te maken. Als je een dialoogscène vanaf nul maakt, kan Kling VIDEO 3.0 dialogen, mondbewegingen, gezichtsuitdrukkingen, geluid en shotwissels tegelijk genereren via Native Audio, dialoog met meerdere personages en Multi-Shot. Dit vermindert het aparte werk om stem, mondbeweging en camerawissels in de nabewerking op elkaar af te stemmen, terwijl het helpt om de uiteindelijke scène samenhangend te houden met stabielere lip-sync en consistenter spel van het personage.
Veelgestelde vragen
Welke AI heeft de beste lip-sync?
De beste lip-sync-AI hangt af van wat je maakt. Voor een bestaande ondersteunde Kling AI-charactervideo is Kling AI Lip Sync ontworpen om nieuwe spraak of zang toe te voegen; voor vertaalde video's richten tools zoals HeyGen en Vozo AI zich meer op dubbing en lokalisatie; en voor avatarvideo's in presentatiestijl is HeyGen opgebouwd rond avatar-geleide workflows. Als je vanaf nul een nieuwe dialoogscène maakt, kan Kling VIDEO 3.0 spraak, lipbeweging, gezichtsuitdrukking en geluid samen in dezelfde scène genereren. Kies het hulpmiddel op basis van je startmateriaal en of je eenvoudige spraakvervanging, vertaling, avataarpresentatie of een volledig gegenereerde dialoogscène nodig hebt.
Kan AI-lip-syncsoftware meerdere talen aan?
Ja, maar taalondersteuning verschilt per functie. Kling Lip Sync kan geüploade spraak of zang synchroniseren, terwijl Text to Speech de in de tool beschikbare stemmen gebruikt. Voor nieuw gegenereerde scènes ondersteunt VIDEO 3.0 dialogen in het Chinees, Engels, Japans, Koreaans en Spaans, inclusief conversaties met meerdere talen. Taalopties kunnen per modelversie verschillen, dus controleer de instellingen die worden weergegeven in de versie die je gebruikt.
Kan ik mijn eigen audio gebruiken in Kling Lip Sync?
Ja. Kling Lip Sync laat je je eigen voice-over of zangaudio uploaden. Als de audio langer is dan de video, kun je deze inkorten vóór de generatie. Gebruik een duidelijke opname en bronbeelden waarbij het gezicht zichtbaar blijft tijdens de belangrijkste spreekgedeelten. Controleer na de generatie snelle zinnen, pauzes, langere klinkers en momenten met meer hoofdbeweging om er zeker van te zijn dat de mond afgestemd blijft op de audio.
Wat is het verschil tussen Kling Lip Sync en VIDEO 3.0 native audio?
Kling Lip Sync voegt nieuwe spraak of zang toe aan een bestaande ondersteunde video van een personage, terwijl VIDEO 3.0 Native Audio vanaf het begin tegelijkertijd de video en het geluid creëert. Met VIDEO 3.0 kunnen dialoog, lipbeweging, geluid en Multi-Shot allemaal in de nieuwe scène worden ingebouwd. Gebruik Kling Lip Sync wanneer je al een ondersteunde Kling AI-personagevideo hebt die je wilt behouden; gebruik VIDEO 3.0 of VIDEO 3.0 Omni wanneer de dialoogscène nog moet worden gecreëerd.