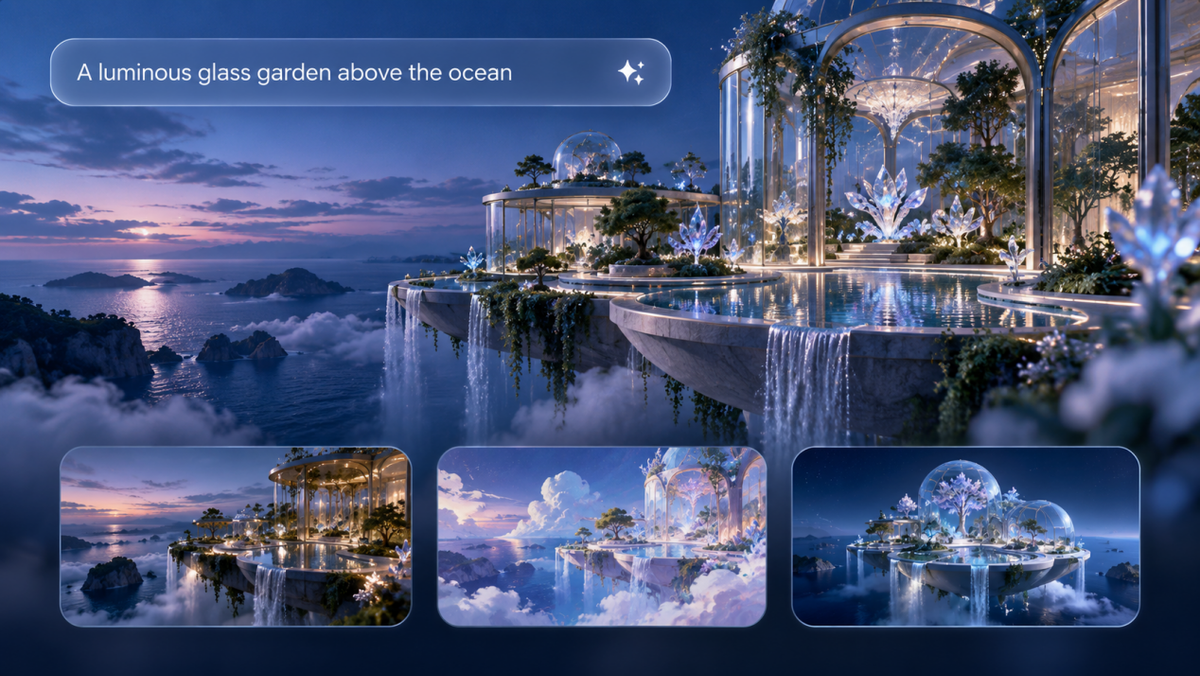
Met slechts een idee of een eenvoudige beschrijving kunnen tekst-naar-beeldmodellen natuurlijke taal omzetten in visuele concepten. Voor makers gaan de beste tekst-naar-beeldmodellen verder dan alleen beeldgeneratie. Ze moeten complexe prompts begrijpen, visuele consistentie behouden en creatieve verfijning in de loop van de tijd ondersteunen. Deze gids legt uit hoe tekst-naar-beeldmodellen werken, vergelijkt de belangrijkste mogelijkheden en verkent hoe Kling IMAGE 3.0 referentiegestuurde creatie, precieze bewerking en flexibele workflows combineert om makers te helpen hun visuele ideeën tot leven te brengen.
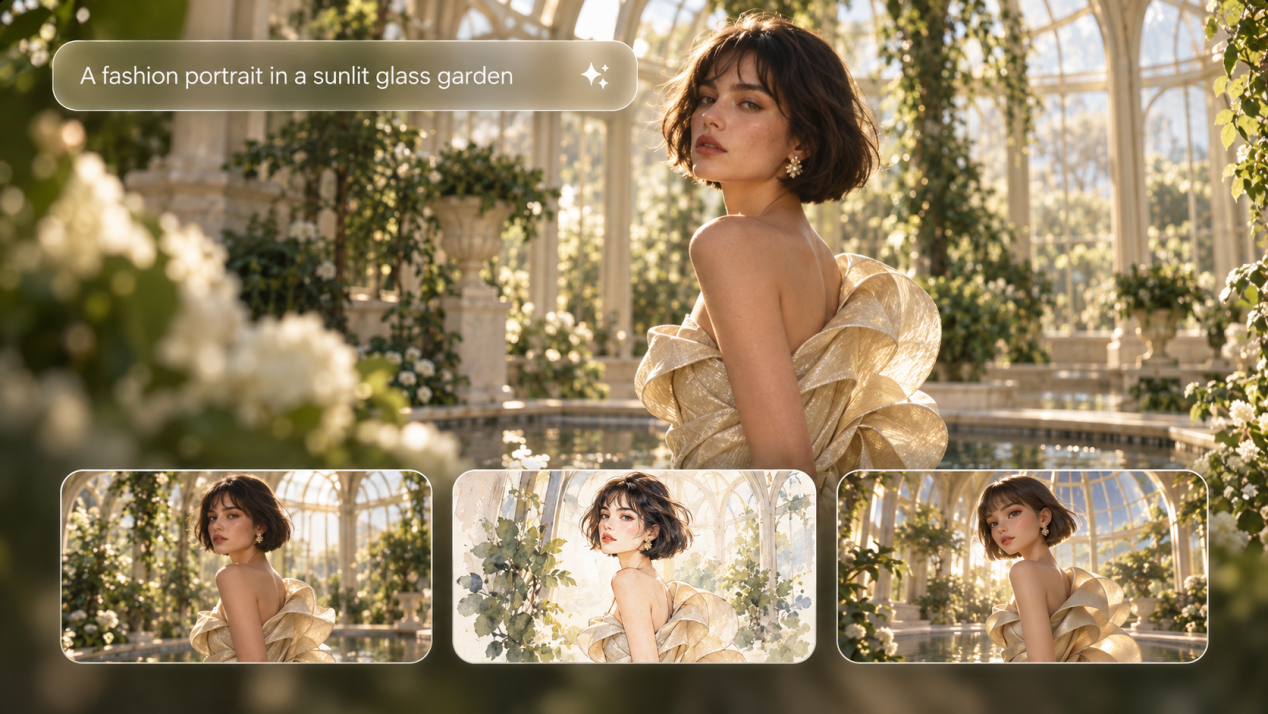
Wat zijn tekst-naar-beeldmodellen?
Een tekst-naar-beeldmodel is een type systeem voor kunstmatige intelligentie dat natuurlijke taalprompts omzet in digitale beelden op basis van de details die in de prompt worden beschreven.
Moderne tekst-naar-beeldsystemen combineren doorgaans een component die de prompt begrijpt of codeert met een beeldgenererende component die deze instructies omzet in visuele inhoud. Sommige modellen kunnen ook werken met afbeeldingen en andere visuele referenties, waardoor ze complexe prompts kunnen volgen, belangrijke details behouden en preciezere bewerkingen ondersteunen.
Neem bijvoorbeeld de volgende prompt:
| Prompt: Een vintage camera die op een houten bureau staat, met zacht ochtendlicht dat over de scène valt. |
Het model moet het object, het materiaal, de ruimtelijke ordening, de belichting en de algehele visuele stijl begrijpen voordat het de bijbehorende afbeelding genereert.
Tegenwoordig omvat het beoordelen van tekst-naar-beeldmodellen meer dan alleen beeldkwaliteit. De focus is verschoven naar een nauwkeurig begrip van prompts, het omgaan met complexe scènes, het behouden van visuele consistentie en het ondersteunen van flexibele bewerkingen.
Hoe werken tekst-naar-beeldmodellen?
Tekst-naar-beeldmodellen vertalen geschreven beschrijvingen naar visuele inhoud door te leren hoe taal zich verhoudt tot objecten, stijlen, composities en andere details. Veel moderne systemen gebruiken diffusiegebaseerde methoden, waarbij de prompt een stapsgewijs proces aanstuurt dat visuele ruis geleidelijk in een afgewerkt beeld verandert.
Het proces kan in drie fasen worden begrepen:
1.Leren hoe tekst met beelden verbonden is
Voordat het beelden genereert, leert een tekst-naar-beeldmodel van grote datasets met afbeeldingen die aan beschrijvingen zijn gekoppeld. Tijdens de training identificeert het patronen tussen woorden en visuele details, waaronder objecten, kleuren, vormen, stijlen en ruimtelijke relaties. Zo leert het model hoe concepten als "vintage camera", "houten bureau" en "zacht ochtendlicht" gekoppeld zijn aan specifieke visuele kenmerken.
2.De prompt begrijpen
Wanneer je een prompt invoert, vertaalt het systeem je tekst naar een formaat dat het kan begrijpen, waarbij het de kernbetekenis en context vastlegt. Hoewel de exacte technologie per model verschilt—en commerciële systemen hun volledige architectuur vaak geheimhouden—werken deze tekst- en visuele componenten samen om een brug te slaan tussen jouw woorden en de uiteindelijke visuele output.
3. De afbeelding genereren
Veel moderne tekst-naar-beeldmodellen gebruiken diffusietechnieken, al gebruiken andere modellen mogelijk autoregressieve of andere generatieve benaderingen. In op diffusie gebaseerde systemen begint het proces met visuele ruis en wordt die ruis geleidelijk verwijderd op basis van de informatie die door de prompt wordt geleverd. Via herhaalde stappen van ruisonderdrukking ontwikkelt het beeld duidelijkere vormen, details en stijlen die overeenkomen met de beschrijving. Sommige systemen voeren dit proces uit in een gecomprimeerde latente ruimte voordat ze het resultaat omzetten in de uiteindelijke afbeelding. Nadat de afbeelding is gevormd, kunnen verdere aanpassingen worden gedaan om details te verfijnen of het voor te bereiden op bewerking.
Wat maakt tekst-naar-beeldmodellen anders?
Tekst-naar-beeldmodellen kunnen heel verschillend reageren op dezelfde prompt. Een deel daarvan komt voort uit de manier waarop afbeeldingen worden gegenereerd, terwijl een ander deel voortkomt uit de soorten input die het model kan lezen en gebruiken.
Generatie-architectuur
Op generatieniveau zijn twee veelvoorkomende benaderingen diffusie en autoregressieve generatie.
Benadering | Hoe het werkt | Veelvoorkomende toepassingen |
Diffusiemodellen | Begin met visuele ruis en verfijn deze geleidelijk tot een afbeelding die wordt gestuurd door de prompt. | Gedetailleerde beeldgeneratie, realistische scènes, illustratie en stijlgedreven werk. |
Autoregressieve modellen | Bouw een afbeelding op door visuele tokens of elementen achtereenvolgens te voorspellen. | Beeldgeneratie die visuele inhoud sequentieel opbouwt in plaats van ruis te verfijnen. |
Diffusiemodellen blijven een actief onderzoeksgebied voor tekst-naar-beeld. De enquête uit 2023 Text-to-image Diffusion Models in Generative AI: A Survey biedt een nuttig overzicht van diffusie-gebaseerde tekst-naar-beeldmethoden, datasets, evaluatiebenaderingen en gerelateerde toepassingen.
Multimodale invoer
Multimodaal beschrijft de soorten invoer die een model kan gebruiken in plaats van hoe het een afbeelding genereert. Een multimodaal beeldmodel kan tekst, afbeeldingen en visuele referenties gebruiken voor creatie op basis van referenties, bewerking of het consistent houden van personages en producten binnen een reeks. Onderliggend kan het nog steeds diffusie, autoregressieve generatie of een andere methode gebruiken, waardoor een model in meer dan één categorie kan vallen.
Wat zijn de beste tekst-naar-beeldmodellen in 2026?
Voor deze gids hebben we zeven actuele modellen geselecteerd die verschillende benaderingen vertegenwoordigen voor beeldgeneratie, bewerking, referentiegestuurde creatie en visuele productie. De volgorde is geen ranglijst.
Model | Modeltype | Beste voor | Belangrijkste kenmerken |
Model voor beeldgeneratie en -bewerking met multimodale invoer | Referentiegestuurde creatie, productvisuals, personages en gedetailleerde bewerkingen | Genereert vanuit tekst of afbeeldingen, combineert kenmerken van maximaal 10 referenties en ondersteunt behoud van onderwerp, precieze bewerkingen en stijlcontrole. IMAGE 3.0 ondersteunt generatie tot 2K, terwijl IMAGE 3.0 Omni tot 4K biedt. | |
Leonardo Lucid Origin | Model voor beeldgeneratie | Illustratie, concept art, productmock-ups en algemene beeldcreatie | Dekt een breed scala aan stijlen, volgt gedetailleerde prompts, produceert Full HD-afbeeldingen en ondersteunt leesbare tekstweergave. |
Seedream 5.0 Pro | Model voor beeldgeneratie en -bewerking | Productbeelden, infographics, ontwerpmiddelen en lokale bewerkingen | Werkt vanuit tekst of beelden, accepteert referenties, ondersteunt regionale bewerking en verwerkt meertalige invoer en generatie. |
Adobe Firefly Image 5 | Model voor beeldgeneratie en -bewerking | Ontwerpproductie, marketingmaterialen en Adobe-gebaseerde projecten | Genereert vanuit tekst, werkt met referentieafbeeldingen en maakt gerichte bewerkingen in Photoshop mogelijk terwijl de omringende beeldinhoud intact blijft. |
Krea 2 Large | Model voor beeldgeneratie | Fotorealisme, stijlgestuurd werk en visuele richting | Geoptimaliseerd voor expressief fotorealisme, met promptgestuurde creatie en referentiegestuurde controle over compositie, onderwerp en stijl. |
Luma UNI-1.1 | Geïntegreerd multimodaal beeldmodel | Referentiegestuurde generatie en beeldherziening | Combineert afbeeldingsgeneratie met natuurlijke-taalbewerking en accepteert tot negen referentie-inputs per aanvraag. |
Runway Gen-4 Image | Model voor beeldgeneratie binnen een beeld- en videoplatform | Personageontwikkeling, scèneontwerp en projecten die later naar video overgaan | Genereert op basis van tekst en referentiebeelden, gebruikt tot drie referenties per generatie, en kan personages, objecten of visuele kenmerken meenemen naar nieuwe scènes. |
De volgende sectie vergelijkt deze modellen op het opvolgen van prompts, omgaan met referenties, bewerken, visuele consistentie en stijlcontrole.
Hoe vergelijken tekst-naar-beeldmodellen zich in 2026?
Tekst-naar-beeldmodellen verschillen het meest in promptnauwkeurigheid, gebruik van referenties, bewerking, consistentie en stijlcontrole. Deze verschillen vallen gemakkelijker op in projecten met herhaalde afbeeldingen, revisies, producten of terugkerende personages.
Vergelijkingsgebied | Wat je moet vergelijken | Waarom het ertoe doet |
Prompt-opvolging | Onderwerpen, attributen, objectrelaties, compositie en vereiste details. | Een gepolijste afbeelding schiet nog steeds tekort als deze de briefing mist. |
Referentieafhandeling | Aantal referenties, behoud van onderwerp, stijloverdracht en compositierichting. | Referenties helpen een personage, product of visuele richting herkenbaar te houden in meerdere afbeeldingen. |
Afbeeldingsbewerking | Lokale wijzigingen, bewerkingen in natuurlijke taal en hoe goed onaangeroerde gebieden intact blijven. | Precieze bewerkingen besparen tijd en voorkomen dat de afbeelding vanaf nul opnieuw moet worden opgebouwd. |
Visuele consistentie | Personages, producten, kleding, stijl en terugkerende details over afbeeldingen of revisies heen. | Stabiele details zijn belangrijk voor reeksen afbeeldingen, campagnes, storyboards en productsets. |
Stijlcontrole | Belichting, palet, textuur, fotografische uitstraling, illustratiestijl en visuele richting. | Duidelijke stijlcontrole helpt gerelateerde afbeeldingen visueel verbonden te houden. |
Geschiktheid voor de workflow | Herzieningen, exportopties, gebruik van image-to-video en compatibiliteit met andere creatieve tools. | Wat er na het genereren gebeurt, kan net zo belangrijk zijn als de eerste afbeelding. |
Een model dat goed werkt voor snelle conceptafbeeldingen is mogelijk niet geschikt voor een productreeks of een personageproject. Nauwkeurigheid en stijl van prompts kunnen voldoende zijn voor een enkele afbeelding, maar herhaald werk vraagt vaak om sterkere referenties, bewerking en consistentie.
Hoe kies je het beste tekst-naar-beeldmodel?
Bij het kiezen van een AI image generator, begin je met wat je wilt maken en welke details ongewijzigd moeten blijven terwijl je de afbeelding bijwerkt. De onderstaande tabel laat zien waar je op moet letten in verschillende veelvoorkomende scenario's.
Als je nodig hebt | Zoek naar | Waarom het ertoe doet |
Snelle conceptafbeeldingen | Promptnauwkeurigheid, beeldkwaliteit en stijlbereik | Je kunt dichter bij het beoogde resultaat komen met minder revisies. |
Consistente personages of producten | Verwerking van referenties en behoud van details | Gezichten, kleding, producten en andere bepalende kenmerken moeten over verschillende afbeeldingen herkenbaar blijven. |
Veelvuldige revisies van afbeeldingen | Lokale bewerking en wijzigingen in natuurlijke taal | Je kunt één deel van de afbeelding aanpassen zonder de hele scène opnieuw op te bouwen. |
Campagnematerialen of beeldseries | Stabiele onderwerpen, stijl en compositie | Gerelateerde afbeeldingen moeten dezelfde visuele richting delen. |
Afbeeldingen die later worden omgezet naar video | Referentieafbeeldingen en beeld-naar-video-opties | Stabiele onderwerpen en visuele details zijn gemakkelijker naar beweging over te brengen. |
Waarom is Kling IMAGE 3.0 het overwegen waard?
Kling IMAGE 3.0 laat je creaties starten met een tekstprompt of referentiebeelden, waarna je elk detail kunt verfijnen met natuurlijke taal. Voorbij standaardgeneratie geeft het je diepgaande controle over karakterconsistentie, precieze bewerkingen en stijlafstemming, waardoor eindeloze creatieve mogelijkheden opengaan.
Verander complexe ideeën in frisse visuals
IMAGE 3.0 laat je visuele aanwijzingen uit meerdere referenties combineren en alledaagse taal gebruiken om voorbij standaardbewerkingen te gaan. Combineer onderwerpen uit verschillende afbeeldingen, draai het perspectief van een scène om of verschuif een concept naar een geheel nieuwe stijl—terwijl het eindresultaat naadloos en samenhangend blijft.
Referentieafbeelding 1 | Referentieafbeelding 2 | Uitvoerafbeelding |
Prompt: Combineer de dieren uit afbeelding 1 en afbeelding 2. | ||
Houd personages, producten en belangrijke details herkenbaar
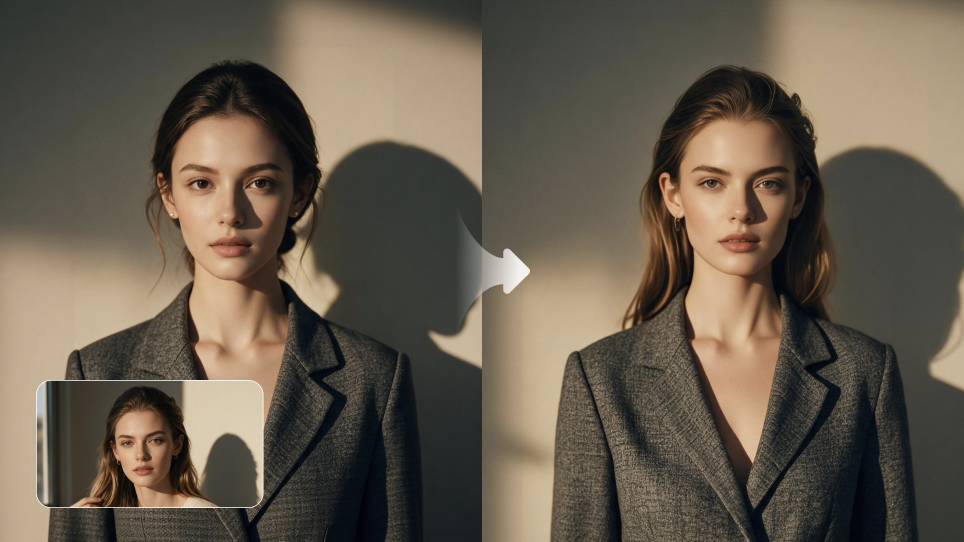
Je kunt tot 10 referentieafbeeldingen in één generatie gebruiken. Verschillende referenties kunnen een karakter, kleding, product, omgeving of stijl definiëren terwijl je prompt uitlegt hoe die elementen samen moeten komen. Voor portretretouches kunnen gezichtsreferenties helpen herkenbare gelaatstrekken te behouden terwijl je het kapsel, de outfit, de pose of de omgeving verandert. Als je gewoon een gezicht in een bestaande opname wilt plaatsen, kun je ook rechtstreeks naar de gezichtswissel workflows van Kling gaan.
Verander alleen wat veranderd moet worden
Als het grootste deel van een afbeelding er al goed uitziet, kun je Kling IMAGE 3.0 gebruiken als AI-fotobewerker om specifieke details aan te passen zonder de hele scène opnieuw op te bouwen. Instructies in natuurlijke taal kunnen de grootte, kleur, materiaal, expressie of achtergrond van een object wijzigen, terwijl wordt geprobeerd de omliggende delen van de afbeelding te behouden. Je kunt Kling AI ook gebruiken als watermerkverwijderaar voor afbeeldingen die je bezit of mag bewerken. Andere bewerkingen omvatten fotokleuring, vintage-effecten, doodle-bewerkingen, wijzigingen in licht en toon, en beeldrestauratie.
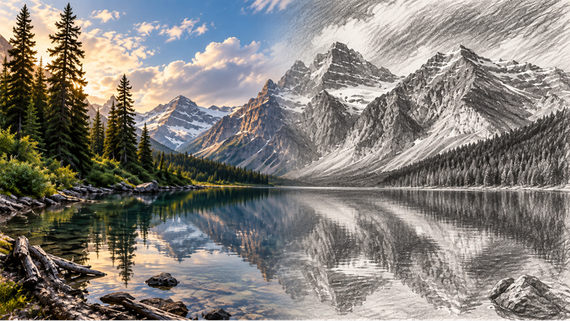
Houd stijl en toon consistent tussen afbeeldingen Als je al een duidelijke visuele richting hebt, kun je een bestaande afbeelding gebruiken als stijlreferentie. Kling IMAGE 3.0 kan elementen zoals penseelstreek, kleur, compositie en toon overdragen naar nieuwe afbeeldingen. Dit werkt goed voor illustratiesets, productvisuals of branded content waarbij dezelfde uitstraling in meer dan één afbeelding moet voorkomen.
Referentieafbeelding 1 | Referentieafbeelding 2 | Uitvoerafbeelding |
Prompt: verander de stijl van Afbeelding 1 naar die van Afbeelding 2 | ||
Het einde
Tekst-naar-beeldmodellen verschillen in waar ze het beste in zijn, dus de juiste keuze hangt af van wat je nodig hebt nadat de eerste afbeelding is gegenereerd. Als je slechts een snel concept nodig hebt, zijn promptnauwkeurigheid en beeldkwaliteit misschien voldoende. Voor productvisuals, terugkerende personages of beeldreeksen zijn referenties, bewerking en consistentie belangrijker. Als je vanuit tekst of bestaande visuals wilt beginnen, laat Kling IMAGE 3.0 je referenties combineren, specifieke details wijzigen en dezelfde uitstraling meenemen in nieuwe afbeeldingen. Of je nu een productcampagne opbouwt, een terugkerend personage ontwikkelt of een vroeg concept omzet in een afgewerkte visuele set, het juiste model moet het eenvoudiger maken om de details die voor jou belangrijk zijn te behouden naarmate het project groeit.
Veelgestelde vragen
Welk AI-taalmodel wordt gebruikt voor tekst-naar-beeldcreatie?
Er wordt geen enkel taalmodel door elk tekst-naar-beeldsysteem gebruikt. Als je je afvraagt welk AI-taalmodel wordt ingezet voor tekst-naar-beeldmogelijkheden, verschilt het antwoord per model. Sommige systemen gebruiken tekstencoders zoals CLIP of T5, terwijl andere taal- of visie-taalcomponenten inzetten om de prompt te lezen voordat de afbeelding wordt gegenereerd.
Welke AI kan tekst naar beeld omzetten?
Veel AI-beeldmodellen kunnen een geschreven prompt omzetten in een afgewerkte afbeelding, waaronder Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 en Runway Gen-4 Image. Elk gaat op een andere manier om met prompts, referenties, bewerkingen en visuele consistentie, dus het juiste model hangt af van het type afbeelding dat je wilt maken.
Kunnen tekst-naar-beeldmodellen referentieafbeeldingen gebruiken?
Ja. Veel tekst-naar-beeldmodellen kunnen referentieafbeeldingen gebruiken naast geschreven prompts, wat beeld-naar-beeld-AI nuttig maakt wanneer je met een bestaand beeld wilt werken in plaats van vanaf nul te beginnen. De referentie kan details vastleggen zoals het personage, product, de pose, compositie, kleuren of stijl, terwijl de prompt het model vertelt wat er moet veranderen. Kling IMAGE 3.0 kan tot 10 referentieafbeeldingen in één generatie gebruiken, wat handig is wanneer hetzelfde personage, product of dezelfde visuele stijl herkenbaar moet blijven.
Hoe verwijder ik de achtergrond van een afbeelding?
Als je een schonere productfoto, profielfoto of ontwerpelement nodig hebt, kun je de achtergrond uit een afbeelding verwijderen en het hoofdonderwerp geïsoleerd houden. Een transparante achtergrond werkt goed voor productvermeldingen, presentaties, socialmediaposts of lay-outs waarbij het onderwerp op een andere achtergrond moet staan. Controleer na het verwijderen de fijne randen rond haar, kleding, vacht of kleine objecten, en houd de achtergrond vervolgens transparant, schakel over naar een effen kleur of plaats het onderwerp in een nieuwe scène.