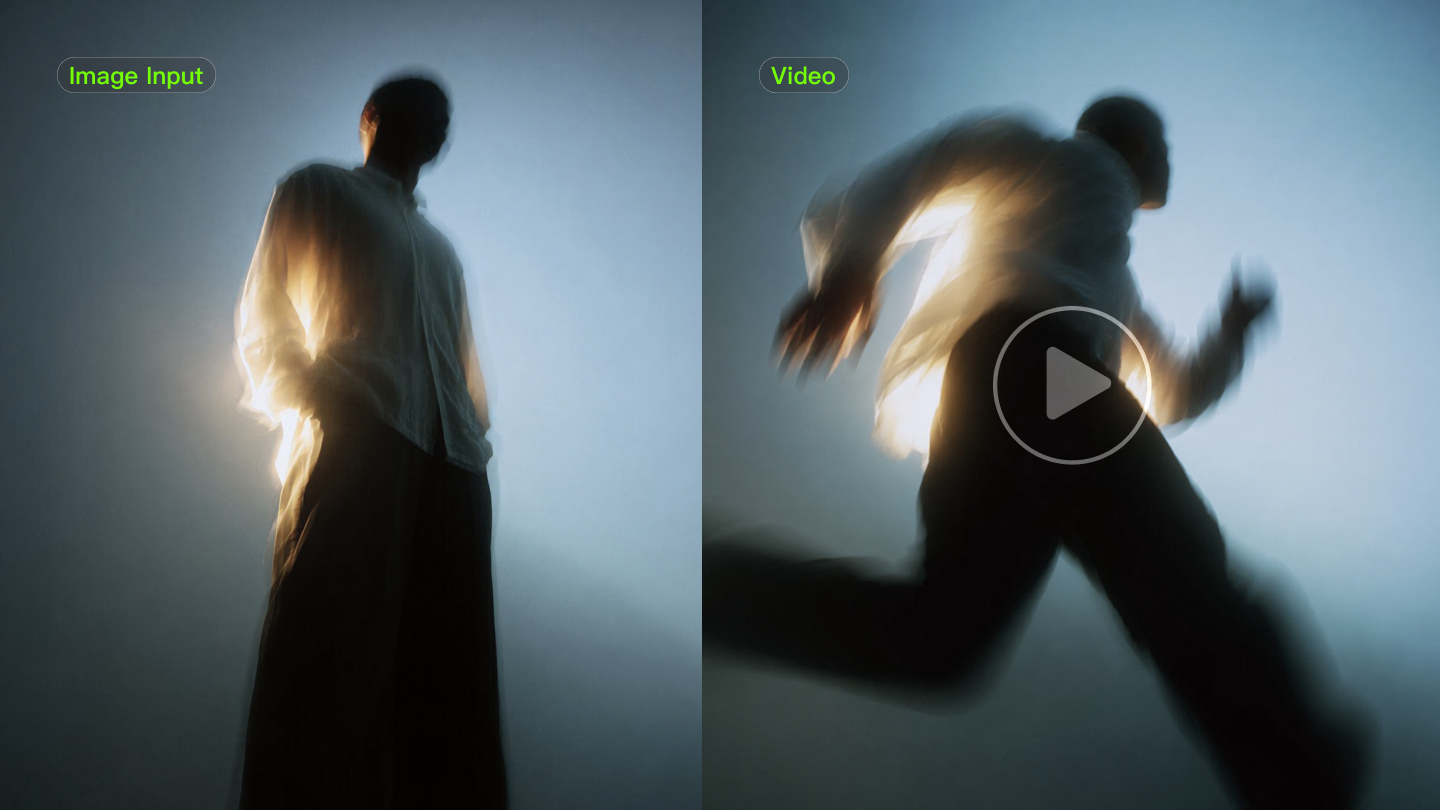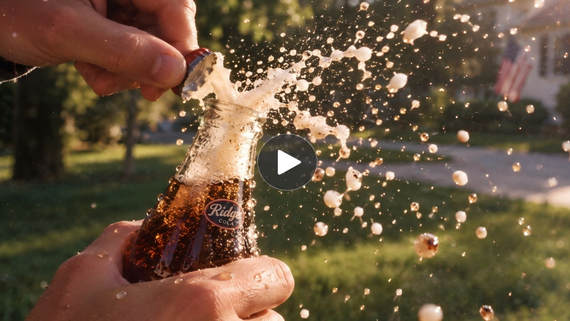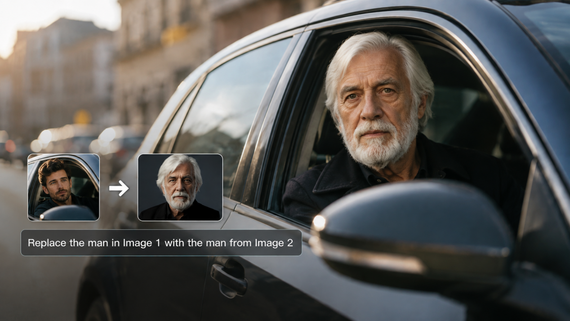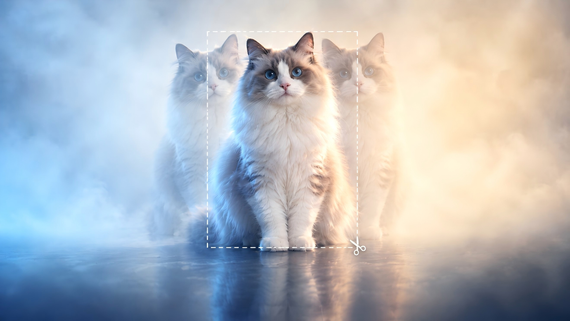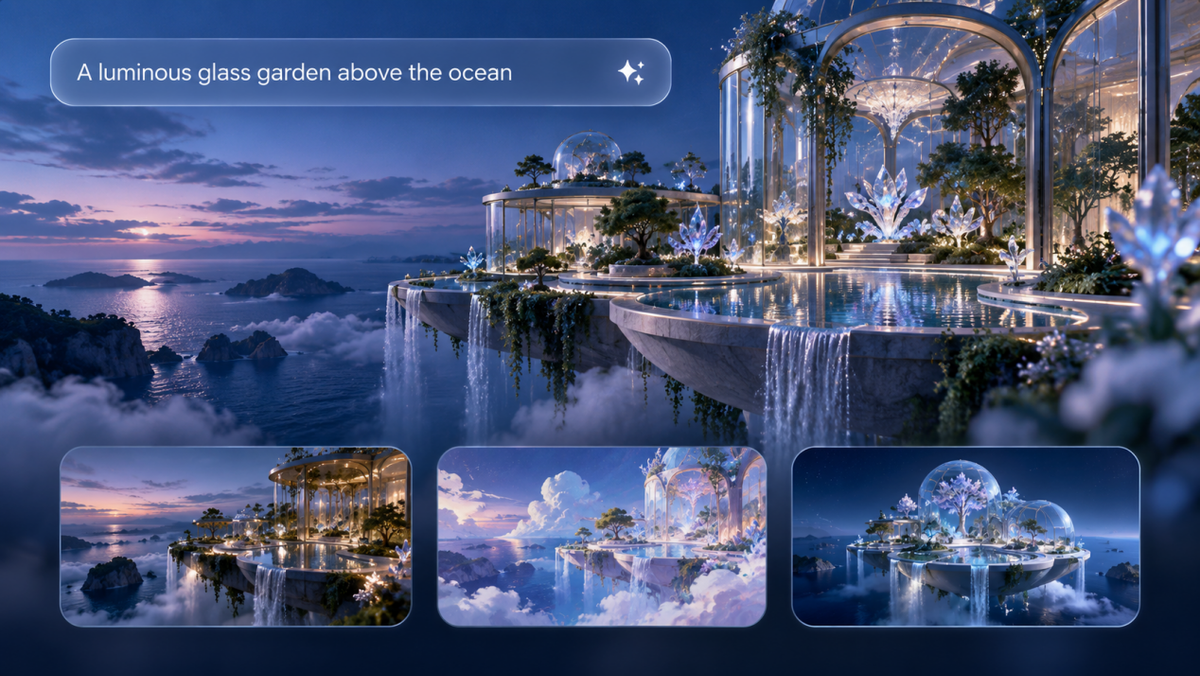
Dysponując jedynie pomysłem lub prostym opisem, modele tekst-na-obraz potrafią przekształcić język naturalny w wizualne koncepcje. Dla twórców najlepsze modele tekst-na-obraz wykraczają poza samo generowanie obrazów. Muszą rozumieć złożone polecenia, zachowywać spójność wizualną i wspierać stopniowe dopracowywanie projektów w czasie. Ten przewodnik wyjaśnia, jak działają modele tekst-na-obraz, porównuje najważniejsze możliwości oraz pokazuje, w jaki sposób Kling IMAGE 3.0 łączy tworzenie na podstawie materiałów referencyjnych, precyzyjną edycję i elastyczne przepływy pracy, aby pomóc twórcom ożywiać ich wizualne pomysły.
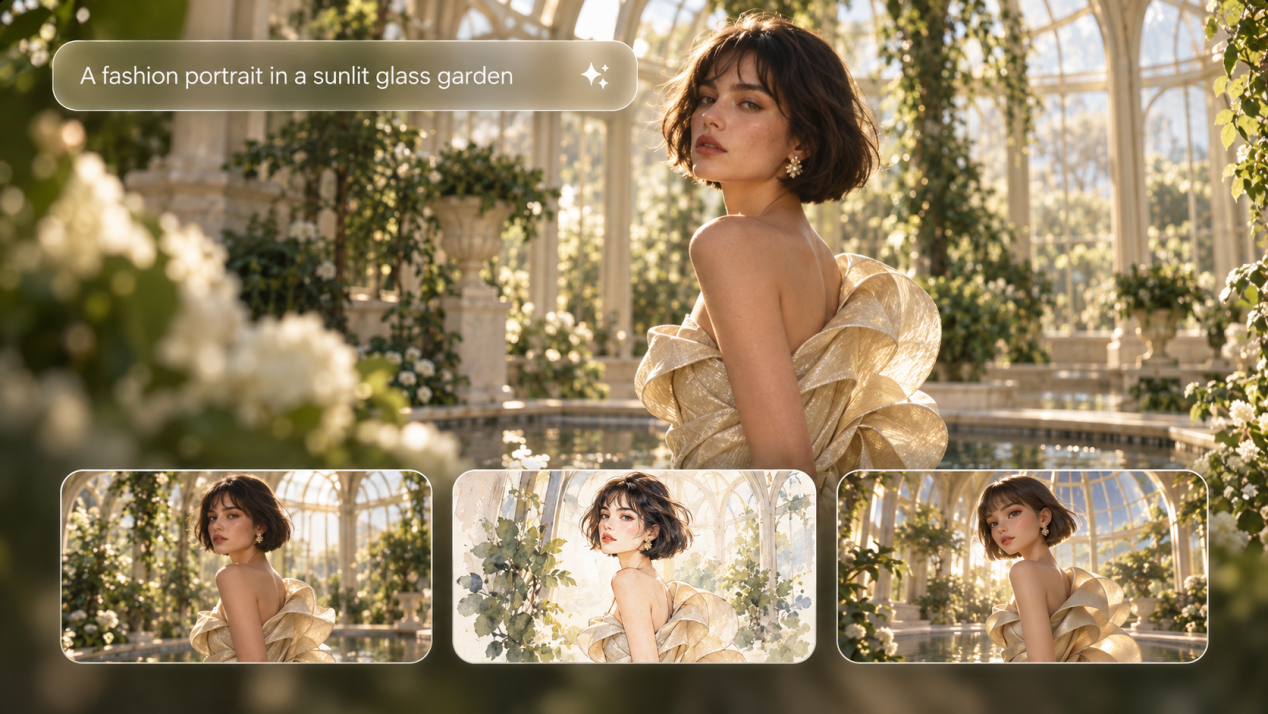
Czym są modele tekst-na-obraz?
Model tekst-na-obraz to rodzaj systemu sztucznej inteligencji, który przekształca polecenia formułowane w języku naturalnym w cyfrowe obrazy na podstawie szczegółów opisanych w poleceniu.
Nowoczesne systemy tekst-do-obrazu zazwyczaj łączą komponent, który rozumie lub koduje prompt, z komponentem generującym obraz, który zamienia te instrukcje w treści wizualne. Niektóre modele potrafią też pracować z obrazami i innymi odniesieniami wizualnymi, co pomaga im podążać za złożonymi promptami, zachowywać ważne szczegóły i wspierać bardziej precyzyjną edycję.
Na przykład rozważmy prompt:
| Polecenie: Zabytkowy aparat fotograficzny ustawiony na drewnianym biurku, na które pada miękkie poranne światło. |
Model musi zrozumieć obiekt, materiał, układ przestrzenny, oświetlenie oraz ogólny styl wizualny, zanim wygeneruje odpowiadający mu obraz.
Dziś ocena modeli tekst-do-obrazu obejmuje więcej niż jakość obrazu. Uwaga przesunęła się w stronę dokładnego rozumienia promptów, obsługi złożonych scen, zachowania spójności wizualnej i wspierania elastycznej edycji.
Jak działają modele tekst-do-obrazu?
Modele text-to-image tłumaczą pisemne opisy na treści wizualne, ucząc się, w jaki sposób język odnosi się do obiektów, stylów, kompozycji i innych szczegółów. Wiele nowoczesnych systemów wykorzystuje metody oparte na dyfuzji, w których prompt prowadzi krok po kroku proces stopniowego przekształcania wizualnego szumu w gotowy obraz.
Proces można zrozumieć w trzech etapach:
1.Nauka tego, jak tekst łączy się z obrazami
Zanim model text-to-image zacznie generować obrazy, uczy się na dużych zbiorach danych zawierających obrazy sparowane z opisami. Podczas treningu identyfikuje wzorce między słowami a szczegółami wizualnymi, obejmującymi obiekty, kolory, kształty, style i relacje przestrzenne. Na przykład model uczy się, w jaki sposób pojęcia takie jak „vintage camera”, „wooden desk” i „soft morning light” są powiązane z określonymi cechami wizualnymi.
2.Zrozumienie promptu
Kiedy wprowadzasz prompt, system tłumaczy twój tekst na format, który potrafi zrozumieć, zachowując podstawowe znaczenie i kontekst. Choć dokładna technologia różni się w zależności od modelu — a systemy komercyjne często ukrywają pełną architekturę — te komponenty tekstowe i wizualne współpracują, aby połączyć twoje słowa z finalnym rezultatem wizualnym.
3.Generowanie obrazu
Wiele nowoczesnych modeli text-to-image używa metod dyfuzji, choć inne modele mogą stosować podejścia autoregresyjne lub odmienne techniki generowania. W systemach opartych na dyfuzji proces zaczyna się od szumu wizualnego i stopniowo usuwa ten szum na podstawie informacji dostarczonych przez prompt. Poprzez powtarzane kroki odszumiania obraz nabiera wyraźniejszych kształtów, detali i stylów odpowiadających opisowi. Niektóre systemy wykonują ten proces w skompresowanej przestrzeni latentnej, zanim zamienią wynik w finalny obraz. Po utworzeniu obrazu można wprowadzić dalsze poprawki, aby dopracować detale lub przygotować go do edycji.
Co wyróżnia modele tekst-do-obrazu?
Modele tekst-do-obrazu mogą odpowiadać na to samo polecenie w bardzo różny sposób. Częściowo wynika to ze sposobu, w jaki generowane są obrazy, a częściowo z rodzaju danych wejściowych, które model potrafi odczytać i wykorzystać.
Architektura generowania
Na poziomie generowania dwoma powszechnymi podejściami są dyfuzja i generowanie autoregresyjne.
Podejście | Jak to działa | Typowe zastosowania |
Modele dyfuzyjne | Zaczynają od szumu wizualnego i stopniowo udoskonalają go w obraz zgodnie z poleceniem. | Szczegółowe tworzenie obrazów, realistyczne sceny, ilustracje oraz prace ukierunkowane na styl. |
Modele autoregresyjne | Tworzą obraz, przewidując kolejno wizualne tokeny lub elementy. | Generowanie obrazów, które buduje treści wizualne sekwencyjnie, zamiast udoskonalać szum. |
Modele dyfuzji pozostają aktywnym obszarem badań nad konwersją tekstu na obraz. Raport z 2023 roku Text-to-image Diffusion Models in Generative AI: A Survey dostarcza użytecznego przeglądu metod tekst-na-obraz opartych na dyfuzji, zbiorów danych, podejść do ewaluacji oraz powiązanych zastosowań.
Wejścia multimodalne
Termin „multimodalny” opisuje rodzaje danych wejściowych, z których model może korzystać, a nie sposób, w jaki generuje obraz. Multimodalny model obrazów może przyjmować tekst, obrazy i odniesienia wizualne, aby tworzyć na podstawie referencji, edytować lub zachowywać spójność postaci i produktów w serii. W warstwie bazowej może nadal korzystać z dyfuzji, generowania autoregresyjnego lub innej metody, więc model może należeć do więcej niż jednej kategorii.
Jakie są najlepsze modele tekst-na-obraz w 2026 roku?
Do tego przewodnika wybraliśmy siedem aktualnych modeli, które reprezentują różne podejścia do generowania obrazów, edycji, tworzenia opartego na referencjach oraz produkcji wizualnej. Kolejność nie jest rankingiem.
Model | Typ modelu | Najlepszy do | Kluczowe funkcje |
Model generowania i edycji obrazów z multimodalnymi wejściami | Tworzenie oparte na referencjach, wizualizacje produktów, postacie i szczegółowe edycje | Generuje na podstawie tekstu lub obrazów, łączy cechy z maksymalnie 10 referencji i obsługuje zachowanie obiektu, precyzyjne edycje oraz kontrolę stylu. IMAGE 3.0 obsługuje generowanie do 2K, podczas gdy IMAGE 3.0 Omni oferuje do 4K. | |
Leonardo Lucid Origin | Model generowania obrazów | Ilustracje, concept art, makiety produktów i ogólne tworzenie obrazów | Obejmuje szeroki zakres stylów, podąża za szczegółowymi poleceniami, generuje obrazy Full HD i obsługuje czytelne renderowanie tekstu. |
Seedream 5.0 Pro | Model do generowania i edycji obrazów | Grafika produktowa, infografiki, zasoby projektowe i lokalne edycje | Działa na podstawie tekstu lub obrazów, przyjmuje materiały referencyjne, obsługuje edycję regionalną i radzi sobie z wielojęzycznymi danymi wejściowymi oraz generowaniem. |
Adobe Firefly Image 5 | Model generowania i edycji obrazów | Produkcja projektów, zasoby marketingowe i projekty oparte na Adobe | Generuje na podstawie tekstu, współpracuje z obrazami referencyjnymi i umożliwia ukierunkowane edycje w Photoshopie, pozostawiając otaczającą zawartość obrazu nienaruszoną. |
Krea 2 Large | Model generowania obrazów | Fotorealizm, praca oparta na stylu i kierunek wizualny | Zoptymalizowany pod kątem ekspresyjnego fotorealizmu, z tworzeniem opartym na promptach i kontrolą kompozycji, tematu oraz stylu kierowaną referencjami. |
Luma UNI-1.1 | Zunifikowany multimodalny model obrazowania | Generowanie i modyfikacja obrazów kierowane referencjami | Łączy generowanie obrazów z edycją w języku naturalnym i akceptuje do dziewięciu referencyjnych danych wejściowych w jednym żądaniu. |
Runway Gen-4 Image | Model generowania obrazów w ramach platformy obrazów i wideo | Rozwój postaci, projektowanie scen oraz projekty, które później przechodzą do wideo | Generuje na podstawie tekstu i obrazów referencyjnych, wykorzystuje do trzech odniesień na jedną generację i potrafi przenosić postacie, obiekty lub cechy wizualne do nowych scen. |
Następna sekcja porównuje te modele pod kątem zgodności z poleceniami, obsługi odniesień, edycji, spójności wizualnej i kontroli stylu.
Jak modele tekst-na-obraz wypadają w 2026 roku?
Modele tekst-na-obraz różnią się przede wszystkim dokładnością wykonywania poleceń, wykorzystaniem odniesień, edycją, spójnością i kontrolą stylu. Różnice te łatwiej zauważyć w projektach obejmujących powtarzające się obrazy, poprawki, produkty lub powracające postacie.
Obszar porównania | Co porównać | Dlaczego to ma znaczenie |
Zgodność z promptem | Podmioty, atrybuty, relacje między obiektami, kompozycja i wymagane szczegóły. | Dopracowany obraz wciąż nie spełnia oczekiwań, jeśli nie spełnia briefu. |
Obsługa referencji | Liczba referencji, zachowanie motywu, transfer stylu i wskazówki dotyczące kompozycji. | Referencje pomagają utrzymać rozpoznawalność postaci, produktu lub kierunku wizualnego w różnych obrazach. |
Edycja obrazu | Zmiany lokalne, edycje w języku naturalnym oraz to, jak dobrze obszary pozostawione bez zmian pozostają nienaruszone. | Precyzyjne edycje oszczędzają czas i pozwalają uniknąć budowania obrazu od zera. |
Spójność wizualna | Postacie, produkty, odzież, styl oraz powtarzające się detale w obrazach lub kolejnych wersjach. | Stabilne detale są ważne dla serii obrazów, kampanii, storyboardów i zestawów produktowych. |
Kontrola stylu | Oświetlenie, paleta, faktura, fotograficzny wygląd, styl ilustracji oraz kierunek wizualny. | Jasna kontrola stylu pomaga utrzymać powiązane obrazy wizualnie spójne. |
Dopasowanie do przepływu pracy | Poprawki, opcje eksportu, wykorzystanie obrazu do wideo i kompatybilność z innymi narzędziami kreatywnymi. | To, co dzieje się po wygenerowaniu, może być równie ważne jak pierwszy obraz. |
Model, który sprawdza się przy szybkich obrazach koncepcyjnych, może nie pasować do serii produktowej lub projektu postaci. Dokładność poleceń i styl mogą wystarczyć w przypadku pojedynczego obrazu, podczas gdy praca powtarzalna często wymaga silniejszych odniesień, edycji i spójności.
Jak wybrać najlepszy model tekst-do-obrazu?
Wybierając generator obrazów AI, zacznij od tego, co chcesz stworzyć i które szczegóły muszą pozostać niezmienione podczas poprawiania obrazu. Poniższa tabela pokazuje, na co zwrócić uwagę w kilku typowych scenariuszach.
Jeśli potrzebujesz | Zwróć uwagę na | Dlaczego to ma znaczenie |
Szybkie obrazy koncepcyjne | Dokładność promptów, jakość obrazu i zakres stylów | Możesz zbliżyć się do zamierzonego rezultatu przy mniejszej liczbie poprawek. |
Spójne postacie lub produkty | Obsługa odniesień i zachowanie szczegółów | Twarze, ubrania, produkty i inne cechy wyróżniające muszą pozostać rozpoznawalne na kolejnych obrazach. |
Częste poprawki obrazów | Lokalna edycja i zmiany w naturalnym języku | Możesz dostosować jedną część obrazu bez przebudowywania całej sceny. |
Zasoby kampanii lub serie obrazów | Stabilne tematy, styl i kompozycja | Powiązane obrazy muszą mieć ten sam kierunek wizualny. |
Obrazy, które później przechodzą w wideo | Obrazy referencyjne i opcje przejścia z obrazu na wideo | Stabilne obiekty i detale wizualne łatwiej przenieść w ruch. |
Dlaczego Kling IMAGE 3.0 jest warte rozważenia?
Kling IMAGE 3.0 pozwala rozpocząć tworzenie od tekstowej podpowiedzi lub obrazów referencyjnych, a następnie dopracować każdy szczegół za pomocą języka naturalnego. Wykraczając poza standardowe generowanie, zapewnia głęboką kontrolę nad spójnością postaci, precyzyjnymi edycjami i dostrajaniem stylu, otwierając nieograniczone możliwości twórcze.
Przekształcaj złożone pomysły w świeże wizualizacje
IMAGE 3.0 pozwala łączyć wskazówki wizualne z wielu odniesień i używać codziennego języka, aby wyjść poza standardowe edycje. Łącz obiekty z różnych obrazów, odwracaj perspektywę sceny lub przenoś koncepcję do zupełnie nowego stylu — wszystko przy zachowaniu spójnego, gładkiego efektu końcowego.
Obraz referencyjny 1 | Obraz referencyjny 2 | Obraz wynikowy |
Polecenie: Połącz zwierzęta z obrazu 1 i obrazu 2. | ||
Zachowaj rozpoznawalność postaci, produktów i kluczowych szczegółów
Możesz użyć do 10 obrazów referencyjnych w jednej generacji. Różne referencje mogą definiować postać, ubiór, produkt, scenerię lub styl, podczas gdy Twój prompt wyjaśnia, w jaki sposób te elementy powinny się ze sobą łączyć. Podczas retuszu portretów referencje twarzy mogą pomóc zachować rozpoznawalne cechy twarzy, gdy zmieniasz fryzurę, strój, pozę lub scenerię. Jeśli chcesz tylko podmienić twarz w istniejącym ujęciu, możesz również od razu przejść do workflowów zamiany twarzy platformy Kling.
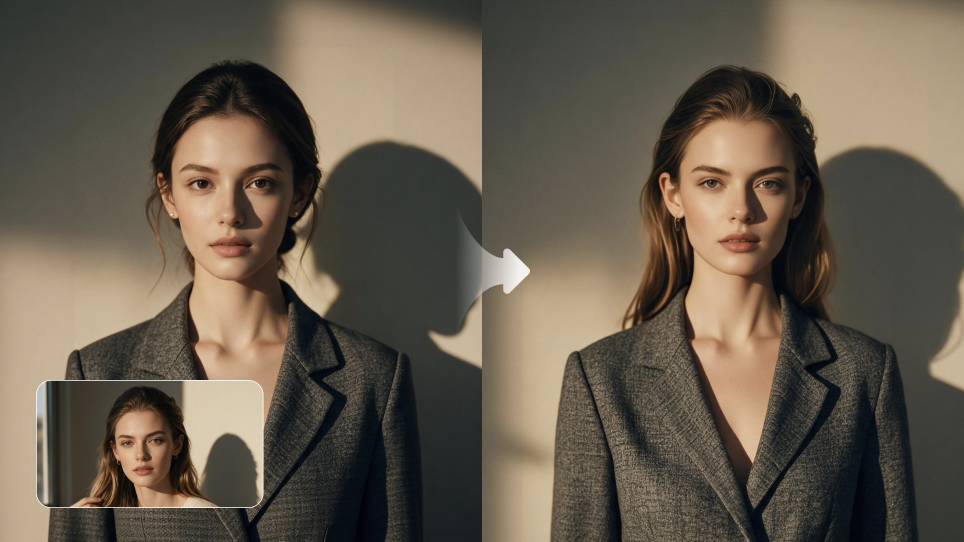
Zmieniaj tylko to, co wymaga zmiany
Jeżeli większość obrazu już wygląda właściwie, możesz użyć Kling IMAGE 3.0 jako edytora zdjęć AI, aby dostosować konkretne detale bez odtwarzania całej sceny. Instrukcje w języku naturalnym mogą zmieniać rozmiar, kolor, materiał, wyraz twarzy lub tło obiektu, jednocześnie starając się zachować otaczające części obrazu. Możesz także użyć Kling AI jako narzędzia do usuwania znaków wodnych w przypadku obrazów, które posiadasz lub do których edycji masz uprawnienia. Do innych modyfikacji należą koloryzacja zdjęć, efekty vintage, edycja rysunków odręcznych, zmiany oświetlenia i tonacji oraz odnawianie obrazów.
Utrzymuj spójny styl i ton w wielu obrazach Jeśli masz już klarowną wizję wizualną, możesz użyć istniejącego obrazu jako odniesienia stylu. Kling IMAGE 3.0 potrafi przenieść do nowych obrazów takie elementy jak pociągnięcia pędzlem, kolor, kompozycję i ton. Dobrze sprawdza się to w zestawach ilustracji, materiałach produktowych lub treściach brandingowych, gdzie ten sam wygląd musi pojawiać się na więcej niż jednym obrazie.
Obraz referencyjny 1 | Obraz referencyjny 2 | Obraz wynikowy |
Polecenie: Zmień styl obrazu 1 na styl obrazu 2 | ||
Koniec
Modele tekst-do-obrazu różnią się tym, w czym są najlepsze, więc właściwy wybór zależy od tego, czego potrzebujesz po wygenerowaniu pierwszego obrazu. Jeśli potrzebujesz jedynie szybkiej koncepcji, dokładność polecenia i jakość obrazu mogą wystarczyć. W przypadku wizualizacji produktów, powtarzających się postaci lub serii obrazów większe znaczenie mają odniesienia, edycja i spójność. Jeśli chcesz zacząć od tekstu lub istniejących wizualizacji, Kling IMAGE 3.0 pozwala łączyć odniesienia, zmieniać konkretne detale i przenosić ten sam wygląd do nowych obrazów. Niezależnie od tego, czy tworzysz kampanię produktową, opracowujesz powtarzającą się postać, czy zamieniasz wczesną koncepcję w gotowy zestaw wizualny, właściwy model powinien ułatwiać zachowanie interesujących Cię szczegółów wraz z rozwojem projektu.
Najczęściej zadawane pytania
Jakiego modelu językowego AI używa się do tworzenia obrazów z tekstu?
Żaden pojedynczy model językowy nie jest używany przez każdy system tekst-na-obraz. Jeśli pytasz, który model językowy AI jest wykorzystywany do możliwości tworzenia tekst-na-obraz, odpowiedź zależy od konkretnego modelu. Niektóre systemy używają enkoderów tekstowych, takich jak CLIP lub T5, podczas gdy inne korzystają z komponentów językowych albo językowo-wizualnych do odczytania promptu, zanim obraz zostanie wygenerowany.
Która AI potrafi zamienić tekst w obraz?
Wiele modeli obrazowych AI potrafi zamienić pisemny prompt w gotowy obraz, w tym Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 oraz Runway Gen-4 Image. Każdy z nich inaczej radzi sobie z promptami, referencjami, edycjami i spójnością wizualną, więc właściwy model zależy od rodzaju obrazu, który chcesz stworzyć.
Czy modele tekst-na-obraz mogą korzystać z obrazów referencyjnych?
Tak. Wiele modeli tekst-na-obraz może korzystać z obrazów referencyjnych obok wpisywanych promptów, co sprawia, że sztuczna inteligencja image-to-image jest przydatna, gdy chcesz pracować na istniejącym materiale wizualnym zamiast zaczynać od zera. Obraz odniesienia może określić takie szczegóły, jak postać, produkt, poza, kompozycja, kolory czy styl, podczas gdy prompt informuje model, co należy zmienić. Kling IMAGE 3.0 może użyć do 10 obrazów referencyjnych w jednej generacji, co jest pomocne, gdy ta sama postać, produkt lub styl wizualny musi pozostać rozpoznawalny.
Jak usunąć tło z obrazu?
Jeśli potrzebujesz bardziej schludnego zdjęcia produktu, zdjęcia profilowego lub zasobu projektowego, możesz usunąć tło z obrazu i pozostawić główny motyw odizolowany. Przezroczyste tło sprawdza się w ofertach produktów, prezentacjach, postach w mediach społecznościowych lub układach, w których motyw musi znaleźć się na innym tle. Po usunięciu sprawdź drobne krawędzie wokół włosów, odzieży, futra lub małych obiektów, a następnie pozostaw tło przezroczyste, zamień je na jednolity kolor albo umieść motyw w nowej scenie.