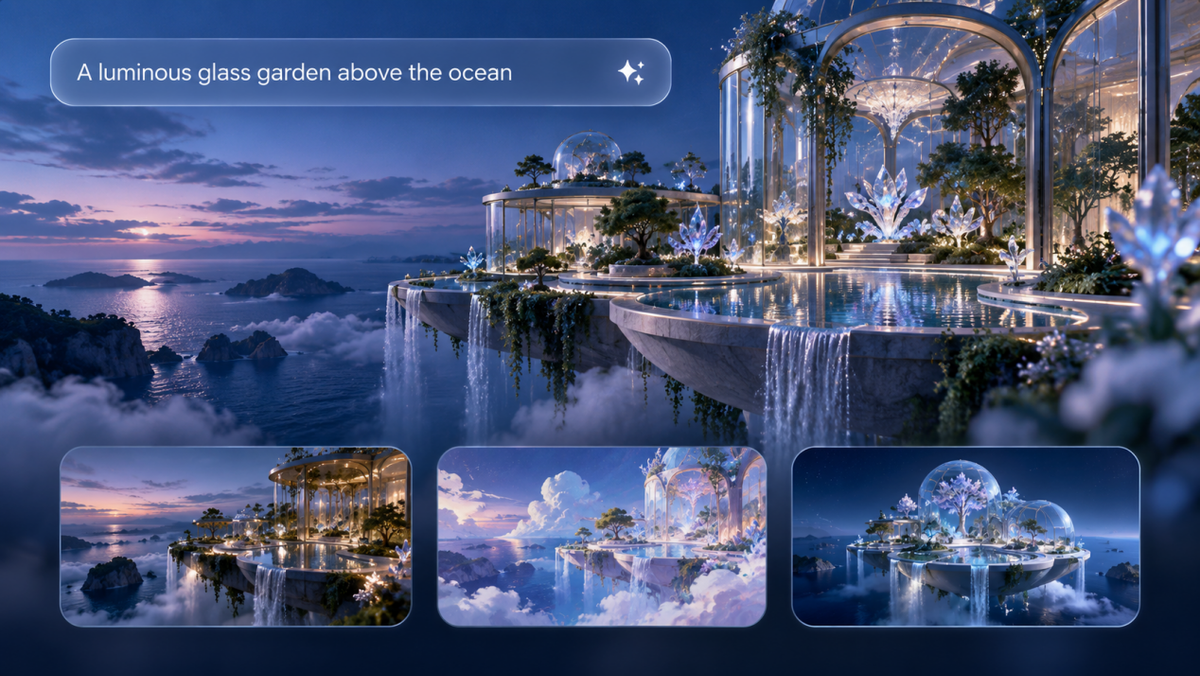
Com apenas uma ideia ou uma descrição simples, os modelos de texto para imagem podem transformar linguagem natural em conceitos visuais. Para criadores, os melhores modelos de texto para imagem vão além da geração de imagens. Eles precisam compreender prompts complexos, preservar a consistência visual e apoiar o refinamento criativo ao longo do tempo. Este guia explica como os modelos de texto para imagem funcionam, compara as capacidades que mais importam e explora como Kling IMAGE 3.0 combina criação baseada em referências, edição precisa e fluxos de trabalho flexíveis para ajudar criadores a dar vida às suas ideias visuais.
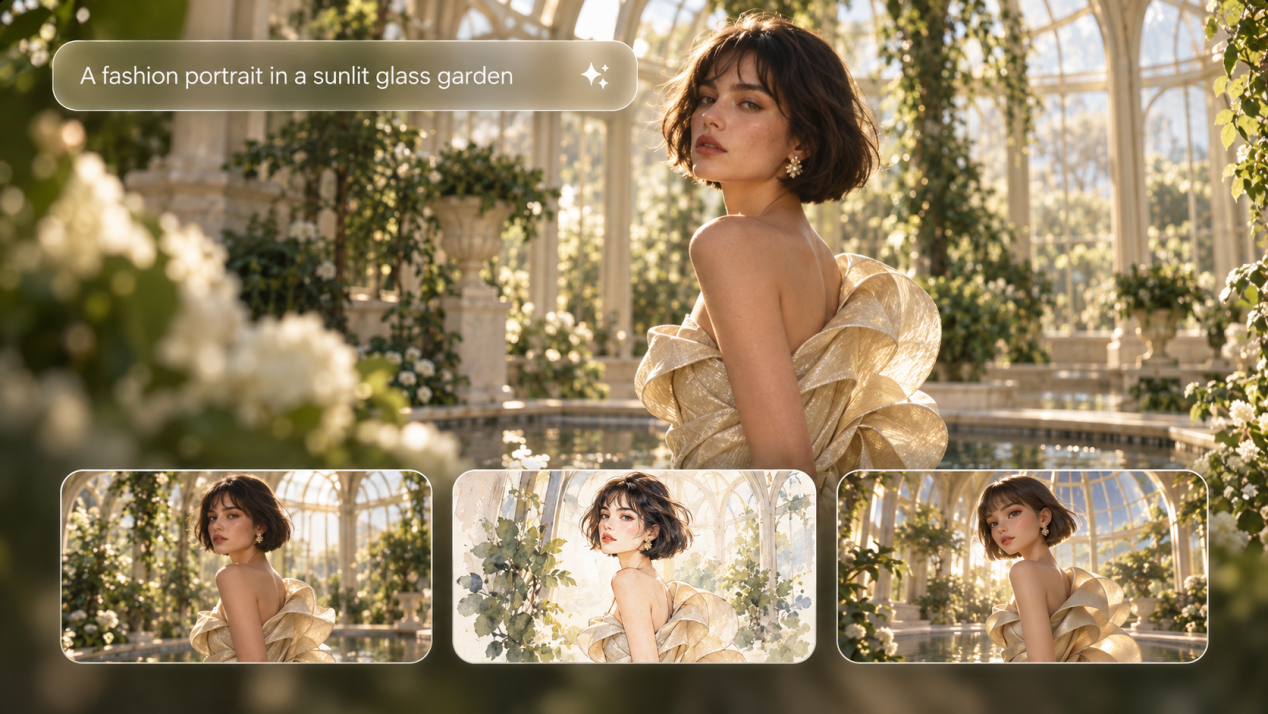
O que são modelos de texto para imagem?
Um modelo de texto para imagem é um tipo de sistema de inteligência artificial que converte prompts de linguagem natural em imagens digitais com base nos detalhes descritos no prompt.
Os sistemas modernos de texto para imagem geralmente combinam um componente que entende ou codifica o prompt com um componente de geração de imagens que transforma essas instruções em conteúdo visual. Alguns modelos também podem trabalhar com imagens e outras referências visuais, ajudando-os a seguir prompts complexos, preservar detalhes importantes e oferecer suporte a uma edição mais precisa.
Por exemplo, considere um prompt:
| Prompt: Uma câmera vintage posicionada sobre uma mesa de madeira, com a luz suave da manhã incidindo sobre a cena. |
O modelo precisa entender o objeto, o material, a disposição espacial, a iluminação e o estilo visual geral antes de produzir a imagem correspondente.
Hoje, avaliar modelos de texto para imagem envolve mais do que a qualidade da imagem. O foco passou para a compreensão precisa do prompt, o tratamento de cenas complexas, a manutenção da consistência visual e o suporte a edições flexíveis.
Como Funcionam os Modelos de Texto para Imagem?
Modelos de texto para imagem traduzem descrições escritas em conteúdo visual ao aprender como a linguagem se relaciona com objetos, estilos, composições e outros detalhes. Muitos sistemas modernos utilizam métodos baseados em difusão, com o prompt orientando um processo passo a passo que gradualmente transforma ruído visual em uma imagem finalizada.
O processo pode ser entendido em três etapas:
1.Aprendendo Como o Texto se Conecta com Imagens
Antes de gerar imagens, um modelo de texto para imagem aprende a partir de grandes conjuntos de dados que contêm imagens emparelhadas com descrições. Durante o treinamento, ele identifica padrões entre palavras e detalhes visuais, incluindo objetos, cores, formas, estilos e relações espaciais. Por exemplo, o modelo aprende como conceitos como “câmera vintage”, “escrivaninha de madeira” e “luz suave da manhã” estão associados a características visuais específicas.
2.Compreendendo o Prompt
Quando insere um prompt, o sistema traduz o seu texto para um formato que consegue compreender, capturando o significado e o contexto essenciais. Embora a tecnologia exata varie consoante o modelo — e os sistemas comerciais muitas vezes mantenham toda a sua arquitetura em segredo — estes componentes de texto e visão trabalham em conjunto para ligar as suas palavras ao resultado visual final.
3. Geração da imagem
Muitos modelos modernos de texto-para-imagem utilizam métodos de difusão, embora outros modelos possam recorrer a abordagens autoregressivas ou diferentes estratégias de geração. Em sistemas baseados em difusão, o processo começa com ruído visual e remove gradualmente esse ruído com base nas informações fornecidas pelo prompt. Através de etapas repetidas de remoção de ruído, a imagem desenvolve formas, detalhes e estilos mais nítidos que correspondem à descrição. Alguns sistemas realizam este processo num espaço latente comprimido antes de converter o resultado na imagem final. Depois de a imagem estar formada, podem ser feitos ajustes adicionais para refinar detalhes ou prepará-la para edição.
O que torna os modelos de texto para imagem diferentes?
Os modelos de texto para imagem podem responder de maneira muito diferente ao mesmo prompt. Parte disso vem da forma como as imagens são geradas, enquanto outra parte vem dos tipos de entrada que o modelo pode ler e usar.
Arquitetura de geração
No nível de geração, duas abordagens comuns são a difusão e a geração autorregressiva.
Abordagem | Como funciona | Usos comuns |
Modelos de difusão | Comece com ruído visual e refine-o gradualmente em uma imagem guiada pelo prompt. | Geração de imagens detalhadas, cenas realistas, ilustração e trabalho orientado pelo estilo. |
Modelos autorregressivos | Construa uma imagem prevendo tokens visuais ou elementos em sequência. | Geração de imagens que constrói conteúdo visual em sequência em vez de refinar o ruído. |
Os modelos de difusão continuam sendo uma área ativa de pesquisa em texto para imagem. A pesquisa de 2023 Text-to-image Diffusion Models in Generative AI: A Survey fornece uma visão geral útil de métodos texto para imagem baseados em difusão, conjuntos de dados, abordagens de avaliação e aplicações relacionadas.
Entradas multimodais
Multimodal descreve os tipos de entrada que um modelo pode usar, em vez de como ele gera uma imagem. Um modelo de imagem multimodal pode receber texto, imagens e referências visuais para criação baseada em referência, edição ou manter personagens e produtos consistentes ao longo de uma série. Por baixo, ele ainda pode usar difusão, geração autorregressiva ou outro método, portanto um modelo pode se enquadrar em mais de uma categoria.
Quais são os melhores modelos de texto para imagem em 2026?
Para este guia, selecionamos sete modelos atuais que representam diferentes abordagens de geração de imagens, edição, criação baseada em referência e produção visual. A ordem não é um ranking.
Modelo | Tipo de Modelo | Melhor Para | Principais Recursos |
Modelo de geração e edição de imagens com entradas multimodais | Criação baseada em referências, visuais de produtos, personagens e edições detalhadas | Gera a partir de texto ou imagens, combina características de até 10 referências e suporta retenção do sujeito, edições precisas e controle de estilo. IMAGE 3.0 suporta geração de até 2K, enquanto IMAGE 3.0 Omni oferece até 4K. | |
Leonardo Lucid Origin | Modelo de geração de imagens | Ilustração, concept art, mockups de produtos e criação geral de imagens | Cobre uma ampla gama de estilos, segue prompts detalhados, produz imagens Full HD e oferece suporte à renderização de texto legível. |
Seedream 5.0 Pro | Modelo de geração e edição de imagens | Imagens de produtos, infográficos, recursos de design e edições locais | Funciona a partir de texto ou imagens, aceita referências, oferece suporte a edições regionais e lida com entrada e geração multilíngue. |
Adobe Firefly Image 5 | Modelo de geração e edição de imagens | Produção de design, ativos de marketing e projetos baseados em Adobe | Gera a partir de texto, trabalha com imagens de referência e permite edições direcionadas no Photoshop mantendo intacto o conteúdo da imagem ao redor. |
Krea 2 Large | Modelo de geração de imagens | Fotorrealismo, trabalho orientado por estilo e direção visual. | Otimizado para fotorealismo expressivo, com criação baseada em prompts e controle orientado por referências sobre composição, tema e estilo. |
Luma UNI-1.1 | Modelo de imagem multimodal unificado | Geração guiada por referências e revisão de imagem | Combina geração de imagens com edição em linguagem natural e aceita até nove entradas de referência em uma solicitação. |
Runway Gen-4 Image | Modelo de geração de imagens dentro de uma plataforma de imagens e vídeos | Desenvolvimento de personagens, design de cenas e projetos que depois migram para vídeo | Gera a partir de texto e imagens de referência, usa até três referências por geração e consegue levar personagens, objetos ou traços visuais para novas cenas. |
A próxima seção compara esses modelos quanto à aderência ao prompt, ao uso de referências, à edição, à consistência visual e ao controle de estilo.
Como os modelos de texto para imagem se comparam em 2026?
Os modelos de texto para imagem diferem principalmente em precisão do prompt, uso de referências, edição, consistência e controle de estilo. Essas diferenças são mais fáceis de notar em projetos que envolvem imagens repetidas, revisões, produtos ou personagens recorrentes.
Área de comparação | O que comparar | Por que isso importa |
Aderência ao prompt | Sujeitos, atributos, relações entre objetos, composição e detalhes necessários. | Uma imagem refinada ainda fica aquém se não atender ao briefing. |
Tratamento de Referências | Número de referências, retenção do assunto, transferência de estilo e orientação de composição. | As referências ajudam a manter um personagem, produto ou direção visual reconhecível em todas as imagens. |
Edição de Imagens | Alterações locais, edições em linguagem natural e o quão bem as áreas intocadas permanecem intactas. | Edições precisas economizam tempo e evitam reconstruir a imagem do zero. |
Consistência visual | Personagens, produtos, vestuário, estilo e detalhes recorrentes em imagens ou revisões. | Detalhes estáveis são importantes para séries de imagens, campanhas, storyboards e conjuntos de produtos. |
Controle de estilo | Iluminação, paleta, textura, aparência fotográfica, estilo de ilustração e direção visual. | Um controle de estilo claro ajuda a manter imagens relacionadas visualmente conectadas. |
Ajuste ao fluxo de trabalho | Revisões, opções de exportação, uso de imagem para vídeo e compatibilidade com outras ferramentas criativas. | O que acontece após a geração pode ser tão importante quanto a primeira imagem. |
Um modelo que funciona bem para imagens conceituais rápidas pode não servir para uma série de produtos ou um projeto de personagens. Precisão do prompt e estilo podem ser suficientes para uma única imagem, enquanto trabalhos repetidos geralmente exigem referências mais fortes, edição e consistência.
Como escolher o melhor modelo de texto para imagem?
Ao escolher um gerador de imagens de IA, comece pelo que você quer criar e quais detalhes precisam permanecer inalterados enquanto revisa a imagem. A tabela abaixo mostra o que observar em vários cenários comuns.
Se Você Precisar | Procure | Por que Isso Importa |
Imagens conceituais rápidas | Precisão do prompt, qualidade da imagem e variedade de estilos | Você pode chegar mais perto do resultado desejado com menos revisões. |
Personagens ou produtos consistentes | Gestão de referências e retenção de detalhes | Rostos, roupas, produtos e outros elementos definidores precisam permanecer reconhecíveis em todas as imagens. |
Revisões frequentes de imagens | Edição localizada e alterações em linguagem natural | Você pode ajustar uma parte da imagem sem reconstruir toda a cena. |
Ativos de campanha ou séries de imagens | Assuntos estáveis, estilo e composição | Imagens relacionadas precisam compartilhar a mesma direção visual. |
Imagens que depois passam para vídeo | Imagens de referência e opções de imagem para vídeo | Assuntos estáveis e detalhes visuais são mais fáceis de levar para o movimento. |
Por que vale a pena considerar o Kling IMAGE 3.0?
Kling IMAGE 3.0 permite dar início a criações com um prompt de texto ou imagens de referência, e depois ajustar cada detalhe usando linguagem natural. Além da geração padrão, oferece controle profundo sobre a consistência dos personagens, edições precisas e ajuste de estilo, abrindo infinitas possibilidades criativas.
Transforme ideias complexas em visuais inéditos
O IMAGE 3.0 permite combinar pistas visuais de várias referências e usar linguagem cotidiana para ir além das edições padrão. Combine sujeitos entre imagens, inverta a perspectiva de uma cena ou leve um conceito para um estilo totalmente novo — tudo isso mantendo o resultado final fluido e coeso.
Imagem de referência 1 | Imagem de referência 2 | Imagem de saída |
Prompt: Una os animais da imagem 1 e da imagem 2. | ||
Mantenha os personagens, produtos e detalhes principais reconhecíveis
Você pode usar até 10 imagens de referência em uma única geração. Referências diferentes podem definir um character, roupas, produto, ambiente ou estilo, enquanto seu prompt explica como esses elementos devem se unir. Para retoques em retratos, referências de rosto podem ajudar a preservar traços faciais reconhecíveis enquanto você altera o penteado, a roupa, a pose ou o cenário. Se você quiser apenas trocar um rosto em uma tomada existente, também pode ir direto para os fluxos de trabalho de face swap da Kling.
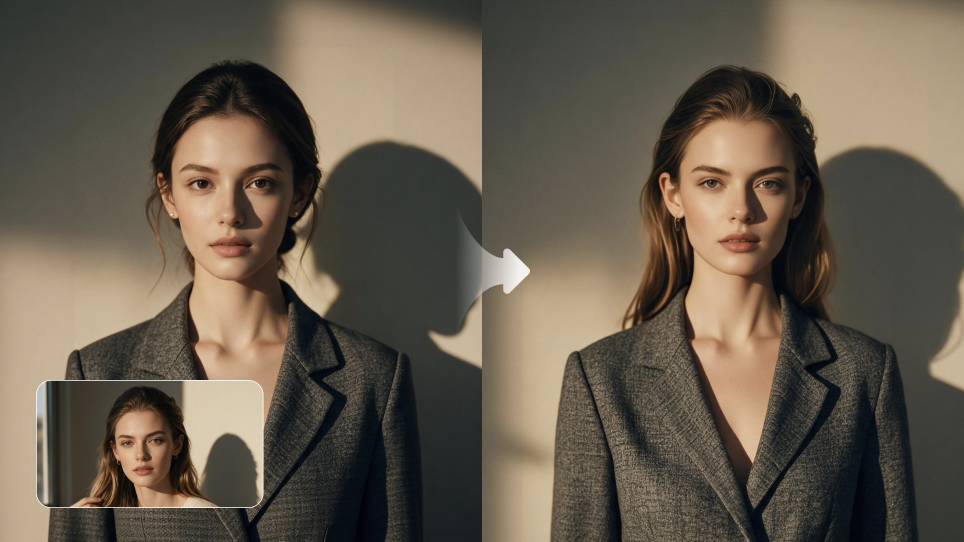
Altere apenas o que precisa ser alterado
Se a maior parte de uma imagem já parece correta, você pode usar Kling IMAGE 3.0 como um editor de fotos com IA para ajustar detalhes específicos sem reconstruir toda a cena. Instruções em linguagem natural podem alterar o tamanho, a cor, o material, a expressão ou o fundo de um objeto, procurando preservar as partes ao redor da imagem. Você também pode usar Kling AI como um removedor de marcas d'água para imagens das quais você é proprietário ou tem permissão para editar. Outras edições incluem colorização de fotos, efeitos vintage, edições de doodles, ajustes de iluminação e de tom, e restauração de imagens.
Mantenha estilo e tom consistentes entre as imagens Se você já tiver uma direção visual clara, pode usar uma imagem existente como referência de estilo. Kling IMAGE 3.0 pode transportar elementos como pinceladas, cor, composição e tom para novas imagens. Isso funciona bem para conjuntos de ilustrações, visuais de produtos ou conteúdo de marca em que o mesmo visual precisa aparecer em mais de uma imagem.
Imagem de referência 1 | Imagem de referência 2 | Imagem de saída |
Prompt: Altere o estilo da Imagem 1 para o da Imagem 2 | ||
O fim
Os modelos de texto para imagem diferem naquilo que fazem melhor, portanto, a escolha certa depende do que você precisa depois que a primeira imagem é gerada. Se você só precisa de um conceito rápido, a precisão do prompt e a qualidade da imagem podem ser suficientes. Para visuais de produto, personagens recorrentes ou séries de imagens, referências, edição e consistência importam mais. Se você quiser começar a partir de texto ou de visuais existentes, Kling IMAGE 3.0 permite combinar referências, alterar detalhes específicos e levar a mesma aparência para novas imagens. Esteja você construindo uma campanha de produto, desenvolvendo um personagem recorrente ou transformando um conceito inicial em um conjunto visual finalizado, o modelo certo deve facilitar a manutenção dos detalhes que importam para você à medida que o projeto cresce.
Perguntas frequentes
Qual modelo de linguagem de IA é usado para criação de texto para imagem?
Nenhum modelo de linguagem único é utilizado por todos os sistemas texto para imagem. Se você está perguntando qual modelo de linguagem de IA é usado para as capacidades de criação texto para imagem, a resposta varia conforme o modelo. Alguns sistemas usam codificadores de texto como CLIP ou T5, enquanto outros recorrem a componentes de linguagem ou de visão e linguagem para interpretar o prompt antes que a imagem seja gerada.
Qual IA pode transformar texto em imagem?
Muitos modelos de imagem de IA conseguem transformar um prompt escrito em uma imagem final, incluindo Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 e Runway Gen-4 Image. Cada um lida com prompts, referências, edições e consistência visual de maneiras distintas, portanto o modelo certo depende do tipo de imagem que você precisa criar.
Modelos de texto para imagem podem usar imagens de referência?
Sim. Muitos modelos de texto para imagem podem usar imagens de referência junto com prompts escritos, o que torna a IA de imagem para imagem útil quando você quer trabalhar a partir de um visual existente em vez de começar do zero. A referência pode estabelecer detalhes como o personagem, produto, pose, composição, cores ou estilo, enquanto o prompt indica ao modelo o que alterar. Kling IMAGE 3.0 pode usar até 10 imagens de referência em uma geração, o que é útil quando é preciso manter reconhecível o mesmo personagem, produto ou estilo visual.
Como removo o fundo de uma imagem?
Se precisar de uma foto de produto mais limpa, imagem de perfil ou ativo de design, pode remover o fundo de uma imagem e manter o assunto principal isolado. Um fundo transparente funciona bem para listagens de produtos, apresentações, publicações nas redes sociais ou layouts em que o assunto precisa estar sobre um fundo diferente. Depois da remoção, verifique as bordas finas em torno do cabelo, da roupa, do pelo ou de pequenos objetos e, em seguida, mantenha o fundo transparente, altere para uma cor sólida ou coloque o assunto numa nova cena.