Mit nur einer Idee oder einer einfachen Beschreibung können Text-to-Image-Modelle natürliche Sprache in visuelle Konzepte verwandeln. Für Kreative geht es bei den besten Text-to-Image-Modellen über die reine Bildgenerierung hinaus. Sie müssen komplexe Prompts verstehen, visuelle Konsistenz bewahren und über die Zeit kreative Verfeinerungen unterstützen. Dieser Leitfaden erklärt, wie Text-to-Image-Modelle funktionieren, vergleicht die wichtigsten Fähigkeiten und zeigt, wie Kling IMAGE 3.0 referenzbasierte Erstellung, präzise Bearbeitung und flexible Workflows kombiniert, um Kreativen zu helfen, ihre visuellen Ideen zum Leben zu erwecken.
Was sind Text-to-Image-Modelle?
Ein Text-to-Image-Modell ist eine Art künstliches Intelligenzsystem, das natürliche Sprachprompts in digitale Bilder umwandelt, basierend auf den im Prompt beschriebenen Details.
Moderne Text-zu-Bild-Systeme kombinieren typischerweise eine Komponente, die den Prompt versteht oder encodiert, mit einer Bildgenerierungskomponente, die diese Anweisungen in visuelle Inhalte umsetzt. Einige Modelle können außerdem mit Bildern und anderen visuellen Referenzen arbeiten, wodurch sie komplexen Prompts folgen, wichtige Details bewahren und präzisere Bearbeitungen unterstützen können.
Betrachten Sie beispielsweise einen Prompt:
| Prompt: Eine Vintage-Kamera, die auf einem hölzernen Schreibtisch steht, während weiches Morgenlicht über die Szene fällt. |
Das Modell muss das Objekt, das Material, die räumliche Anordnung, die Beleuchtung und den gesamten visuellen Stil verstehen, bevor es das entsprechende Bild erzeugt.
Heute umfasst die Bewertung von Text-zu-Bild-Modellen mehr als nur die Bildqualität. Der Schwerpunkt hat sich auf ein präzises Verständnis der Prompts, den Umgang mit komplexen Szenen, die Wahrung visueller Konsistenz und die Unterstützung flexibler Bearbeitung verschoben.
Wie funktionieren Text-zu-Bild-Modelle?
Text-zu-Bild-Modelle übersetzen schriftliche Beschreibungen in visuelle Inhalte, indem sie lernen, wie Sprache sich auf Objekte, Stile, Kompositionen und andere Details bezieht. Viele moderne Systeme verwenden Diffusionsverfahren, bei denen der Prompt einen schrittweisen Prozess steuert, der visuelles Rauschen nach und nach in ein fertiges Bild verwandelt.
Der Prozess lässt sich in drei Phasen gliedern:
1.Lernen, wie Text mit Bildern zusammenhängt
Bevor Bilder erzeugt werden, lernt ein Text-zu-Bild-Modell aus großen Datensätzen, die Bilder mit Beschreibungen koppeln. Während des Trainings identifiziert es Muster zwischen Wörtern und visuellen Details, darunter Objekte, Farben, Formen, Stile und räumliche Beziehungen. So lernt das Modell beispielsweise, wie Konzepte wie „Vintage-Kamera“, „Holzschreibtisch“ und „weiches Morgenlicht“ mit bestimmten visuellen Merkmalen verbunden sind.
2.Den Prompt verstehen
Wenn Sie eine Eingabeaufforderung eingeben, übersetzt das System Ihren Text in ein Format, das es verstehen kann, wobei es die Kernbedeutung und den Kontext erfasst. Auch wenn die genaue Technologie je nach Modell variiert – und kommerzielle Systeme ihre vollständige Architektur häufig unter Verschluss halten – arbeiten diese Text- und Bildkomponenten zusammen, um Ihre Worte mit dem endgültigen visuellen Ergebnis zu verbinden.
3. Erzeugung des Bildes
Viele moderne Text-zu-Bild-Modelle verwenden Diffusionsmethoden, obwohl andere Modelle autoregressive oder andere Generierungsansätze nutzen können. In diffusionsbasierten Systemen beginnt der Prozess mit visuellem Rauschen und entfernt dieses Rauschen schrittweise auf Grundlage der Informationen aus der Eingabeaufforderung. Durch wiederholte Entrauschungsschritte entwickeln sich klarere Formen, Details und Stile, die der Beschreibung entsprechen. Einige Systeme führen diesen Prozess in einem komprimierten latenten Raum durch, bevor sie das Ergebnis in das endgültige Bild umwandeln. Nachdem das Bild entstanden ist, können weitere Anpassungen vorgenommen werden, um Details zu verfeinern oder es für die Bearbeitung vorzubereiten.
Was unterscheidet Text-zu-Bild-Modelle?
Text-zu-Bild-Modelle können auf denselben Prompt sehr unterschiedlich reagieren. Ein Teil davon ergibt sich aus der Art und Weise, wie Bilder erzeugt werden, während ein anderer Teil von den Eingabearten abhängt, die das Modell lesen und nutzen kann.
Generierungsarchitektur
Auf der Ebene der Generierung sind zwei gängige Ansätze die Diffusion und die autoregressive Generierung.
Ansatz | Funktionsweise | Häufige Anwendungsfälle |
Diffusionsmodelle | Beginnen Sie mit visuellem Rauschen und verfeinern Sie es schrittweise zu einem Bild, das durch den Prompt geleitet wird. | Detaillierte Bildgenerierung, realistische Szenen, Illustrationen und stilorientierte Arbeiten. |
Autoregressive Modelle | Erstellen Sie ein Bild, indem Sie visuelle Tokens oder Elemente der Reihe nach vorhersagen. | Bildgenerierung, die visuelle Inhalte der Reihe nach aufbaut, statt Rauschen zu verfeinern. |
Diffusionsmodelle bleiben ein aktives Forschungsfeld für Text-zu-Bild. Die Umfrage von 2023 Text-to-image Diffusion Models in Generative AI: A Survey bietet einen hilfreichen Überblick über diffusionsbasierte Text-zu-Bild-Methoden, Datensätze, Bewertungsansätze und verwandte Anwendungen.
Multimodale Eingaben
Multimodal beschreibt die Arten von Eingaben, die ein Modell verwenden kann, statt wie es ein Bild erzeugt. Ein multimodales Bildmodell kann Text, Bilder und visuelle Referenzen für referenzbasierte Erstellung, Bearbeitung oder zur Wahrung der Konsistenz von Charakteren und Produkten über eine Serie hinweg nutzen. Unter der Haube kann es dennoch Diffusion, autoregressive Generierung oder eine andere Methode verwenden, sodass ein Modell in mehr als eine Kategorie fallen kann.
Was sind die besten Text-zu-Bild-Modelle im Jahr 2026?
Für diesen Leitfaden haben wir sieben aktuelle Modelle ausgewählt, die verschiedene Ansätze zur Bildgenerierung, Bearbeitung, referenzbasierten Erstellung und visuellen Produktion repräsentieren. Die Reihenfolge stellt keine Rangliste dar.
Modell | Modelltyp | Am besten geeignet für | Wichtigste Funktionen |
Modell zur Bildgenerierung und -bearbeitung mit multimodalen Eingaben | Referenzbasierte Erstellung, Produktvisuals, Charaktere und detaillierte Bearbeitungen | Generiert aus Text oder Bildern, kombiniert Merkmale aus bis zu 10 Referenzen und unterstützt Motivtreue, präzise Bearbeitungen und Stilkontrolle. IMAGE 3.0 unterstützt Generationen bis zu 2K, während IMAGE 3.0 Omni bis zu 4K bietet. | |
Leonardo Lucid Origin | Modell zur Bildgenerierung | Illustrationen, Konzeptkunst, Produkt-Mockups und allgemeine Bildgestaltung | Deckt eine breite Palette an Stilen ab, folgt detaillierten Prompts, erzeugt Full-HD-Bilder und unterstützt lesbare Textdarstellung. |
Seedream 5.0 Pro | Modell für Bildgenerierung und -bearbeitung | Produktbilder, Infografiken, Design-Assets und lokale Bearbeitungen | Arbeitet mit Texten oder Bildern, akzeptiert Referenzen, unterstützt regionale Bearbeitungen und verarbeitet mehrsprachige Eingaben und Ausgaben. |
Adobe Firefly Image 5 | Modell zur Bildgenerierung und -bearbeitung | Designproduktion, Marketing-Assets und Adobe-basierte Projekte | Generiert aus Text, arbeitet mit Referenzbildern und erlaubt gezielte Bearbeitungen in Photoshop, während der umgebende Bildinhalt intakt bleibt. |
Krea 2 Large | Modell zur Bildgenerierung | Fotorealismus, stilgeleitete Arbeiten und visuelle Leitung | Optimiert für ausdrucksstarken Fotorealismus, mit promptbasierter Erstellung und referenzgesteuerter Kontrolle über Komposition, Motiv und Stil. |
Luma UNI-1.1 | Einheitliches multimodales Bildmodell | Referenzgesteuerte Generierung und Bildüberarbeitung | Kombiniert Bildgenerierung mit Bearbeitung in natürlicher Sprache und akzeptiert bis zu neun Referenzeingaben pro Anfrage. |
Runway Gen-4 Image | Bildgenerierungsmodell innerhalb einer Bild- und Videoplattform | Charakterentwicklung, Szenengestaltung und Projekte, die später in Video übergehen | Erzeugt aus Text und Referenzbildern, verwendet bis zu drei Referenzen pro Generierung und kann Charaktere, Objekte oder visuelle Merkmale in neue Szenen übertragen. |
Der nächste Abschnitt vergleicht diese Modelle hinsichtlich Prompt-Umsetzung, Umgang mit Referenzen, Bearbeitung, visueller Konsistenz und Stilkontrolle.
Wie schneiden Text-zu-Bild-Modelle im Jahr 2026 im Vergleich ab?
Text-zu-Bild-Modelle unterscheiden sich vor allem in Prompt-Genauigkeit, Referenznutzung, Bearbeitung, Konsistenz und Stilkontrolle. Diese Unterschiede lassen sich leichter in Projekten erkennen, die wiederholte Bilder, Überarbeitungen, Produkte oder wiederkehrende Charaktere umfassen.
Vergleichsbereich | Was vergleichen | Warum das wichtig ist |
Prompt-Befolgung | Subjekte, Attribute, Objektbeziehungen, Komposition und erforderliche Details. | Ein poliertes Bild bleibt dennoch unzureichend, wenn es das Briefing verfehlt. |
Referenzverwaltung | Anzahl der Referenzen, Motivtreue, Stiltransfer und Kompositionsführung. | Referenzen helfen, eine Figur, ein Produkt oder eine visuelle Richtung über mehrere Bilder hinweg wiedererkennbar zu halten. |
Bildbearbeitung | Lokale Änderungen, Bearbeitungen in natürlicher Sprache und wie gut unberührte Bereiche intakt bleiben. | Präzise Bearbeitungen sparen Zeit und vermeiden, dass das Bild komplett neu aufgebaut werden muss. |
Visuelle Konsistenz | Figuren, Produkte, Kleidung, Stil und wiederkehrende Details über Bilder oder Überarbeitungen hinweg. | Stabile Details sind wichtig für Bildserien, Kampagnen, Storyboards und Produktsets. |
Stilkontrolle | Beleuchtung, Palette, Textur, fotografischer Look, Illustrationsstil und visuelle Ausrichtung. | Klare Stilkontrolle hilft dabei, verwandte Bilder visuell verbunden zu halten. |
Workflow-Eignung | Überarbeitungen, Exportoptionen, die Nutzung von Bild-zu-Video und die Kompatibilität mit anderen Kreativtools. | Was nach der Generierung passiert, kann genauso wichtig sein wie das erste Bild. |
Ein Modell, das für schnelle Konzeptbilder gut funktioniert, eignet sich möglicherweise nicht für eine Produktserie oder ein Charakterprojekt. Die Genauigkeit der Prompts und der Stil können für ein einzelnes Bild ausreichen, während wiederholte Arbeiten häufig stärkere Referenzen, Bearbeitung und mehr Konsistenz erfordern.
Wie wählen Sie das beste Text-zu-Bild-Modell aus?
Wenn Sie einen KI-Bildgenerator, auswählen, beginnen Sie damit, was Sie erstellen möchten und welche Details beim Überarbeiten des Bildes unverändert bleiben müssen. Die Tabelle unten zeigt, worauf Sie in mehreren typischen Szenarien achten sollten.
Wenn Sie Folgendes benötigen | Suchen Sie nach | Warum es wichtig ist |
Schnelle Konzeptbilder | Prompt-Genauigkeit, Bildqualität und Stilbandbreite | Sie können mit weniger Überarbeitungen näher an das gewünschte Ergebnis herankommen. |
Konsistente Charaktere oder Produkte | Referenzhandhabung und Detailerhalt | Gesichter, Kleidung, Produkte und andere prägende Merkmale müssen in allen Bildern erkennbar bleiben. |
Häufige Bildüberarbeitungen | Lokale Bearbeitung und Änderungen in natürlicher Sprache | Sie können einen Teil des Bildes anpassen, ohne die gesamte Szene neu aufzubauen. |
Kampagnen-Assets oder Bildserien | Stabile Motive, Stil und Komposition | Verwandte Bilder müssen dieselbe visuelle Richtung teilen. |
Bilder, die später in Videos übergehen | Referenzbilder und Bild-zu-Video-Optionen | Stabile Motive und visuelle Details lassen sich leichter in Bewegung übertragen. |
Warum lohnt es sich, Kling IMAGE 3.0 in Betracht zu ziehen?
Kling IMAGE 3.0 ermöglicht es dir, Kreationen mit einem Texteingabebefehl oder Referenzbildern zu starten und dann jedes Detail mit natürlicher Sprache feinabzustimmen. Über die Standardgenerierung hinaus bietet es dir umfassende Kontrolle über die Konsistenz von Figuren, präzise Bearbeitungen und Stilabstimmungen und eröffnet damit endlose kreative Möglichkeiten.
Verwandle komplexe Ideen in frische Visualisierungen
IMAGE 3.0 ermöglicht es dir, visuelle Hinweise aus mehreren Referenzen zu kombinieren und alltägliche Sprache zu verwenden, um über Standardbearbeitungen hinauszugehen. Kombiniere Motive über mehrere Bilder hinweg, kehre die Perspektive einer Szene um oder verlagere ein Konzept in einen völlig neuen Stil – und behalte dabei ein nahtloses, stimmiges Endergebnis.
Referenzbild 1 | Referenzbild 2 | Ausgabebild |
Prompt: Vereine die Tiere aus Bild 1 und Bild 2. | ||
Halte Figuren, Produkte und wichtige Details erkennbar
Sie können in einer Generation bis zu 10 Referenzbilder verwenden. Verschiedene Referenzen können einen Charakter, die Kleidung, ein Produkt, das Setting oder den Stil definieren, während Ihr Prompt erklärt, wie diese Elemente zusammenkommen sollen. Für Porträt-Retuschen können Gesichtsreferenzen helfen, erkennbare Gesichtszüge zu bewahren, während Sie die Frisur, das Outfit, die Pose oder das Setting ändern. Wenn Sie lediglich ein Gesicht in eine bestehende Aufnahme tauschen möchten, können Sie auch direkt in die face swap -Workflows von Kling einsteigen.
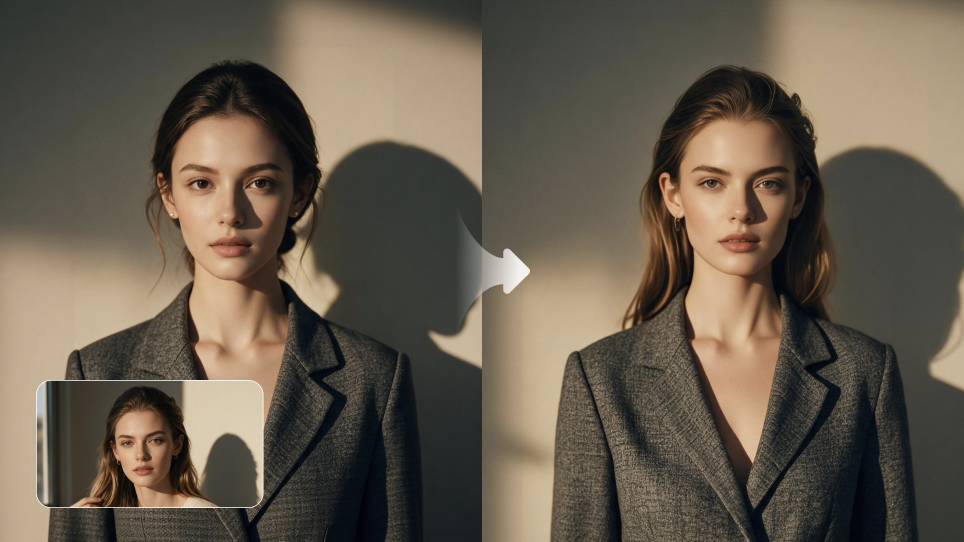
Ändern Sie nur, was geändert werden muss
Wenn der Großteil eines Bildes bereits richtig aussieht, können Sie Kling IMAGE 3.0 als KI-Fotobearbeitungsprogramm verwenden, um bestimmte Details anzupassen, ohne die gesamte Szene neu aufzubauen. Anweisungen in natürlicher Sprache können die Größe, Farbe, das Material, den Ausdruck oder den Hintergrund eines Objekts verändern, wobei angestrebt wird, die umliegenden Bildbereiche zu erhalten. Sie können Kling AI auch als Wasserzeichen-Entferner für Bilder einsetzen, die Ihnen gehören oder zu deren Bearbeitung Sie berechtigt sind. Weitere Bearbeitungen umfassen die Kolorierung von Fotos, Retro-Effekte, Kritzelbearbeitungen, Licht- und Tonwertanpassungen sowie die Restaurierung von Bildern.
Stil und Ton über mehrere Bilder hinweg konsistent halten Wenn Sie bereits eine klare visuelle Richtung haben, können Sie ein vorhandenes Bild als Stilreferenz verwenden. Kling IMAGE 3.0 kann Elemente wie Pinselstriche, Farbe, Komposition und Stimmung in neue Bilder übertragen. Das funktioniert gut für Illustrationsreihen, Produktvisualisierungen oder Markeninhalte, bei denen derselbe Look in mehr als einem Bild erscheinen muss.
Referenzbild 1 | Referenzbild 2 | Ausgabebild |
Prompt: Ändere den Stil von Bild 1 zu dem von Bild 2 | ||
Das Ende
Text-zu-Bild-Modelle unterscheiden sich darin, worin sie am besten sind, sodass die richtige Wahl davon abhängt, was Sie benötigen, nachdem das erste Bild generiert wurde. Wenn Sie nur ein schnelles Konzept benötigen, reichen möglicherweise Prompt-Genauigkeit und Bildqualität aus. Für Produktvisuals, wiederkehrende Charaktere oder Bildserien sind Referenzen, Bearbeitung und Konsistenz wichtiger. Wenn Sie mit Text oder bestehenden Visuals starten möchten, ermöglicht Kling IMAGE 3.0 Ihnen, Referenzen zu kombinieren, bestimmte Details zu ändern und denselben Look in neuen Bildern beizubehalten. Egal ob Sie eine Produktkampagne aufbauen, einen wiederkehrenden Charakter entwickeln oder ein frühes Konzept in ein fertiges Visual-Set verwandeln, das richtige Modell sollte es einfacher machen, die Details zu bewahren, die Ihnen wichtig sind, während das Projekt wächst.
FAQs
Welches KI-Sprachmodell wird für die Text-zu-Bild-Erstellung verwendet?
Es gibt kein einzelnes Sprachmodell, das von jedem Text-zu-Bild-System verwendet wird. Wenn Sie fragen, welches KI-Sprachmodell für Text-zu-Bild-Erstellungsfunktionen verwendet wird, lautet die Antwort: Es hängt vom jeweiligen Modell ab. Einige Systeme nutzen Text-Encoder wie CLIP oder T5, während andere Sprach- oder Vision-Language-Komponenten einsetzen, um den Prompt zu lesen, bevor das Bild erzeugt wird.
Welche KI kann Text in Bilder verwandeln?
Viele KI-Bildmodelle können einen geschriebenen Prompt in ein fertiges Bild verwandeln, darunter Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 und Runway Gen-4 Image. Jedes geht mit Prompts, Referenzen, Bearbeitungen und visueller Konsistenz anders um, daher hängt das richtige Modell von der Art des Bildes ab, das Sie erstellen möchten.
Können Text-zu-Bild-Modelle Referenzbilder verwenden?
Ja. Viele Text-zu-Bild-Modelle können Referenzbilder zusammen mit schriftlichen Prompts verwenden, was Bild-zu-Bild-KI nützlich macht, wenn Sie mit einem vorhandenen visuellen Motiv arbeiten möchten, statt ganz von vorn zu beginnen. Die Referenz kann Details wie die Figur, das Produkt, die Pose, die Komposition, die Farben oder den Stil festlegen, während der Prompt dem Modell mitteilt, was geändert werden soll. Kling IMAGE 3.0 kann in einer Generation bis zu 10 Referenzbilder verwenden, was hilfreich ist, wenn dieselbe Figur, dasselbe Produkt oder derselbe visuelle Stil erkennbar bleiben soll.
Wie entferne ich den Hintergrund aus einem Bild?
Wenn Sie eine sauberere Produktaufnahme, ein Profilbild oder ein Design-Asset benötigen, können Sie den Hintergrund aus einem Bild entfernen und das Hauptmotiv isoliert lassen. Ein transparenter Hintergrund funktioniert gut für Produktlisten, Präsentationen, Social-Media-Beiträge oder Layouts, in denen das Motiv auf einem anderen Hintergrund platziert werden muss. Nach dem Entfernen überprüfen Sie die feinen Kanten rund um Haare, Kleidung, Fell oder kleine Objekte, behalten Sie dann den Hintergrund transparent bei, wechseln Sie zu einer Volltonfarbe oder platzieren Sie das Motiv in einer neuen Szene.