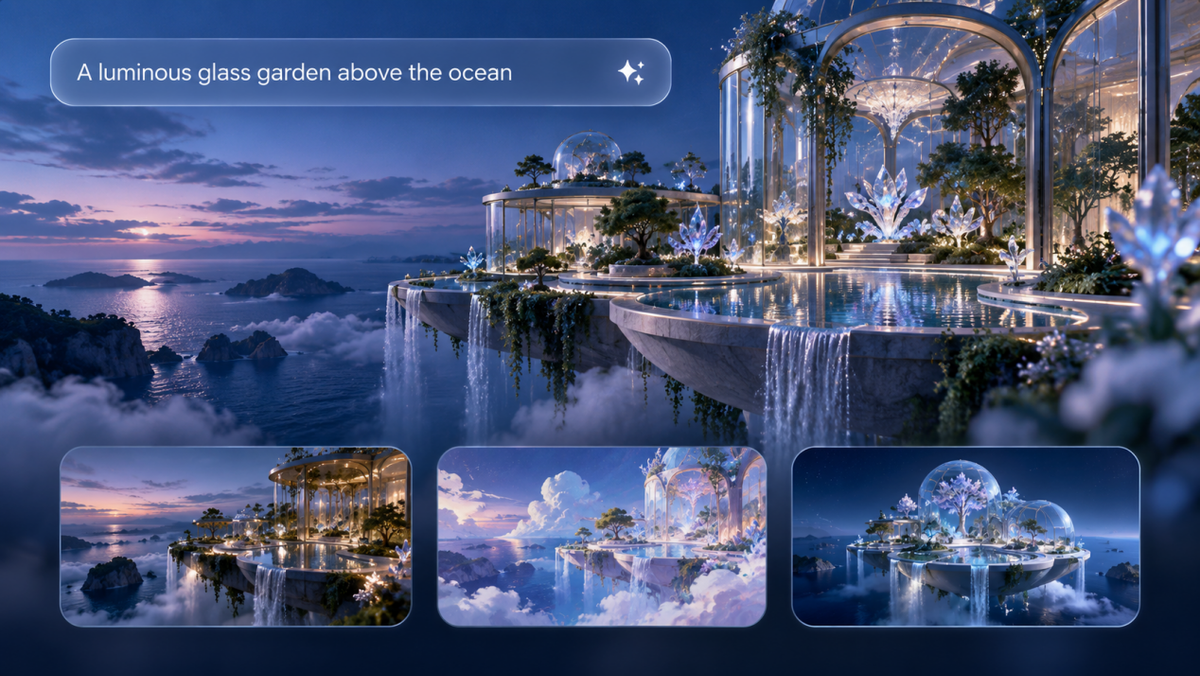
Con solo una idea o una simple descripción, los modelos de texto a imagen pueden convertir el lenguaje natural en conceptos visuales. Para los creadores, los mejores modelos de texto a imagen van más allá de la generación de imágenes. Deben comprender indicaciones complejas, conservar la coherencia visual y respaldar el perfeccionamiento creativo con el tiempo. Esta guía explica cómo funcionan los modelos de texto a imagen, compara las capacidades que más importan y explora cómo Kling IMAGE 3.0 combina creación basada en referencias, edición precisa y flujos de trabajo flexibles para ayudar a los creadores a dar vida a sus ideas visuales.
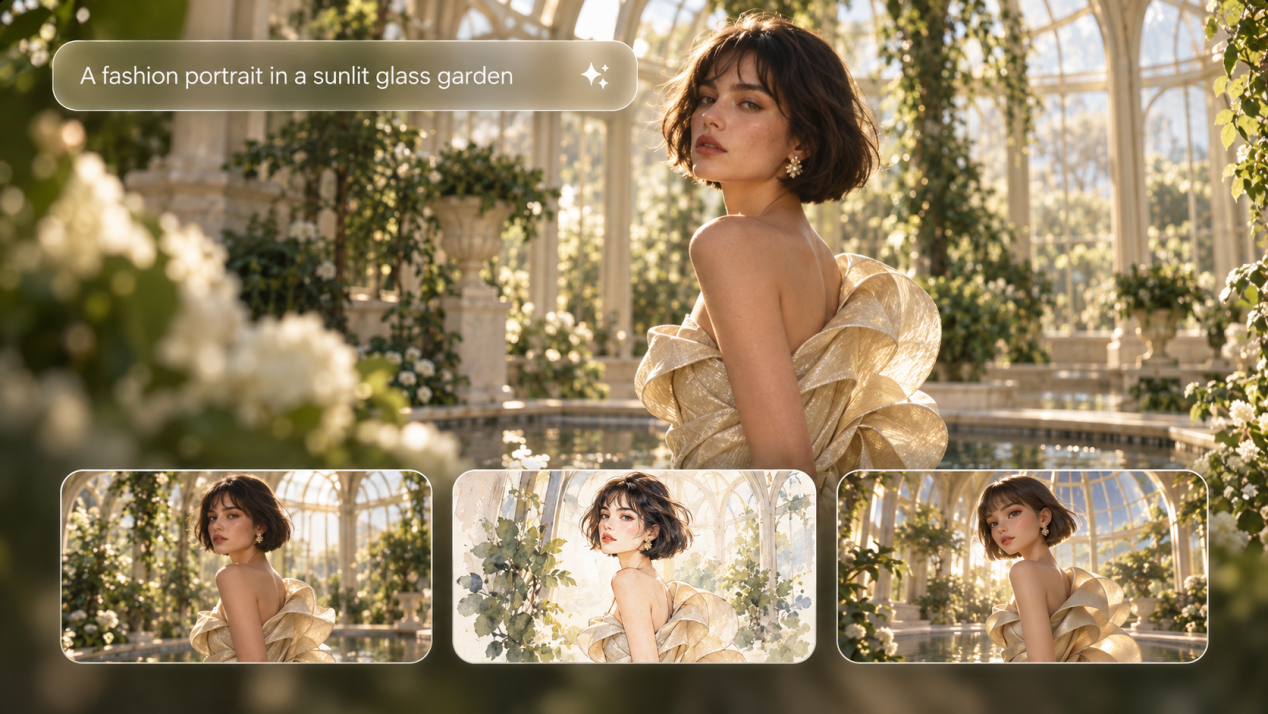
¿Qué son los modelos de texto a imagen?
Un modelo de texto a imagen es un tipo de sistema de inteligencia artificial que convierte indicaciones en lenguaje natural en imágenes digitales según los detalles descritos en la indicación.
Los sistemas modernos de texto a imagen suelen combinar un componente que comprende o codifica la indicación con un componente de generación de imágenes que transforma esas instrucciones en contenido visual. Algunos modelos también pueden trabajar con imágenes y otras referencias visuales, lo que les ayuda a seguir indicaciones complejas, preservar detalles importantes y permitir ediciones más precisas.
Por ejemplo, considera una indicación:
| Indicación: Una cámara vintage colocada sobre un escritorio de madera con luz suave de la mañana bañando la escena. |
El modelo necesita comprender el objeto, el material, la disposición espacial, la iluminación y el estilo visual general antes de producir la imagen correspondiente.
Hoy en día, evaluar los modelos de texto a imagen implica más que la calidad de la imagen. El enfoque se ha desplazado hacia comprender con precisión la indicación, manejar escenas complejas, mantener la coherencia visual y admitir una edición flexible.
¿Cómo funcionan los modelos de texto a imagen?
Los modelos de texto a imagen traducen descripciones escritas en contenido visual al aprender cómo el lenguaje se relaciona con objetos, estilos, composiciones y otros detalles. Muchos sistemas modernos emplean métodos basados en difusión, en los que el prompt guía un proceso paso a paso que transforma gradualmente el ruido visual en una imagen terminada.
El proceso puede entenderse en tres etapas:
1.Aprender cómo el texto se conecta con las imágenes
Antes de generar imágenes, un modelo de texto a imagen aprende a partir de grandes conjuntos de datos que contienen imágenes emparejadas con descripciones. Durante el entrenamiento, identifica patrones entre palabras y detalles visuales, incluidos objetos, colores, formas, estilos y relaciones espaciales. Por ejemplo, el modelo aprende cómo conceptos como "cámara vintage", "escritorio de madera" y "luz suave de la mañana" se asocian con características visuales específicas.
2.Comprender el prompt
Cuando introduces un prompt, el sistema traduce tu texto a un formato que puede comprender, capturando el significado y el contexto centrales. Aunque la tecnología exacta varía según el modelo—y los sistemas comerciales suelen mantener oculta toda su arquitectura—, estos componentes de texto y visión trabajan juntos para conectar tus palabras con el resultado visual final.
3.Generación de la imagen
Muchos modelos modernos de texto a imagen utilizan métodos de difusión, aunque otros modelos pueden emplear enfoques autorregresivos u otros métodos de generación. En los sistemas basados en difusión, el proceso comienza con ruido visual y lo elimina gradualmente según la información proporcionada por el prompt. Mediante pasos repetidos de eliminación de ruido, la imagen desarrolla formas, detalles y estilos más nítidos que coinciden con la descripción. Algunos sistemas realizan este proceso en un espacio latente comprimido antes de convertir el resultado en la imagen final. Una vez que la imagen se forma, se pueden realizar ajustes adicionales para perfeccionar los detalles o prepararla para su edición.
¿Qué hace que los modelos de texto a imagen sean diferentes?
Los modelos de texto a imagen pueden responder de manera muy diferente al mismo prompt. Algunas de esas diferencias provienen de la forma en que se generan las imágenes, mientras que otras dependen de los tipos de entrada que el modelo puede leer y utilizar.
Arquitectura de generación
En el nivel de generación, dos enfoques comunes son la difusión y la generación autorregresiva.
Enfoque | Cómo funciona | Usos comunes |
Modelos de difusión | Comienza con ruido visual y refínalo gradualmente hasta convertirlo en una imagen guiada por el prompt. | Generación de imágenes detalladas, escenas realistas, ilustración y trabajos impulsados por el estilo. |
Modelos autorregresivos | Construye una imagen al predecir tokens visuales o elementos en secuencia. | Generación de imágenes que construye contenido visual en secuencia en lugar de refinar ruido. |
Los modelos de difusión siguen siendo un área activa de investigación de texto a imagen. La encuesta de 2023 Modelos de difusión de texto a imagen en IA generativa: una encuesta ofrece una visión general útil de los métodos de texto a imagen basados en difusión, los conjuntos de datos, los enfoques de evaluación y las aplicaciones relacionadas.
Entradas multimodales
Multimodal describe los tipos de entrada que un modelo puede utilizar en lugar de cómo genera una imagen. Un modelo de imágenes multimodal puede tomar texto, imágenes y referencias visuales para la creación basada en referencias, la edición o mantener coherentes personajes y productos a lo largo de una serie. En su interior, aún puede usar difusión, generación autorregresiva u otro método, por lo que un modelo puede encajar en más de una categoría.
¿Cuáles son los mejores modelos de texto a imagen en 2026?
Para esta guía, seleccionamos siete modelos actuales que representan diferentes enfoques de generación de imágenes, edición, creación basada en referencias y producción visual. El orden no es una clasificación.
Modelo | Tipo de modelo | Ideal para | Características principales |
Modelo de generación y edición de imágenes con entradas multimodales | Creación basada en referencias, visuales de productos, personajes y ediciones detalladas | Genera a partir de texto o imágenes, combina características de hasta 10 referencias y admite la retención del sujeto, ediciones precisas y control de estilo. IMAGE 3.0 admite generación de hasta 2K, mientras que IMAGE 3.0 Omni ofrece hasta 4K. | |
Leonardo Lucid Origin | Modelo de generación de imágenes | Ilustración, arte conceptual, maquetas de productos y creación de imágenes en general | Cubre una amplia gama de estilos, sigue indicaciones detalladas, produce imágenes Full HD y admite renderizado de texto legible. |
Seedream 5.0 Pro | Modelo de generación y edición de imágenes | Imágenes de productos, infografías, recursos de diseño y ediciones locales | Funciona a partir de texto o imágenes, acepta referencias, admite edición regional y maneja entrada y generación multilingüe. |
Adobe Firefly Image 5 | Modelo de generación y edición de imágenes | Producción de diseño, recursos de marketing y proyectos basados en Adobe | Genera a partir de texto, trabaja con imágenes de referencia y permite ediciones dirigidas en Photoshop mientras mantiene intacto el contenido circundante de la imagen. |
Krea 2 Large | Modelo de generación de imágenes | Fotorrealismo, trabajos guiados por el estilo y dirección visual | Optimizado para un fotorrealismo expresivo, con creación basada en indicaciones y control guiado por referencias sobre la composición, el sujeto y el estilo. |
Luma UNI-1.1 | Modelo de imagen multimodal unificado | Generación guiada por referencias y revisión de imagen | Combina la generación de imágenes con la edición en lenguaje natural y acepta hasta nueve entradas de referencia en una solicitud. |
Runway Gen-4 Imagen | Modelo de generación de imágenes dentro de una plataforma de imagen y vídeo | Desarrollo de personajes, diseño de escenas y proyectos que luego pasan a vídeo | Genera a partir de texto e imágenes de referencia, utiliza hasta tres referencias por generación y puede trasladar personajes, objetos o rasgos visuales a nuevas escenas. |
La siguiente sección compara estos modelos en el seguimiento del prompt, la gestión de referencias, la edición, la consistencia visual y el control de estilo.
¿Cómo se comparan los modelos de texto a imagen en 2026?
Los modelos de texto a imagen difieren sobre todo en la precisión del prompt, el uso de referencias, la edición, la consistencia y el control del estilo. Estas diferencias son más fáciles de notar en proyectos que implican imágenes repetidas, revisiones, productos o personajes recurrentes.
Área de comparación | Qué comparar | Por qué importa |
Cumplimiento del prompt | Sujetos, atributos, relaciones entre objetos, composición y detalles requeridos. | Una imagen pulida sigue quedándose corta si no cumple con el encargo. |
Gestión de referencias | Número de referencias, retención del sujeto, transferencia de estilo y guía de composición. | Las referencias ayudan a mantener un personaje, producto o dirección visual reconocible en todas las imágenes. |
Edición de imágenes | Cambios locales, ediciones en lenguaje natural y qué tan bien permanecen intactas las áreas no tocadas. | Las ediciones precisas ahorran tiempo y evitan reconstruir la imagen desde cero. |
Consistencia visual | Personajes, productos, vestuario, estilo y detalles recurrentes en todas las imágenes o revisiones. | Los detalles estables son importantes para series de imágenes, campañas, guiones gráficos y conjuntos de productos. |
Control de estilo | Iluminación, paleta, textura, aspecto fotográfico, estilo de ilustración y dirección visual. | Un control claro del estilo ayuda a mantener conectadas visualmente las imágenes relacionadas. |
Ajuste al flujo de trabajo | Revisiones, opciones de exportación, uso de imagen a video y compatibilidad con otras herramientas creativas. | Lo que ocurre después de la generación puede ser tan importante como la primera imagen. |
Un modelo que funciona bien para imágenes conceptuales rápidas puede no ser adecuado para una serie de productos o un proyecto de personajes. La precisión del prompt y el estilo pueden ser suficientes para una sola imagen, mientras que el trabajo repetido suele requerir referencias más sólidas, edición y coherencia.
¿Cómo elegir el mejor modelo de texto a imagen?
Al escoger un generador de imágenes de IA, empieza por lo que quieres crear y qué detalles deben permanecer sin cambios mientras revisas la imagen. La tabla siguiente muestra qué debes buscar en varios escenarios comunes.
Si necesitas | Busca | Por qué importa |
Imágenes conceptuales rápidas | Precisión del prompt, calidad de imagen y variedad de estilos | Puedes acercarte más al resultado previsto con menos revisiones. |
Personajes o productos coherentes | Gestión de referencias y conservación de detalles | Los rostros, la ropa, los productos y otras características distintivas deben mantenerse reconocibles en todas las imágenes. |
Revisiones frecuentes de imágenes | Edición local y cambios en lenguaje natural | Puedes ajustar una parte de la imagen sin reconstruir toda la escena. |
Activos de campaña o series de imágenes | Sujetos, estilo y composición estables | Las imágenes relacionadas deben compartir la misma dirección visual. |
Imágenes que luego se convierten en video | Imágenes de referencia y opciones de imagen a video | Los sujetos y detalles visuales estables son más fáciles de trasladar al movimiento. |
¿Por qué vale la pena considerar Kling IMAGE 3.0?
Kling IMAGE 3.0 te permite iniciar creaciones con un prompt de texto o imágenes de referencia, y luego afinar cada detalle usando lenguaje natural. Más allá de la generación estándar, te brinda un control profundo sobre la consistencia de los personajes, ediciones precisas y ajuste de estilo, abriendo infinitas posibilidades creativas.
Convierte ideas complejas en imágenes frescas
IMAGE 3.0 te permite combinar pistas visuales de múltiples referencias y usar un lenguaje cotidiano para ir más allá de las ediciones estándar. Combina sujetos entre imágenes, invierte la perspectiva de una escena o traslada un concepto a un estilo completamente nuevo, todo mientras mantienes un resultado final fluido y coherente.
Imagen de referencia 1 | Imagen de referencia 2 | Imagen de salida |
Instrucción: Combina los animales de la imagen 1 y la imagen 2. | ||
Mantén a los personajes, productos y detalles clave reconocibles
Puedes usar hasta 10 imágenes de referencia en una sola generación. Referencias diferentes pueden definir un personaje, vestuario, producto, escenario o estilo mientras tu prompt explica cómo deben unirse esos elementos. Para retoques de retratos, las referencias faciales pueden ayudar a conservar rasgos faciales reconocibles mientras cambias el peinado, el atuendo, la pose o el escenario. Si solo quieres intercambiar un rostro en una toma existente, también puedes ir directamente a los flujos de trabajo de face swap de Kling.
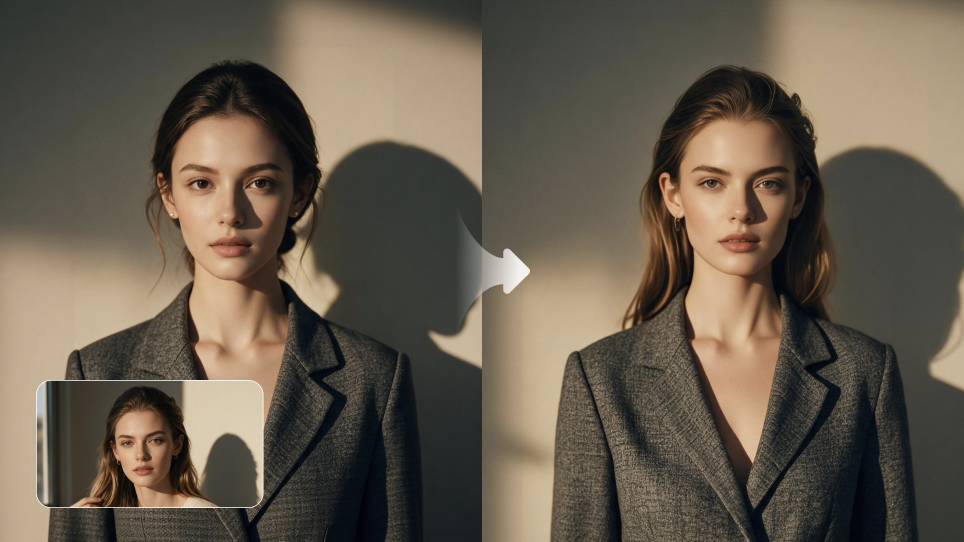
Cambia solo lo que deba cambiar
Si la mayor parte de una imagen ya se ve bien, puedes usar Kling IMAGE 3.0 como un editor de fotos con IA para ajustar detalles específicos sin reconstruir toda la escena. Las instrucciones en lenguaje natural pueden cambiar el tamaño, el color, el material, la expresión o el fondo de un objeto, procurando preservar las partes circundantes de la imagen. También puedes usar Kling AI como un eliminador de marcas de agua para las imágenes que poseas o que tengas permiso de editar. Otros ajustes incluyen la colorización de fotos, efectos vintage, ediciones de garabatos, cambios de iluminación y tono, y restauración de imágenes.
Mantén el estilo y el tono coherentes en todas las imágenes Si ya tienes una dirección visual clara, puedes usar una imagen existente como referencia de estilo. Kling IMAGE 3.0 puede trasladar elementos como las pinceladas, el color, la composición y el tono a nuevas imágenes. Esto funciona bien para conjuntos de ilustraciones, visuales de producto o contenido de marca en los que se necesita que la misma apariencia se repita en más de una imagen.
Imagen de referencia 1 | Imagen de referencia 2 | Imagen de salida |
Prompt: Cambia el estilo de la Imagen 1 al de la Imagen 2 | ||
Fin
Los modelos de texto a imagen difieren en aquello que mejor hacen, por lo que la elección adecuada depende de lo que necesites después de que se genere la primera imagen. Si solo necesitas un concepto rápido, la precisión del prompt y la calidad de la imagen pueden ser suficientes. Para recursos visuales de productos, personajes recurrentes o series de imágenes, las referencias, la edición y la consistencia importan más. Si quieres partir de texto o de elementos visuales existentes, Kling IMAGE 3.0 te permite combinar referencias, cambiar detalles específicos y mantener la misma apariencia en nuevas imágenes. Ya sea que estés creando una campaña de producto, desarrollando un personaje recurrente o convirtiendo un concepto temprano en un conjunto visual terminado, el modelo adecuado debe facilitar que conserves los detalles que te importan a medida que el proyecto crece.
Preguntas frecuentes
¿Qué modelo de lenguaje de IA se utiliza para la creación de texto a imagen?
Ningún modelo de lenguaje único es utilizado por todos los sistemas de texto a imagen. Si preguntas qué modelo de lenguaje de IA se usa para las capacidades de creación de texto a imagen, la respuesta varía según el modelo. Algunos sistemas emplean codificadores de texto como CLIP o T5, mientras que otros usan componentes de lenguaje o de visión y lenguaje para interpretar el prompt antes de generar la imagen.
¿Qué IA puede convertir texto en imagen?
Muchos modelos de imagen de IA pueden convertir un prompt escrito en una imagen final, entre ellos Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 y Runway Gen-4 Image. Cada uno gestiona los prompts, las referencias, las ediciones y la consistencia visual de manera diferente, por lo que el modelo adecuado depende del tipo de imagen que necesites crear.
¿Pueden los modelos de texto a imagen usar imágenes de referencia?
Sí. Muchos modelos de texto a imagen pueden usar imágenes de referencia junto con indicaciones escritas, lo que hace que IA de imagen a imagen sea útil cuando quieres trabajar desde un visual existente en lugar de empezar desde cero. La referencia puede establecer detalles como el personaje, el producto, la pose, la composición, los colores o el estilo, mientras que la indicación le dice al modelo qué cambiar. Kling IMAGE 3.0 puede usar hasta 10 imágenes de referencia en una generación, lo que es útil cuando el mismo personaje, producto o estilo visual necesita seguir siendo reconocible.
¿Cómo elimino el fondo de una imagen?
Si necesitas una fotografía de producto más limpia, una imagen de perfil o un recurso de diseño, puedes eliminar el fondo de una imagen y mantener el sujeto principal aislado. Un fondo transparente funciona bien para listados de productos, presentaciones, publicaciones en redes sociales o composiciones en las que el sujeto deba situarse sobre un fondo diferente. Tras la eliminación, revisa los bordes finos alrededor del cabello, la ropa, el pelaje o los objetos pequeños; luego deja el fondo transparente, cámbialo por un color sólido o coloca al sujeto en una nueva escena.