सबसे अच्छा लिप सिंक वीडियो AI टूल चुनना केवल मुंह की हरकतों को ऑडियो से मिलाने से कहीं अधिक है। इसे चेहरे, भाव-भंगिमा और वीडियो विवरण को पूरे क्लिप में सुसंगत रखने में मदद करनी चाहिए। इस गाइड में हम 2026 के प्रमुख AI लिप सिंक टूल्स की तुलना करते हैं और दो Kling AI वर्कफ़्लो पर नज़र डालते हैं: Lip Sync टूल का उपयोग करके मौजूदा कैरेक्टर वीडियो में समकालिक भाषण या गायन जोड़ना, तथा VIDEO 3.0 सीरीज़ में Native Audio का उपयोग कर शुरुआत से ही समकालिक भाषण, चेहरे की परफॉर्मेंस और साउंड के साथ नई संवाद दृश्य तैयार करना।
एक अच्छा AI लिप सिंक टूल किन बातों से बनता है?
सर्वश्रेष्ठ लिप सिंक वीडियो AI टूल चुनना केवल यह जांचने से अधिक है कि क्या मुंह की हरकतें ऑडियो से मेल खाती हैं। प्रमुख तुलना कारकों में समकालिकता की सटीकता, चेहरे की सुसंगति, मोशन हैंडलिंग, इनपुट लचीलापन, भाषा समर्थन और मल्टी-स्पीकर प्रदर्शन शामिल हैं।
तुलना कारक | क्या देखें | यह क्यों महत्वपूर्ण है |
ऑडियो-विज़ुअल समकालिकता | मुँह की गतिविधियाँ भाषण ध्वनियों, विरामों और वाक्य के समय से मेल खाती हों | छोटे समय-संबंधी मुद्दे संवाद को वीडियो से अलग-सा महसूस करा सकते हैं |
चेहरे की स्थिरता और गति प्रबंधन | स्थिर चेहरे की विशेषताएँ, भाव-भंगिमाएँ, सिर की गतियाँ, कैमरा कोण और दृश्य विवरण | वीडियो के दौरान वक्ता पहचानने योग्य बना रहना चाहिए |
इनपुट लचीलापन | मौजूदा वीडियो, पात्रों, अवतारों और एआई-निर्मित दृश्यों के लिए समर्थन | विभिन्न रचनाकार अलग-अलग सामग्री और उत्पादन आवश्यकताओं के साथ शुरू करते हैं |
बहुभाषी और आवाज समर्थन | विभिन्न भाषाओं, आवाज़ों और बोलने की शैलियों के लिए समर्थन | अनुवाद, स्थानीयकरण और वैश्विक दर्शकों के लिए महत्वपूर्ण |
बहु-वक्ता दृश्य प्रबंधन | वार्तालापों में सटीक वक्ता मिलान और संवाद समय-निर्धारण | प्रत्येक व्यक्ति की आवाज़ को सही वक्ता के साथ संरेखित रखने में मदद करता है |
62026 के सर्वश्रेष्ठ लिप सिंक वीडियो AI टूल्स
AI लिप सिंक टूल्स विभिन्न तरीकों से काम करते हैं। कुछ मौजूदा वीडियो में नया भाषण जोड़ने के लिए बनाए जाते हैं, जबकि अन्य लिप सिंक को अनुवाद, अवतार या AI-जनरेटेड दृश्यों के साथ संयोजित करते हैं। सर्वश्रेष्ठ विकल्प इस बात पर निर्भर करता है कि आप किस फुटेज से शुरू करते हैं और किस प्रकार का वीडियो बनाना चाहते हैं।
नीचे दी गई तालिका वीडियो सिंकिंग, अनुवाद, AI वीडियो निर्माण और बहु-वक्ता दृश्यों में छह AI लिप सिंक टूल्स की तुलना करती है।
उपकरण | मुख्य उपयोग | लिप सिंक का उपयोग कैसे किया जाता है | बहुभाषी और स्थानीयकरण | संवाद और बहु-वक्ता |
Kling AI | मौजूदा चरित्र वीडियो के लिए लिप सिंक और नए AI वीडियो के लिए मूल संवाद निर्माण | समर्थित मौजूदा चरित्र वीडियो के साथ अपलोड किए गए या टेक्स्ट-टू-स्पीच ऑडियो को मिलाने के लिए समर्पित लिप सिंक टूल का उपयोग करें, या नए वीडियो में संवाद और समकालिक दृश्य प्रदर्शन एक साथ जनरेट करने के लिए VIDEO 3.0 / VIDEO 3.0 Omni में नेटिव ऑडियो का उपयोग करें। | VIDEO 3.0 श्रृंखला चीनी, अंग्रेज़ी, जापानी, कोरियाई और स्पेनिश में मूल संवाद निर्माण का समर्थन करती है, जिसमें मिश्रित-भाषा संवाद, बोलियाँ और लहजे शामिल हैं। | VIDEO 3.0 श्रृंखला वक्ता-विशिष्ट पंक्तियों और समकालिक चेहरे की अभिव्यक्ति के साथ बहु-चरित्र संवाद का समर्थन करती है। |
Vozo AI | मौजूदा वीडियो के लिए डबिंग और स्थानीयकरण | नई या अनूदित वाणी को मूल फुटेज में वक्ता से मिलाया जाता है | वीडियो अनुवाद और स्थानीयकृत वॉइस सामग्री पर आधारित | मल्टी-स्पीकर लोकलाइज़ेशन का समर्थन करता है |
HeyGen | अवतार वीडियो और अनूदित वीडियो सामग्री | वॉइस परिवर्तन या अनुवाद के बाद भाषण को अवतार या वक्ताओं के साथ समक्रमित किया जाता है | बहुभाषी वीडियो अनुवाद पर मजबूत ध्यान | अवतार और बहु-वक्ता सामग्री का समर्थन करता है |
Sync Labs | उत्पादन और एकीकरण के लिए लिप सिंक | समर्पित लिप सिंक उपकरणों के माध्यम से ऑडियो को मौजूदा वीडियो के साथ समकालिक किया जा सकता है | भाषा समर्थन आसपास की उत्पादन व्यवस्था पर निर्भर करता है | संवाद समकालिकरण के लिए इस्तेमाल किया जा सकता है |
PixVerse | लघु-रूप AI वीडियो निर्माण | उत्पन्न चरित्र सामग्री में लिप सिंक जोड़ा जा सकता है | भाषा विकल्प सुविधा के अनुसार भिन्न होते हैं | चरित्र-आधारित वार्तालाप दृश्य का समर्थन करता है |
CapCut | सोशल वीडियो संपादन और क्रिएटर सामग्री | लिप सिंक को संपादन और एआई-सहायता प्राप्त सुविधाओं के माध्यम से संभाला जा सकता है | अनुवाद विकल्प उपकरण और क्षेत्र के अनुसार बदलते हैं | यह उपयोग की जा रही संपादन सुविधाओं पर निर्भर करता है |
कौन सा लिप सिंक तरीका आपके वीडियो के लिए उपयुक्त है?
लिप सिंक उस वीडियो के प्रकार पर अलग-अलग उद्देश्य पूरा करता है जिसे आप बना रहे हैं। मौजूदा फुटेज, अनूदित सामग्री और नई उत्पन्न दृश्य प्रत्येक को अलग दृष्टिकोण की आवश्यकता होती है।
आपका शुरुआती बिंदु | आप क्या बनाना चाहते हैं | अनुशंसित विधि | विचार करने योग्य उपकरण |
आपके पास पहले से एक मौजूदा कैरेक्टर वीडियो है | बोली बदलें, नया संवाद जोड़ें, या नए ऑडियो को सिंक करें | मौजूदा वीडियो लिप सिंक | Kling AI, Vozo AI, Sync Labs |
आपके पास किसी अन्य भाषा में एक वीडियो है | विभिन्न दर्शकों के लिए स्थानीयकृत संस्करण बनाएँ | अनुवाद + वॉइस जनरेशन + लिप सिंक | HeyGen, Vozo AI, Kling AI* |
आपके पास एक चरित्र छवि या अवतार है | समन्वित अभिव्यक्तियों के साथ किसी चरित्र को बोलने दें | बोलता हुआ चरित्र या अवतार उत्पादन | Kling AI अवतार, HeyGen |
आप शुरू से एक नया दृश्य बनाना चाहते हैं | एक साथ पात्र, संवाद और दृश्य उत्पन्न करें | नेटिव ऑडियो के साथ AI वीडियो जनरेशन | Kling AI |
आप एक बातचीत या कहानी का दृश्य बना रहे हैं | कई पात्रों के बीच संवाद को स्वाभाविक रखें | बहु-पात्र संवाद निर्माण | Kling AI |
*Kling Lip Sync तैयार लक्ष्य-भाषा ऑडियो या उपलब्ध टेक्स्ट-टू-स्पीच आवाज़ों को किसी समर्थित चरित्र वीडियो के साथ सिंक कर सकता है।
Kling AI के साथ लिप-सिंक्ड AI वीडियो बनाने के दो तरीके
विकल्प 1: किसी मौजूदा चरित्र वीडियो में लिप सिंक जोड़ें
यदि आपके पास पहले से समर्थित Kling AI चरित्र वीडियो है, तो दृश्य को शुरू से फिर से बनाए बिना नई वाणी या गायन जोड़ने के लिए Kling AI Lip Sync टूल का उपयोग करें। आप अपना स्वयं का ऑडियो अपलोड कर सकते हैं या टेक्स्ट-टू-स्पीच का उपयोग कर सकते हैं, और फिर चरित्र के होंठों की हरकतों को नई आवाज़ के साथ समकालित करें।
चरण 1: एक स्पष्ट चरित्र वीडियो चुनें
एक समर्थित Kling AI क्लिप चुनें जिसमें पूरा, स्पष्ट दिखाई देने वाला चेहरा हो। मुंह का स्पष्ट दृश्य यह आकलन करना आसान बनाता है कि नई आवाज़ पूरे क्लिप के दौरान सिंक में रहती है या नहीं। Kling AI Lip Sync वास्तविक, 3D और 2D मानवीय पात्रों का समर्थन करता है। यदि पात्र कैमरे से मुड़ जाता है या मुंह आंशिक रूप से ढका हुआ है, तो सुनिश्चित करें कि मुख्य बोलने वाले हिस्सों में चेहरे का पर्याप्त भाग दिखे ताकि सिंक स्पष्ट रूप से काम कर सके।
चरण 2: ऑडियो जोड़ें या कोई स्क्रिप्ट दर्ज करें
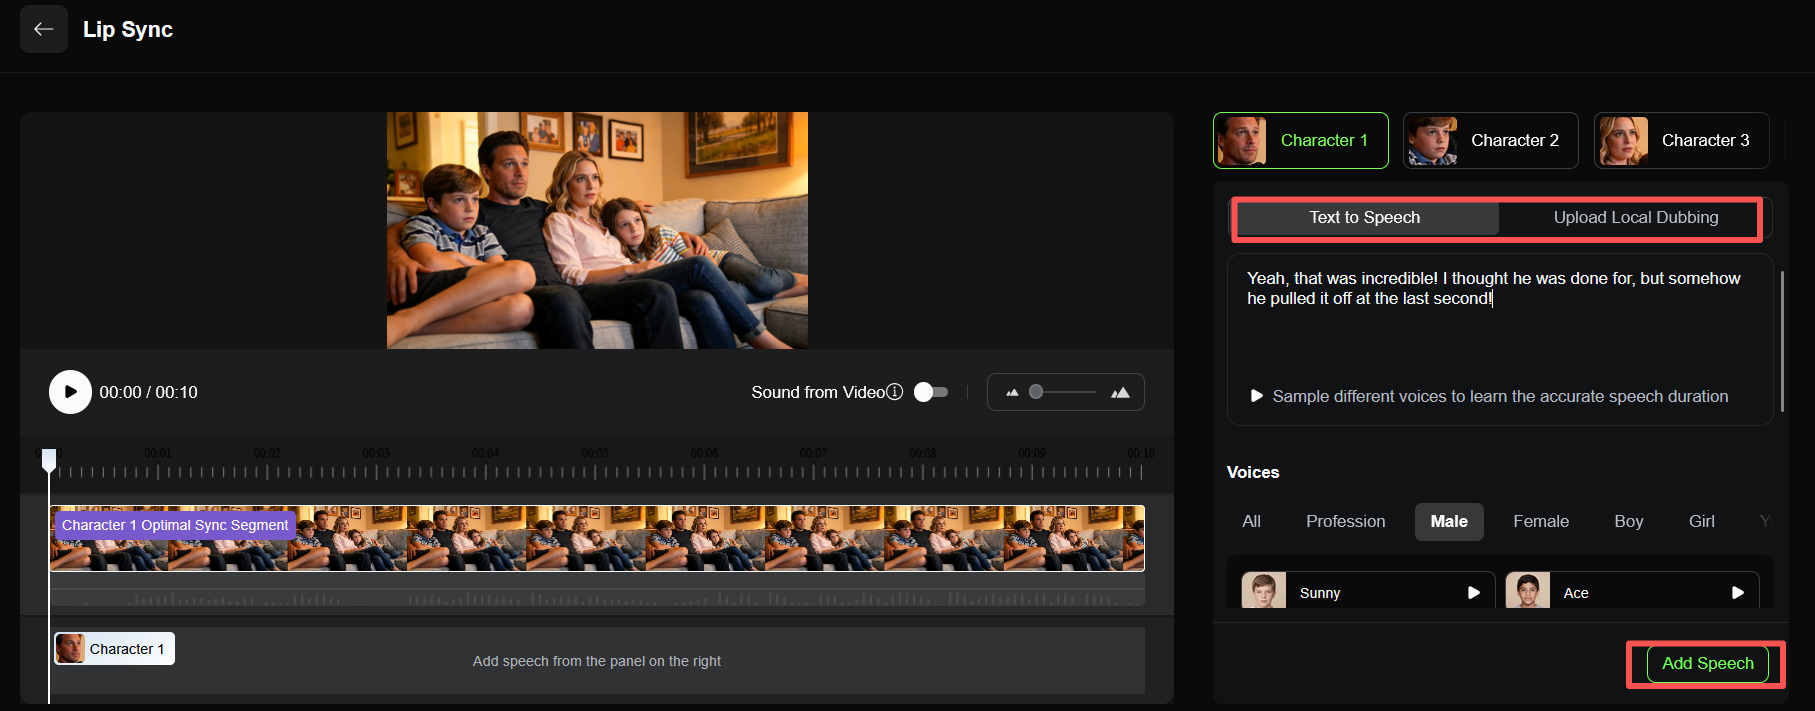
एक वॉइसओवर या गायन ट्रैक अपलोड करें, या स्क्रिप्ट से आवाज़ जनरेट करने के लिए Text to Speech का उपयोग करें। यदि ऑडियो वीडियो से लंबा है, तो जनरेशन से पहले उसे ट्रिम करें। जब किसी पंक्ति को छोटे क्लिप में फिट करना हो तो आप Text to Speech की गति भी समायोजित कर सकते हैं। स्क्रिप्ट को उपलब्ध वीडियो समय के अनुरूप रखें ताकि प्रस्तुति जल्दबाज़ी वाली न लगे या लंबे विराम न छोड़ दे।
चरण 3: लिप सिंक जनरेट करें और समीक्षा करें
लिप-सिंक किया हुआ संस्करण तैयार करें और पूरे क्लिप को देखें, जिसमें तेज़ वाक्यांश, विराम और वाक्य समापन शामिल हों। यदि भाषण का कोई भाग जल्दी या देर से महसूस हो, तो पहले ऑडियो की लंबाई और गति की जाँच करें। आप अपलोड किए गए ट्रैक से अनावश्यक विराम हटाकर या फिर से जनरेट करने से पहले Text to Speech गति समायोजित करके इसे सही कर सकते हैं। मूल वीडियो में यदि अधिक मजबूत अभिव्यक्तियाँ या सिर की गतिशीलता शामिल हों, तो पात्र के पूरे चेहरे और विशेष रूप से मुंह पर ध्यान दें।

विकल्प 2: VIDEO 3.0 सीरीज़ के साथ लिप-सिंक्ड संवाद जनरेट करें
यदि आप किसी मौजूदा वीडियो में भाषण जोड़ने के बजाय एक नया संवाद दृश्य बनाना चाहते हैं, तो Kling VIDEO 3.0 और VIDEO 3.0 Omni Native Audio के माध्यम से संवाद, होंठों की गति, चेहरे के भाव, दृश्य, माहौल और साउंड इफेक्ट्स को एक साथ जनरेट कर सकते हैं। यदि दृश्य की शुरुआत से ही कई बोलते हुए पात्र शामिल हों, तो आप Text to Video AI का उपयोग करके यह निर्दिष्ट कर सकते हैं:
- कौन बोल रहा है
- प्रत्येक पात्र क्या कहता है
- बोलने का क्रम
- भाषा या उच्चारण
- प्रत्येक पात्र बोलते समय क्या कर रहा है
| Prompt: एक पुरुष और एक महिला रात में एक शांत, आधुनिक कैफ़े में आमने-सामने बैठे हैं। पुरुष पहले अंग्रेज़ी में नरम अमेरिकी उच्चारण के साथ बोलता है, थोड़ा आगे झुकता है और कहता है, “मुझे नहीं लगा था कि तुम आओगी।” महिला उसे देखती है, एक क्षण के लिए रुकती है, फिर अंग्रेज़ी में ब्रिटिश उच्चारण के साथ जवाब देती है, “मैं लगभग नहीं आई थी।” वह हल्की मुस्कान देती है और धीरे-धीरे अपना कॉफी कप नीचे रखती है। पुरुष आश्चर्यचकित दिखता है और जवाब देना शुरू करता है, लेकिन उसके फिर से बोलने से पहले वह खिड़की की ओर मुड़ जाती है। संवाद का समय स्पष्ट रखें, प्राकृतिक होंठों की गति, सूक्ष्म चेहरे के भाव, और प्रत्येक वक्ता के बीच वास्तविक विराम बनाए रखें। |
VIDEO 3.0 चीनी, अंग्रेज़ी, जापानी, कोरियाई और स्पेनिश में बहु-पात्र संवाद के साथ-साथ मिश्रित-भाषा संवाद, बोलियों और उच्चारणों का समर्थन करता है। कई पात्र एक ही दृश्य साझा कर सकते हैं, बिना प्रत्येक वक्ता को अलग-अलग क्लिप के रूप में तैयार किए और बाद में टुकड़ों को जोड़ने की आवश्यकता के।
Native Audio के साथ, संवाद, माहौल और ध्वनि प्रभाव विजुअल्स के साथ ही उत्पन्न किए जा सकते हैं। आप बोलचाल की पंक्तियों, कमरे के टोन, कदमों की आवाज़ या अन्य ध्वनियों को प्रॉम्प्ट में वर्णित कर सकते हैं ताकि वे दृश्य के पूरा होने के बाद अलग-अलग परतों में जोड़ने के बजाय दृश्य का हिस्सा बन जाएँ। लघु कहानी दृश्यों, वार्तालापों और बोले गए संवादों वाले उत्पाद वीडियो के लिए, यह जनरेशन के बाद होने वाले अलग ऑडियो कार्य को कम कर देता है।
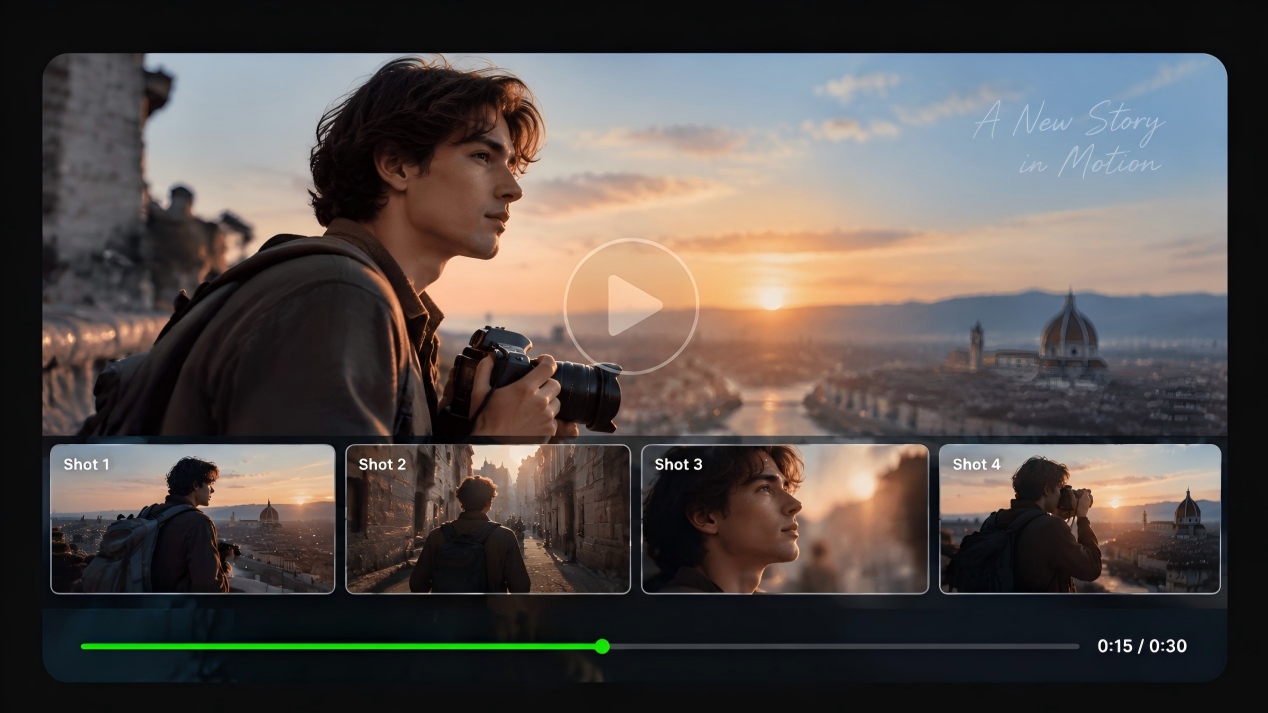
यदि आप चाहते हैं कि कैमरा बातचीत के साथ-साथ चले, तो Kling AI वीडियो जेनरेटर में Multi-Shot का उपयोग करें। कोई दृश्य टू-शॉट से बोलते हुए व्यक्ति के क्लोज़-अप तक जा सकता है, और फिर दूसरे चरित्र की प्रतिक्रिया पर कट कर सकता है। Multi-Shot प्रॉम्प्ट से शॉट परिवर्तन, फ्रेमिंग और कैमरा एंगल्स को व्यवस्थित कर सकता है। यदि आपने पहले से अनुक्रम की योजना बनाई है, तो Custom Multi-Shot आपको प्रत्येक शॉट की सामग्री और अवधि स्वयं निर्धारित करने देता है। VIDEO 3.0 3–15 सेकंड की जेनरेशन का समर्थन करता है, इसलिए एक छोटा अनुक्रम संवाद, प्रतिक्रियाएँ, चरित्र की गति और कई कैमरा परिवर्तनों को शामिल कर सकता है।
VIDEO 3.0 Omni इस वर्कफ़्लो को अधिक संदर्भ-आधारित निर्माण के लिए विस्तारित करता है, Native Audio को Element-आधारित चरित्र स्थिरता और व्यापक मल्टीमॉडल इनपुट्स के साथ संयोजित करते हुए।
एक साथ लेकर देखें तो ये नियंत्रण आपको एक संवाद दृश्य तैयार करने देते हैं, जिसमें भाषण, होंठों की गति, चरित्र प्रतिक्रियाएँ, ध्वनि और कैमरा परिवर्तन पहले से ही उसी अनुक्रम के भीतर काम कर रहे होते हैं, बजाय इसके कि बाद में उन्हें टुकड़ों में जोड़ना पड़े।
छवि |
| प्रॉम्प्ट: मैड्रिड की पुरानी गलियों में धूप भर जाती है। सड़क किनारे की एक बेकरी के सामने, एक चीनी महिला पर्यटक और एक ग्रे हुडी पहने पुरुष पर्यटक विनम्र मुस्कान के साथ दुकान के कर्मचारी की ओर बढ़ते हैं। महिला पर्यटक (थोड़ा धीरे-धीरे, एक अटपटी लहजे के साथ, स्पेनिश में बोलते हुए): Disculpe, ¿dónde está la plaza mayor? सफेद बालों वाला स्पेनी दुकानदार (हल्का सा मुड़कर और आगे की ओर इशारा करते हुए, हल्के और प्रसन्न स्वर में, स्पेनिश में): Por allí, a dos calles. Muy cerca. महिला पर्यटक धन्यवाद व्यक्त करने के लिए सिर हिलाती है। पुरुष पर्यटक भी सहमति में सिर हिलाता है और कहता है (स्पेनिश में): Muchas gracias. दुकानदार मुस्कुराता है और जवाब में सिर हिलाता है। फिर दोनों पर्यटक मुड़कर बताए गए दिशा में चल पड़ते हैं। |
आउटपुट |
सबसे आम लिप सिंक समस्याएँ कौन-सी हैं और आप उन्हें कैसे ठीक कर सकते हैं?
कुछ सामान्य असमानताएँ lip-sync generation के दौरान दिखाई दे सकती हैं। वे अक्सर स्रोत फुटेज, ऑडियो टाइमिंग, स्क्रिप्ट लंबाई या वक्ता की दिशा से उत्पन्न होती हैं। कारण की पहचान करने और उसे समायोजित करने का यह तरीका है।
समाधान उस कार्यप्रवाह पर निर्भर करता है जिसका आप उपयोग कर रहे हैं। Lip Sync टूल के साथ, समस्याएँ आम तौर पर स्रोत कैरेक्टर वीडियो, ऑडियो टाइमिंग या स्क्रिप्ट की लंबाई से संबंधित होती हैं। VIDEO 3.0 या VIDEO 3.0 Omni में Native Audio के साथ, बहु-चरित्र दृश्य यह भी निर्भर कर सकते हैं कि प्रॉम्प्ट में प्रत्येक वक्ता और पंक्ति कितनी स्पष्ट रूप से सौंपे गए हैं।
समस्या | संभावित कारण | क्या आज़माएँ |
मुंह बहुत जल्दी या बहुत देर से चलता है | नई ऑडियो मूल क्लिप के समय-निर्धारण से मेल नहीं खाती, या प्रस्तुति बहुत तेज या बहुत धीमी है | फिर से जनरेट करने से पहले लंबी विरामों को ट्रिम करें, पंक्ति को छोटा करें, या आवाज़ की गति समायोजित करें |
चरित्र के बोलते समय चेहरा बदल जाता है | स्रोत वीडियो में चेहरे के विवरण सीमित हैं, तेज सिर के मोड़, मोशन ब्लर है, या चेहरे के कुछ हिस्से ढके हुए हैं | ऐसा फुटेज उपयोग करें जिसमें मुख्य बोले गए हिस्सों के दौरान चेहरा और मुंह दिखाई देते रहें |
जबड़े या मुंह की हरकत अतिरंजित लगती है | संवाद में तीव्र या मजबूत उच्चारण है जो स्रोत फुटेज में दिखाई देने वाली गति से मेल नहीं खाता | एक छोटा संवाद, धीमी प्रस्तुति, या अधिक स्पष्ट सामने या तीन-चौथाई कोण वाला फुटेज आज़माएं |
सिंक अच्छी तरह शुरू होता है लेकिन बाद में भटक जाता है | एक लंबा वाक्य, असमान गति, या अतिरिक्त विराम धीरे-धीरे ऑडियो को वीडियो टाइमिंग से दूर धकेलते हैं | पूरा क्लिप देखें, फिर उस बिंदु के पास से वाक्य छोटा करें या विराम हटाएं जहाँ बहकाव शुरू होता है |
गलत पात्र बोलता हुआ प्रतीत होता है | प्रॉम्प्ट वक्ता क्रम या संवाद आवंटन को पर्याप्त स्पष्ट नहीं करता है | प्रत्येक पंक्ति कौन बोलता है यह बताएं, बोलने के क्रम को स्पष्ट रखें, और प्रत्येक पात्र के संवाद को स्पष्ट रूप से अलग करें |
अनूदित संवाद जल्दबाज़ी भरा लगता है | अनूदित वाक्य मूल पंक्ति की तुलना में बोलने में अधिक समय लेता है | अनुवाद को शब्दशः स्रोत से मिलाने के बजाय बोले जाने की अवधि के अनुसार पुनर्लेखित करें, फिर आवश्यकता होने पर आवाज़ की गति समायोजित करें |
Lip Sync के लिए, पहले स्रोत क्लिप, ऑडियो टाइमिंग और स्क्रिप्ट की लंबाई की जाँच करें। Native Audio दृश्यों में, बाकी प्रॉम्प्ट में और विवरण जोड़ने से पहले यह भी जाँच लें कि प्रत्येक वक्ता, पंक्ति और बोलने का क्रम स्पष्ट रूप से परिभाषित हैं या नहीं।
समाप्ति
सबसे अच्छा लिप सिंक वीडियो एआई प्रदर्शन का हिस्सा महसूस कराने के लिए भाषण को ऐसा बनाता है, जिससे चरित्र के चलते समय या लंबी लाइनों के दौरान मुँह की हरकतें सटीक रहें और चेहरे की विशेषताएँ व प्राकृतिक अभिव्यक्ति सुरक्षित रहें। समर्थित मौजूदा Kling AI चरित्र वीडियो के लिए, Kling AI Lip Sync आपको दृश्य को दोबारा बनाए बिना नए संवाद या गायन जोड़ने देता है। यदि आप किसी संवाद दृश्य को शुरुआत से बना रहे हैं, तो Kling VIDEO 3.0 Native Audio, मल्टी-कैरेक्टर संवाद और Multi-Shot के माध्यम से संवाद, लिप मूवमेंट, चेहरे की अभिव्यक्तियाँ, ध्वनि और शॉट बदलाव एक साथ जनरेट कर सकता है। यह पोस्ट-प्रोडक्शन में आवाज, मुँह की हरकत और कैमरा बदलाव मिलाने के अलग कार्य को कम करता है, जबकि अंतिम दृश्य को अधिक स्थिर लिप सिंक और अधिक सुसंगत चरित्र प्रदर्शन के साथ एकसाथ बनाए रखने में मदद करता है।
अक्सर पूछे जाने वाले प्रश्न
किस AI का लिप सिंक सबसे अच्छा है?
सबसे बेहतर लिप सिंक AI इस पर निर्भर करता है कि आप क्या बना रहे हैं। किसी मौजूदा समर्थित Kling AI चरित्र वीडियो के लिए, Kling AI Lip Sync को नई आवाज़ या गायन जोड़ने के लिए डिज़ाइन किया गया है; अनूदित वीडियो के लिए, HeyGen और Vozo AI जैसे टूल डबिंग और स्थानीयकरण पर अधिक ध्यान केंद्रित करते हैं; और प्रस्तुतकर्ता-शैली के अवतार वीडियो के लिए, HeyGen अवतार-आधारित वर्कफ़्लो के इर्द-गिर्द बनाया गया है। यदि आप शुरू से एक नया संवाद दृश्य बना रहे हैं, तो Kling VIDEO 3.0 एक ही दृश्य में भाषण, होंठों की गति, चेहरे की अभिव्यक्ति और ध्वनि को एक साथ उत्पन्न कर सकता है। अपने प्रारंभिक सामग्री और आपको साधारण भाषण प्रतिस्थापन, अनुवाद, अवतार प्रस्तुति या पूर्णतः उत्पन्न संवाद दृश्य में से क्या चाहिए, इसके आधार पर उपकरण चुनें।
क्या AI लिप सिंक सॉफ़्टवेयर कई भाषाओं को संभाल सकता है?
हाँ, लेकिन भाषा समर्थन सुविधा के अनुसार बदलता है। Kling Lip Sync अपलोड किए गए भाषण या गायन को सिंक कर सकता है, जबकि Text to Speech उपकरण में उपलब्ध आवाज़ों का उपयोग करता है। नई निर्मित दृश्यों के लिए, VIDEO 3.0 चीनी, अंग्रेज़ी, जापानी, कोरियाई और स्पेनिश में संवाद का समर्थन करता है, जिसमें मिश्रित-भाषा वार्तालाप भी शामिल हैं। भाषा विकल्प मॉडल संस्करण के अनुसार भिन्न हो सकते हैं, इसलिए आप जिस संस्करण का उपयोग कर रहे हैं उसमें दिखाई जाने वाली सेटिंग्स की जाँच करें।
क्या मैं Kling Lip Sync में अपना खुद का ऑडियो उपयोग कर सकता हूँ?
हाँ। Kling Lip Sync आपको अपना स्वयं का वॉयसओवर या गायन ऑडियो अपलोड करने की अनुमति देता है। यदि ऑडियो वीडियो से लंबा है, तो आप उसे जनरेशन से पहले ट्रिम कर सकते हैं। एक स्पष्ट रिकॉर्डिंग और ऐसा स्रोत फुटेज उपयोग करें, जहाँ मुख्य बोलने वाले हिस्सों के दौरान चेहरा दृश्य बना रहे। जनरेशन के बाद, तेज़ संवाद, विराम, लंबे स्वर ध्वनियाँ और अधिक सिर के मूवमेंट वाले क्षणों की जाँच करें ताकि सुनिश्चित हो सके कि मुँह अब भी ऑडियो के साथ सिंक में बना रहे।
Kling Lip Sync और VIDEO 3.0 नैटिव ऑडियो के बीच क्या अंतर है?
Kling Lip Sync किसी मौजूदा समर्थित कैरेक्टर वीडियो में नया भाषण या गायन जोड़ता है, जबकि VIDEO 3.0 Native Audio शुरुआत से ही वीडियो और ध्वनि को एक साथ बनाता है। VIDEO 3.0 के साथ, संवाद, होंठों की हरकत, ध्वनि और Multi-Shot सभी को नए दृश्य में शामिल किया जा सकता है। जब आपके पास पहले से कोई समर्थित Kling AI कैरेक्टर वीडियो हो जिसे आप बनाए रखना चाहते हों, तब Kling Lip Sync का उपयोग करें; जब संवाद दृश्य अभी बनाया जाना बाकी हो, तब VIDEO 3.0 या VIDEO 3.0 Omni का उपयोग करें।