Memilih alat lip sync video AI terbaik bukan hanya soal mencocokkan gerakan mulut dengan audio. Alat tersebut harus membantu menjaga wajah, ekspresi, dan detail video tetap konsisten sepanjang klip. Dalam panduan ini, kami membandingkan alat lip sync AI terkemuka pada 2026 dan meninjau dua alur kerja Kling AI: menggunakan alat Lip Sync untuk menambahkan ucapan atau nyanyian tersinkronisasi ke video karakter yang sudah ada, serta menggunakan Native Audio dalam seri VIDEO 3.0 untuk membuat adegan dialog baru dengan ucapan tersinkronisasi, performa wajah, dan suara sejak awal.
Apa yang Membuat Alat Lip Sync AI Berkualitas?
Memilih alat lip sync video AI terbaik melibatkan lebih dari sekadar memeriksa apakah gerakan mulut sesuai dengan audio. Faktor perbandingan utama mencakup akurasi sinkronisasi, konsistensi wajah, penanganan gerakan, fleksibilitas input, dukungan bahasa, dan performa multi-pembicara.
Faktor Perbandingan | Hal yang Perlu Diperhatikan | Mengapa Penting |
Sinkronisasi Audio-Visual | Gerakan mulut yang selaras dengan bunyi ucapan, jeda, dan waktu kalimat | Masalah sinkronisasi kecil dapat membuat dialog terasa terputus dari video |
Konsistensi Wajah dan Penanganan Gerakan | Ciri wajah yang stabil, ekspresi, gerakan kepala, sudut kamera, dan detail visual | Pembicara harus tetap mudah dikenali sepanjang video |
Fleksibilitas Input | Dukungan untuk video, karakter, avatar, dan adegan yang sudah ada serta yang dibuat oleh AI | Pembuat yang berbeda memulai dengan materi dan kebutuhan produksi yang berbeda |
Dukungan Multibahasa dan Suara | Dukungan untuk berbagai bahasa, suara, dan gaya berbicara | Penting untuk penerjemahan, pelokalan, dan audiens global |
Penanganan Adegan Multi-Pembicara | Pencocokan pembicara yang akurat dan penjadwalan dialog dalam percakapan | Membantu menjaga suara setiap orang tetap selaras dengan pembicara yang tepat |
6 Alat AI Lip Sync Video Terbaik pada 2026
Alat lip sync AI bekerja dengan cara berbeda. Beberapa dibuat untuk menambahkan ucapan baru ke video yang sudah ada, sementara yang lain menggabungkan lip sync dengan terjemahan, avatar, atau adegan yang dibuat AI. Opsi terbaik bergantung pada rekaman awal yang Anda miliki dan jenis video yang ingin Anda buat.
Tabel di bawah membandingkan enam alat lip sync AI dalam hal sinkronisasi video, terjemahan, pembuatan video AI, dan adegan multi-pembicara.
Alat | Penggunaan Utama | Cara Sinkronisasi Bibir Digunakan | Multibahasa & Lokalisasi | Dialog & Multi-Pembicara |
Kling AI | Sinkronisasi bibir untuk video karakter yang sudah ada dan pembuatan dialog asli untuk video AI baru | Gunakan alat Sinkronisasi Bibir khusus untuk mencocokkan audio yang diunggah atau audio Teks-ke-Ucapan dengan video karakter yang didukung dan sudah ada, atau gunakan Audio Native di VIDEO 3.0 / VIDEO 3.0 Omni untuk menghasilkan dialog dan performa visual tersinkronisasi secara bersamaan dalam video baru. | Seri VIDEO 3.0 mendukung pembuatan dialog asli dalam bahasa Mandarin, Inggris, Jepang, Korea, dan Spanyol, termasuk dialog campuran bahasa, dialek, dan aksen. | Seri VIDEO 3.0 mendukung dialog multi-karakter dengan dialog khusus per penutur dan performa wajah yang tersinkronisasi. |
Vozo AI | Sulih suara dan lokalisasi untuk video yang sudah ada. | Ucapan baru atau yang diterjemahkan disesuaikan dengan pembicara dalam rekaman asli | Dibangun di sekitar penerjemahan video dan konten suara terlokalisasi | Mendukung lokalisasi multi-pembicara |
HeyGen | Video avatar dan konten video yang diterjemahkan | Ucapan disinkronkan dengan avatar atau pembicara setelah perubahan suara atau terjemahan | Fokus kuat pada penerjemahan video multibahasa | Mendukung konten avatar dan multi-pembicara |
Sync Labs | Lip sync untuk produksi dan integrasi | Audio dapat disinkronkan dengan video yang ada melalui alat lip sync khusus | Dukungan bahasa bergantung pada pengaturan produksi yang menyertainya | Dapat digunakan untuk sinkronisasi dialog |
PixVerse | Pembuatan video AI berdurasi pendek | Sinkronisasi bibir dapat ditambahkan ke konten karakter yang dihasilkan | Pilihan bahasa berbeda-beda menurut fitur | Mendukung adegan berbicara berbasis karakter |
CapCut | Pengeditan video sosial dan konten kreator | Sinkronisasi bibir dapat ditangani melalui pengeditan dan fitur berbantuan AI | Opsi terjemahan bervariasi menurut alat dan wilayah | Tergantung pada fitur pengeditan yang digunakan |
Pendekatan Sinkronisasi Bibir Mana yang Sesuai untuk Video Anda?
Lip sync memiliki tujuan yang berbeda tergantung pada video yang Anda buat. Rekaman yang sudah ada, konten terjemahan, dan adegan yang baru dihasilkan masing-masing memerlukan pendekatan yang berbeda.
Titik Awal Anda | Apa yang Ingin Anda Buat | Metode yang Disarankan | Alat yang Perlu Dipertimbangkan |
Anda sudah memiliki video karakter yang sudah ada | Ganti suara, tambahkan dialog baru, atau sinkronkan audio baru | Lip sync video yang sudah ada | Kling AI, Vozo AI, Sync Labs |
Anda memiliki video dalam bahasa lain | Buat versi yang dilokalkan untuk audiens berbeda | Terjemahan + pembuatan suara + sinkronisasi bibir | HeyGen, Vozo AI, Kling AI* |
Anda memiliki gambar karakter atau avatar | Buat karakter berbicara dengan ekspresi tersinkronisasi | Karakter berbicara atau avatar yang dihasilkan | Kling AI Avatar, HeyGen |
Anda ingin membuat adegan baru dari awal | Buat karakter, dialog, dan visual secara bersamaan | Pembuatan video AI dengan Native Audio | Kling AI |
Anda sedang membuat percakapan atau adegan cerita | Jaga dialog tetap natural di antara beberapa karakter | Pembuatan dialog multi-karakter | Kling AI |
*Kling Lip Sync dapat menyinkronkan audio bahasa target yang disiapkan atau suara text-to-speech yang tersedia dengan video karakter yang didukung.
Dua Cara Membuat Video AI dengan Sinkronisasi Bibir Menggunakan Kling AI
Pilihan 1: Tambahkan Lip Sync ke Video Karakter yang Sudah Ada
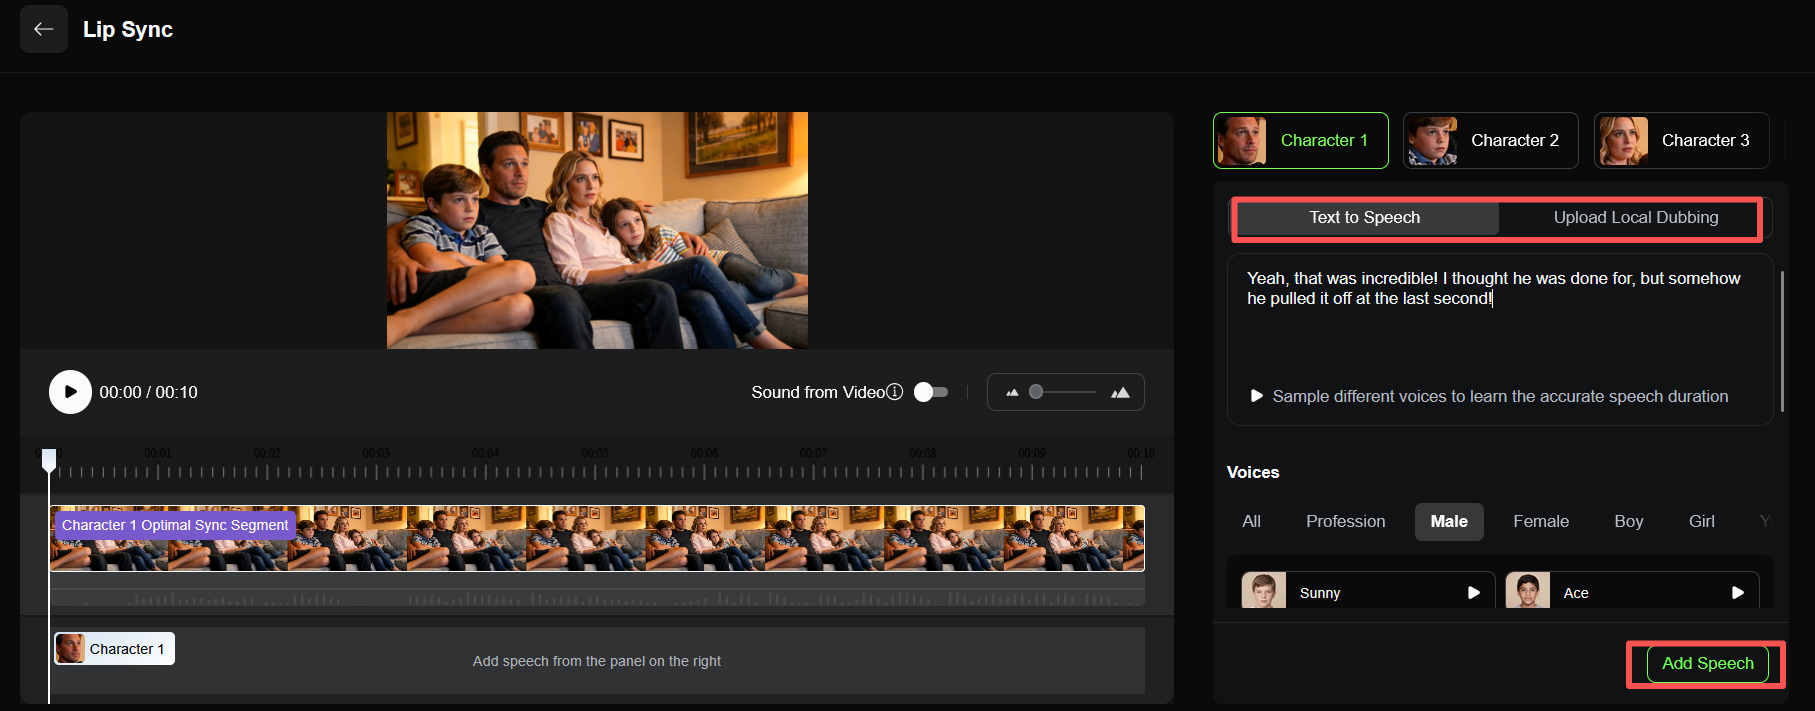
Jika Anda sudah memiliki video Kling karakter AI yang didukung, gunakan alat Lip Sync Kling AI untuk menambahkan ucapan atau nyanyian baru tanpa membuat ulang adegannya dari awal. Anda dapat mengunggah audio sendiri atau menggunakan Text to Speech, lalu menyinkronkan gerakan mulut karakter dengan suara yang baru.
Langkah 1: Pilih Video Karakter yang Jelas
Pilih klip Kling AI yang didukung dengan wajah penuh yang terlihat jelas. Tampilan mulut yang jelas memudahkan untuk menilai apakah ucapan baru tetap sinkron sepanjang klip. Kling AI Lip Sync mendukung karakter manusia realistis, 3D, dan 2D. Jika karakter memalingkan wajah dari kamera atau mulutnya sebagian tertutup, pastikan bagian utama pembicaraan masih menampilkan cukup wajah agar sinkronisasi bekerja dengan jelas.
Langkah 2: Tambahkan Audio atau Masukkan Skrip
Unggah voiceover atau trek bernyanyi, atau gunakan Text to Speech untuk menghasilkan suara dari skrip. Jika audio lebih panjang daripada video, potong terlebih dahulu sebelum generasi. Anda juga dapat menyesuaikan kecepatan Text to Speech ketika sebuah dialog harus masuk ke klip yang lebih pendek. Jaga agar skrip tetap mendekati durasi video yang tersedia sehingga penyampaian tidak terasa terburu-buru atau menyisakan jeda panjang.
Langkah 3: Hasilkan dan Tinjau Lip Sync
Hasilkan versi lip-sync dan tonton klip penuh, termasuk frasa yang lebih cepat, jeda, dan penutup kalimat. Jika bagian dari ucapan terasa terlalu awal atau terlambat, periksa terlebih dahulu durasi dan tempo audionya. Anda dapat menghapus jeda yang tidak perlu dari trek yang diunggah atau menyesuaikan kecepatan Text to Speech sebelum membuatnya lagi. Perhatikan wajah karakter secara keseluruhan serta mulutnya, terutama ketika video asli menampilkan ekspresi yang lebih kuat atau gerakan kepala.

Opsi 2: Hasilkan Dialog Lip-Sync dengan Seri VIDEO 3.0
Jika Anda ingin membuat adegan dialog baru alih-alih menambahkan ucapan ke video yang sudah ada, Kling VIDEO 3.0 dan VIDEO 3.0 Omni dapat menghasilkan dialog, gerakan bibir, ekspresi wajah, visual, suasana, dan efek suara secara bersamaan melalui Native Audio. Jika adegan tersebut sudah mencakup beberapa karakter yang berbicara sejak awal, Anda dapat menggunakan Text to Video AI dan menentukan:
- siapa yang berbicara
- apa yang dikatakan setiap karakter
- urutan berbicara
- bahasa atau aksen
- apa yang dilakukan setiap karakter saat berbicara
| Prompt: Seorang pria dan seorang wanita duduk berhadapan di sebuah kafe modern yang tenang pada malam hari. Pria itu berbicara duluan dalam bahasa Inggris dengan aksen Amerika yang lembut, sedikit condong ke depan, dan berkata, “Aku tidak menyangka kamu akan datang.” Wanita itu menatapnya, berhenti sejenak, lalu menjawab dalam bahasa Inggris dengan aksen Britania, “Hampir saja aku tidak datang.” Dia tersenyum tipis dan perlahan meletakkan cangkir kopinya. Pria itu tampak terkejut dan mulai merespons, tetapi dia berbalik ke arah jendela sebelum dia berbicara lagi. Jaga waktu dialog tetap jelas, dengan gerakan bibir yang alami, ekspresi wajah halus, dan jeda realistis antar pembicara. |
VIDEO 3.0 mendukung dialog multi-karakter dalam bahasa Tionghoa, Inggris, Jepang, Korea, dan Spanyol, serta dialog campuran bahasa, dialek, dan aksen. Beberapa karakter dapat berbagi satu adegan tanpa membuat setiap pembicara sebagai klip terpisah dan menyatukan potongan-potongan itu kemudian.
Dengan Native Audio, dialog, suasana latar, dan efek suara dapat dihasilkan bersamaan dengan visual. Anda dapat mendeskripsikan baris dialog, suasana ruangan, langkah kaki, atau suara lain dalam prompt sehingga suara-suara tersebut menjadi bagian dari adegan alih-alih ditambahkan satu per satu setelah visual selesai. Untuk adegan cerita pendek, percakapan, dan video produk dengan dialog, hal ini mengurangi pekerjaan audio terpisah setelah proses generasi.
Jika Anda ingin kamera bergerak mengikuti percakapan, gunakan Multi-Shot di Kling generator video AI. Sebuah adegan dapat bergerak dari bidikan dua orang ke close-up orang yang berbicara, kemudian berpindah ke reaksi karakter lainnya. Multi-Shot dapat mengatur pergantian bidikan, pembingkaian, dan sudut kamera dari prompt. Jika Anda sudah merencanakan urutan tersebut, Custom Multi-Shot memungkinkan Anda mengatur konten dan durasi setiap bidikan sendiri. VIDEO 3.0 mendukung generasi berdurasi 3–15 detik, sehingga sebuah urutan pendek dapat mencakup dialog, reaksi, pergerakan karakter, dan beberapa pergantian kamera.
VIDEO 3.0 Omni memperluas alur kerja ini untuk kreasi yang lebih berorientasi referensi, menggabungkan Native Audio dengan konsistensi karakter berbasis Element dan masukan multimodal yang lebih luas.
Jika digabungkan, kontrol-kontrol ini memungkinkan Anda membangun sebuah adegan dialog di mana ucapan, gerakan bibir, reaksi karakter, suara, dan pergantian kamera sudah bekerja dalam urutan yang sama alih-alih disusun satu per satu setelahnya.
Gambar |
| Prompt: Sinar matahari memenuhi jalan-jalan tua Madrid. Di depan sebuah toko roti pinggir jalan, seorang turis wanita Tiongkok dan seorang turis pria yang mengenakan hoodie abu-abu berjalan menuju pegawai toko, keduanya menampilkan senyum sopan. Turis wanita (berbicara sedikit pelan, dengan aksen canggung, dalam bahasa Spanyol): Disculpe, ¿dónde está la plaza mayor? Seorang pegawai toko Spanyol berambut putih (sedikit berbalik dan menunjuk ke depan, dengan nada ringan dan ceria, dalam bahasa Spanyol): Por allí, a dos calles. Muy cerca. Turis wanita itu mengangguk untuk menyampaikan terima kasihnya. Turis pria itu juga mengangguk setuju dan berkata (dalam bahasa Spanyol): Muchas gracias. Pegawai toko tersebut tersenyum dan mengangguk sebagai balasan. Kedua turis itu kemudian berbalik dan berjalan ke arah yang ditunjukkan. |
Keluaran |
Apa Masalah Sinkronisasi Bibir yang Paling Umum dan Bagaimana Anda Dapat Memperbaikinya?
Beberapa ketidaksesuaian umum dapat muncul selama pembuatan lip-sync. Biasanya hal ini berasal dari rekaman sumber, penentuan waktu audio, panjang skrip, atau arah pembicara. Berikut cara menemukan penyebabnya dan menyesuaikannya.
Perbaikan bergantung pada alur kerja yang Anda gunakan. Dengan alat Lip Sync, masalah biasanya berkaitan dengan video karakter sumber, penentuan waktu audio, atau panjang skrip. Dengan Native Audio di VIDEO 3.0 atau VIDEO 3.0 Omni, adegan multi-karakter juga dapat bergantung pada seberapa jelas setiap pembicara dan baris dialog ditetapkan dalam prompt.
Masalah | Penyebab yang Mungkin | Apa yang Dapat Dicoba |
Mulut bergerak terlalu awal atau terlalu lambat | Audio baru tidak sesuai dengan waktu klip asli, atau penyampaiannya terlalu cepat atau terlalu lambat | Potong jeda panjang, perpendek kalimat, atau sesuaikan kecepatan suara sebelum membuat ulang |
Wajah berubah saat karakter berbicara | Video sumber memiliki detail wajah terbatas, gerakan kepala yang kuat, blur akibat gerakan, atau bagian wajah tertutup | Gunakan rekaman di mana wajah dan mulut tetap terlihat selama bagian utama yang diucapkan |
Gerakan rahang atau mulut terlihat berlebihan | Dialog tersebut mengandung artikulasi yang cepat atau kuat yang tidak sesuai dengan gerakan yang terlihat dalam rekaman sumber | Cobalah dialog yang lebih pendek, penyampaian yang lebih lambat, atau rekaman dengan tampilan depan atau tiga perempat yang lebih jelas |
Sinkronisasi dimulai dengan baik tetapi melenceng kemudian | Kalimat yang panjang, tempo yang tidak merata, atau jeda tambahan secara bertahap menggeser audio dari penyesuaian waktu video | Tonton klip penuh, lalu pendekkan kalimat atau hilangkan jeda di dekat titik tempat pergeseran mulai terjadi |
Karakter yang salah tampak sedang berbicara | Prompt tersebut tidak cukup menjelaskan urutan pembicara atau penugasan dialog. | Sebutkan siapa yang mengucapkan setiap baris, pertahankan urutan bicara secara eksplisit, dan pisahkan dialog setiap karakter dengan jelas. |
Dialog terjemahan terasa tergesa-gesa | Kalimat terjemahan memerlukan waktu lebih lama untuk diucapkan dibandingkan baris aslinya. | Tulis ulang terjemahan agar sesuai panjang ucapannya alih-alih mencocokkan kata per kata dengan sumber, lalu sesuaikan kecepatan suara jika diperlukan. |
Untuk Lip Sync, periksa terlebih dahulu klip sumber, penentuan waktu audio, dan panjang naskah. Untuk adegan Native Audio, periksa juga apakah setiap pembicara, baris, dan urutan bicara sudah didefinisikan dengan jelas sebelum menambahkan detail lebih lanjut pada bagian lain dari prompt.
Tamat
AI video sinkronisasi bibir terbaik harus membuat ucapan terasa seperti bagian dari penampilan, menjaga gerak mulut tetap akurat saat karakter bergerak atau menyampaikan dialog yang lebih panjang sekaligus mempertahankan fitur wajah dan ekspresi alami. Untuk video karakter Kling AI yang sudah didukung, Kling AI Lip Sync memungkinkan Anda menambahkan ucapan atau nyanyian baru tanpa membuat ulang adegan dari awal. Jika Anda membuat adegan dialog dari awal, Kling VIDEO 3.0 dapat menghasilkan dialog, gerakan bibir, ekspresi wajah, suara, dan pergantian shot secara bersamaan melalui Native Audio, dialog multi-karakter, dan Multi-Shot. Hal ini mengurangi pekerjaan terpisah untuk mencocokkan suara, gerak mulut, dan perubahan kamera di tahap pascaproduksi, sekaligus membantu adegan akhir tetap padu dengan sinkronisasi bibir yang lebih stabil dan performa karakter yang lebih konsisten.
Pertanyaan Umum
AI manakah yang memiliki sinkronisasi bibir terbaik?
AI lip sync terbaik bergantung pada apa yang Anda buat. Untuk video karakter Kling AI yang sudah didukung, Kling AI Lip Sync dirancang untuk menambahkan ucapan atau nyanyian baru; untuk video terjemahan, alat seperti HeyGen dan Vozo AI lebih berfokus pada dubbing dan lokalisasi; dan untuk video avatar bergaya presenter, HeyGen dibangun mengelilingi alur kerja yang dipimpin avatar. Jika Anda membuat adegan dialog baru dari awal, Kling VIDEO 3.0 dapat menghasilkan ucapan, gerakan bibir, ekspresi wajah, dan suara secara bersamaan dalam adegan yang sama. Pilih alat berdasarkan materi awal Anda dan apakah Anda memerlukan penggantian ucapan sederhana, terjemahan, presentasi avatar, atau adegan dialog yang sepenuhnya dihasilkan.
Bisakah Perangkat Lunak AI Lip Sync Menangani Banyak Bahasa?
Ya, tetapi dukungan bahasa berbeda-beda tergantung fitur. Kling Lip Sync dapat menyinkronkan ucapan atau nyanyian yang diunggah, sementara Text to Speech menggunakan suara yang tersedia di alat tersebut. Untuk adegan yang baru dihasilkan, VIDEO 3.0 mendukung dialog dalam bahasa Tionghoa, Inggris, Jepang, Korea, dan Spanyol, termasuk percakapan campuran bahasa. Opsi bahasa dapat berbeda menurut versi model, jadi periksa pengaturan yang ditampilkan di versi yang Anda gunakan.
Bisakah Saya Menggunakan Audio Saya Sendiri di Kling Lip Sync?
Ya. Kling Lip Sync memungkinkan Anda mengunggah sulih suara atau audio nyanyian Anda sendiri. Jika audio lebih panjang daripada video, Anda dapat memangkasnya sebelum proses generasi. Gunakan rekaman yang jelas dan cuplikan sumber di mana wajah tetap terlihat selama bagian utama berbicara. Setelah generasi, periksa kalimat yang lebih cepat, jeda, bunyi vokal yang lebih panjang, dan momen dengan lebih banyak gerakan kepala untuk memastikan mulut tetap selaras dengan audio.
Apa Perbedaan antara Kling Lip Sync dan Native Audio VIDEO 3.0?
Kling Lip Sync menambahkan ucapan atau nyanyian baru ke video karakter yang didukung yang sudah ada, sementara VIDEO 3.0 Native Audio menciptakan video dan suara secara bersamaan sejak awal. Dengan VIDEO 3.0, dialog, gerakan bibir, suara, dan Multi-Shot semuanya dapat dibangun ke dalam adegan baru. Gunakan Kling Lip Sync ketika Anda sudah memiliki video karakter Kling AI yang didukung yang ingin Anda pertahankan; gunakan VIDEO 3.0 atau VIDEO 3.0 Omni ketika adegan dialog masih perlu dibuat.