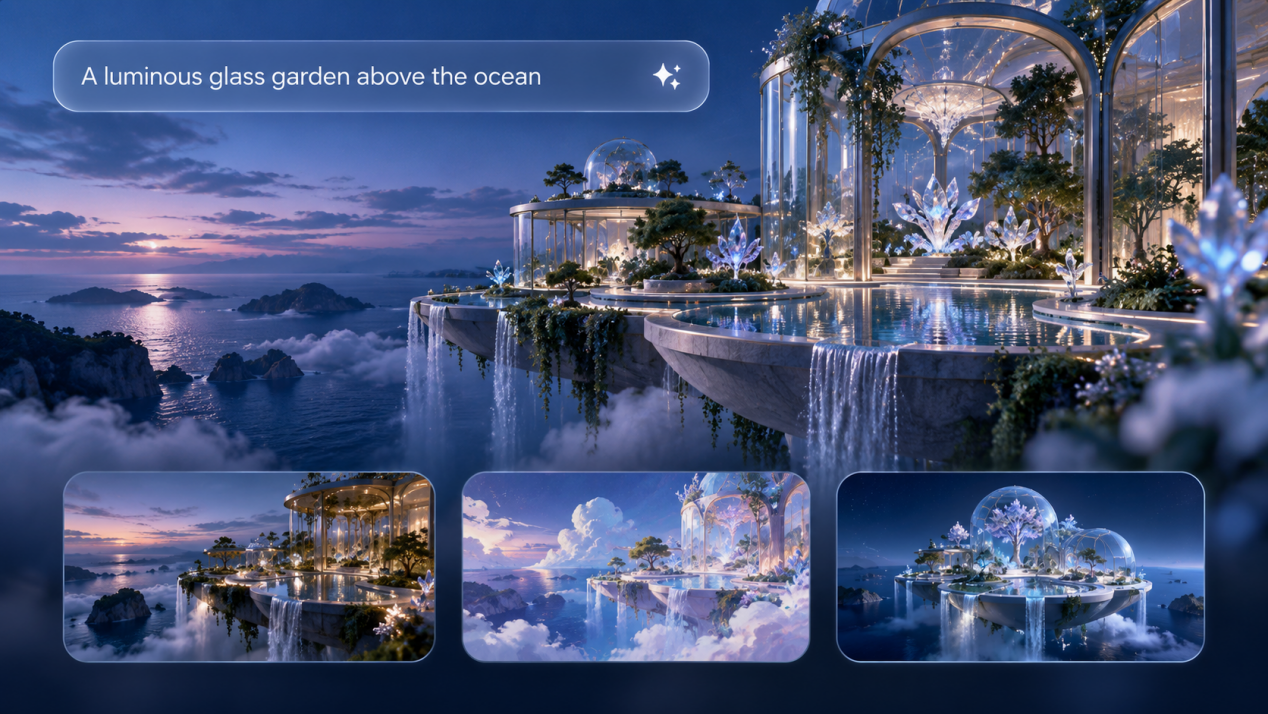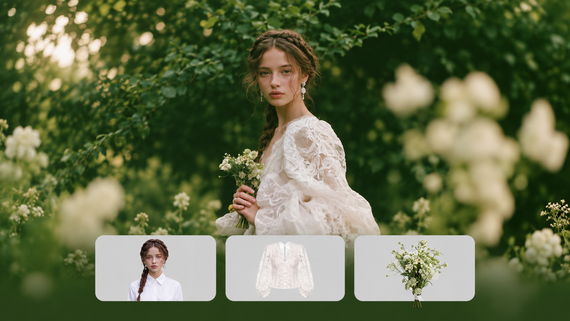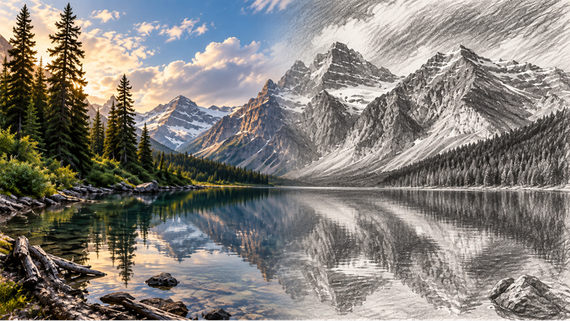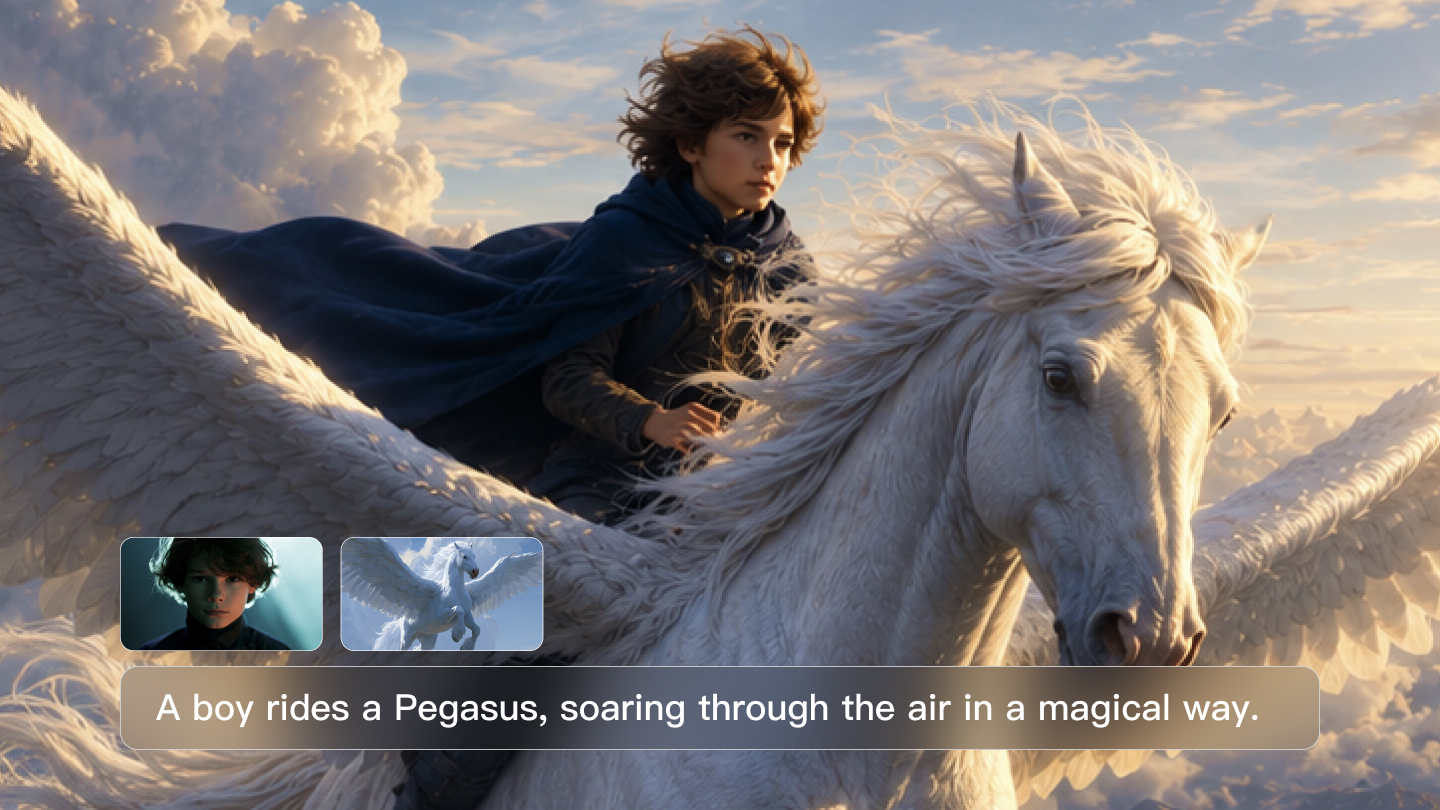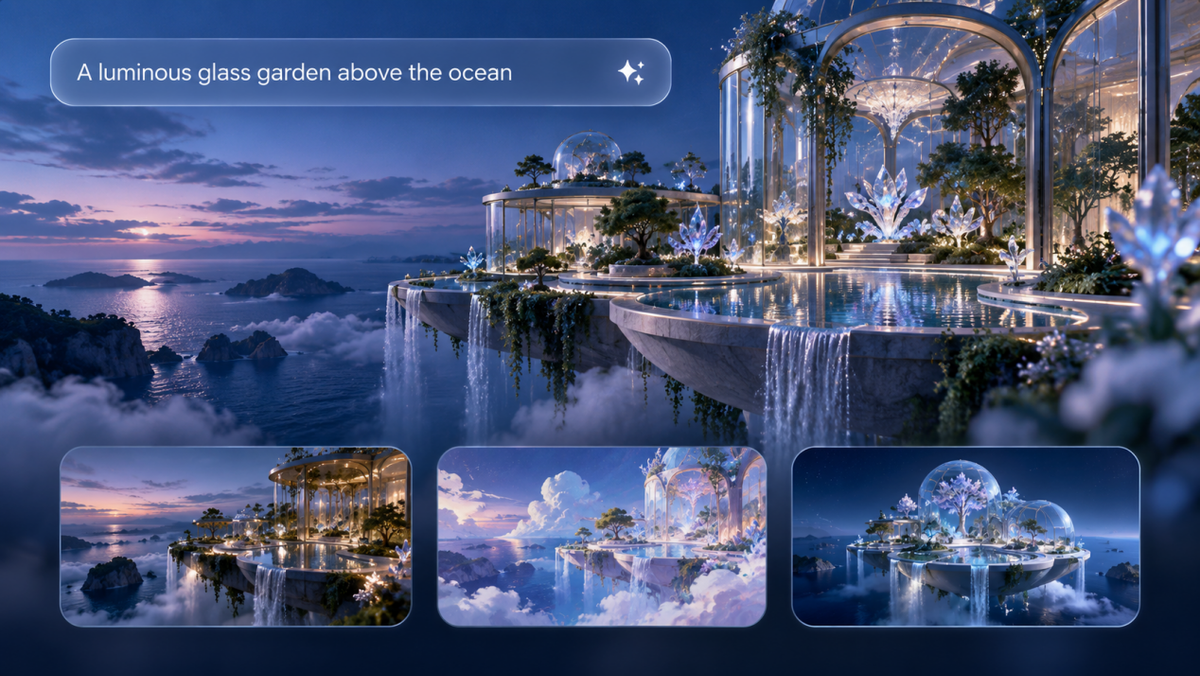
Hanya dengan sebuah ide atau deskripsi sederhana, model text-to-image dapat mengubah bahasa alami menjadi konsep visual. Bagi para kreator, model text-to-image terbaik melampaui sekadar menghasilkan gambar. Model tersebut perlu memahami prompt yang kompleks, menjaga konsistensi visual, dan mendukung penyempurnaan kreatif seiring waktu. Panduan ini menjelaskan cara kerja model text-to-image, membandingkan kemampuan yang paling penting, dan mengeksplorasi bagaimana Kling IMAGE 3.0 menggabungkan kreasi berbasis referensi, penyuntingan presisi, serta alur kerja yang fleksibel untuk membantu kreator mewujudkan ide visual mereka.
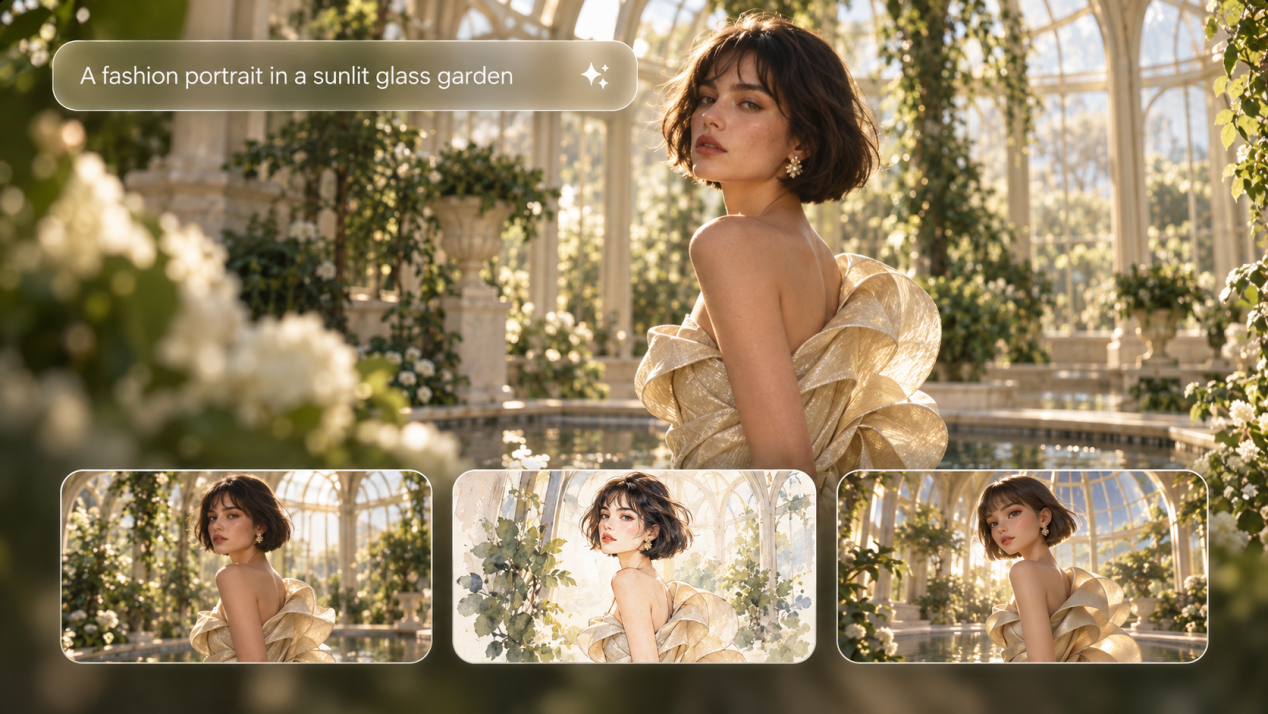
Apa Itu Model Text-to-Image?
Sebuah model text-to-image adalah jenis sistem kecerdasan buatan yang mengonversi prompt bahasa alami menjadi gambar digital berdasarkan detail yang dijelaskan dalam prompt.
Sistem text-to-image modern biasanya menggabungkan komponen yang memahami atau mengodekan prompt dengan komponen pembuat gambar yang mengubah instruksi tersebut menjadi konten visual. Beberapa model juga dapat bekerja dengan gambar dan referensi visual lainnya, membantu mereka mengikuti prompt yang kompleks, mempertahankan detail penting, dan mendukung pengeditan yang lebih presisi.
Sebagai contoh, pertimbangkan sebuah prompt:
| Prompt: Sebuah kamera vintage ditempatkan di atas meja kayu dengan cahaya pagi yang lembut menyinari seluruh adegan. |
Model perlu memahami objek, material, tata letak ruang, pencahayaan, dan gaya visual keseluruhan sebelum menghasilkan gambar yang sesuai.
Saat ini, mengevaluasi model text-to-image mencakup lebih dari sekadar kualitas gambar. Fokusnya telah bergeser ke pemahaman prompt yang akurat, penanganan adegan kompleks, menjaga konsistensi visual, dan mendukung pengeditan yang fleksibel.
Bagaimana Cara Model Text-to-Image Bekerja?
Model text-to-image menerjemahkan deskripsi tertulis menjadi konten visual dengan mempelajari bagaimana bahasa terkait dengan objek, gaya, komposisi, dan detail lainnya. Banyak sistem modern menggunakan metode berbasis difusi, dengan prompt memandu proses bertahap yang secara perlahan mengubah kebisingan visual menjadi gambar selesai.
Proses ini dapat dipahami dalam tiga tahap:
1.Mempelajari Bagaimana Teks Terhubung dengan Gambar
Sebelum membuat gambar, model text-to-image belajar dari dataset besar yang berisi gambar yang dipasangkan dengan deskripsi. Selama pelatihan, model mengidentifikasi pola antara kata dan detail visual, termasuk objek, warna, bentuk, gaya, dan hubungan spasial. Misalnya, model mempelajari bagaimana konsep seperti "vintage camera," "wooden desk," dan "soft morning light" dikaitkan dengan karakteristik visual tertentu.
2.Memahami Prompt
Ketika Anda memasukkan prompt, sistem menerjemahkan teks Anda ke dalam format yang dapat dipahami, menangkap makna inti dan konteksnya. Meskipun teknologi yang tepat berbeda-beda menurut model—dan sistem komersial sering merahasiakan seluruh arsitekturnya—komponen teks dan visual ini bekerja sama untuk menjembatani kata-kata Anda dengan keluaran visual akhir.
3.Menghasilkan Gambar
Banyak model teks-ke-gambar modern menggunakan metode difusi, meskipun model lain mungkin memakai pendekatan generatif autoregresif atau berbeda. Dalam sistem berbasis difusi, proses dimulai dengan noise visual dan secara bertahap menghapus noise tersebut berdasarkan informasi yang diberikan oleh prompt. Melalui langkah denoising berulang, gambar mengembangkan bentuk, detail, dan gaya yang lebih jelas sesuai dengan deskripsi. Beberapa sistem menjalankan proses ini dalam ruang laten terkompresi sebelum mengonversi hasilnya menjadi gambar final. Setelah gambar terbentuk, penyesuaian lebih lanjut dapat dilakukan untuk memperhalus detail atau menyiapkannya untuk penyuntingan.
Apa yang Membuat Model Teks-ke-Gambar Berbeda?
Model teks-ke-gambar dapat merespons dengan sangat berbeda terhadap prompt yang sama. Sebagian berasal dari cara gambar dihasilkan, sementara sebagian lainnya berasal dari jenis masukan yang dapat dibaca dan digunakan oleh model.
Arsitektur Generasi
Pada level generasi, dua pendekatan umum adalah difusi dan generasi autoregresif.
Pendekatan | Cara Kerjanya | Penggunaan Umum |
Model Difusi | Mulai dengan noise visual dan secara bertahap menyempurnakannya menjadi sebuah gambar yang dipandu oleh prompt. | Pembuatan gambar yang detail, adegan realistis, ilustrasi, dan pekerjaan berbasis gaya. |
Model Autoregresif | Membangun sebuah gambar dengan memprediksi token atau elemen visual secara berurutan. | Pembuatan gambar yang menyusun konten visual secara berurutan alih-alih menyempurnakan noise. |
Model difusi tetap menjadi bidang penelitian teks-ke-gambar yang aktif. Survei 2023 Text-to-image Diffusion Models in Generative AI: A Survey memberikan gambaran umum yang berguna tentang metode teks-ke-gambar berbasis difusi, kumpulan data, pendekatan evaluasi, dan aplikasi terkait.
Input Multimodal
Multimodal menggambarkan jenis masukan yang dapat digunakan oleh sebuah model alih-alih cara model tersebut menghasilkan gambar. Model gambar multimodal dapat menerima teks, gambar, dan referensi visual untuk pembuatan berbasis referensi, pengeditan, atau menjaga karakter dan produk tetap konsisten dalam sebuah rangkaian. Di balik itu, model tersebut mungkin masih menggunakan difusi, generasi autoregresif, atau metode lain, sehingga sebuah model dapat masuk ke lebih dari satu kategori.
Apa Model Teks-ke-Gambar Terbaik pada 2026?
Untuk panduan ini, kami memilih tujuh model terkini yang mewakili pendekatan berbeda terhadap pembuatan gambar, pengeditan, kreasi berbasis referensi, dan produksi visual. Urutannya bukan peringkat.
Model | Jenis Model | Terbaik Untuk | Fitur Utama |
Model pembuatan dan penyuntingan gambar dengan input multimodal | Pembuatan berbasis referensi, visual produk, karakter, dan penyuntingan terperinci | Menghasilkan dari teks atau gambar, menggabungkan fitur dari hingga 10 referensi, dan mendukung retensi subjek, penyuntingan presisi, serta kontrol gaya. IMAGE 3.0 mendukung pembuatan hingga 2K, sementara IMAGE 3.0 Omni menawarkan hingga 4K. | |
Leonardo Lucid Origin | Model pembuatan gambar | Ilustrasi, seni konsep, mockup produk, dan pembuatan gambar umum | Mencakup beragam gaya, mengikuti prompt terperinci, menghasilkan gambar Full HD, dan mendukung rendering teks yang mudah dibaca. |
Seedream 5.0 Pro | Model pembuatan dan pengeditan gambar | Gambar produk, infografik, aset desain, dan penyuntingan lokal | Bekerja dari teks atau gambar, menerima referensi, mendukung pengeditan regional, dan menangani input serta generasi multibahasa. |
Adobe Firefly Image 5 | Model generasi dan pengeditan gambar | Produksi desain, aset pemasaran, dan proyek berbasis Adobe | Menghasilkan dari teks, bekerja dengan gambar referensi, dan memungkinkan pengeditan terarah di Photoshop sambil membiarkan konten gambar di sekitarnya tetap utuh. |
Krea 2 Large | Model generasi gambar | Fotorealisme, pekerjaan berpandu gaya, dan arahan visual | Dioptimalkan untuk fotorealisme ekspresif, dengan pembuatan berbasis prompt dan kontrol berpemandu referensi atas komposisi, subjek, dan gaya. |
Luma UNI-1.1 | Model gambar multimodal terpadu | Pembuatan dipandu referensi dan revisi gambar | Menggabungkan pembuatan gambar dengan penyuntingan bahasa alami dan menerima hingga sembilan masukan referensi dalam satu permintaan. |
Runway Gen-4 Image | Model pembangkitan gambar dalam platform gambar dan video | Pengembangan karakter, desain adegan, dan proyek yang kemudian beralih ke video | Menghasilkan dari teks dan gambar referensi, menggunakan hingga tiga referensi per generasi, dan dapat membawa karakter, objek, atau ciri visual ke adegan baru. |
Bagian berikutnya membandingkan model-model ini berdasarkan kepatuhan terhadap prompt, penanganan referensi, pengeditan, konsistensi visual, dan kontrol gaya.
Bagaimana Perbandingan Model Teks ke Gambar pada 2026?
Model teks ke gambar paling berbeda dalam hal akurasi prompt, penggunaan referensi, pengeditan, konsistensi, dan kontrol gaya. Perbedaan ini lebih mudah terlihat pada proyek yang melibatkan gambar berulang, revisi, produk, atau karakter yang muncul kembali.
Area Perbandingan | Apa yang Harus Dibandingkan | Mengapa Itu Penting |
Kepatuhan terhadap Prompt | Subjek, atribut, hubungan antar objek, komposisi, dan detail yang diperlukan. | Sebuah gambar yang telah dipoles tetap kurang jika tidak memenuhi arahan. |
Penanganan Referensi | Jumlah referensi, retensi subjek, transfer gaya, dan panduan komposisi. | Referensi membantu menjaga karakter, produk, atau arah visual tetap dikenali di berbagai gambar. |
Pengeditan Gambar | Perubahan lokal, penyuntingan bahasa alami, dan seberapa baik area yang tidak disentuh tetap utuh. | Pengeditan yang presisi menghemat waktu dan mencegah membangun ulang gambar dari awal. |
Konsistensi Visual | Karakter, produk, pakaian, gaya, dan detail berulang di seluruh gambar atau revisi. | Detail yang konsisten penting untuk rangkaian gambar, kampanye, storyboard, dan rangkaian produk. |
Kontrol Gaya | Pencahayaan, palet, tekstur, tampilan fotografi, gaya ilustrasi, dan arah visual. | Kontrol gaya yang jelas membantu menjaga gambar terkait tetap terhubung secara visual. |
Kesesuaian Alur Kerja | Revisi, opsi ekspor, penggunaan gambar-ke-video, dan kompatibilitas dengan alat kreatif lainnya. | Apa yang terjadi setelah proses pembuatan bisa sama pentingnya dengan gambar pertama. |
Model yang bekerja baik untuk gambar konsep cepat mungkin tidak cocok untuk rangkaian produk atau proyek karakter. Akurasi prompt dan gaya mungkin cukup untuk satu gambar, sementara pekerjaan berulang sering memerlukan referensi yang lebih kuat, pengeditan, dan konsistensi.
Cara Memilih Model Teks-ke-Gambar Terbaik?
Saat memilih generator gambar AI, mulailah dengan apa yang ingin Anda buat dan detail mana yang perlu tetap tidak berubah saat Anda merevisi gambar. Tabel di bawah ini menunjukkan hal-hal yang perlu diperhatikan dalam beberapa skenario umum.
Jika Anda Membutuhkan | Cari | Mengapa Itu Penting |
Gambar konsep cepat | Akurasi prompt, kualitas gambar, dan ragam gaya | Anda dapat mendekati hasil yang dimaksud dengan lebih sedikit revisi. |
Karakter atau produk yang konsisten | Penanganan referensi dan retensi detail | Wajah, pakaian, produk, dan fitur penentu lainnya perlu tetap mudah dikenali di seluruh gambar. |
Revisi gambar yang sering | Pengeditan lokal dan perubahan dengan bahasa alami | Anda dapat menyesuaikan satu bagian gambar tanpa membangun ulang seluruh adegan. |
Aset kampanye atau rangkaian gambar | Subjek, gaya, dan komposisi yang stabil | Gambar terkait perlu berbagi arah visual yang sama. |
Gambar yang nantinya beralih ke video | Gambar referensi dan opsi gambar-ke-video | Subjek dan detail visual yang stabil lebih mudah dibawa ke dalam gerakan. |
Mengapa Kling IMAGE 3.0 Layak Dipertimbangkan?
Kling IMAGE 3.0 memungkinkan Anda memulai kreasi dengan prompt teks atau gambar referensi, lalu menyempurnakan setiap detail menggunakan bahasa alami. Melampaui generasi standar, ini memberi Anda kontrol mendalam atas konsistensi karakter, penyuntingan presisi, dan penyesuaian gaya, membuka kemungkinan kreatif tanpa batas.
Ubah Ide Kompleks Menjadi Visual Segar
IMAGE 3.0 memungkinkan Anda memadukan petunjuk visual dari berbagai referensi dan menggunakan bahasa sehari-hari untuk melampaui penyuntingan standar. Gabungkan subjek antar gambar, balik perspektif suatu adegan, atau ubah sebuah konsep ke gaya yang sama sekali baru—semuanya sambil menjaga hasil akhir tetap mulus dan kohesif.
Gambar Referensi 1 | Gambar Referensi 2 | Gambar Keluaran |
Prompt: Gabungkan hewan dari gambar 1 dan gambar 2. | ||
Pastikan Karakter, Produk, dan Detail Kunci Tetap Mudah Dikenali
Anda dapat menggunakan hingga 10 gambar referensi dalam satu proses generasi. Referensi yang berbeda dapat mendefinisikan karakter, pakaian, produk, latar, atau gaya sementara prompt Anda menjelaskan bagaimana elemen-elemen tersebut harus digabungkan. Untuk perbaikan potret, referensi wajah dapat membantu mempertahankan ciri-ciri wajah yang mudah dikenali saat Anda mengubah gaya rambut, pakaian, pose, atau pengaturan. Jika Anda hanya ingin menukar wajah ke dalam bidikan yang sudah ada, Anda juga dapat langsung masuk ke alur kerja face swap milik Kling.
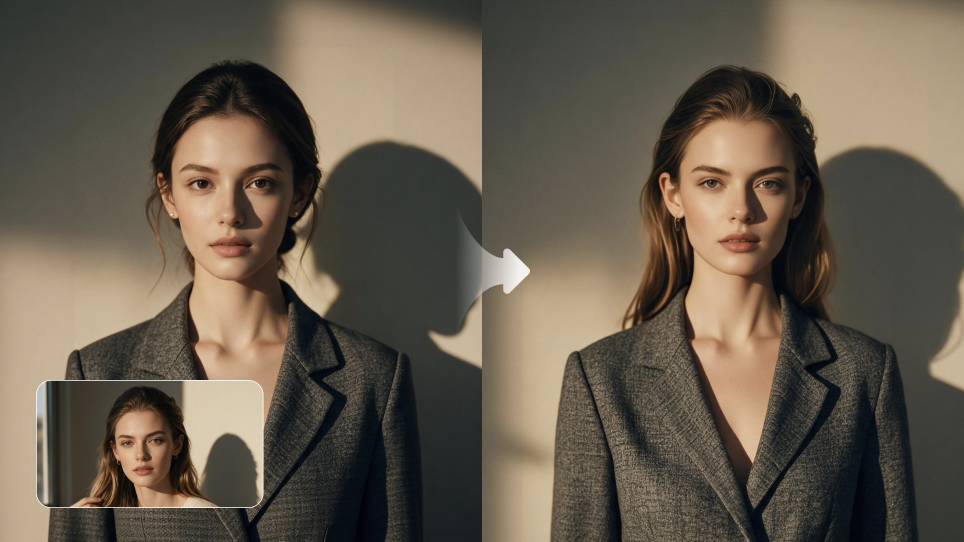
Hanya Ubah Apa yang Perlu Diubah
Jika sebagian besar gambar sudah terlihat benar, Anda dapat menggunakan Kling IMAGE 3.0 sebagai editor foto AI untuk menyesuaikan detail tertentu tanpa membangun ulang seluruh adegan. Instruksi berbahasa alami dapat mengubah ukuran, warna, material, ekspresi, atau latar belakang suatu objek sambil berupaya mempertahankan bagian gambar di sekitarnya. Anda juga dapat menggunakan Kling AI sebagai penghapus watermark untuk gambar yang Anda miliki atau yang Anda memiliki izin untuk menyunting. Pengeditan lainnya mencakup pewarnaan foto, efek vintage, edit coretan, perubahan pencahayaan dan nada, serta restorasi gambar.
Pertahankan Gaya dan Nada Konsisten di Seluruh Gambar Jika Anda sudah memiliki arah visual yang jelas, Anda dapat menggunakan gambar yang ada sebagai referensi gaya. Kling IMAGE 3.0 dapat membawa elemen seperti sapuan kuas, warna, komposisi, dan nada ke dalam gambar baru. Ini bekerja dengan baik untuk set ilustrasi, visual produk, atau konten bermerek ketika tampilan yang sama perlu muncul di lebih dari satu gambar.
Gambar Referensi 1 | Gambar Referensi 2 | Gambar Keluaran |
Prompt: Ubah gaya Gambar 1 menjadi gaya Gambar 2 | ||
Akhir
Model teks ke gambar berbeda dalam hal apa yang paling mereka kuasai, jadi pilihan yang tepat bergantung pada apa yang Anda perlukan setelah gambar pertama dihasilkan. Jika Anda hanya perlu konsep cepat, akurasi prompt dan kualitas gambar mungkin sudah cukup. Untuk visual produk, karakter berulang, atau seri gambar, referensi, pengeditan, dan konsistensi menjadi lebih penting. Jika Anda ingin memulai dari teks atau visual yang sudah ada, Kling IMAGE 3.0 memungkinkan Anda menggabungkan referensi, mengubah detail tertentu, dan mempertahankan tampilan yang sama ke gambar baru. Baik Anda membangun kampanye produk, mengembangkan karakter berulang, atau mengubah konsep awal menjadi set visual yang selesai, model yang tepat seharusnya memudahkan Anda mempertahankan detail yang penting seiring proyek berkembang.
FAQ
Model Bahasa AI mana yang digunakan untuk pembuatan teks-ke-gambar?
Tidak ada satu model bahasa pun yang digunakan oleh setiap sistem teks-ke-gambar. Jika Anda bertanya model bahasa AI mana yang digunakan untuk kemampuan pembuatan teks-ke-gambar, jawabannya berbeda-beda tergantung model. Beberapa sistem menggunakan pengenkode teks seperti CLIP atau T5, sementara yang lain menggunakan komponen bahasa atau visi-bahasa untuk membaca prompt sebelum gambar dihasilkan.
AI mana yang dapat mengubah teks menjadi gambar?
Banyak model gambar AI dapat mengubah prompt tertulis menjadi gambar jadi, termasuk Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1, dan Runway Gen-4 Image. Setiap model menangani prompt, referensi, penyuntingan, dan konsistensi visual secara berbeda, sehingga model yang tepat bergantung pada jenis gambar yang perlu Anda buat.
Bisakah model teks-ke-gambar menggunakan gambar referensi?
Ya. Banyak model teks-ke-gambar dapat menggunakan gambar referensi bersama prompt tertulis, yang membuat AI gambar-ke-gambar berguna ketika Anda ingin bekerja dari visual yang sudah ada alih-alih memulai dari awal. Referensi tersebut dapat menetapkan detail seperti karakter, produk, pose, komposisi, warna, atau gaya, sementara prompt memberi tahu model apa yang harus diubah. Kling IMAGE 3.0 dapat menggunakan hingga 10 gambar referensi dalam satu proses generasi, yang membantu ketika karakter, produk, atau gaya visual yang sama perlu tetap mudah dikenali.
Bagaimana Cara Menghapus Latar Belakang dari Gambar?
Jika Anda membutuhkan gambar produk yang lebih bersih, foto profil, atau aset desain, Anda bisa menghapus latar belakang dari sebuah gambar dan menjaga subjek utama tetap terisolasi. Latar belakang transparan bekerja dengan baik untuk daftar produk, presentasi, unggahan media sosial, atau tata letak di mana subjek perlu ditempatkan pada latar berbeda. Setelah penghapusan, periksa tepi halus di sekitar rambut, pakaian, bulu, atau objek kecil, lalu pertahankan latar belakang tetap transparan, ganti ke warna solid, atau tempatkan subjek dalam adegan baru.