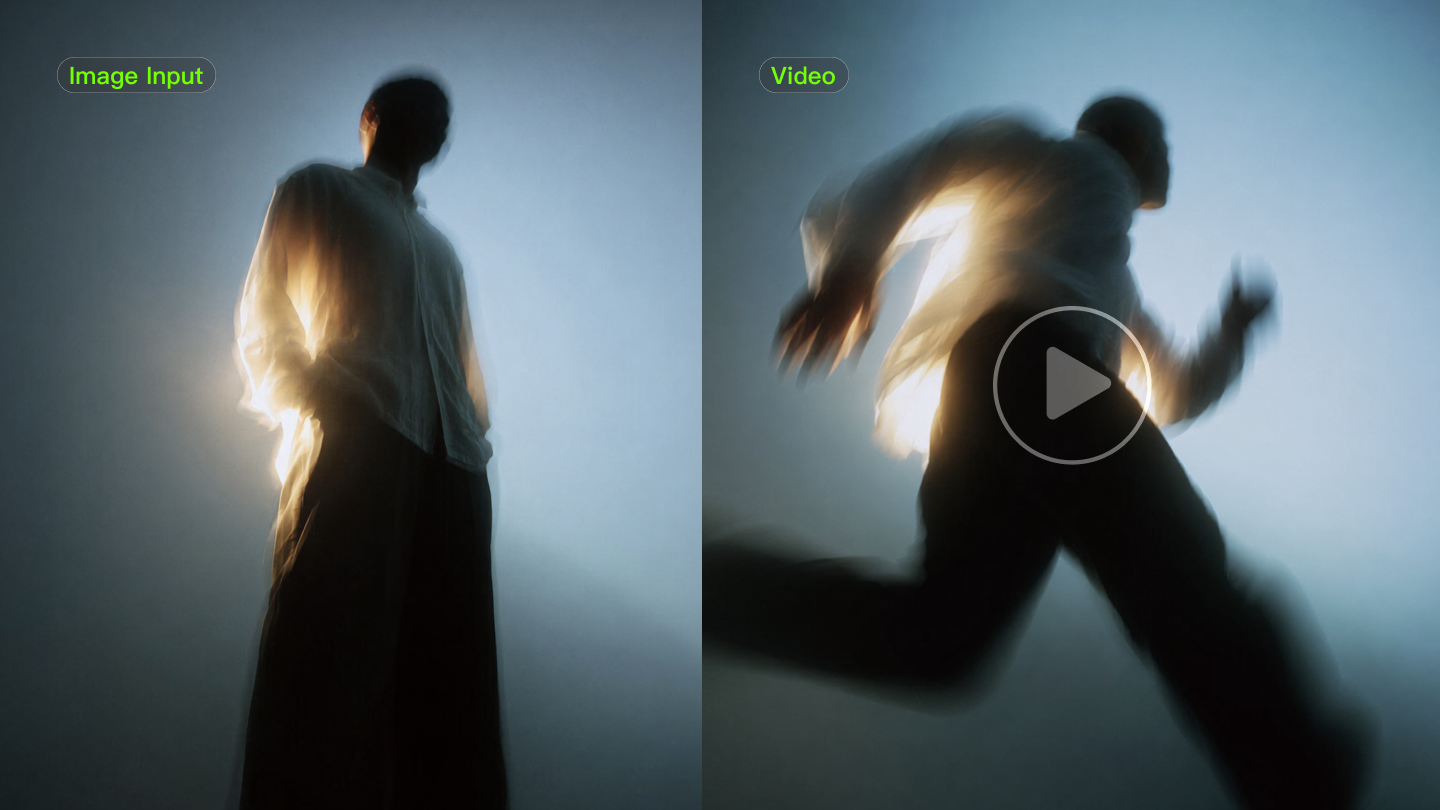
画像から動画へのAIジェネレーターは、静止画像をアクション、雰囲気、ストーリーテリングを備えた動くシーンへと変換します。風景写真が映画のシーンのオープニングショットになり得るように、キャラクターのイラストは新しい舞台に入り込み、ポートレートは動きや表情、音を通じて短いビジュアルストーリーへと発展できます。しかし、説得力のある動画を作ることは単に動きを加えるだけではありません。
最良の画像から動画へのAI ツールには、元の画像の価値を支えるディテールを維持する力が求められます。被写体は認識できるままであるべきで、製品は本来の形状と細部を保ち、すべての動きはシーンの中で自然に感じられなければなりません。
本ガイドでは、モーション品質、一貫性、オーディオ機能、クリエイティブコントロール、実際のユースケースの観点から、2026年のベスト画像から動画へのAIジェネレーター10種を比較し、Kling AIが静止画像をより完成した動画シーンへ変換するためにMulti-Shot生成、Native Audio、キャラクターの一貫性をどのように組み合わせているかも紹介します。
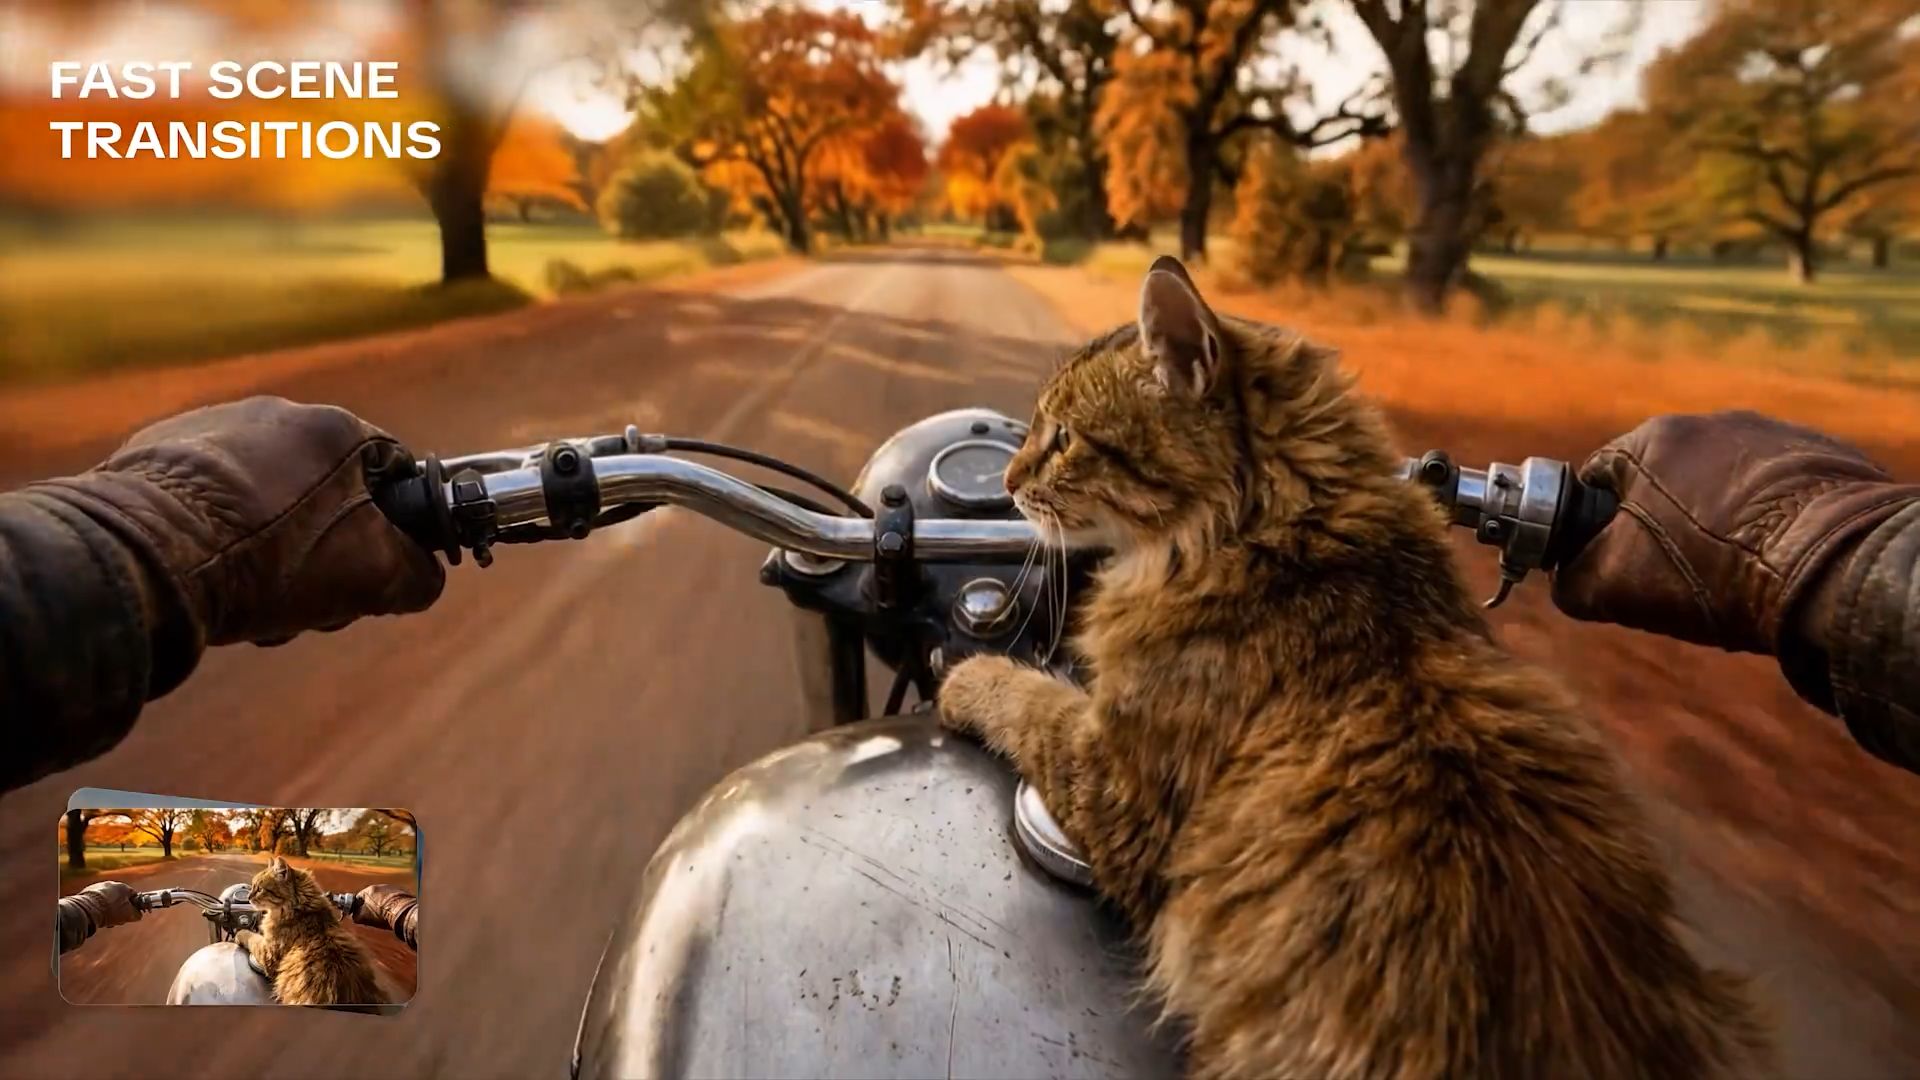

私たちは最高の画像から動画へのAIジェネレーターをどのように比較しましたか?
最終結果に最も影響する要素、すなわち元の画像をどれだけ保持するか、クリエイティブな方向性にどれだけ従うか、さまざまな種類の動画プロジェクトにどのように対処するかに基づいて各ツールを比較しました。
この比較のために、各ツールの現在の機能、公式製品情報、利用可能なコントロール、および実用的なユースケースを確認しました。
比較項目 | 重視するポイント |
モーションの品質 | キャラクターやオブジェクト、カメラの動きが元の画像からどれほど自然に展開していくか。 |
視覚的一貫性 | 生成された動画が重要な視覚的ディテールをどの程度維持しているか、また同じ人物やキャラクター、オブジェクトが動きやシーンの変化の中でも認識できるままであるかどうか。 |
クリエイティブコントロール | リファレンス画像、カメラへの指示、キーフレーム、ショットのプランニング、モーションプロンプトなど、結果を導くために利用できるオプション。 |
オーディオ機能 | ツールが動画制作プロセスの一部として、セリフ、環境音、効果音、または同期された音声を生成できるかどうか。 |
ユースケース適合性 | 各ツールが、短いSNSクリップや製品ビジュアルからキャラクタービデオや映画風プロジェクトまで、さまざまなニーズをどのようにサポートするか。 |
2026年におけるAI画像から動画へのジェネレーター10選
最適な画像から動画へのAIジェネレーターは、何を作りたいかによって異なります。一部はリアルな動きに注力し、別のものはクリエイターにシーン構成への制御をより多く提供し、また別のものはショートフォームコンテンツやリファレンスベースのプロジェクトにより適しています。以下の表は、画像から動画を作成するうえで重要な領域にわたって各ツールの主要機能を比較しています。
ブランド / モデル | モーション品質 | ビジュアルの一貫性 | クリエイティブコントロール | オーディオ機能 | 最適なユースケース |
| キャラクター、物体、カメラの動きを自然に表現 | 動きや複数ショットのシーンでも顔、製品、キャラクターの判別性を維持 | マルチショット、カスタムマルチショット、要素参照、開始・終了フレーム | ダイアログ、環境音、効果音、多言語音声、複数キャラクターの話者マッチングに対応したネイティブオーディオ。 | UGC動画、製品ビジュアル、シネマティックなシーン、ブランドコンテンツ | |
Google Veo | 精細な環境とシーンの挙動を備えたリアルな動き | シーン全体の一貫性と視覚的リアリズムを維持 | プロンプトに基づくシーン演出とビジュアルガイダンス | 会話、効果音、環境音、音楽を備えたネイティブオーディオ。 | 映画スタイルのシーン、リアルな環境、ビジュアルストーリーテリング |
Runway | ガイドされたシーン展開による滑らかなモーション | クリエイティブな変更の際も全体的なビジュアル構造を維持 | カメラ指示、リファレンス、制作志向のコントロール | 音声、効果音、音楽用に別々のオーディオ生成ツールを備える。Gen-4.5のimage-to-videoにはネイティブオーディオが記載されていない。 | プロのクリエイター、マーケティング動画、制御されたショット向け |
Seedance | 複数の参照とシーン指示によって導かれるモーション | 複数の参照を用いてキャラクターやビジュアル要素を導きます | 複数参照の入力とシーン計画 | 会話、効果音、環境音、背景音楽を含むデュアルチャネル音声による音声と映像の統合生成。 | ストーリーテリングプロジェクトと複数シーンのコンセプト |
Luma AI | 動的なカメラ移動と変化する視点 | 視覚的な探索中でもシーン全体の構造を維持します | カメラに特化した操作とモーションガイダンス | 音声サポートはモデルによって異なります。 | コンセプト動画、製品発表、カメラ中心のシーン |
Adobe Firefly | 既存の画像やデザインをビデオシーンへ拡張します | Adobeのワークフロー内の既存のクリエイティブアセットと連携します | Adobeのクリエイティブツールおよびデザインプロセスとの統合 | 音声、音楽、効果音用に個別のツールを用意し、ネイティブオーディオは選択したビデオモデルに依存します。 | ブランドコンテンツ、マーケティングアセット、デザインプロジェクト |
Hailuo AI | 多様な入力から異なるモーションスタイルをサポートします | 画像ベースのリファレンスやクリエイティブな入力を利用して結果を導きます | 画像、動画、テキストプロンプトなどの入力を組み合わせます | MiniMax H3 は、ネイティブステレオサウンドの共同生成をサポートします。 | 実験的なプロジェクトと混合入力による動画制作 |
Vidu | 繰り返し登場する被写体の安定した動きをサポートします | リファレンスから動画へのワークフローがキャラクターの個性を維持するのに役立ちます | リファレンス画像と被写体のガイダンス | セリフと効果音を備えたネイティブ音声・映像生成 | キャラクター動画とリファレンスベースのプロジェクト |
Pika | 高速モーション効果と画像変換 | 厳密なディテール保持よりも、創造的な変化に適している | 効果、変換、迅速な調整 | 別の Pika Audio ツールは、同期されたサウンドトラック、音声、音楽、環境音、効果音を生成できる。 | ソーシャルクリップ、短編動画、創造的な実験 |
PixVerse | スタイライズされた動きとアニメーションの効果 | 厳密な画像保持よりもビジュアルスタイルに重点を置く | 芸術的なエフェクトと視覚的な変換 | PixVerse V6は、会話や効果音、環境音を含むネイティブオーディオをサポートします。 | スタイライズされた動画、アニメーション、エフェクト主体のコンテンツ |
あなたのニーズに最適な画像から動画へのAIジェネレーターはどれですか?
各ツールの主要な機能を比較したら、最適な画像から動画へのAIを見つけるには、まず自分が何を作りたいのかを理解することから始まります。商品動画、シネマティックなシーン、キャラクターの物語では、それぞれ必要なアプローチが異なります。下の表を使って、プロジェクトの目的に合うツールを見つけてください。
プロジェクトの目的 | 推奨ツール | 理由 |
リアルな動きと被写体の一貫性に最適 | Kling AI、Google Veo | シーンが展開する間に人、製品、またはcharactersが認識可能なままである必要があるプロジェクトに適しています。 |
映画的なシーンとクリエイティブな演出に最適 | Kling AI, Runway | 視覚的なアイデアから最終カットまで、シーンの展開を形作りたいクリエイターに適しています。 |
キャラクター中心のストーリーテリングに最適 | Kling AI, Vidu, Seedance | キャラクターが一貫したビジュアルアイデンティティを保ちながら異なるシーンに登場する必要があるプロジェクトに役立ちます。 |
製品およびブランド動画に最適 | Kling AI, Adobe Firefly | 既存のビジュアルをブランデッド動画コンテンツに変換しつつ、元のクリエイティブの方向性を維持するのに適しています。 |
ソーシャル向けのクリップとクリエイティブな効果に最適 | Kling AI, Pika, PixVerse | 短尺コンテンツ、ビジュアル変換、およびソーシャルプラットフォーム向けに設計されたクリエイティブな実験に適しています。 |
カメラ重視のシーンに最適 | Kling AI, Luma AI | カメラの動き、視点の変化、ビジュアルの探求が主な焦点となるプロジェクトに適しています。 |
リファレンスベースのクリエイティブプロジェクトに最適 | Kling AI, Hailuo AI | 画像、参照素材、テキスト指示が連携して最終的な動画を導くときに役立ちます。 |
なぜ Kling はイメージから動画の制作で際立つのか?
初めてのAI動画を制作する場合でも、ブランドコンテンツを作成する場合でも、TikTokやInstagramのようなプラットフォーム向けに短いクリップを用意する場合でも、適切なイメージから動画へのツールは単純なアニメーション以上のことに対応する必要があります。オリジナル画像の重要な部分を識別可能なまま保ち、動きを自然に感じさせ、シーンで何が起こるかをあなたが指示できるようにしなければなりません。
Kling VIDEO 3.0 は被写体の一貫性、Multi-Shot シーン開発、Native Audio、高品質な 4K 動画出力を組み合わせてこれらの機能を実現します。単一の画像を完全な動画シーンへと変換し、被写体の動きやオーディオ、全体的な方向性をより細かく制御できるようにします。
動きの中でも被写体を識別可能に保つ
イメージから動画の生成における最大の課題の一つは、動きが始まった後も主な被写体を識別可能なまま保つことです。
ポートレートは最初のフレームでは正確に見えても、人が向きを変えたり、カメラが動いたり、シーンが進行したりすると変化する場合があります。製品は全体の形状を保ちながらも、素材や色、デザイン要素などの重要なディテールを失ってしまうことがあります。
Kling VIDEO 3.0 は複数の画像リファレンスをサポートしており、同じ被写体の異なる視点を提供できます。さまざまな角度からのリファレンス画像を使用することで、モデルは人物、製品、キャラクターの重要な視覚的特徴をよりよく理解し、動画全体でそれらのディテールを維持するのに役立ちます。
これは特に次のケースで役立ちます。
- 一貫した外見を維持する必要があるブランドの代表者;
- 正確な視覚的ディテールが求められる製品;
- 複数のシーンにわたって登場するキャラクター。
画像 | ||
| ||
キャラクター参照 | ||
| プロンプト: カメラは徐々に少女の前方へと回り込み、彼女は顔を上げてカメラに向かって温かく微笑み、まるで長年ぶりに旧友に会ったかのように見える。 | ||
動画 | ||
自然な音声と複数キャラクターの対話を生成
映像と音が一致しないと、ビデオシーンは不完全に感じられます。Kling VIDEO 3.0には Native Audioが含まれており、映像と一緒に会話、環境音、効果音を生成します。中国語、英語、日本語、韓国語、スペイン語を含む複数の言語をサポートし、さまざまなアクセントや方言にも対応します。
画像 |
プロンプト:朝霧に包まれた小さな駅で、少年が微笑みながら弁当を手渡した。「急いで作ったけど、大丈夫? お母さんのレシピだよ。」 少女は笑顔でそれを受け取り、「うん、きっと美味しい! 到着したらLINEするね。」と答えた。 |
動画 |
Native Audioは対話とそれに対応する口の動きを同時に生成します。生成済みの動画に後から音声を追加または差し替えたいクリエイター向けに、Kling AIは選択した音声に合わせてキャラクターの口の動きを同期させる個別の リップシンクツールも提供しています。
インテリジェントかつカスタムなショットプランニングでマルチショット動画を作成
1枚の画像は一瞬を捉えられますが、完全なストーリーテリングには構図、視点、ショット構造の変化がしばしば求められます。
Kling VIDEO 3.0 シリーズは Multi-Shot をサポートし、プロンプトに基づいてシーンの切り替え、ショット構成、カメラアングルの変化を知的に計画します。モデルは説明を分析して連続したショットシーケンスを作成し、シーンが単一の連続ショットとして機能するほうが良い場合は構成を調整できます。
より多くの制御を必要とするクリエイター向けに、Custom Multi-Shot では各ショットの内容、持続時間、構成を定義できます。ビデオ全体を通して一貫したビジュアルの方向性を維持しながら、各シーンがどのように展開するかを決められます。
例えば:
キャラクターのシーンは次のように移り変わります。
- 導入ショットから;
- より近いリアクションショットへ;
- 最終的なクローズアップショットへ。
製品動画は次のように移行できます:
- より広い導入ショットから;
- 詳細な製品ビューへ;
- 最終的なプレゼンテーションショットへ。
柔軟なショット計画と制御により、Kling VIDEO 3.0 シリーズはクリエイターを支援します。
- ストーリーテリングが連続した動画を素早く作成できます。
- ショットのテンポと映像構成を正確に制御できます。
- 製品紹介やシネマティックなトランジション、ブランド動画、クリエイター主導のUGCコンテンツを制作できます。
画像 | 動画 |
|
|
Klinで画像を動画に変換する方法g?
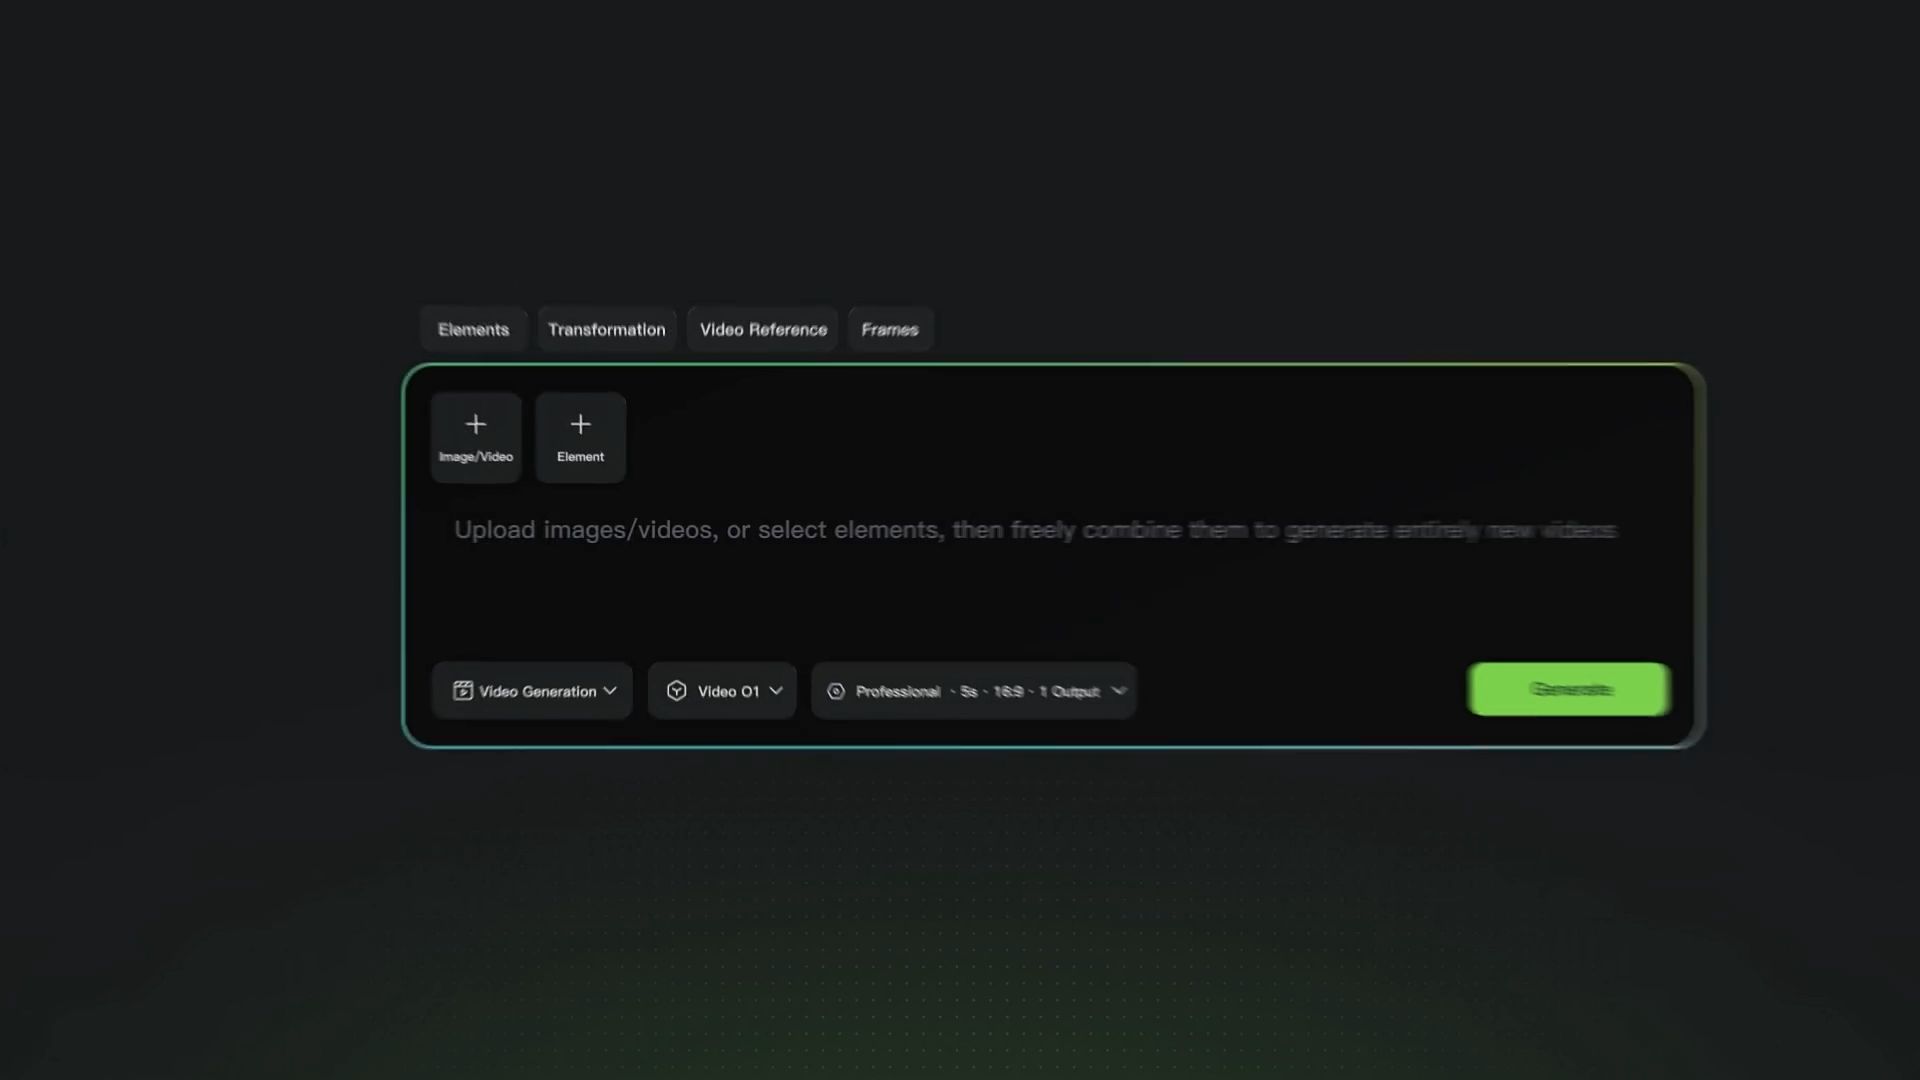
画像から動画へのクリップを作成するには、保持したい要素と変更したい要素を明確にすることから始まります。Kling VIDEO 3.0を使用して画像から動画クリップを作成するには、次の手順に従ってください。
ステップ1:画像をアップロードする
アニメーション化したい画像から始めます。ポートレート、製品写真、キャラクターデザイン、イラスト、または風景などを出発点として使用できます。
明瞭なディテールと視認できる被写体が写っている画像を選びましょう。輪郭のはっきりした顔やプロダクトの形状、ビジュアルスタイルがあると、Kling VIDEO 3.0 は元の見た目を保ちながら自然な動きを生み出すためのより強固な土台を得られます。
被写体の一貫性を高めるために、必要に応じて複数の画像参照を追加できます。これらの参照は、被写体が異なる角度で現れたり、シーン内を移動したり、複数のショットにまたがって登場するときに、Kling VIDEO 3.0 が重要なディテールを保持するのに役立ちます。
ステップ2:求める動きを記述する
画像はシーンに存在するものを示し、プロンプトはその後に起こることを説明します。
効果的な画像から動画へのプロンプトは次の構成に従うと良いでしょう。
被写体 + 動作 + 表情 + カメラワーク + シーンの変化 + ビジュアルスタイル
シンプルなプロンプトで基本的なアクションを定義でき、より詳細な説明を加えると、Kling VIDEO 3.0が最終動画のタイミング、方向、ビジュアルスタイルをより的確に制御できます。
最終結果をさらに細かく制御するには、Kling VIDEO 3.0のクリエイティブツールを利用できます。Multi-Shotを有効にすると、モデルがプロンプトに基づいてシーンの切り替え、ショットの画角、カメラワークを知的に計画します。厳密な制御が必要な場合は、Custom Multi-Shotを使用して各ショットの内容、長さ、構成を定義してください。動画にセリフや環境音、効果音が必要なときは、Native Audioを有効にして映像と同時に音声を生成します。
ステップ3:動画を生成して書き出す
プロジェクトのニーズに応じて最終的な出力設定を選択し、動画を生成しましょう。Kling VIDEO 3.0は最大4Kの動画出力、最長15秒の動画、16:9・1:1・9:16といった複数のアスペクト比、そしてさまざまなクリエイティブプロジェクトやプラットフォーム向けの複数出力に対応しています。
終わり
最高の画像から動画へのAIは、動きだけで決まるものではありません。被写体を認識できるように保ち、重要な視覚的ディテールを維持しながら、自然なモーションで画像に命を吹き込み、シーンがどのように展開するかをクリエイターが制御できる必要があります。こうした主要なニーズに基づき、Kling AIはmotion control、被写体の一貫性、Native Audio、ネイティブ4K品質を組み合わせ、完全な画像から動画へのワークフローを実現します。画像をアップロードし、望む動きやシーンの変化を説明するだけで、静止フレームをモーション、サウンド、ストーリーテリングを備えたシネマティックな動画へと変換できます。
よくある質問
2026年における最高の画像から動画へのAIは何ですか?
2026年に最適な画像から動画へのAIは、作りたい動画の種類によって異なります。自然な動きや認識しやすい被写体、Native Audio、高品質な出力が求められるプロジェクトでは、Kling AIが静止画をより完成度の高い動画シーンに変換するためのバランスの取れたワークフローを提供します。動きの質、一貫性、クリエイティブコントロール、音声機能といった、あなたのプロジェクトで最も重要な要素を比較することで、最適なツールを選べます。
AIはどんな写真でも動画に変えられるのか?
はい。画像から動画への機能を備えたAI動画ジェネレーターは、ポートレートや製品写真からイラスト、風景まで、多くの種類の写真に命を吹き込めます。結果は、元の画像のディテールや、作りたい動きによって変わります。Klingを使えば、元の写真を見分けられる重要な特徴を保ちながら、画像がどのように動いたり変化したりすべきかを指示できます。
画像から動画へのAIは音声やセリフも生成できるのか?
はい、一部のイメージから動画へのAIツールは、音声を後から追加するのではなく、動画生成プロセスの一部として音声や会話を作成できます。これは、会話があるシーンやキャラクター同士のやり取り、環境音が必要なシーンで特に有用です。Kling VIDEO 3.0はNative Audioを使用して、複数キャラクターのシーンで各キャラクターに対応するセリフを合わせながら、動画と一緒に会話、環境音、効果音を生成します。また、より自然な会話を実現するために、複数の言語、アクセント、方言をサポートしています。
AIは同じ人物やキャラクターの一貫性を保てるか?
はい、AIは、モデルが視覚的な参照を利用できるときに特に、ビデオ全体を通じて人物、キャラクター、物体の同一性を維持するのに役立ちます。被写体が動いたり、異なる角度から現れたり、複数のショットを通じて一貫性を保つ必要がある場合、一貫性を維持するのはより困難になります。Kling VIDEO 3.0は複数の画像参照を用いて主要な視覚的ディテールを導き、シーンが進行する間も被写体が認識できる状態を保つのに役立ちます。