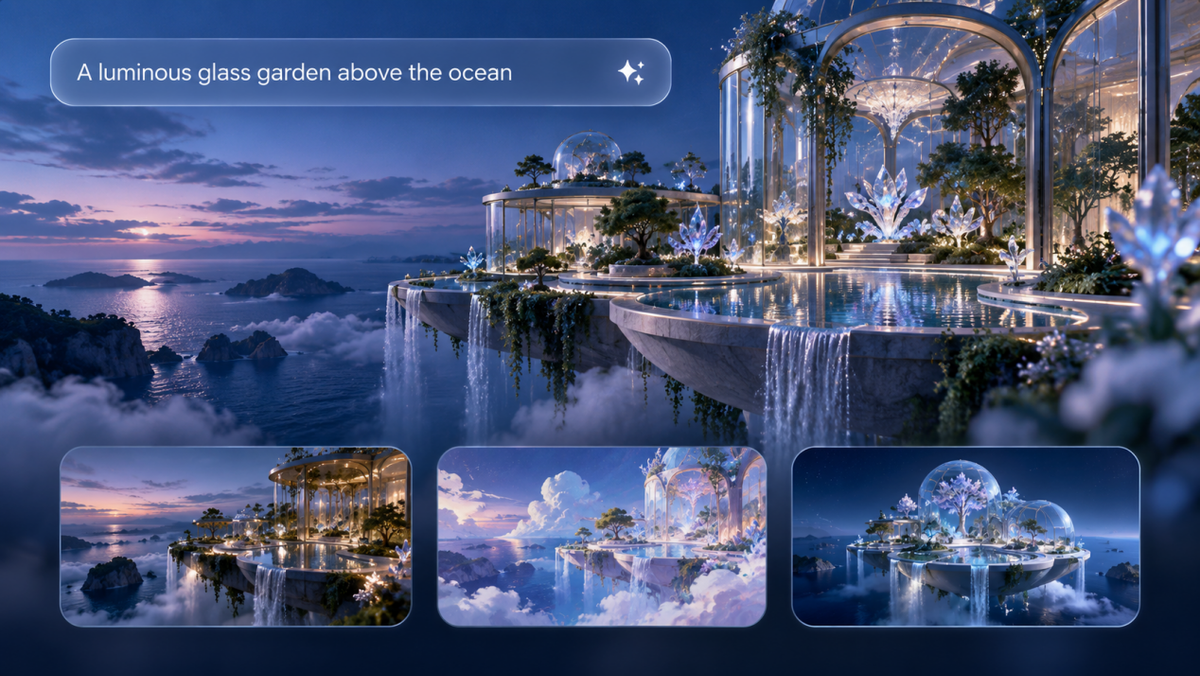
アイデアや簡単な説明だけで、テキストから画像へのモデルは自然言語を視覚的なコンセプトに変換できます。クリエイターにとって、最良のテキストから画像へのモデルは単なる画像生成を超えた存在です。複雑なプロンプトを理解し、視覚的一貫性を保ち、時間をかけた創造的な洗練を支援する必要があります。本ガイドではテキストから画像へのモデルの仕組みを説明し、重要な機能を比較し、Kling IMAGE 3.0 がリファレンスベースの制作、正確な編集、柔軟なワークフローを組み合わせてクリエイターの視覚的アイデアを形にする方法を探ります。
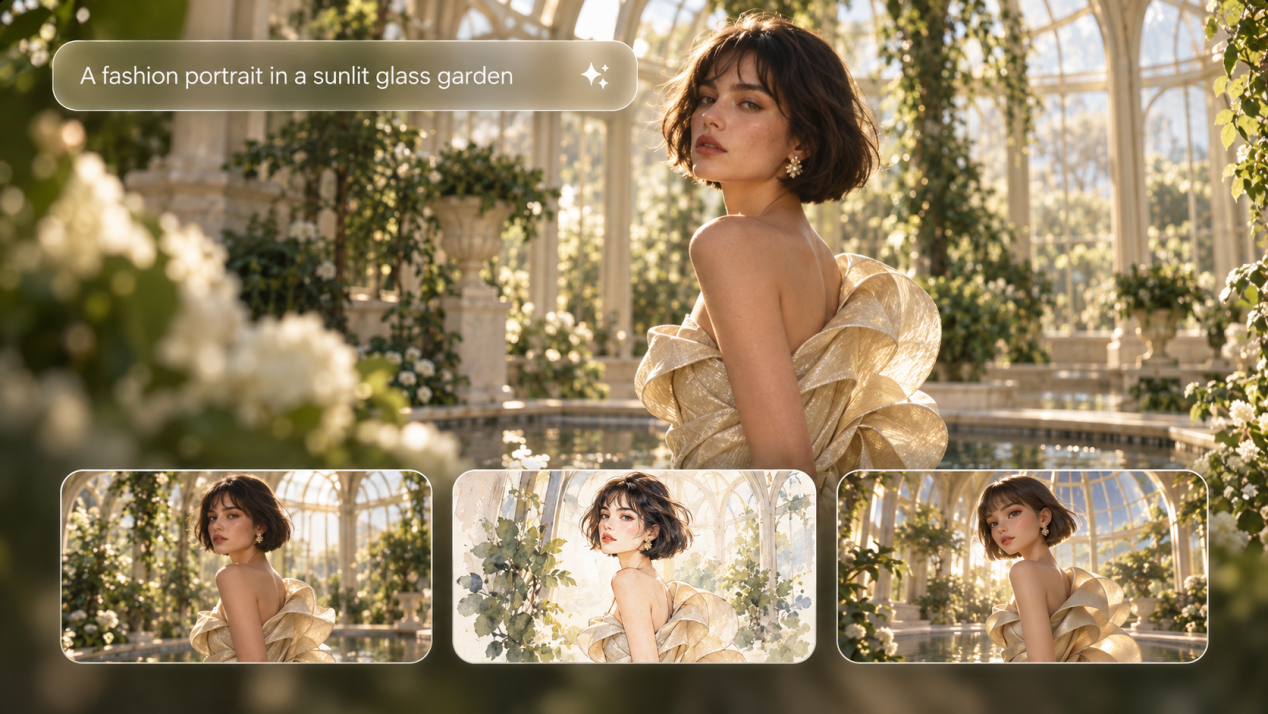
テキストから画像へのモデルとは?
テキストから画像へのモデルとは、プロンプトに記述された詳細に基づいて自然言語のプロンプトをデジタル画像に変換する人工知能システムの一種です。
現代のテキストから画像へのシステムは通常、プロンプトを理解またはエンコードするコンポーネントと、その指示を視覚コンテンツに変換する画像生成コンポーネントを組み合わせています。一部のモデルは画像やその他の視覚的参照とも連携でき、複雑なプロンプトに従い、重要なディテールを保持し、より精密な編集をサポートします。
たとえば、次のプロンプトを考えてみましょう。
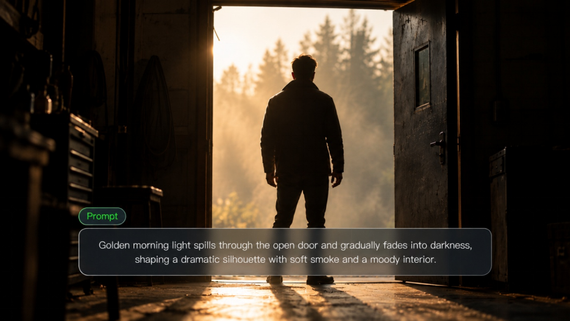
| Prompt: 柔らかな朝の光がシーンに差し込む木製の机の上に置かれたヴィンテージカメラ。 |
モデルは対応する画像を生成する前に、対象物、素材、空間配置、ライティング、そして全体的なビジュアルスタイルを理解する必要があります。
今日では、テキストから画像へのモデルを評価する際には、画質以上の要素が求められます。焦点は、プロンプトを正確に理解すること、複雑なシーンへの対応、視覚的一貫性の維持、柔軟な編集のサポートへと移行しています。
テキストから画像へのモデルはどのように機能するのか?
テキストから画像へのモデルは、言語が対象、スタイル、構図、その他の詳細とどのように関連するかを学習することで、文章による説明を視覚コンテンツに変換します。多くの最新システムは拡散ベースの手法を採用しており、プロンプトがステップバイステップの工程を導き、視覚的なノイズを徐々に完成した画像へと変換します。
このプロセスは3つの段階で理解できます。
1.テキストが画像と結び付く仕組みを学習する
画像を生成する前に、テキストから画像へのモデルは説明文とペアになった大量の画像データセットから学習します。トレーニングでは、対象、色、形状、スタイル、空間的関係など、言葉と視覚的な詳細の間のパターンを特定します。例えば、そのモデルは「ヴィンテージカメラ」「木製のデスク」「柔らかな朝の光」といった概念が特定の視覚的特徴と関連付けられていることを学びます。
2.プロンプトの理解
プロンプトを入力すると、システムはテキストを理解可能な形式に変換し、核心的な意味と文脈を捉えます。具体的な技術はモデルによって異なり、商用システムはしばしば全体のアーキテクチャを公開しませんが、テキストとビジョンの各コンポーネントが連携し、あなたの言葉と最終的なビジュアル出力との橋渡しをします。
3.画像生成
多くの現代のテキストから画像へのモデルは拡散法を利用していますが、他のモデルではオートレグレッシブなど別の生成手法を採用する場合もあります。拡散ベースのシステムでは、処理は視覚的ノイズから始まり、プロンプトによって提供された情報に基づいてそのノイズを徐々に除去していきます。繰り返しのノイズ除去ステップを通じて、画像は説明に合致するより明確な形状、ディテール、スタイルを形成します。一部のシステムは、最終的な画像に変換する前に、このプロセスを圧縮された潜在空間内で実行します。画像が生成された後も、細部を洗練したり編集に備えるために、さらに調整を加えることができます。
テキストから画像を生成するモデルはなぜ異なるのか?
テキストから画像を生成するモデルは、同じプロンプトに対してまったく異なる応答を返すことがあります。その違いの一部は画像の生成方法に起因し、別の部分はモデルが読み取り利用できる入力の種類にあります。
生成アーキテクチャ
生成レベルでは、一般的な手法は拡散と自己回帰生成の2つです。
アプローチ | 仕組み | 一般的な用途 |
拡散モデル | 視覚的なノイズから始め、プロンプトに従って徐々に画像へと洗練する。 | 詳細な画像生成、リアルなシーン、イラスト、スタイル重視の制作。 |
自己回帰モデル | 視覚トークンや要素を順に予測して画像を構築する。 | ノイズを洗練させるのではなく、順次的にビジュアルコンテンツを構築する画像生成。 |
拡散モデルはテキストから画像への研究において依然として活発な領域です。2023年の調査 Text-to-image Diffusion Models in Generative AI: A Survey は、拡散ベースのテキストから画像への手法、データセット、評価手法、および関連するアプリケーションの有用な概要を提供しています。
マルチモーダル入力
マルチモーダルとは、モデルがどのように画像を生成するかではなく、利用できる入力の種類を指します。マルチモーダルな画像モデルは、テキスト、画像、およびビジュアル参照を取り込み、参照に基づく生成や編集、シリーズ全体でのキャラクターや製品の一貫性維持に活用できます。その内部では、拡散や自己回帰生成、その他の手法を用いる場合もあるため、1つのモデルが複数のカテゴリに属することがあります。
2026年に最も優れたテキストから画像へのモデルはどれでしょうか?
本ガイドでは、画像生成、編集、リファレンスベースの作成、ビジュアル制作における異なるアプローチを代表する最新のモデルを7つ選出しました。順序はランキングではありません。
モデル | モデルタイプ | 最適な用途 | 主な特長 |
マルチモーダルな入力に対応した画像生成・編集モデル | リファレンスを基にした制作、製品ビジュアル、キャラクター、緻密な編集 | テキストまたは画像から生成し、最大10個のリファレンスの特徴を組み合わせ、被写体の維持、精密な編集、スタイル制御をサポートします。IMAGE 3.0は最大2Kの生成に対応し、IMAGE 3.0 Omniは最大4Kを提供します。 | |
Leonardo Lucid Origin | 画像生成モデル | イラスト、コンセプトアート、製品モックアップ、汎用的な画像制作 | 幅広いスタイルに対応し、詳細なプロンプトに従い、Full HD画像を生成し、読みやすいテキストレンダリングをサポートします。 |
Seedream 5.0 Pro | 画像生成および編集モデル | 製品イメージ、インフォグラフィック、デザインアセット、ローカル編集 | テキストまたは画像を元に機能し、参照を受け入れ、地域編集をサポートし、多言語の入力と生成に対応します。 |
Adobe Firefly Image 5 | 画像生成および編集モデル | デザイン制作、マーケティング資産、Adobeベースのプロジェクト | テキストから生成し、参照画像と連携し、Photoshopで周辺の画像コンテンツを損なわずにターゲットを絞った編集を可能にします。 |
Krea 2 Large | 画像生成モデル | フォトリアリズム、スタイル主導の制作、ビジュアルディレクション | プロンプトに基づく作成と参照による構図・被写体・スタイルの制御により、表現力豊かなフォトリアリズムに最適化されています。 |
Luma UNI-1.1 | 統合マルチモーダル画像モデル | 参照主導の生成と画像修正 | 画像生成と自然言語による編集を組み合わせ、1件のリクエストで最大9つの参照入力を受け付けます。 |
Runway Gen-4 画像 | 画像および動画プラットフォーム内の画像生成モデル | キャラクター開発、シーン設計、後に動画へ展開するプロジェクト | テキストや参照画像から生成し、1回の生成で最大3つの参照を使用でき、キャラクターやオブジェクト、ビジュアルの特徴を新しいシーンに引き継げます。 |
次のセクションでは、これらのモデルをプロンプト追従性、参照の扱い、編集、ビジュアルの一貫性、スタイル制御の観点から比較します。
2026年、テキストから画像へのモデルはどう比較できるのか?
テキストから画像へのモデルで最も差が出るのは、プロンプトの正確性、参照の活用、編集、一貫性、スタイル制御です。これらの違いは、繰り返しの画像、改訂、プロダクト、反復登場するキャラクターを伴うプロジェクトでより明確になります。
比較領域 | 何を比較するか | それが重要な理由 |
プロンプトの遵守 | 被写体、属性、オブジェクト間の関係、構図、必要な詳細。 | 洗練された画像でも、要件を外せば物足りないままです。 |
参照の扱い | 参照数、被写体保持、スタイル転送、構図ガイダンス。 | 参照は、キャラクターや製品、ビジュアルの方向性が複数の画像を通じて識別可能であるよう保つのに役立ちます。 |
画像編集 | 局所的な変更、自然言語による編集、そして手を加えていない領域がどれだけそのまま保たれるか。 | 精密な編集は時間を節約し、画像を一から作り直す手間を省きます。 |
視覚的一貫性 | キャラクター、製品、衣服、スタイル、および画像や改訂全体にわたる繰り返しのディテール。 | 安定したディテールは、画像シリーズ、キャンペーン、ストーリーボード、製品セットにとって重要です。 |
スタイルの制御 | 照明、パレット、質感、写真のような見た目、イラストレーションスタイル、ビジュアルの方向性。 | 明確なスタイルの制御は、関連する画像を視覚的に結び付けるのに役立ちます。 |
ワークフローへの適合 | リビジョン、書き出しオプション、画像から動画への活用、他のクリエイティブツールとの互換性。 | 生成後に何が起こるかは、最初の画像と同じくらい重要になり得ます。 |
素早いコンセプト画像に適したモデルでも、製品シリーズやキャラクタープロジェクトには向かない場合があります。単体の画像であればプロンプトの正確さとスタイルで十分ですが、繰り返しの制作ではより強力な参照、編集、そして一貫性が求められることが多いのです。
最適なテキストから画像へのモデルを選ぶには?
AI image generatorを選ぶときは、まず作りたいものと、画像を修正する際に変えずに維持すべきディテールを確認しましょう。以下の表では、いくつかの一般的なシナリオで注目すべきポイントを示しています。
必要なもの | 探すべきもの | それが重要な理由 |
迅速なコンセプト画像 | プロンプトの精度、画像品質、スタイルの幅 | より少ない修正で意図した結果に近づけます。 |
一貫したキャラクターや製品 | 参照の扱いとディテールの保持 | 顔、衣装、製品などの特徴的な要素は、画像全体で認識できる状態を保つ必要があります。 |
頻繁な画像の改訂 | ローカルな編集と自然言語による変更 | シーン全体を作り直すことなく、画像の一部だけを調整できます。 |
キャンペーン用アセットまたは画像シリーズ | 安定した被写体、スタイル、構図 | 関連する画像は同じビジュアルの方向性を共有する必要があります。 |
後に動画へ移行する画像 | 参照画像と画像から動画へのオプション | 安定した被写体とビジュアルの細部は動きへと反映させやすい。 |
なぜKling IMAGE 3.0を検討する価値があるのか?
Kling IMAGE 3.0は、テキストプロンプトや参照画像から制作を開始し、自然言語で細部を微調整できます。標準的な生成を超え、キャラクターの一貫性、精密な編集、スタイル調整を深く制御でき、無限のクリエイティブな可能性を切り開きます。
複雑なアイデアを新鮮なビジュアルへと変える
IMAGE 3.0は複数の参照から視覚的な手がかりを組み合わせ、日常的な言葉で標準的な編集の枠を超えることができます。画像をまたいで被写体を組み合わせたり、シーンの視点を反転させたり、コンセプトをまったく新しいスタイルへと切り替えたりしても、最終結果はシームレスで一貫性を保ちます。
参照画像1 | 参照画像2 | 出力画像 |
プロンプト:画像1と画像2の動物を統合してください。 | ||
キャラクター、製品、主要な詳細が認識できる状態を保ってください
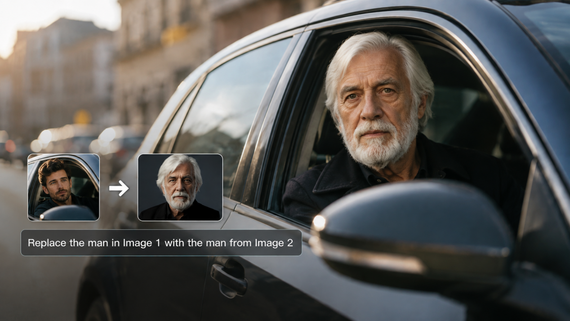
1回の生成で最大10枚の参照画像を使用できます。異なる参照画像を使えば、キャラクター、衣装、製品、背景、スタイルを定義でき、プロンプトでそれらの要素をどのように組み合わせるかを説明できます。ポートレートのレタッチでは、顔の参照画像を使うことで、ヘアスタイルや衣装、ポーズ、背景を変更しても、認識可能な顔の特徴を維持できます。既存のショットに顔だけを入れ替えたい場合は、Kling のフェイススワップ ワークフローに直接進むこともできます。
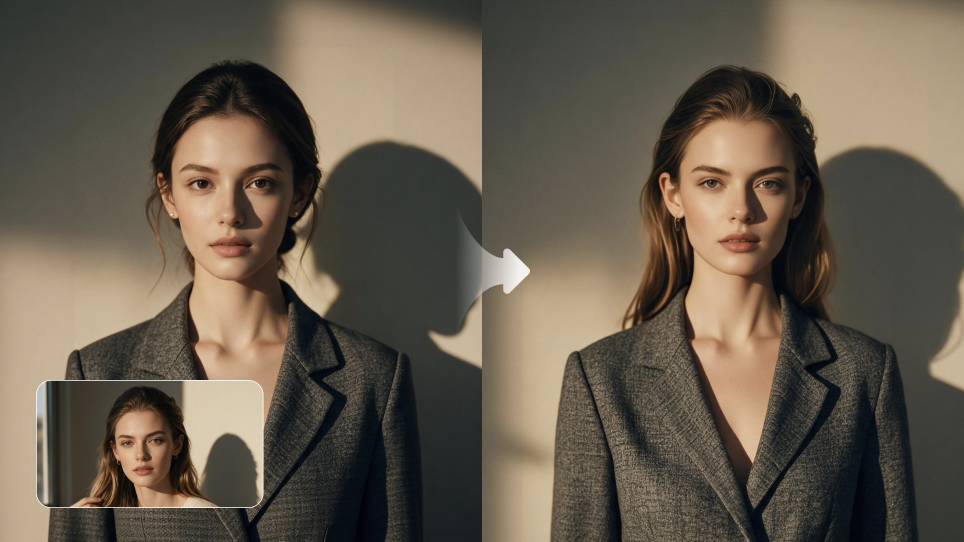
必要な部分だけを変更する
画像の大部分がすでに望ましい状態であれば、シーン全体を作り直すことなく細部を調整するために、Kling IMAGE 3.0 をAIフォトエディターとして利用できます。自然言語の指示で、周囲の部分を保ちながら、オブジェクトのサイズ、色、素材、表情、背景を変更できます。所有している、または編集許可のある画像に対して、Kling AI を透かし除去ツールとして使用することもできます。そのほか、写真のカラー化、ヴィンテージ効果、落書きの編集、ライティングやトーンの調整、画像の修復などの編集にも対応します。
画像間でスタイルとトーンを統一する 明確なビジュアルの方向性がすでにある場合は、既存の画像をスタイルリファレンスとして使用できます。Kling IMAGE 3.0 は、筆致、色、構図、トーンといった要素を新しい画像に引き継げます。この機能は、同じ見た目を複数の画像で再現する必要があるイラストセットや製品ビジュアル、ブランドコンテンツに最適です。
参照画像 1 | 参照画像 2 | 出力画像 |
プロンプト: 画像1のスタイルを画像2のものに変更する | ||
終わり
テキストから画像へのモデルは得意分野が異なるため、最初の画像が生成された後に何を必要とするかによって、適切な選択が決まります。手早いコンセプトだけが必要であれば、プロンプトの精度と画像品質で十分かもしれません。製品ビジュアルや繰り返し登場するキャラクター、画像シリーズでは、リファレンス、編集、そして一貫性がより重要になります。テキストや既存のビジュアルから始めたい場合、Kling IMAGE 3.0 はリファレンスを組み合わせ、特定のディテールを変更し、同じ外観を新しい画像に引き継ぐことができます。製品キャンペーンを構築する場合でも、繰り返し登場するキャラクターを作り込む場合でも、初期のコンセプトを完成したビジュアルセットに仕上げる場合でも、適切なモデルであれば、プロジェクトが成長するにつれて大切なディテールを保ちやすくなるはずです。
よくある質問
テキストから画像を生成するためにはどのAI言語モデルが使われていますか?
すべてのテキストから画像へのシステムで単一の言語モデルが使われているわけではありません。テキストから画像生成機能にどのAI言語モデルが用いられているのかを尋ねているのであれば、その答えはモデルによって異なります。CLIPやT5などのテキストエンコーダーを使うシステムもあれば、画像が生成される前にプロンプトを読み取るために言語モデルやビジョン言語コンポーネントを用いるものもあります。
テキストを画像に変換できるAIは?
Kling IMAGE 3.0、Leonardo Lucid Origin、Seedream 5.0 Pro、Adobe Firefly Image 5、Krea 2 Large、Luma UNI-1.1、Runway Gen-4 Image など、多くのAI画像モデルがテキストで書かれたプロンプトを完成した画像へと変換できます。それぞれがプロンプト、参照資料、編集、視覚的一貫性の扱い方が異なるため、適切なモデルは作りたい画像の種類によって決まります。
テキストから画像へのモデルは参照画像を使用できる?
はい。多くのテキストから画像へのモデルは、文章のプロンプトと並行して参照画像を使用でき、既存のビジュアルから作業したいときには image-to-image AI が役立ちます。参照画像はキャラクター、製品、ポーズ、構図、色、スタイルといった詳細を確立でき、プロンプトはモデルに何を変更するかを指示します。Kling IMAGE 3.0は、一度の生成で最大10枚の参照画像を使用できるため、同じキャラクター、製品、またはビジュアルスタイルを認識できる状態に保つ必要がある場合に便利です。
画像から背景を削除するには?
よりクリーンな商品写真、プロフィール画像、またはデザイン素材が必要な場合は、 画像から背景を削除 して主題だけを残せます。透明な背景は商品リスト、プレゼンテーション、ソーシャル投稿、あるいは主題を別の背景に配置するレイアウトで効果的です。背景を削除した後は、髪や衣服、毛並み、小さなオブジェクトの細かなエッジをチェックし、背景を透明のままにするか、単色に切り替えるか、主題を新しいシーンに配置しましょう。