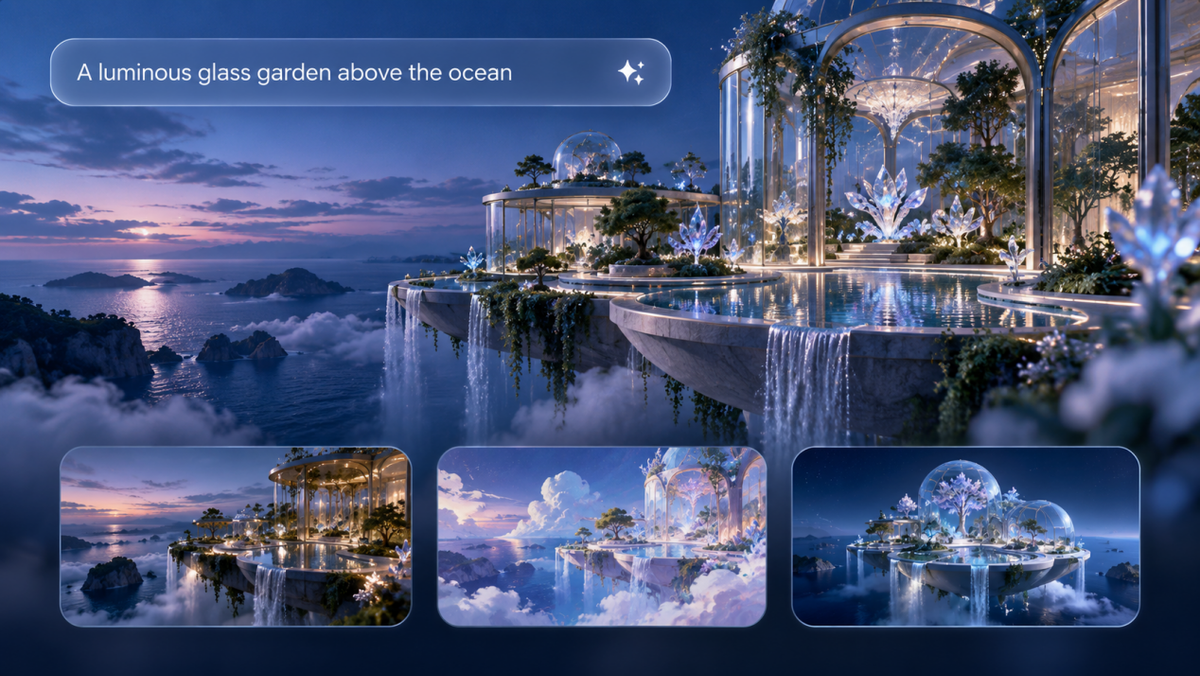
아이디어나 간단한 설명만으로도 텍스트-이미지 모델은 자연어를 시각적 개념으로 변환할 수 있다. 창작자에게 최고의 텍스트-이미지 모델은 단순한 이미지 생성 이상의 기능을 제공한다. 복잡한 프롬프트를 이해하고, 시각적 일관성을 유지하며, 시간이 지남에 따라 창의적 다듬기를 지원해야 한다. 이 가이드는 텍스트-이미지 모델의 작동 방식, 가장 중요한 역량을 비교하고, Kling IMAGE 3.0이 레퍼런스 기반 제작, 정밀 편집, 유연한 워크플로를 결합해 창작자가 시각적 아이디어를 실현하도록 돕는 방법을 살펴본다.
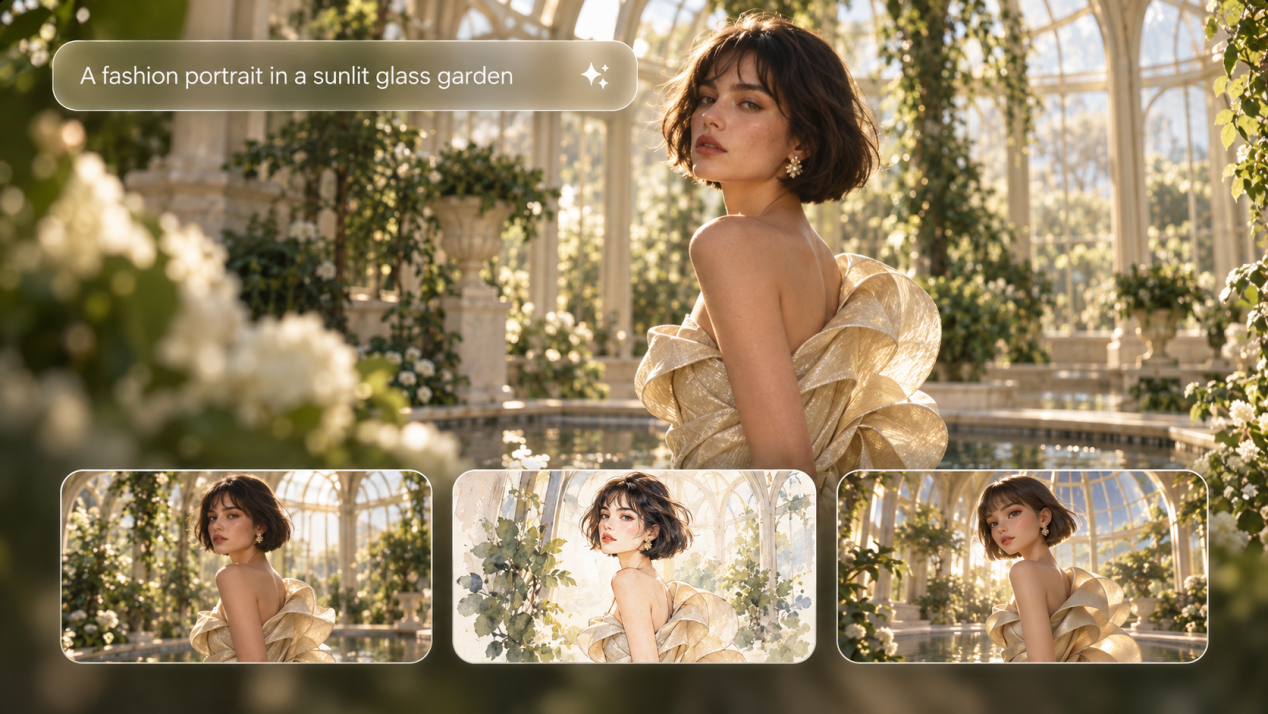
텍스트-이미지 모델이란?
텍스트-이미지 모델은 프롬프트에 설명된 세부 정보를 바탕으로 자연어 프롬프트를 디지털 이미지로 변환하는 인공지능 시스템의 한 유형이다.
최신 텍스트-이미지 시스템은 일반적으로 프롬프트를 이해하거나 인코딩하는 구성 요소와 그 지시를 시각 콘텐츠로 변환하는 이미지 생성 구성 요소를 결합한다. 일부 모델은 이미지 및 기타 시각적 참조와 함께 작업할 수도 있어 복잡한 프롬프트를 따르고 중요한 세부 정보를 유지하며 보다 정밀한 편집을 지원하는 데 도움이 된다.
예를 들어, 다음과 같은 프롬프트를 생각해 보자:
| Prompt: 부드러운 아침 햇살이 장면 전체에 비치는 나무 책상 위에 놓인 빈티지 카메라. |
모델은 해당 이미지를 생성하기 전에 객체, 재질, 공간 배치, 조명, 전체적인 시각 스타일을 이해해야 한다.
오늘날 텍스트-이미지 모델을 평가할 때는 단순한 이미지 품질을 넘어선다. 초점은 정확한 프롬프트 이해, 복잡한 장면 처리, 시각적 일관성 유지, 유연한 편집 지원으로 이동했다.
텍스트-이미지 모델은 어떻게 작동할까?
텍스트-이미지 모델은 언어가 사물, 스타일, 구성 및 기타 세부 사항과 어떻게 연결되는지 학습하여 작성된 설명을 시각적 콘텐츠로 변환한다. 많은 최신 시스템은 확산 기반 방법을 사용하며, 프롬프트가 점차 시각적 잡음을 완성된 이미지로 변환하는 단계별 과정을 안내한다.
이 과정은 세 단계로 이해할 수 있다:
1.텍스트가 이미지와 연결되는 방식을 학습하기
이미지를 생성하기 전에 텍스트-이미지 모델은 설명과 짝지어진 이미지가 포함된 대규모 데이터세트로부터 학습한다. 훈련 동안 모델은 사물, 색상, 형태, 스타일, 공간적 관계 등을 포함한 단어와 시각적 세부 정보 사이의 패턴을 식별한다. 예를 들어, 모델은 “빈티지 카메라”, “나무 책상”, “부드러운 아침빛”과 같은 개념이 특정 시각적 특성과 어떻게 연결되는지를 학습한다.
2.프롬프트 이해하기
프롬프트를 입력하면 시스템은 텍스트를 이해할 수 있는 형식으로 변환하여 핵심 의미와 맥락을 포착합니다. 정확한 기술은 모델마다 다르며, 상용 시스템은 전체 아키텍처를 비공개로 유지하는 경우가 많지만, 이러한 텍스트 및 비전 구성 요소는 사용자의 단어와 최종 시각적 출력 사이를 연결하기 위해 함께 작동합니다.
3. 이미지 생성
많은 현대 텍스트-투-이미지 모델은 diffusion 방식을 사용하지만, 다른 모델은 autoregressive 또는 다른 생성 접근법을 사용할 수 있습니다. diffusion 기반 시스템에서는 과정이 시각적 노이즈에서 시작하여 프롬프트가 제공한 정보를 바탕으로 그 노이즈를 점차 제거합니다. 반복적인 노이즈 제거 단계를 통해 설명과 일치하는 더 선명한 형태, 세부 정보, 스타일이 형성됩니다. 일부 시스템은 최종 이미지를 생성하기 전에 압축된 latent space에서 이 과정을 수행합니다. 이미지가 형성된 후에는 세부 조정이나 편집 준비를 위해 추가로 손질할 수 있습니다.
텍스트-이미지 모델을 서로 다르게 만드는 것은 무엇인가?
텍스트-이미지 모델은 동일한 프롬프트에도 매우 다르게 반응할 수 있다. 이는 이미지가 생성되는 방식에서 비롯되기도 하고, 모델이 읽고 활용할 수 있는 입력 유형에서 비롯되기도 한다.
생성 아키텍처
생성 단계에서는 두 가지 일반적인 접근법이 확산 방식과 자기회귀 생성이다.
접근법 | 동작 방식 | 일반적인 활용 |
확산 모델 | 시각적 노이즈에서 시작해 프롬프트를 따라 점차 이미지를 다듬는다. | 정교한 이미지 생성, 사실적인 장면, 일러스트레이션, 스타일 중심 작업. |
자기회귀 모델 | 시각적 토큰이나 요소를 순차적으로 예측하여 이미지를 구성한다. | 노이즈를 정제하는 것이 아니라 순차적으로 시각적 콘텐츠를 구축하는 이미지 생성. |
확산 모델은 텍스트-투-이미지 연구에서 여전히 활발한 영역이다. 2023년 설문 조사 Text-to-image Diffusion Models in Generative AI: A Survey는 확산 기반 텍스트-투-이미지 방법, 데이터세트, 평가 접근 방식, 관련 응용 사례에 대한 유용한 개요를 제공한다.
멀티모달 입력
멀티모달은 모델이 이미지를 생성하는 방식이 아니라 사용할 수 있는 입력 유형을 설명한다. 멀티모달 이미지 모델은 참조 기반 생성, 편집 또는 시리즈 전반에서 캐릭터와 제품을 일관되게 유지하기 위해 텍스트, 이미지, 시각적 참조를 받을 수 있다. 그 아래에서는 여전히 확산, 자기회귀 생성 또는 다른 방법을 사용할 수 있으므로 하나의 모델이 한 가지 이상의 범주에 속할 수 있다.
2026년에 가장 뛰어난 텍스트-투-이미지 모델은 무엇일까?
이 가이드를 위해 우리는 이미지 생성, 편집, 참조 기반 제작, 시각적 프로덕션에 대한 서로 다른 접근 방식을 대표하는 최신 모델 일곱 가지를 선정했습니다. 순서는 순위가 아닙니다.
모델 | 모델 유형 | 최적 용도 | 주요 기능 |
멀티모달 입력을 지원하는 이미지 생성 및 편집 모델 | 레퍼런스를 기반으로 한 제작, 제품 비주얼, 캐릭터, 정교한 편집 | 텍스트나 이미지에서 생성하고, 최대 10개의 레퍼런스를 통합하며, 피사체 유지, 정밀한 편집, 스타일 제어를 지원합니다. IMAGE 3.0은 최대 2K 생성, IMAGE 3.0 Omni는 최대 4K를 제공합니다. | |
Leonardo Lucid Origin | 이미지 생성 모델 | 일러스트레이션, 컨셉 아트, 제품 목업, 일반 이미지 제작 | 폭넓은 스타일을 아우르고, 세부적인 프롬프트를 따르며, Full HD 이미지를 생성하고, 읽기 쉬운 텍스트 렌더링을 지원합니다. |
Seedream 5.0 Pro | 이미지 생성 및 편집 모델 | 제품 이미지, 인포그래픽, 디자인 자산, 부분 편집 | 텍스트나 이미지로 작동하고, 참고 자료를 받아들이며, 영역별 편집을 지원하고, 다국어 입력과 생성을 처리합니다. |
Adobe Firefly Image 5 | 이미지 생성 및 편집 모델 | 디자인 제작, 마케팅 자산, Adobe 기반 프로젝트 | 텍스트에서 생성하고, 참조 이미지로 작업하며, 주변 이미지 콘텐츠는 그대로 둔 채 Photoshop에서 선택적 편집을 허용합니다. |
Krea 2 Large | 이미지 생성 모델 | 포토리얼리즘, 스타일 중심 작업, 시각적 방향성 | 표현력이 풍부한 포토리얼리즘에 최적화되어 있으며, 프롬프트 기반 생성과 레퍼런스 기반의 구성, 주제, 스타일 제어를 제공합니다. |
Luma UNI-1.1 | 통합 멀티모달 이미지 모델 | 레퍼런스 중심 생성 및 이미지 수정 | 이미지 생성을 자연어 편집과 결합하고, 한 번의 요청에서 최대 아홉 개의 레퍼런스 입력을 허용합니다. |
Runway Gen-4 이미지 | 이미지 및 비디오 플랫폼 내의 이미지 생성 모델 | 캐릭터 개발, 장면 디자인 및 이후 비디오로 확장되는 프로젝트 | 텍스트와 참고 이미지를 기반으로 생성하며, 한 번 생성할 때 최대 세 개의 참고 자료를 사용하고, 캐릭터나 오브젝트, 시각적 특성을 새로운 장면으로 이어갈 수 있습니다. |
다음 섹션에서는 이러한 모델을 프롬프트 준수, 참고 자료 처리, 편집, 시각적 일관성 및 스타일 제어 측면에서 비교합니다.
2026년에 텍스트-투-이미지 모델은 어떻게 비교될까요?
텍스트-투-이미지 모델은 프롬프트 정확도, 참고 자료 활용, 편집, 일관성, 스타일 제어 측면에서 가장 차이가 큽니다. 이러한 차이는 반복되는 이미지, 수정 작업, 제품, 반복 등장 캐릭터가 포함된 프로젝트에서 더욱 쉽게 드러납니다.
비교 영역 | 비교할 항목 | 왜 중요한가 |
프롬프트 준수 | 피사체, 속성, 객체 관계, 구도, 요구되는 세부 사항. | 세련된 이미지라도 요구 사항을 놓치면 여전히 부족합니다. |
참조 처리 | 참조 수, 주제 유지, 스타일 전환 및 구도 안내. | 참조는 캐릭터, 제품 또는 시각적 방향을 여러 이미지에서 식별 가능하게 유지하는 데 도움이 됩니다. |
이미지 편집 | 국소적 변경, 자연어 편집, 그리고 손대지 않은 영역이 얼마나 잘 보존되는지. | 정확한 편집은 시간을 절약하고 이미지를 처음부터 다시 만들 필요를 줄여 줍니다. |
시각적 일관성 | 캐릭터, 제품, 의상, 스타일, 이미지나 수정본 전반에 반복되는 디테일. | 안정적인 디테일은 이미지 시리즈, 캠페인, 스토리보드, 제품 세트에 중요합니다. |
스타일 제어 | 조명, 팔레트, 질감, 사진의 룩, 일러스트레이션 스타일, 시각적 방향성. | 명확한 스타일 제어는 관련 이미지가 시각적으로 연결된 상태를 유지하도록 돕습니다. |
워크플로 적합성 | 수정, 내보내기 옵션, 이미지-비디오 활용, 기타 크리에이티브 도구와의 호환성. | 생성 이후에 벌어지는 일도 첫 번째 이미지만큼 중요할 수 있습니다. |
빠르게 콘셉트 이미지를 만드는 데 잘 맞는 모델이 제품 시리즈나 캐릭터 프로젝트에는 적합하지 않을 수 있습니다. 단일 이미지에는 프롬프트 정확도와 스타일만으로도 충분할 수 있지만, 반복 작업에서는 더 강력한 참고 자료, 편집, 일관성이 요구되는 경우가 많습니다.
최적의 텍스트-이미지 모델을 선택하는 방법?
AI 이미지 생성기,를 선택할 때에는 먼저 만들고 싶은 결과와 이미지를 수정하면서도 변하지 않아야 하는 세부 요소부터 정하세요. 아래 표는 여러 일반적인 시나리오에서 확인해야 할 요소를 보여줍니다.
필요하다면 | 찾아볼 것 | 왜 중요한가 |
빠른 콘셉트 이미지 | 프롬프트 정확도, 이미지 품질, 스타일 범위 | 적은 수정으로도 의도한 결과에 더 가깝게 다가갈 수 있습니다. |
일관된 캐릭터 또는 제품 | 참조 처리 및 세부 사항 유지 | 얼굴, 의상, 제품 및 기타 특징적인 요소는 이미지 전반에서 알아볼 수 있어야 합니다. |
빈번한 이미지 수정 | 부분 편집 및 자연어 기반 변경 | 전체 장면을 다시 구성하지 않고 이미지의 한 부분만 조정할 수 있습니다. |
캠페인 자산 또는 이미지 시리즈 | 안정적인 피사체, 스타일 및 구도 | 관련 이미지는 동일한 시각적 방향을 공유해야 합니다. |
나중에 영상으로 전환되는 이미지 | 참조 이미지 및 이미지-투-비디오 옵션 | 안정적인 피사체와 시각적 세부 사항은 동작으로 전환하기 더 쉽습니다. |
Kling IMAGE 3.0를 고려할 가치가 있는 이유는?
Kling IMAGE 3.0은 텍스트 프롬프트나 참조 이미지를 사용해 창작을 시작하고, 자연어로 모든 세부 사항을 세밀하게 조정할 수 있게 해줍니다. 표준 생성 기능을 넘어, 캐릭터 일관성, 정밀 편집, 스타일 조정에 대한 폭넓은 제어를 제공하여 무한한 창의적 가능성을 열어 줍니다.
복잡한 아이디어를 새로운 비주얼로 전환하세요
IMAGE 3.0은 여러 참조에서 시각적 단서를 결합하고 일상 언어를 사용해 일반적인 편집을 넘어설 수 있게 합니다. 이미지 전반의 피사체를 조합하고, 장면의 관점을 뒤집거나, 개념을 완전히 새로운 스타일로 전환하면서도 최종 결과를 매끄럽고 일관되게 유지할 수 있습니다.
참조 이미지 1 | 참조 이미지 2 | 출력 이미지 |
프롬프트: 이미지 1과 이미지 2의 동물들을 합쳐 주세요. | ||
캐릭터, 제품 및 핵심 세부 사항이 알아볼 수 있도록 유지하세요.
한 번의 생성에서 최대 10개의 참조 이미지를 사용할 수 있습니다. 서로 다른 참조 이미지는 캐릭터, 의상, 제품, 배경 또는 스타일을 정의하고, 프롬프트가 이러한 요소를 어떻게 조합할지 설명할 수 있습니다. 인물 사진을 보정할 때는 얼굴 참조를 사용하면 헤어스타일, 의상, 포즈 또는 배경을 변경하면서도 알아볼 수 있는 얼굴 특징을 유지하는 데 도움이 됩니다. 기존 촬영본에 얼굴만 교체하고 싶다면 Kling의 페이스 스왑 워크플로로 바로 이동할 수도 있습니다.
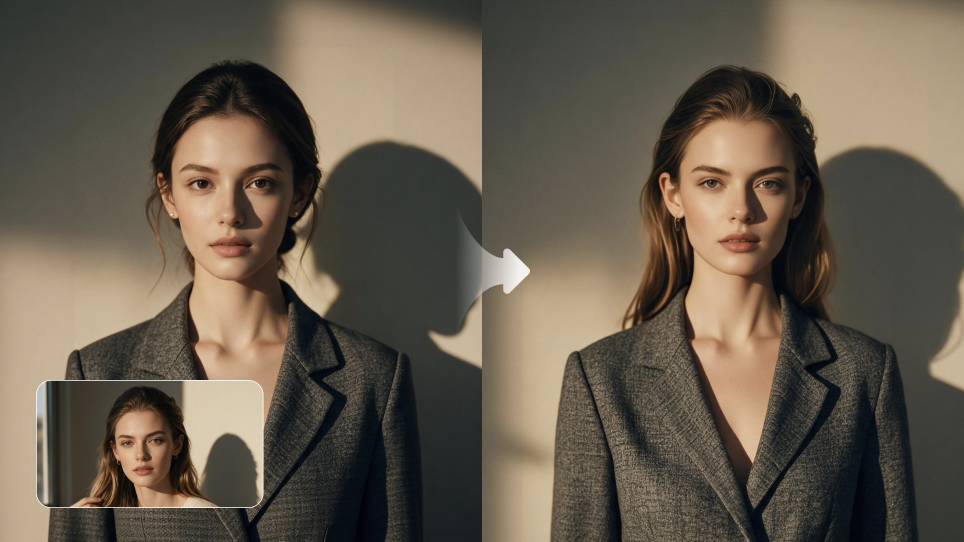
변경이 필요한 부분만 변경하세요
이미지의 대부분이 이미 원하는 대로 보인다면, 전체 장면을 다시 만들지 않고도 특정 디테일을 조정하기 위해 Kling IMAGE 3.0을 AI 사진 편집기로 사용할 수 있습니다. 자연어 지침을 통해 주변 부분을 유지하면서 객체의 크기, 색상, 재질, 표정 또는 배경을 변경할 수 있습니다. 또한 소유하거나 편집 권한이 있는 이미지에 대해 Kling AI를 워터마크 제거 도구로 사용할 수 있습니다. 그 밖의 편집 기능으로는 사진 컬러화, 빈티지 효과, 낙서 편집, 조명 및 톤 조정, 이미지 복원이 있습니다.
이미지 전반에 스타일과 톤을 일관되게 유지하세요 이미 명확한 시각적 방향성이 있다면, 기존 이미지를 스타일 참고용으로 사용할 수 있습니다. Kling IMAGE 3.0은 붓터치, 색상, 구도, 톤과 같은 요소를 새로운 이미지로 이어갈 수 있습니다. 이는 동일한 스타일이 여러 이미지에서 반복되어야 하는 일러스트레이션 세트, 제품 비주얼 또는 브랜드 콘텐츠에 적합합니다.
참조 이미지 1 | 참조 이미지 2 | 출력 이미지 |
프롬프트: 이미지 1의 스타일을 이미지 2의 스타일로 변경하세요 | ||
끝
텍스트-이미지 모델은 강점이 서로 달라서, 첫 번째 이미지가 생성된 이후에 무엇이 필요한지에 따라 올바른 선택이 달라집니다. 빠른 콘셉트만 필요하다면, 프롬프트 정확도와 이미지 품질만으로도 충분할 수 있습니다. 제품 비주얼, 반복 등장 캐릭터, 또는 이미지 시리즈를 위한 경우에는 레퍼런스, 편집, 일관성이 더 중요합니다. 텍스트나 기존 비주얼에서 시작하고 싶다면, Kling IMAGE 3.0은 레퍼런스를 결합하고 특정 세부 사항을 변경하며 동일한 룩을 새로운 이미지로 이어갈 수 있게 해줍니다. 제품 캠페인을 구축하든, 반복 등장 캐릭터를 개발하든, 초기 콘셉트를 완성된 비주얼 세트로 발전시키든, 프로젝트가 커질수록 중요하게 생각하는 디테일을 유지하기 쉽게 해주는 모델이 적합합니다.
자주 묻는 질문
텍스트를 이미지로 생성할 때 어떤 AI 언어 모델이 사용되나요?
모든 텍스트-투-이미지 시스템이 동일한 언어 모델을 사용하는 것은 아닙니다. 텍스트-투-이미지 생성 기능에 어떤 AI 언어 모델이 사용되는지 묻는다면, 답은 모델마다 다릅니다. 일부 시스템은 CLIP이나 T5 같은 텍스트 인코더를 사용하고, 다른 시스템은 이미지가 생성되기 전에 프롬프트를 해석하기 위해 언어 또는 비전-언어 구성 요소를 사용합니다.
어떤 AI가 텍스트를 이미지로 변환할 수 있나요?
Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1, Runway Gen-4 Image 등 많은 AI 이미지 모델이 작성한 프롬프트를 완성된 이미지로 변환할 수 있습니다. 각 모델은 프롬프트, 참조, 편집, 시각적 일관성을 서로 다르게 처리하므로, 적합한 모델은 만들어야 하는 이미지의 유형에 따라 달라집니다.
텍스트-투-이미지 모델은 참조 이미지를 사용할 수 있나요?
네. 많은 텍스트-이미지 모델은 글로 작성한 프롬프트와 함께 참조 이미지를 사용할 수 있으며, 이 덕분에 처음부터 다시 시작하는 대신 기존 비주얼을 기반으로 작업하고 싶을 때 image-to-image AI 가 유용해집니다. 참조 이미지는 캐릭터, 제품, 포즈, 구도, 색상 또는 스타일과 같은 세부 정보를 정하는 데 도움이 되며, 프롬프트는 모델에게 무엇을 변경할지 알려줍니다. Kling IMAGE 3.0은 한 번의 생성에서 최대 10개의 참조 이미지를 사용할 수 있어 동일한 캐릭터, 제품 또는 시각적 스타일을 알아볼 수 있게 유지해야 할 때 유용합니다.
이미지에서 배경을 어떻게 제거하나요?
더 깔끔한 제품 사진, 프로필 이미지 또는 디자인 에셋이 필요하다면, 이미지에서 배경을 제거할 수 있고 주요 피사체만 분리해 둘 수 있습니다. 투명한 배경은 제품 목록, 프레젠테이션, 소셜 게시물 또는 피사체를 다른 배경 위에 배치해야 하는 레이아웃에 잘 어울립니다. 배경을 제거한 후에는 머리카락, 옷감, 털, 작은 물체 주변의 세밀한 가장자리를 확인한 다음, 배경을 투명하게 유지하거나 단색으로 바꾸거나 피사체를 새로운 장면에 배치하세요.