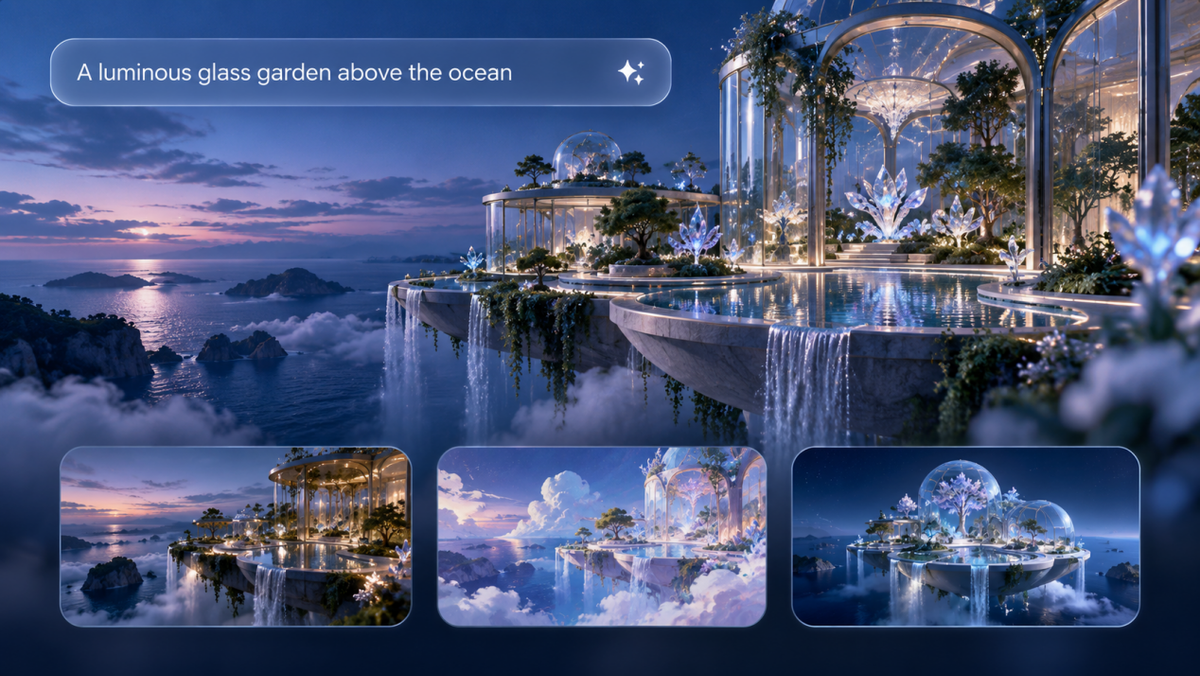
Имея лишь идею или простое описание, модели текст-в-изображение могут превращать естественный язык в визуальные концепции. Для создателей лучшие модели текст-в-изображение выходят за рамки генерации изображений. Им нужно понимать сложные запросы, сохранять визуальную целостность и поддерживать творческую доработку со временем. Это руководство объясняет, как работают модели текст-в-изображение, сравнивает наиболее значимые возможности и показывает, как Kling IMAGE 3.0 сочетает создание на основе референсов, точное редактирование и гибкие рабочие процессы, чтобы помогать создателям воплощать визуальные идеи.
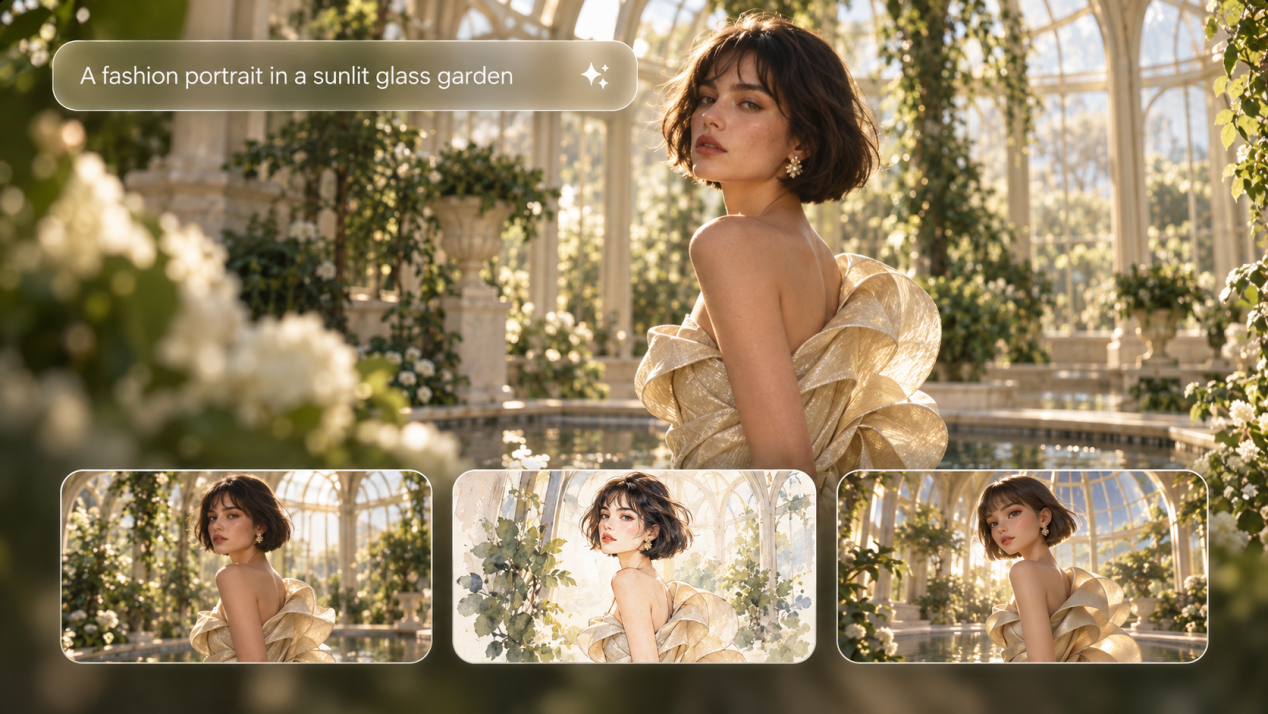
Что такое модели текст-в-изображение?
Модель текст-в-изображение — это вид системы искусственного интеллекта, которая преобразует запросы на естественном языке в цифровые изображения на основе деталей, описанных в запросе.
Современные системы текст-в-изображение обычно объединяют компонент, который понимает или кодирует запрос, с компонентом генерации изображения, который превращает эти инструкции в визуальный контент. Некоторые модели могут также работать с изображениями и другими визуальными референсами, что помогает им следовать сложным запросам, сохранять важные детали и обеспечивать более точное редактирование.
Например, возьмём такой запрос:
| Prompt: Винтажная камера, расположенная на деревянном столе и освещённая мягким утренним светом. |
Модели необходимо понять объект, материал, пространственное расположение, освещение и общий визуальный стиль, прежде чем генерировать соответствующее изображение.
Сегодня оценка моделей текст-в-изображение включает больше, чем просто качество изображения. В фокусе теперь точное понимание запроса, работа со сложными сценами, поддержание визуальной согласованности и обеспечение гибкого редактирования.
Как работают модели текст-в-изображение?
Модели преобразования текста в изображение переводят письменные описания в визуальный контент, изучая, как язык соотносится с объектами, стилями, композициями и другими деталями. Многие современные системы используют методы, основанные на диффузии, где подсказка направляет пошаговый процесс, постепенно превращающий визуальный шум в готовое изображение.
Этот процесс можно представить в трёх этапах:
1.Изучение того, как текст связан с изображениями
Прежде чем генерировать изображения, модель текста-в-изображение обучается на больших наборах данных, содержащих изображения, сопоставленные с описаниями. Во время обучения она выявляет закономерности между словами и визуальными деталями, включая объекты, цвета, формы, стили и пространственные отношения. Например, модель узнаёт, как такие понятия, как «винтажная камера», «деревянный стол» и «мягкий утренний свет», связаны с определёнными визуальными характеристиками.
2.Понимание подсказки
Когда вы вводите подсказку, система преобразует ваш текст в понятный ей формат, фиксируя ключевой смысл и контекст. Хотя конкретная технология зависит от модели — и коммерческие системы часто скрывают свою полную архитектуру, — эти текстовые и визуальные компоненты работают совместно, чтобы связать ваши слова с итоговым визуальным результатом.
3.Генерация изображения
Многие современные модели текст-изображение используют диффузионные методы, хотя другие модели могут применять авторегрессионные или иные подходы к генерации. В диффузионных системах процесс начинается с визуального шума и постепенно удаляет этот шум на основе информации из подсказки. Через повторяющиеся шаги удаления шума изображение приобретает более четкие формы, детали и стили, соответствующие описанию. Некоторые системы выполняют этот процесс в сжатом латентном пространстве, прежде чем преобразовать результат в финальное изображение. После формирования изображения можно внести дополнительные корректировки, чтобы уточнить детали или подготовить его к редактированию.
Чем отличаются модели текст-в-изображение?
Модели текст-в-изображение могут очень по-разному реагировать на один и тот же запрос. Частично это связано со способом генерации изображений, а частично — с типами входных данных, которые модель может читать и использовать.
Архитектура генерации
На уровне генерации распространены два подхода: диффузионный и авторегрессионный.
Подход | Как это работает | Распространённые сценарии использования |
Диффузионные модели | Начинают с визуального шума и постепенно преобразуют его в изображение, руководствуясь промптом. | Создание детализированных изображений, реалистичных сцен, иллюстраций и работ, ориентированных на стиль. |
Авторегрессивные модели | Формируют изображение, последовательно предсказывая визуальные токены или элементы. | Генерация изображений, создающая визуальный контент последовательно, а не за счёт уточнения шума. |
Диффузионные модели остаются активной областью исследований по теме преобразования текста в изображение. Обзор 2023 года Text-to-image Diffusion Models in Generative AI: A Survey предоставляет полезное обобщение методов текст-изображение на основе диффузии, наборов данных, подходов к оценке и связанных приложений.
Мультимодальные входные данные
Термин «мультимодальный» описывает типы входных данных, которые модель может использовать, а не то, как она генерирует изображение. Мультимодальная модель изображений может принимать текст, изображения и визуальные референсы для создания по образцу, редактирования или сохранения последовательности персонажей и продуктов в серии. При этом в основе она всё ещё может использовать диффузию, авторегрессионную генерацию или другой метод, поэтому модель может относиться сразу к нескольким категориям.
Какие модели преобразования текста в изображение будут лучшими в 2026 году?
Для этого руководства мы выбрали семь актуальных моделей, представляющих различные подходы к генерации изображений, редактированию, созданию на основе референсов и визуальному производству. Порядок не является рейтингом.
Модель | Тип модели | Лучше всего подходит для | Ключевые особенности |
Модель генерации и редактирования изображений с мультимодальными входными данными | Создание на основе референсов, визуализация продуктов, персонажи и детальные правки | Генерирует по тексту или изображениям, комбинирует характеристики до 10 референсов и поддерживает сохранение объекта, точные правки и управление стилем. IMAGE 3.0 поддерживает генерацию до 2K, а IMAGE 3.0 Omni — до 4K. | |
Leonardo Lucid Origin | Модель генерации изображений | Иллюстрации, концепт-арт, продуктовые мокапы и общее создание изображений | Охватывает широкий спектр стилей, следует подробным запросам, создаёт изображения Full HD и поддерживает вывод разборчивого текста. |
Seedream 5.0 Pro | Модель для генерации и редактирования изображений | Продуктовые изображения, инфографика, дизайнерские ассеты и локальные правки | Работает с текстом или изображениями, принимает референсы, поддерживает региональное редактирование и обрабатывает многоязычный ввод и генерацию. |
Adobe Firefly Image 5 | Модель для генерации и редактирования изображений | Производство дизайна, маркетинговые материалы и проекты на базе Adobe | Создает по тексту, работает с референсными изображениями и позволяет выполнять точечные правки в Photoshop, сохраняя остальное содержимое изображения нетронутым. |
Krea 2 Large | Модель генерации изображений | Фотореализм, стилистически ориентированные проекты и визуальное направление | Оптимизирован для выразительного фотореализма, с созданием на основе подсказок и управлением композицией, объектом и стилем, направляемым референсами. |
Luma UNI-1.1 | Единая мультимодальная модель изображений | Генерация и доработка изображений на основе референсов | Совмещает генерацию изображений с редактированием на естественном языке и принимает до девяти референсов в одном запросе. |
Runway Gen-4 Image | Модель генерации изображений в составе платформы для изображений и видео | Разработка персонажей, дизайн сцен и проекты, которые позднее переходят в видео | Генерирует по тексту и опорным изображениям, использует до трёх референсов за генерацию и может переносить персонажей, объекты или визуальные признаки в новые сцены. |
Следующий раздел сравнивает эти модели по точности следования запросу, работе с референсами, возможностям редактирования, визуальной согласованности и контролю стиля.
Как сравниваются модели текст-в-изображение в 2026 году?
Модели текст-в-изображение сильнее всего отличаются точностью выполнения запросов, использованием референсов, возможностями редактирования, согласованностью и контролем стиля. Эти различия проще заметить в проектах, где задействованы повторяющиеся изображения, доработки, продукты или повторяющиеся персонажи.
Область сравнения | Что сравнивать | Почему это важно |
Следование запросу | Объекты, атрибуты, взаимосвязи между объектами, композиция и обязательные детали. | Даже отполированное изображение не принесёт результата, если оно не соответствует техническому заданию. |
Работа с референсами | Количество референсов, сохранение объекта, перенос стиля и руководство по композиции. | Референсы помогают сохранить узнаваемость персонажа, продукта или визуального направления на разных изображениях. |
Редактирование изображений | Локальные изменения, правки на естественном языке и то, насколько хорошо остаются нетронутыми неизменённые области. | Точные правки экономят время и избавляют от необходимости воссоздавать изображение с нуля. |
Визуальная согласованность | Персонажи, продукты, одежда, стиль и повторяющиеся детали на разных изображениях или в разных версиях. | Стабильные детали важны для серий изображений, кампаний, раскадровок и продуктовых наборов. |
Управление стилем | Освещение, палитра, текстура, фотографический вид, стиль иллюстрации и визуальное направление. | Чёткое управление стилем помогает поддерживать визуальную связь между связанными изображениями. |
Соответствие рабочему процессу | Правки, параметры экспорта, использование изображений для видео и совместимость с другими творческими инструментами. | То, что происходит после генерации, может быть столь же важным, как и первое изображение. |
Модель, которая хорошо справляется с быстрыми концептуальными изображениями, может не подойти для серии продуктов или проекта с персонажами. Точность промта и стиль могут быть достаточными для единичного изображения, тогда как повторяющаяся работа часто требует более надежных референсов, редактирования и согласованности.
Как выбрать лучшую модель для преобразования текста в изображение?
Выбирая генератор изображений на основе ИИ, начните с того, что вы хотите создать, и какие детали должны оставаться неизменными при внесении правок в изображение. Таблица ниже показывает, на что обращать внимание в нескольких распространённых сценариях.
Если вам нужно | Ищите | Почему это важно |
Быстрые концептуальные изображения | Точность промпта, качество изображения и диапазон стилей | Вы можете приблизиться к задумке с меньшим количеством правок. |
Последовательные персонажи или продукты | Работа с референсами и сохранение деталей | Лица, одежда, товары и другие определяющие характеристики должны оставаться узнаваемыми на всех изображениях. |
Частые правки изображений | Локальное редактирование и изменения на естественном языке | Вы можете скорректировать одну часть изображения, не пересобирая всю сцену. |
Активы кампании или серии изображений | Стабильные сюжеты, стиль и композиция | Связанные изображения должны придерживаться одного визуального направления. |
Изображения, которые затем переходят в видео | Референсные изображения и варианты преобразования изображения в видео | Стабильные сюжеты и визуальные детали легче перенести в движение. |
Почему стоит рассмотреть Kling IMAGE 3.0?
Kling IMAGE 3.0 позволяет вам начинать создание по текстовому запросу или с опорных изображений, а затем доводить каждую деталь с помощью естественного языка. Помимо стандартной генерации, оно дает глубокий контроль над последовательностью персонажей, точными правками и настройкой стиля, открывая бесконечные творческие возможности.
Превращайте сложные идеи в свежие визуальные образы
IMAGE 3.0 позволяет смешивать визуальные подсказки из нескольких референсов и использовать повседневный язык, чтобы выйти за пределы стандартных правок. Объединяйте объекты из разных изображений, меняйте перспективу сцены или переносите концепт в совершенно новый стиль — при этом финальный результат останется цельным и согласованным.
Референсное изображение 1 | Референсное изображение 2 | Выходное изображение |
Запрос: Объедините животных с изображения 1 и изображения 2. | ||
Сохраняйте узнаваемыми персонажей, продукты и ключевые детали
Вы можете использовать до 10 эталонных изображений в одной генерации. Разные референсы могут определять персонажа, одежду, продукт, окружение или стиль, пока ваш запрос объясняет, как эти элементы должны сочетаться. Для портретной ретуши эталонные лица помогают сохранить узнаваемые черты, даже если вы меняете прическу, наряд, позу или окружение. Если вы хотите просто заменить лицо в существующем кадре, вы также можете сразу перейти к рабочим процессам Kling по замене лица .
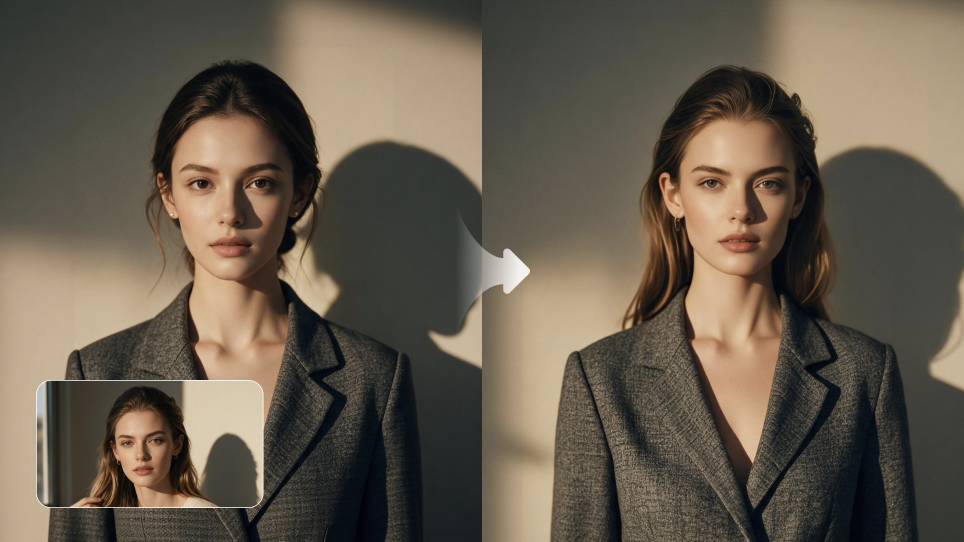
Изменяйте только то, что нужно изменить
Если большая часть изображения уже выглядит правильно, вы можете использовать Kling IMAGE 3.0 как редактор фотографий на основе ИИ, чтобы корректировать определенные детали без перестройки всей сцены. Инструкции на естественном языке могут изменять размер, цвет, материал, выражение или фон объекта, стремясь сохранить окружающие части изображения. Вы также можете использовать Kling AI в качестве инструмента для удаления водяных знаков для изображений, которыми вы владеете или которые имеете право редактировать. Другие виды правок включают колоризацию фотографий, винтажные эффекты, редактирование набросков, изменения освещения и тональности, а также восстановление изображений.
Сохраняйте единый стиль и тон во всех изображениях Если у вас уже есть четкое визуальное направление, вы можете использовать существующее изображение в качестве образца стиля. Kling IMAGE 3.0 может переносить такие элементы, как мазки кисти, цвет, композиция и тон, в новые изображения. Это хорошо подходит для наборов иллюстраций, продуктовых визуализаций или брендированного контента, когда одинаковый вид должен присутствовать более чем в одном изображении.
Эталонное изображение 1 | Эталонное изображение 2 | Результирующее изображение |
Промпт: Измените стиль изображения 1 на стиль изображения 2 | ||
Конец
Модели генерации изображений по тексту различаются по тому, что у них получается лучше всего, поэтому правильный выбор зависит от того, что вам нужно после генерации первого изображения. Если вам нужен лишь быстрый концепт, может быть достаточно точности промпта и качества изображения. Для продуктовых визуалов, повторяющихся персонажей или серий изображений большую роль играют референсы, возможность редактирования и согласованность. Если вы хотите начать с текста или уже имеющихся визуалов, Kling IMAGE 3.0 позволяет комбинировать референсы, изменять отдельные детали и переносить тот же стиль в новые изображения. Создаёте ли вы продуктовую кампанию, прорабатываете повторяющегося персонажа или превращаете ранний концепт в завершённый набор визуалов, подходящая модель должна упрощать сохранение важных для вас деталей по мере развития проекта.
Частые вопросы
Какая языковая модель ИИ используется для генерации изображений по тексту?
Не существует единой языковой модели, которую бы использовали все системы превращения текста в изображение. Если вы хотите узнать, какая языковая модель ИИ используется для создания изображений по тексту, ответ зависит от конкретной модели. Одни системы используют текстовые энкодеры, такие как CLIP или T5, тогда как другие применяют языковые или мультимодальные компоненты, чтобы интерпретировать запрос перед генерацией изображения.
Какие ИИ могут преобразовать текст в изображение?
Многие модели ИИ для генерации изображений способны преобразовать текстовый запрос в готовое изображение, включая Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 и Runway Gen-4 Image. Каждая из них по-своему работает с запросами, референсами, правками и визуальной целостностью, поэтому выбор подходящей модели зависит от того, какое именно изображение вам нужно создать.
Могут ли модели текст-в-изображение использовать референсные изображения?
Да. Многие модели преобразования текста в изображение могут использовать эталонные изображения вместе с текстовыми подсказками, что делает image-to-image AI полезным, когда вы хотите работать с готовым визуалом, а не начинать с нуля. Эталон может задать такие детали, как персонаж, продукт, поза, композиция, цвета или стиль, в то время как подсказка указывает модели, что нужно изменить. Kling IMAGE 3.0 может использовать до 10 эталонных изображений за одну генерацию, что удобно, когда нужно сохранить узнаваемость одного и того же персонажа, продукта или визуального стиля.
Как удалить фон с изображения?
Если вам нужен более аккуратный снимок товара, изображение профиля или дизайн-ресурс, вы можете удалить фон с изображения и оставить главный объект изолированным. Прозрачный фон хорошо подходит для карточек товаров, презентаций, публикаций в соцсетях или макетов, где объекту нужно находиться на другом фоне. После удаления проверьте тонкие края вокруг волос, одежды, шерсти или мелких предметов, затем оставьте фон прозрачным, замените его на сплошной цвет или поместите объект в новую сцену.