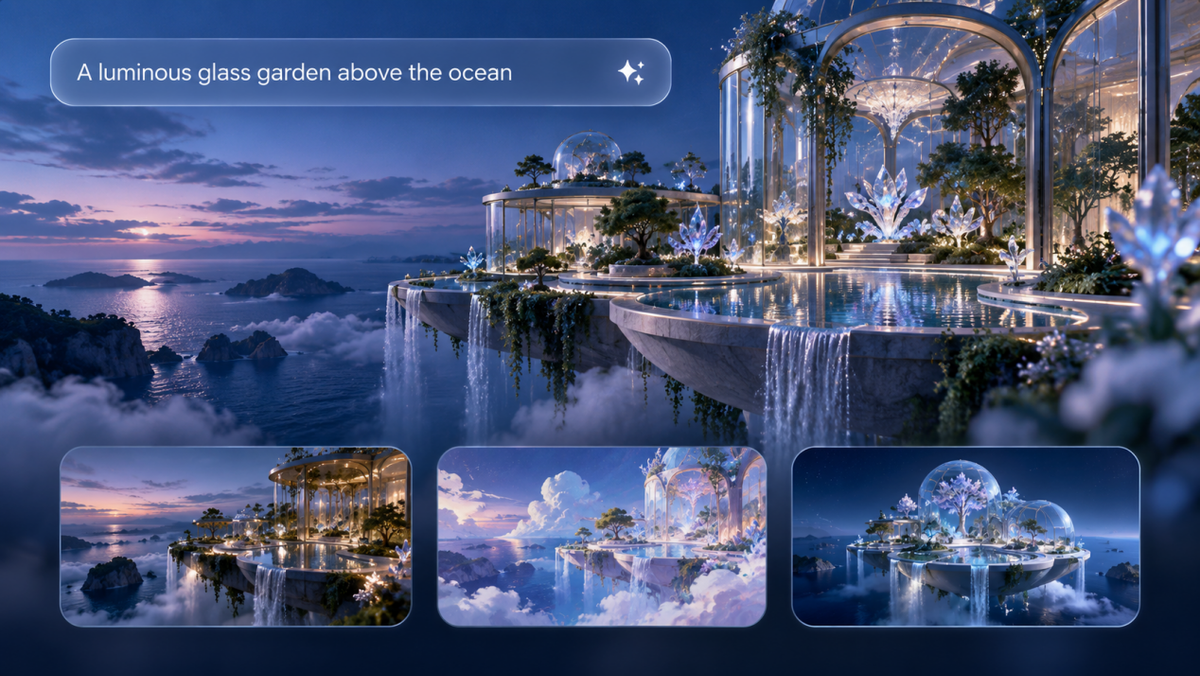
เพียงมีไอเดียหรือคำอธิบายง่ายๆ แบบจำลอง text-to-image ก็สามารถแปลงภาษาธรรมชาติให้กลายเป็นคอนเซ็ปต์เชิงภาพได้ สำหรับครีเอเตอร์ แบบจำลอง text-to-image ที่ดีที่สุดต้องทำได้มากกว่าการสร้างภาพ พวกมันต้องเข้าใจพรอมต์ที่ซับซ้อน รักษาความสอดคล้องทางภาพ และรองรับการปรับแต่งผลงานอย่างต่อเนื่อง คู่มือนี้อธิบายว่าแบบจำลอง text-to-image ทำงานอย่างไร เปรียบเทียบความสามารถที่สำคัญที่สุด และสำรวจว่า Kling IMAGE 3.0 ผสานการสร้างจากภาพอ้างอิง การแก้ไขที่แม่นยำ และเวิร์กโฟลว์ที่ยืดหยุ่น เพื่อช่วยให้ครีเอเตอร์ถ่ายทอดไอเดียเชิงภาพให้กลายเป็นจริงได้อย่างไร
แบบจำลอง Text-to-Image คืออะไร?
text-to-image model คือระบบปัญญาประดิษฐ์ประเภทหนึ่งที่แปลงพรอมต์ภาษาธรรมชาติให้เป็นภาพดิจิทัลตามรายละเอียดที่อธิบายไว้ในพรอมต์
ระบบแปลงข้อความเป็นภาพสมัยใหม่มักผสานส่วนประกอบที่เข้าใจหรือเข้ารหัสพรอมต์เข้ากับส่วนสร้างภาพที่แปลงคำสั่งเหล่านั้นเป็นเนื้อหาภาพ บางโมเดลยังสามารถทำงานกับภาพและตัวอ้างอิงเชิงภาพอื่น ๆ ช่วยให้พวกมันทำตามพรอมต์ที่ซับซ้อน รักษารายละเอียดสำคัญ และรองรับการปรับแต่งที่แม่นยำยิ่งขึ้น
ตัวอย่างเช่น ลองพิจารณาพรอมต์หนึ่งว่า:
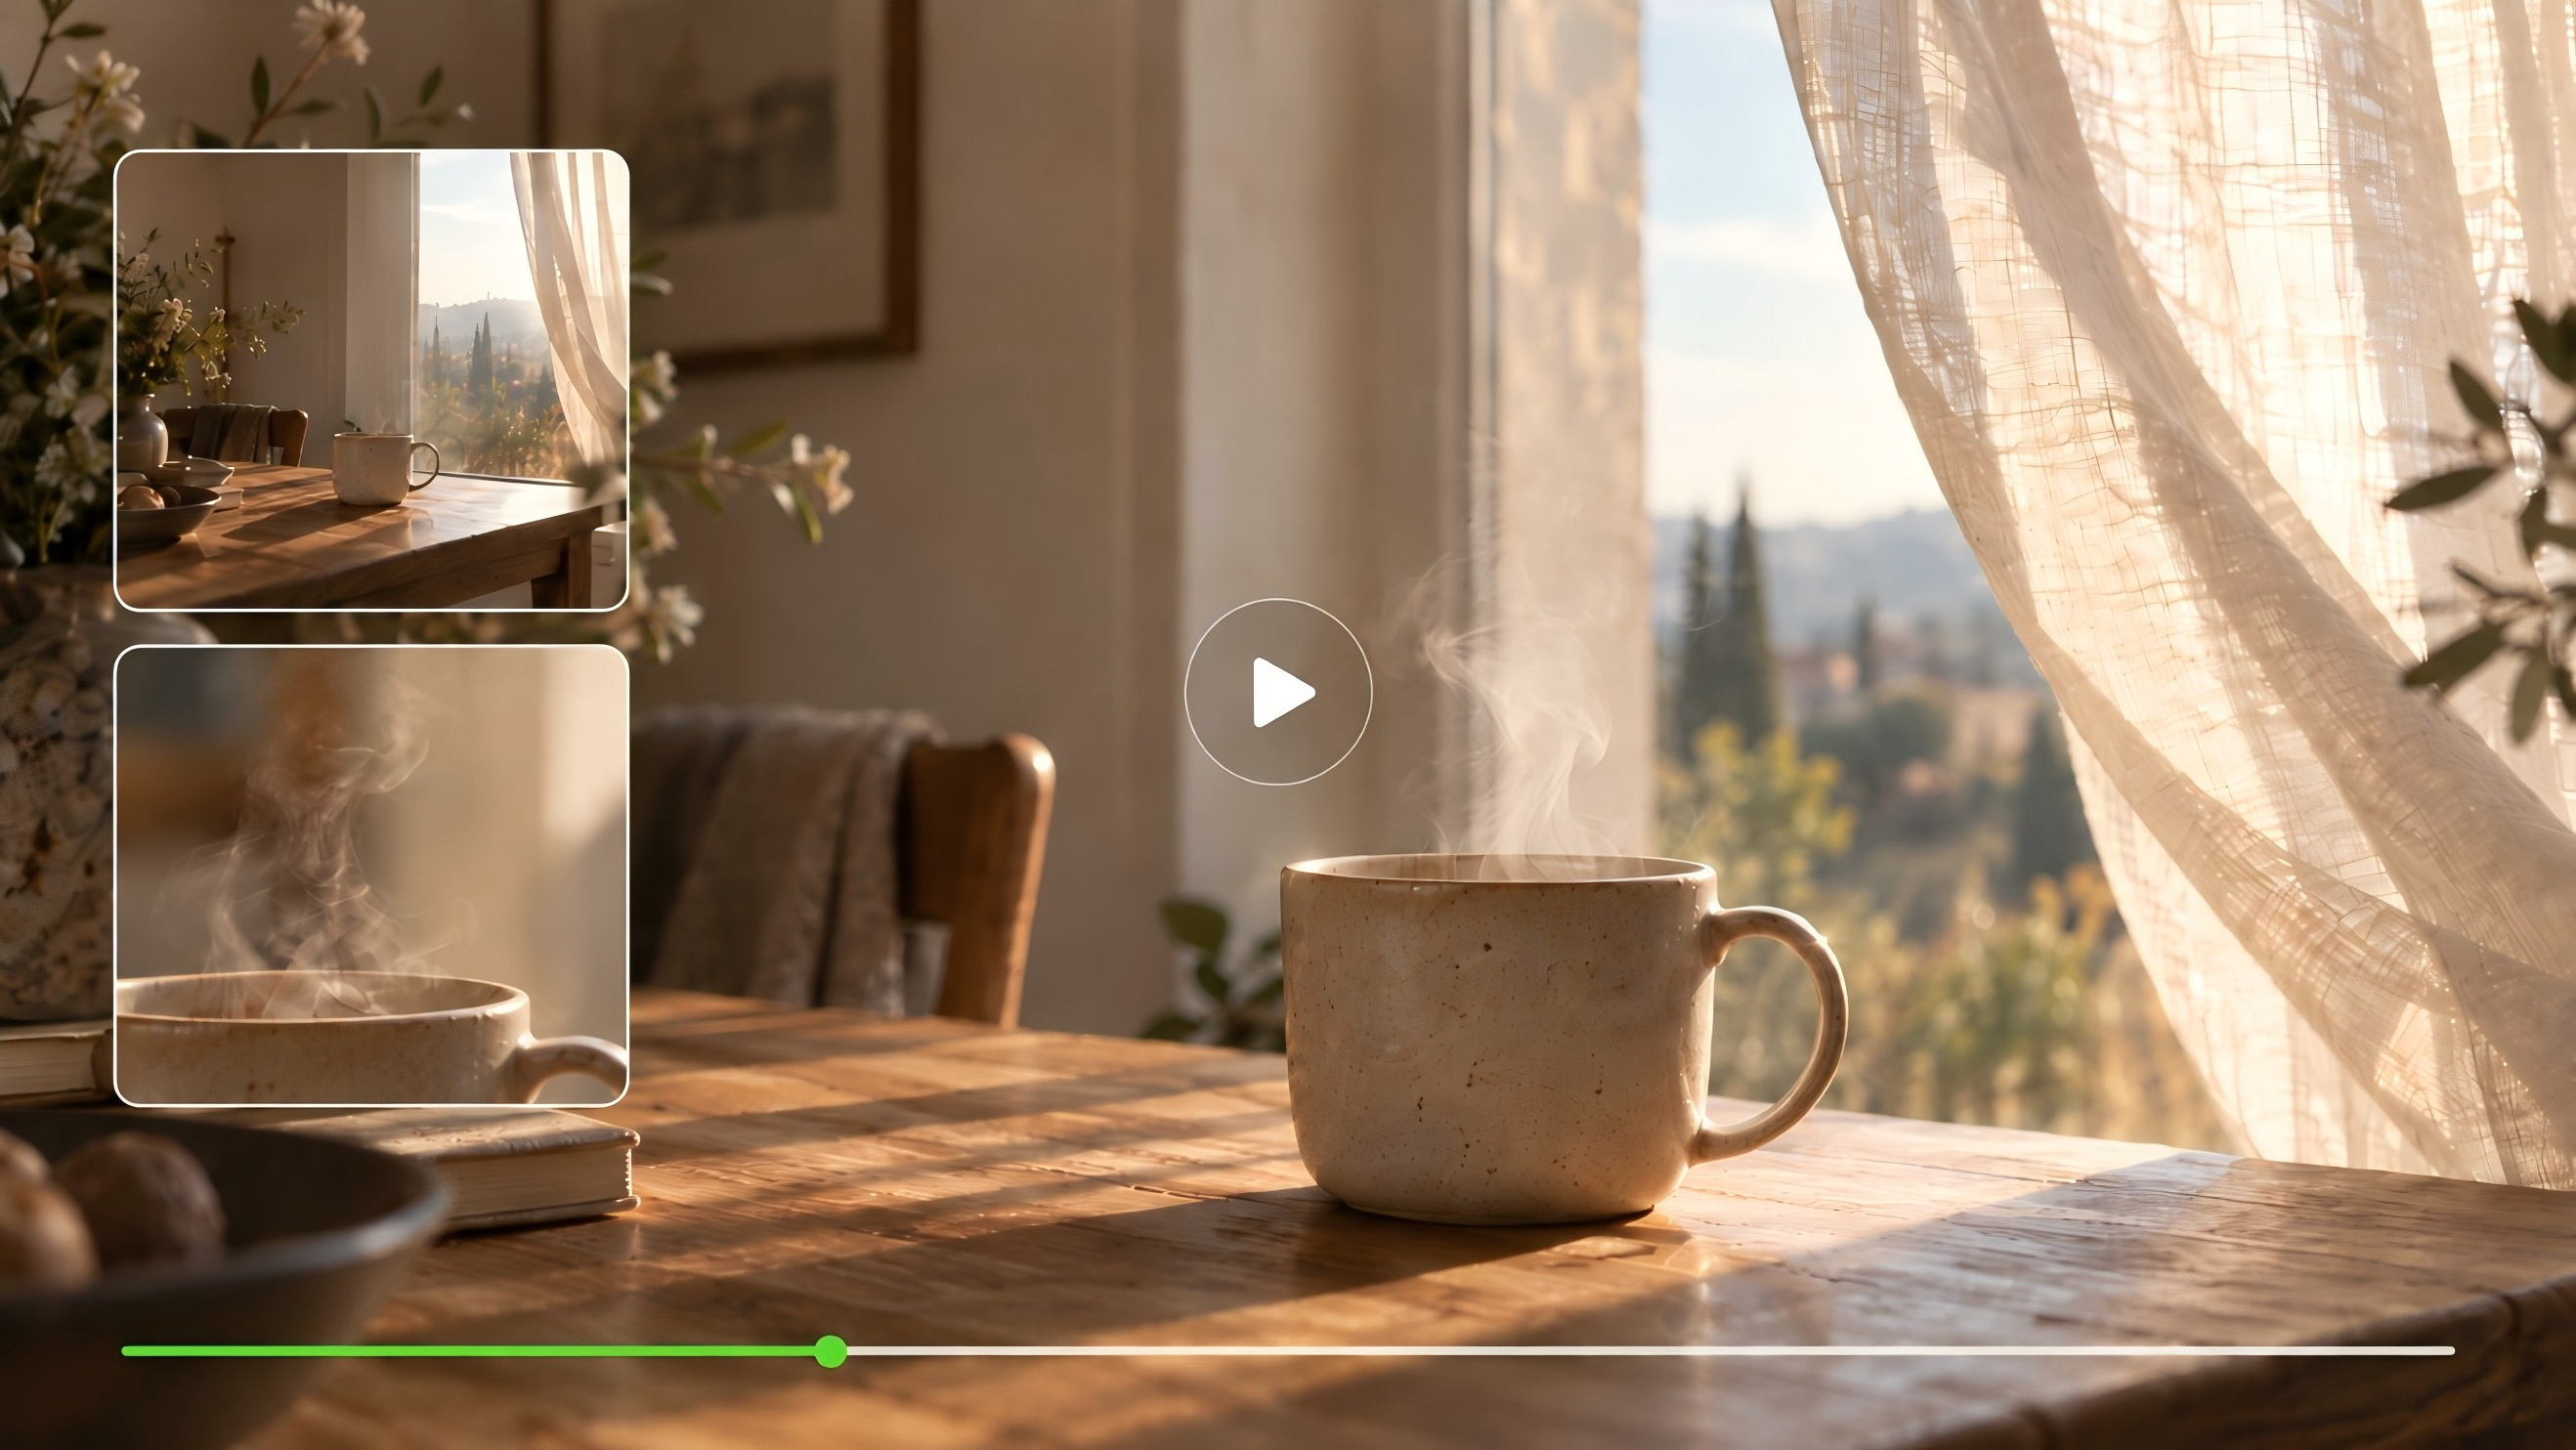
| Prompt: กล้องวินเทจตั้งอยู่บนโต๊ะไม้ พร้อมแสงเช้านุ่ม ๆ สาดผ่านทั่วฉาก |
โมเดลจำเป็นต้องเข้าใจวัตถุ วัสดุ การจัดวางในเชิงพื้นที่ แสง และสไตล์ภาพโดยรวม ก่อนจะสร้างภาพที่สอดคล้องออกมา
ทุกวันนี้ การประเมินโมเดลแปลงข้อความเป็นภาพมีมากกว่าการพิจารณาคุณภาพของภาพ การให้ความสำคัญได้เปลี่ยนไปเน้นความเข้าใจพรอมต์อย่างแม่นยำ การจัดการฉากที่ซับซ้อน การรักษาความสอดคล้องของภาพ และการรองรับการปรับแต่งที่ยืดหยุ่น
โมเดลแปลงข้อความเป็นภาพทำงานอย่างไร?
โมเดลแปลงข้อความเป็นภาพจะแปลคำบรรยายที่เป็นข้อความให้เป็นเนื้อหาภาพ โดยเรียนรู้ว่าภาษามีความสัมพันธ์กับวัตถุ สไตล์ องค์ประกอบ และรายละเอียดอื่นๆ อย่างไร ระบบสมัยใหม่จำนวนมากใช้วิธีการแบบดิฟฟิวชัน โดยมีพรอมต์เป็นตัวนำขั้นตอนทีละขั้นที่ค่อยๆ เปลี่ยนสัญญาณรบกวนทางภาพให้กลายเป็นภาพสำเร็จ.
กระบวนการนี้สามารถทำความเข้าใจได้เป็นสามขั้นตอน:
1.การเรียนรู้ว่าข้อความเชื่อมโยงกับภาพอย่างไร
ก่อนจะสร้างภาพ โมเดลแปลงข้อความเป็นภาพจะเรียนรู้จากชุดข้อมูลขนาดใหญ่ที่มีภาพจับคู่กับคำบรรยาย ระหว่างการฝึก โมเดลจะระบุรูปแบบระหว่างคำและรายละเอียดเชิงภาพ รวมถึงวัตถุ สี รูปร่าง สไตล์ และความสัมพันธ์เชิงพื้นที่ ตัวอย่างเช่น โมเดลเรียนรู้ว่าคอนเซปต์อย่าง “vintage camera,” “wooden desk,” และ “soft morning light” เชื่อมโยงกับลักษณะทางภาพที่เฉพาะเจาะจงอย่างไร
2.การทำความเข้าใจพรอมต์
เมื่อคุณป้อนพรอมป์ ระบบจะถอดความข้อความของคุณให้อยู่ในรูปแบบที่มันเข้าใจได้ โดยจับความหมายและบริบทหลักเอาไว้ แม้ว่าความก้าวหน้าทางเทคโนโลยีจะต่างกันไปตามแต่ละโมเดล—และระบบเชิงพาณิชย์มักเก็บสถาปัตยกรรมทั้งหมดไว้เป็นความลับ—องค์ประกอบด้านข้อความและภาพเหล่านี้จะทำงานร่วมกันเพื่อเชื่อมโยงคำพูดของคุณกับผลลัพธ์ภาพสุดท้าย
3.การสร้างภาพ
โมเดลสร้างภาพจากข้อความสมัยใหม่จำนวนมากใช้วิธีการดิฟฟิวชัน แม้ว่าโมเดลอื่นอาจใช้แนวทางการสร้างแบบออโตรีเกรสซีฟหรือวิธีอื่น ๆ ในระบบที่ใช้ดิฟฟิวชัน กระบวนการจะเริ่มจากสัญญาณรบกวนเชิงภาพและค่อย ๆ กำจัดสัญญาณรบกวนออกไปตามข้อมูลที่พรอมป์ให้ไว้ ผ่านขั้นตอนการลดสัญญาณรบกวนซ้ำ ๆ ภาพจะค่อย ๆ พัฒนารูปร่าง รายละเอียด และสไตล์ที่ตรงกับคำอธิบาย ระบบบางระบบจะดำเนินกระบวนการนี้ภายใน latent space ที่ถูกบีบอัดก่อนจะแปลงผลลัพธ์ให้เป็นภาพสุดท้าย หลังจากสร้างภาพแล้ว ยังสามารถปรับแต่งเพิ่มเติมเพื่อทำให้รายละเอียดแม่นยำขึ้นหรือเตรียมไว้สำหรับการแก้ไขได้
อะไรทำให้โมเดลแปลงข้อความเป็นภาพแตกต่างกัน?
โมเดลแปลงข้อความเป็นภาพสามารถตอบสนองต่อพรอมต์เดียวกันได้แตกต่างกันมาก บางส่วนเกิดจากวิธีที่ภาพถูกสร้างขึ้น ขณะที่บางส่วนมาจากประเภทของข้อมูลนำเข้าที่โมเดลสามารถอ่านและใช้งานได้
สถาปัตยกรรมการสร้าง
ในระดับการสร้างภาพ แนวทางที่พบได้ทั่วไปสองแบบคือกระบวนการ diffusion และการสร้างแบบ autoregressive
แนวทาง | วิธีการทำงาน | การใช้งานทั่วไป |
โมเดลดิฟฟิวชัน | เริ่มจากสัญญาณรบกวนเชิงภาพและค่อย ๆ ปรับให้ละเอียดจนกลายเป็นภาพโดยมีพรอมต์เป็นตัวชี้นำ | การสร้างภาพที่มีรายละเอียด ฉากสมจริง งานภาพประกอบ และงานที่ขับเคลื่อนด้วยสไตล์ |
โมเดลออโตรีเกรสซีฟ | สร้างภาพโดยการทำนายโทเค็นหรือองค์ประกอบด้านภาพตามลำดับ | การสร้างภาพที่สร้างเนื้อหาภาพตามลำดับ แทนที่จะปรับแต่งสัญญาณรบกวน |
โมเดล diffusion ยังคงเป็นพื้นที่วิจัย text-to-image ที่มีการเคลื่อนไหวอย่างต่อเนื่อง แบบสำรวจปี 2023 Text-to-image Diffusion Models in Generative AI: A Survey ให้ภาพรวมที่เป็นประโยชน์เกี่ยวกับวิธีการ text-to-image ที่ใช้ diffusion ชุดข้อมูล วิธีการประเมิน และการประยุกต์ที่เกี่ยวข้อง.
อินพุตมัลติโมดัล
คำว่า มัลติโมดัล อธิบายประเภทของอินพุตที่โมเดลสามารถใช้ได้ มากกว่าวิธีที่มันสร้างภาพ โมเดลสร้างภาพแบบมัลติโมดัลอาจรับข้อความ ภาพ และข้อมูลอ้างอิงด้านภาพสำหรับการสร้างตามต้นแบบ การแก้ไข หรือการคงความสม่ำเสมอของตัวละครและผลิตภัณฑ์ตลอดทั้งชุด ภายใต้กระบวนการ โมเดลอาจยังคงใช้ diffusion การสร้างแบบ autoregressive หรือวิธีอื่น ดังนั้นโมเดลหนึ่งจึงอาจอยู่ได้มากกว่าหนึ่งหมวดหมู่
โมเดลสร้างภาพจากข้อความที่ดีที่สุดในปี 2026 คืออะไร?
สำหรับคู่มือนี้ เราได้คัดเลือกโมเดลปัจจุบันจำนวนเจ็ดตัวที่สะท้อนแนวทางที่แตกต่างกันในการสร้างภาพ การแก้ไข การสร้างจากข้อมูลอ้างอิง และการผลิตผลงานเชิงภาพ ลำดับที่นำเสนอนี้ไม่ใช่การจัดอันดับ
โมเดล | ประเภทโมเดล | เหมาะสำหรับ | คุณลักษณะเด่น |
โมเดลสร้างและแก้ไขภาพด้วยอินพุตหลายโมดัล | การสร้างโดยอ้างอิง ภาพผลิตภัณฑ์ ตัวละคร และการแก้ไขอย่างละเอียด | สร้างจากข้อความหรือภาพ ผสมผสานคุณลักษณะจากแหล่งอ้างอิงได้สูงสุด 10 รายการ และรองรับการคงตัวแบบ การปรับแก้ที่แม่นยำ และการควบคุมสไตล์ IMAGE 3.0 รองรับการสร้างได้สูงสุด 2K ขณะที่ IMAGE 3.0 Omni ให้ได้สูงสุด 4K | |
Leonardo Lucid Origin | โมเดลสร้างภาพ | ภาพประกอบ อาร์ตคอนเซ็ปต์ ม็อกอัปผลิตภัณฑ์ และการสร้างภาพทั่วไป | ครอบคลุมหลากหลายสไตล์ ปฏิบัติตามพรอมต์ที่ละเอียด สร้างภาพ Full HD และรองรับการเรนเดอร์ข้อความที่อ่านได้ชัดเจน |
Seedream 5.0 Pro | โมเดลสร้างและแก้ไขภาพ | ภาพผลิตภัณฑ์ อินโฟกราฟิก สินทรัพย์การออกแบบ และการแก้ไขเฉพาะจุด | ทำงานจากข้อความหรือภาพ รับข้อมูลอ้างอิง รองรับการแก้ไขเฉพาะพื้นที่ และจัดการอินพุตและการสร้างหลายภาษา |
Adobe Firefly Image 5 | โมเดลการสร้างและแก้ไขภาพ | การผลิตงานออกแบบ สินทรัพย์การตลาด และโปรเจกต์ที่อิงกับ Adobe | สร้างจากข้อความ ทำงานร่วมกับภาพอ้างอิง และอนุญาตให้แก้ไขแบบเจาะจงใน Photoshop โดยคงเนื้อหาภาพรอบข้างไว้ |
Krea 2 Large | โมเดลการสร้างภาพ | โฟโตเรียลิซึม งานที่ขับเคลื่อนด้วยสไตล์ และทิศทางด้านภาพ | ปรับให้เหมาะสำหรับภาพสมจริงที่ถ่ายทอดอารมณ์ได้พร้อมการสร้างด้วยพรอมป์และการควบคุมองค์ประกอบ หัวข้อ และสไตล์ด้วยการอ้างอิง |
Luma UNI-1.1 | โมเดลภาพมัลติโหมดแบบบูรณาการ | การสร้างและการปรับภาพที่ขับเคลื่อนด้วยการอ้างอิง | ผสานการสร้างภาพเข้ากับการแก้ไขด้วยภาษาธรรมชาติ และรองรับการป้อนข้อมูลอ้างอิงได้สูงสุดเก้ารายการต่อคำขอ |
Runway Gen-4 Image | โมเดลสร้างภาพภายในแพลตฟอร์มภาพและวิดีโอ | การพัฒนาตัวละคร การออกแบบฉาก และโปรเจ็กต์ที่ต่อยอดไปสู่วิดีโอในภายหลัง | สร้างจากข้อความและภาพอ้างอิง ใช้ภาพอ้างอิงได้สูงสุดสามภาพต่อการสร้างหนึ่งครั้ง และสามารถนำตัวละคร วัตถุ หรือคุณลักษณะทางภาพไปยังฉากใหม่ได้ |
ส่วนถัดไปเปรียบเทียบโมเดลเหล่านี้ในด้านการทำตามพรอมต์ การจัดการข้อมูลอ้างอิง การแก้ไข ความสอดคล้องด้านภาพ และการควบคุมสไตล์
โมเดลข้อความเป็นภาพเปรียบเทียบกันในปี 2026 อย่างไร?
โมเดลข้อความเป็นภาพมีความแตกต่างกันมากที่สุดในด้านความแม่นยำของพรอมต์ การใช้ข้อมูลอ้างอิง การแก้ไข ความสอดคล้อง และการควบคุมสไตล์ ความแตกต่างเหล่านี้สังเกตได้ง่ายขึ้นในโปรเจ็กต์ที่เกี่ยวข้องกับภาพซ้ำ การแก้ไข ผลิตภัณฑ์ หรือการปรากฏของตัวละครซ้ำๆ
พื้นที่เปรียบเทียบ | สิ่งที่จะเปรียบเทียบ | ทำไมจึงสำคัญ |
การปฏิบัติตามพรอมต์ | ตัวแบบ คุณลักษณะ ความสัมพันธ์ของวัตถุ องค์ประกอบ และรายละเอียดที่จำเป็น | ภาพที่ปรับแต่งอย่างดี ก็ยังไม่เพียงพอหากไม่ตรงตามบรีฟ |
การจัดการอ้างอิง | จำนวนของรายการอ้างอิง การคงตัวแบบ การถ่ายทอดสไตล์ และคำแนะนำการจัดองค์ประกอบ. | การอ้างอิงช่วยให้ตัวละคร ผลิตภัณฑ์ หรือทิศทางภาพยังคงจดจำได้ในหลากหลายภาพ. |
การแก้ไขภาพ | การเปลี่ยนแปลงเฉพาะจุด การแก้ไขด้วยภาษาธรรมชาติ และการรักษาความสมบูรณ์ของพื้นที่ที่ไม่ได้แตะต้องไว้ได้ดีเพียงใด. | การแก้ไขที่แม่นยำช่วยประหยัดเวลาและหลีกเลี่ยงการสร้างภาพขึ้นใหม่ตั้งแต่ต้น. |
ความสม่ำเสมอทางภาพ | ตัวละคร ผลิตภัณฑ์ เครื่องแต่งกาย สไตล์ และรายละเอียดที่เกิดซ้ำในภาพหรือการแก้ไข | รายละเอียดที่คงที่มีความสำคัญต่อชุดภาพ แคมเปญ สตอรีบอร์ด และชุดผลิตภัณฑ์ |
การควบคุมสไตล์ | แสง พาเลตต์ เนื้อสัมผัส รูปลักษณ์แบบภาพถ่าย สไตล์ภาพประกอบ และทิศทางภาพ | การควบคุมสไตล์ที่ชัดเจนช่วยให้ภาพที่เกี่ยวข้องยังคงเชื่อมโยงกันทางสายตา |
ความเหมาะสมกับเวิร์กโฟลว์ | การปรับแก้ไข, ตัวเลือกการส่งออก, การใช้งานภาพสู่วิดีโอ และความเข้ากันได้กับเครื่องมือสร้างสรรค์อื่น ๆ | สิ่งที่เกิดขึ้นหลังการสร้างอาจสำคัญพอ ๆ กับภาพแรก |
โมเดลที่ทำงานได้ดีสำหรับภาพแนวคิดอย่างรวดเร็วอาจไม่เหมาะกับซีรีส์สินค้าหรือโปรเจ็กต์ตัวละคร การมีความแม่นยำของพรอมต์และสไตล์อาจเพียงพอสำหรับภาพเดียว ขณะที่งานซ้ำ ๆ มักต้องการแหล่งอ้างอิงที่แข็งแรงขึ้น การปรับแต่ง และความสม่ำเสมอ
จะเลือกโมเดลสร้างภาพจากข้อความที่ดีที่สุดอย่างไร?
เมื่อเลือก เครื่องสร้างภาพด้วย AI, ให้เริ่มจากสิ่งที่คุณต้องการสร้างและรายละเอียดใดที่ต้องคงเดิมขณะปรับแก้ภาพ ตารางด้านล่างแสดงสิ่งที่ควรมองหาในสถานการณ์ที่พบได้ทั่วไปหลายแบบ
หากคุณต้องการ | มองหา | เหตุใดจึงสำคัญ |
ภาพคอนเซปต์อย่างรวดเร็ว | ความแม่นยำของพรอมต์ คุณภาพของภาพ และช่วงของสไตล์ | คุณสามารถเข้าใกล้ผลลัพธ์ที่ตั้งใจไว้ได้ด้วยการปรับแก้ให้น้อยครั้งลง |
ตัวละครหรือผลิตภัณฑ์ที่มีความสม่ำเสมอ | การจัดการข้อมูลอ้างอิงและการรักษารายละเอียด | ใบหน้า เสื้อผ้า ผลิตภัณฑ์ และคุณลักษณะจำแนกอื่น ๆ ต้องยังคงจดจำได้ในทุกภาพ |
การแก้ไขภาพบ่อยครั้ง | การแก้ไขเฉพาะจุดและการเปลี่ยนแปลงด้วยภาษาธรรมชาติ | คุณสามารถปรับแต่งบางส่วนของภาพโดยไม่ต้องสร้างฉากทั้งหมดใหม่ |
ทรัพยากรแคมเปญหรือซีรีส์ภาพ | หัวเรื่องที่คงที่ สไตล์ และองค์ประกอบ | ภาพที่เกี่ยวข้องจำเป็นต้องมีทิศทางด้านภาพเดียวกัน |
ภาพที่ต่อมาจะเปลี่ยนเป็นวิดีโอ | ภาพอ้างอิงและตัวเลือกภาพสู่วิดีโอ | หัวเรื่องและรายละเอียดด้านภาพที่คงที่ทำให้ง่ายต่อการนำไปสู่การเคลื่อนไหว |
ทำไม Kling IMAGE 3.0 จึงควรค่าแก่การพิจารณา?
Kling IMAGE 3.0 ช่วยให้คุณเริ่มต้นการสร้างสรรค์ด้วยพรอมต์ข้อความหรือภาพอ้างอิง จากนั้นปรับแต่งทุกรายละเอียดได้ด้วยภาษาธรรมชาติ นอกเหนือจากการสร้างผลลัพธ์แบบมาตรฐาน มันยังให้คุณควบคุมความสม่ำเสมอของตัวละคร การปรับแก้ที่แม่นยำ และการปรับแต่งสไตล์ได้อย่างลึกซึ้ง เปิดโอกาสสู่ความเป็นไปได้เชิงสร้างสรรค์ที่ไม่รู้จบ
เปลี่ยนไอเดียที่ซับซ้อนให้กลายเป็นภาพสดใหม่
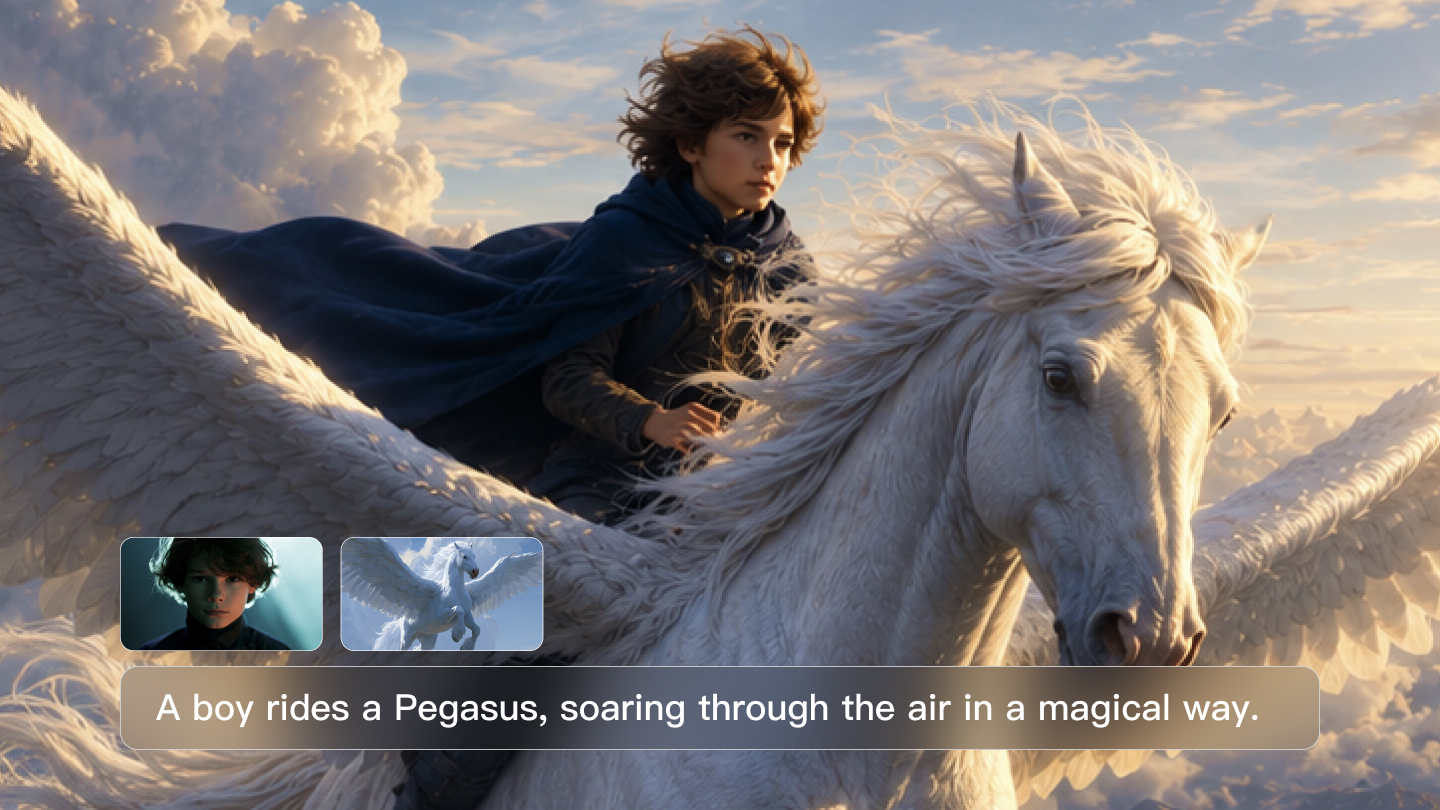
IMAGE 3.0 ช่วยให้คุณผสานสัญญาณภาพจากข้อมูลอ้างอิงหลายชุดและใช้ภาษาพูดในชีวิตประจำวันเพื่อก้าวข้ามการแก้ไขทั่วไป ผสานตัวแบบจากหลายภาพ พลิกมุมมองของฉาก หรือย้ายคอนเซ็ปต์ไปสู่สไตล์ใหม่ทั้งหมด ในขณะที่ยังทำให้ผลลัพธ์สุดท้ายลื่นไหลและกลมกลืน
ภาพอ้างอิง 1 | ภาพอ้างอิง 2 | ภาพผลลัพธ์ |
พรอมต์: รวมสัตว์จากภาพ 1 และภาพ 2 เข้าด้วยกัน. | ||
รักษาให้ตัวละคร ผลิตภัณฑ์ และรายละเอียดสำคัญยังคงจดจำได้
คุณสามารถใช้ภาพอ้างอิงได้สูงสุด 10 ภาพในการสร้างหนึ่งครั้ง อ้างอิงที่แตกต่างกันสามารถกำหนด ตัวละคร, เครื่องแต่งกาย ผลิตภัณฑ์ ฉาก หรือสไตล์ ในขณะที่พรอมต์ของคุณอธิบายว่าองค์ประกอบเหล่านั้นควรมารวมกันอย่างไร สำหรับการปรับแต่งภาพบุคคล การใช้อ้างอิงใบหน้าจะช่วยรักษาลักษณะใบหน้าที่จดจำได้ ในขณะที่คุณเปลี่ยนทรงผม เครื่องแต่งกาย ท่าโพส หรือฉาก หากคุณต้องการเพียงสลับใบหน้าเข้าไปในช็อตที่มีอยู่แล้ว คุณยังสามารถไปที่เวิร์กโฟลว์ face swap ของ Kling ได้โดยตรงอีกด้วย
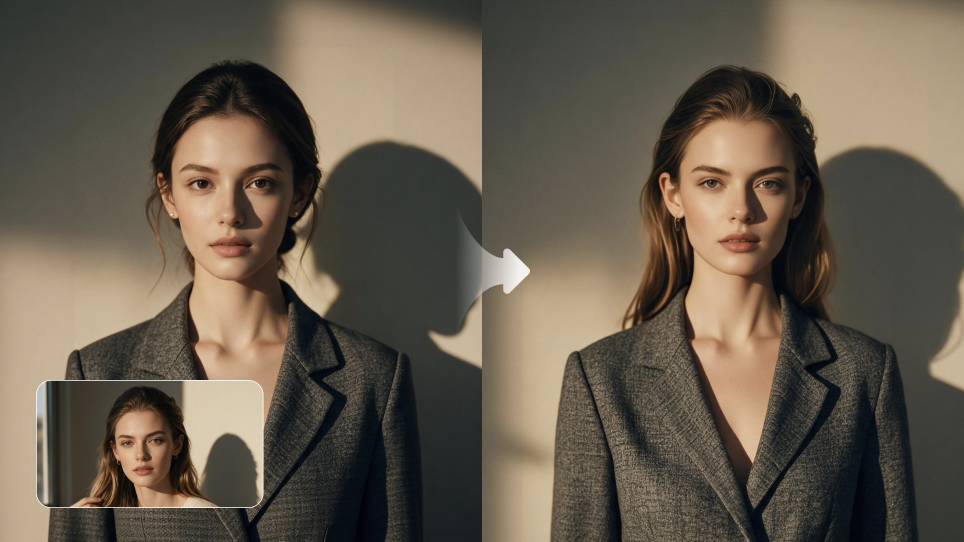
เปลี่ยนเฉพาะสิ่งที่จำเป็นต้องเปลี่ยน
หากส่วนใหญ่ของภาพดูถูกต้องอยู่แล้ว คุณสามารถใช้ Kling IMAGE 3.0 เป็น ตัวแก้ไขภาพด้วย AI เพื่อปรับรายละเอียดเฉพาะโดยไม่ต้องสร้างฉากขึ้นใหม่ทั้งหมด คำสั่งภาษาธรรมชาติสามารถเปลี่ยนขนาด สี วัสดุ สีหน้า หรือพื้นหลังของวัตถุ โดยตั้งใจรักษาส่วนรอบ ๆ ของภาพให้เหมือนเดิม คุณยังสามารถใช้ Kling AI เป็น ตัวลบลายน้ำ สำหรับภาพที่คุณเป็นเจ้าของหรือได้รับอนุญาตให้แก้ไข การปรับแต่งอื่น ๆ ได้แก่ การลงสีภาพถ่าย เอฟเฟกต์วินเทจ การปรับแต่งภาพ doodle การเปลี่ยนแปลงแสงและโทน รวมถึงการบูรณะภาพ
รักษาสไตล์และโทนให้สม่ำเสมอในทุกภาพ หากคุณมีทิศทางภาพที่ชัดเจนอยู่แล้ว คุณสามารถใช้ภาพที่มีอยู่เป็นภาพอ้างอิงสไตล์ได้ Kling IMAGE 3.0 สามารถถ่ายทอดองค์ประกอบอย่างเช่น ลายแปรง สี การจัดองค์ประกอบ และโทน ไปยังภาพใหม่ได้ สิ่งนี้เหมาะสำหรับชุดภาพประกอบ ภาพสินค้า หรือคอนเทนต์แบรนด์ที่ต้องการให้ลุคเดียวกันปรากฏในมากกว่าหนึ่งภาพ
ภาพอ้างอิง 1 | ภาพอ้างอิง 2 | ภาพผลลัพธ์ |
พรอมต์: เปลี่ยนสไตล์ของภาพที่ 1 ให้เป็นแบบเดียวกับภาพที่ 2 | ||
จบ
โมเดลแปลงข้อความเป็นภาพมีจุดเด่นต่างกัน ดังนั้นการเลือกที่เหมาะสมขึ้นอยู่กับสิ่งที่คุณต้องการหลังจากสร้างภาพแรก หากคุณต้องการเพียงแนวคิดอย่างรวดเร็ว ความแม่นยำของพรอมต์และคุณภาพของภาพอาจเพียงพอแล้ว สำหรับภาพสินค้า ตัวละครที่ปรากฏซ้ำ หรือชุดภาพ การอ้างอิง การแก้ไข และความสม่ำเสมอมีความสำคัญมากกว่า หากคุณต้องการเริ่มจากข้อความหรือภาพที่มีอยู่ Kling IMAGE 3.0 ช่วยให้คุณผสานการอ้างอิง ปรับเปลี่ยนรายละเอียดเฉพาะ และคงรูปลักษณ์เดียวกันไว้ในภาพใหม่ได้ ไม่ว่าคุณจะสร้างแคมเปญผลิตภัณฑ์ พัฒนาตัวละครที่ปรากฏซ้ำ หรือแปลงแนวคิดเริ่มต้นให้กลายเป็นชุดภาพสมบูรณ์ โมเดลที่เหมาะสมควรทำให้คุณรักษารายละเอียดที่คุณให้ความสำคัญได้ง่ายขึ้นเมื่อโปรเจกต์เติบโต
คำถามที่พบบ่อย
ใช้โมเดลภาษา AI ใดสำหรับการสร้างภาพจากข้อความ?
ไม่มีโมเดลภาษารายใดที่ถูกใช้โดยทุกระบบแปลงข้อความเป็นภาพ หากคุณถามว่าโมเดลภาษา AI ใดที่ใช้สำหรับความสามารถในการสร้างภาพจากข้อความ คำตอบจะแตกต่างกันไปตามโมเดล บางระบบใช้ตัวเข้ารหัสข้อความ เช่น CLIP หรือ T5 ขณะที่บางระบบใช้ส่วนประกอบด้านภาษา หรือภาษา-ภาพ เพื่ออ่านพรอมต์ก่อนที่จะสร้างภาพ
AI ตัวไหนเปลี่ยนข้อความเป็นภาพได้บ้าง?
มีโมเดลภาพ AI จำนวนมากที่สามารถแปลงพรอมต์ที่เขียนไว้ให้เป็นภาพสำเร็จรูปได้ รวมถึง Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 และ Runway Gen-4 Image แต่ละโมเดลจัดการพรอมต์ แหล่งอ้างอิง การแก้ไข และความสอดคล้องของภาพแตกต่างกัน ดังนั้นโมเดลที่เหมาะสมจึงขึ้นอยู่กับประเภทของภาพที่คุณต้องการสร้าง
โมเดลข้อความเป็นภาพใช้ภาพอ้างอิงได้ไหม?
ใช่ โมเดลสร้างภาพจากข้อความจำนวนมากสามารถใช้ภาพอ้างอิงควบคู่กับพรอมป์ที่เป็นข้อความได้ ซึ่งทำให้ AI แปลงภาพเป็นภาพ มีประโยชน์เมื่อคุณต้องการทำงานจากภาพที่มีอยู่แทนที่จะเริ่มจากศูนย์ ภาพอ้างอิงสามารถกำหนดรายละเอียด เช่น ตัวละคร ผลิตภัณฑ์ ท่าโพส องค์ประกอบ สี หรือสไตล์ ขณะที่พรอมป์บอกโมเดลว่าควรเปลี่ยนอะไร Kling IMAGE 3.0 สามารถใช้ภาพอ้างอิงได้สูงสุด 10 ภาพในการสร้างครั้งเดียว ซึ่งเป็นประโยชน์เมื่อจำเป็นต้องให้ตัวละคร ผลิตภัณฑ์ หรือสไตล์ภาพเดียวกันยังคงเป็นที่จดจำได้.
ฉันจะลบพื้นหลังออกจากภาพได้อย่างไร?
หากคุณต้องการภาพสินค้าที่สะอาดกว่า ภาพโปรไฟล์ หรือสินทรัพย์สำหรับการออกแบบ คุณสามารถ ลบพื้นหลังออกจากภาพ และคงให้วัตถุหลักแยกโดดอยู่ พื้นหลังโปร่งใสเหมาะสำหรับรายการสินค้า งานนำเสนอ โพสต์บนโซเชียล หรือเลย์เอาต์ที่ต้องให้วัตถุวางอยู่บนฉากหลังต่างออกไป หลังจากลบแล้ว ให้ตรวจสอบขอบละเอียดรอบเส้นผม เสื้อผ้า ขน หรือวัตถุขนาดเล็ก จากนั้นคงพื้นหลังให้โปร่งใส เปลี่ยนเป็นสีทึบ หรือวางวัตถุหลักลงในฉากใหม่