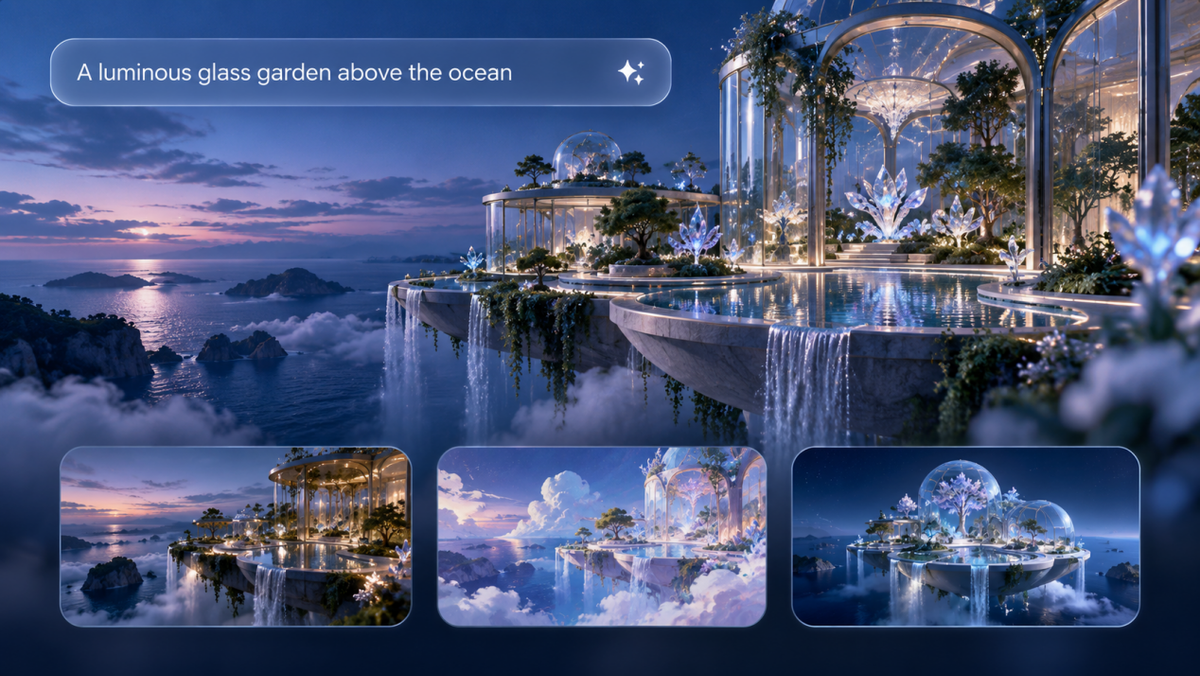
Chỉ với một ý tưởng hoặc mô tả đơn giản, các mô hình chuyển văn bản thành hình ảnh có thể biến ngôn ngữ tự nhiên thành các khái niệm trực quan. Đối với nhà sáng tạo, những mô hình chuyển văn bản thành hình ảnh tốt nhất còn làm được nhiều hơn cả việc tạo hình. Chúng cần hiểu các prompt phức tạp, giữ được sự nhất quán thị giác và hỗ trợ tinh chỉnh sáng tạo theo thời gian. Hướng dẫn này giải thích cách các mô hình chuyển văn bản thành hình ảnh hoạt động, so sánh những khả năng quan trọng nhất và khám phá cách Kling IMAGE 3.0 kết hợp sáng tạo dựa trên hình ảnh tham chiếu, chỉnh sửa chính xác cùng quy trình linh hoạt để giúp nhà sáng tạo hiện thực hóa ý tưởng trực quan.
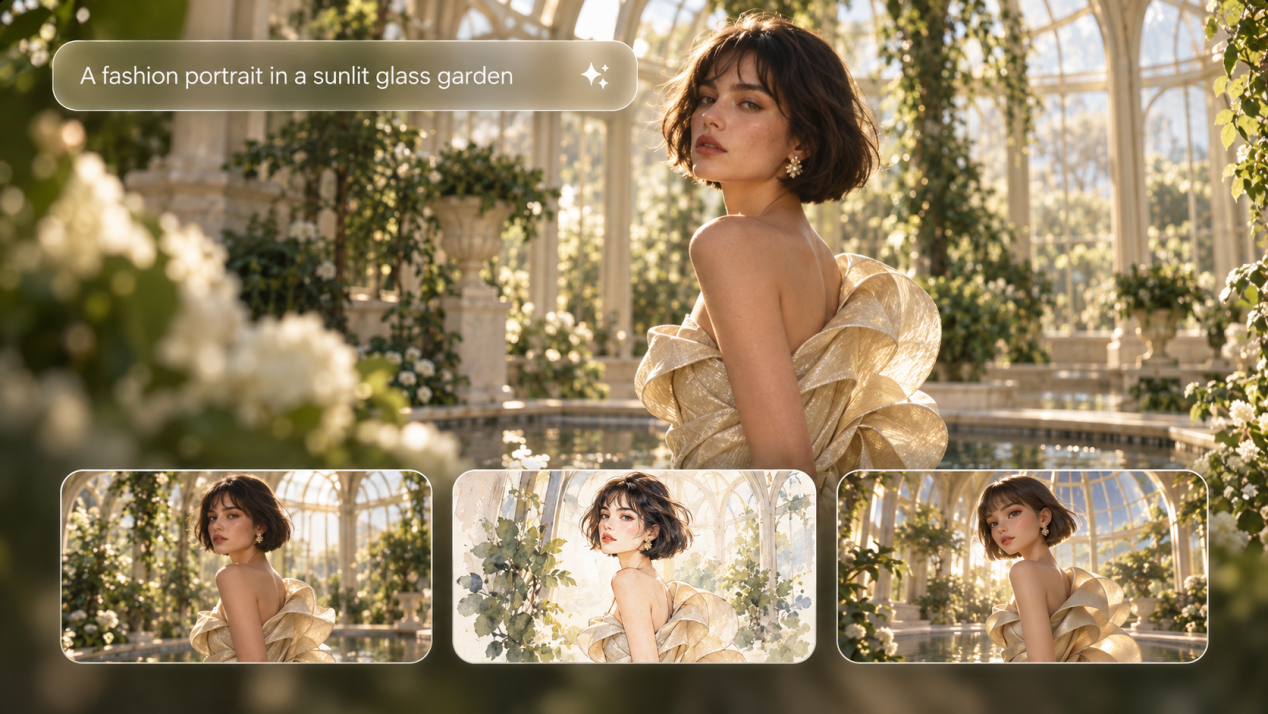
Các mô hình chuyển văn bản thành hình ảnh là gì?
Một mô hình chuyển văn bản thành hình ảnh là một dạng hệ thống trí tuệ nhân tạo chuyển các prompt ngôn ngữ tự nhiên thành hình ảnh kỹ thuật số dựa trên các chi tiết được mô tả trong prompt.
Các hệ thống chuyển văn bản thành hình ảnh hiện đại thường kết hợp một thành phần hiểu hoặc mã hóa prompt với một thành phần tạo hình ảnh biến những hướng dẫn đó thành nội dung thị giác. Một số mô hình cũng có thể làm việc với hình ảnh và các tham chiếu trực quan khác, giúp chúng theo sát những prompt phức tạp, giữ lại các chi tiết quan trọng và hỗ trợ chỉnh sửa chính xác hơn.
Ví dụ, hãy xem xét một prompt:
| Prompt: Một chiếc máy ảnh cổ được đặt trên một bàn gỗ với ánh sáng buổi sáng dịu nhẹ chiếu ngang khung cảnh. |
Mô hình cần hiểu đối tượng, chất liệu, bố cục không gian, ánh sáng và phong cách thị giác tổng thể trước khi tạo ra hình ảnh tương ứng.
Ngày nay, việc đánh giá các mô hình chuyển văn bản thành hình ảnh không chỉ dừng ở chất lượng hình ảnh. Trọng tâm đã chuyển sang khả năng hiểu prompt chính xác, xử lý các cảnh phức tạp, duy trì tính nhất quán thị giác và hỗ trợ chỉnh sửa linh hoạt.
Các mô hình chuyển văn bản thành hình ảnh hoạt động như thế nào?
Các mô hình chuyển văn bản thành hình ảnh chuyển đổi các mô tả dạng viết thành nội dung trực quan bằng cách học cách ngôn ngữ liên hệ với các đối tượng, phong cách, bố cục và những chi tiết khác. Nhiều hệ thống hiện đại sử dụng các phương pháp dựa trên khuếch tán, với prompt hướng dẫn một quy trình từng bước dần dần biến nhiễu hình ảnh thành một bức hình hoàn chỉnh.
Quy trình có thể được hiểu qua ba giai đoạn:
1.Học cách văn bản kết nối với hình ảnh
Trước khi tạo hình ảnh, một mô hình chuyển văn bản thành hình ảnh học từ các bộ dữ liệu lớn chứa hình ảnh đi kèm mô tả. Trong quá trình huấn luyện, nó xác định các mẫu giữa từ ngữ và chi tiết trực quan, bao gồm đối tượng, màu sắc, hình dạng, phong cách và mối quan hệ không gian. Ví dụ, mô hình học cách các khái niệm như “máy ảnh cổ điển”, “bàn gỗ” và “ánh sáng buổi sáng mềm mại” gắn liền với những đặc điểm thị giác cụ thể.
2.Hiểu prompt
Khi bạn nhập một prompt, hệ thống chuyển văn bản của bạn sang một định dạng mà nó có thể hiểu, nắm bắt ý nghĩa cốt lõi và ngữ cảnh. Mặc dù công nghệ chính xác khác nhau tùy theo từng mô hình — và các hệ thống thương mại thường giữ kín toàn bộ kiến trúc — các thành phần văn bản và thị giác này phối hợp với nhau để kết nối lời bạn nói với đầu ra hình ảnh cuối cùng.
3.Tạo ra hình ảnh
Nhiều mô hình văn bản-thành-hình ảnh hiện đại sử dụng phương pháp khuếch tán, mặc dù các mô hình khác có thể dùng cách sinh tự hồi quy hoặc các phương pháp tạo sinh khác. Trong các hệ thống dựa trên khuếch tán, quá trình bắt đầu bằng nhiễu hình ảnh và dần loại bỏ nhiễu đó dựa trên thông tin mà prompt cung cấp. Thông qua các bước khử nhiễu lặp lại, hình ảnh dần hình thành hình khối, chi tiết và phong cách rõ ràng hơn phù hợp với mô tả. Một số hệ thống thực hiện quá trình này trong không gian tiềm ẩn được nén trước khi chuyển kết quả thành hình ảnh cuối cùng. Sau khi hình ảnh được tạo, có thể tiếp tục điều chỉnh để tinh chỉnh chi tiết hoặc chuẩn bị cho việc chỉnh sửa.
Điều gì khiến các mô hình chuyển văn bản thành hình ảnh trở nên khác biệt?
Các mô hình chuyển văn bản thành hình ảnh có thể phản hồi rất khác nhau với cùng một prompt. Một phần xuất phát từ cách hình ảnh được tạo ra, trong khi phần khác đến từ loại đầu vào mà mô hình có thể đọc và sử dụng.
Kiến trúc tạo sinh
Ở cấp độ tạo sinh, hai cách tiếp cận phổ biến là khuếch tán và tạo sinh tự hồi quy.
Cách tiếp cận | Cách thức hoạt động | Các cách sử dụng phổ biến |
Các mô hình khuếch tán | Bắt đầu với nhiễu thị giác và dần tinh chỉnh thành hình ảnh được dẫn dắt bởi lời nhắc. | Tạo hình ảnh chi tiết, cảnh chân thực, minh họa và các công việc dựa trên phong cách. |
Các mô hình tự hồi quy | Xây dựng một hình ảnh bằng cách dự đoán tuần tự các token hoặc thành phần thị giác. | Tạo ảnh xây dựng nội dung trực quan theo trình tự thay vì tinh chỉnh nhiễu. |
Các mô hình khuếch tán vẫn là một lĩnh vực nghiên cứu tạo ảnh từ văn bản sôi nổi. Khảo sát năm 2023 Text-to-image Diffusion Models in Generative AI: A Survey cung cấp cái nhìn tổng quan hữu ích về các phương pháp tạo ảnh từ văn bản dựa trên khuếch tán, bộ dữ liệu, cách đánh giá và những ứng dụng liên quan.
Đầu vào đa phương thức
Đa phương thức mô tả các loại đầu vào mà một mô hình có thể sử dụng hơn là cách nó tạo ra hình ảnh. Một mô hình ảnh đa phương thức có thể nhận văn bản, hình ảnh và tài liệu tham chiếu để tạo dựa trên tham chiếu, chỉnh sửa hoặc giữ nhân vật cùng sản phẩm nhất quán xuyên suốt một loạt nội dung. Bên dưới, nó vẫn có thể dùng khuếch tán, sinh tự hồi quy hoặc phương pháp khác, vì vậy một mô hình có thể thuộc nhiều hơn một danh mục.
Những mô hình tạo ảnh từ văn bản tốt nhất vào năm 2026 là gì?
Trong hướng dẫn này, chúng tôi đã chọn bảy mô hình hiện tại đại diện cho các cách tiếp cận khác nhau đối với việc tạo hình ảnh, chỉnh sửa, sáng tạo dựa trên tham chiếu và sản xuất trực quan. Thứ tự không phải là một bảng xếp hạng.
Mô hình | Loại mô hình | Phù hợp nhất cho | Tính năng chính |
Mô hình tạo và chỉnh sửa hình ảnh với đầu vào đa phương thức | Sáng tạo dựa trên tham chiếu, hình ảnh sản phẩm, nhân vật và các chỉnh sửa chi tiết | Tạo từ văn bản hoặc hình ảnh, kết hợp các đặc điểm từ tối đa 10 nguồn tham chiếu, và hỗ trợ giữ nguyên chủ thể, chỉnh sửa chính xác, cùng kiểm soát phong cách. IMAGE 3.0 hỗ trợ tạo hình lên đến 2K, trong khi IMAGE 3.0 Omni cung cấp độ phân giải lên đến 4K. | |
Leonardo Lucid Origin | Mô hình tạo hình ảnh | Minh họa, concept art, mô phỏng sản phẩm và tạo hình ảnh tổng quát | Phủ rộng nhiều phong cách, tuân theo các yêu cầu chi tiết, tạo ra hình ảnh Full HD và hỗ trợ kết xuất văn bản dễ đọc. |
Seedream 5.0 Pro | Mô hình tạo và chỉnh sửa hình ảnh | Hình ảnh sản phẩm, đồ họa thông tin, tài sản thiết kế và chỉnh sửa cục bộ | Hoạt động từ văn bản hoặc hình ảnh, chấp nhận tham chiếu, hỗ trợ chỉnh sửa theo khu vực và xử lý đầu vào cùng đầu ra đa ngôn ngữ. |
Adobe Firefly Image 5 | Mô hình tạo và chỉnh sửa hình ảnh | Sản xuất thiết kế, tài sản marketing và các dự án dựa trên Adobe | Tạo từ văn bản, làm việc với hình ảnh tham chiếu và cho phép chỉnh sửa có mục tiêu trong Photoshop đồng thời giữ nguyên nội dung hình ảnh xung quanh. |
Krea 2 Large | Mô hình tạo hình ảnh | Tính chân thực như ảnh, công việc dẫn dắt phong cách và định hướng trực quan | Được tối ưu cho tính chân thực biểu cảm, với quá trình tạo dựa trên prompt và điều khiển được dẫn dắt bởi tham chiếu đối với bố cục, chủ thể và phong cách. |
Luma UNI-1.1 | Mô hình hình ảnh đa phương thức thống nhất | Tạo sinh được dẫn dắt bởi tham chiếu và chỉnh sửa hình ảnh | Kết hợp việc tạo hình ảnh với chỉnh sửa bằng ngôn ngữ tự nhiên và chấp nhận tối đa chín đầu vào tham chiếu trong một yêu cầu. |
Runway Gen-4 Image | Mô hình tạo hình ảnh trong một nền tảng hình ảnh và video | Phát triển nhân vật, thiết kế cảnh và các dự án sau đó chuyển sang video | Tạo từ văn bản và hình ảnh tham chiếu, sử dụng tối đa ba tham chiếu cho mỗi lần tạo, và có thể đưa nhân vật, đối tượng hoặc đặc điểm thị giác vào các cảnh mới. |
Phần tiếp theo so sánh các mô hình này về khả năng tuân theo prompt, xử lý tham chiếu, chỉnh sửa, tính nhất quán trực quan và kiểm soát phong cách.
Các mô hình chuyển văn bản thành hình ảnh so sánh như thế nào vào năm 2026?
Các mô hình chuyển văn bản thành hình ảnh khác nhau nhiều nhất ở độ chính xác của prompt, việc sử dụng tham chiếu, chỉnh sửa, tính nhất quán và kiểm soát phong cách. Những khác biệt này dễ nhận thấy hơn trong các dự án liên quan đến hình ảnh lặp lại, chỉnh sửa, sản phẩm hoặc nhân vật tái diễn.
Khu vực so sánh | Những gì cần so sánh | Vì sao điều này quan trọng |
Tuân thủ prompt | Đối tượng, thuộc tính, mối quan hệ giữa các vật thể, bố cục và các chi tiết bắt buộc. | Một hình ảnh được trau chuốt vẫn chưa đạt nếu bỏ lỡ bản tóm tắt yêu cầu. |
Xử lý tham chiếu | Số lượng tham chiếu, giữ nguyên chủ thể, chuyển phong cách và hướng dẫn bố cục. | Các tham chiếu giúp giữ cho một nhân vật, sản phẩm hoặc định hướng thị giác dễ nhận diện xuyên suốt các hình ảnh. |
Chỉnh sửa hình ảnh | Các thay đổi cục bộ, chỉnh sửa bằng ngôn ngữ tự nhiên và mức độ nguyên vẹn của các vùng không bị tác động. | Các chỉnh sửa chính xác tiết kiệm thời gian và tránh phải dựng lại hình ảnh từ đầu. |
Tính nhất quán thị giác | Nhân vật, sản phẩm, trang phục, phong cách và các chi tiết lặp lại xuyên suốt các hình ảnh hoặc phiên bản sửa đổi. | Các chi tiết ổn định rất quan trọng đối với chuỗi hình ảnh, chiến dịch, bảng phân cảnh và bộ sản phẩm. |
Kiểm soát phong cách | Ánh sáng, bảng màu, kết cấu, phong thái nhiếp ảnh, phong cách minh họa và định hướng thị giác. | Kiểm soát phong cách rõ ràng giúp các hình ảnh liên quan duy trì sự kết nối về mặt thị giác. |
Độ phù hợp với quy trình làm việc | Chỉnh sửa, các tùy chọn xuất, sử dụng hình ảnh thành video và khả năng tương thích với các công cụ sáng tạo khác. | Những gì diễn ra sau khi tạo ra có thể quan trọng không kém bức hình đầu tiên. |
Một mô hình hoạt động tốt cho các hình ảnh ý tưởng nhanh có thể không phù hợp với một bộ sản phẩm hoặc dự án nhân vật. Độ chính xác của prompt và phong cách có thể đủ cho một hình ảnh đơn lẻ, trong khi công việc lặp lại thường đòi hỏi các tài liệu tham chiếu mạnh mẽ hơn, khả năng chỉnh sửa và tính nhất quán.
Làm thế nào để chọn mô hình văn bản thành hình ảnh tốt nhất?
Khi chọn một trình tạo hình ảnh AI, hãy bắt đầu với những gì bạn muốn tạo ra và những chi tiết cần giữ nguyên khi bạn chỉnh sửa hình ảnh. Bảng dưới đây cho thấy bạn nên tìm kiếm điều gì trong một số tình huống phổ biến.
Nếu bạn cần | Hãy tìm | Vì sao điều này quan trọng |
Hình ảnh ý tưởng nhanh | Độ chính xác của prompt, chất lượng hình ảnh và phạm vi phong cách | Bạn có thể tiến gần hơn đến kết quả mong muốn với ít lần chỉnh sửa hơn. |
Nhân vật hoặc sản phẩm nhất quán | Xử lý tham chiếu và giữ lại chi tiết | Khuôn mặt, trang phục, sản phẩm và các đặc điểm nhận diện khác cần giữ được tính nhận dạng xuyên suốt các hình ảnh. |
Chỉnh sửa hình ảnh thường xuyên | Chỉnh sửa cục bộ và thay đổi bằng ngôn ngữ tự nhiên | Bạn có thể điều chỉnh một phần của hình ảnh mà không cần dựng lại toàn bộ cảnh. |
Tài sản chiến dịch hoặc chuỗi hình ảnh | Chủ thể, phong cách và bố cục ổn định | Các hình ảnh liên quan cần chia sẻ cùng định hướng thị giác. |
Hình ảnh sau đó chuyển thành video | Hình ảnh tham chiếu và các tùy chọn hình ảnh sang video | Chủ thể ổn định và các chi tiết thị giác dễ đưa vào chuyển động hơn. |
Tại sao Kling IMAGE 3.0 đáng để cân nhắc?
Kling IMAGE 3.0 cho phép bạn bắt đầu sáng tạo bằng một lời nhắc văn bản hoặc các hình ảnh tham chiếu, sau đó tinh chỉnh mọi chi tiết bằng ngôn ngữ tự nhiên. Vượt qua việc tạo nội dung tiêu chuẩn, nó mang đến cho bạn khả năng kiểm soát sâu đối với sự nhất quán của nhân vật, các chỉnh sửa chính xác và điều chỉnh phong cách, mở ra vô số khả năng sáng tạo.
Biến ý tưởng phức tạp thành hình ảnh mới mẻ
IMAGE 3.0 cho phép bạn hòa trộn các gợi ý thị giác từ nhiều nguồn tham chiếu và sử dụng ngôn ngữ đời thường để vượt qua các chỉnh sửa tiêu chuẩn. Kết hợp các chủ thể ở nhiều hình ảnh, đảo ngược góc nhìn của một cảnh, hoặc chuyển một khái niệm sang một phong cách hoàn toàn mới—tất cả trong khi giữ cho kết quả cuối cùng liền mạch và thống nhất.
Hình ảnh tham chiếu 1 | Hình ảnh tham chiếu 2 | Hình ảnh đầu ra |
Gợi ý: Hợp nhất các con vật từ ảnh 1 và ảnh 2. | ||
Giữ cho các nhân vật, sản phẩm và chi tiết chính dễ nhận biết
Bạn có thể sử dụng tối đa 10 hình ảnh tham chiếu trong một lần tạo. Các tài liệu tham chiếu khác nhau có thể xác định một nhân vật, trang phục, sản phẩm, bối cảnh hoặc phong cách trong khi lời nhắc của bạn giải thích cách các yếu tố đó kết hợp với nhau. Đối với việc chỉnh sửa chân dung, các tham chiếu khuôn mặt có thể giúp giữ lại những đặc điểm khuôn mặt dễ nhận biết trong khi bạn thay đổi kiểu tóc, trang phục, tư thế hoặc bối cảnh. Nếu bạn chỉ muốn hoán đổi một khuôn mặt vào một cảnh quay có sẵn, bạn cũng có thể đi thẳng vào quy trình hoán đổi khuôn mặt của Kling.
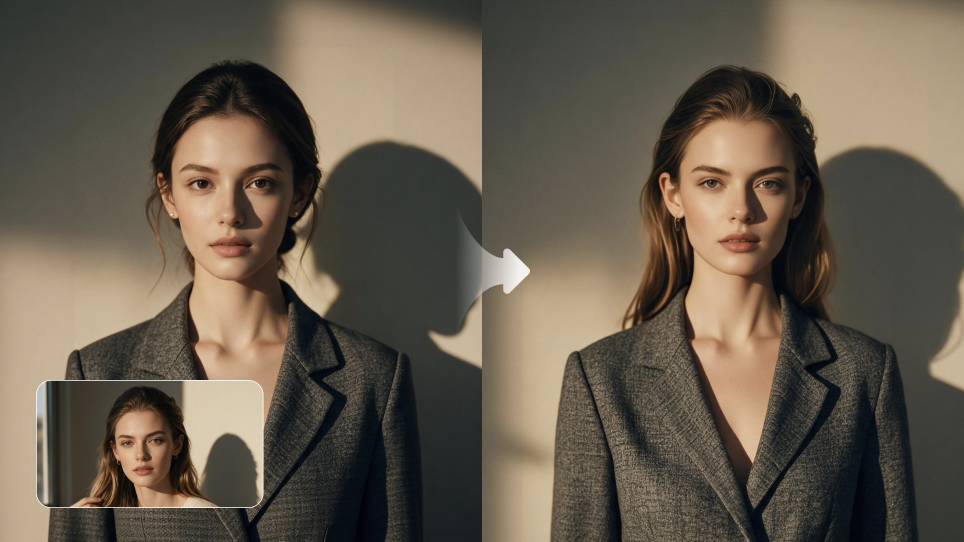
Chỉ thay đổi những gì cần thay đổi
Nếu phần lớn một hình ảnh đã trông ổn, bạn có thể sử dụng Kling IMAGE 3.0 như một trình chỉnh sửa ảnh AI để điều chỉnh các chi tiết cụ thể mà không cần xây dựng lại toàn bộ cảnh. Các hướng dẫn bằng ngôn ngữ tự nhiên có thể thay đổi kích thước, màu sắc, chất liệu, biểu cảm hoặc phông nền của một đối tượng đồng thời cố gắng giữ nguyên các phần xung quanh hình ảnh. Bạn cũng có thể sử dụng Kling AI như một trình xóa watermark cho những hình ảnh bạn sở hữu hoặc có quyền chỉnh sửa. Các chỉnh sửa khác bao gồm tô màu ảnh, hiệu ứng cổ điển, chỉnh sửa doodle, thay đổi ánh sáng và tông màu, cùng khôi phục hình ảnh.
Giữ phong cách và tông màu nhất quán trên các hình ảnh Nếu bạn đã có định hướng thị giác rõ ràng, bạn có thể sử dụng một hình ảnh hiện có làm tham chiếu phong cách. Kling IMAGE 3.0 có thể chuyển các yếu tố như nét vẽ, màu sắc, bố cục và tông màu sang các hình ảnh mới. Điều này hoạt động hiệu quả với các bộ minh họa, hình ảnh sản phẩm hoặc nội dung thương hiệu, nơi cùng một phong cách cần xuất hiện trên nhiều hình ảnh.
Hình ảnh tham chiếu 1 | Hình ảnh tham chiếu 2 | Hình ảnh đầu ra |
Gợi ý: Thay đổi phong cách của Hình ảnh 1 thành phong cách của Hình ảnh 2 | ||
Kết thúc
Các mô hình chuyển văn bản thành hình ảnh khác nhau ở những gì chúng làm tốt nhất, vì vậy lựa chọn đúng phụ thuộc vào những gì bạn cần sau khi hình ảnh đầu tiên được tạo ra. Nếu bạn chỉ cần một ý tưởng nhanh, độ chính xác của prompt và chất lượng hình ảnh có thể là đủ. Đối với hình ảnh sản phẩm, nhân vật lặp lại hoặc loạt hình, các yếu tố tham chiếu, chỉnh sửa và tính nhất quán quan trọng hơn. Nếu bạn muốn bắt đầu từ văn bản hoặc hình ảnh sẵn có, Kling IMAGE 3.0 cho phép bạn kết hợp các tham chiếu, thay đổi các chi tiết cụ thể và giữ nguyên phong cách đó trong những hình ảnh mới. Cho dù bạn đang xây dựng một chiến dịch sản phẩm, phát triển một nhân vật lặp lại hay biến một ý tưởng sơ khai thành bộ hình ảnh hoàn chỉnh, mô hình phù hợp sẽ giúp bạn dễ dàng giữ lại những chi tiết bạn quan tâm khi dự án phát triển.
Câu hỏi thường gặp
Mô hình ngôn ngữ AI nào được sử dụng để tạo văn bản thành hình ảnh?
Không có mô hình ngôn ngữ nào được tất cả các hệ thống chuyển văn bản thành hình ảnh sử dụng. Nếu bạn hỏi mô hình ngôn ngữ AI nào được dùng cho khả năng tạo hình ảnh từ văn bản, thì câu trả lời thay đổi tùy vào từng mô hình. Một số hệ thống sử dụng bộ mã hóa văn bản như CLIP hoặc T5, trong khi những hệ thống khác dùng các thành phần ngôn ngữ hoặc ngôn ngữ-thị giác để đọc lời nhắc trước khi hình ảnh được tạo ra.
Những AI nào có thể chuyển văn bản thành hình ảnh?
Nhiều mô hình hình ảnh AI có thể chuyển một lời nhắc bằng văn bản thành hình ảnh hoàn chỉnh, bao gồm Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 và Runway Gen-4 Image. Mỗi mô hình xử lý lời nhắc, hình ảnh tham chiếu, chỉnh sửa và sự nhất quán thị giác theo cách khác nhau, vì vậy lựa chọn phù hợp phụ thuộc vào loại hình ảnh bạn cần tạo.
Các mô hình chuyển văn bản thành hình ảnh có thể sử dụng hình ảnh tham chiếu không?
Đúng vậy. Nhiều mô hình tạo hình ảnh từ văn bản có thể sử dụng hình ảnh tham chiếu cùng với các lời nhắc bằng văn bản, điều này khiến AI chuyển đổi hình ảnh thành hình ảnh trở nên hữu ích khi bạn muốn làm việc dựa trên hình ảnh có sẵn thay vì bắt đầu từ đầu. Hình ảnh tham chiếu có thể xác định các chi tiết như nhân vật, sản phẩm, tư thế, bố cục, màu sắc hoặc phong cách, trong khi lời nhắc cho mô hình biết cần thay đổi điều gì. Kling IMAGE 3.0 có thể sử dụng tối đa 10 hình ảnh tham chiếu trong một lần tạo, điều này hữu ích khi cần giữ cho cùng một nhân vật, sản phẩm hoặc phong cách hình ảnh dễ nhận diện.
Làm cách nào để tôi xóa nền khỏi một hình ảnh?
Nếu bạn cần một ảnh chụp sản phẩm gọn gàng hơn, ảnh hồ sơ hoặc tài nguyên thiết kế, bạn có thể xóa nền khỏi một hình ảnh và giữ cho chủ thể chính được tách riêng. Nền trong suốt hoạt động tốt cho danh sách sản phẩm, bài thuyết trình, bài đăng mạng xã hội hoặc bố cục nơi chủ thể cần đặt trên phông nền khác. Sau khi xóa, hãy kiểm tra các mép chi tiết quanh tóc, quần áo, lông hoặc các vật nhỏ, sau đó giữ nền trong suốt, chuyển sang màu đồng nhất hoặc đặt chủ thể vào khung cảnh mới.