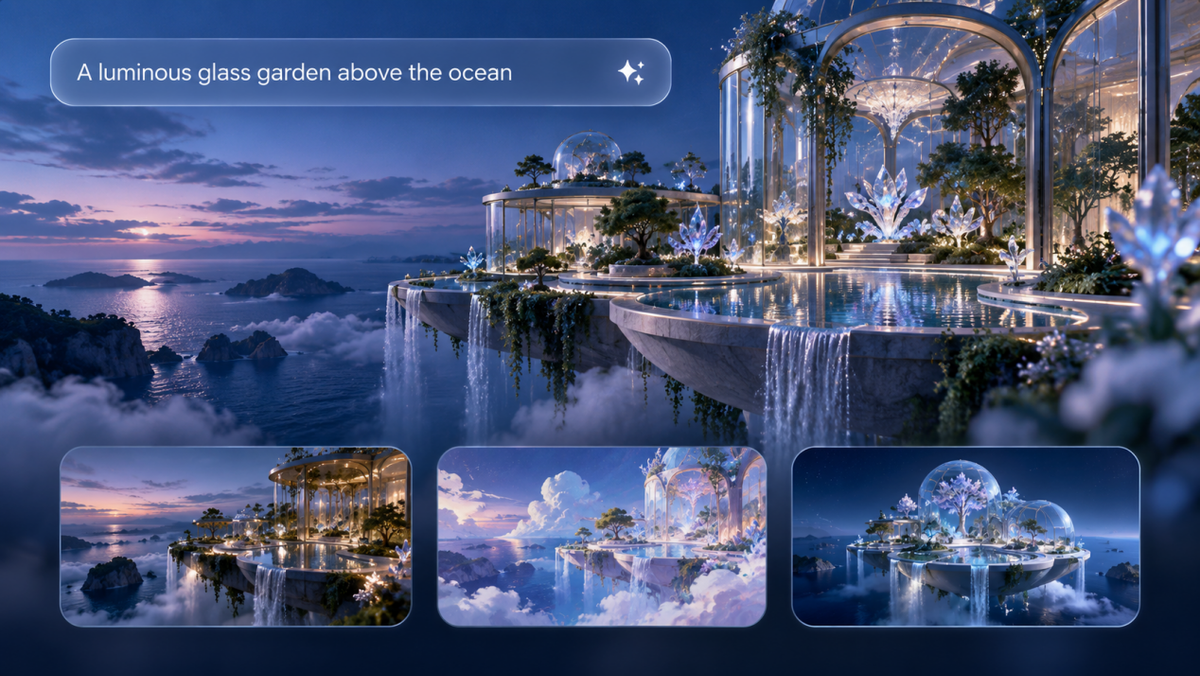
Avec une simple idée ou description, les modèles texte-image peuvent transformer le langage naturel en concepts visuels. Pour les créateurs, les meilleurs modèles texte-image vont au-delà de la simple génération d’images. Ils doivent comprendre des prompts complexes, préserver la cohérence visuelle et soutenir l’affinage créatif dans le temps. Ce guide explique comment fonctionnent les modèles texte-image, compare les capacités qui comptent le plus et explore comment Kling IMAGE 3.0 combine création basée sur des références, édition précise et flux de travail flexibles pour aider les créateurs à donner vie à leurs idées visuelles.
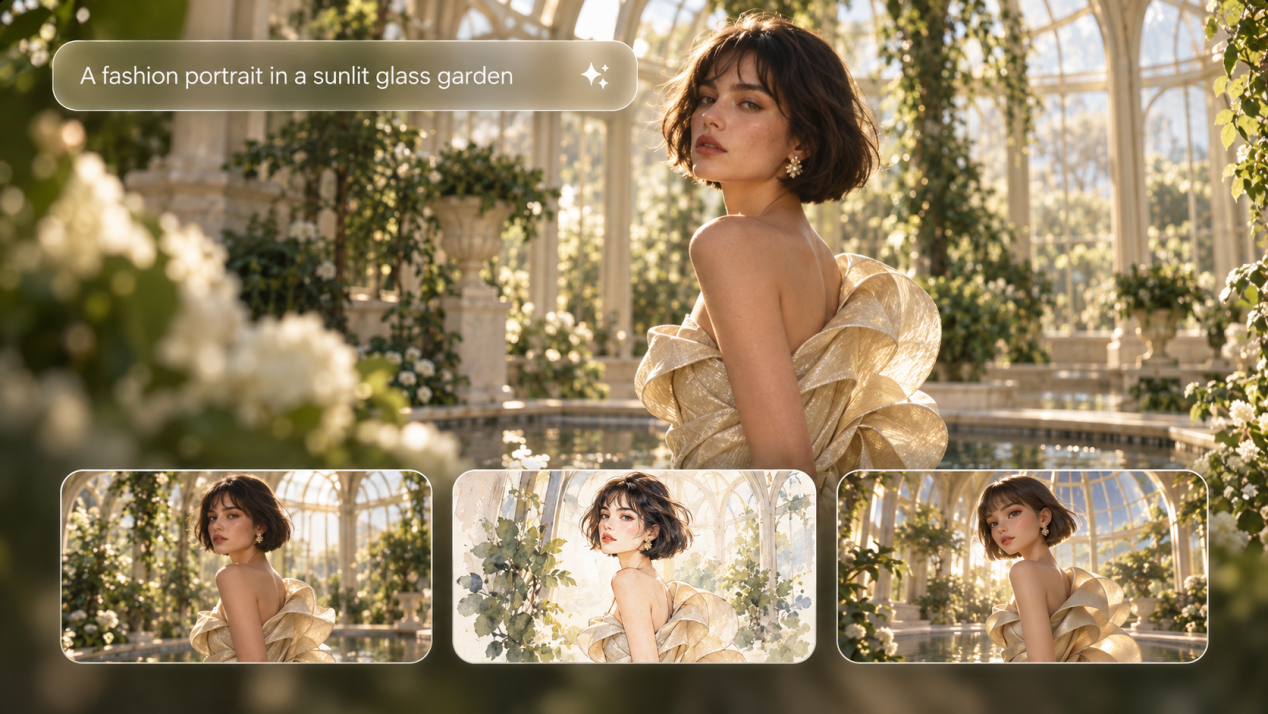
Qu’est-ce qu’un modèle texte-image ?
Un modèle texte-image est un type de système d’intelligence artificielle qui convertit des prompts en langage naturel en images numériques à partir des détails décrits dans le prompt.
Les systèmes modernes de conversion texte-vers-image combinent généralement un composant qui comprend ou encode l'invite avec un composant de génération d'images qui transforme ces instructions en contenu visuel. Certains modèles peuvent également travailler avec des images et d'autres références visuelles, ce qui les aide à suivre des invites complexes, à préserver les détails importants et à prendre en charge des retouches plus précises.
Par exemple, prenons une invite :
| Invite : Un appareil photo vintage posé sur un bureau en bois, baigné par la douce lumière du matin. |
Le modèle doit comprendre l'objet, le matériau, la disposition spatiale, l'éclairage et le style visuel global avant de produire l'image correspondante.
Aujourd'hui, l'évaluation des modèles texte-vers-image ne se limite pas à la qualité de l'image. L'accent s'est déplacé vers une compréhension fidèle des invites, la gestion de scènes complexes, le maintien de la cohérence visuelle et la prise en charge d'une édition flexible.
Comment fonctionnent les modèles texte-vers-image ?
Les modèles de conversion texte-image traduisent des descriptions écrites en contenu visuel en apprenant comment le langage se rapporte aux objets, aux styles, aux compositions et à d'autres détails. De nombreux systèmes modernes utilisent des méthodes basées sur la diffusion, le prompt guidant un processus étape par étape qui transforme progressivement le bruit visuel en une image finale.
Le processus peut être compris en trois étapes:
1.Apprendre comment le texte se relie aux images
Avant de générer des images, un modèle texte-image apprend à partir de vastes jeux de données contenant des images associées à des descriptions. Pendant l'entraînement, il identifie des correspondances entre les mots et les détails visuels, y compris les objets, les couleurs, les formes, les styles et les relations spatiales. Par exemple, le modèle apprend comment des concepts tels que « appareil photo vintage », « bureau en bois » et « douce lumière matinale » sont associés à des caractéristiques visuelles spécifiques.
2.Comprendre le prompt
Lorsque vous saisissez une instruction, le système traduit votre texte dans un format qu'il peut comprendre, en capturant le sens et le contexte fondamentaux. Bien que la technologie exacte varie selon le modèle — et que les systèmes commerciaux gardent souvent leur architecture complète sous le manteau — ces composants texte et vision travaillent ensemble pour faire le lien entre vos mots et le rendu visuel final.
3.Génération de l'image
De nombreux modèles modernes de texte vers image utilisent des méthodes de diffusion, bien que d'autres modèles puissent recourir à des approches autorégressives ou à différentes approches de génération. Dans les systèmes basés sur la diffusion, le processus commence par un bruit visuel et élimine progressivement ce bruit en fonction des informations fournies par le prompt. Grâce à des étapes de débruitage répétées, l'image développe des formes, des détails et des styles plus nets qui correspondent à la description. Certains systèmes effectuent ce processus dans un espace latent compressé avant de convertir le résultat en image finale. Une fois l'image formée, des ajustements supplémentaires peuvent être apportés pour affiner les détails ou la préparer à l'édition.
Qu'est-ce qui distingue les modèles texte-vers-image ?
Les modèles texte-vers-image peuvent répondre de manière très différente au même prompt. Une partie de cette variation provient de la façon dont les images sont générées, tandis qu'une autre vient des types d'entrées que le modèle peut lire et utiliser.
Architecture de génération
Au niveau de la génération, deux approches courantes sont la diffusion et la génération autorégressive.
Approche | Fonctionnement | Utilisations courantes |
Modèles de diffusion | Commencez par un bruit visuel et affinez-le progressivement en une image guidée par l'invite. | Génération d'images détaillées, scènes réalistes, illustration et travail axé sur le style. |
Modèles autorégressifs | Construisez une image en prédisant des jetons ou éléments visuels de manière séquentielle. | La génération d'images qui construit le contenu visuel en séquence plutôt que d'affiner le bruit. |
Les modèles de diffusion restent un domaine actif de recherche texte-vers-image. L'enquête 2023 Text-to-image Diffusion Models in Generative AI: A Survey offre un aperçu utile des méthodes texte-vers-image basées sur la diffusion, des jeux de données, des approches d'évaluation et des applications connexes.
Entrées multimodales
Multimodal décrit les types d'entrée qu'un modèle peut utiliser plutôt que la manière dont il génère une image. Un modèle d'image multimodal peut prendre du texte, des images et des références visuelles pour une création basée sur des références, de l'édition ou pour maintenir des personnages et des produits cohérents sur une série. En dessous, il peut toujours utiliser la diffusion, la génération autorégressive ou une autre méthode, de sorte qu'un modèle peut appartenir à plus d'une catégorie.
Quels sont les meilleurs modèles texte-vers-image en 2026 ?
Pour ce guide, nous avons sélectionné sept modèles actuels qui représentent différentes approches de la génération d'images, de l'édition, de la création basée sur des références et de la production visuelle. L'ordre n'est pas un classement.
Modèle | Type de modèle | Idéal pour | Fonctionnalités clés |
Modèle de génération et d'édition d'images avec des entrées multimodales | Création basée sur des références, visuels de produits, personnages et retouches détaillées | Génère à partir de texte ou d'images, combine des caractéristiques issues de jusqu'à 10 références et prend en charge la conservation du sujet, les retouches précises et le contrôle du style. IMAGE 3.0 prend en charge une génération allant jusqu'à 2K, tandis que IMAGE 3.0 Omni offre jusqu'à 4K. | |
Leonardo Lucid Origin | Modèle de génération d'images | Illustration, concept art, maquettes de produits et création d'images générale | Couvre un large éventail de styles, suit des invites détaillées, produit des images Full HD et prend en charge le rendu de texte lisible. |
Seedream 5.0 Pro | Modèle de génération et d'édition d'images | Visuels produits, infographies, ressources de conception et retouches localisées | Fonctionne à partir de texte ou d'images, accepte des références, prend en charge l'édition régionale et gère l'entrée et la génération multilingues. |
Adobe Firefly Image 5 | Modèle de génération et d'édition d'images | Production de design, ressources marketing et projets basés sur Adobe | Génère à partir de texte, fonctionne avec des images de référence et permet des retouches ciblées dans Photoshop tout en laissant le contenu de l'image environnante intact. |
Krea 2 Large | Modèle de génération d'images | Photoréalisme, travail guidé par le style et direction visuelle | Optimisé pour un photoréalisme expressif, avec une création basée sur des prompts et un contrôle guidé par des références sur la composition, le sujet et le style. |
Luma UNI-1.1 | Modèle d'image multimodal unifié | Génération guidée par des références et révision d'image | Combine la génération d'images avec l'édition en langage naturel et accepte jusqu'à neuf références en entrée par requête. |
Runway Gen-4 Image | Modèle de génération d'images au sein d'une plateforme d'images et de vidéos | Développement de personnages, conception de scènes et projets qui passent ensuite à la vidéo | Génère à partir de texte et d'images de référence, utilise jusqu'à trois références par génération et peut reprendre des personnages, des objets ou des caractéristiques visuelles dans de nouvelles scènes. |
La section suivante compare ces modèles sur le suivi des instructions, la gestion des références, l'édition, la cohérence visuelle et le contrôle du style.
Comment les modèles texte-vers-image se comparent-ils en 2026 ?
Les modèles texte-vers-image diffèrent surtout en précision des instructions, utilisation des références, édition, cohérence et contrôle du style. Ces différences sont plus faciles à remarquer dans les projets qui impliquent des images répétées, des révisions, des produits ou des personnages récurrents.
Zone de comparaison | Ce qu'il faut comparer | Pourquoi c'est important |
Respect du prompt | Sujets, attributs, relations entre objets, composition et détails requis. | Une image soignée reste insuffisante si elle ne respecte pas le cahier des charges. |
Gestion des références | Nombre de références, conservation du sujet, transfert de style et indications de composition. | Les références aident à maintenir un personnage, un produit ou une direction visuelle reconnaissable à travers les images. |
Retouche d'image | Modifications locales, retouches en langage naturel et mesure dans laquelle les zones non touchées restent intactes. | Des retouches précises font gagner du temps et évitent de reconstruire l'image à partir de zéro. |
Cohérence visuelle | Personnages, produits, vêtements, style et détails récurrents à travers les images ou les révisions. | Les détails stables sont importants pour les séries d'images, les campagnes, les storyboards et les ensembles de produits. |
Contrôle du style | Éclairage, palette, texture, rendu photographique, style d'illustration et direction visuelle. | Un contrôle clair du style contribue à maintenir la cohérence visuelle des images liées. |
Adaptation au flux de travail | Révisions, options d'exportation, utilisation image-vers-vidéo et compatibilité avec d'autres outils créatifs. | Ce qui se passe après la génération peut être tout aussi important que la première image. |
Un modèle qui fonctionne bien pour des images conceptuelles rapides peut ne pas convenir à une série de produits ou à un projet de personnage. La précision du prompt et le style peuvent suffire pour une image unique, tandis que les travaux répétitifs nécessitent souvent des références plus solides, des retouches et de la cohérence.
Comment choisir le meilleur modèle texte-vers-image ?
Lors du choix d'un générateur d'images IA, commencez par ce que vous souhaitez créer et quels détails doivent rester inchangés lorsque vous modifiez l'image. Le tableau ci-dessous indique ce qu'il faut rechercher dans plusieurs scénarios courants.
Si vous avez besoin | Ce qu'il faut rechercher | Pourquoi c'est important |
Images conceptuelles rapides | Précision des prompts, qualité d'image et diversité des styles | Vous pouvez vous rapprocher davantage du résultat souhaité avec moins de révisions. |
Personnages ou produits cohérents | Gestion des références et conservation des détails | Les visages, les vêtements, les produits et les autres caractéristiques déterminantes doivent rester reconnaissables d'une image à l'autre. |
Révisions d'images fréquentes | Modifications locales et changements en langage naturel | Vous pouvez ajuster une partie de l'image sans reconstruire toute la scène. |
Ressources de campagne ou séries d'images | Sujets, style et composition stables | Les images connexes doivent partager la même direction visuelle. |
Images qui passent ensuite en vidéo | Images de référence et options d'image vers vidéo | Des sujets stables et des détails visuels sont plus faciles à transposer en mouvement. |
Pourquoi Kling IMAGE 3.0 mérite-t-il d'être envisagé ?
Kling IMAGE 3.0 vous permet de lancer des créations à partir d'une invite textuelle ou d'images de référence, puis d'affiner chaque détail à l'aide du langage naturel. Au-delà de la génération standard, il vous offre un contrôle approfondi de la cohérence des personnages, des retouches précises et de l'ajustement du style, ouvrant un champ infini de possibilités créatives.
Transformez des idées complexes en visuels inédits
IMAGE 3.0 vous permet de combiner des indices visuels provenant de plusieurs références et d'utiliser un langage courant pour aller au-delà des retouches standard. Combinez des sujets provenant de plusieurs images, renversez la perspective d'une scène ou transformez un concept dans un style totalement nouveau, tout en conservant un résultat final fluide et cohérent.
Image de référence 1 | Image de référence 2 | Image de sortie |
Invite : Fusionnez les animaux de l'image 1 et de l'image 2. | ||
Conservez les personnages, les produits et les détails clés reconnaissables
Vous pouvez utiliser jusqu'à 10 images de référence au cours d'une génération. Des références différentes peuvent définir un personnage, des vêtements, un produit, un décor ou un style tandis que votre prompt explique comment ces éléments doivent s'assembler. Pour les retouches de portrait, des références de visage peuvent aider à préserver des traits faciaux reconnaissables tout en changeant la coiffure, la tenue, la pose ou le décor. Si vous souhaitez simplement échanger un visage dans une prise de vue existante, vous pouvez également passer directement aux workflows face swap de Kling.
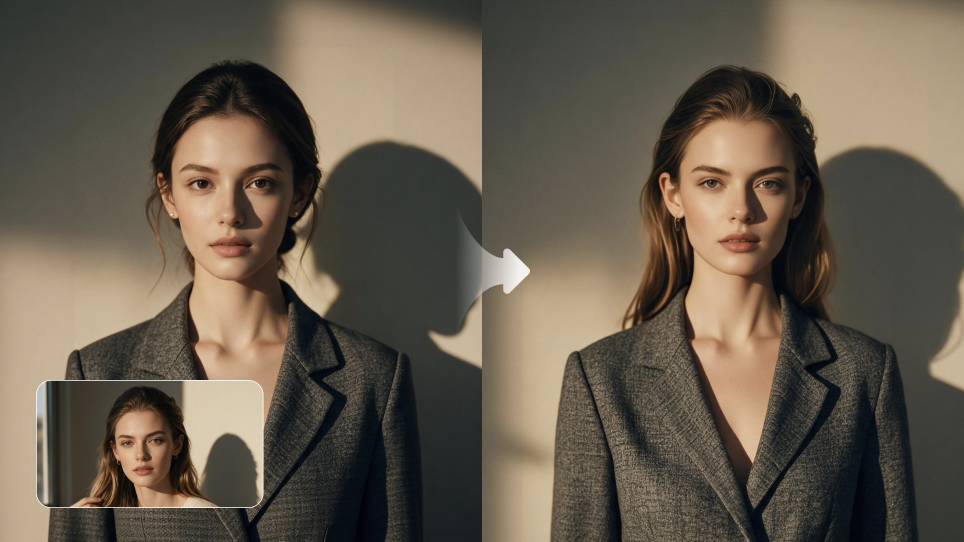
Ne changez que ce qui doit changer
Si la majeure partie d'une image est déjà correcte, vous pouvez utiliser Kling IMAGE 3.0 comme éditeur photo IA pour ajuster des détails spécifiques sans reconstruire toute la scène. Des instructions en langage naturel peuvent modifier la taille, la couleur, le matériau, l'expression ou l'arrière-plan d'un objet tout en préservant les parties environnantes de l'image. Vous pouvez également utiliser Kling AI comme outil de suppression de filigrane pour les images que vous possédez ou que vous avez l'autorisation de modifier. D'autres retouches incluent la colorisation de photos, des effets vintage, des modifications de gribouillis, des ajustements d'éclairage et de tonalité, ainsi que la restauration d'images.
Maintenez un style et une tonalité cohérents sur toutes les images Si vous disposez déjà d'une direction visuelle claire, vous pouvez utiliser une image existante comme référence de style. Kling IMAGE 3.0 peut transférer dans de nouvelles images des éléments tels que les coups de pinceau, la couleur, la composition et la tonalité. Cela fonctionne bien pour des ensembles d'illustrations, des visuels de produits ou du contenu de marque lorsque le même aspect doit apparaître sur plus d'une image.
Image de référence 1 | Image de référence 2 | Image de sortie |
Invite : Modifiez le style de l’image 1 pour qu’il corresponde à celui de l’image 2 | ||
Fin
Les modèles de conversion texte en image diffèrent par leurs points forts, donc le bon choix dépend de ce dont vous avez besoin après la génération de la première image. Si vous avez seulement besoin d’un concept rapide, la précision du prompt et la qualité de l’image peuvent suffire. Pour des visuels de produits, des personnages récurrents ou des séries d’images, les références, la retouche et la cohérence comptent davantage. Si vous souhaitez partir d’un texte ou de visuels existants, Kling IMAGE 3.0 vous permet de combiner des références, de modifier des détails spécifiques et de conserver le même rendu dans de nouvelles images. Que vous construisiez une campagne produit, développiez un personnage récurrent ou transformiez un concept précoce en un ensemble visuel abouti, le bon modèle devrait faciliter la conservation des détails qui comptent pour vous à mesure que le projet prend de l’ampleur.
FAQ
Quel modèle linguistique d’IA est utilisé pour la création texte en image ?
Aucun modèle linguistique unique n'est utilisé par tous les systèmes de texte en image. Si vous demandez quel modèle de langage d'IA est utilisé pour les capacités de création texte-vers-image, la réponse varie selon le modèle. Certains systèmes utilisent des encodeurs de texte tels que CLIP ou T5, tandis que d'autres utilisent des composants langage ou vision-langage pour lire l'invite avant que l'image ne soit générée.
Quelle IA peut transformer du texte en image ?
De nombreux modèles d'image IA peuvent transformer une invite écrite en image finalisée, y compris Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 et Runway Gen-4 Image. Chacun gère différemment les invites, les références, les retouches et la cohérence visuelle, de sorte que le bon modèle dépend du type d'image que vous devez créer.
Les modèles texte-vers-image peuvent-ils utiliser des images de référence ?
Oui. De nombreux modèles texte-vers-image peuvent utiliser des images de référence en plus d'invites écrites, ce qui rend IA image-à-image utile lorsque vous souhaitez travailler à partir d'un visuel existant plutôt que de repartir de zéro. La référence peut fixer des détails tels que le personnage, le produit, la pose, la composition, les couleurs ou le style, tandis que l'invite indique au modèle ce qu'il doit modifier. Kling IMAGE 3.0 peut utiliser jusqu'à 10 images de référence en une génération, ce qui est utile lorsque le même personnage, produit ou style visuel doit rester reconnaissable.
Comment supprimer l'arrière-plan d'une image ?
Si vous avez besoin d’une photo produit plus nette, d’une image de profil ou d’une ressource de conception, vous pouvez supprimer l’arrière-plan d’une image et garder le sujet principal isolé. Un arrière-plan transparent fonctionne bien pour les fiches produit, les présentations, les publications sociales ou les mises en page où le sujet doit être placé sur un autre décor. Après la suppression, vérifiez les bords fins autour des cheveux, des vêtements, de la fourrure ou de petits objets, puis gardez l’arrière-plan transparent, passez à une couleur unie ou placez le sujet dans une nouvelle scène.