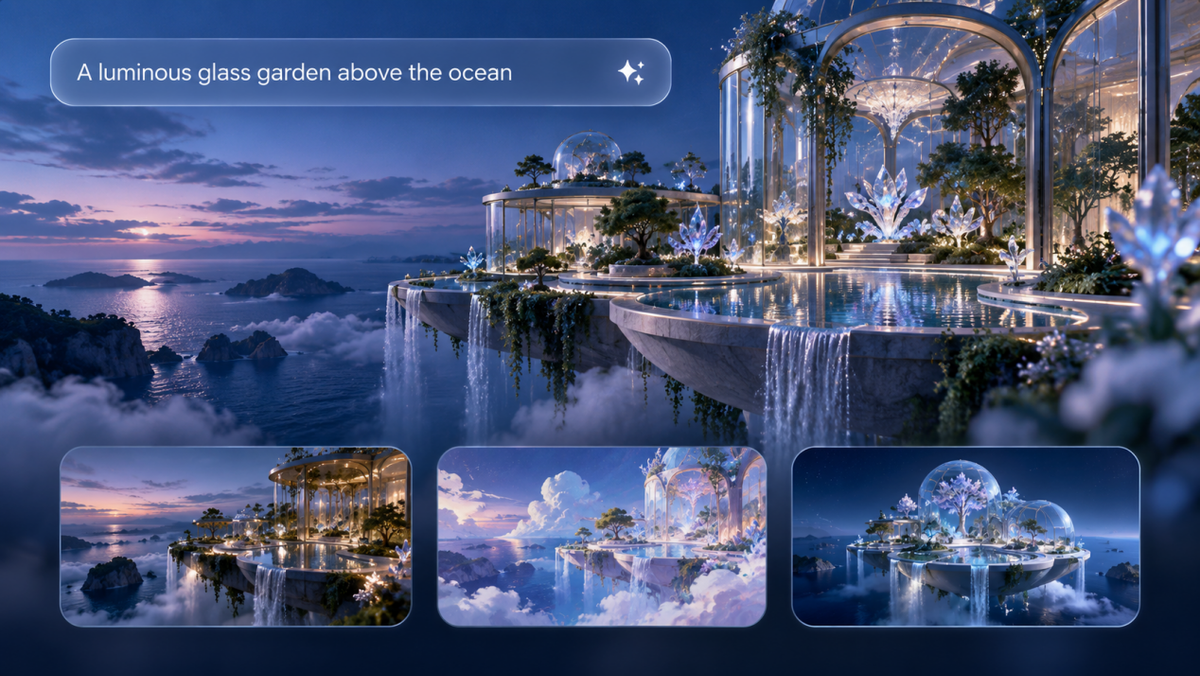
सिर्फ एक विचार या सरल विवरण से, टेक्स्ट-टू-इमेज मॉडल प्राकृतिक भाषा को दृश्य अवधारणाओं में बदल सकते हैं। क्रिएटर्स के लिए, सर्वश्रेष्ठ टेक्स्ट-टू-इमेज मॉडल सिर्फ इमेज जनरेशन से आगे जाते हैं। उन्हें जटिल प्रोम्प्ट्स को समझना, दृश्य स्थिरता बनाए रखना और समय के साथ रचनात्मक परिष्करण का समर्थन करना आवश्यक है। यह मार्गदर्शिका बताती है कि टेक्स्ट-टू-इमेज मॉडल कैसे काम करते हैं, उन क्षमताओं की तुलना करती है जो सबसे महत्वपूर्ण हैं, और दर्शाती है कि Kling IMAGE 3.0 किस तरह संदर्भ-आधारित निर्माण, सटीक संपादन और लचीले वर्कफ़्लोज़ को संयोजित करके क्रिएटर्स को अपनी दृश्य कल्पनाओं को जीवन में लाने में मदद करता है।
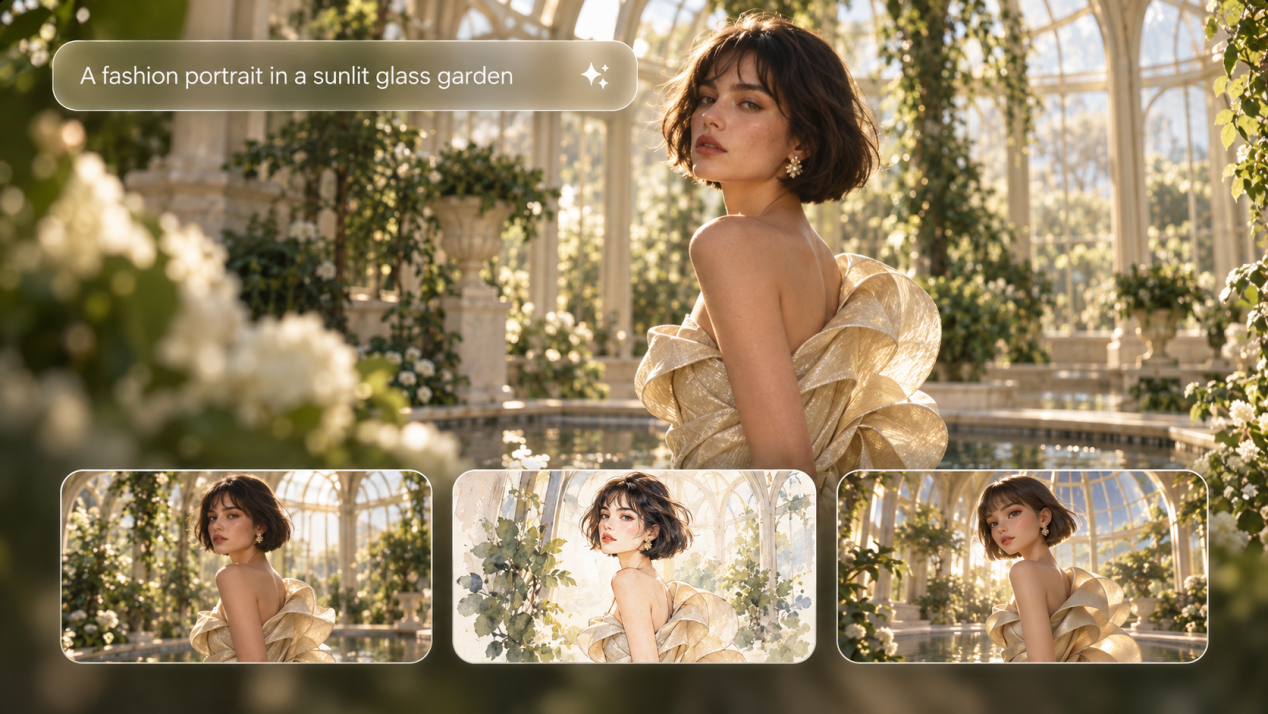
टेक्स्ट-टू-इमेज मॉडल्स क्या हैं?
एक टेक्स्ट-टू-इमेज मॉडल कृत्रिम बुद्धिमत्ता प्रणाली का प्रकार है जो प्रोम्प्ट में वर्णित विवरणों के आधार पर प्राकृतिक भाषा प्रोम्प्ट्स को डिजिटल छवियों में परिवर्तित करता है।
आधुनिक टेक्स्ट-टू-इमेज सिस्टम आम तौर पर एक ऐसे घटक को मिलाते हैं जो प्रॉम्प्ट को समझता या एन्कोड करता है, और एक इमेज-जनरेशन घटक जो उन निर्देशों को दृश्य सामग्री में बदल देता है। कुछ मॉडल छवियों और अन्य दृश्य संदर्भों के साथ भी काम कर सकते हैं, जिससे उन्हें जटिल प्रॉम्प्ट का पालन करने, महत्वपूर्ण विवरणों को संरक्षित रखने और अधिक सटीक संपादन को समर्थन देने में सहायता मिलती है।
उदाहरण के लिए, एक प्रॉम्प्ट पर विचार करें:
| प्रॉम्प्ट: एक लकड़ी की मेज़ पर रखा हुआ विंटेज कैमरा, जिस पर हल्की सुबह की रोशनी दृश्य पर फैल रही है। |
संबंधित छवि बनाने से पहले मॉडल को वस्तु, सामग्री, स्थानिक व्यवस्था, प्रकाश और समग्र दृश्य शैली को समझने की आवश्यकता होती है।
आज, टेक्स्ट-टू-इमेज मॉडलों का मूल्यांकन केवल छवि गुणवत्ता से अधिक है। ध्यान सटीक प्रॉम्प्ट समझ, जटिल दृश्यों को संभालने, दृश्य संगति बनाए रखने और लचीले संपादन का समर्थन करने की ओर स्थानांतरित हो गया है।
टेक्स्ट-टू-इमेज मॉडल कैसे काम करते हैं?
टेक्स्ट-टू-इमेज मॉडल यह सीखकर कि भाषा वस्तुओं, शैलियों, संरचनाओं और अन्य विवरणों से कैसे संबंधित होती है, लिखित विवरणों को दृश्य सामग्री में अनुवादित करते हैं। कई आधुनिक सिस्टम प्रसरण-आधारित तरीकों का उपयोग करते हैं, जहाँ प्रॉम्प्ट एक चरण-दर-चरण प्रक्रिया का मार्गदर्शन करता है जो धीरे-धीरे दृश्य शोर को एक तैयार चित्र में बदल देता है।
इस प्रक्रिया को तीन चरणों में समझा जा सकता है:
1.यह सीखना कि पाठ चित्रों से कैसे जुड़ता है
छवियाँ बनाने से पहले, एक टेक्स्ट-टू-इमेज मॉडल विवरणों के साथ जोड़ी गई छवियों वाले बड़े डेटासेट से सीखता है। प्रशिक्षण के दौरान, यह शब्दों और दृश्य विवरणों के बीच पैटर्न पहचानता है, जिनमें वस्तुएँ, रंग, आकार, शैलियाँ और स्थानिक संबंध शामिल होते हैं। उदाहरण के लिए, मॉडल यह सीखता है कि “विंटेज कैमरा,” “लकड़ी की डेस्क,” और “मुलायम सुबह की रोशनी” जैसे अवधारणाएँ विशिष्ट दृश्य गुणों से कैसे जुड़ी होती हैं।
2.प्रॉम्प्ट को समझना
जब आप कोई प्रॉम्प्ट दर्ज करते हैं, तो सिस्टम आपके पाठ को ऐसे प्रारूप में अनुवादित करता है जिसे वह समझ सके, और मुख्य अर्थ तथा संदर्भ को कैद करता है। हालांकि सटीक तकनीक मॉडल के अनुसार भिन्न होती है—और व्यावसायिक प्रणालियाँ अक्सर अपनी पूरी संरचना को गुप्त रखती हैं—ये पाठ और विज़न घटक मिलकर आपके शब्दों को अंतिम दृश्य आउटपुट से जोड़ते हैं।
3. छवि उत्पन्न करना
कई आधुनिक टेक्स्ट-टू-इमेज मॉडल डिफ्यूजन विधियों का उपयोग करते हैं, हालांकि अन्य मॉडल ऑटोरेग्रेसिव या अलग जनरेशन दृष्टिकोण अपना सकते हैं। डिफ्यूजन-आधारित प्रणालियों में, प्रक्रिया विज़ुअल शोर से शुरू होती है और प्रॉम्प्ट द्वारा प्रदान की गई जानकारी के आधार पर धीरे-धीरे उस शोर को हटाती है। बार-बार डिनॉइज़िंग चरणों के माध्यम से, छवि स्पष्ट आकार, विवरण, और शैलियाँ विकसित करती है जो विवरण से मेल खाती हैं। कुछ प्रणालियाँ इस प्रक्रिया को संकुचित लेटेंट स्पेस में पूरा करती हैं, इससे पहले कि परिणाम को अंतिम छवि में परिवर्तित किया जाए। छवि बनने के बाद, विवरण को परिष्कृत करने या संपादन के लिए तैयार करने के लिए आगे समायोजन किए जा सकते हैं।
टेक्स्ट-टू-इमेज मॉडल अलग क्यों होते हैं?
टेक्स्ट-टू-इमेज मॉडल एक ही प्रॉम्प्ट पर बहुत अलग प्रतिक्रिया दे सकते हैं। इसका कुछ भाग इस बात से आता है कि छवियाँ कैसे उत्पन्न की जाती हैं, जबकि कुछ भाग उन इनपुट के प्रकारों से आता है जिन्हें मॉडल पढ़ और उपयोग कर सकता है।
जनरेशन आर्किटेक्चर
जनरेशन स्तर पर, दो सामान्य तरीकों में डिफ्यूज़न और ऑटोरिग्रेसिव जनरेशन शामिल हैं।
दृष्टिकोण | यह कैसे काम करता है | सामान्य उपयोग |
डिफ्यूज़न मॉडल | दृश्य शोर से शुरू करें और प्रॉम्प्ट के मार्गदर्शन से धीरे-धीरे उसे एक छवि में परिष्कृत करें। | विस्तृत छवि निर्माण, यथार्थवादी दृश्य, चित्रण और शैली-चालित कार्य। |
ऑटोरिग्रेसिव मॉडल | दृश्य टोकन या तत्वों का क्रमवार पूर्वानुमान लगाकर एक छवि तैयार करें। | शोर को परिष्कृत करने के बजाय अनुक्रम में दृश्य सामग्री तैयार करने वाला छवि निर्माण। |
डिफ्यूजन मॉडल टेक्स्ट-टू-इमेज शोध का एक सक्रिय क्षेत्र बने हुए हैं। 2023 का सर्वेक्षण Text-to-image Diffusion Models in Generative AI: A Survey डिफ्यूजन-आधारित टेक्स्ट-टू-इमेज विधियों, डेटासेट, मूल्यांकन दृष्टिकोणों और संबंधित अनुप्रयोगों का एक उपयोगी अवलोकन प्रदान करता है।
मल्टीमोडल इनपुट
मल्टीमोडल उस इनपुट के प्रकारों का वर्णन करता है जिन्हें कोई मॉडल उपयोग कर सकता है, न कि वह छवि कैसे बनाता है। एक मल्टीमोडल इमेज मॉडल संदर्भ-आधारित निर्माण, संपादन या किसी श्रृंखला में पात्रों और उत्पादों को सुसंगत बनाए रखने के लिए पाठ, छवियाँ और दृश्य संदर्भ ले सकता है। भीतर से, यह अब भी डिफ्यूजन, ऑटोरिग्रेसिव जनरेशन या किसी अन्य विधि का उपयोग कर सकता है, इसलिए एक मॉडल एक से अधिक श्रेणियों में आ सकता है।
2026 में सर्वश्रेष्ठ टेक्स्ट-टू-इमेज मॉडल कौन से हैं?
इस गाइड के लिए, हमने सात वर्तमान मॉडल चुने हैं जो छवि निर्माण, संपादन, संदर्भ-आधारित निर्माण और दृश्य उत्पादन के विभिन्न दृष्टिकोणों का प्रतिनिधित्व करते हैं। क्रम किसी रैंकिंग का संकेत नहीं है।
मॉडल | मॉडल प्रकार | सबसे उपयुक्त | मुख्य विशेषताएं |
बहु-मोडल इनपुट के साथ छवि निर्माण और संपादन मॉडल | संदर्भ-आधारित निर्माण, उत्पाद विज़ुअल्स, पात्र, और विस्तृत संपादन | पाठ या छवियों से जनरेट करता है, अधिकतम 10 संदर्भों की विशेषताओं को संयोजित करता है, और विषय बनाए रखने, सटीक संपादन, तथा शैली नियंत्रण का समर्थन करता है। IMAGE 3.0 2K तक जनरेशन का समर्थन करता है, जबकि IMAGE 3.0 Omni 4K तक प्रदान करता है। | |
लियोनार्डो लूसिड ओरिजिन | छवि निर्माण मॉडल | इलस्ट्रेशन, कॉन्सेप्ट आर्ट, उत्पाद मॉकअप्स, और सामान्य छवि निर्माण | विविध शैलियों की विस्तृत श्रृंखला को कवर करता है, विस्तृत प्रॉम्प्ट का पालन करता है, फुल एचडी छवियाँ तैयार करता है और पठनीय टेक्स्ट रेंडरिंग का समर्थन करता है। |
Seedream 5.0 Pro | छवि जनरेशन और संपादन मॉडल | उत्पाद इमेजरी, इन्फोग्राफिक्स, डिज़ाइन एसेट्स और स्थानीय संपादन | टेक्स्ट या छवियों से काम करता है, संदर्भ स्वीकार करता है, क्षेत्रीय संपादन का समर्थन करता है और बहुभाषी इनपुट तथा जनरेशन को संभालता है। |
Adobe Firefly Image 5 | छवि निर्माण और संपादन मॉडल | डिज़ाइन उत्पादन, मार्केटिंग एसेट्स, और Adobe-आधारित प्रोजेक्ट्स | टेक्स्ट से जनरेट करता है, रेफरेंस इमेज के साथ काम करता है, और Photoshop में लक्षित संपादन की अनुमति देता है जबकि आसपास की छवि सामग्री को जस का तस छोड़ता है। |
Krea 2 Large | छवि निर्माण मॉडल | फोटो-रियलिज़्म, स्टाइल-प्रेरित कार्य, और विज़ुअल दिशा | भावपूर्ण फोटोरियलिज़्म के लिए अनुकूलित, और संयोजन, विषय तथा शैली पर संदर्भ-निर्देशित नियंत्रण के साथ प्रॉम्प्ट-आधारित निर्माण। |
Luma UNI-1.1 | एकीकृत बहु-मोडल छवि मॉडल | संदर्भ-नेतृत्वित जनरेशन और छवि संशोधन | यह छवि निर्माण को प्राकृतिक भाषा संपादन के साथ संयोजित करता है और एक अनुरोध में अधिकतम नौ संदर्भ इनपुट स्वीकार करता है। |
Runway Gen-4 Image | छवि और वीडियो प्लेटफ़ॉर्म के भीतर छवि निर्माण मॉडल | चरित्र विकास, दृश्य डिज़ाइन, और वे प्रोजेक्ट जो बाद में वीडियो में जाते हैं | पाठ और संदर्भ छवियों से जनरेट करता है, प्रति जनरेशन अधिकतम तीन संदर्भों का उपयोग करता है, और नए दृश्यों में पात्रों, वस्तुओं या दृश्य गुणों को वहन कर सकता है। |
अगला अनुभाग इन मॉडलों की तुलना प्रॉम्प्ट फॉलोइंग, संदर्भ हैंडलिंग, संपादन, दृश्य स्थिरता, और शैली नियंत्रण पर करता है।
2026 में टेक्स्ट-टू-इमेज मॉडल कैसे तुलना करते हैं?
टेक्स्ट-टू-इमेज मॉडल मुख्य रूप से प्रॉम्प्ट सटीकता, संदर्भ उपयोग, संपादन, स्थिरता, और शैली नियंत्रण में भिन्न होते हैं। ये अंतर उन प्रोजेक्ट्स में अधिक स्पष्ट होते हैं जिनमें दोहराई जाने वाली छवियाँ, संशोधन, उत्पाद या आवर्ती चरित्र शामिल होते हैं।
तुलना क्षेत्र | किसकी तुलना करें | यह क्यों महत्वपूर्ण है |
प्रॉम्प्ट का पालन | विषय, गुण, वस्तु संबंध, संरचना, और आवश्यक विवरण। | यदि एक सुसज्जित छवि ब्रीफ़ से चूक जाए, तो वह फिर भी कम पड़ती है। |
संदर्भ प्रबंधन | रेफ़रेंस की संख्या, विषय का संरक्षण, शैली स्थानांतरण और रचना मार्गदर्शन। | रेफ़रेंस किसी चरित्र, उत्पाद या दृश्य दिशा को विभिन्न छवियों में पहचानने योग्य बनाए रखने में मदद करते हैं। |
छवि संपादन | स्थानीय बदलाव, प्राकृतिक भाषा संपादन, और यह कि अछूते क्षेत्र कितनी अच्छी तरह अक्षुण्ण रहें। | सटीक संपादन समय बचाते हैं और छवि को शुरू से फिर से बनाने से बचाते हैं। |
दृश्य संगति | छवियों या संशोधनों में पात्र, उत्पाद, वस्त्र, शैली और आवर्ती विवरण। | स्थिर विवरण छवि श्रृंखलाओं, अभियानों, स्टोरीबोर्डों और उत्पाद सेटों के लिए महत्वपूर्ण होते हैं। |
शैली नियंत्रण | प्रकाश व्यवस्था, पैलेट, बनावट, फोटोग्राफिक लुक, चित्रण शैली और दृश्य दिशा। | स्पष्ट शैली नियंत्रण संबंधित छवियों को दृश्य रूप से जुड़े रहने में मदद करता है। |
वर्कफ़्लो अनुकूलता | संशोधनों, निर्यात विकल्पों, इमेज-टू-वीडियो उपयोग, और अन्य क्रिएटिव टूल्स के साथ संगतता। | जनरेशन के बाद क्या होता है, यह पहली छवि जितना ही महत्वपूर्ण हो सकता है। |
एक मॉडल जो त्वरित अवधारणा छवियों के लिए अच्छी तरह काम करता है, वह किसी उत्पाद श्रृंखला या चरित्र परियोजना के लिए उपयुक्त नहीं हो सकता। एक ही छवि के लिए प्रॉम्प्ट की सटीकता और शैली पर्याप्त हो सकती है, जबकि बार-बार के काम के लिए अक्सर मजबूत संदर्भ, संपादन, और एकरूपता की आवश्यकता होती है।
सबसे अच्छा टेक्स्ट-टू-इमेज मॉडल कैसे चुनें?
जब एक AI image generator, चुनें, तो शुरुआत इस बात से करें कि आप क्या बनाना चाहते हैं और छवि को संशोधित करते समय किन विवरणों को अपरिवर्तित रहना चाहिए। नीचे दी गई तालिका कई सामान्य परिदृश्यों में किन बातों पर ध्यान देना है, यह दिखाती है।
यदि आपको आवश्यकता है | इनकी तलाश करें | यह क्यों महत्वपूर्ण है |
त्वरित अवधारणा छवियाँ | प्रॉम्प्ट की सटीकता, छवि गुणवत्ता और शैली का दायरा | आप कम संशोधनों के साथ इच्छित परिणाम के अधिक निकट पहुँच सकते हैं। |
सुसंगत पात्र या उत्पाद | संदर्भ प्रबंधन और विवरण संरक्षण | चेहरे, परिधान, उत्पाद, और अन्य परिभाषित विशेषताएँ छवियों में पहचानने योग्य बनी रहनी चाहिए। |
बार-बार छवि संशोधन | स्थानीय संपादन और प्राकृतिक भाषा परिवर्तन | आप पूरी दृश्य को दोबारा बनाए बिना छवि के एक भाग को समायोजित कर सकते हैं। |
अभियान एसेट्स या छवियों की श्रृंखला | स्थिर विषय, शैली और रचना | संबंधित छवियों को समान दृश्य दिशा साझा करनी चाहिए। |
वे छवियाँ जो बाद में वीडियो में बदल जाती हैं | संदर्भ छवियाँ और छवि-से-वीडियो विकल्प | स्थिर विषय और दृश्य विवरण को गति में ले जाना आसान होता है। |
Kling IMAGE 3.0 पर विचार करना क्यों सार्थक है?
Kling IMAGE 3.0 आपको टेक्स्ट प्रॉम्प्ट या संदर्भ छवियों से रचनाएँ शुरू करने देता है, फिर प्राकृतिक भाषा का उपयोग करके हर विवरण को बारीकी से परिष्कृत करने देता है। मानक जेनरेशन से परे, यह आपको चरित्र की स्थिरता, सटीक संपादन और शैली ट्यूनिंग पर गहन नियंत्रण देता है, जिससे असीम रचनात्मक संभावनाएँ खुलती हैं।
जटिल विचारों को ताज़ा दृश्य रूपों में बदलें
IMAGE 3.0 आपको अनेक संदर्भों से दृश्य संकेतों को मिलाने और रोज़मर्रा की भाषा का उपयोग करके मानक संपादन से आगे बढ़ने देता है। विभिन्न छवियों के विषयों को संयोजित करें, किसी दृश्य के दृष्टिकोण को पलटें, या किसी अवधारणा को पूरी तरह नई शैली में स्थानांतरित करें—और यह सब अंतिम परिणाम को निर्बाध और सुसंगत रखते हुए।
संदर्भ छवि 1 | संदर्भ छवि 2 | आउटपुट छवि |
प्रॉम्प्ट: छवि 1 और छवि 2 के जानवरों को मिलाएं। | ||
पात्रों, उत्पादों और प्रमुख विवरणों को पहचानने योग्य रखें
आप एक जेनरेशन में अधिकतम 10 रेफरेंस इमेज का उपयोग कर सकते हैं। विभिन्न रेफरेंस एक चरित्र, परिधान, उत्पाद, सेटिंग या शैली को परिभाषित कर सकते हैं, जबकि आपका प्रॉम्प्ट बताता है कि इन तत्वों को कैसे एक साथ आना चाहिए। पोर्ट्रेट टच-अप्स के लिए, फेस रेफरेंस हेयरस्टाइल, आउटफिट, पोज़ या सेटिंग बदलते समय भी पहचानी जाने योग्य चेहरे की विशेषताओं को बनाए रखने में मदद कर सकते हैं। यदि आप केवल किसी मौजूदा शॉट में एक चेहरा स्वैप करना चाहते हैं, तो आप सीधे Kling के face swap वर्कफ़्लो में भी जा सकते हैं।
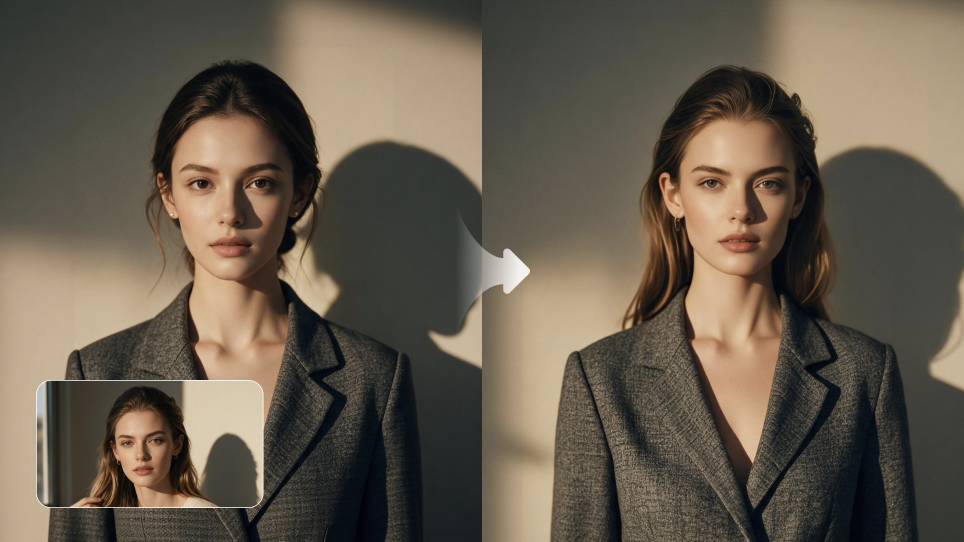
केवल वही बदलें जिसे बदलने की ज़रूरत है
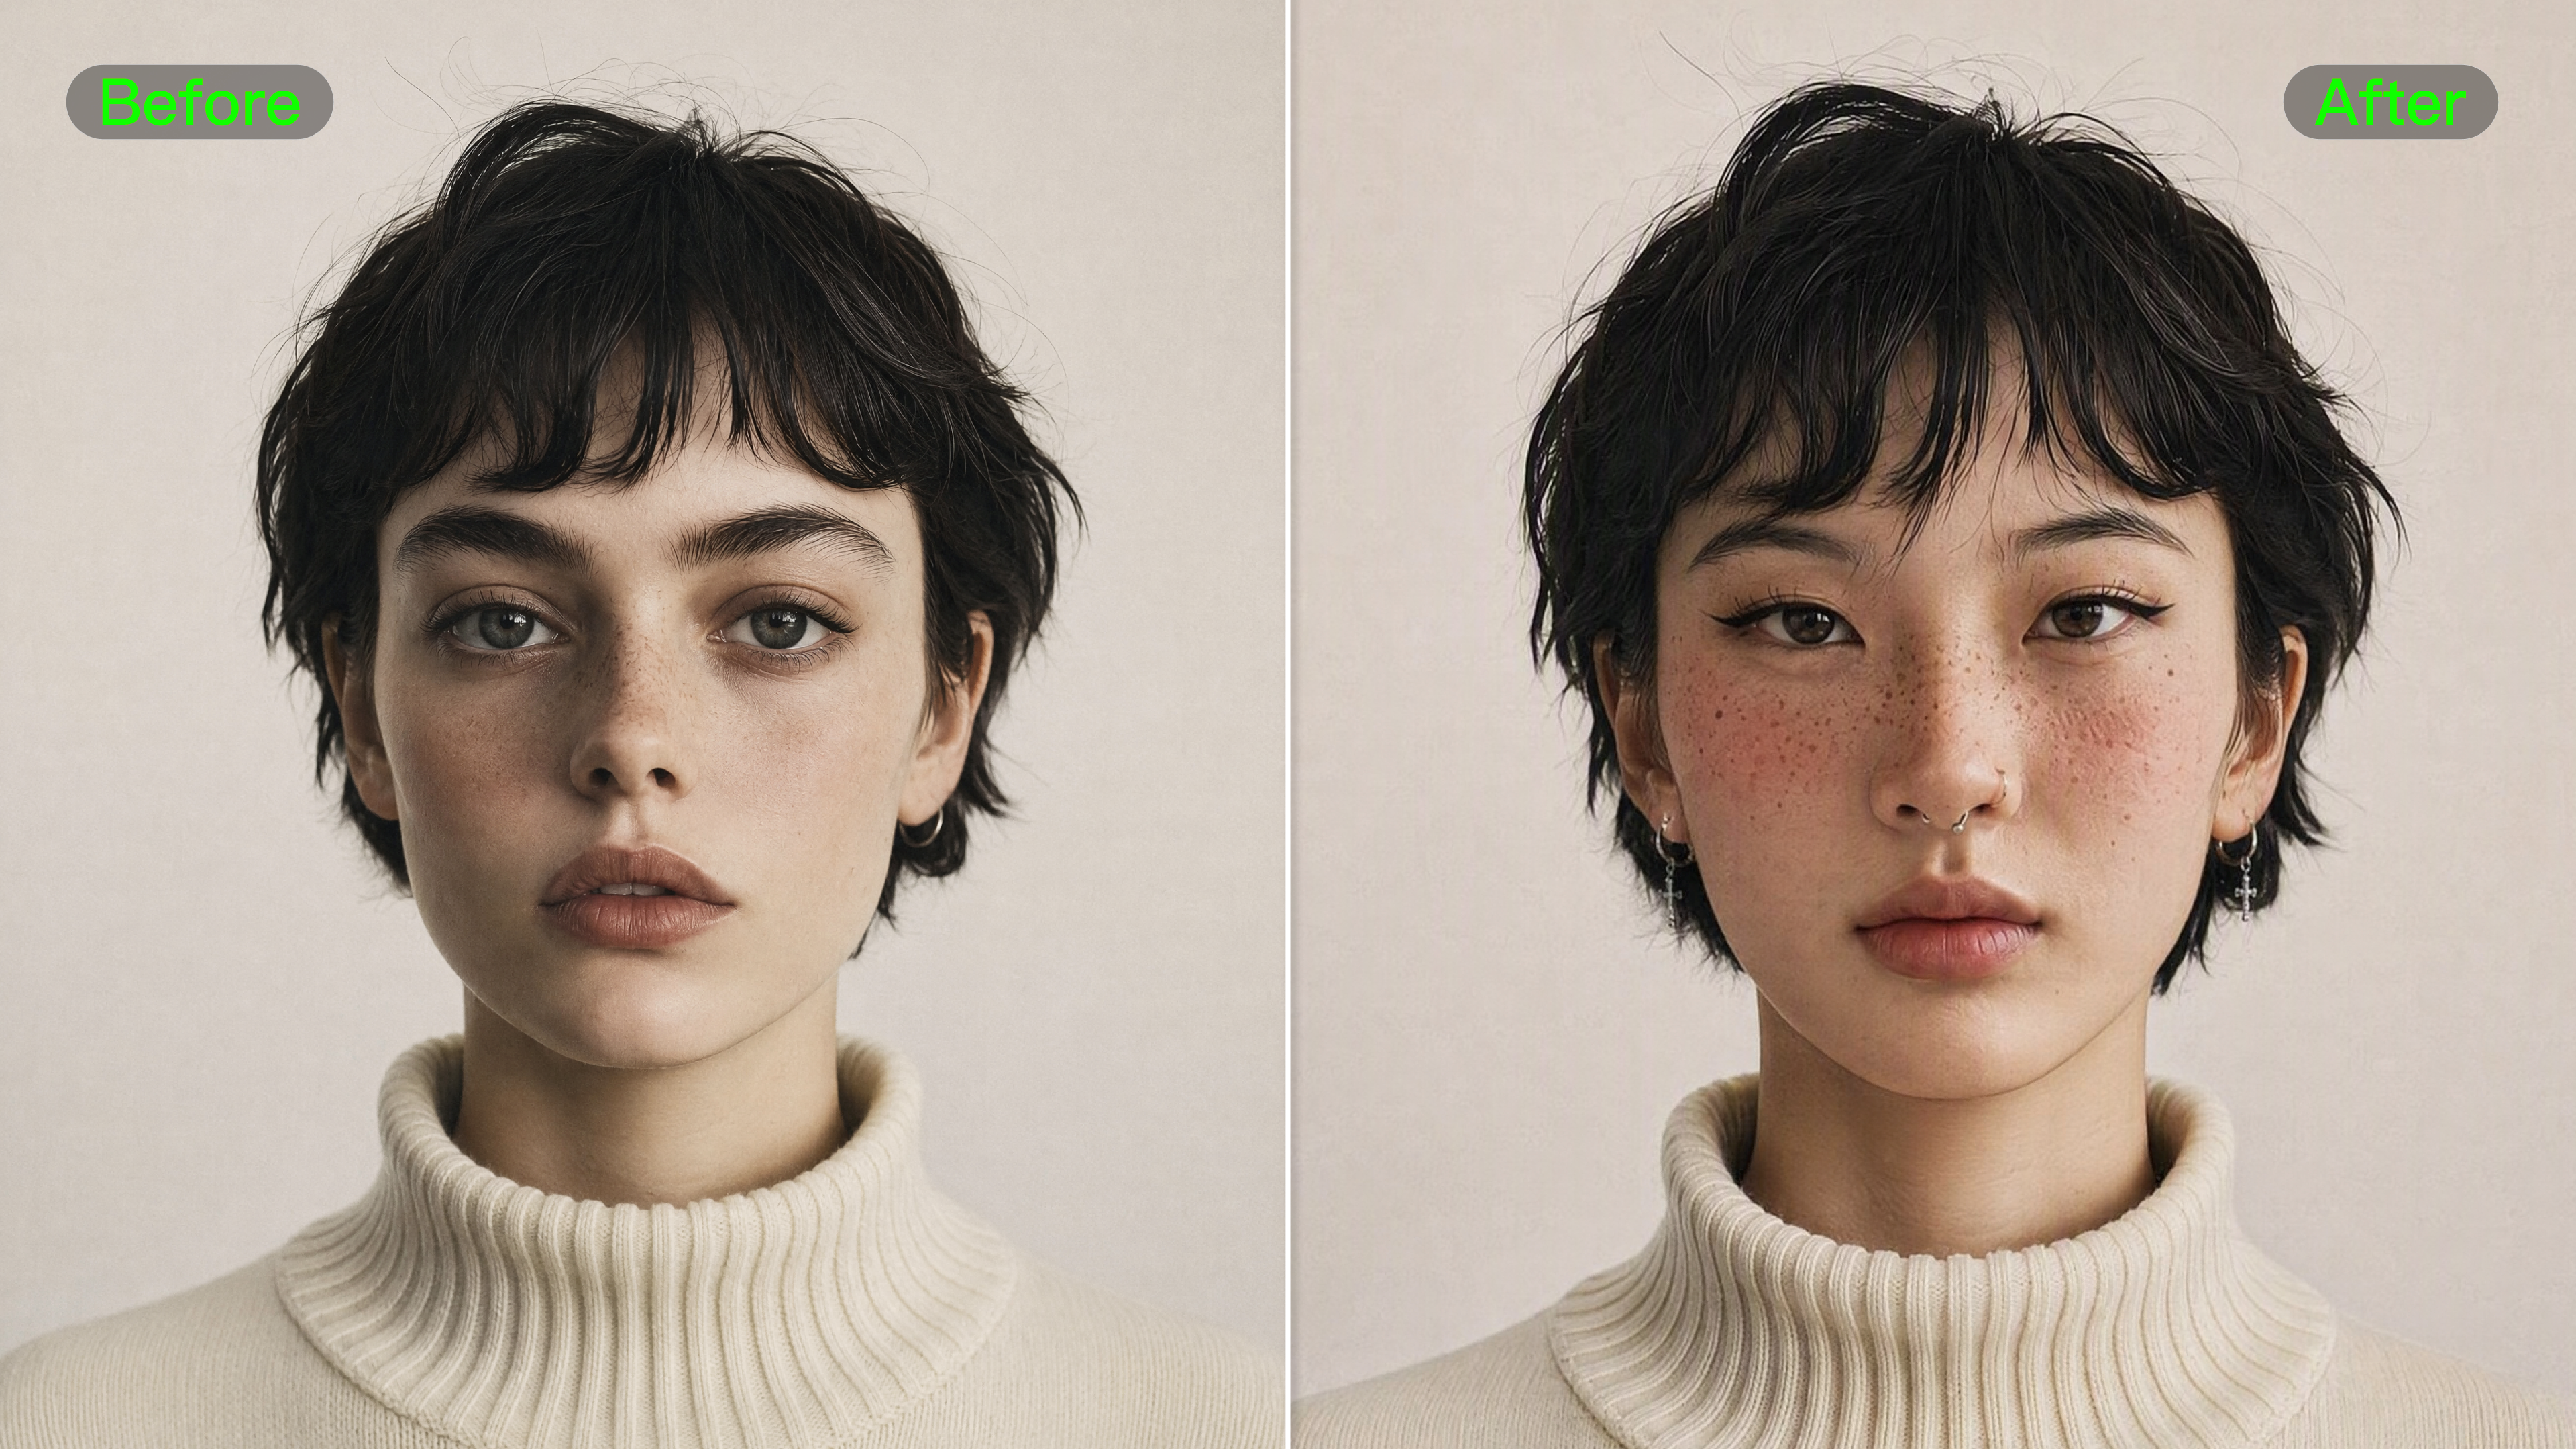
यदि किसी छवि का अधिकांश भाग पहले से ही सही दिखता है, तो आप पूरे दृश्य को फिर से बनाने के बिना विशिष्ट विवरण समायोजित करने के लिए Kling IMAGE 3.0 को AI फोटो संपादक के रूप में उपयोग कर सकते हैं। प्राकृतिक भाषा के निर्देश किसी वस्तु के आकार, रंग, सामग्री, अभिव्यक्ति या पृष्ठभूमि को बदल सकते हैं, जबकि छवि के आसपास के भागों को संरक्षित रखने का लक्ष्य रखते हैं। आप अपने स्वामित्व वाली या संपादन की अनुमति प्राप्त छवियों के लिए Kling AI को वॉटरमार्क हटाने वाला के रूप में भी उपयोग कर सकते हैं। अन्य संपादन में फोटो रंगीकरण, विंटेज प्रभाव, डूडल संपादन, प्रकाश और टोन परिवर्तन, तथा छवि पुनर्स्थापन शामिल हैं।
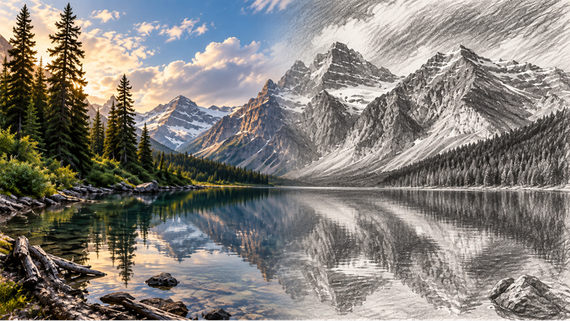
छवियों में शैली और टोन को एकसमान रखें यदि आपके पास पहले से ही स्पष्ट दृश्य दिशा है, तो आप मौजूदा छवि को शैली संदर्भ के रूप में उपयोग कर सकते हैं। Kling IMAGE 3.0 ब्रशवर्क, रंग, संरचना और टोन जैसे तत्वों को नई छवियों में स्थानांतरित कर सकता है। यह चित्रण सेट, उत्पाद विजुअल्स या ब्रांडेड सामग्री के लिए अच्छी तरह काम करता है, जहाँ एक से अधिक छवियों में एक जैसी उपस्थिति बनाए रखना आवश्यक होता है।
संदर्भ छवि 1 | संदर्भ छवि 2 | आउटपुट छवि |
प्रॉम्प्ट: छवि 1 की शैली को छवि 2 जैसी बदलें | ||
समाप्त
टेक्स्ट-टू-इमेज मॉडल अपनी प्रमुख क्षमताओं में अलग-अलग होते हैं, इसलिए सही चुनाव इस पर निर्भर करता है कि पहली छवि बनने के बाद आपको क्या चाहिए। यदि आपको केवल एक त्वरित कॉन्सेप्ट चाहिए, तो प्रॉम्प्ट की सटीकता और छवि गुणवत्ता पर्याप्त हो सकती है। उत्पाद विज़ुअल्स, आवर्ती पात्रों या छवि श्रृंखला के लिए संदर्भ, संपादन और स्थिरता अधिक मायने रखते हैं। यदि आप टेक्स्ट या मौजूदा विज़ुअल्स से शुरू करना चाहते हैं, तो Kling IMAGE 3.0 आपको संदर्भों को संयोजित करने, विशिष्ट विवरण बदलने और वही लुक नई छवियों में ले जाने देता है। चाहे आप उत्पाद अभियान बना रहे हों, एक आवर्ती पात्र विकसित कर रहे हों, या किसी शुरुआती कॉन्सेप्ट को पूर्ण विज़ुअल सेट में बदल रहे हों, सही मॉडल को परियोजना के बढ़ने के साथ उन विवरणों को बनाए रखना आसान बनाना चाहिए जिनकी आपको परवाह है।
अक्सर पूछे जाने वाले प्रश्न
टेक्स्ट-टू-इमेज निर्माण के लिए कौन सा AI भाषा मॉडल उपयोग किया जाता है?
किसी भी टेक्स्ट-टू-इमेज सिस्टम द्वारा एक ही भाषा मॉडल का उपयोग नहीं किया जाता है। यदि आप पूछ रहे हैं कि टेक्स्ट-टू-इमेज निर्माण क्षमताओं के लिए कौन सा AI भाषा मॉडल इस्तेमाल होता है, तो उत्तर मॉडल के अनुसार बदल जाता है। कुछ सिस्टम CLIP या T5 जैसे टेक्स्ट एन्कोडर का उपयोग करते हैं, जबकि अन्य छवि बनने से पहले प्रॉम्प्ट पढ़ने के लिए भाषा या विज़न-भाषा घटकों का प्रयोग करते हैं।
कौन-सा AI टेक्स्ट को छवि में बदल सकता है?
कई AI इमेज मॉडल एक लिखित प्रॉम्प्ट को तैयार छवि में बदल सकते हैं, जिनमें Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 और Runway Gen-4 Image शामिल हैं। प्रत्येक मॉडल प्रॉम्प्ट, रेफ़रेंस, एडिट और दृश्य संगति को अलग-अलग तरीके से संभालता है, इसलिए सही मॉडल इस बात पर निर्भर करता है कि आपको किस प्रकार की छवि बनानी है।
क्या टेक्स्ट-टू-इमेज मॉडल संदर्भ छवियों का उपयोग कर सकते हैं?
हाँ। कई टेक्स्ट-टू-इमेज मॉडल लिखित प्रॉम्प्ट्स के साथ संदर्भ छवियों का उपयोग कर सकते हैं, जिससे image-to-image AI उपयोगी होता है जब आप प्रारंभ से शुरू करने के बजाय किसी मौजूदा दृश्य से काम करना चाहते हैं। संदर्भ चरित्र, उत्पाद, पोज़, संरचना, रंग या शैली जैसे विवरण तय कर सकता है, जबकि प्रॉम्प्ट मॉडल को बताता है कि क्या बदलना है। Kling IMAGE 3.0 एक जनरेशन में अधिकतम 10 संदर्भ छवियों का उपयोग कर सकता है, जो तब सहायक होता है जब उसी चरित्र, उत्पाद या दृश्य शैली को पहचानने योग्य बनाए रखना आवश्यक हो।
मैं किसी इमेज की पृष्ठभूमि कैसे हटाऊँ?
यदि आपको अधिक साफ-सुथरा उत्पाद शॉट, प्रोफ़ाइल छवि या डिज़ाइन एसेट चाहिए, तो आप किसी छवि की पृष्ठभूमि हटा सकते हैं और मुख्य विषय को अलग रख सकते हैं। पारदर्शी पृष्ठभूमि उत्पाद लिस्टिंग, प्रस्तुतियों, सोशल पोस्ट या उन लेआउट में अच्छी तरह काम करती है जहाँ विषय को किसी अलग पृष्ठभूमि पर रखना होता है। हटाने के बाद, बाल, कपड़ों, फर या छोटे वस्तुओं के आसपास की महीन किनारियों की जाँच करें, फिर पृष्ठभूमि को पारदर्शी रखें, एक ठोस रंग में बदलें या विषय को किसी नए दृश्य में रखें।